
Blog flatkey.ai
Analyses, notes produit et guides d'implémentation pour les équipes qui construisent avec des API d'IA.
Architecture des passerelles IA
Derniers articles dans Architecture des passerelles IA.
Lire la suiteMigration des URL de base et des SDK
Derniers articles dans Migration des URL de base et des SDK.
Lire la suiteCoûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
Lire la suiteContrôles d’entreprise et confiance
Derniers articles dans Contrôles d’entreprise et confiance.
Lire la suiteComparatifs de passerelles
Derniers articles dans Comparatifs de passerelles.
Lire la suiteGuides des modèles et des modalités
Derniers articles dans Guides des modèles et des modalités.
Lire la suiteFiabilité et routage
Derniers articles dans Fiabilité et routage.
Lire la suiteIntégrations d’outils
Derniers articles dans Intégrations d’outils.
Lire la suite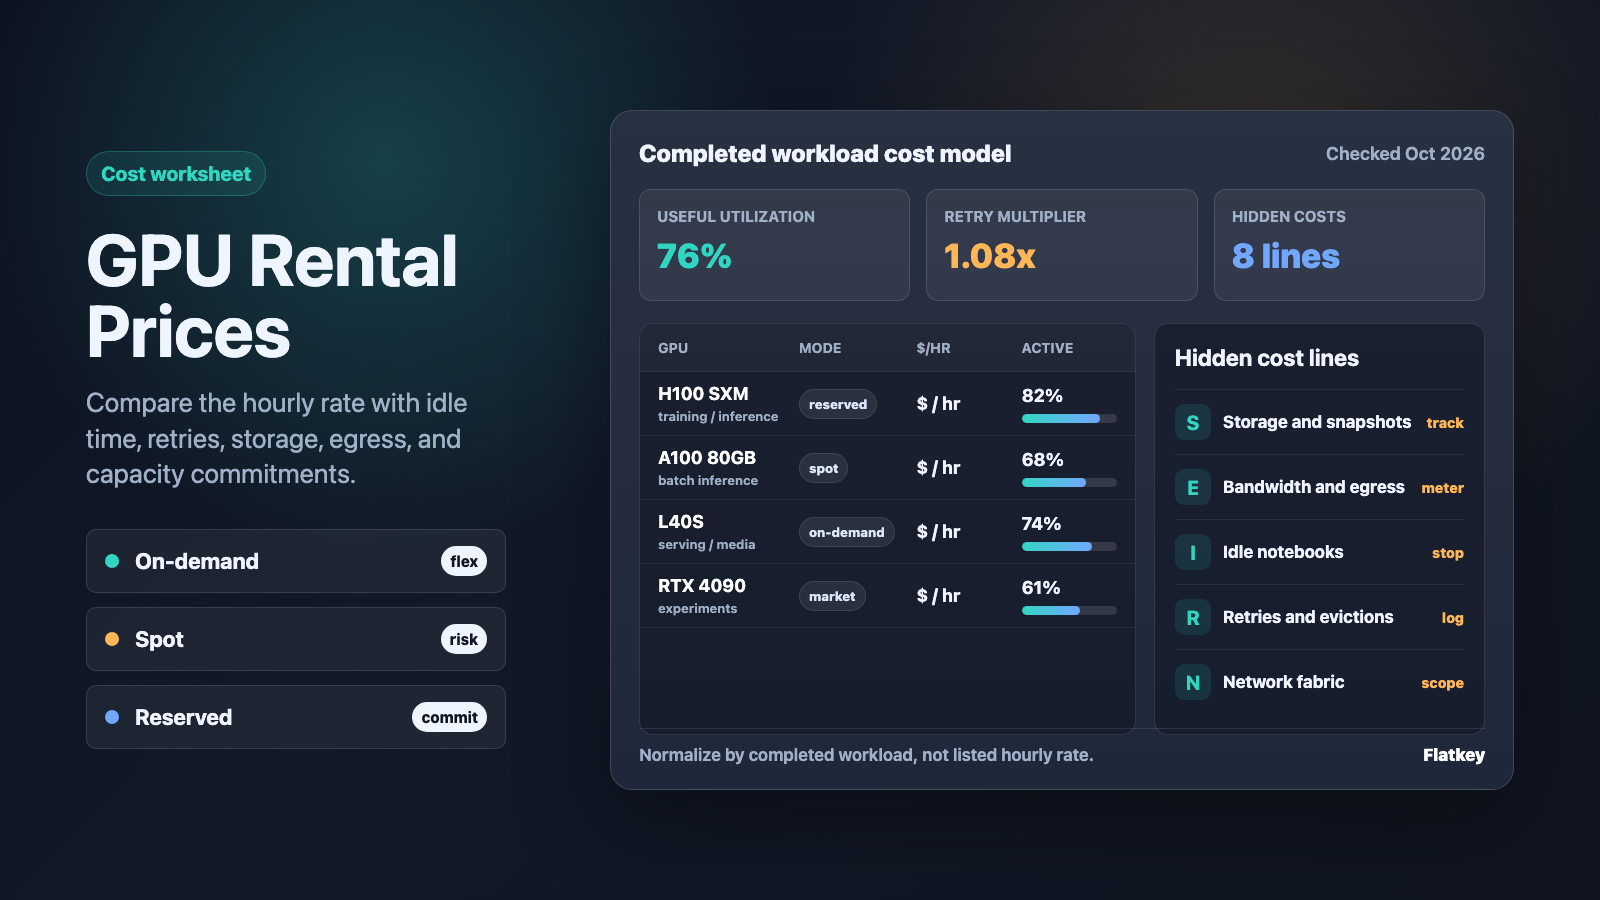
Explication des prix de location de GPU : à la demande, spot, réservé et coûts cachés
Un guide pratique pour comparer les prix de location de GPU selon le coût du travail terminé, et non seulement les tarifs horaires, avec des vérifications de sources pour les modèles à la demande, spot, réservés, sur marketplace et à coûts cachés.
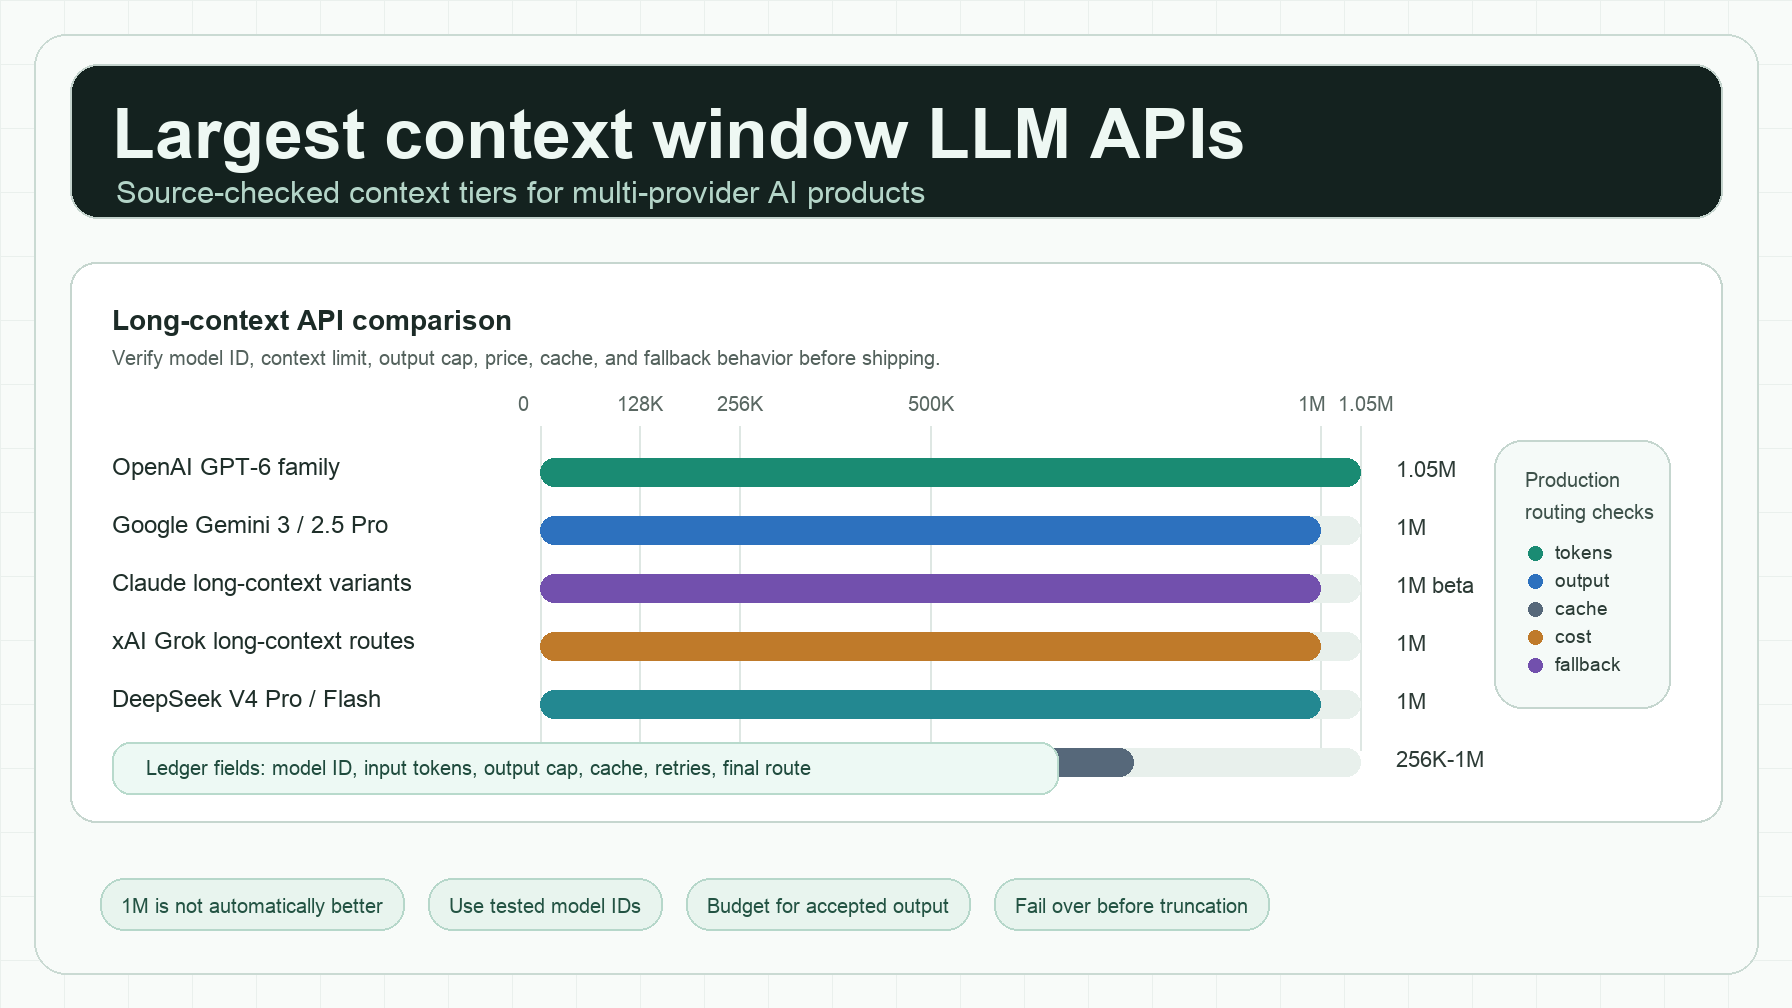
Comprendre la fenêtre de contexte des LLM : définition, tailles des principaux modèles et utilisation (octobre 2026)
La fenêtre de contexte d’un LLM est sa mémoire de travail pour chaque requête. Découvrez ce que représentent 128K, 200K et 1M tokens, les limites publiées des principaux modèles en octobre 2026, les tarifs des contextes longs et du code pour compter les tokens.
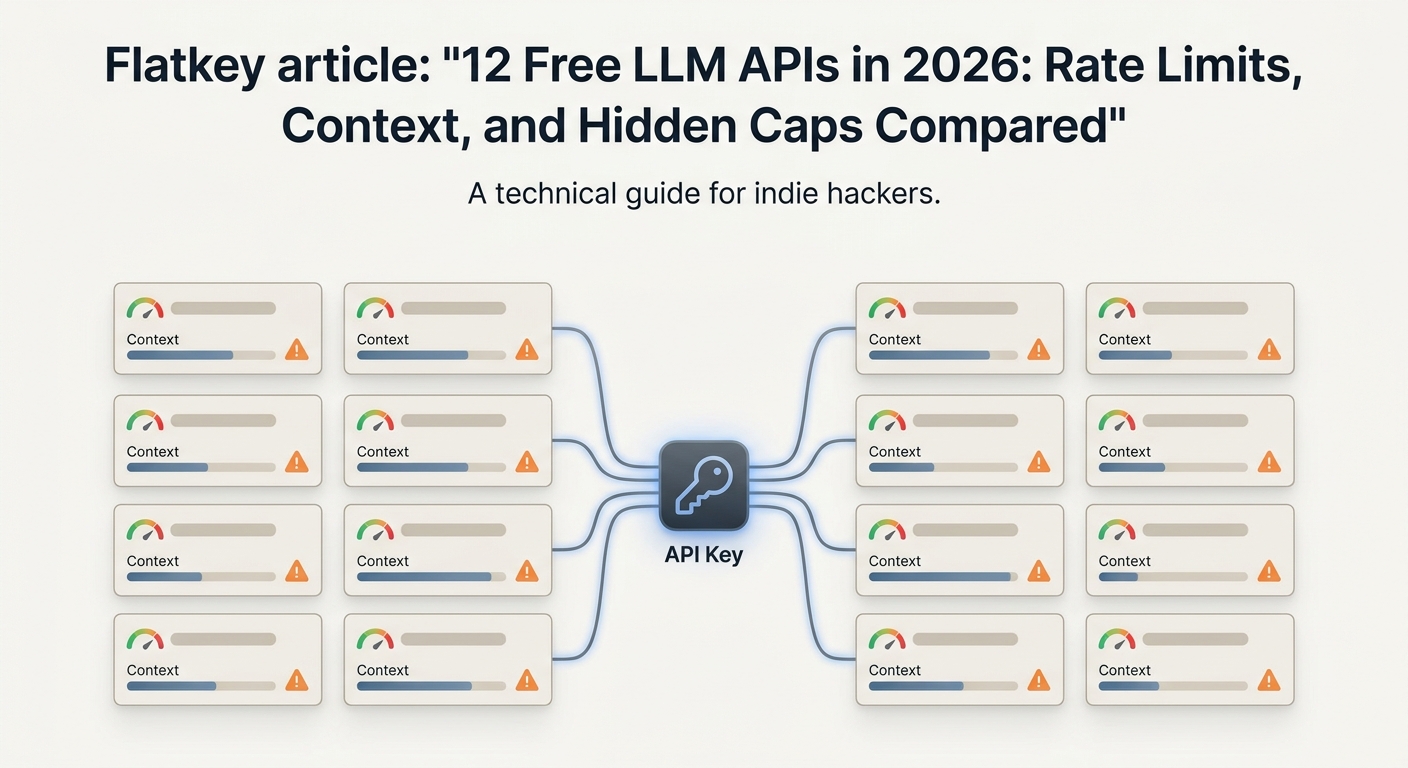
API LLM gratuite (2026) : 10 options comparées selon les vraies limites, les modèles et les pièges
Dix API LLM gratuites vérifiées dans la documentation officielle en octobre 2026 : ce qui est gratuit, les limites exactes, les pièges cachés et du code pour basculer de l'une à l'autre.
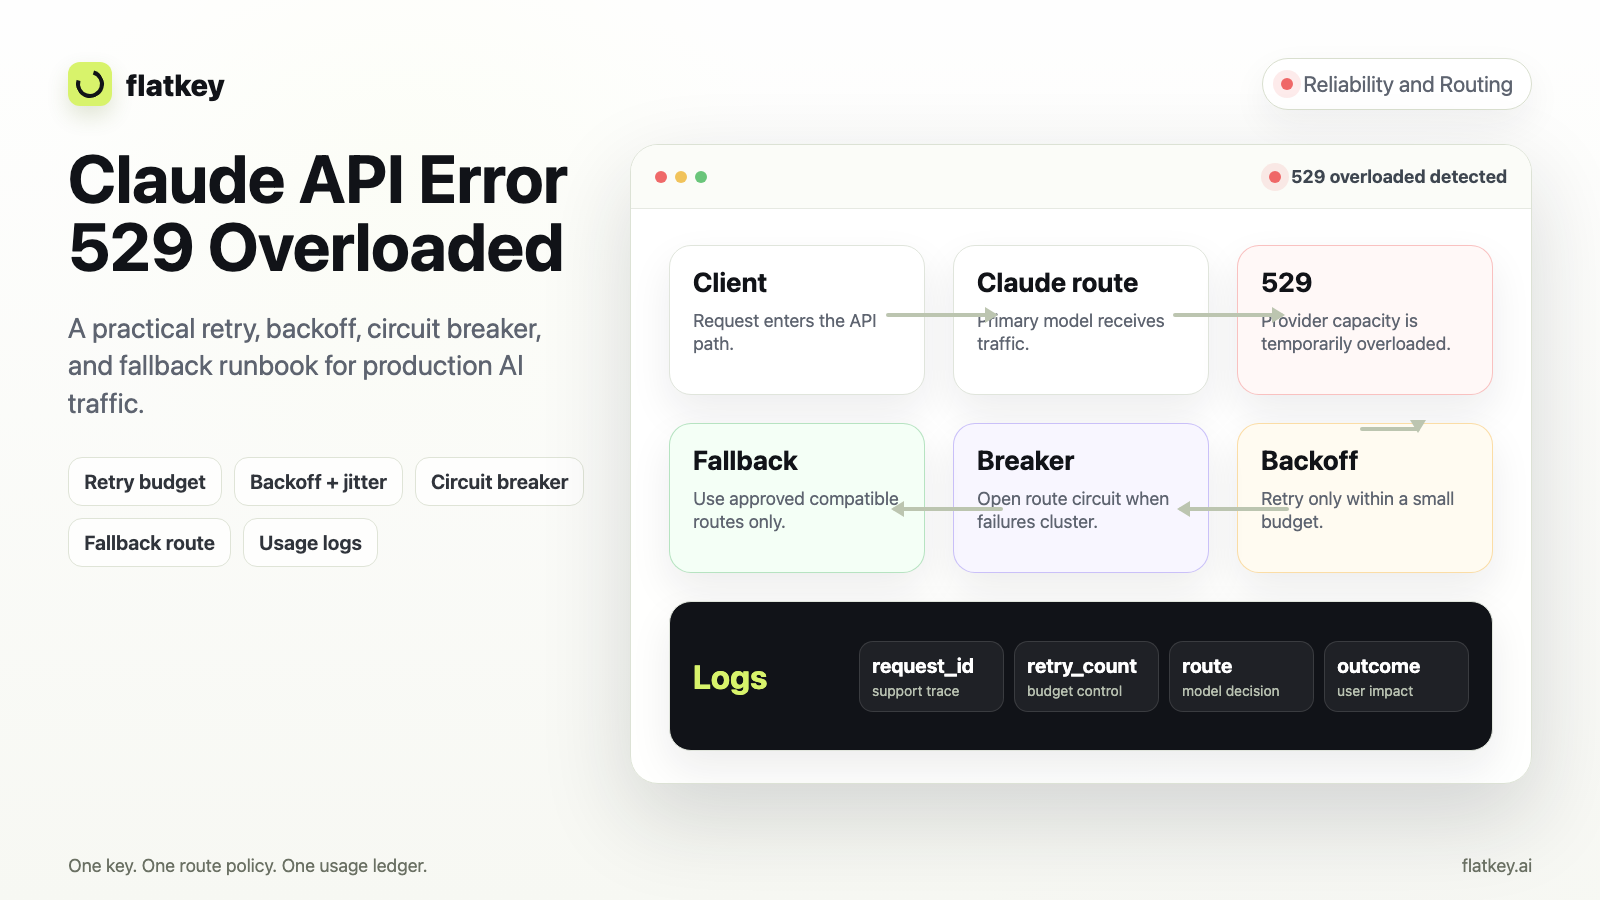
Erreur Claude API 529 de surcharge : guide d’intervention pour retry, backoff et fallback
Un guide d’intervention en production pour les erreurs de surcharge Claude API 529 : classer l’échec, définir des budgets de retry, ajouter du backoff et du jitter, protéger les effets de bord, couper les boucles de surcharge avec un circuit breaker et choisir des routes de fallback sûres.

Comparaison des prix des modèles d’IA : coûts des tokens, des images et des vidéos dans un seul tableau de bord
Comparez les tarifs des modèles d’IA sur les parcours texte, image, vidéo et API multi-fournisseurs avec un tableau de bord pour le coût par résultat accepté.
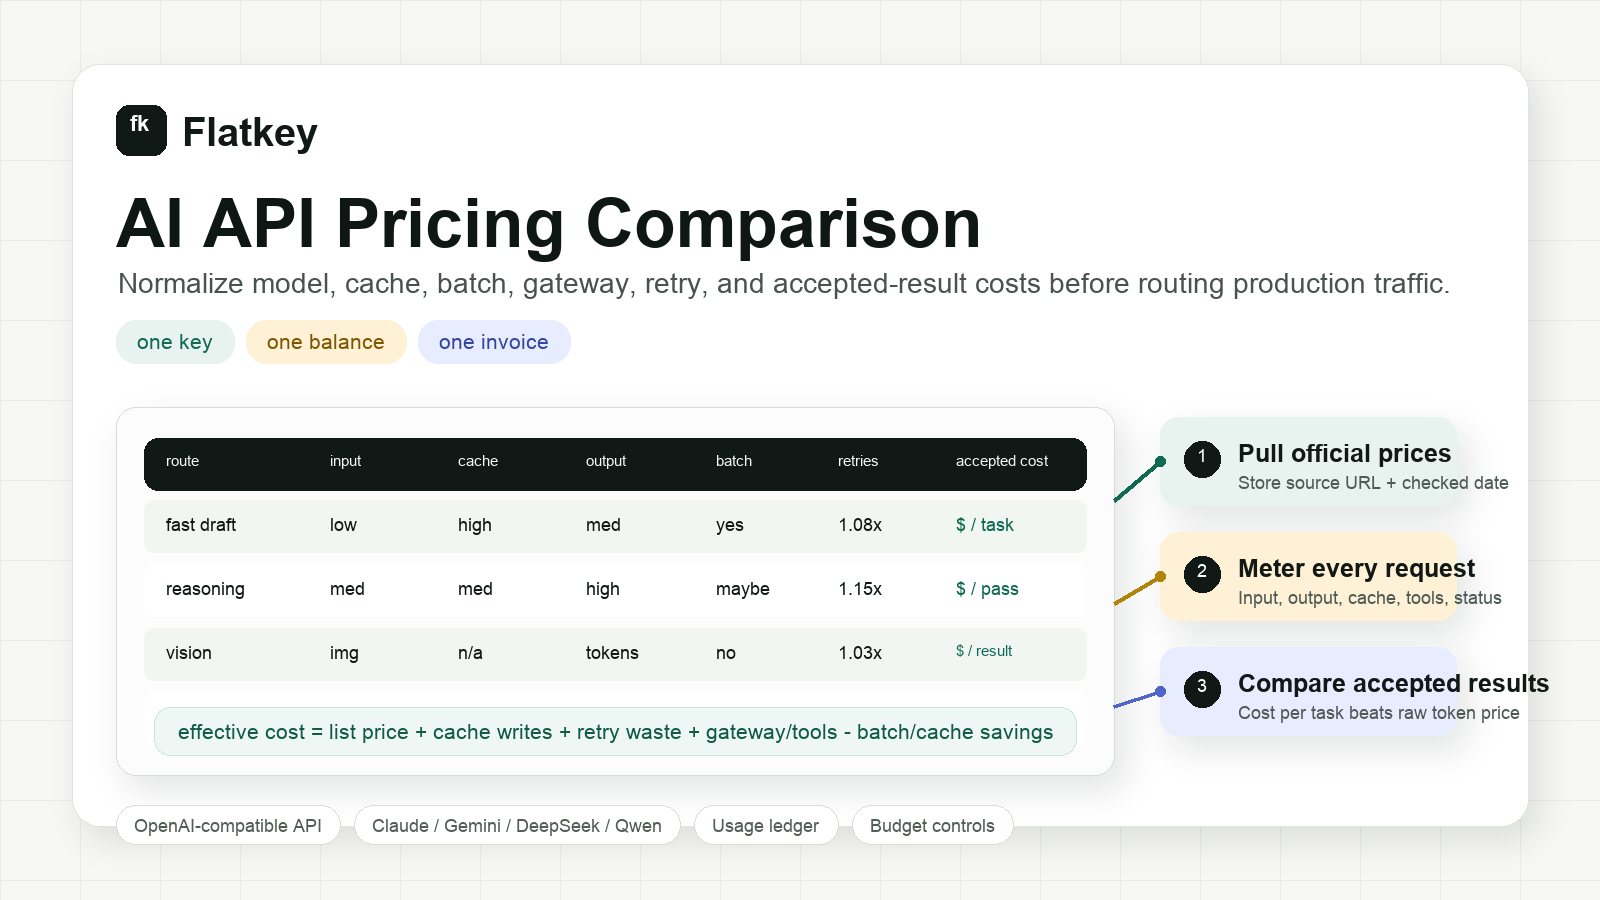
Comparaison des tarifs des API IA : coûts des modèles, du cache, des lots et de la passerelle
Un cadre pratique de comparaison des tarifs des API IA pour les développeurs, les équipes produit et les équipes achats, en comparant les coûts des modèles, du cache, des lots, de la passerelle, des retries et des résultats acceptés.
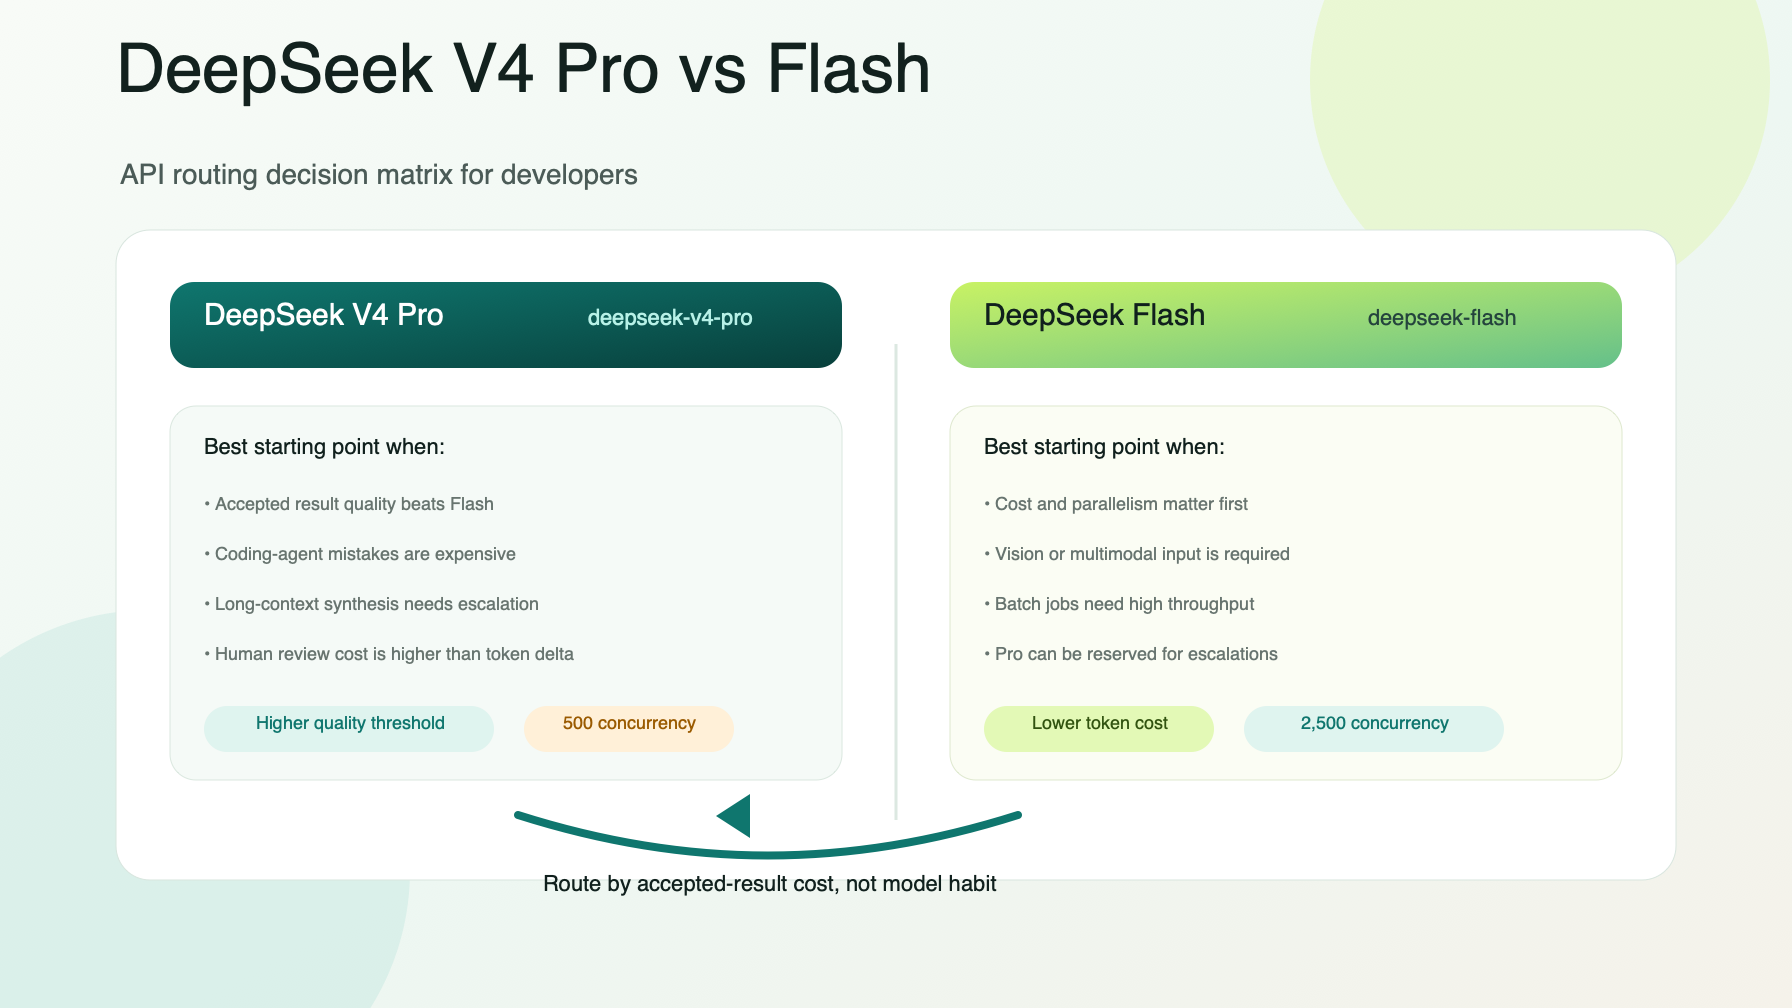
DeepSeek V4 Pro vs Flash : Quel modèle convient à votre flux de travail API ?
Comparez DeepSeek V4 Pro et Flash pour le routage API, les tarifs, la vision, la concurrence, le coût du cache et pour savoir quand utiliser Pro ou Flash.
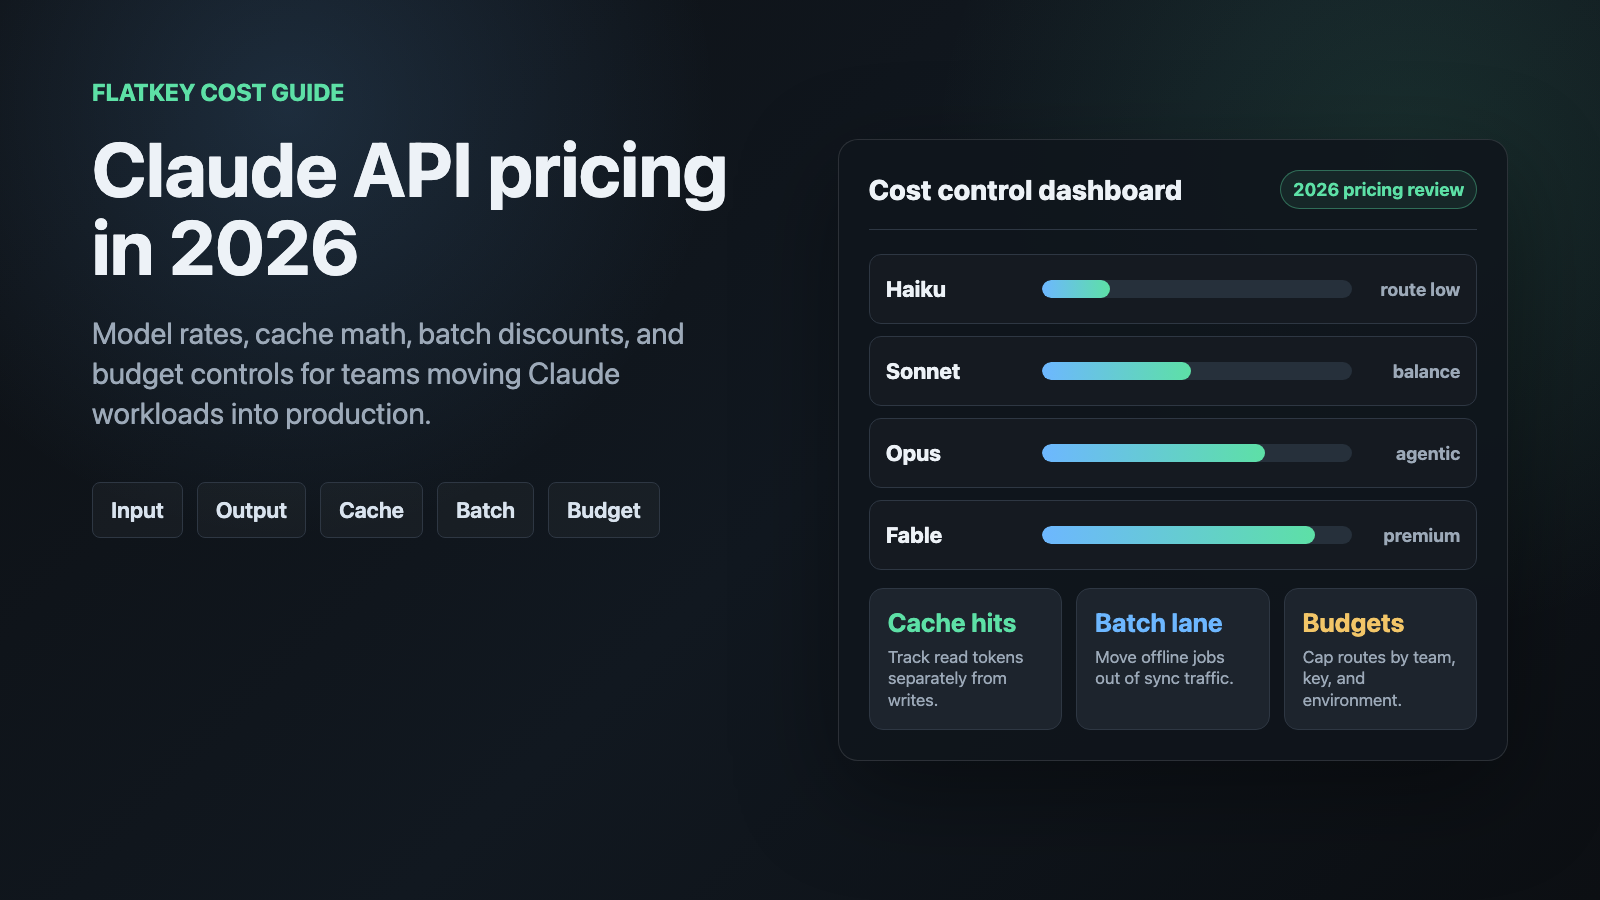
Quel modèle Claude choisir pour coder ? Opus 5.5 vs Sonnet 5.5 vs Haiku 5.5 vs Fable 5.1 (2026)
Quel modèle Claude utiliser pour coder en 2026 ? Un guide par type de tâche pour choisir entre Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.1, avec les tarifs officiels, le calcul du coût des sessions, les alias de Claude Code et des exemples d’API exécutables.
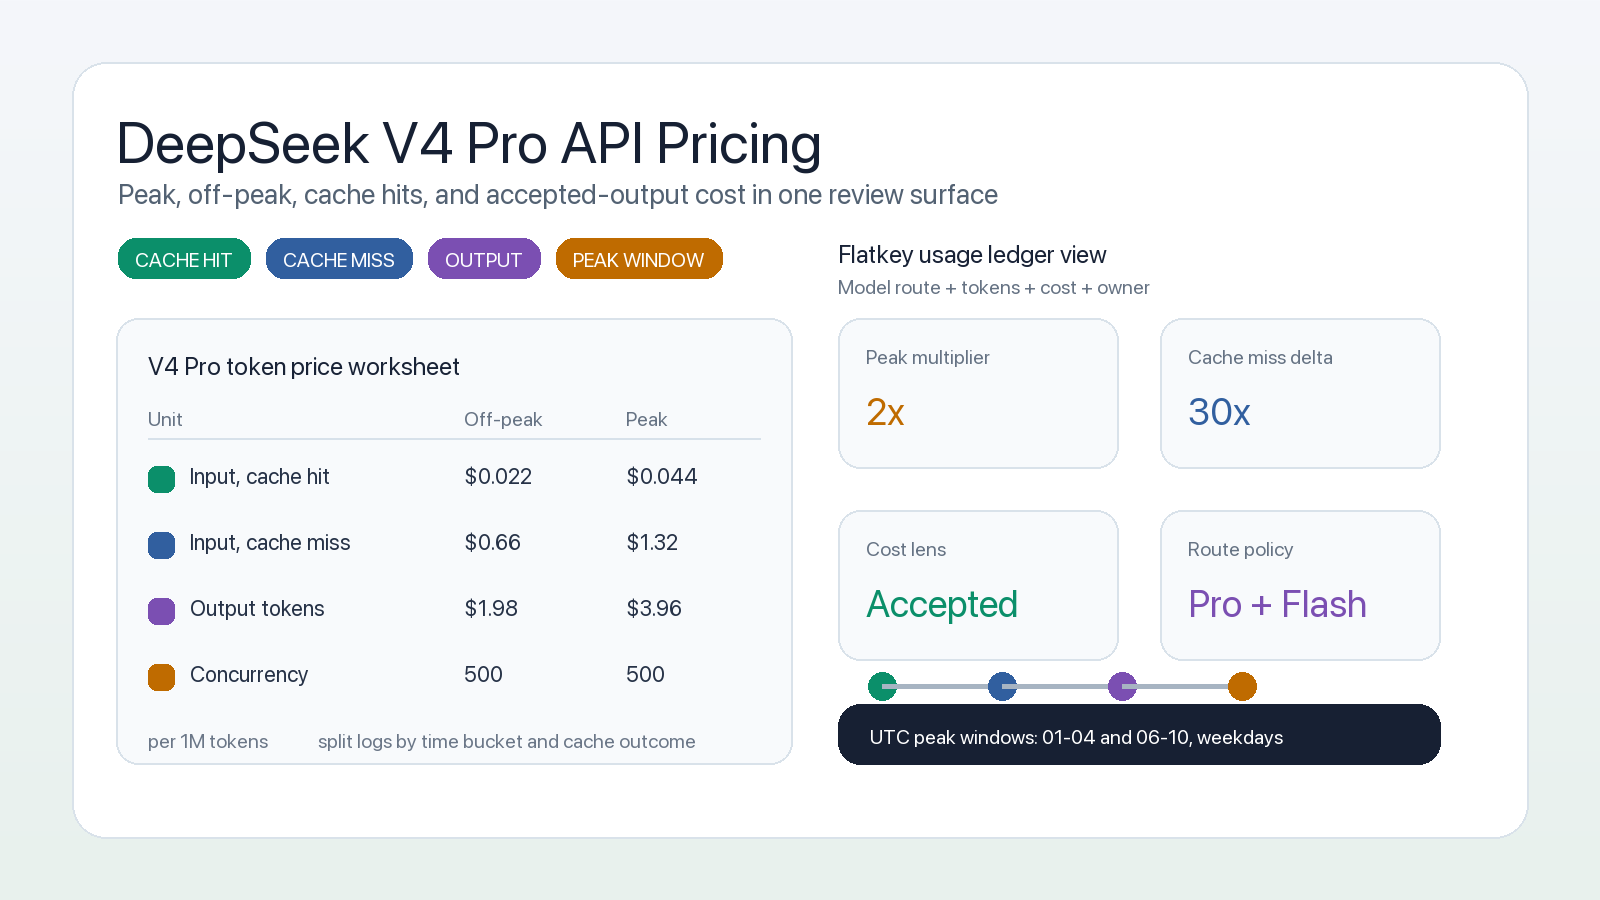
Tarification de l’API DeepSeek V4 Pro : heures de pointe, hors pointe et coûts du cache
Tarification actuelle de l’API DeepSeek V4 Pro avec les tarifs en heures de pointe et hors pointe, le calcul du taux de cache hit, et une feuille de calcul pour maîtriser les coûts destinée aux développeurs et aux équipes achats.
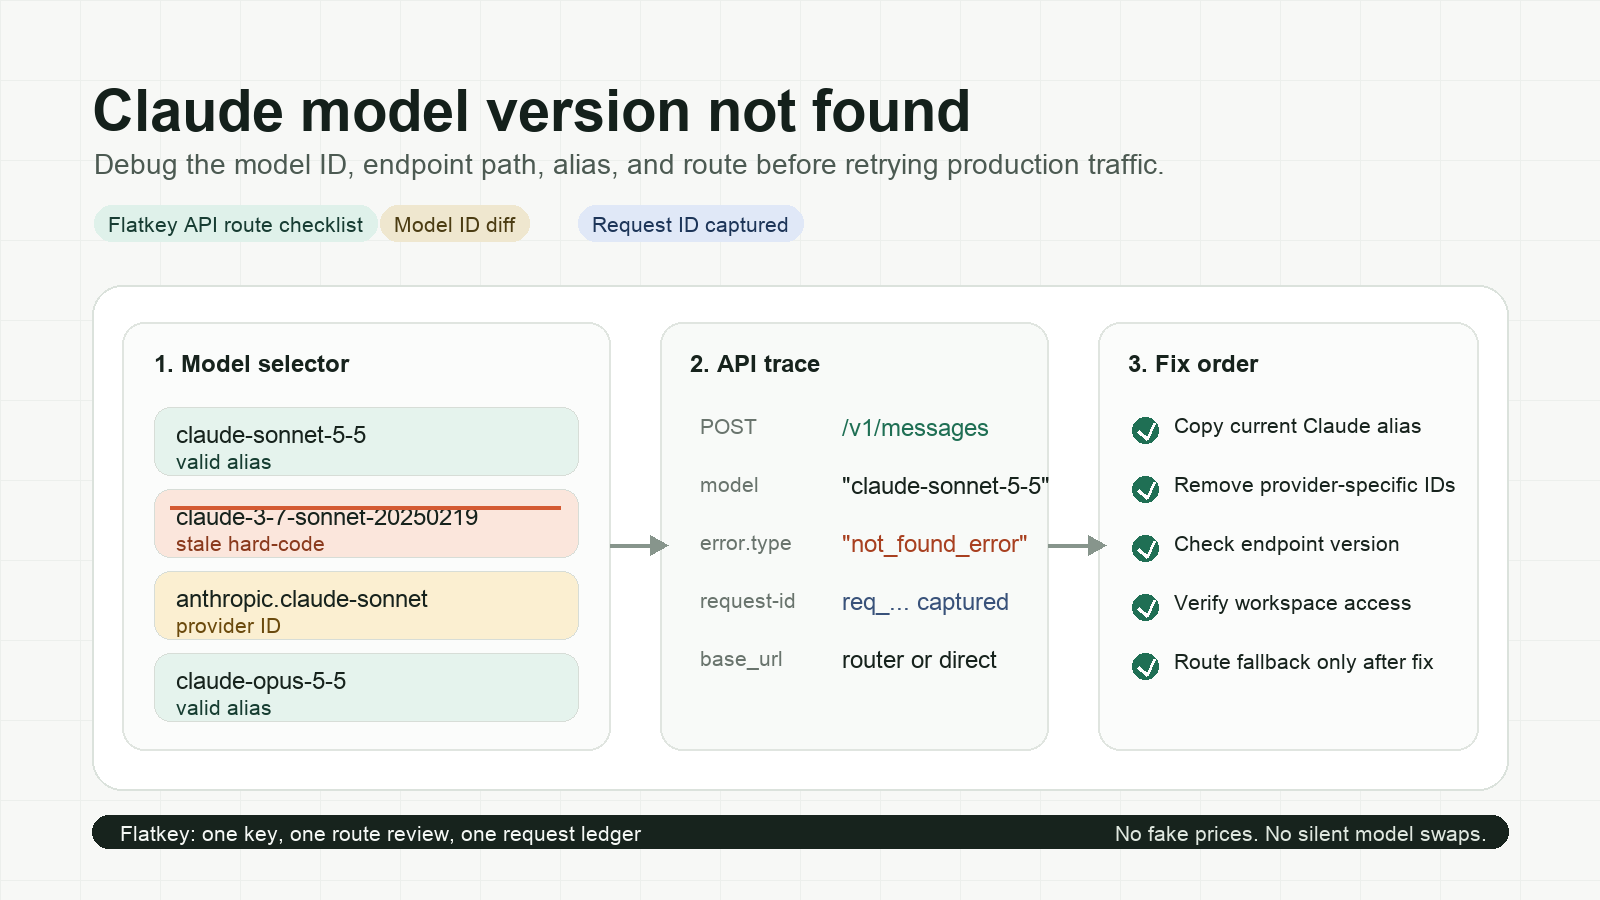
Claude Model Version Not Found : corriger les mauvais ID de modèle, alias et routes API
Un guide pratique de débogage pour les erreurs « model version not found » de Claude, couvrant les API natives d’Anthropic, les routeurs, les IDs des fournisseurs cloud, les configurations d’agents et les solutions de repli en production.
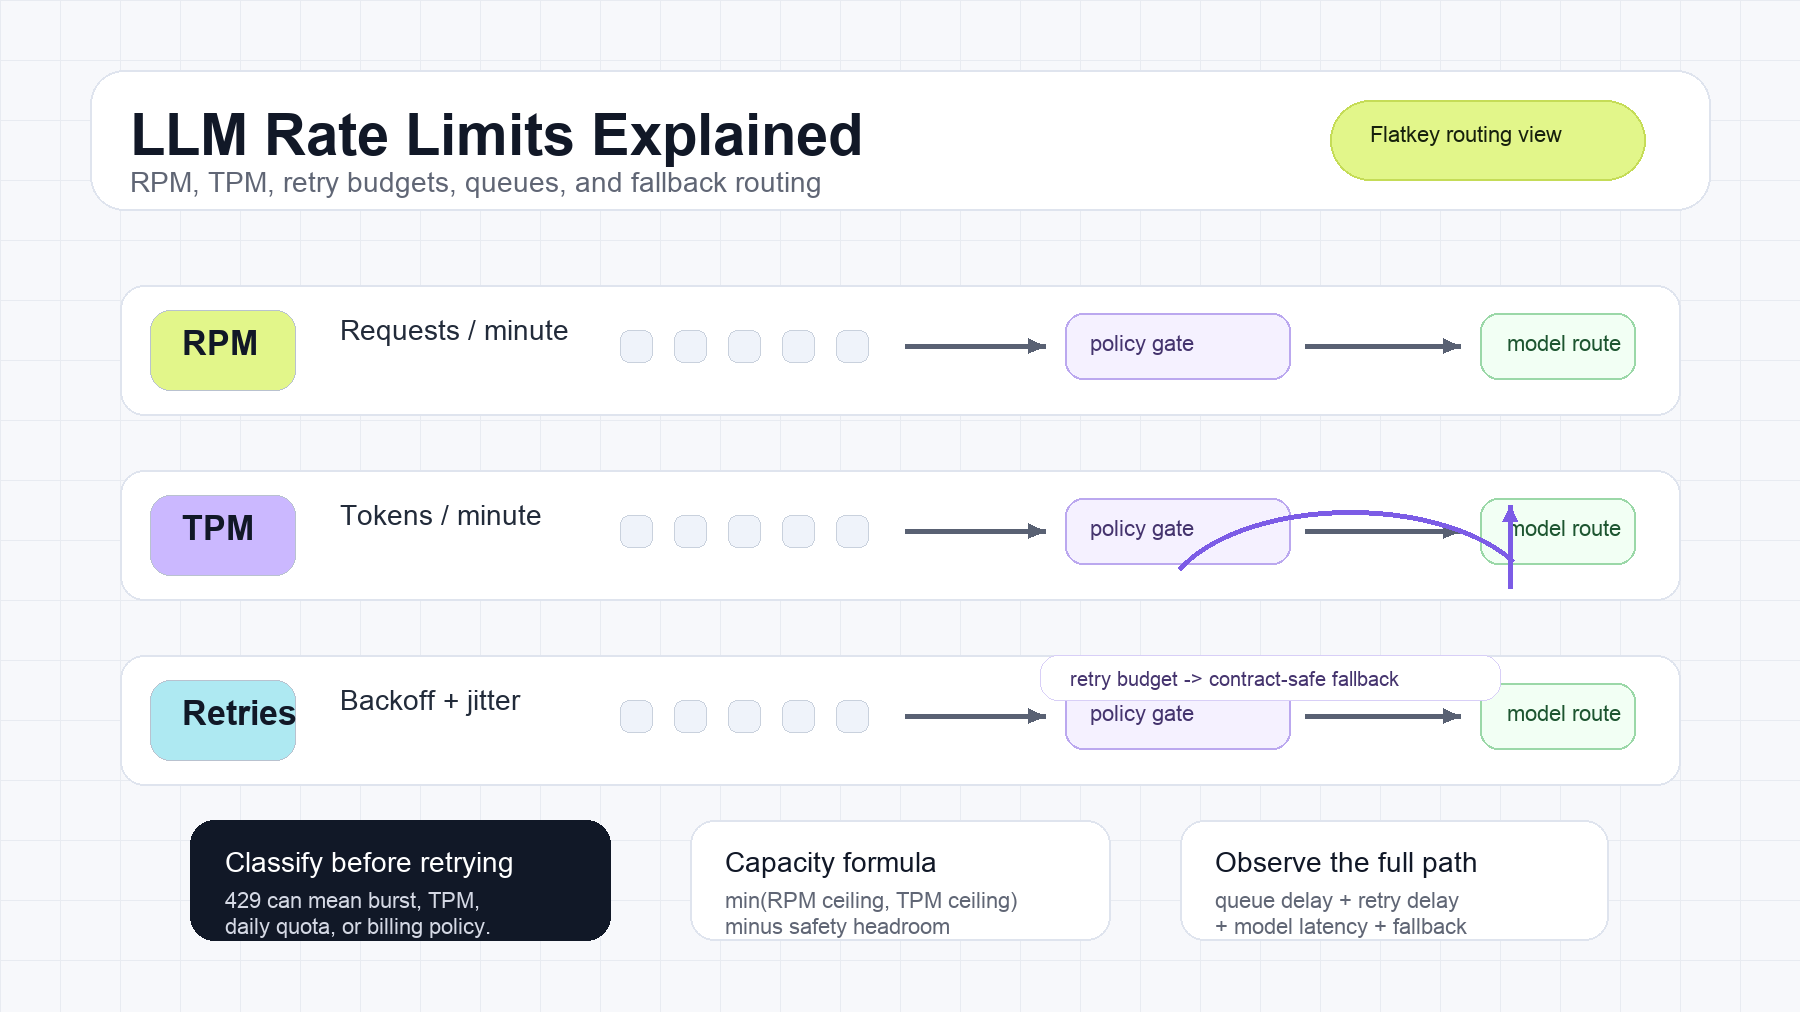
Comprendre les limites de débit des LLM : RPM, TPM et retries
Comprenez les limites de débit des LLM, RPM, TPM, les erreurs 429, Retry-After, l'exponential backoff, les budgets de retry, les files d'attente et le routage de secours.

Accès API GLM-5 : tarification et configuration compatible OpenAI
Comparez les prix des API de la famille GLM-5, les identifiants de modèle, les fenêtres de contexte et les schémas de configuration compatibles OpenAI pour Z.AI et Flatkey.
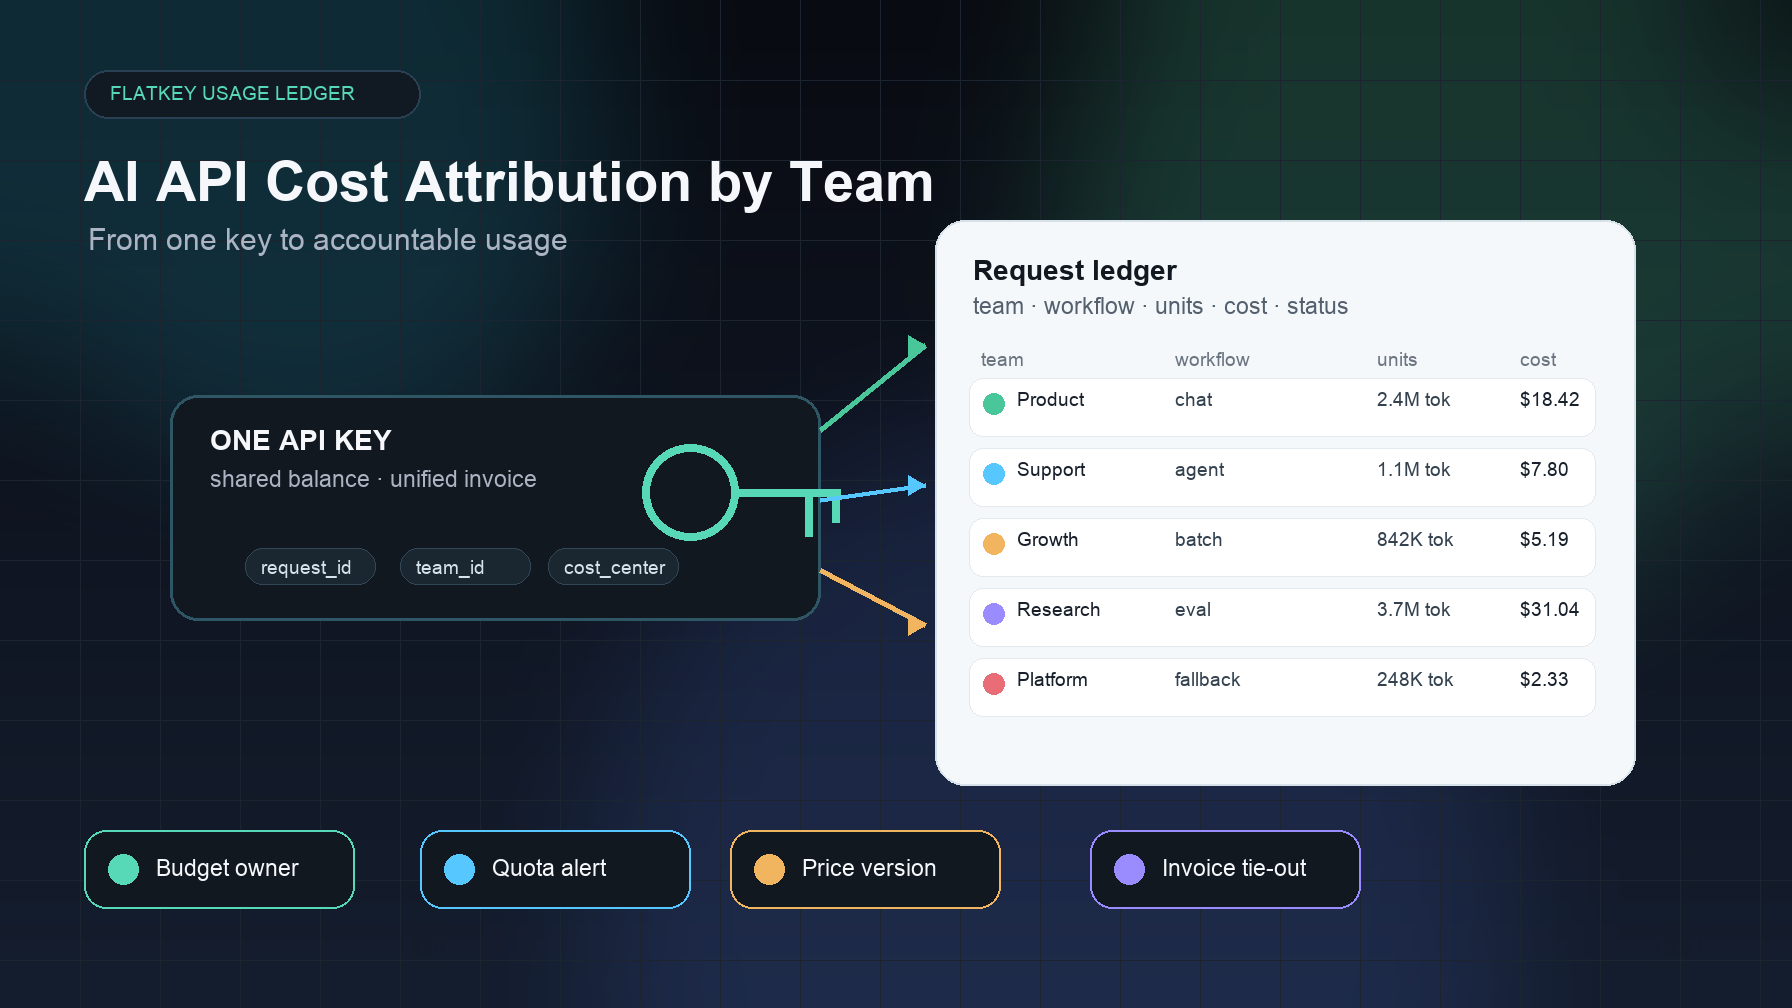
Attribution des coûts des API IA par équipe : d’une seule clé à une utilisation responsable
Mettez en place l’attribution des coûts des API IA par équipe avec des balises de requête, des limites par sous-clé, des journaux d’utilisation, des quotas et une revue financière mensuelle.
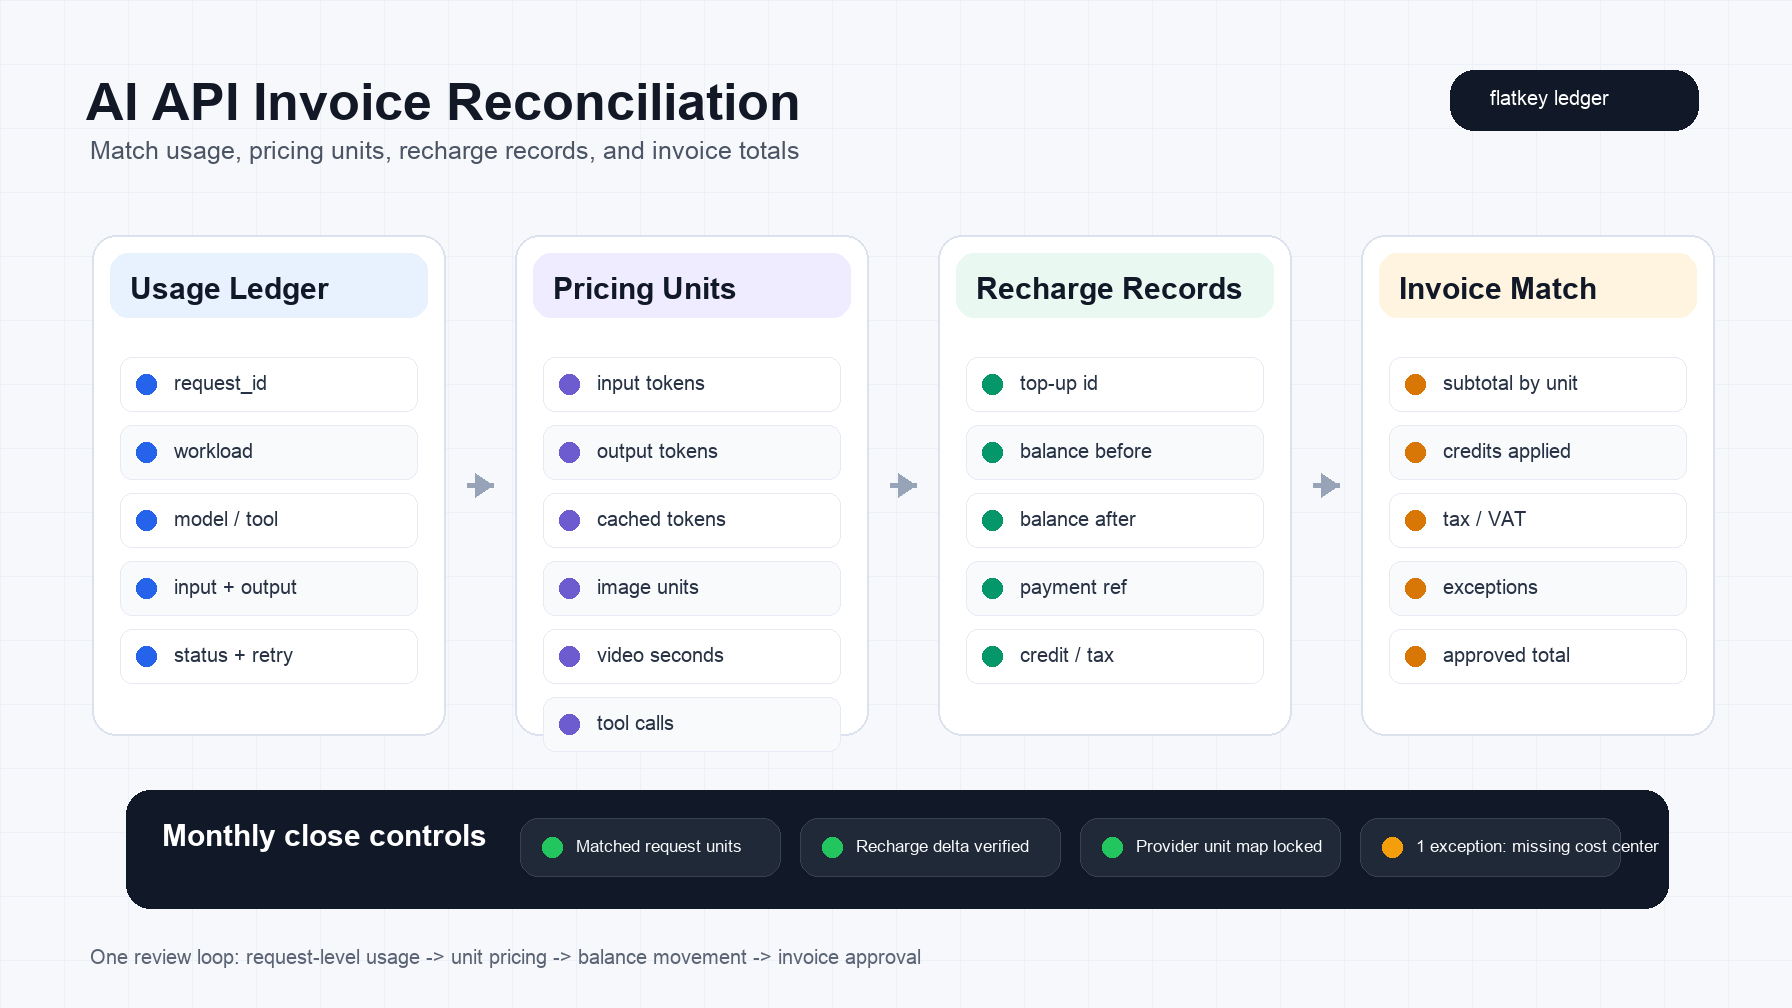
Rapprochement des factures d’API IA : faire correspondre l’utilisation, les unités tarifaires et les recharges
Rapprochez les factures d’API IA en faisant correspondre les journaux d’utilisation, les unités tarifaires, les recharges, les mouvements de solde, les crédits, les taxes et les totaux de facture.

Tarifs de l’API Anthropic (octobre 2026) : chaque modèle Claude, cache, Batch et calcul des coûts
Tous les tarifs de l’API Anthropic en octobre 2026, de Haiku 5.5 à 0,10 $/0,50 $ à Fable 5.1 à 10 $/50 $, avec cache, Batch API, résidence des données, mode rapide, plafonds et budgets mensuels.
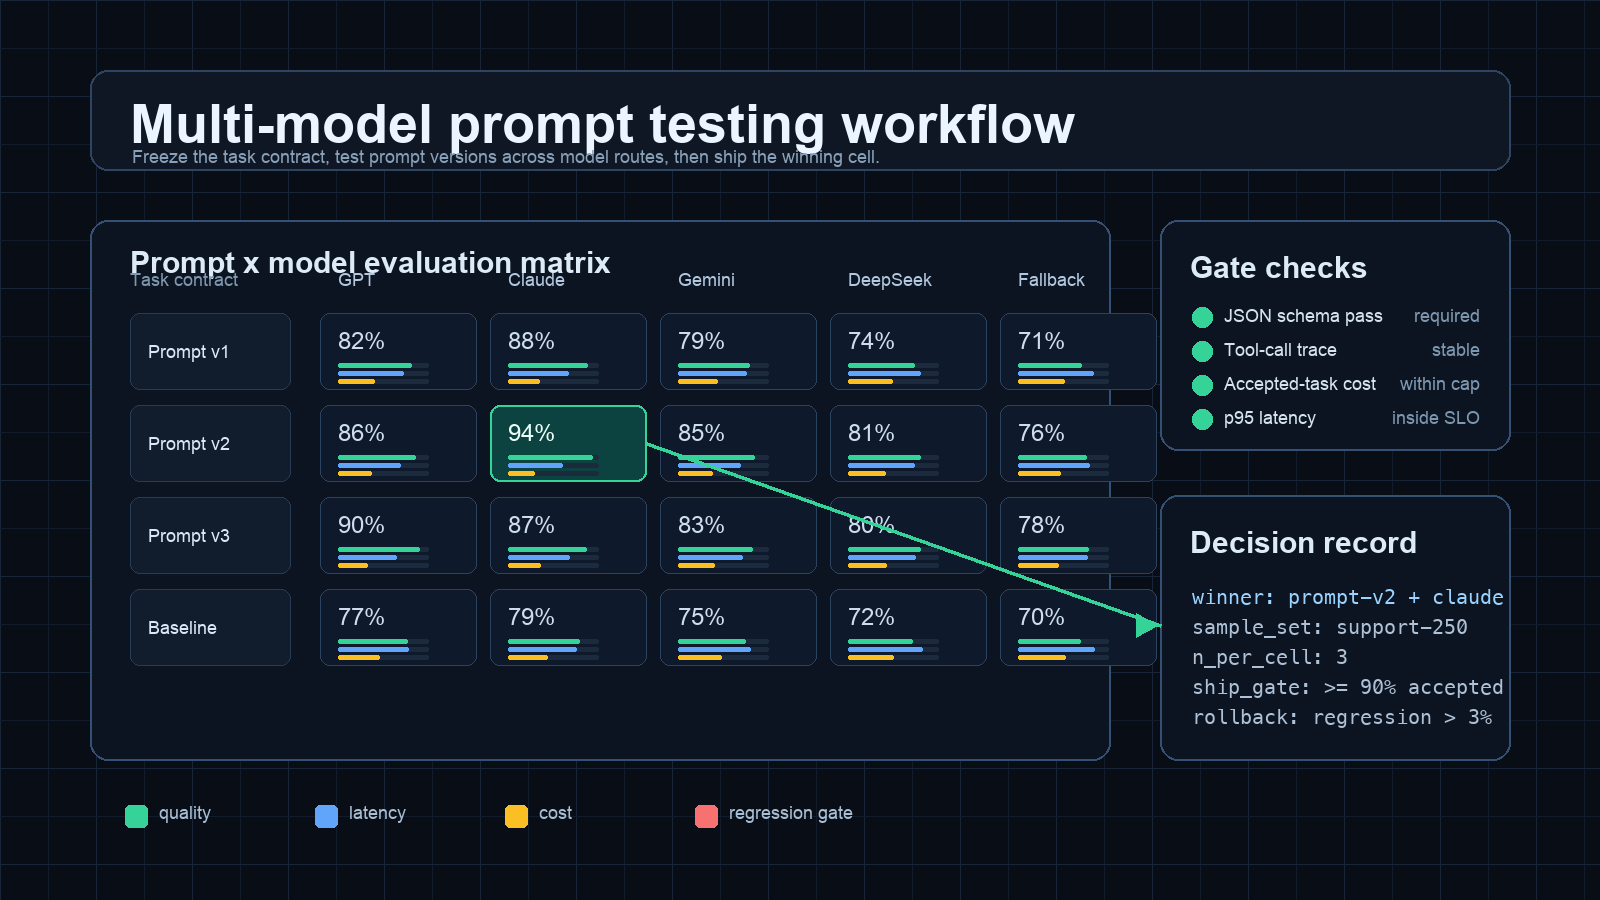
Flux de travail de test de prompts multi-modèles : matrice d’évaluation pour les équipes produit IA
Menez un flux de travail de test de prompts multi-modèles avec des matrices prompt/modèle, des validateurs, le coût par tâche acceptée, des seuils de latence et des journaux de déploiement.
Comment comparer les prix des modèles d’IA avant de changer de fournisseur d’API
Comparez les prix des modèles d’IA en tenant compte du comportement du cache, de la qualité des résultats acceptés, de la latence, des tentatives de reprise et du coût effectif par tâche réussie avant de changer de fournisseur d’API.
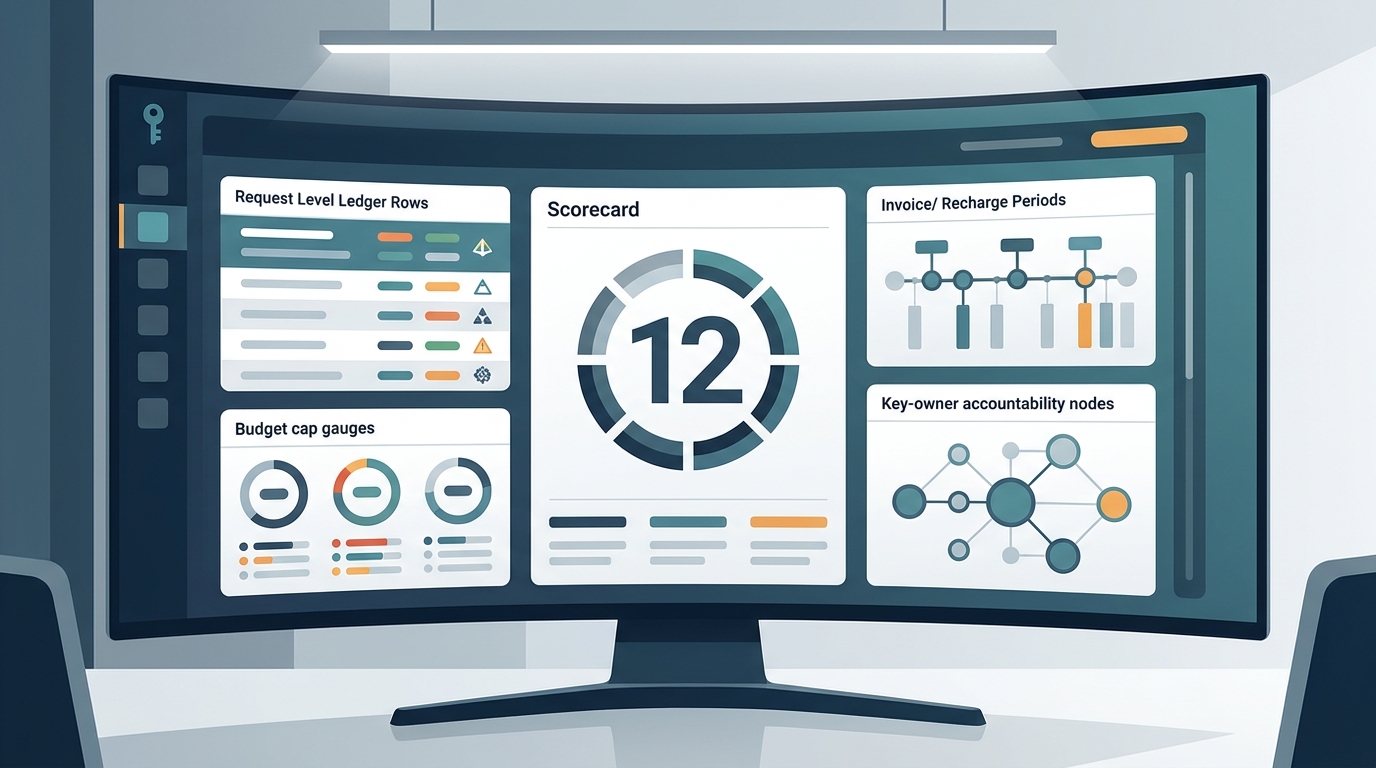
Tableau de bord de facturation IA unifié : 12 questions à poser avant d’acheter
Un cadre d’achat en 12 questions pour évaluer les tableaux de bord de facturation IA unifiés, couvrant les registres d’utilisation, les clés API, les quotas, les historiques de recharge, les exports, les factures et la responsabilité.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer