
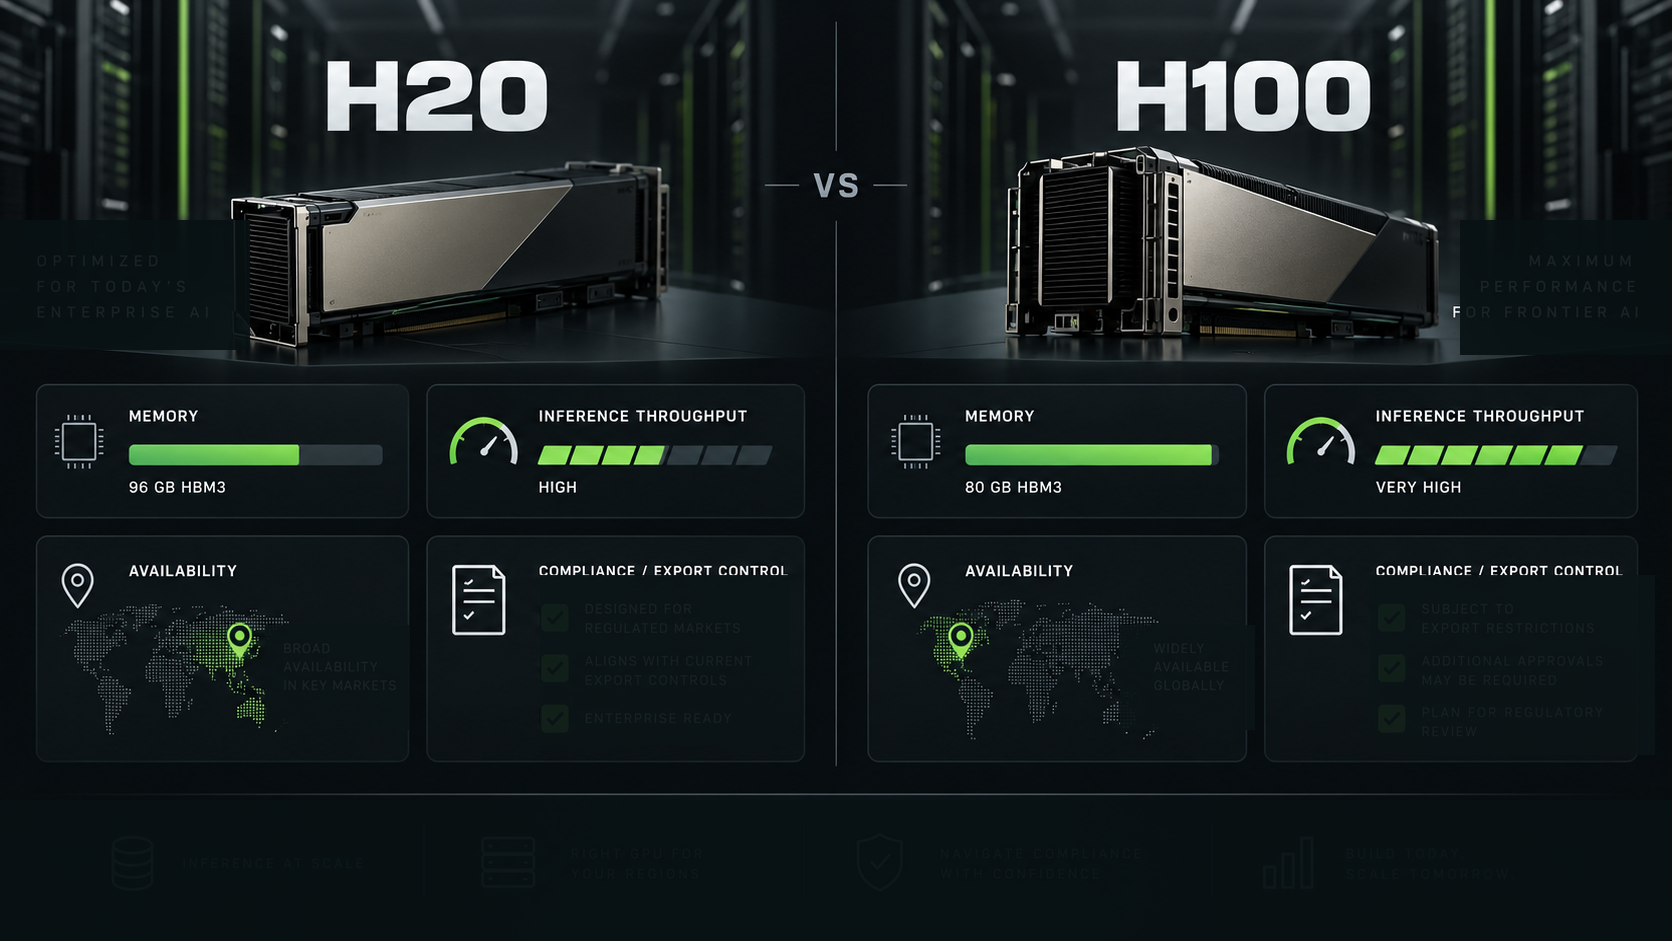
H20 と H100 を比較しているなら、要点は次のとおりです。合法的に調達でき、安定して入手でき、かつ十分に稼働させられるのであれば、H100 がより強い標準的な選択肢です。H20 が魅力的になるのは、輸出規制、中国市場での入手性、または現地調達ルールによって H100 の利用が現実的でない場合だけです。
そのため、NVIDIA H20 vs H100 は通常のスペック表比較というより、コンプライアンスを考慮したキャパシティ判断に近いものになります。H100 は、学習と推論向けとしてよく知られた Hopper GPU です。H20 は制約付きの Hopper ファミリー経路であり、調達条件が輸出ライセンス、PRC 市場ルール、ベンダー固有の SKU 可用性によって左右される場合に、購入者が評価するものです。
エンタープライズ AI チームにとって、h20 vs h100 で本当に重要なのは「どの GPU が速いか?」ではありません。重要なのは、メモリの適合性、待ち時間、コンプライアンス承認、入手性を含めた後でも、どの経路が最も低い総リスクで受け入れ可能な推論結果を提供できるかです。
H20 vs H100: すばやい答え
H100 を選ぶのは、次の場合です。
- 展開地域で輸出規制の障害なく H100 容量を調達またはレンタルできる。
- ワークロードが、学習、ファインチューニング、または高スループット推論のために成熟した Hopper ベースラインを必要とする。
- 強いソフトウェア成熟度、広いクラウドサポート、予測しやすいベンチマーク参照が必要である。
- モデルに中国向けの GPU 調達経路が不要である。
H20 を選ぶのは、次の場合のみです。
- 展開先が制限市場または顧客所在地であり、H100 が利用できない、またはライセンス取得が難しい。
- プロバイダーが、正確な H20 の SKU、メモリ容量、相互接続、ドライバーイメージ、商業条件を提示できる。
- コンプライアンス、顧客所在地、再販売、エンドユース確認が、すでに購入プロセスに組み込まれている。
- 第三者のピークスペック表に頼らず、実際の推論ワークロードをベンチマークしている。
多くのチームにとって、H20 vs H100 は、生の推論性能より先に、入手性とコンプライアンスで決まります。どちらも受け入れ可能な法的・商業的条件で利用できるなら、H100 がより安全な標準選択です。
NVIDIA H20 vs H100 で重要なスペック
NVIDIA H20 vs H100 specs の比較が難しいのは、H100 には公開製品ページがある一方で、H20 の公開データはより断片的だからです。NVIDIA の公開 H100 ページでは、H100 Tensor Core GPU が Hopper データセンター GPU として、HBM メモリオプションと公開されたピーク AI/HPC 指標を備えていることが示されています。NVIDIA AI Enterprise のドキュメントでは、Hopper vGPU サポートマトリクス内に H20 のバリアントが公開されており、H20 SXM5 の 96GB および 141GB のフレームバッファ項目が含まれています。
この表は最終見積書ではなく、調達チェックリストとして扱ってください。
| Spec area | H100 | H20 |
|---|---|---|
| Public positioning | AI、HPC、学習、推論向けの主流 Hopper データセンター GPU | 制限付き調達コンテキストで評価される Hopper ファミリーのデータセンター GPU 経路 |
| Public NVIDIA product page | Yes, H100 has a dedicated product page | 最終購入者向けの仕様確認に使われる、同等の広範な公開 H20 製品ページはない |
| Public memory signal | H100 SXM は一般に約 80GB HBM3 として評価され、H100 NVL はより大きなメモリを伴う LLM サービング用途で登場する | NVIDIA AI Enterprise の vGPU ドキュメントでは、H20 SXM5 の 96GB および 141GB のフレームバッファプロファイルが記載されている |
| Inference takeaway | 生の性能、エコシステムサポート、学習、一般的な推論における標準選択としてより強い | 正確な SKU ベンチマークでのみ評価すべき。メモリ容量は魅力的だが、コンプライアンスと入手性が支配的 |
| Procurement risk | 入手性とクラウド価格は変動するが、製品としては広くサポートされている | 輸出ライセンス、PRC 市場ルール、ベンダー固有の供給状況によって、その見積もりが利用可能かどうかが決まることがある |
nvidia h20 vs h100 specs を正しく読むには、3 つの層を分ける必要があります。
- H100 の製品ドキュメントや NVIDIA AI Enterprise の H20 サポート項目など、NVIDIA によって公開・確認された事実。
- 正確な H20 のメモリ、相互接続、ドライバー、ノード形状、リージョン、保証など、ベンダー見積もりに含まれる事実。
- tokens per second、time to first token、キュー遅延、失敗率、受理済み出力あたりのコストなど、あなたのワークロードの事実。
これらの層を 1 つの合成された「勝者」スコアに混ぜないでください。
NVIDIA H20 vs H100 performance: 推論で何が変わるか
nvidia h20 vs h100 performance では、推論を prefill と decode の 2 段階でベンチマークします。
Prefill は、プロンプト長、バッチ戦略、アテンション実装、メモリ帯域幅の影響を受けやすいです。Decode は、同時実行数、KV cache 圧迫、スケジューラ挙動、サービングスタックの効率に敏感です。ピークの tensor-core 数値だけを求める調達チームは、実際のコスト要因を見落とします。
次の場合は H100 を基準にしてください。
- 成熟した vLLM、TensorRT-LLM、SGLang、または管理 Kubernetes イメージで 7B〜70B モデルを提供している。
- 既存の H100、H200、または B200 のクラウド容量とクリーンに比較する必要がある。
- より広い H100 フリートで行ったベンチマーク作業を再利用する予定である。
- 学習またはファインチューニングが、ワークロード構成の一部として残っている。
次の場合は、実運用テストの後にのみ H20 を使ってください。
- 対象環境向けに H100 を購入、輸入、展開、または承認できない。
- H20 ノードに、品質の強制的な妥協なしでモデルとコンテキスト長を収める十分なメモリがある。
- プロバイダーが、安定したドライバー、コンテナイメージ、サービングフレームワークのサポートを証明できる。
- コンプライアンス審査で、エンドユーザー、エンドユース、地域、転送経路が受け入れられる。
実務では、H20 vs H100 は公平なラボベンチマークになることはほとんどありません。通常は「制限のない地域の H100」と「制限付き調達環境にある H20 あるいは別のローカル विकल्प」を比較しているにすぎません。だからこそ、ベンチマークには tokens per second だけでなく、法的な入手性と待ち時間も含める必要があります。
メモリ: H20 が魅力的に見える場合
メモリは、H20 について慎重な確認に値する唯一の領域です。NVIDIA AI Enterprise のドキュメントには、96GB と 141GB の framebuffer エントリを持つ H20 SXM5 vGPU プロファイルが掲載されています。これらの公開エントリは、H20 を語る際に単一の固定メモリサイズを前提にすべきではないことを示しているため有用です。
LLM 推論では、メモリは次の点に影響します。
- モデルが強い量子化なしで収まるかどうか。
- レプリカごとにどれだけの KV cache を保持できるか。
- より長いコンテキストや高い同時実行数が実用的かどうか。
- ワークロードが複数 GPU にまたがる tensor parallelism を必要とするかどうか。
- 本番プロンプトで out-of-memory の再試行がどの程度発生するか。
つまり、より大容量メモリの H20 構成は、H100 のほうが一般的なアクセラレータとして優れていても、運用上は魅力的な場合があります。ただし、メモリ容量が大きいからといって H20 が自動的に高速または低コストになるわけではありません。ノードは依然として推論ベンチマーク、入手性チェック、コンプライアンス審査、総所有コストのモデリングを通過しなければなりません。
ワークロードがメモリ律速で、H100 が入手可能な場合は、H100 と同時に H200 も比較してください。より広い H200 vs H100 の判断は、輸出制約を前提とした H20 の供給経路に頼るよりも、より明確なメモリアップグレードの道筋になることが多いです。
入手性とコンプライアンスは第一級の要件です
NVIDIA H20 vs H100 において、コンプライアンスは脚注ではありません。NVIDIA の最新の公開 SEC 提出書類では、A100、H100、H20、H200、B200、GB200 クラスの製品および関連システムに影響する一連の輸出規制が説明されています。同書類は、H100 製品が以前の中国関連規制の影響を受けたこと、H20 の中国および D:5 国向け輸出が 2025 年 4 月に許可制の対象となったこと、そしてその後のライセンスが PRC 側の制約によって H20 の制約のない販売にはつながらなかったことを述べています。
購入者にとって、これは 3 つの実務ルールを意味します。
- H20 の入手性を通常の在庫問題として扱わないこと。
- ライセンス、見積もり、マーケットプレイス掲載だけで最終顧客に十分だと仮定しないこと。
- バックアップ経路なしに H20 の容量を見積もらないこと。
H20 の見積もりを受け入れる前に、ベンダーへ次の質問をしてください。
- どの正確な H20 SKU が見積もられていますか?
- GPU を設置する国、地域、データセンター、法的主体はどこですか?
- 購入者、最終利用者、ワークロード、親会社、顧客の所在地は、いずれかの輸出管理審査の対象ですか?
- 再販売、移転、リモートアクセス、またはクラウドサービス制限は関係しますか?
- GPU は今すぐ利用可能ですか、予約済みですか、ライセンス待ちですか、輸入待ちですか、それとも将来の割り当てに依存していますか?
- 配備前にライセンス、関税、検査、または政府規則が変更された場合、どうなりますか?
- H20 が遅れた場合でも、同じワークロードを H100、H200、L40S、ローカル代替、またはモデル API で実行できますか?
そのチェックリストは、別の合成的な nvidia h20 vs h100 performance comparison よりも重要です。
H20 vs H100 vs H200
多くのチームが h20 vs h100 vs h200 を検索するのは、実際の判断が二択ではないからです。より単純に次のように考えてください。
| GPU パス | 主な標準用途 | 購入者の主な問い |
|---|---|---|
| H100 | 学習、ファインチューニング、推論向けの成熟した Hopper ベースライン | 利用可能な地域と価格で十分な容量を調達できるか? |
| H200 | メモリ重視の推論、長いコンテキスト、より大きなバッチ、メモリ律速の HPC | より大きい HBM3e メモリにより、GPU 数、シャーディング、再試行を十分に減らしてプレミアムを正当化できるか? |
| H20 | H100/H200 が簡単には調達できない制限付き調達の文脈 | この正確な H20 展開は、コンプライアンス、入手性、ワークロードのベンチマークを通過できるか? |
チームが必要としているのがモデルの出力だけなら、4 つ目の道としてマネージドモデル API を追加してください。ハードウェア所有が正当化されるのは、プライベート重み、カスタムカーネル、固定の専有容量、または低レベルのサービング制御が必要な場合です。そうでなければ、アイドル時間、キュー管理、ドライバ作業、失敗ジョブを含めると、モデル API のベースラインが GPU レンタルを上回ることがあります。
Flatkey はそのベースラインに役立ちます。1 つのキー、1 つの残高、OpenAI 互換のルーティング、使用状況の可視化、そして GPU サーバーを運用せずに多くの公式モデル API へアクセスできます。ハードウェア層を自社保有しなければならないチームに対して H20 や H100 の代わりにはなりませんが、調達に対して現実的な「そもそも GPU は必要か?」という比較を提供します。
関連する計画ガイド:
H20 vs H100 推論のベンチマークチェックリスト
購入予定の正確な展開形態で、同じワークロードを実行してください。h20 vs h100 の推論では、本番に近いプロンプトを使い、受け入れられた出力を測定します。
| 指標 | 重要な理由 |
|---|---|
| 最初のトークンまでの時間 | ユーザーに見えるレイテンシとプリフィルの挙動を捉える |
| トークン間レイテンシ | 実際の同時実行下でのデコード速度を示す |
| GPUあたりの1秒あたりトークン数 | 有用だが、利用率と受理率がなければ不完全 |
| 最大安定同時実行数 | KVキャッシュとスケジューラの圧力を明らかにする |
| 割り当て済みおよび予約済みメモリ | モデルが本番プロンプト込みで実際に収まるかを示す |
| キュー遅延 | 希少な処理能力を実際のユーザー待ち時間へと変える |
| OOMおよび再試行率 | メモリ制限をコストと信頼性への影響に変換する |
| 受理された出力あたりのコスト | GPU時間、利用率、失敗、エンジニアリング時間を正規化する |
| コンプライアンス承認時間 | H20および制限地域への展開では重要 |
| フォールバック経路 | 供給やライセンス条件が変わってもリリース時期を守る |
重要な調達指標は「H20対H100のピーク性能」ではありません。入手性、失敗試行、待ち行列、コンプライアンス審査、運用を含めた後の、完了したワークロードのコストです。
調達の意思決定マトリクス
購買会議ではこのマトリクスを使ってください。
| これが真なら | 優先するもの | 理由 |
|---|---|---|
| H100が法的に利用可能で、在庫が実在し、価格も許容範囲 | H100 | 広くサポートされる、よりクリーンなHopperのベースラインだから |
| ワークロードがメモリボトルネックで、H200が入手可能 | H200をH100と比較してテストする | メモリアップグレードは、H20を使うより直接的かもしれない |
| 制限市場を対象に展開する必要があり、H100/H200が使えない | H20とフォールバックをテストする | コンプライアンス経路がハードウェア選定を左右する可能性がある |
| モデルが小~中規模で、トラフィックがバースト的 | モデルAPIまたはサーバーレスGPU | アイドル状態の専有GPU容量を避ける |
| チームがカスタムカーネル、プライベートウェイト、継続的な利用率を必要とする | 直接GPU容量 | ハードウェアを制御できるなら、運用負荷を正当化できるかもしれない |
| 供給、ライセンス、地政学的ルールがリリース前に変わる可能性がある | 2つの経路を生かしておく | 1つの制限付きSKUに製品ロードマップを賭けない |
NVIDIA H20対H100の計画でよくあるミス
最初のミスは、H20を「単に遅いH100」とみなすことです。実際の違いは調達の文脈にあります。法務、コンプライアンス、入手性の制約でH20が必要でないなら、通常はH100を基準にした方がシンプルです。
2つ目のミスは、正確なSKUを確認せずに公開されているnvidia h20 vs h100 specsをそのまま使うことです。H20の参照値はメモリ容量や展開形態によって異なる場合があります。見積書には、GPU、メモリ、相互接続、ノード設計、ドライバーイメージ、サービス条件、リージョンを明記すべきです。
3つ目のミスはH200を無視することです。問題がH100のメモリ圧迫なら、H200の方がより自然な比較対象かもしれません。H20は、単にメモリの数値が魅力的に見えるからではなく、調達環境がその経路を強制する場合に使ってください。
4つ目のミスは、モデルAPIのベースラインを忘れることです。ワークロードが必要としているのが信頼できるモデル出力だけで、直接GPUを制御する必要がないなら、使用量追跡、フォールバック、従量課金の経済性を備えたAPIの方が簡単な場合があります。
最終推奨
H20 vs H100では、H100が利用可能で、かつ展開に適法かつコンプライアンス上問題ないならH100を選びます。多くの学習、ファインチューニング、推論の用途で、依然としてより安全なHopperのベースラインです。
H20を選ぶのは、調達環境がそれを必要とし、かつ個別のH20展開が3つのテストを通過する場合だけです。つまり、モデルが収まること、推論ベンチマークが本番相当の負荷で動作すること、コンプライアンスがエンドユーザー、リージョン、転送経路を承認できることです。
そのうえで、H200とモデルAPIのベースラインとも比較してください。勝つ経路は、最も興味深いスペック表を持つものではなく、受理された出力を確実に生成できるものです。
FAQ
推論ではH20はH100より優れていますか?
通常はいいえです。利用可能で、かつコンプライアンス上問題ないなら、H100の方が強いデフォルトです。H20が有効になるのは、調達、輸出規制、地域の入手性の制約でH100が使えない場合です。H20が良い推論代替だと決めつける前に、正確なSKUをベンチマークしてください。
NVIDIA H20とH100の主な違いは何ですか?
主な違いは調達の文脈です。H100は広くサポートされるHopperのデータセンターGPUです。H20は、輸出ライセンス、PRC市場のルール、正確なSKUの入手性、コンプライアンス審査によって、容量を実際に使えるかどうかが決まる制限付きの調達環境で評価されます。
NVIDIA H20とH100のスペックはどう比較すべきですか?
正確なSKU、メモリ、相互接続、ノード形状、ドライバーイメージ、リージョン、保証、コンプライアンス状態を比較してください。第三者のスペック表だけに頼らないでください。本番では、実際のプロンプト、目標同時実行数、受理された出力あたりのコストで検証してください。
H20 vs H100 vs H200を比較すべきですか?
はい。ワークロードがメモリボトルネックで、H200が入手可能なら、H200はH100からのより自然なアップグレードになるかもしれません。H20は、コンプライアンスや地域調達がH100/H200を妨げる場合により関連性があります。
H20やH100の代わりにモデルAPIを使うべきなのはいつですか?
カスタムカーネル、プライベートウェイト、固定された専有容量が不要なときにモデルAPIを使ってください。バースト性のある製品トラフィックでは、モデルAPIによりアイドルGPUコストと運用作業を減らしつつ、利用状況の可視性とルーティングの柔軟性を維持できます。


