
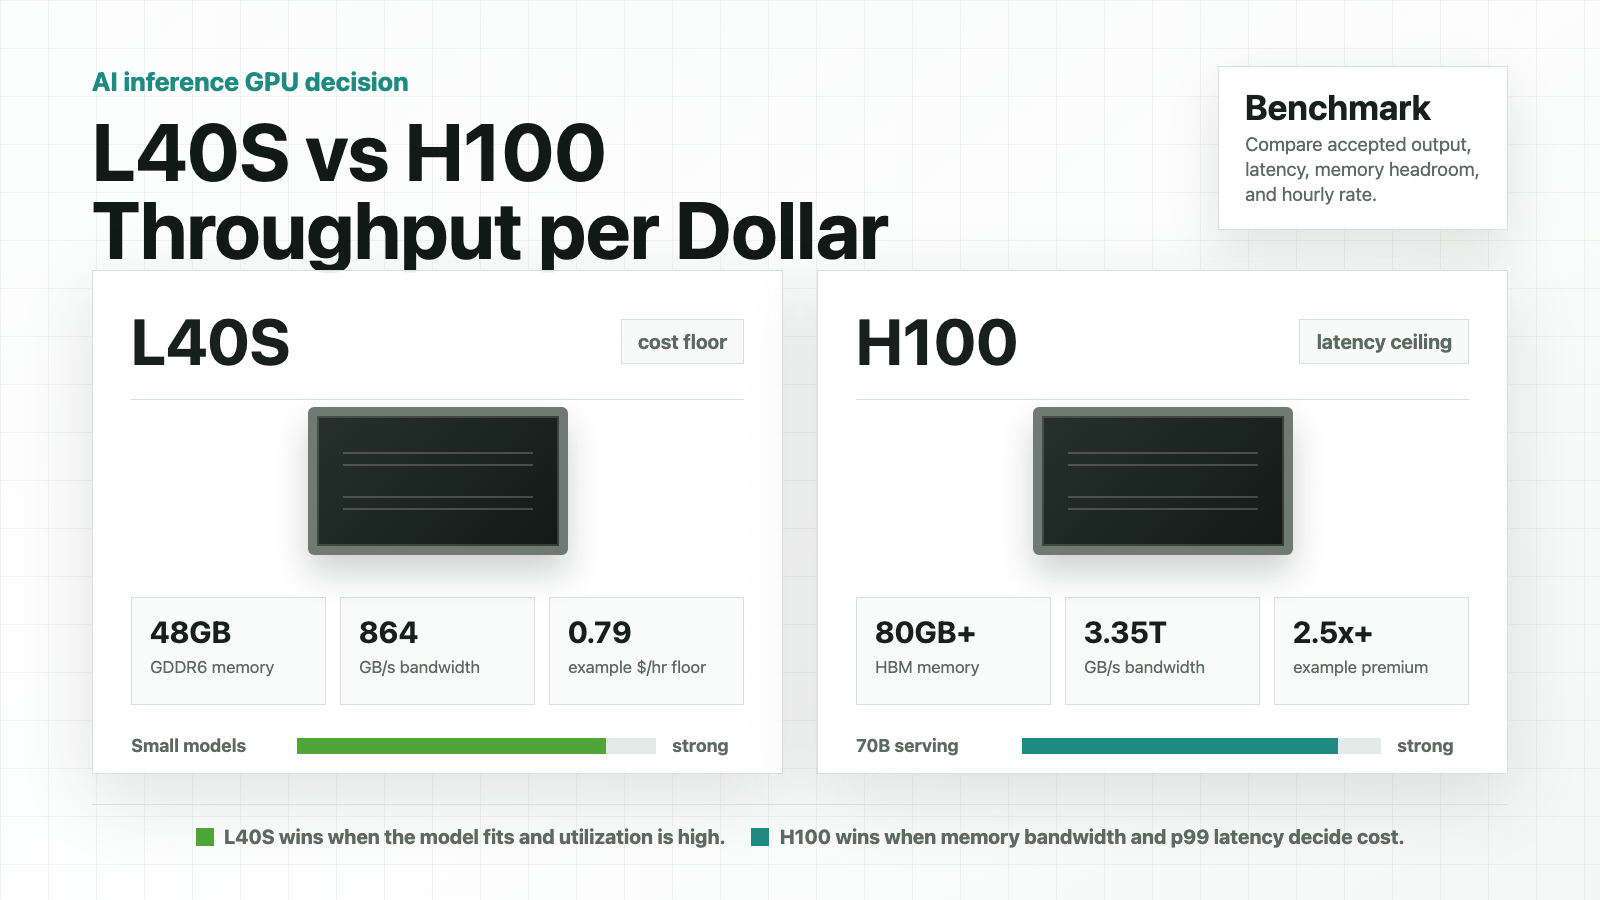
NVIDIA L40S vs H100 の AI 推論: 1ドルあたりのスループット
L40S vs H100 に対する短い答えは、「H100 のほうが速いので H100 を買うべき」というものではありません。H100 はより強力な AI アクセラレータです。モデルが 48 GB に収まり、レイテンシ要件が中程度で、プロバイダーの見積もりが大幅に低い場合は、L40S のほうが 1ドルあたりのスループット候補として優れていることがよくあります。
AI 推論チームにとって有用な問いは次のとおりです。
この特定のモデル、プロンプト構成、サービングスタック、SLA において、H100 は L40S に対する価格プレミアムを上回るだけの、1時間あたりの承認済み出力を提供できるか?
この NVIDIA L40S vs H100 比較では、メモリ適合性、prefill、decode、バッチ処理、レイテンシ、利用率、クラウド GPU 価格といった推論経済性に焦点を当てます。価格は頻繁に変動するため、以下の公開価格の行は 2026年10月12日時点で確認した例として扱い、同じワークシートを現在のプロバイダー見積もりに対して再実行してください。
L40S vs H100: クイック判断表
| 推論ワークロード | 通常は最初に選ぶ候補 | 理由 |
|---|---|---|
| 7B〜13B のチャット、社内コパイロット、軽量 RAG | L40S | レイテンシが許容範囲で、モデルが KV キャッシュの余裕を持って収まるなら、時間単価の低さで H100 を上回ることがある。 |
| 中程度のコンテキストを持つ 30B 級モデル | 両方をベンチマーク | L40S がコスト面で勝つことがあり、H100 はテールレイテンシやメモリ帯域が支配的な場合に勝つことがある。 |
| 厳格なレイテンシ要件の 70B 級サービング | H100、H100 NVL、H200、またはマルチ GPU | H100 は、HBM 帯域幅が大幅に高く、一般的な SXM/NVL 構成でより大きなメモリを備え、NVLink オプションがあり、本番サービングのサポートも強力。 |
| 緩めの SLA を持つバッチ推論 | まず L40S | キューに適したワークロードでは、稼働率を高く維持できるなら、より安価なキャパシティを使える。 |
| 長文コンテキストの RAG | まず H100 | prefill と KV キャッシュへの圧力は、通常 HBM 帯域幅とより大きなメモリに有利に働く。 |
| マルチテナント基盤 | MIG が重要なら H100 | NVIDIA は H100 に MIG サポートを記載しているが、L40S には MIG サポートを記載していない。 |
| レンダリング、画像/動画、またはグラフィックスを伴うマルチモーダルワークロード | L40S は魅力的になり得る | L40S は、AI、グラフィックス、レンダリング、メディア加速向けのユニバーサル GPU として NVIDIA に位置づけられている。 |
| 高同時実行の顧客向け LLM API | まず H100 | テールレイテンシ、バッチ処理の余裕、ソフトウェア最適化が、しばしばプレミアムを正当化する。 |
実務上のルールは、コスト下限が重要で、ワークロードがきれいに収まるなら L40S を選ぶこと。レイテンシ、帯域幅、同時実行、シャーディングの単純さ、またはマルチ GPU トポロジーが収益や信頼性に影響するなら H100 を選ぶことです。
主要スペックの違い
NVIDIA は L40S を、生成 AI、LLM 推論と学習、3D グラフィックス、レンダリング、動画向けの Ada Lovelace データセンター GPU と位置づけています。NVIDIA の L40S 仕様には、48 GB の GDDR6 ECC メモリ、864 GB/s のメモリ帯域幅、PCIe Gen4 x16、350W の最大電力、第4世代 Tensor Cores、FP8 対応、MIG なし、NVLink 非対応が記載されています。NVIDIA は H100 を、大規模 AI と HPC 向けの Hopper データセンター GPU と位置づけており、専用の Transformer Engine、第4世代 NVLink、MIG、HBM メモリを備えています。NVIDIA の H100 製品仕様では、H100 SXM は 80 GB メモリ、3.35 TB/s 帯域幅、最大 7 の MIG インスタンス、900 GB/s の NVLink、最大 700W の構成可能 TDP と記載されており、H100 NVL は GPU あたり 94 GB、3.9 TB/s 帯域幅、600 GB/s の NVLink と記載されています。出典: NVIDIA L40S および NVIDIA H100。
| 領域 | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | 購入者への示唆 |
|---|---|---|---|
| アーキテクチャ | Ada Lovelace | Hopper | H100 は AI/HPC アクセラレータ世代の旗艦であり、L40S はユニバーサルなデータセンター GPU です。 |
| メモリ | 48 GB GDDR6 ECC | H100 SXM は 80 GB HBM、H100 NVL は 94 GB HBM | H100 は、より大きなモデル、より長いコンテキスト、より高い同時実行に対応しやすい。 |
| メモリ帯域幅 | 864 GB/s | H100 SXM は 3.35 TB/s、H100 NVL は 3.9 TB/s | H100 は、帯域幅に制約される prefill、decode、KV キャッシュ移動で大きな優位性がある。 |
| スパース性ありの FP8 Tensor Core ピーク | 1,466 TFLOPS | H100 SXM は 3,958 TFLOPS、H100 NVL は 3,341 TFLOPS | サービングスタックと精度ポリシーが FP8 を使えるなら、H100 の上限ははるかに高い。 |
| 相互接続 | PCIe Gen4 x16、NVLink なし | PCIe Gen5 と SXM/NVL 構成での NVLink | H100 はスケールアップおよびマルチ GPU 推論に強い。 |
| MIG | なし | 最大 7 の MIG インスタンス | 利用率や分離のためにハードウェア分割が必要なら H100 が適している。 |
| 最大電力 | 350W | SXM では最大 700W、NVL では 350〜400W | L40S は低消費電力サーバーに載せやすく、H100 は GPU あたりより多くの仕事をこなせる。 |
これらの仕様は、一般的な L40S vs H100 benchmark が調達判断を誤らせる理由を説明しています。H100 は技術的な上限が高い一方で、L40S は H100 の価格が数倍高く、かつアプリケーションがその上限を使い切らない場合に、依然として勝つことがあります。
1ドルあたりのスループットの式
推論では、理論上の FLOPS ではなく、承認済み出力を比較します。
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
次に、隠れたコストも含めます:
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
損益分岐のルールはシンプルです:
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
H100 のコストが L40S の 3 倍なら、低レイテンシによるビジネス価値を考慮する前に、H100 は 1 時間あたりの受理済み出力で 3 倍超を達成しなければ、スループットあたりのコストで勝てません。H100 のコストが 1.8 倍なら、そのハードルは下がります。L40S が OOM リトライ、低いバッチサイズ、または p99 レイテンシの未達を引き起こすなら、安い時間単価が安いサービスとは限りません。
より広い隠れコストのワークシートについては、Flatkey の GPU rental prices ガイドを参照してください。
2026年10月12日に確認した公開価格の例
公開 GPU 価格は恒久的な料金表ではありません。提供事業者、リージョン、可用性、セキュリティ階層、予約、課金単位、そしてその容量がマーケットプレイスなのか、専有なのか、オンデマンドなのか、コミット済みなのかによって変わります。
| Provider page | L40S example | H100 example | What it shows |
|---|---|---|---|
| RunPod pricing | L40S: Community Cloud $0.79/hr, Secure Cloud $1.09/hr | H100 PCIe: Community Cloud $1.99/hr, Secure Cloud $2.89/hr; H100 SXM: Community Cloud $2.69/hr, Secure Cloud $3.49/hr; H100 NVL: Community Cloud $2.59/hr, Secure Cloud $3.19/hr | 直接引用の行を見ると、隠れコストを含める前でも H100 は L40S の時間単価の約 2.5 倍から 3.4 倍になることがあります。 |
| Lambda pricing | この記事用に確認した公開価格の HTML では、L40S の直接の行は見つかりませんでした | H100 の行は、H100 SXM および H100 PCIe の例を含め、セルフサービスとクラスタ構成全体で公開されています | 提供範囲は事業者ごとに異なります。すべての GPU 候補がすべてのベンダーで使えるとは限りません。 |
RunPod Community Cloud の例では、損益分岐のスピードアップは次のようになります:
| Comparison | H100 price | L40S price | H100 price premium | Break-even meaning |
|---|---|---|---|---|
| H100 PCIe vs L40S | $1.99/hr | $0.79/hr | 2.52x | H100 PCIe は、単純な GPU レンタル料で勝つには、1 時間あたりの受理済み出力が 2.52 倍超必要です。 |
| H100 SXM vs L40S | $2.69/hr | $0.79/hr | 3.41x | H100 SXM は、その上乗せを正当化するには、大きなスループット向上か、レイテンシ/ビジネス上の理由が必要です。 |
| H100 NVL vs L40S | $2.59/hr | $0.79/hr | 3.28x | H100 NVL は、ワークロード内でそのメモリ/相互接続の優位性が効いてくる必要があります。 |
| Secure H100 SXM vs Secure L40S | $3.49/hr | $1.09/hr | 3.20x | セキュア容量は絶対的な料金を変えますが、損益分岐の考え方は同じです。 |
これらの行を普遍的な真実として使わないでください。計算の意味を理解するために使ってください。見積もりが変われば、NVIDIA L40S vs H100 inference performance の判断も変わります。
L40S が勝つ場面
ワークロードがコスト重視で、かつ技術的に収まりがよい場合、L40S は通常、最初のベンチマーク候補として最適です:
- モデルが 7B、8B、13B、または 48 GB に KV-cache の余裕を持って収まる量子化済みの 30B 級ルートである。
- トラフィックがバッチ指向、非同期、社内向け、または高い p95 レイテンシに寛容である。
- 即時応答のために過剰プロビジョニングするのではなく、キューで L40S の稼働率を維持できる。
- レンダリング、メディア、画像生成、または混在したクリエイティブワークロードにも対応できる汎用 GPU が必要である。
- ベンダー見積もり上、H100 が 2.5 倍から 4 倍高い。
- サービングフレームワークで、現実的なプロンプトに対して許容できる p95/p99 レイテンシが示されている。
L40S は、初期の推論製品を構築しているチームにも魅力的です。モデル選定、プロンプトの形、トラフィックがまだ変化している段階では、低コスト GPU により、実際の需要データを集めながら試行錯誤を安く行えます。
H100 が勝つ場面
レイテンシ、同時実行数、メモリ帯域、または大規模モデルのサービングが費用を左右する場合、H100 は通常、最初のベンチマーク候補として最適です:
- 長文コンテキストの RAG は prefill と KV-cache の移動に負荷をかける。
- p95 または p99 のレイテンシが、コンバージョン、定着率、またはサポート負荷に影響する。
- モデルが十分に大きく、L40S の 48 GB では強い量子化、小さなバッチサイズ、またはテンソル並列が必要になる。
- マルチテナント分離または高い稼働率のために MIG が必要である。
- 70B 級推論のために NVLink、NVSwitch、または H100 NVL 風のスケーリングが必要である。
- 品質低下なしに FP8 または Hopper 最適化カーネルを活用できるスタックである。
- GPU 台数の削減が時間単価の上乗せを相殺する。
H100 はピーク性能だけの話ではありません。1 台の H100 が複数の下位 GPU を置き換え、モデルのシャーディングを回避し、テールレイテンシを SLA 内に収めることで、本番運用を簡素化できることもあります。
勝敗を変えるワークロードの詳細
最もよくある NVIDIA L40S vs H100 performance comparison の間違いは、1 つのプロンプト長と 1 つの同時実行レベルだけをテストすることです。LLM のサービングには異なるボトルネックがあります:
| ワークロードの次元 | 重要な理由 |
|---|---|
| モデルサイズ | 7B モデルと 70B モデルでは、メモリ、帯域幅、または相互接続への負荷が同じではありません。 |
| 精度と量子化 | FP8、FP16、BF16、INT8、AWQ、GPTQ、その他の経路は、品質とスループットの両方を変えます。 |
| コンテキスト長 | 長いプロンプトでは、コストがプレフィルと KV キャッシュの圧迫により大きくなります。 |
| 出力長 | 長い回答では、コストがデコードのスループットとスケジューリングにより大きくなります。 |
| 同時実行数 | バッチサイズ 1 で優位な GPU でも、実際のトラフィックでは負けることがあります。 |
| 受理率 | 失敗、タイムアウト、または低品質の出力は、生産的なスループットとしてはカウントされません。 |
| 提供フレームワーク | vLLM、SGLang、TensorRT-LLM、NVIDIA NIM、そしてカスタムサーバーには、それぞれ異なる最適化経路があります。 |
| プロバイダーの形状 | CPU、RAM、ローカル NVMe、ネットワーク、起動時間、そして noisy-neighbor リスクは、安価な GPU リストよりも支配的になることがあります。 |
同時に提供スタックを選ぶ場合は、Flatkey の vLLM vs SGLang ガイドが、スループット、レイテンシ、モデルサポート、運用を測定するための別のフレームワークを提供します。
L40S vs H100 推論のベンチマーク計画
L40S と H100 で同じリプレイを実行します。受け入れ基準は固定してください。
| 手順 | 測定するもの | 理由 |
|---|---|---|
| 1. ワークロードを固定する | モデル ID、量子化、コンテキスト分布、出力上限、品質チェック | 見せかけの apples-to-apples 結果を防ぎます。 |
| 2. 提供スタックを固定する | vLLM、SGLang、TensorRT-LLM、NIM、CUDA、ドライバー、コンテナイメージ | ソフトウェア変更によってハードウェアの効果が隠れることがあります。 |
| 3. 同時実行の段階を実行する | 1、4、8、16、32、64、または実際のトラフィックパターン | 各 GPU がいつ飽和するかを示します。 |
| 4. プレフィルとデコードを分ける | 最初のトークンまでの時間、プロンプトトークン/秒、出力トークン/秒 | 帯域幅とデコードのどちらがボトルネックかを明らかにします。 |
| 5. テールレイテンシを追跡する | p50、p95、p99、キュー待ち時間、タイムアウト率 | 購入判断ではユーザー体験を守るべきです。 |
| 6. 使用率を追跡する | GPU 使用率、使用メモリ、HBM/GDDR 帯域圧迫、CPU 待機、ストレージ待機 | GPU が実際のボトルネックであることを確認します。 |
| 7. 失敗を数える | OOM、エビクション、不良ホスト、コールドスタート、リトライストーム | 失敗した作業は、受理済み出力あたりのコストに含めるべきです。 |
| 8. 受理済みコストを計算する | 受理済み出力トークン 100 万あたりのコスト、受理済み応答あたりのコスト、または完了ジョブあたりのコスト | 調達に必要なのは正規化されたコストであり、ベンチマークのスクリーンショットではありません。 |
最小リプレイ:
100 個の短いプロンプト
100 個の中程度のプロンプト
100 個の長文コンテキストプロンプト
同じモデル
同じ精度または量子化ポリシー
同じ最大出力トークン数
同じサーバーバージョン
同じ同時実行の段階
同じ品質および受理チェック
判断表:
| 指標 | L40S の結果 | H100 の結果 |
|---|---|---|
| GPU 時間単価 | ||
| 実効時間当たりコスト | ||
| 受理済み応答数/時 | ||
| 受理済み出力トークン数/時 | ||
| 受理済み出力トークン 100 万あたりのコスト | ||
| 最初のトークンまでの時間 p95 | ||
| エンドツーエンドレイテンシ p95/p99 | ||
| OOM またはリトライ率 | ||
| 平均 GPU 使用率 | ||
| 運用メモ |
これは、実際の L40S vs H100 ベンチマーク における価値指標です。勝者は、製品が求めるレイテンシと信頼性のレベルで、受理済みコストがより低い GPU です。
調達チェックリスト
どちらの GPU もレンタルまたは購入する前に、以下を確認してください:
- 正確な SKU: L40S、H100 PCIe、H100 SXM、H100 NVL、メモリ容量、およびフォームファクター。
- ノード構成: GPU 数、CPU、RAM、ローカル NVMe、ネットワーク、および GPU が強力な相互接続を共有しているかどうか。
- 課金単位: 秒、分、時、月、または契約期間。
- 容量モード: マーケットプレイス、セキュアクラウド、専有、予約、スポット、またはクラスタ。
- 中断および置換ポリシー。
- リージョン、コンプライアンス、テナンシー、データ処理要件。
- ストレージおよびスナップショットの価格。
- エグレスおよび帯域幅ポリシー。
- ドライバー、CUDA、コンテナ、および提供フレームワークのサポート。
- 可観測性: 使用率、メモリ、キューイング、p95/p99、OOM、リトライ、ルートごとのコスト。
- サポート SLA とエスカレーション経路。
より広いクラスタレベルのチェックリストについては、Flatkey の GPU クラスタレンタルガイド を参照してください。
モデル API がどちらの GPU よりも優れる場合
L40S vs H100 への正しい答えは、「どちらでもない」こともあります。GPU をレンタルするのが適しているのは、独自の重み、持続的な使用率、厳格なレイテンシ制御、カスタムカーネル、データ局所性要件、または推論インフラを運用できるチームがある場合です。
次のような場合は、モデル API またはルーターを使用してください:
- トラフィックはバースト的です。
- モデルの選択は頻繁に変わります。
- プロバイダー間でフォールバックが必要です。
- 独自の重みをホストする必要はありません。
- アイドル状態のGPU時間が、APIプレミアムを上回ってしまいます。
- 財務部門には、リクエスト単位の使用記録、サブキーごとの予算、請求書、コスト配賦が必要です。
Flatkey はその判断軸に適しています。1つのキー、1つの残高、1通の請求書、公式モデルエンドポイント、そしてモデルルート全体にわたるリクエスト単位の使用記録を提供します。長期的なGPU容量を確保する前に、専用のL40SまたはH100のコストを、受理されたトークンあたりでマネージドなモデルルートと比較してください。
関連するコスト検討については、Flatkey の LLM推論に最適なGPU、H100 vs A100、H200 vs H100、AIモデル価格比較、および AI API支出管理 のガイドをご覧ください。
最終推奨
ほとんどの独立開発者や小規模AIチームが L40S vs H100 を比較する場合、次のルールから始めてください。
- モデルが収まり、レイテンシーが中程度で、トラフィックをキューにでき、H100の時間単価がL40Sの2倍から3倍を超えるなら、L40S を選びます。
- メモリ帯域幅、より大きなメモリ、NVLink、MIG、高い同時実行性、長いコンテキスト、または p95/p99 レイテンシーが製品成果を左右するなら、H100 を選びます。
- ワークロードが30Bクラス、混合コンテキスト、または48 GBのメモリ境界に近い場合は、両方をベンチマークします。
- 利用率が不確実な場合やモデル選択が頻繁に変わる場合は、両方をマネージドモデルAPIと比較します。
最も強い NVIDIA L40S vs H100 の性能 の判断は、一般的なベンチマークの勝者ではありません。レイテンシーと信頼性の目標を満たしながら、受理された出力あたりのコストが最も低いGPUです。
L40S vs H100 に関するよくある質問
AI推論ではH100はL40Sより速いですか?
はい。H100 は、特にメモリ帯域幅、FP8スループット、より大きなメモリ、NVLink、Hopper最適化のサービングが重要な場合、AI推論においてはるかに高い技術的上限を持ちます。とはいえ、ワークロードが収まり、H100 の時間単価プレミアムが高すぎる場合は、L40S がスループット/ドルで勝つこともあります。
L40S は LLM 推論に適していますか?
はい。NVIDIA は L40S を生成AIおよび LLM 推論/学習向けに位置づけており、48 GB の GDDR6 ECC メモリに加えて、FP8 をサポートする第4世代 Tensor Core を搭載しています。より小規模から中規模のモデル、バッチ推論、AI/グラフィックス混在ワークロード、コスト重視のサービングで最も強みを発揮します。
70Bモデルには L40S と H100 のどちらを使うべきですか?
70Bクラスの本番推論では、特に長いコンテキストや厳しいレイテンシー要件がある場合、H100、H100 NVL、H200、またはマルチGPU構成から始めてください。L40S は制約付きまたは量子化した実験には使えるかもしれませんが、48 GB のメモリは同時実行性と KV キャッシュの余裕を制限する可能性があります。
L40S vs H100 で最適な指標は何ですか?
目標レイテンシーでの受理された出力あたりのコストを使ってください。1時間あたりの受理された出力トークン数、1時間あたりの受理されたレスポンス数、p95/p99 レイテンシー、再試行率、OOM率、利用率、実効時間単価を追跡します。
L40S vs H100 のベンチマークだけで容量を購入してよいですか?
ベンチマークが、実際のプロンプト構成、コンテキスト長、出力長、同時実行性、品質チェック、プロバイダー環境を再現している場合に限ります。一般的な tokens/sec の結果は有用ですが、それ自体で購入判断にはなりません。


