Руководство по выбору AI GPU: подберите подходящий GPU для обучения и инференса
Руководство по выбору AI GPU должно начинаться с рабочей нагрузки, а не с названия новейшего ускорителя. Обучение, дообучение, пакетный инференс, инференс в реальном времени, пайплайны поиска, генерация медиа и задачи оценки по-разному нагружают GPU. Неподходящий GPU может выглядеть привлекательно в прайс-листе и все равно проиграть, если учесть соответствие по памяти, сетевую топологию, простои, очереди, работу стеков обслуживания и качество принятого результата.
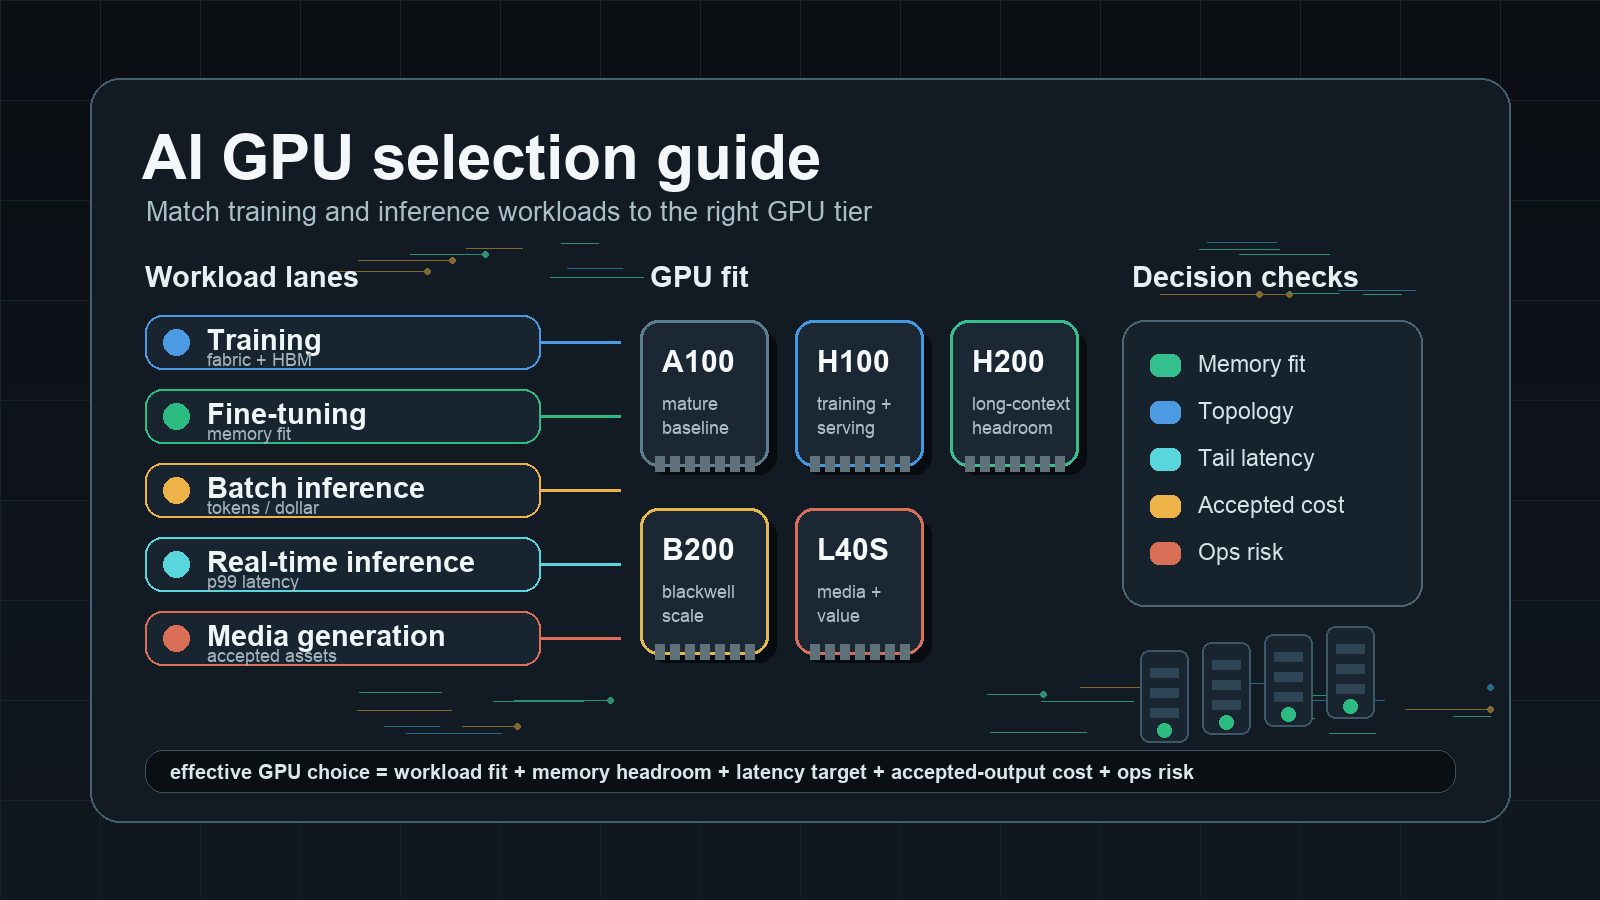
Используйте это руководство по выбору AI GPU как чек-лист для закупок и архитектуры. Оно сопоставляет распространенные AI-нагрузки с важными характеристиками GPU, объясняет, когда имеют смысл H100, H200, B200, A100, L40S, системы класса GB200 и локальные GPU класса RTX, а также предлагает план бенчмаркинга, который привязывает решение о покупке к завершенной работе, а не к синтетическим пиковым цифрам.
Практическое правило Flatkey: выбирайте GPU по стоимости одного завершенного прогона обучения, стоимости одного принятого токена, стоимости одного принятого изображения или видео и по операционному риску, который вы готовы на себя взять. Если вам нужен только доступ к модели, управление, резервный вариант и единый журнал использования, сравните аренду GPU с маршрутами через модель/API, прежде чем инвестировать в оборудование.
Краткий ответ в руководстве по выбору AI GPU
Начните с этой матрицы, прежде чем сравнивать предложения провайдеров.
| Нагрузка | Обычно в приоритете | Направление по GPU | На что обратить внимание |
|---|---|---|---|
| Предобучение или крупномасштабное обучение | Многоузловая сеть, объем HBM, пропускная способность памяти, производительность BF16/FP8, I/O контрольных точек | H100/H200, системы класса B200/GB200, управляемые кластеры для обучения | Почасовая цена вторична по сравнению со временем завершения прогона и риском перезапуска |
| Полное дообучение | Запас по памяти, вместимость состояний оптимизатора, тензорный параллелизм, локальность хранилища | H100, H200, B200, A100 для меньших моделей | Нехватка VRAM может вынудить перейти на более медленное шардинг-разбиение или меньшие размеры батча |
| Дообучение LoRA/QLoRA | Соответствие VRAM, совместимость с CUDA, производительность на доллар | A100, L40S, H100, H200, высокопроизводительные локальные GPU для небольших задач | Набор данных и длина контекста могут изменить ответ по памяти |
| Пакетный инференс LLM | Соответствие по памяти, эффективность батчинга, токенов на доллар, терпимость к очереди | L40S, A100, H100, H200, B200 в зависимости от размера модели | Низкая загрузка может свести на нет более дешевые тарифы на GPU |
| Инференс LLM в реальном времени | Задержка p95/p99, емкость KV-кэша, стабильность стриминга, поддержка фреймворка обслуживания | H100/H200/B200 для больших моделей или моделей с длинным контекстом; L40S/A100 для меньших моделей | Хвостовая задержка и повторные попытки важнее пиковых токенов/с |
| Эмбеддинги и reranking | Пропускная способность на доллар, баланс CPU/GPU, размер батча, простота сервиса | L40S, A100, меньшие облачные GPU, иногда CPU при низком объеме | Избыточность GPU очень распространена при низком трафике |
| Генерация изображений и видео | VRAM, медиакернелы, пропускная способность хранилища, терпимость к очереди | L40S, H100/H200/B200 для более тяжелых пайплайнов, локальные рабочие станции класса RTX для создателей | Итоговая стоимость принятого изображения/клипа важнее сырой скорости рендера |
| Оценка и синтетические данные | Пиковая емкость, контроль затрат, разнообразие моделей | Spot/marketplace GPU, пакетные API или маршруты через модель/API | Избегайте владения простаивающей мощностью ради редких всплесков |
Краткий ответ намеренно не звучит как «купите самый быстрый GPU». Для enterprise-команд по AI лучший GPU — это тот, который соответствует модели, длине контекста, целевой задержке, конкуренции запросов, границе данных и операционной модели команды.
Шаг 1: классифицируйте рабочую нагрузку
Первый шаг в любом руководстве по выбору AI GPU — классификация рабочей нагрузки. Без этого любое последующее сравнение сводится к общему спору об ускорителях.
Любое обсуждение GPU должно начинаться с краткого описания нагрузки. Зафиксируйте его письменно, прежде чем запрашивать коммерческие предложения у провайдеров.
| Поле | Что нужно зафиксировать |
|---|---|
| Тип нагрузки | Обучение, дообучение, пакетный инференс, онлайн-инференс, генерация медиа, эмбеддинги, оценка или ноутбуки |
| Форма модели | Количество параметров, архитектура, точность, квантизация, размер окна контекста, модальность и поведение токенизатора |
| Форма запроса | Среднее и p95 число входных токенов, выходных токенов, размер изображения, длина видео, размер батча, число одновременных сессий или записей на задачу |
| Единица успеха | Завершенный прогон обучения, принятый патч, принятый ответ, принятый токен, принятое изображение, принятый клип или принятая запись |
| Целевой показатель задержки | Офлайн, минуты, секунды, меньше секунды, требование p95/p99 или требование стриминга |
| Режим работы | Постоянно включено, запланированный batch, сезонный всплеск, эксперимент или ноутбук разработчика |
| Операционная граница | Публичное облако, частная сеть, выделенный кластер, on-prem, локализация данных или управляемый API |
| Инструменты | vLLM, SGLang, TensorRT-LLM, Triton, Ray, Slurm, Kubernetes, ComfyUI или управляемые провайдером endpoints |
Если вы не можете заполнить эту таблицу, приостановите выбор GPU. Вы все еще покупаете возможность, а не мощность.
Шаг 2: выберите правильную метрику для принятия решения
Второй шаг в руководстве по выбору AI GPU — выбрать знаменатель. Хороший знаменатель связывает решение по GPU с завершенной работой, а не с листом спецификаций вендора.
Пиковые FLOPS, количество Tensor Core и почасовая цена GPU — полезные входные данные, но это не метрика для принятия решения. Используйте знаменатель, привязанный к бизнес-результату.
| Нагрузка | Лучшая метрика |
|---|---|
| Обучение | Стоимость одного завершённого цикла обучения, достигшего целевого eval score |
| Fine-tuning | Стоимость одного принятого fine-tuned checkpoint |
| Онлайн-инференс | Стоимость одного принятого ответа при целевом p95/p99 latency |
| Batch inference | Стоимость одной принятой записи или одного принятого output token |
| Code agents | Стоимость одной принятой задачи, принятого патча или решённого issue |
| Генерация изображений | Стоимость одного принятого изображения после quality filters |
| Генерация видео | Стоимость одной принятой секунды или одного принятого клипа |
| Оценка | Стоимость одного завершённого eval suite и время до ответа |
Используйте эту базовую формулу:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
Для обучения:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
Для инференса:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
Именно здесь выбор GPU меняется. GPU, который выигрывает по benchmark пропускной способности, может проиграть, если требует дорогой топологии, работает при низкой загрузке, не попадает в целевой latency или вынуждает к дополнительным операционным затратам.
Выбор GPU для обучения
Для обучения руководство по выбору AI GPU должно вести себя как руководство по кластеру. Отдельный GPU важен, но размещение, interconnect, storage и поведение при перезапуске часто определяют стоимость завершённого цикла.
Для обучения нужны большой объём памяти, высокая пропускная способность памяти, высокоскоростная сеть GPU-to-GPU, стабильное размещение в multi-node и надёжность checkpointing. Оно менее терпимо, чем инференс, потому что отказ узла может привести к потере часов или дней вычислений.
Что важнее всего для обучения
- Ёмкость HBM: параметры модели, градиенты, состояния optimizer, activations, длина sequence и batch size — всё это конкурирует за память.
- Пропускная способность памяти: крупные матричные операции и шаги optimizer могут упираться в bandwidth.
- Interconnect: NVLink, NVSwitch, InfiniBand, RoCE, EFA или AI fabric от провайдера могут определять, будет ли масштабирование эффективным.
- Поддержка precision: BF16, FP8 и более новые низкоточные пути важны только если ваш framework и recipe модели используют их безопасно.
- Storage и checkpoint I/O: время записи checkpoint и время восстановления входят в стоимость завершённого цикла.
- Надёжность размещения: правильные GPU, разбросанные по слабой fabric, — это не то же самое, что целостный training cluster.
Направление выбора GPU для обучения
Используйте H100 или H200, когда вам нужна проверенная поддержка обучения уровня Hopper и широкая зрелость frameworks. H200 добавляет больше ёмкости HBM и bandwidth, чем H100, что полезно для memory-heavy обучения и fine-tuning. Используйте системы класса B200 или GB200, когда нагрузка может выиграть от throughput уровня Blackwell, путей более низкой точности, и когда провайдер действительно может обеспечить нужную topology, поддержку framework и acceptance tests. Используйте A100, когда модель меньше, recipe обучения зрелый, бюджет ограничен или доступность важнее пиковых характеристик.
Не выбирайте GPU для обучения по одному benchmark. Запустите ваш точный recipe или близкий proxy. Измеряйте время до достижения целевого eval score, поведение при перезапуске, время checkpoint и общую стоимость. Решения H100 vs A100 и H200 vs H100 обычно принимаются по стоимости завершённого цикла, а не по почасовой ставке.
Полезные сопутствующие материалы: H100 vs A100, H200 vs H100, B200 vs H200 и B300 vs B200.
Выбор GPU для Fine-Tuning
Fine-tuning находится между обучением и инференсом. Полный fine-tuning ведёт себя как обучение, тогда как LoRA и QLoRA могут уместиться на более компактном оборудовании, если контролировать размер модели, длину context, batch size и precision.
Полный fine-tuning
Для полного fine-tuning в первую очередь приоритизируйте память и topology. GPU должен либо вмещать training state, либо эффективно shard'ить его. H100, H200, B200 и multi-GPU кластеры A100 — распространённые направления в зависимости от размера модели и бюджета. GPU классов H200 и B200 могут снизить давление sharding для memory-heavy задач, но только если стек провайдера и версия framework готовы.
Вопросы, которые стоит задать:
- Какую самую большую модель и длину context вы должны fine-tune?
- Состояния optimizer полностью загружаются, shard'ятся, offload'ятся или quantized?
- Нужны ли задаче tensor parallelism, pipeline parallelism, FSDP, DeepSpeed или другой distributed approach?
- Находится ли dataset локально в регионе GPU?
- Насколько дорогой будет неудачный checkpoint?
Адаптерное дообучение
Для LoRA, QLoRA, instruction tuning и меньшей domain adaptation ответ может быть более гибким. A100, L40S, H100, H200 и локальные GPU класса RTX могут подходить для разных частей workflow. Риск в том, чтобы предположить, что небольшой demo означает, что production-задача тоже поместится. Более длинные context, больший batch size, больше примеров и validation runs могут перевести задачу в другой класс.
Это хорошее место, чтобы провести двухэтапный бенчмарк: сначала подтвердить, что объем памяти подходит, а затем подтвердить время до контрольной точки и стоимость на одну принятую дообученную модель.
Выбор GPU для инференса LLM
Для инференса руководство по выбору AI GPU должно отделять соответствие по памяти от соответствия по задержке. GPU может загрузить модель и при этом не уложиться в production p99 target.
Инференс — это не одна рабочая нагрузка. Правильный GPU меняется в зависимости от размера модели, длины контекста, конкуррентности, целевой задержки и того, являются ли запросы пакетными или выполняются в реальном времени.
Сначала — соответствие по памяти
Для инференса LLM память GPU должна вмещать веса модели и KV cache с достаточным запасом для serving framework. Длинный контекст и высокая конкуррентность могут сделать KV cache основным фактором давления на память. GPU, который подходит для одной версии модели для одного пользователя, может не подойти при production concurrency.
Используйте этот чек-лист:
- Размер весов при вашей точности: FP16, BF16, FP8, INT8, INT4 или другой квантованный формат.
- Окно контекста и ожидаемая p95 длина входа.
- Длина вывода и поведение потоковой передачи.
- Конкурентные сессии и размер батча.
- Стратегия KV cache, prefix cache и поведение при вытеснении.
- Накладные расходы serving framework.
- Запас безопасности на пики и фрагментацию.
Если памяти впритык, GPU с большим объемом памяти может оказаться лучше теоретически более быстрого GPU с меньшим объемом памяти, потому что он позволяет избежать шардирования, offload или более низкокачественной квантизации.
Инференс в реальном времени
Инференс в реальном времени важнее оценивает p95 и p99 latency, а не только средний throughput. GPU классов H100, H200 и B200 обычно лучше подходят для крупных моделей, длинного контекста и нагрузок, чувствительных к задержке. L40S и A100 могут быть экономически эффективны для меньших моделей, более низкой конкуррентности или нагрузок, где требования к p99 менее строгие.
Измеряйте:
- Время до первого токена.
- Задержку между токенами.
- End-to-end latency p95/p99.
- Токенов в секунду на один GPU.
- Принятых токенов на доллар.
- Частоту ошибок при всплесках трафика.
- Амплификацию повторных попыток при rate limits, OOM или деплоях.
Для выбора serving stack используйте vLLM vs SGLang и руководство по развертыванию vLLM.
Пакетный инференс
Пакетный инференс может обменивать задержку на throughput. Это открывает больше вариантов GPU. L40S, A100, H100, H200 и B200 могут быть уместны, если модель помещается и загрузка высока. Ключевая метрика обычно — количество принятых результатов на доллар за окно batch.
Пакетные нагрузки также хорошо подходят для spot, резервированных окон или serverless GPU capacity, когда поведение повторных попыток находится под контролем. Если тот же batch можно отправить в model API с меньшей операционной нагрузкой, сравните оба пути с помощью таблицы GPU cloud vs model API.
Выбор GPU для генерации медиа
Генерация изображений и видео часто ведет себя иначе, чем текстовый инференс. VRAM, сложность pipeline модели, I/O хранилища и терпимость к очередям имеют большее значение, чем conversational latency.
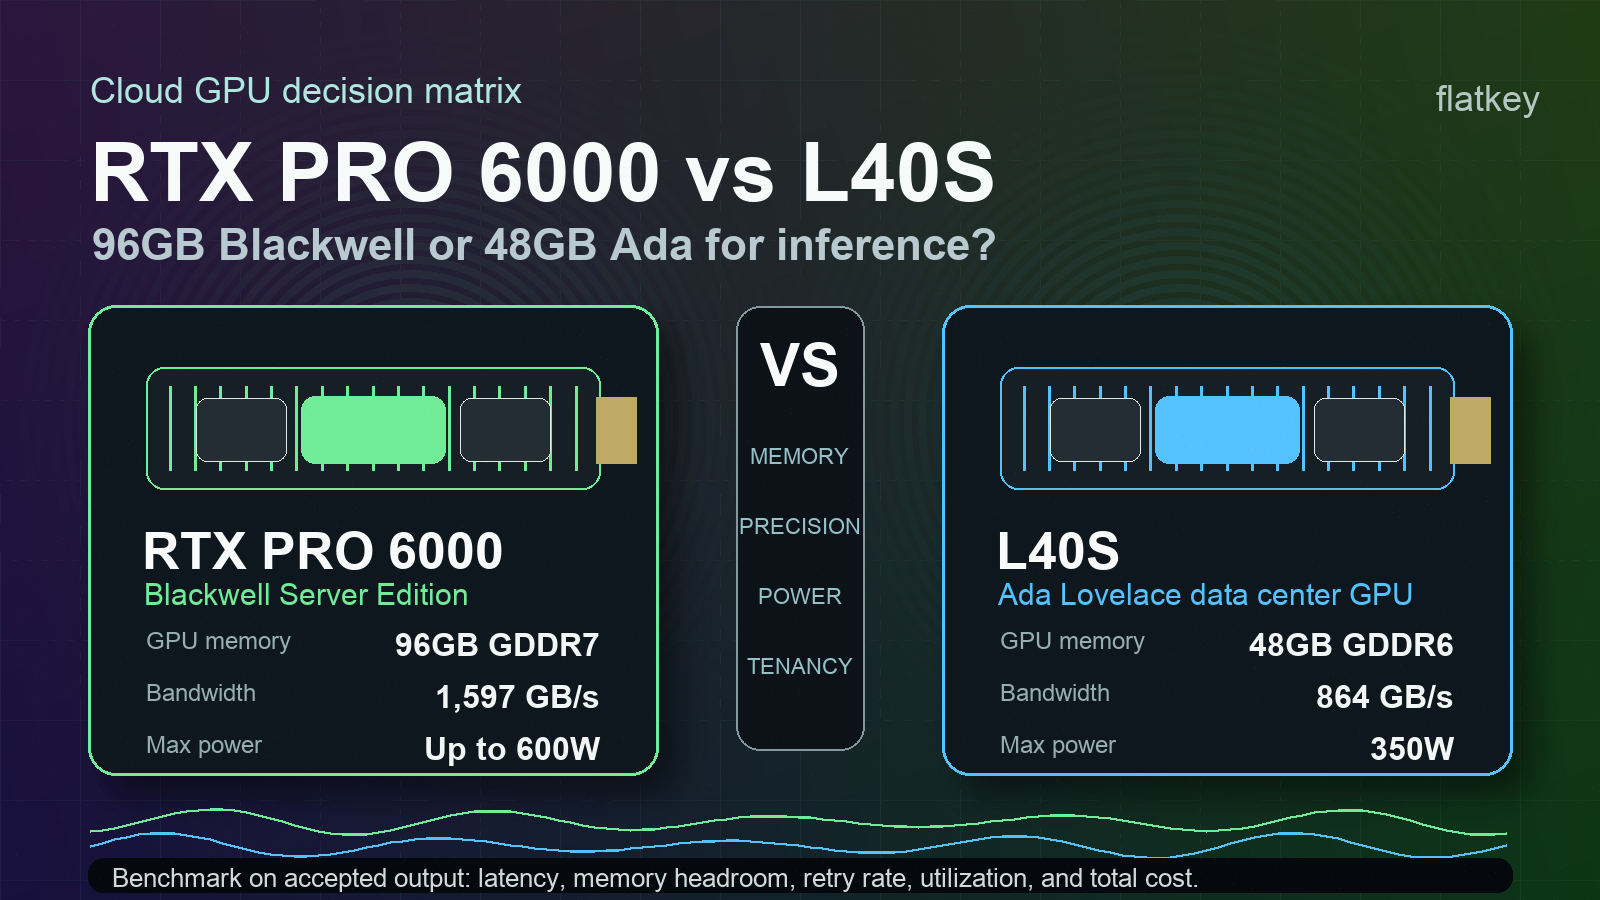
L40S часто привлекателен для изображений и небольших медиа-нагрузок, потому что он обладает сильными характеристиками для инференса и графики при более низком уровне закупки, чем GPU класса H100. H100, H200 и B200 становятся более актуальными, когда нагрузки тяжелее, больше по размеру, мультимодальны или жестко ограничены по latency. Локальные рабочие станции класса RTX могут быть полезны для создателей контента, прототипирования и низкообъемных pipeline, но производственным командам по-прежнему нужны очереди, хранилище, повторные попытки и наблюдаемость.
Используйте стоимость на принятый image или clip, а не сырое время рендеринга:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
Если вашей команде нужен только доступ к нескольким моделям для изображений или видео, путь через model/API может быть проще, чем запускать GPU media pipelines. Применяйте ту же дисциплину закупок, что и для текста: стоимость на один принятый результат, а не только прайс-лист.
Шпаргалка по моделям GPU
Используйте эту таблицу как отправную точку, а затем проверьте актуальные характеристики и доступность на официальных страницах провайдера. Не воспринимайте ее как таблицу цен.
| Семейство GPU | Практическая роль | Сигналы наилучшего соответствия | Распространённые оговорки |
|---|---|---|---|
| NVIDIA A100 | Зрелая базовая платформа для обучения и инференса | Существующие рецепты, варианты 40GB/80GB, широкая доступность в облаке, рабочие нагрузки с чувствительностью к бюджету | Более старое поколение; ниже пропускная способность памяти и более новые пути точности, чем у H100/H200/B200 |
| NVIDIA H100 | Рабочая лошадка Hopper-класса для обучения и инференса | Высокая зрелость фреймворков, поддержка FP8 Transformer Engine, высокая пропускная способность памяти, варианты NVLink/NVSwitch | Поставка и цена по-прежнему могут быть ограничены; памяти может не хватать для инференса с очень длинным контекстом и высокой конкуренцией |
| NVIDIA H200 | Вариант Hopper с увеличенным объёмом памяти | Больше объём HBM и пропускная способность, чем у H100; полезно для инференса с длинным контекстом и задач с высоким расходом памяти | Наличие и цена варьируются; сравнивайте с H100 для вашей конкретной рабочей нагрузки |
| NVIDIA B200 | Ускоритель Blackwell-класса | Тяжёлое обучение и инференс, новые пути низкой точности, большой объём памяти и высокая пропускная способность | Требует готовности стека, доступности у провайдера и проверки топологии |
| NVIDIA GB200 / системы rack-scale | Крупномасштабное обучение и инференс высокой плотности | Задачи кластерного масштаба, где архитектура системы важна не меньше, чем сам кремний GPU | Закупка и эксплуатация — это решения уровня системы, а не одного GPU |
| NVIDIA L40S | Инференс и медиа-задачи с чувствительностью к стоимости | Память уровня 48GB, конвейеры изображений/видео, инференс небольших LLM, пакетные задачи | Не является универсальной заменой H100/H200 для крупного обучения или жёсткого инференса LLM по p99 |
| Локальные GPU класса RTX | Локальные эксперименты и workflow для создателей контента | Прототипирование, небольшие модели, итерации на личной рабочей станции | Ограниченный объём памяти, более слабая история эксплуатации в дата-центре, сам по себе не является production-кластером |
В таблице скрыт важный факт закупок: модель GPU — это только часть ответа. Форм-фактор узла, хранилище, планировщик, межсоединение, модель квот и качество поддержки могут определить, будет ли GPU полезен.
Чек-лист закупки
Перед покупкой или арендой запросите у провайдеров следующие сведения.
Аппаратная часть и топология
- Точная модель GPU, объём памяти, форм-фактор узла и число GPU на узел.
- Межсоединение внутри узла и между узлами.
- CPU, RAM, локальный NVMe, пропускная способность хранилища и сетевая пропускная способность.
- Регион, зона, placement group, rack или предположения о выделенном кластере.
- Процесс замены вышедших из строя GPU, узлов, хранилищ и сетевых устройств.
Программный стек
- Версии драйвера, CUDA, cuDNN, NCCL, container runtime и поддерживаемых фреймворков.
- Модель доступа: Kubernetes, Slurm, управляемый endpoint или bare-metal.
- Поддержка vLLM, SGLang, TensorRT-LLM, Triton, Ray или медиа-пайплайнов.
- Поля наблюдаемости для загрузки GPU, памяти, ожидания в очереди, задержки, ошибок и затрат.
- Процесс обновления и отката.
Коммерческая модель
- On-demand, spot, reserved, marketplace, выделенный кластер, private cloud или managed endpoint.
- Минимальное обязательство, права на отмену, тарифы за перерасход и уровни поддержки.
- Стоимость хранилища, egress, снапшотов, публичного IP, load balancer и приватной сети.
- Формат выгрузки использования и детализация счёта.
- Взимается ли плата за простаивающую ёмкость и как работает автоматизация выключения.
Безопасность и управление
- Сетевая граница, модель VPC/VNet, поддержка private endpoint и политика egress.
- IAM, обращение с секретами, audit logs, доступ поддержки и уведомление об инцидентах.
- Хранение данных, срок удержания checkpoint, резервное копирование, удаление и legal hold.
- Доказательства соответствия требованиям и поддержка vendor review.
- Бюджеты по командам, квоты, теги и поддержка chargeback/showback.
Этот чек-лист применим к публичному GPU-облаку, частному GPU-облаку и аренде GPU-кластера. Чем глубже обязательства, тем больше доказательств следует требовать.
План бенчмарка: как протестировать перед тем, как принять обязательства
Это та часть руководства по выбору AI GPU, которая должна стать вашим доказательством для закупки. Сохраните входные данные, результаты и критерии приёмки, чтобы позже финансовая команда и платформа могли проверить решение.
Запустите бенчмарк, который похож на вашу рабочую нагрузку. Не полагайтесь только на публичные таблицы бенчмарков.
Этап 1: тест на соответствие по памяти
- Загрузите точную модель или ближайший аналог.
- Используйте целевую точность и квантизацию.
- Задайте требуемую длину контекста и размер batch.
- Запустите репрезентативные запросы или записи.
- Зафиксируйте пиковое потребление памяти, фрагментацию, частоту OOM и безопасный запас.
Этап 2: тест пропускной способности и задержки
- Проверьте стабильный трафик и всплесковый трафик.
- Измерьте задержку p50, p95 и p99.
- Измерьте время до первого токена для потоковых LLM-задач.
- Измерьте tokens/sec, images/hour, clips/hour или records/hour.
- Зафиксируйте принятые результаты, а не только сгенерированные.
Этап 3: тест на сбои и эксплуатацию
- Остановите worker, выведите узел из эксплуатации, перезапустите serving stack и смоделируйте неудачный деплой.
- Проверьте восстановление checkpoint для обучения и fine-tuning.
- Проверьте время cold-start и время загрузки модели.
- Подтвердите, что журналы и метрики доступны командам платформы, безопасности и финансов.
- Убедитесь, что учёт затрат сохраняется при повторных попытках и сбоях.
Этап 4: Финансовая нормализация
Создайте строку для каждого кандидата:
| Кандидат | Стоимость GPU | Хранилище/сеть | Трудозатраты платформы | Потери из-за сбоев | Принятые выходные данные | Эффективная удельная стоимость | Примечания |
|---|---|---|---|---|---|---|---|
| Provider A H100 | Ввод из коммерческого предложения | Добавить проверенные по источникам дополнительные расходы | Оценка | Измерено | Измерено | Рассчитано | Включить задержку p95 |
| Provider B H200 | Ввод из коммерческого предложения | Добавить проверенные по источникам дополнительные расходы | Оценка | Измерено | Измерено | Рассчитано | Включить запас по памяти |
| Model/API route | Стоимость API, проверенная по источникам | Стоимость шлюза/операций | Более низкая оценка операционных затрат | Измеренные повторы | Измерено | Рассчитано | Включить принятие по качеству |
Это превращает руководство по выбору AI GPU в документ для принятия решения, который могут изучить финансы, платформа и продукт.
Арендовать, зарезервировать, купить или использовать API модели?
Последний шаг в этом руководстве по выбору AI GPU — решить, следует ли арендовать мощность, зарезервировать ее, купить или обойтись через API модели.
Выбор модели GPU и выбор модели мощности — это разные решения.
| Ситуация | Лучшая отправная точка |
|---|---|
| Неопределенный спрос, меняющиеся модели или прототипы | API модели или краткосрочная аренда |
| Нерегулярные эксперименты и задания на оценку | Spot/маркетплейс GPU или пакетный API модели |
| Стабильный высоконагруженный инференс на одной модели | Резервированный GPU, выделенная конечная точка или зарезервированный кластер |
| Обучение на нескольких узлах с требованиями к топологии | Выделенный кластер для обучения или зарезервированная высокоскоростная фабрика |
| Строгое частное сетевое или аппаратное изолирование | Частное GPU-облако или выделенный кластер |
| Нужно много официальных моделей, один счет и резервный вариант | Маршруты модели/API под управлением Flatkey |
Если аргумент в пользу GPU в основном звучит как «нам нужен доступ к AI-моделям», начните с маршрутизации через модель/API. Если аргумент звучит как «нам нужно контролировать топологию, runtime, веса, границу данных или пользовательские ядра», оставьте путь GPU открытым. Разница важна, потому что GPU-инфраструктура включает ответственность за планировщик, runtime, безопасность, FinOps и инциденты.
Flatkey помогает с API-стороной этого решения: один ключ, один баланс, один счет, управление учетом использования и официальные маршруты модели/инструментов. Это не замена контролю над оборудованием, когда контроль над оборудованием действительно требуется. Это более простая альтернатива, когда реальное требование — управляемый доступ к моделям и прозрачность затрат.
Распространенные ошибки при выборе GPU
Ошибка 1: Выбор по почасовой ставке
Почасовая ставка игнорирует утилизацию, повторы, простои, хранилище, сеть, поддержку и время инженеров. Используйте стоимость завершенной рабочей нагрузки. Руководство по ценам аренды GPU охватывает скрытые статьи затрат.
Ошибка 2: Рассматривать соответствие по памяти как вопрос «да/нет»
Соответствие по памяти при одной длине запроса или размере батча не доказывает пригодность для продакшена. Длинный контекст, высокая конкуренция, смена моделей и накладные расходы фреймворка обслуживания могут изменить ответ.
Ошибка 3: Игнорировать interconnect
Для задач на нескольких GPU и нескольких узлах топология — часть GPU. Более дешевый пул GPU со слабым размещением может проиграть более дорогому, но согласованному кластеру.
Ошибка 4: Бенчмарк по сгенерированным результатам вместо принятых результатов
AI-нагрузки включают фильтры качества, фильтры безопасности, повторы, неудачные генерации, неудачные патчи и неудачные eval. Измеряйте стоимость принятых результатов.
Ошибка 5: Забывать об ответственности платформы
Кто-то должен обслуживать драйверы, CUDA, контейнеры, серверы моделей, автоскейлинг, квоты, логирование, оповещения, инциденты и отчетность по расходам. Если такой команды нет, учтите это.
Ошибка 6: Покупать только под сегодняшнюю модель
Выбор модели меняется. Окна контекста растут. Квантизация улучшается. Доступность провайдеров меняется. Делайте документ решения гибким и избегайте обязательств, предполагающих, что одна модель останется доминирующей.
Официальные источники для проверки
Используйте официальные страницы для изменчивых или зависящих от вендора деталей:
- Обзор NVIDIA H100 для контекста GPU класса Hopper: NVIDIA H100 Tensor Core GPU.
- Обзор NVIDIA H200 для контекста большей памяти HBM3e и пропускной способности: NVIDIA H200 Tensor Core GPU.
- Материалы по NVIDIA Blackwell/DGX B200 и GB200 для контекста системы Blackwell: NVIDIA DGX B200 и NVIDIA GB200 NVL72.
- Обзор NVIDIA A100 для контекста зрелой базовой платформы Ampere: NVIDIA A100 Tensor Core GPU.
- Страница NVIDIA L40S для контекста рабочих нагрузок инференса и графики/медиа: NVIDIA L40S.
- Документация NVIDIA MIG при разбиении поддерживаемых GPU: NVIDIA Multi-Instance GPU User Guide.
- Документация фреймворков для serving и соответствия runtime: vLLM OpenAI-compatible server, документация SGLang и NVIDIA TensorRT-LLM.
- Страницы с предложениями и ценами провайдеров для актуальной доступности и стоимости. Указывайте временную метку для каждой цены, которую вы переносите в закупочную таблицу.
Часто задаваемые вопросы
Какая GPU лучше всего подходит для обучения AI?
Лучшая GPU для обучения AI зависит от размера модели, схемы обучения, требований к памяти, интерконнекта, поведения checkpoint и времени до достижения целевого eval score. Системы уровня H100, H200, B200 и GB200 — сильные кандидаты для крупных задач обучения, тогда как A100 по-прежнему может быть приемлема для меньших или чувствительных к бюджету рабочих нагрузок. Перед выбором сравните стоимость завершённого прогона.
Какая GPU лучше всего подходит для инференса LLM?
Лучшая GPU для инференса LLM — та, которая вмещает веса модели и KV cache, при этом обеспечивает целевые показатели p95/p99 latency и стоимости на принятый токен. H100, H200 и B200 хорошо подходят для больших или длинноконтекстных рабочих нагрузок. L40S и A100 могут быть эффективны для меньших моделей, batch inference и более мягких требований к latency. Для расчётов, специфичных для инференса, используйте подробное руководство по best GPU for LLM inference.
Всегда ли H200 лучше, чем H100?
Нет. H200 предлагает больший запас по памяти и более высокую пропускную способность, чем H100, что может помочь в memory-heavy инференсе и обучении. Но лучший выбор зависит от цены, доступности, зрелости фреймворков, размера batch, latency и от того, действительно ли рабочая нагрузка ограничена памятью. Если H100 достигает цели при более низкой эффективной стоимости, H100 всё ещё может выиграть.
Когда мне следует выбрать L40S вместо H100?
Выбирайте L40S, когда модель помещается, требования к latency умеренные, важна производительность для media/inference в расчёте на доллар, и мощность класса H100 не будет использоваться полностью. Выбирайте H100, когда более крупные модели, более строгая p99 latency, обучение или высококонкурентный инференс требуют более высокой производительности дата-центрового ускорителя.
Стоит ли арендовать GPU или использовать model API?
Арендуйте GPU, когда вам нужен контроль над hardware, собственные runtimes, приватная топология или стабильная загрузка для модели с постоянным спросом. Используйте model API, когда спрос неопределён, модели часто меняются, важен доступ к frontier model или вашей команде важнее governance, fallback, ledgers и один счёт, чем контроль над hardware. Сравните с GPU cloud vs model API.
Как избежать избыточной покупки GPU?
Избегайте избыточной покупки, бенчмаркая точную рабочую нагрузку, измеряя принятые результаты, включая время простоя и operations, и сначала тестируя более маленькие или управляемые альтернативы. Бронируйте или покупайте только после того, как трафик, выбор модели и утилизация подтверждены.
Итог
Это руководство по выбору AI GPU — не рейтинг ускорителей. Это способ сделать решения по GPU обоснованными. Начните с рабочей нагрузки, выберите метрику, согласованную с бизнесом, подтвердите, что память подходит, проверьте throughput и tail latency, учтите operations и потери из-за отказов и сравните с вариантами model/API перед тем, как брать на себя обязательства.
Для многих команд правильный ответ — гибрид: GPU для рабочих нагрузок, которым действительно нужен контроль над hardware, и доступ к model/API под управлением Flatkey для overflow, frontier models, fallback, usage ledgers и команд, которым не следует обслуживать serving stack. Выигрышный выбор GPU — тот, который обеспечивает принятые задачи по нужной цене, не заставляя вашу команду владеть инфраструктурой, которая ей не нужна.