
Затраты, оплата и эксплуатация
Последние статьи в категории Затраты, оплата и эксплуатация.

GPU H200: архитектура, производительность и руководство по развертыванию в облаке
Практическое руководство по H200: выбор форм-фактора, расчет памяти и сети, развертывание в облачной инфраструктуре и проверка задержки, пропускной способности, состояния и стоимости выполненных задач.
Цена GPU H100: стоимость, факторы ценообразования и руководство по покупке
Руководство по цене GPU H100: сравнение предложения PCIe за $32 200, тарифов облачной аренды, форм-факторов и TCO в коммерческом предложении для локальной инфраструктуры.

GPU-сервер: архитектура, производительность и развертывание в облаке
Выберите и разверните облачный GPU-сервер, используя подход, ориентированный на рабочую нагрузку, тестирование производительности и оценку готовности к продакшену.
Бесплатные LLM API: лимиты, расходы и компромиссы в продакшене
Практическое руководство по бесплатным тарифам LLM API, кредитам, лимитам запросов, скрытым операционным расходам и мерам контроля перед запуском маршрута для пользователей.
ComfyUI на облачном GPU: настройка, хранилище и расходы
Практическое руководство по развертыванию ComfyUI на облачном GPU: постоянное хранилище, приватный доступ, выбор GPU под задачи и контроль расходов.

Самые дешёвые LLM API в 2026 году: сравнивайте цены по нагрузке, а не по хайпу
Гайд с проверенными источниками по сравнению недорогих LLM API по типам нагрузки: стоимость ввода, вывода, кэша, пакетной обработки, инструментов, повторных попыток и исправлений.

Инфраструктура суверенного ИИ: модели, локализация данных и контроль вычислений (руководство на 2026 год)
Практическое руководство по инфраструктуре суверенного ИИ в 2026 году: четыре слоя (вычисления, данные, модели, эксплуатация), нормативные требования, пять уровней суверенности, развертывание открытой модели для инференса и пример стоимости GPU внутри страны для модели класса 70B.
H200 и H100 (2026): характеристики, реальная производительность, цена за час и выбор для аренды
NVIDIA H200 и H100 в 2026 году: официальные характеристики, значение 141GB для инференса 70B, реальные почасовые цены Flatkey Compute, RunPod и Lambda, альтернативы Blackwell и выбор GPU для разных нагрузок.

API-ключ Anthropic (2026): как получить, типы ключей, настройка Claude Code и ошибки
Пошаговое руководство по API-ключу Anthropic на 2026 год: настройка Console, личные ключи и ключи сервисных аккаунтов, срок действия, первый запрос, Claude Code, стоимость и ошибки.

Цены на Grok API (2026): все модели, плата за инструменты и множители
Актуальные цены xAI Grok API: тарифы на текст, изображения, видео и голос, пять множителей (длинный контекст, приоритет, регион США, Batch и инструменты), калькулятор затрат и сравнение с GPT, Claude, Gemini и Qwen.
Цены на API Mistral (2026): все модели, скидка на batch и примеры расчёта
Полная таблица цен API Mistral (официальные данные на октябрь 2026), бесплатный режим, скидки на batch и кэш, калькулятор стоимости, сравнение с GPT, Claude, Gemini и Qwen, а также код.
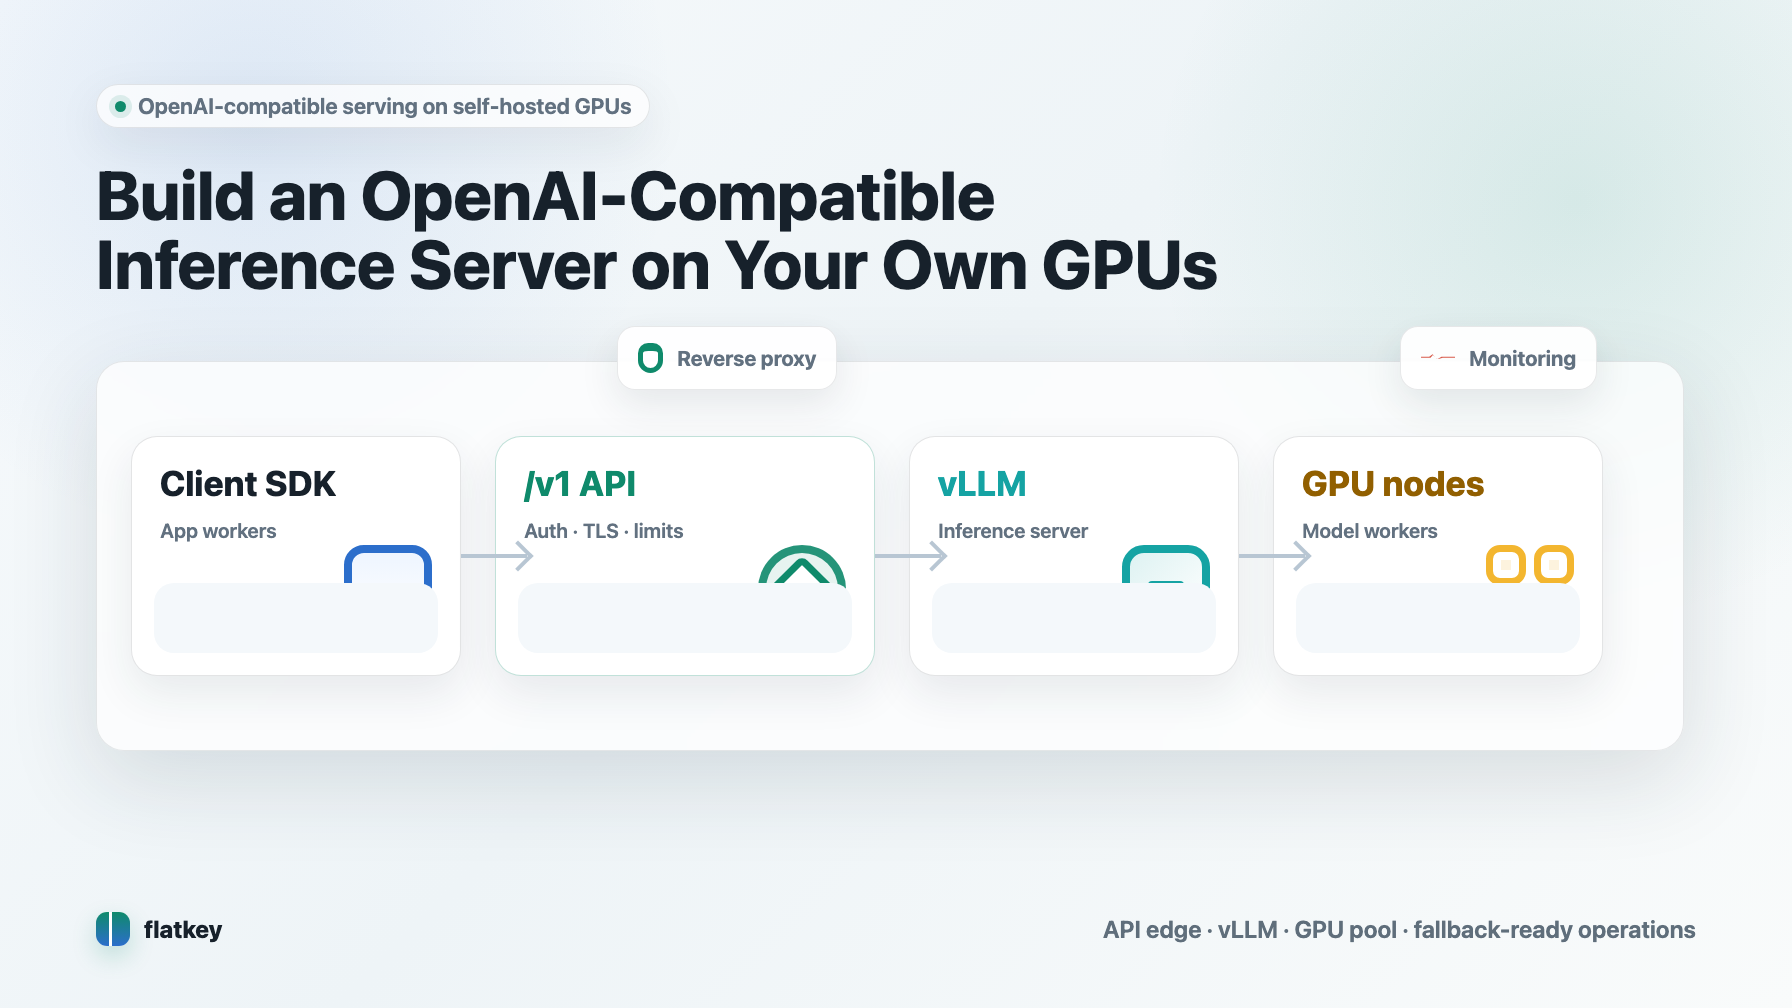
Самостоятельное размещение LLM (2026): когда это выгодно, какое оборудование нужно и как запустить сервер инференса
Самостоятельное размещение LLM позволяет запускать модели с открытыми весами на GPU под вашим контролем. Разбираем, когда это выгоднее API с оплатой за токены (по тарифам на GPU за октябрь 2026 года), как рассчитать объём памяти GPU, выбрать инструмент для инференса и развернуть OpenAI-совместимый сервер vLLM с резервным маршрутом.
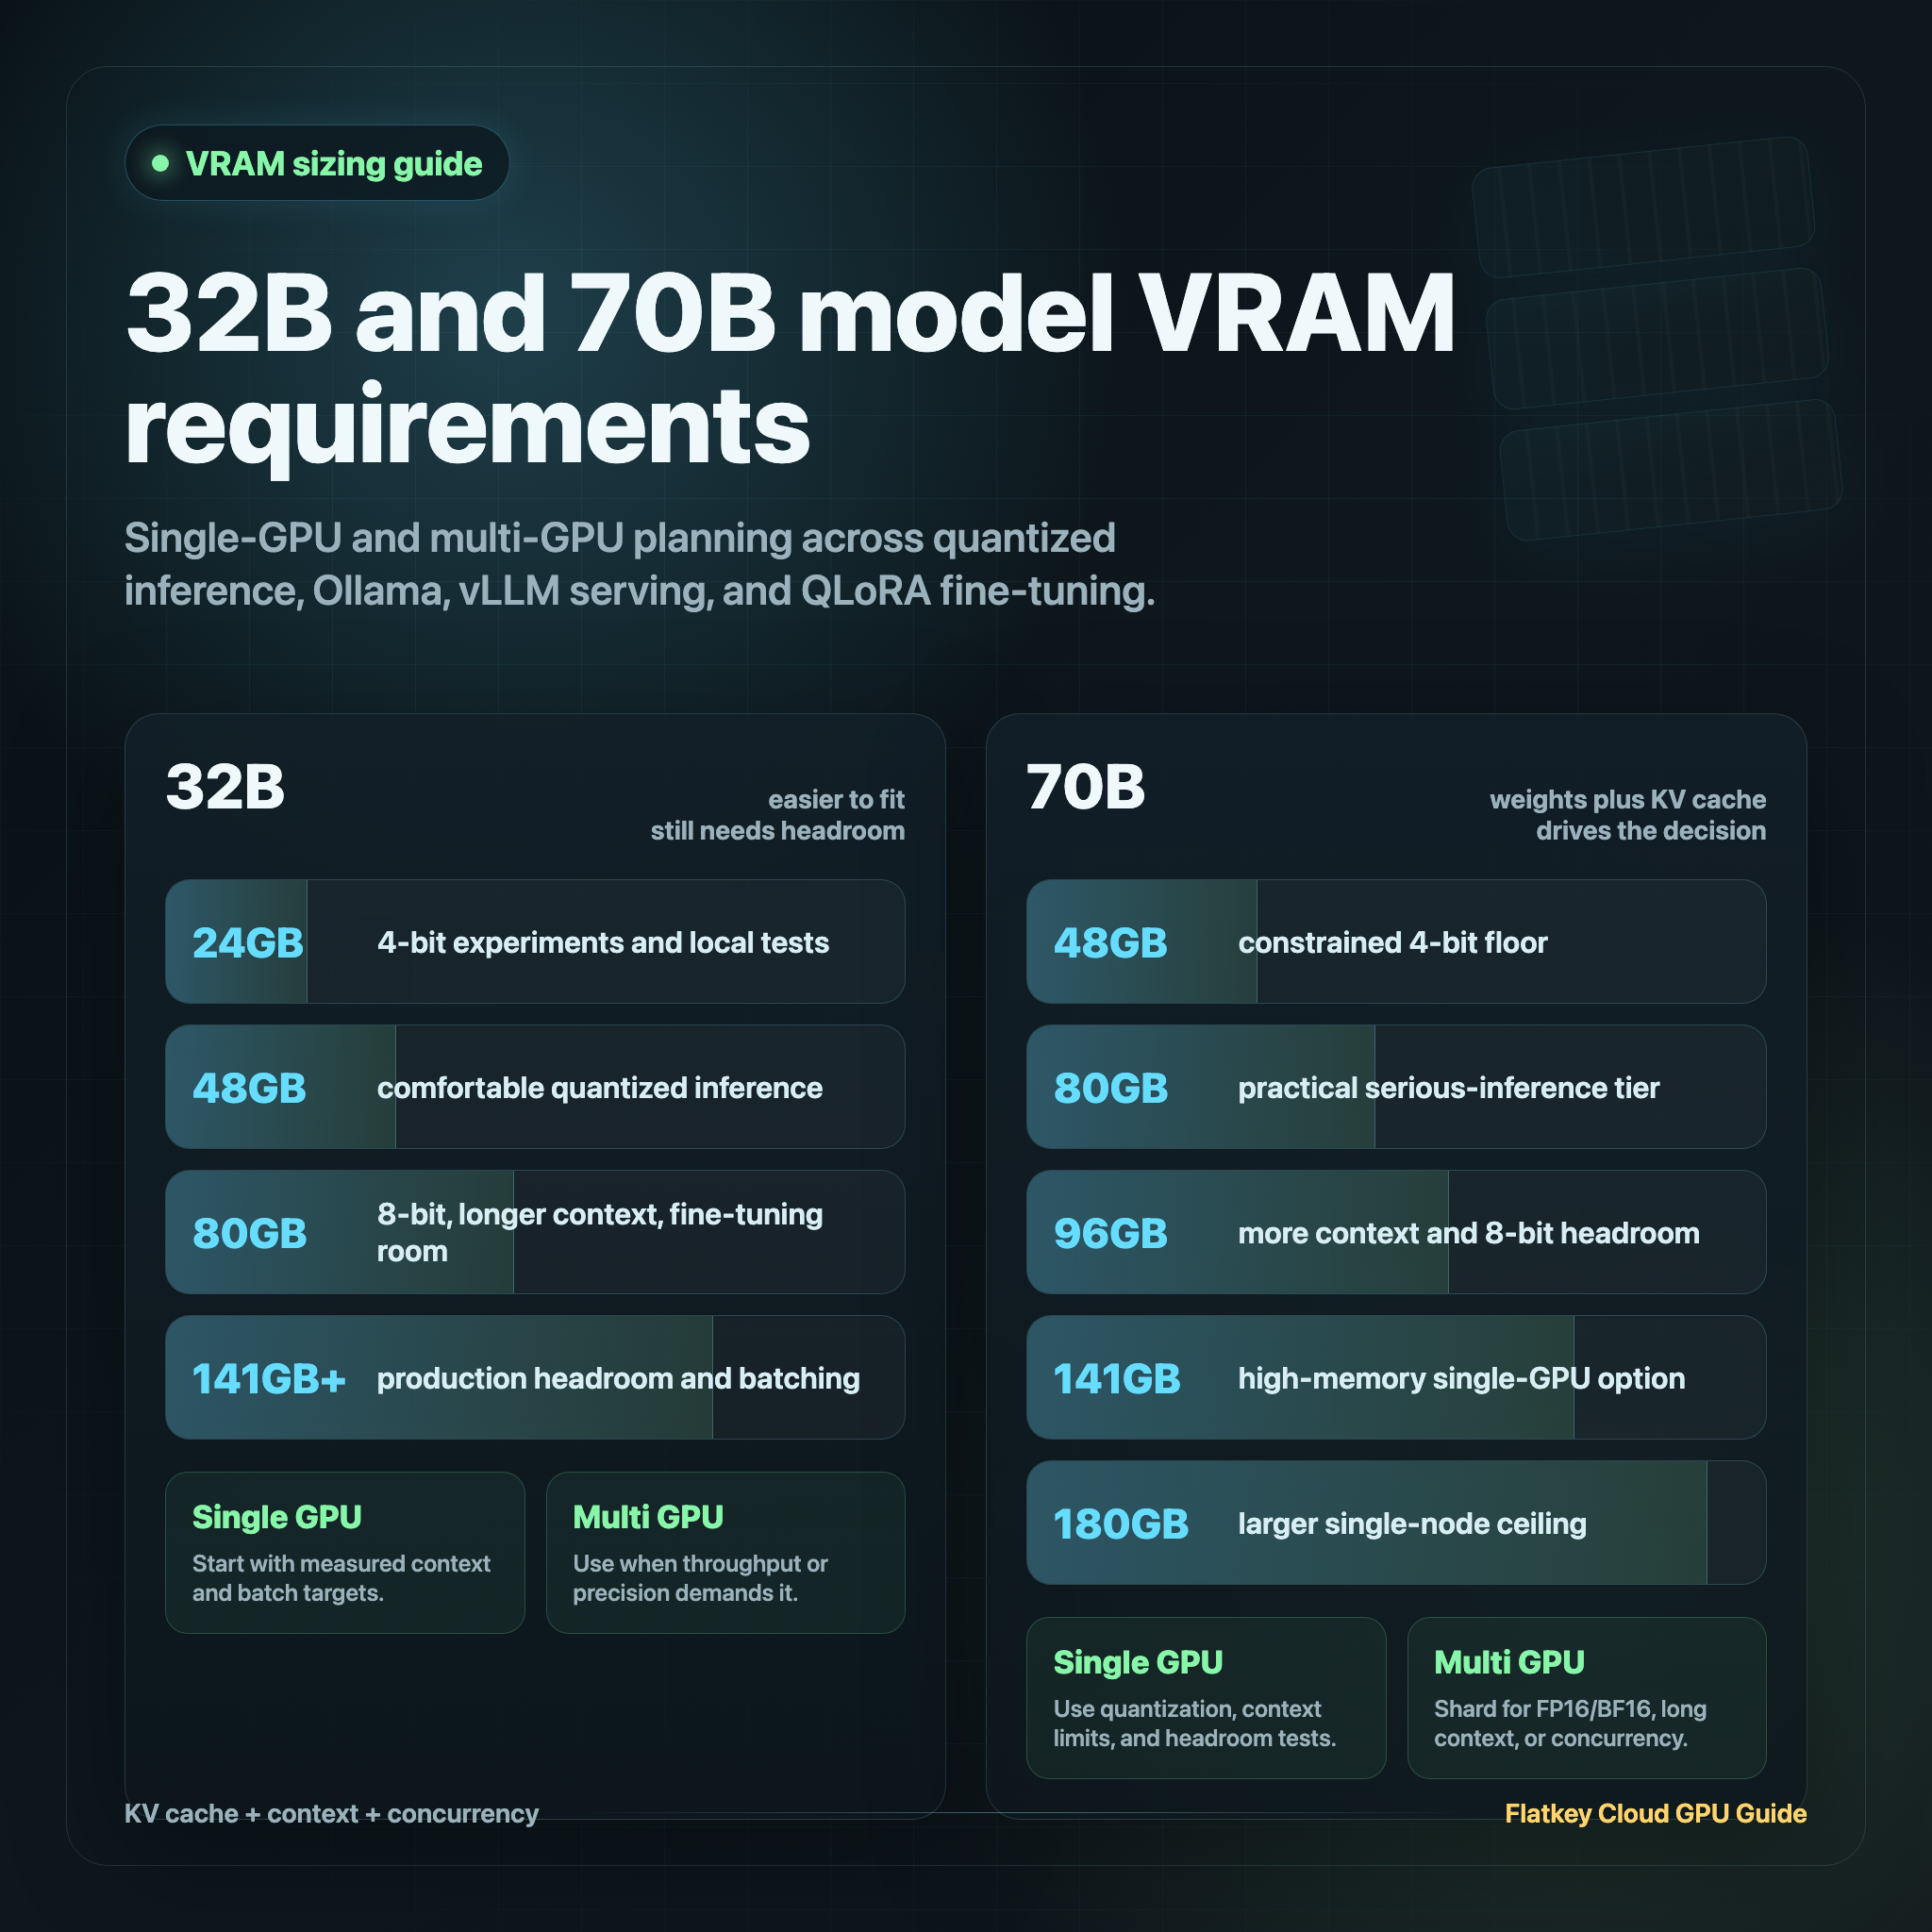
Руководство по VRAM для моделей 32B и 70B: варианты для одной и нескольких GPU
Узнайте практические требования к VRAM для моделей 32B и 70B при инференсе в 4-bit, 8-bit и FP16/BF16, а также для Ollama, тонкой настройки QLoRA и вариантов с одной или несколькими GPU.
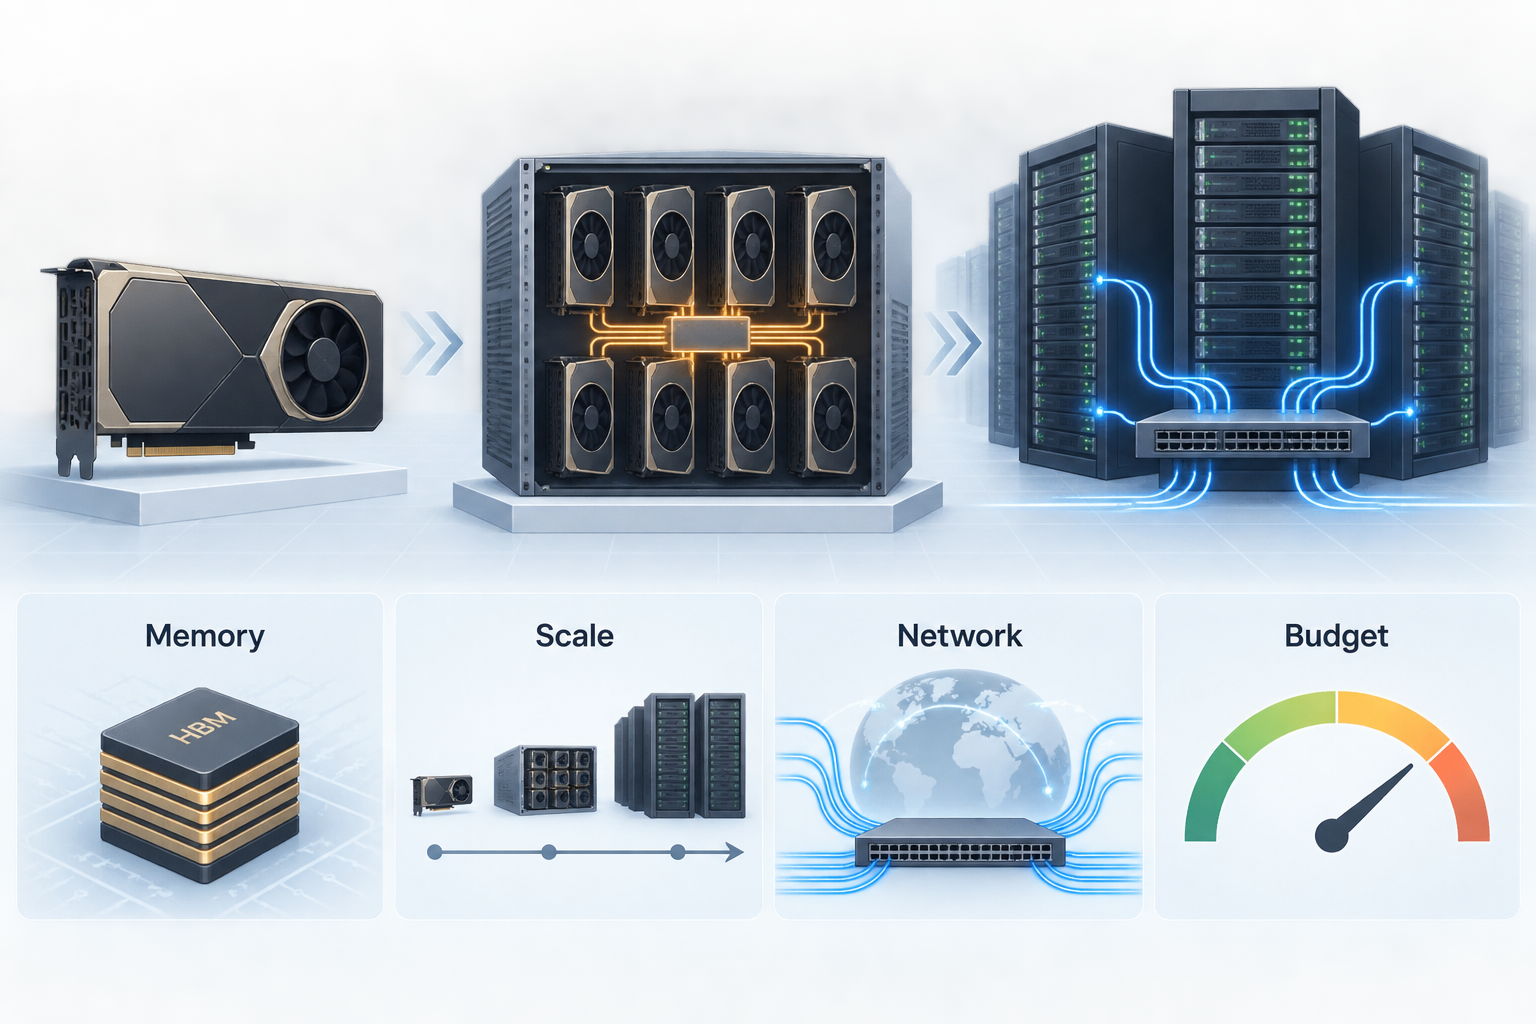
Лучшая GPU для обучения LLM: масштаб, память, сеть и бюджет
Практическое руководство 2026 года по выбору лучшей GPU для обучения LLM с учетом масштаба, памяти, сети, подходящего провайдера и стоимости одного готового checkpoint.
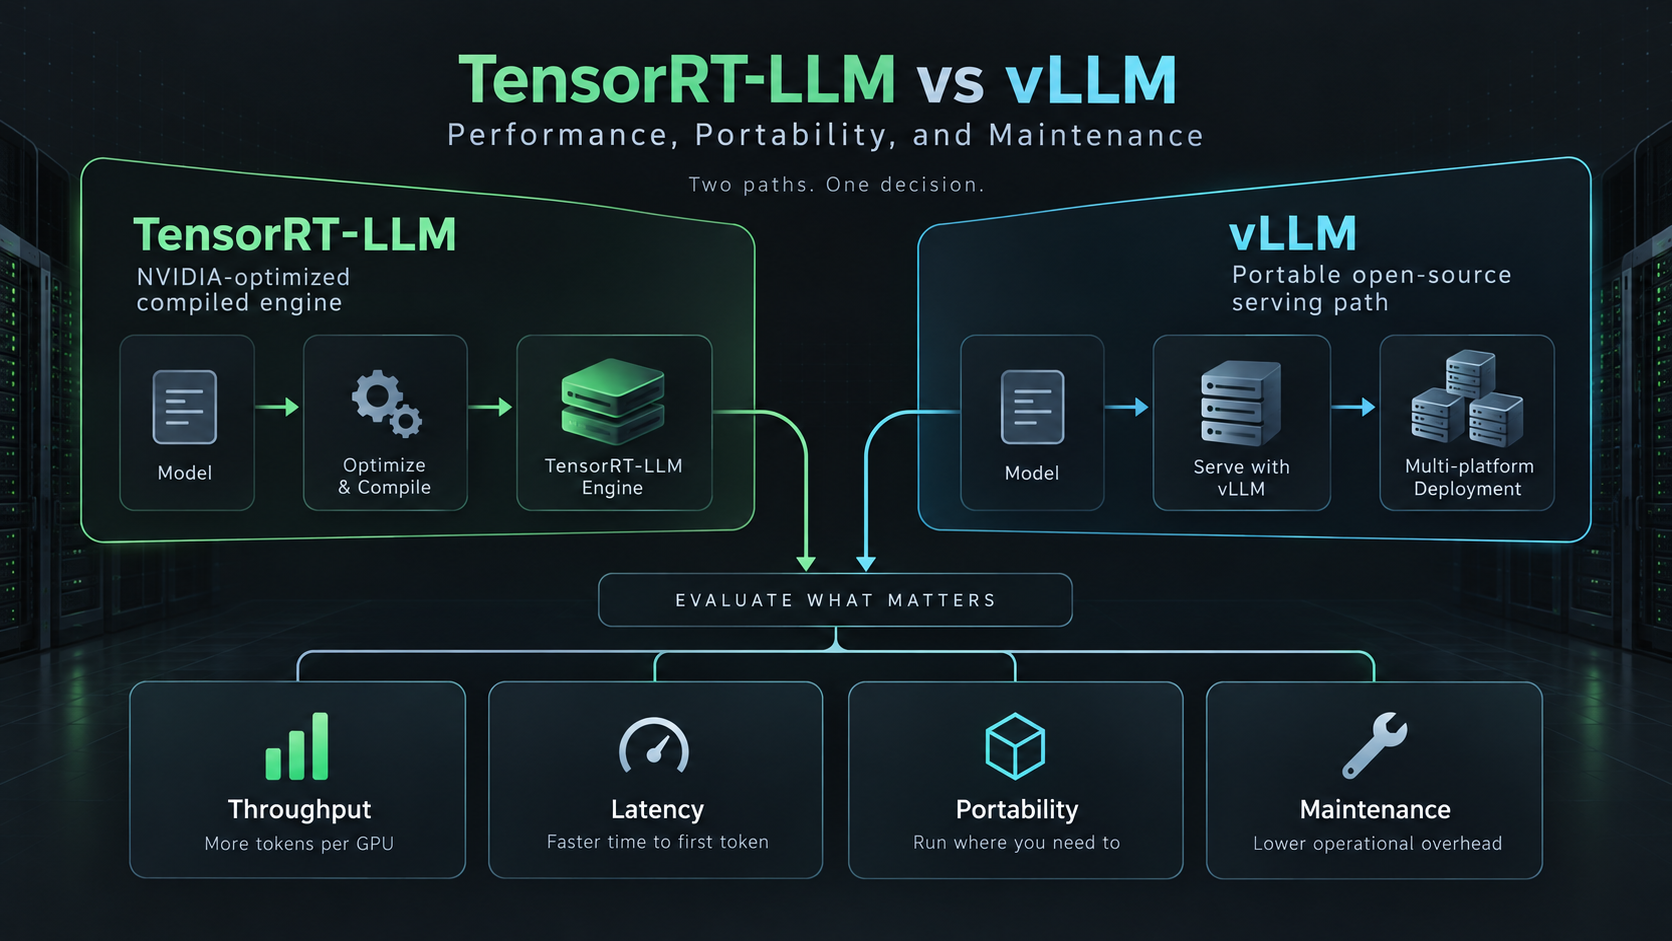
TensorRT-LLM vs vLLM: Производительность, портативность и сопровождение
Практическое сравнение TensorRT-LLM и vLLM для команд AI-инфраструктуры, выбирающих движок для обслуживания LLM с учетом производительности, портативности, сопровождения и дизайна бенчмарков.
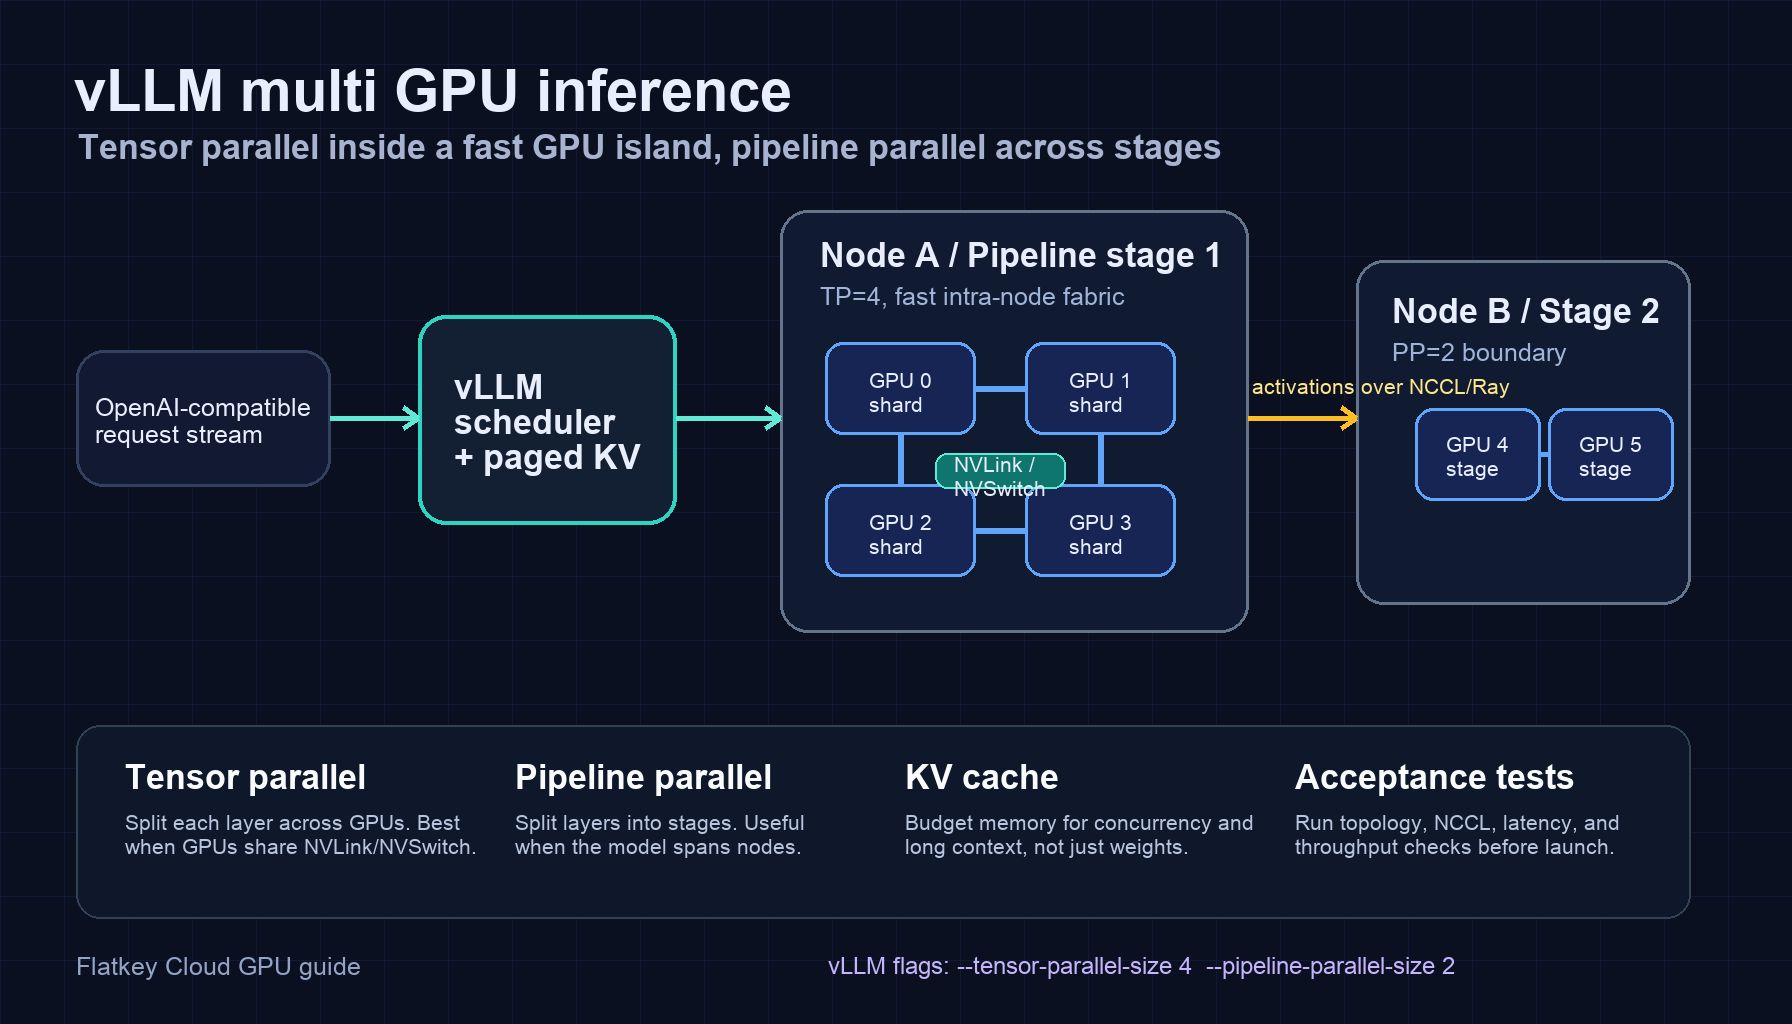
vLLM Multi-GPU Inference: Настройка tensor и pipeline parallelism
Настройте многопроцессорный inference vLLM с tensor parallelism, pipeline parallelism, Ray, проверками топологии, примерами и production-тестами.
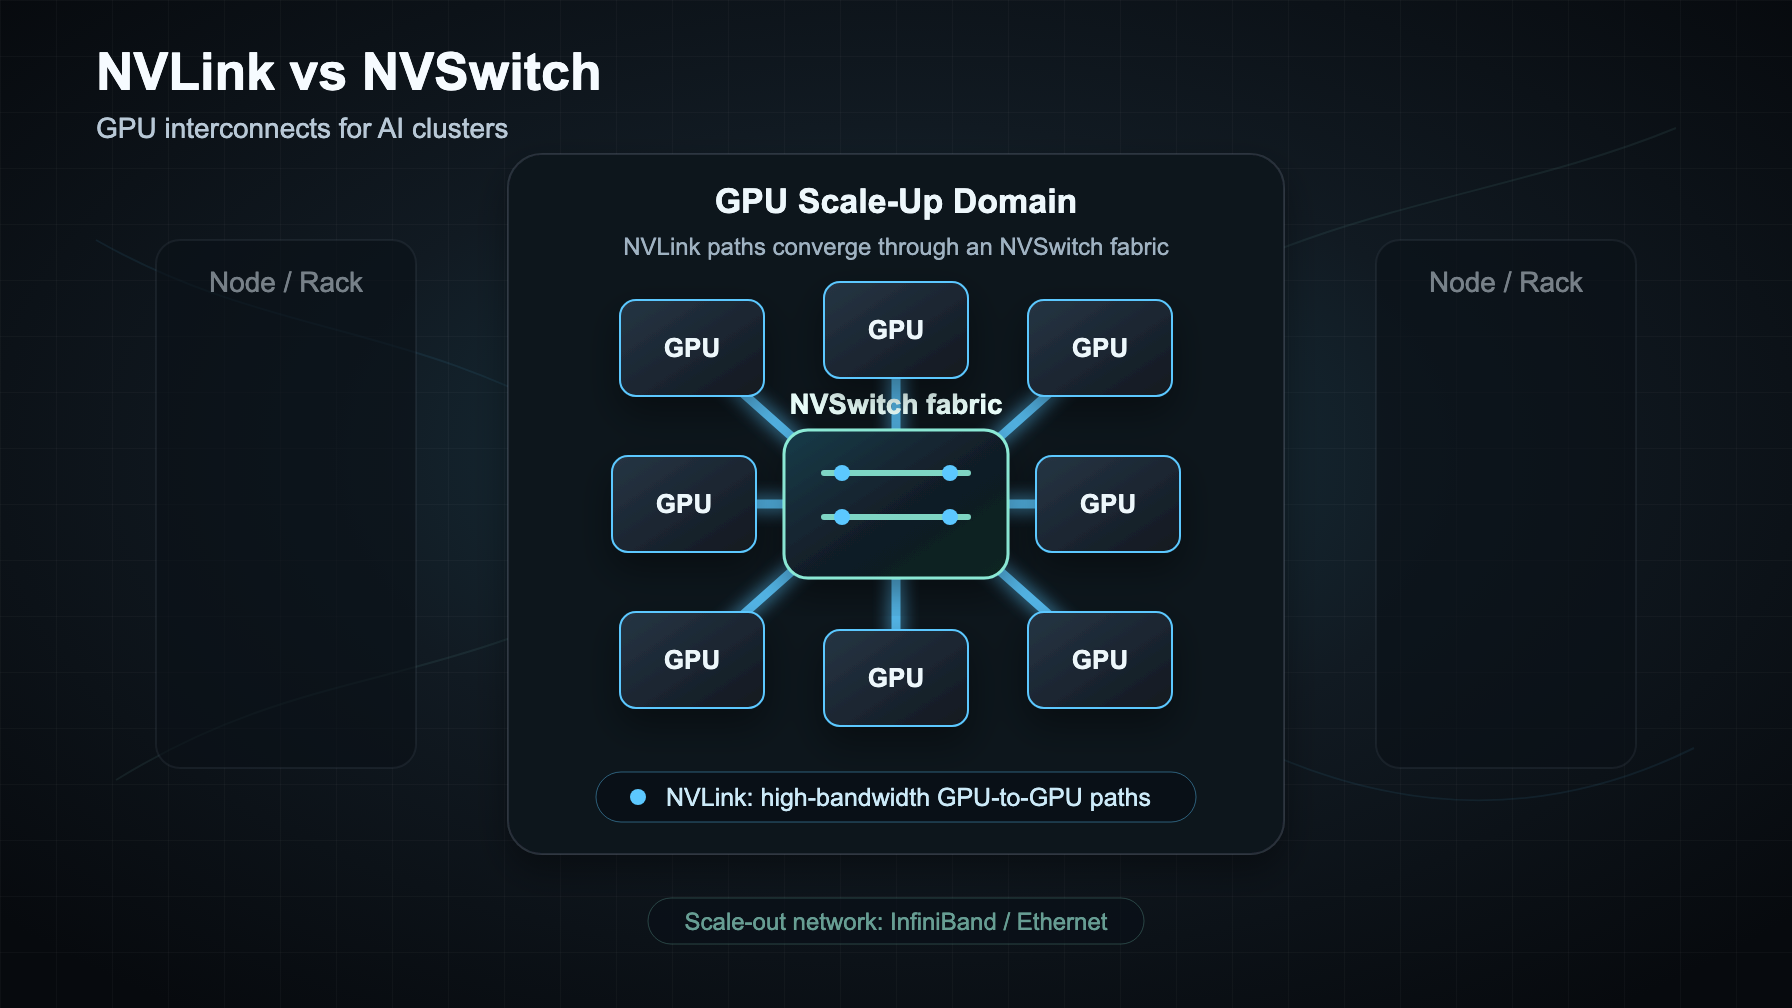
NVLink vs NVSwitch: Объяснение GPU-интерконнектов для AI-кластеров
NVLink — это связь GPU-to-GPU, NVSwitch — это fabric, а InfiniBand или Ethernet — это сеть для масштабирования. Вот как выбрать решение для AI-кластеров.
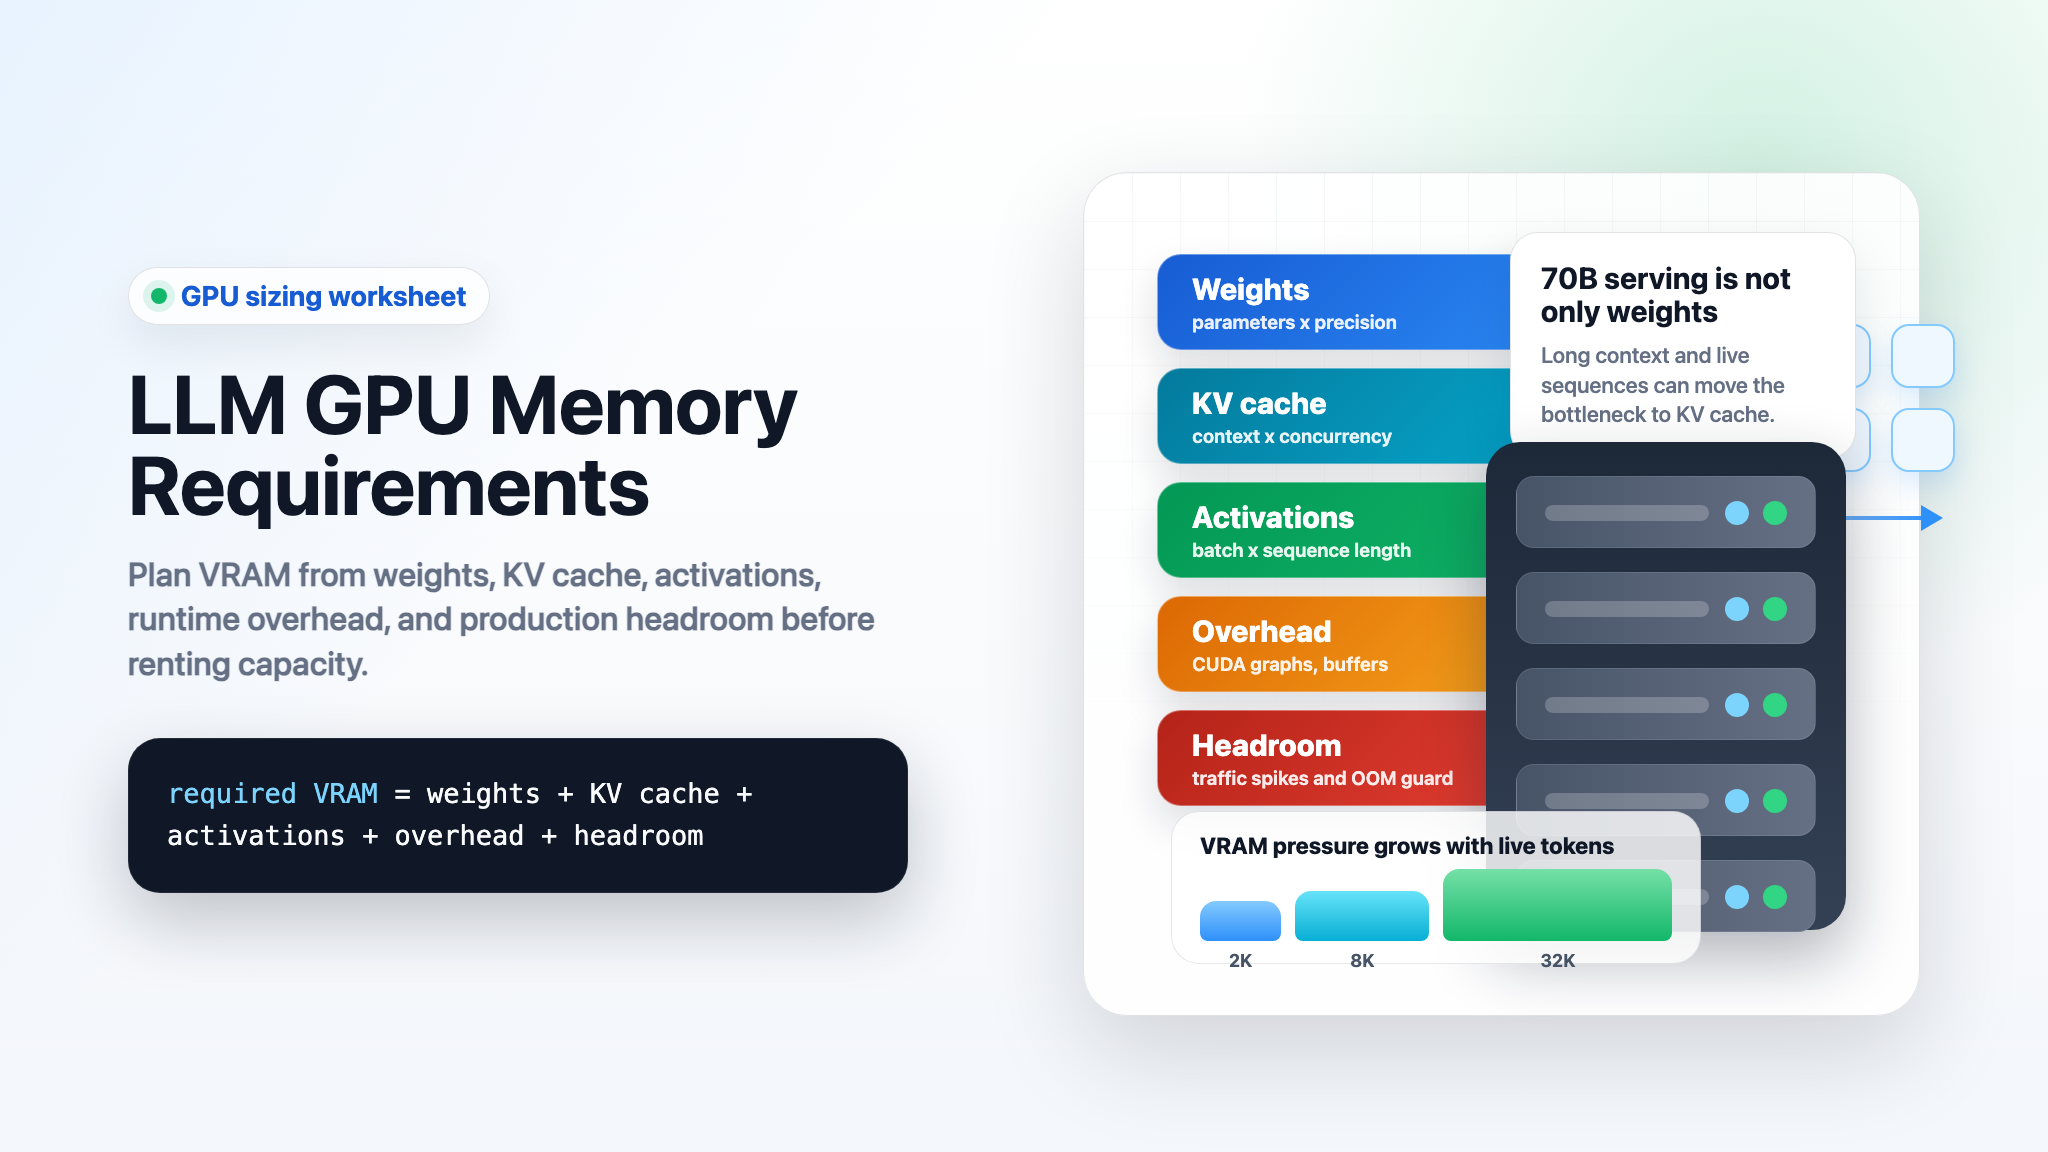
Требования к GPU-памяти для LLM: веса, KV-кэш, активации и накладные расходы
Практический рабочий лист для оценки требований LLM к памяти GPU: веса, KV-кэш, активации, накладные расходы при обслуживании, планирование vLLM для 70B, fine-tuning и обучение.
Запускайте быстрее с единым AI-шлюзом.
Используйте flatkey.ai, чтобы управлять моделями, ключами, биллингом и наблюдаемостью на одной API-платформе.
Начать