
Blog flatkey.ai
Góc nhìn, ghi chú sản phẩm và hướng dẫn triển khai cho đội ngũ xây dựng trên AI API.
Kiến trúc cổng AI
Bài viết mới nhất trong Kiến trúc cổng AI.
Đọc thêmDi chuyển URL cơ sở và SDK
Bài viết mới nhất trong Di chuyển URL cơ sở và SDK.
Đọc thêmChi phí, thanh toán và vận hành
Bài viết mới nhất trong Chi phí, thanh toán và vận hành.
Đọc thêmKiểm soát doanh nghiệp và độ tin cậy
Bài viết mới nhất trong Kiểm soát doanh nghiệp và độ tin cậy.
Đọc thêmSo sánh các cổng API
Bài viết mới nhất trong So sánh các cổng API.
Đọc thêmHướng dẫn mô hình và phương thức
Bài viết mới nhất trong Hướng dẫn mô hình và phương thức.
Đọc thêmĐộ tin cậy và định tuyến
Bài viết mới nhất trong Độ tin cậy và định tuyến.
Đọc thêmTích hợp công cụ
Bài viết mới nhất trong Tích hợp công cụ.
Đọc thêm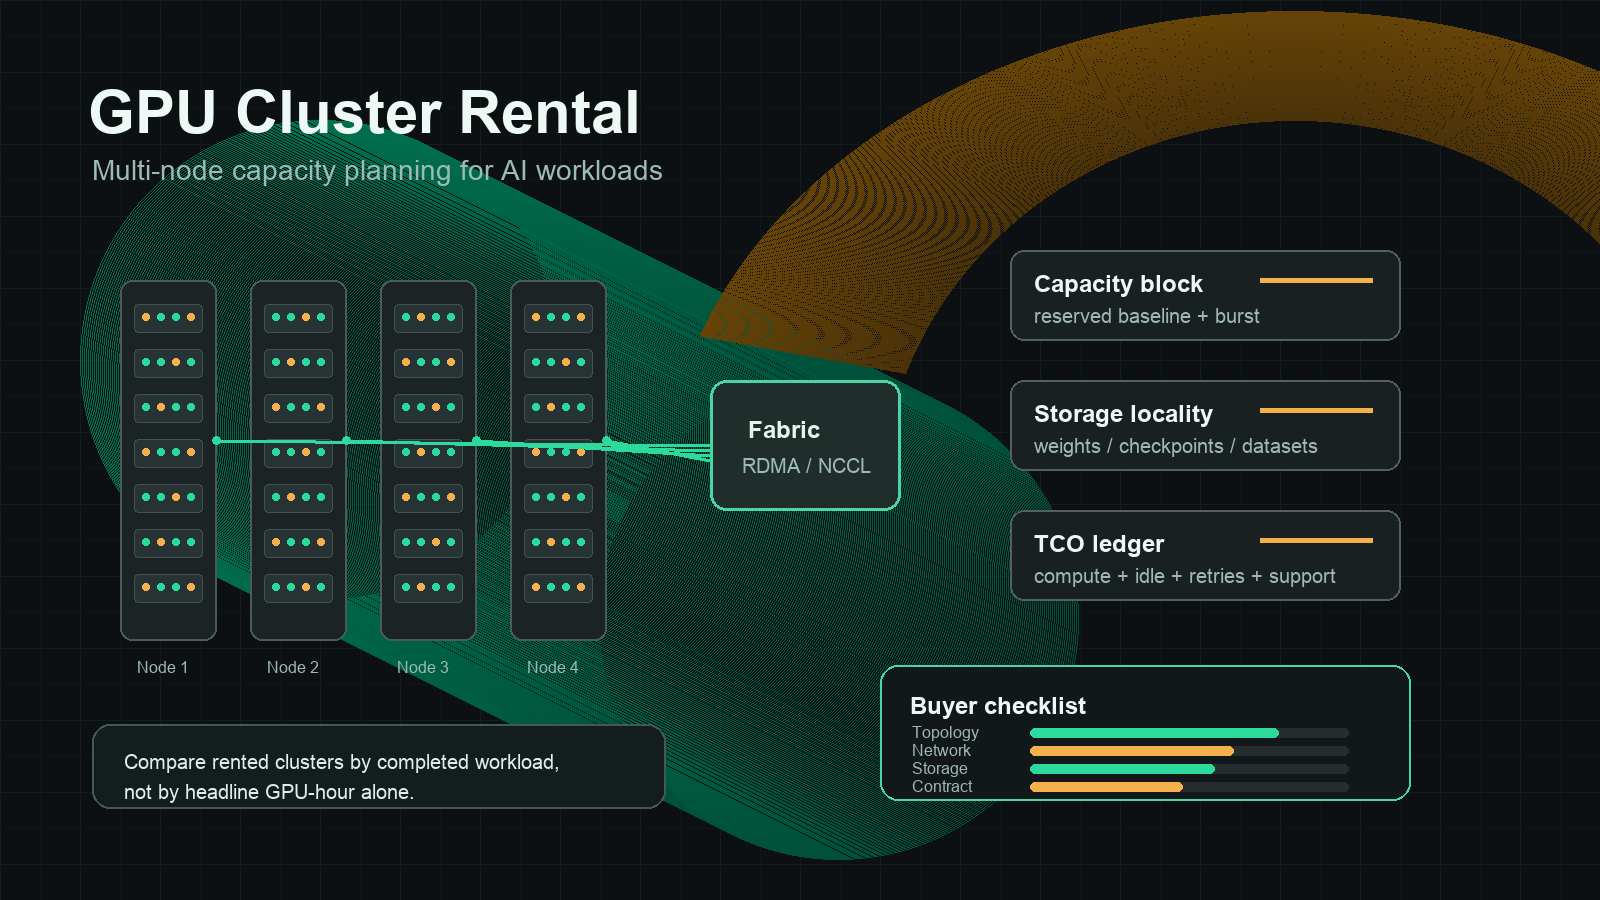
Thuê Cụm GPU: Hướng Dẫn Cho Người Mua Về Năng Lực AI Đa Nút
Hướng dẫn dành cho các đội ngũ AI doanh nghiệp khi đánh giá thuê cụm GPU đa nút, nhà cung cấp đám mây, năng lực đặt trước, mạng fabric, lưu trữ và TCO.
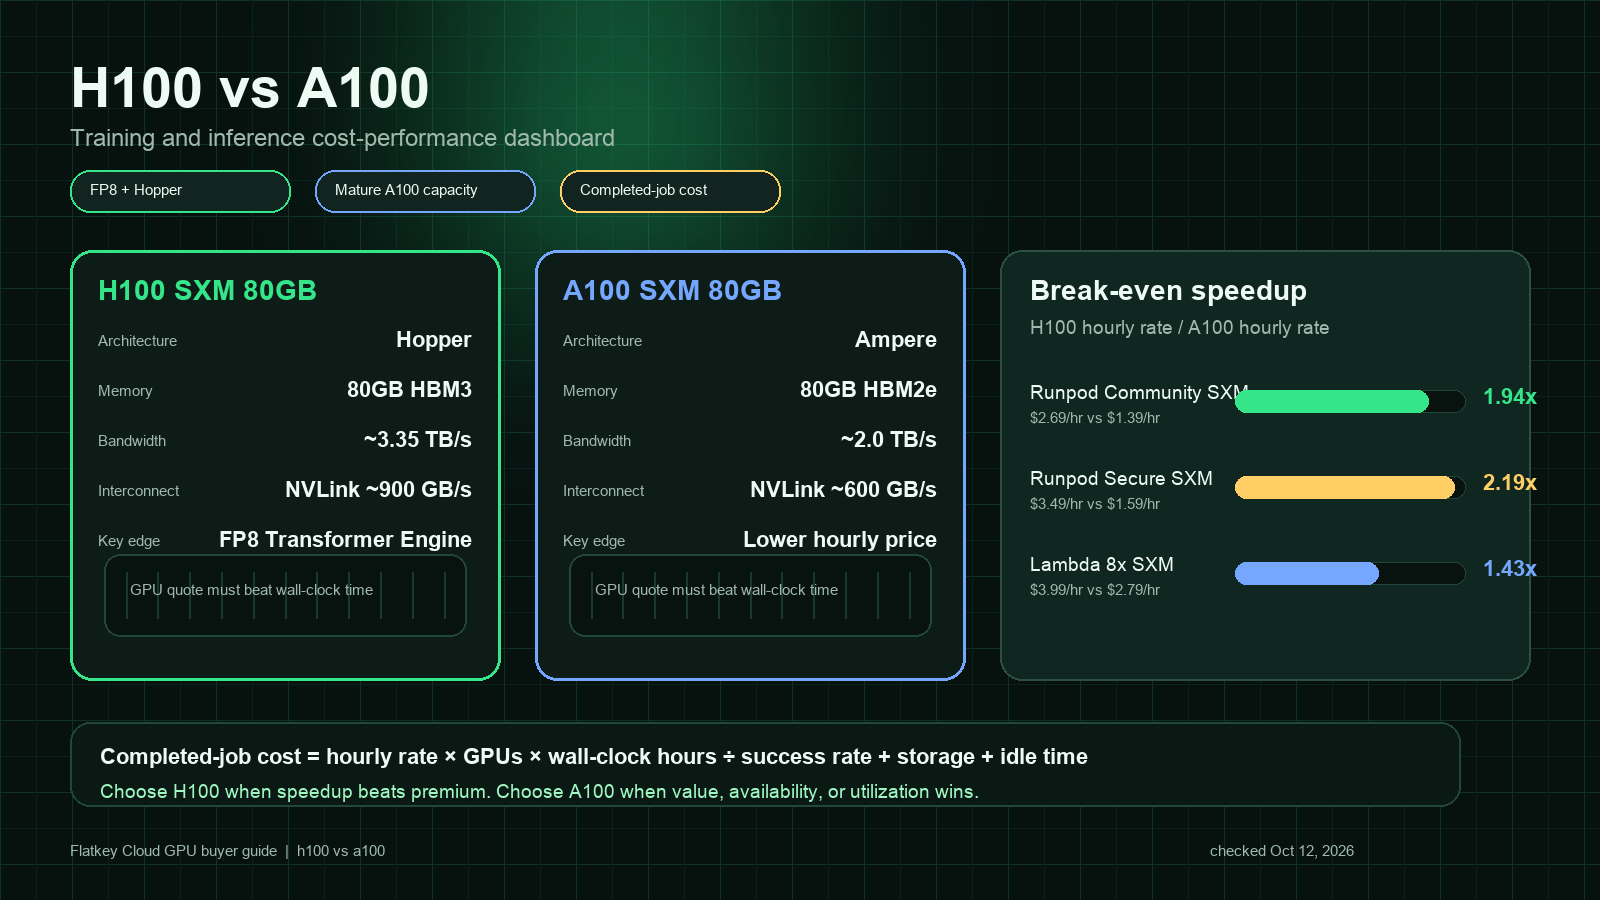
NVIDIA H100 vs A100: Hiệu năng trên chi phí cho huấn luyện và suy luận
So sánh thực tế H100 vs A100 dành cho các đội ngũ AI đang cân nhắc giữa hiệu năng Hopper và giá trị Ampere trong huấn luyện, suy luận và thuê GPU trên đám mây.

H200 vs H100 (2026): Thông số, hiệu năng thực tế, giá theo giờ và nên thuê GPU nào
NVIDIA H200 vs H100 năm 2026: thông số chính thức, vì sao 141GB quan trọng khi suy luận mô hình 70B, giá thuê thực tế theo giờ từ Flatkey Compute, RunPod và Lambda, các lựa chọn Blackwell và gợi ý theo từng khối lượng công việc.
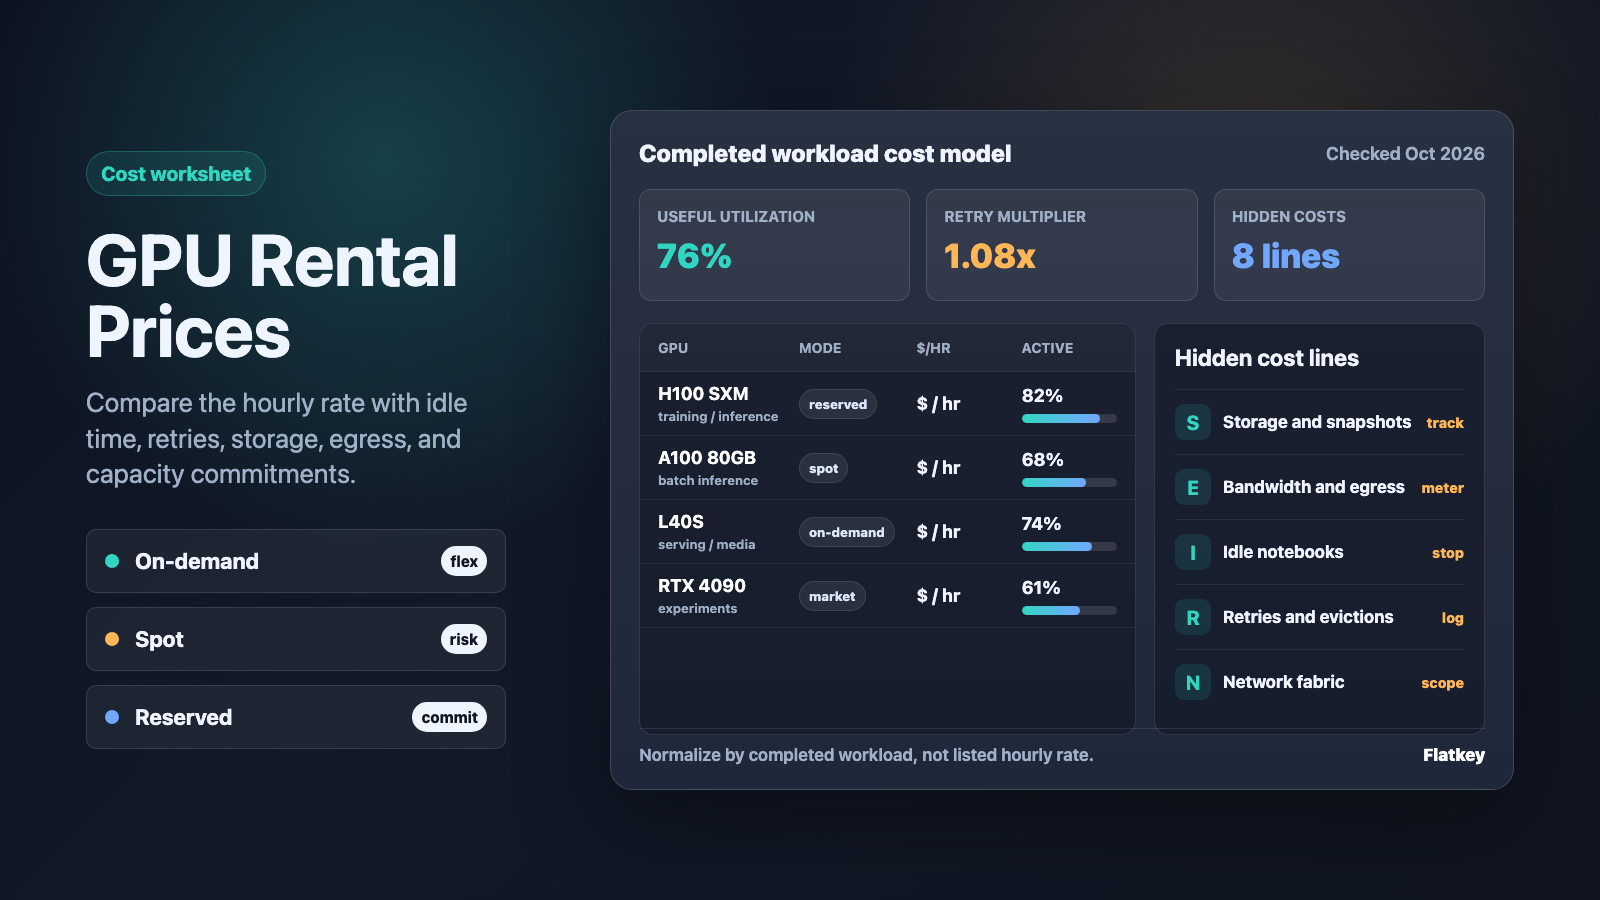
Giải thích giá thuê GPU: On-Demand, Spot, Reserved và các chi phí ẩn
Hướng dẫn thực tế để so sánh giá thuê GPU theo chi phí cho mỗi workload hoàn thành, không chỉ theo đơn giá giờ, với kiểm tra nguồn cho các mô hình on-demand, spot, reserved, marketplace và chi phí ẩn.
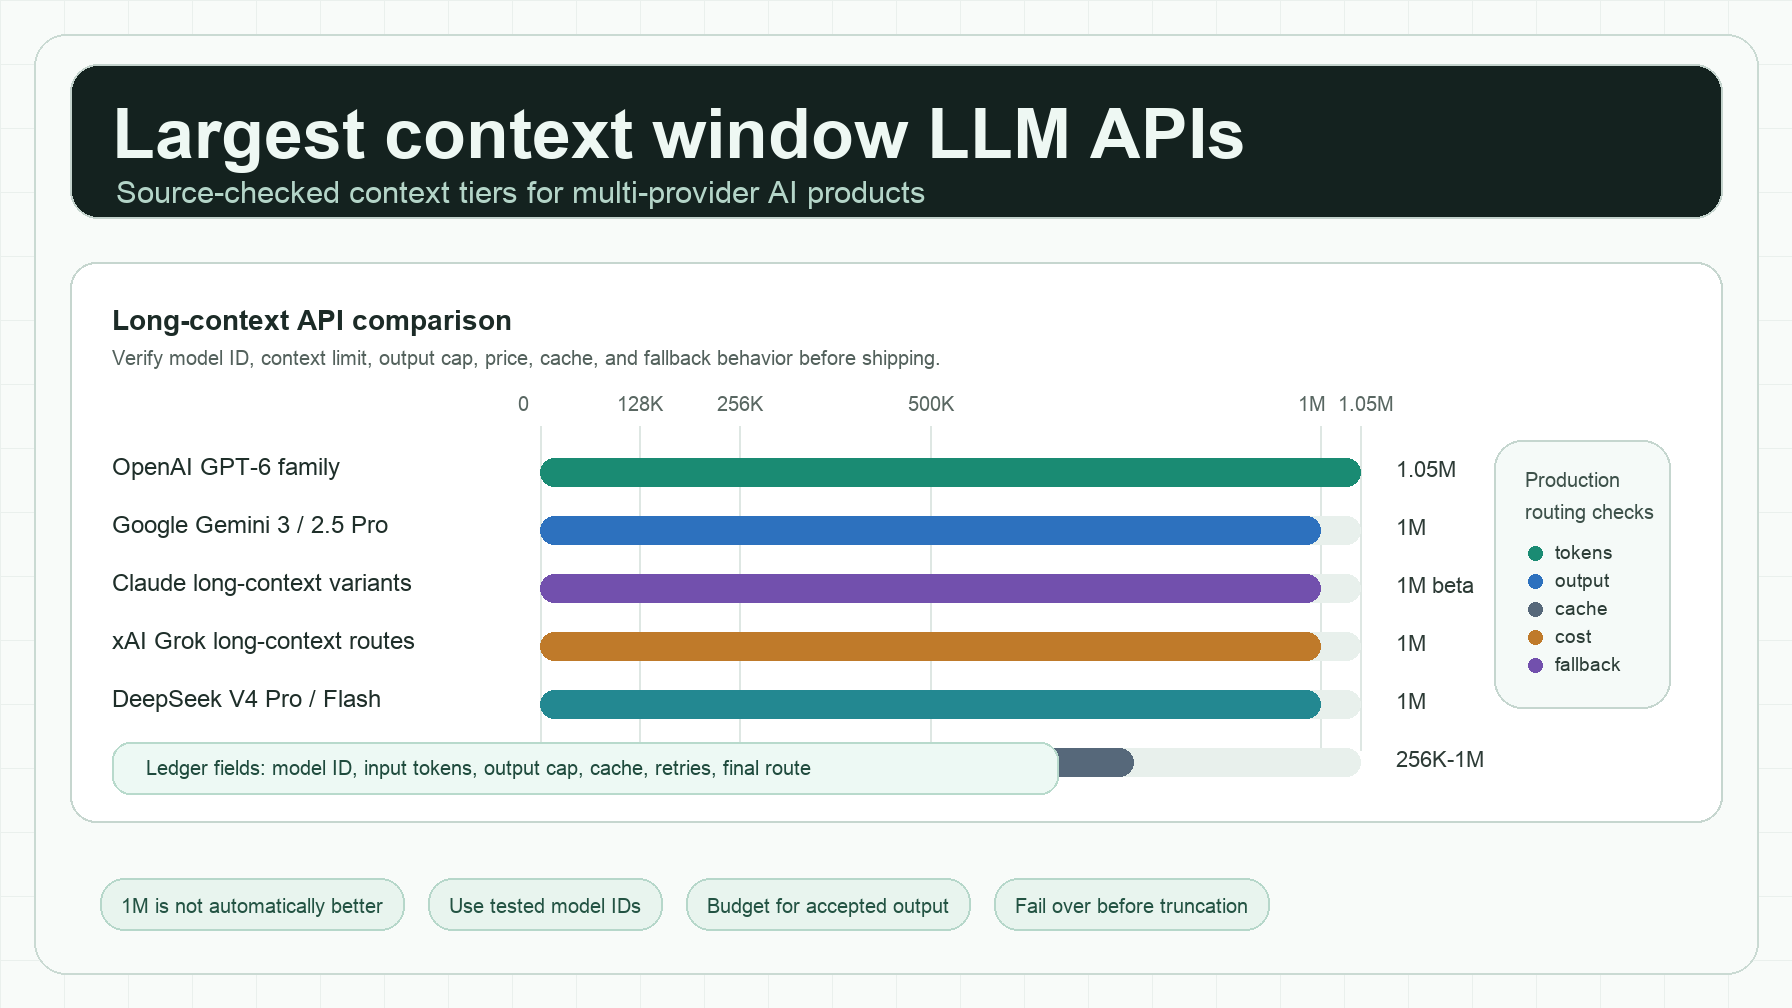
Cửa sổ ngữ cảnh LLM: Khái niệm, kích thước của từng mô hình lớn và cách sử dụng (tháng 10 năm 2026)
Cửa sổ ngữ cảnh LLM là bộ nhớ làm việc của mô hình cho mỗi yêu cầu. Tìm hiểu ý nghĩa của 128K, 200K và 1M token, giới hạn công bố của các mô hình lớn trong tháng 10 năm 2026, giá ngữ cảnh dài và mã đếm token.
API LLM miễn phí (2026): So sánh 10 lựa chọn theo giới hạn thực tế, mô hình và điểm cần lưu ý
Mười API LLM miễn phí được kiểm tra trên tài liệu chính thức vào tháng 10/2026: cái gì miễn phí, giới hạn chính xác, điểm cần lưu ý và code để chuyển đổi giữa chúng.

So sánh giá mô hình AI: Chi phí Token, Hình ảnh và Video trong một bảng điều khiển
So sánh giá mô hình AI trên các tuyến API văn bản, hình ảnh, video và đa nhà cung cấp với một bảng điều khiển theo dõi chi phí cho mỗi kết quả được chấp nhận.
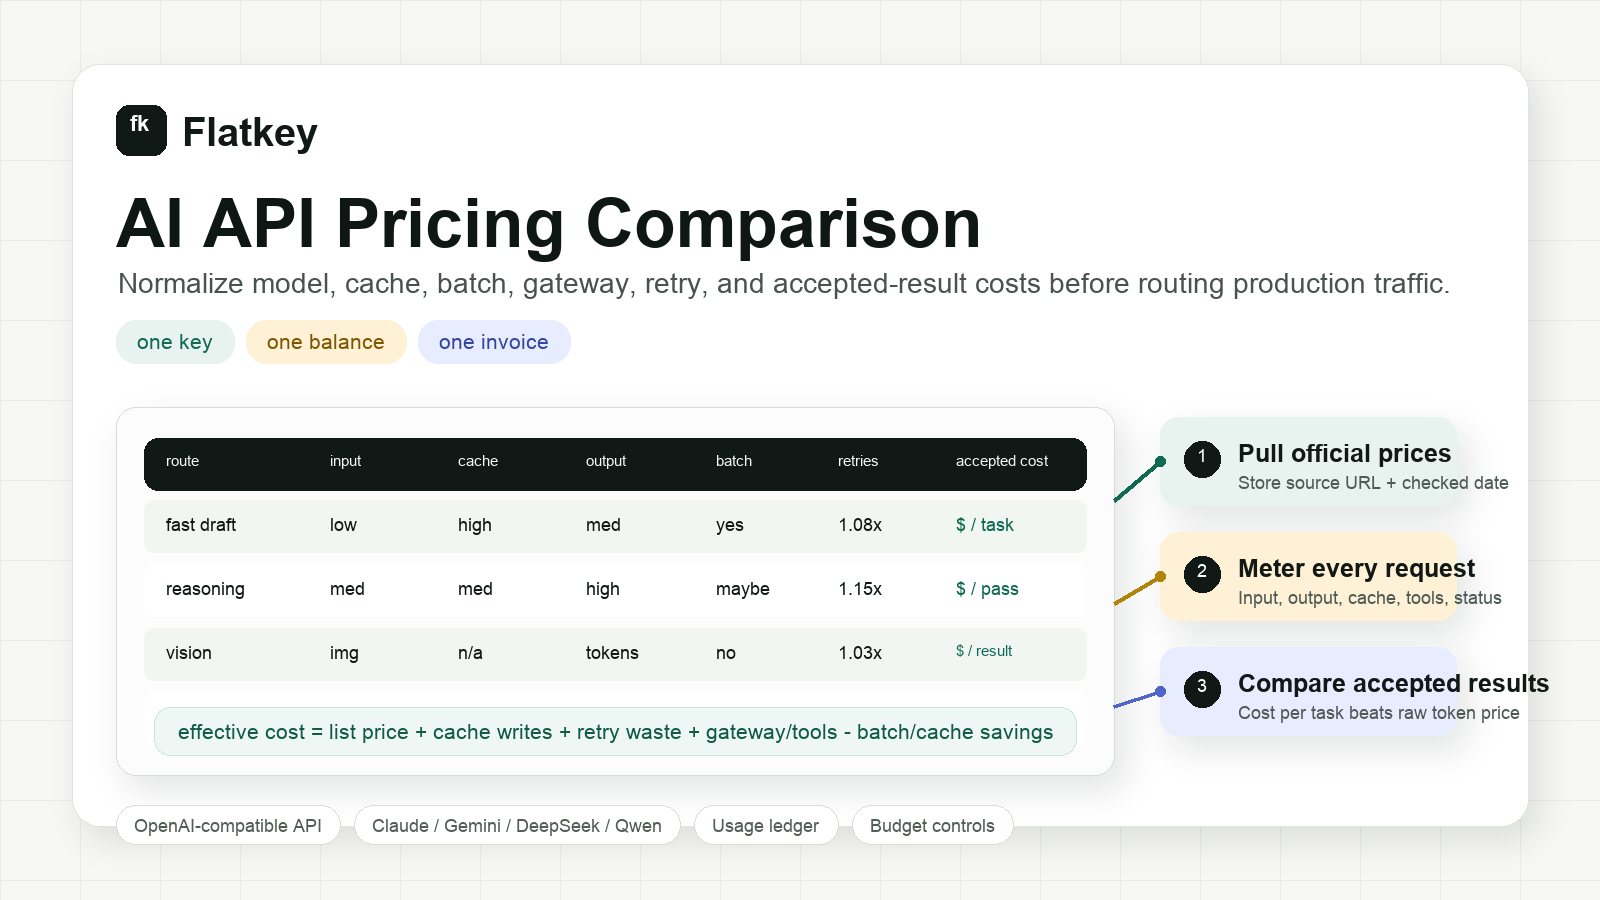
So sánh giá AI API: Chi phí model, cache, batch và gateway
Một khung so sánh giá AI API thực tiễn dành cho lập trình viên, đội sản phẩm và đội mua sắm, so sánh chi phí model, cache, batch, gateway, retry và kết quả được chấp nhận.
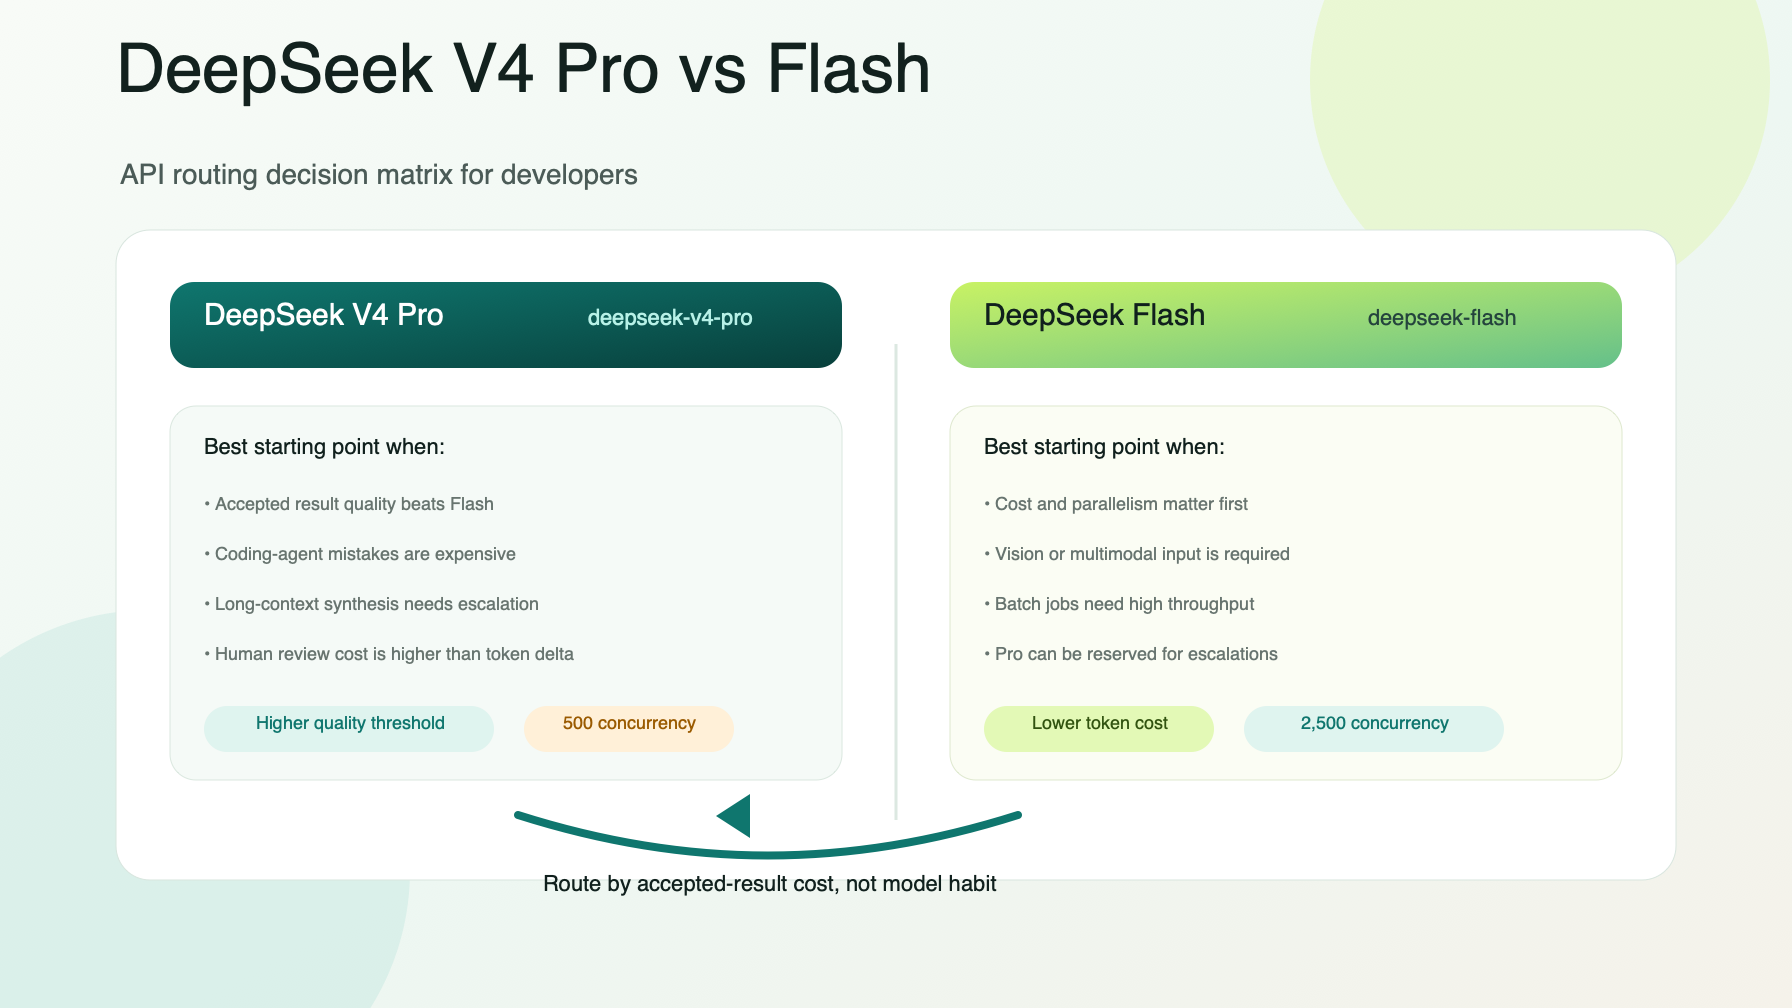
DeepSeek V4 Pro vs Flash: Mô hình nào phù hợp với quy trình API của bạn?
So sánh DeepSeek V4 Pro vs Flash cho định tuyến API, giá, khả năng xử lý hình ảnh, đồng thời, chi phí cache, và khi nào nên dùng Pro hoặc Flash.
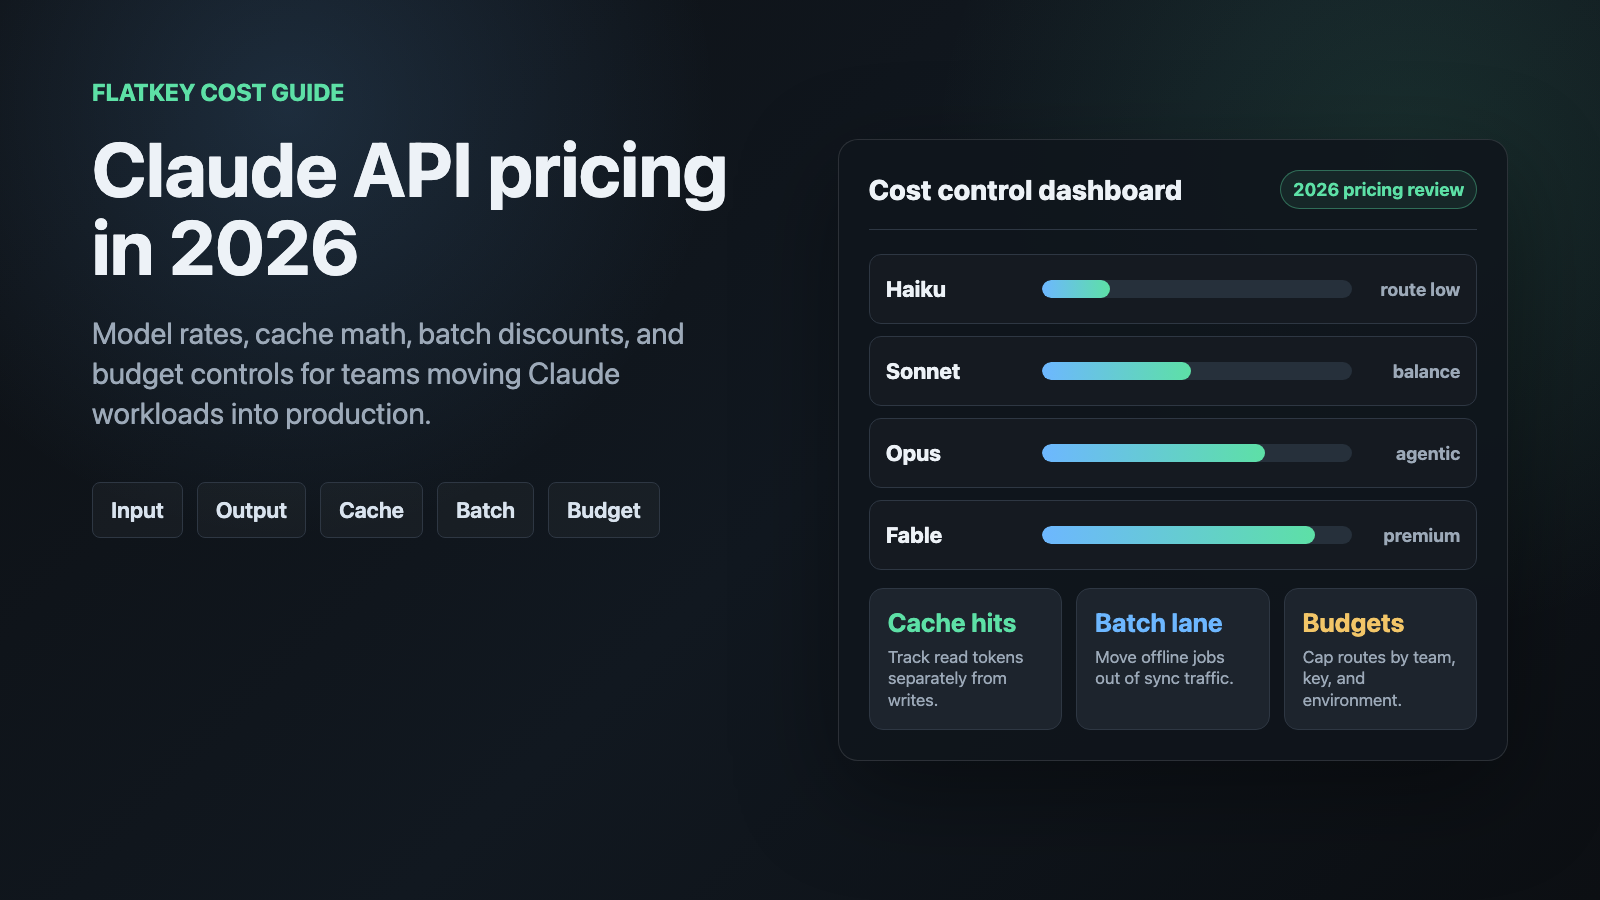
Mô hình Claude nào lập trình tốt nhất? Opus 5.5 so với Sonnet 5.5, Haiku 5.5 và Fable 5.1 (2026)
Bạn nên dùng mô hình Claude nào để lập trình trong năm 2026? Hướng dẫn chọn Opus 5.5, Sonnet 5.5, Haiku 5.5 và Fable 5.1 theo từng tác vụ, kèm giá chính thức, cách tính chi phí phiên làm việc, bí danh trong Claude Code và ví dụ API có thể chạy ngay.
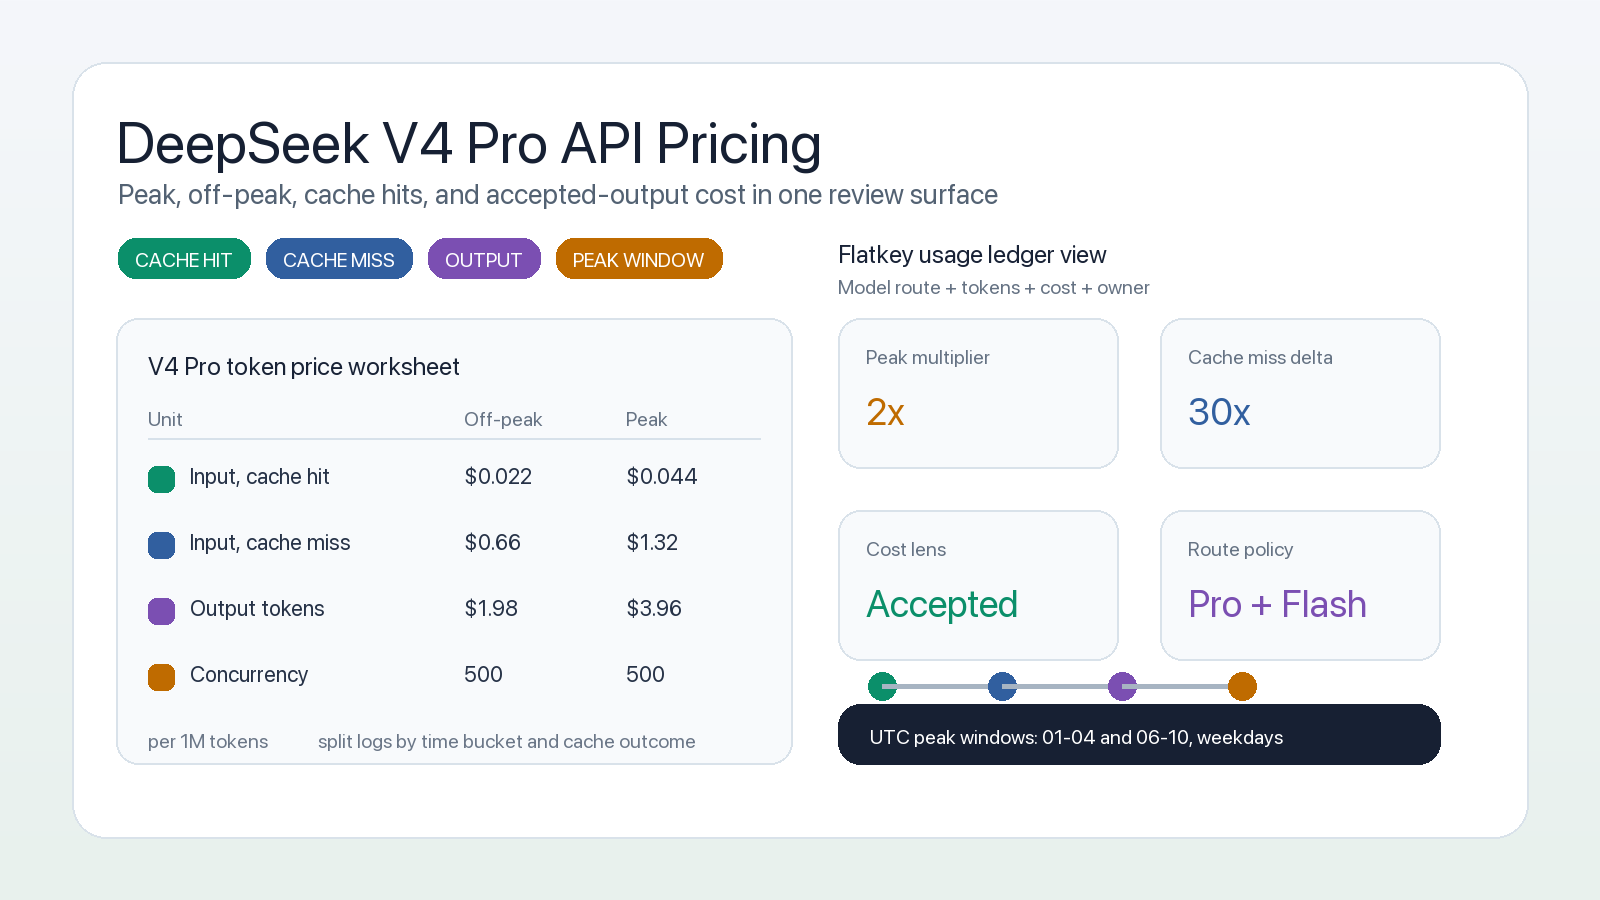
Giá API DeepSeek V4 Pro: giờ cao điểm, thấp điểm và chi phí cache
Mức giá API DeepSeek V4 Pro hiện tại với giá theo giờ cao điểm/thấp điểm, phép tính cache-hit và bảng tính kiểm soát chi phí cho nhà phát triển và đội mua sắm.
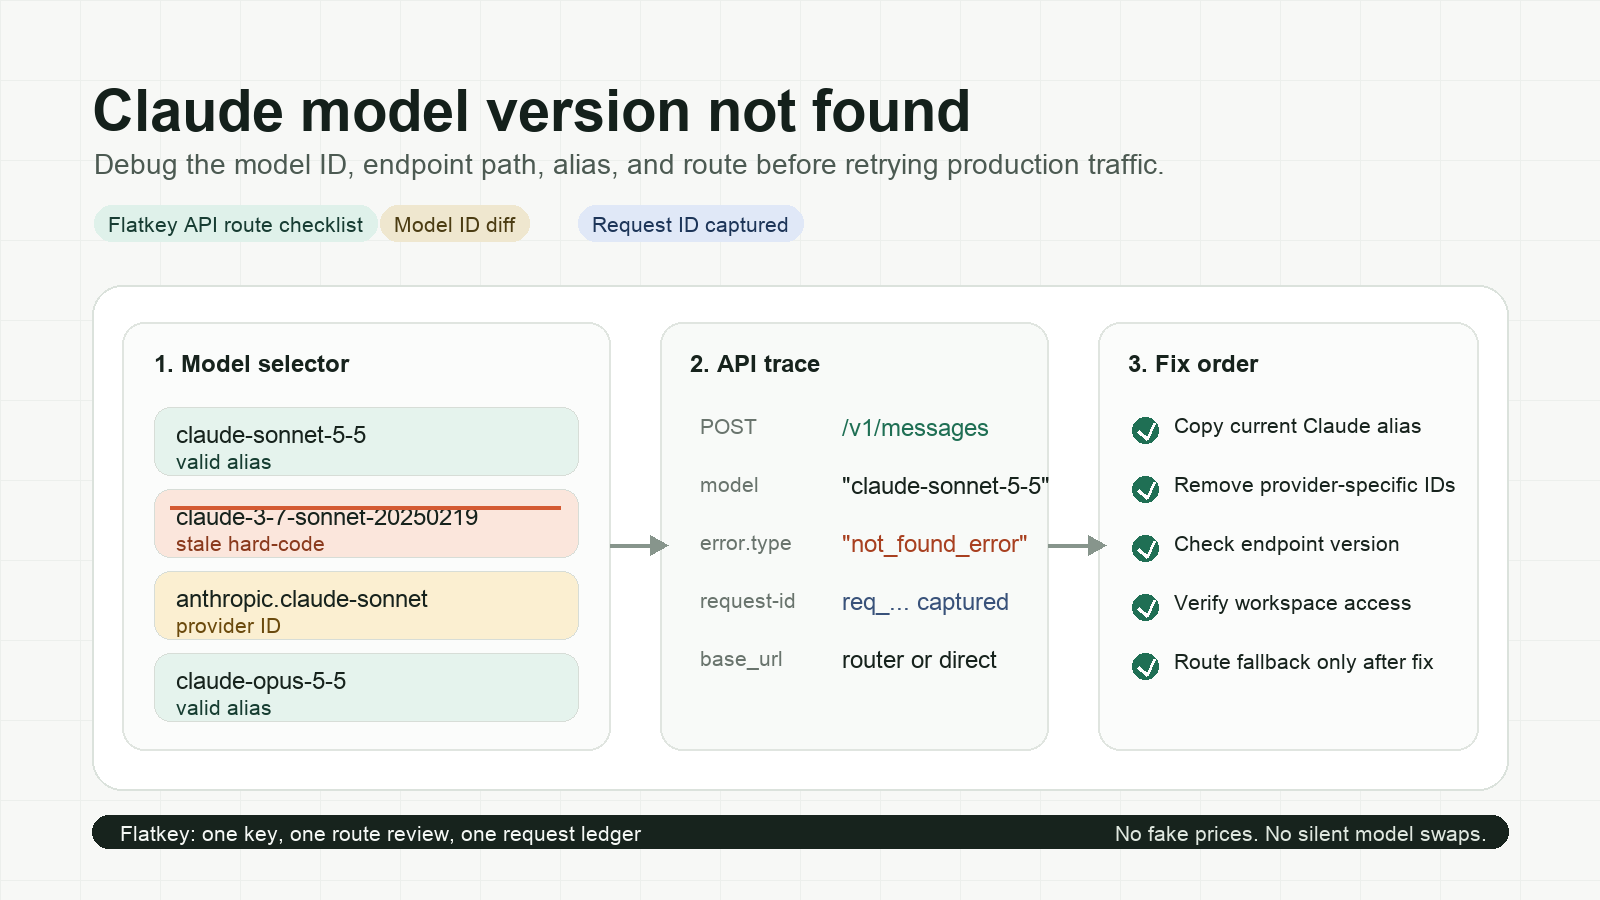
Claude Model Version Not Found: Sửa Sai Model ID, Alias và API Route
Một runbook gỡ lỗi thực tế cho lỗi không tìm thấy phiên bản model Claude trên các API gốc của Anthropic, bộ định tuyến, ID của nhà cung cấp đám mây, cấu hình agent và cơ chế dự phòng trong production.
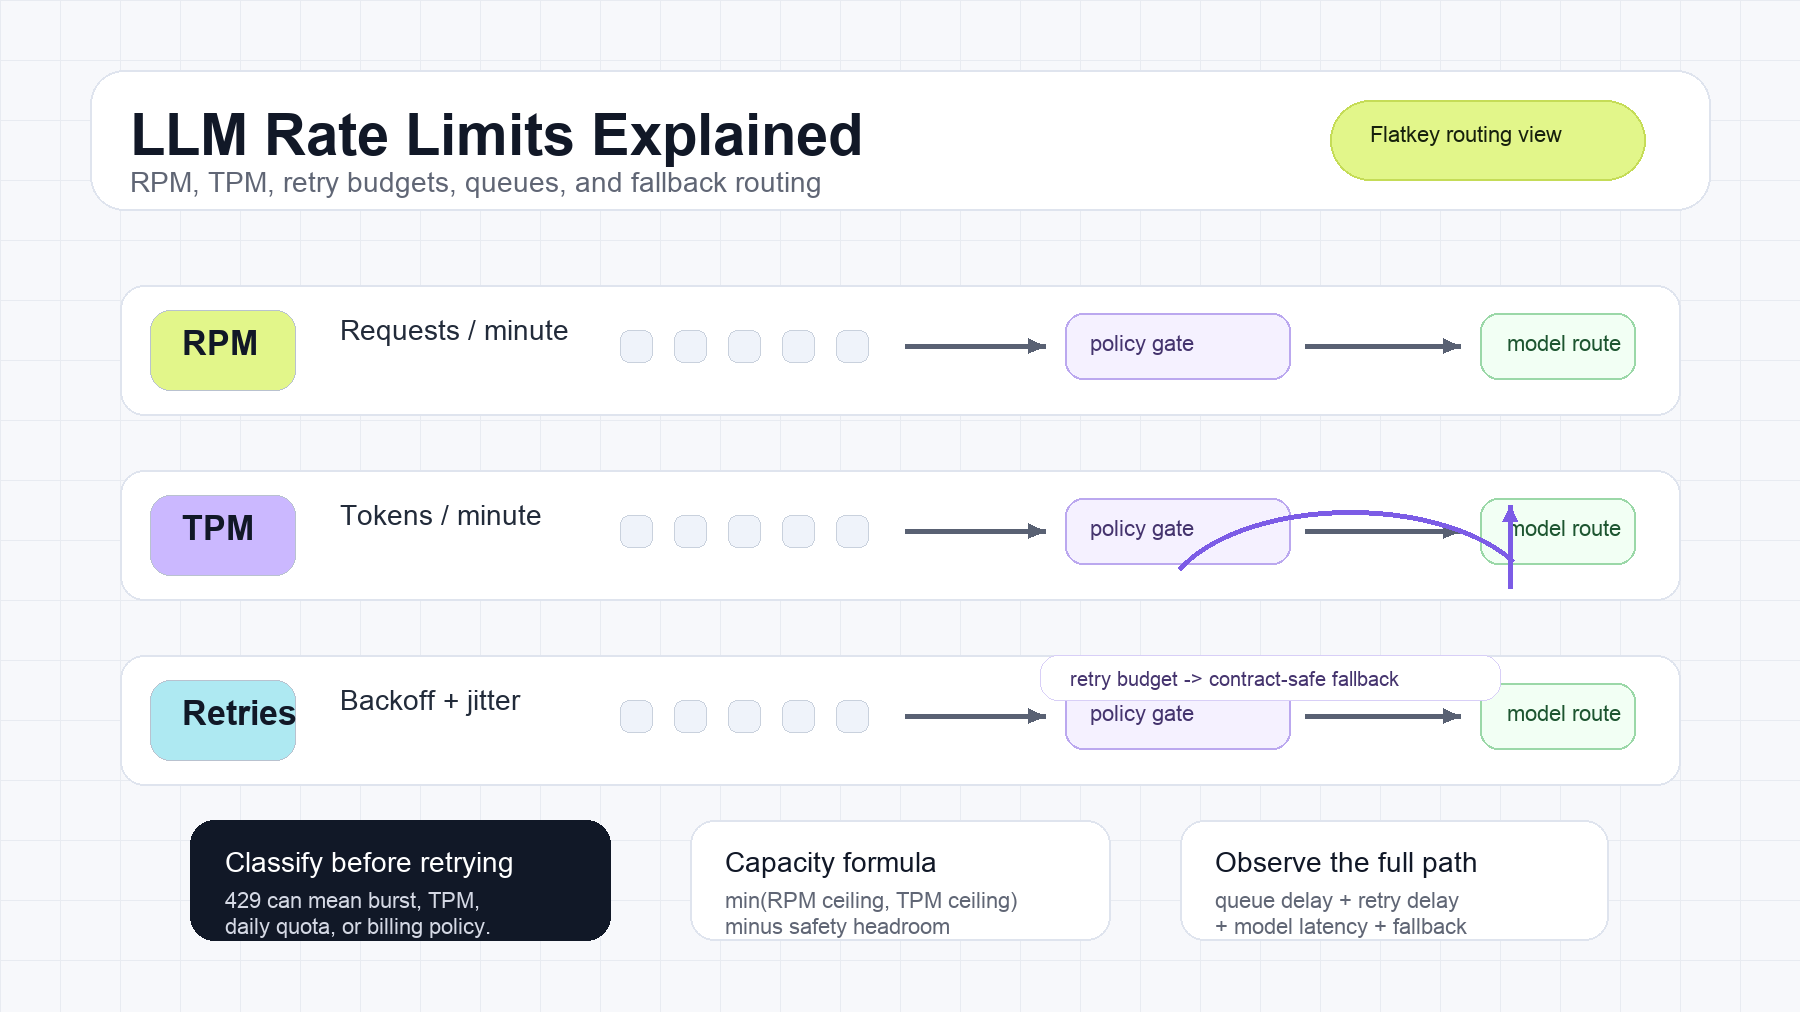
Giải thích giới hạn tốc độ LLM: RPM, TPM và cơ chế thử lại
Hiểu giới hạn tốc độ của LLM, RPM, TPM, lỗi 429, Retry-After, exponential backoff, retry budgets, hàng đợi và định tuyến dự phòng.

Truy cập API GLM-5: Bảng giá và thiết lập tương thích OpenAI
So sánh giá API của họ GLM-5, model ID, cửa sổ ngữ cảnh và các mẫu thiết lập tương thích OpenAI cho Z.AI và Flatkey.
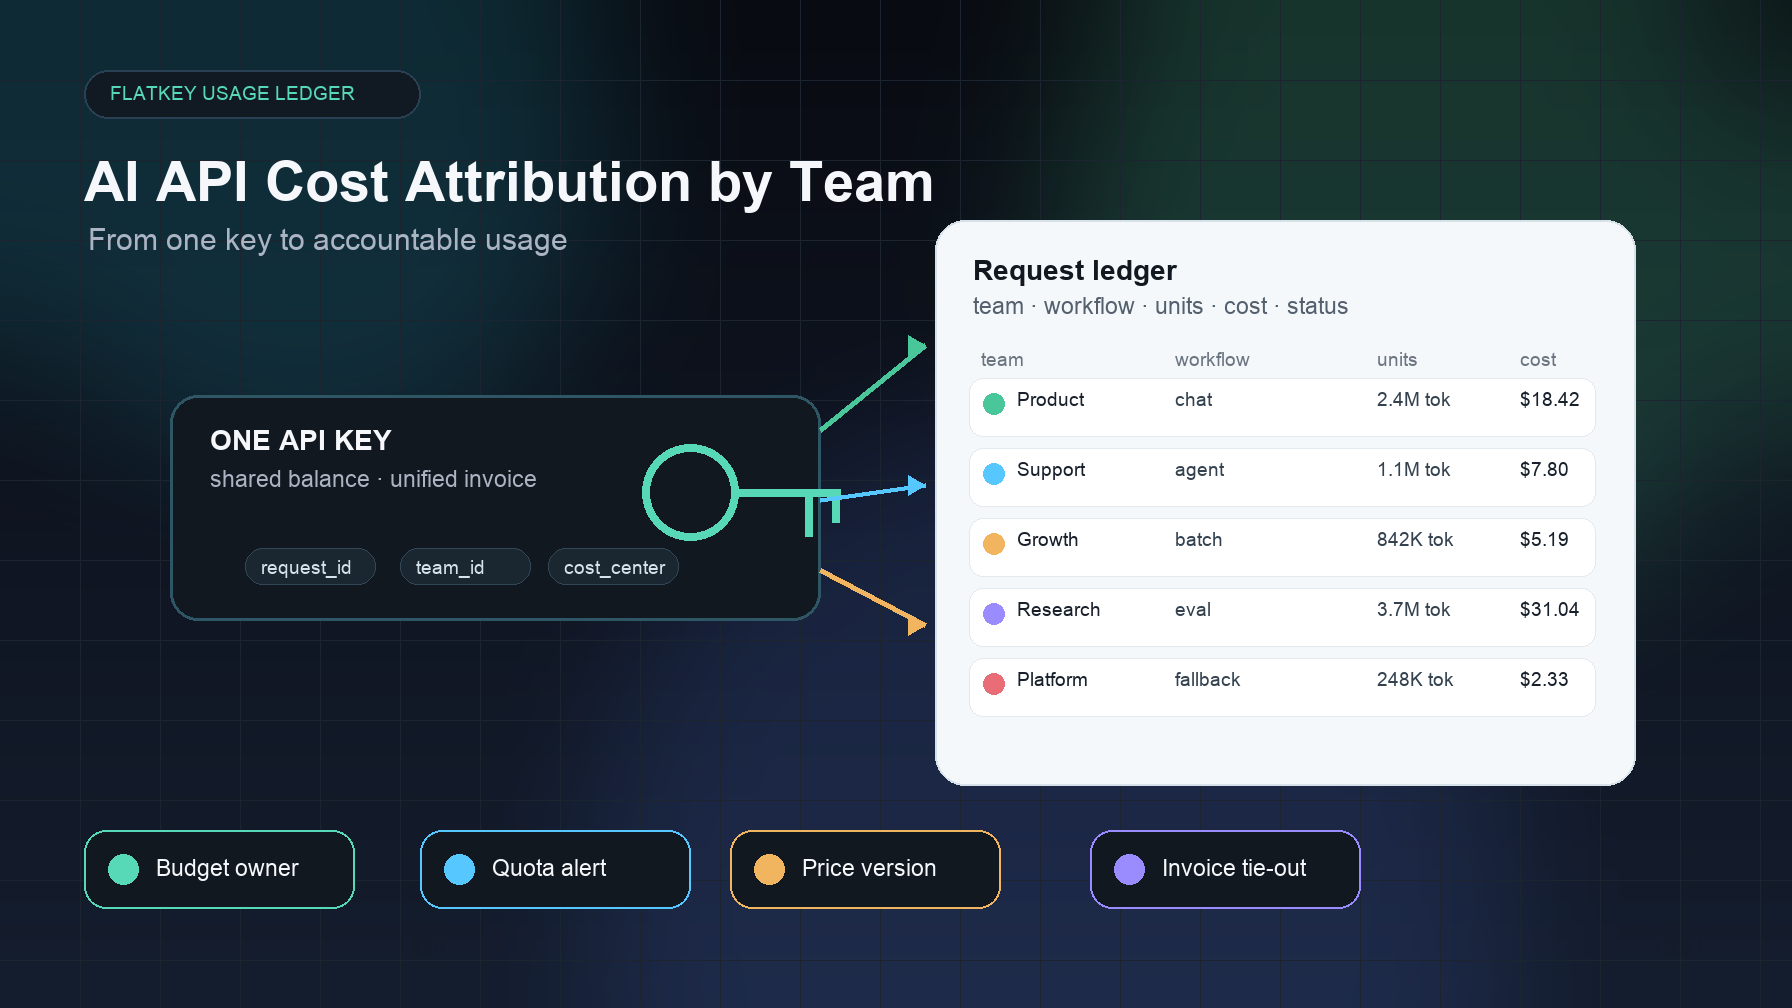
Phân bổ chi phí AI API theo nhóm: Từ một khóa đến mức sử dụng có trách nhiệm
Xây dựng phân bổ chi phí AI API theo nhóm với thẻ yêu cầu, ranh giới sub-key, sổ theo dõi sử dụng, hạn mức và rà soát tài chính hàng tháng.
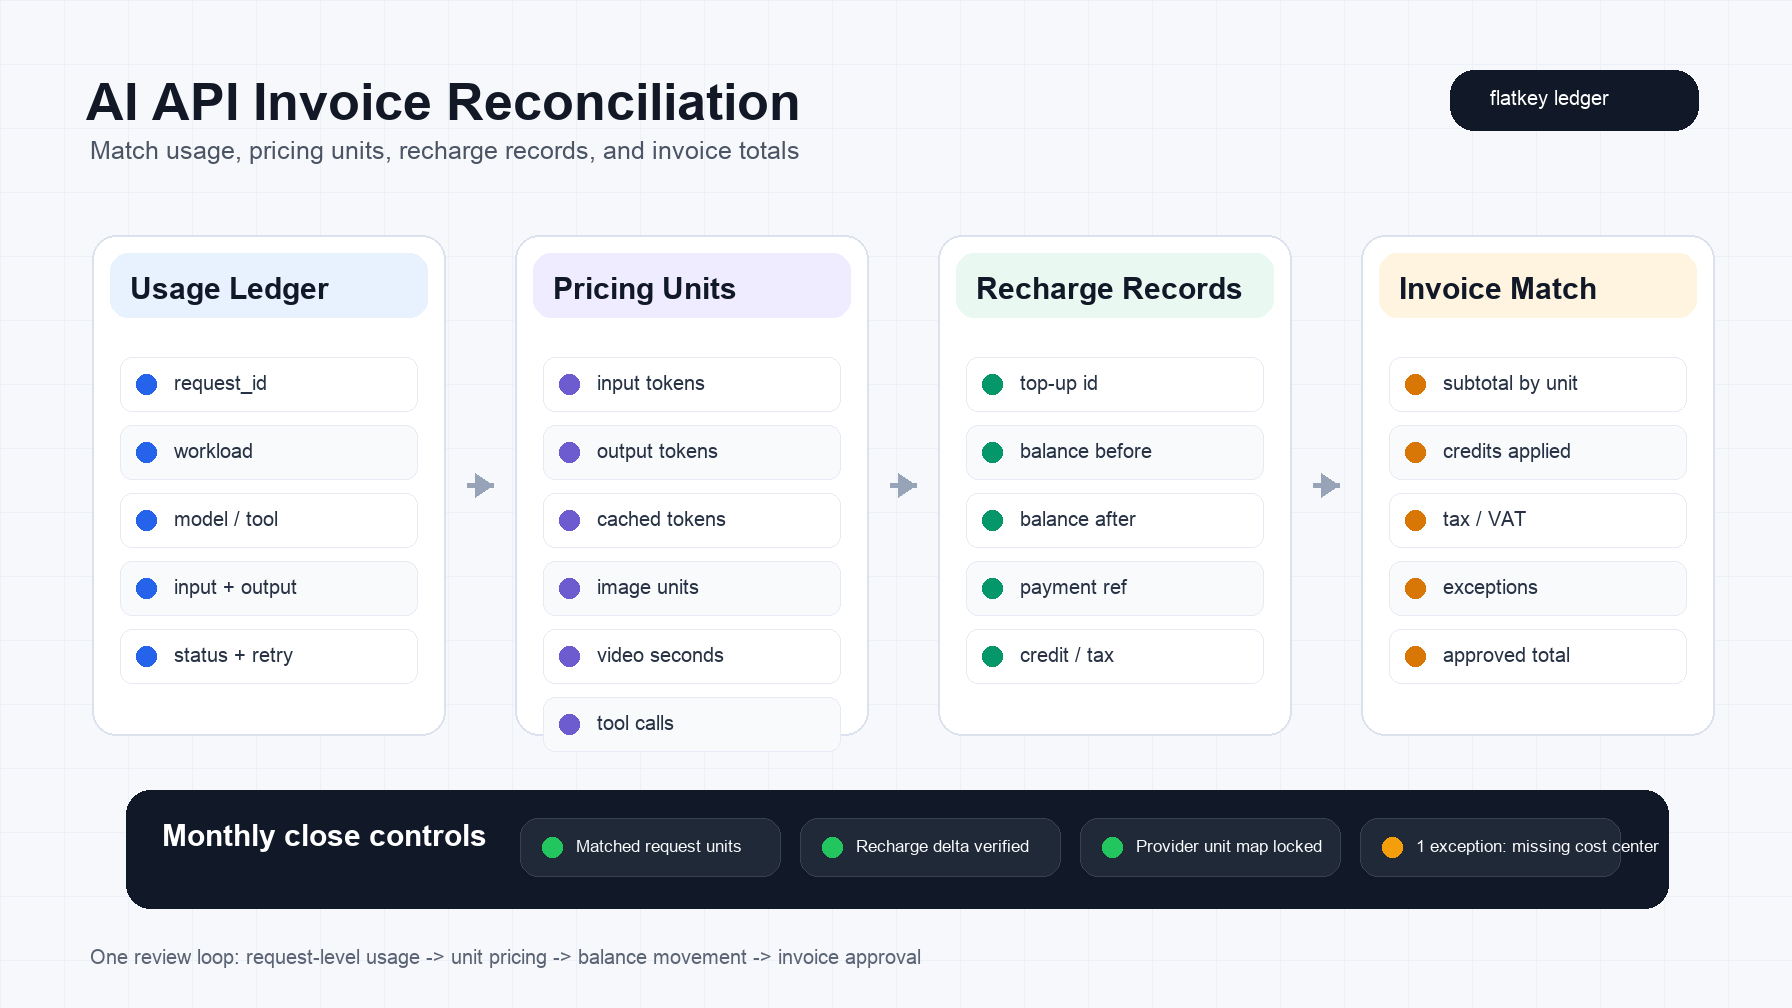
Đối soát hóa đơn AI API: Khớp mức sử dụng, đơn vị giá và bản ghi nạp tiền
Đối soát hóa đơn AI API bằng cách khớp sổ ghi mức sử dụng, đơn vị giá, bản ghi nạp tiền, biến động số dư, tín dụng, thuế và tổng tiền hóa đơn.

Giá API Anthropic (tháng 10/2026): Mọi mô hình Claude, cache, Batch và cách tính chi phí thực tế
Toàn bộ giá API Anthropic tháng 10/2026, từ Haiku 5.5 ở mức $0,10/$0,50 đến Fable 5.1 ở mức $10/$50, kèm cache, Batch API, lưu trú dữ liệu, chế độ nhanh, giới hạn chi tiêu và ngân sách hằng tháng.
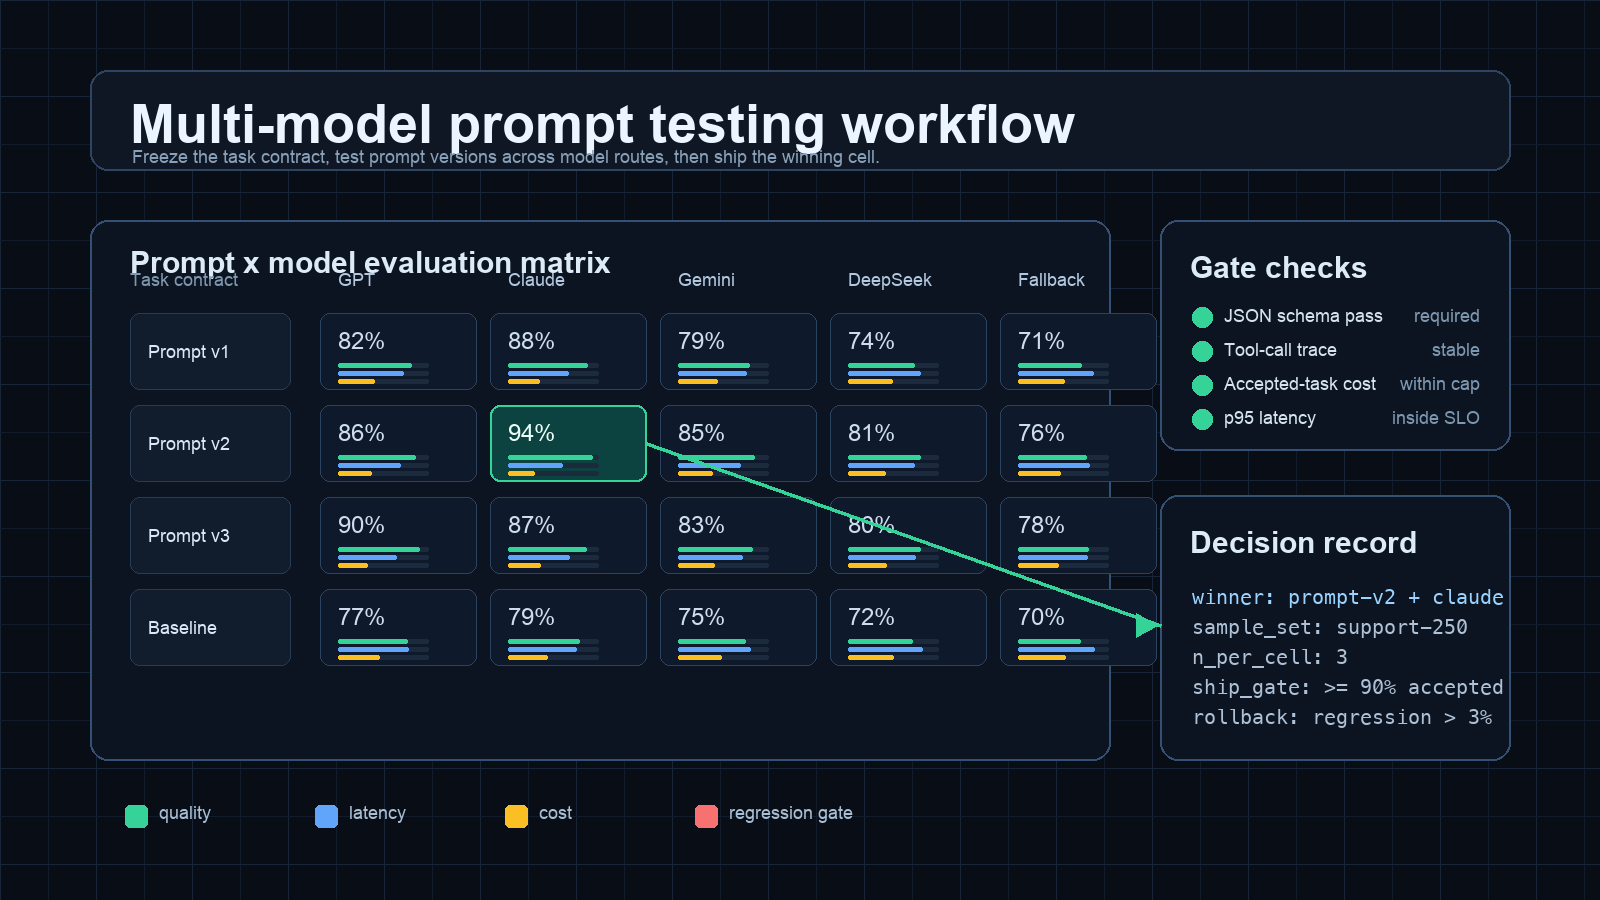
Quy trình kiểm thử prompt đa mô hình: Ma trận đánh giá cho các nhóm sản phẩm AI
Chạy quy trình kiểm thử prompt đa mô hình với các ma trận prompt/model, bộ kiểm tra, chi phí cho mỗi tác vụ được chấp nhận, ngưỡng độ trễ và hồ sơ triển khai.
Xây dựng nhanh hơn với một cổng AI.
Dùng flatkey.ai để quản lý mô hình, khóa, tính phí và quan sát vận hành trong một nền tảng API.
Bắt đầu