Harga GPU H100: Harga, Faktor Biaya, dan Panduan Pembelian
Terakhir diperiksa: 22 Oktober 2026.
Harga GPU H100 bukanlah satu angka. Listing kartu, instans cloud delapan GPU, dan server siap produksi menjawab tiga pertanyaan pembelian yang berbeda. Jika sebuah penawaran tidak mencantumkan faktor bentuk, jumlah GPU, model penagihan, lokasi, dan infrastruktur yang disertakan, penawaran tersebut belum dapat dibandingkan.
Sebagai titik referensi bertanggal, listing marketplace untuk satu kartu H100 PCIe 80 GB dimulai dari $32.200 saat diperiksa. Contoh cloud publik berkisar dari harga terdaftar $2,89 per jam untuk pod H100 PCIe hingga $3,99 per jam untuk pod H100 SXM, sementara AWS mencantumkan P5 Capacity Block satu H100 seharga $5,97 per jam-akselerator. Angka-angka tersebut adalah contoh, bukan MSRP atau tarif universal: ketersediaan, wilayah, komitmen, bundel CPU/RAM, penyimpanan, dukungan, dan konfigurasi H100 yang tepat semuanya mengubah tagihan.
Panduan ini menunjukkan cara mengubah penawaran H100 menjadi sebuah keputusan, bukan sekadar harga utama yang menyesatkan.
Harga GPU H100: jawaban singkat
Gunakan unit yang sesuai dengan apa yang benar-benar Anda pengadaan:
| Apa yang Anda hargai | Referensi publik bertanggal | Apa arti angka tersebut dan apa yang tidak diartikan |
|---|---|---|
| Satu kartu H100 PCIe 80 GB | Dari $32.200 | Harga awal marketplace untuk sebuah kartu, bukan MSRP NVIDIA dan bukan server lengkap. |
| Satu pod cloud H100 PCIe | $2,89/jam | Contoh tarif pod publik; verifikasi tier cloud, wilayah, penyimpanan, dan bundel CPU/RAM saat checkout. |
| Satu pod cloud H100 SXM | $3,99/jam | Contoh tarif pod publik untuk faktor bentuk dan konfigurasi host yang dibundel berbeda. |
| AWS P5.4xlarge Capacity Block | $5,97/jam-akselerator | Produk kapasitas terjadwal dengan satu H100; ini bukan sewa satu kartu yang sebanding secara langsung. |
| Google Cloud A3 High | $88,49/jam-instans untuk 8 H100 | Sekitar $11,06 per jam-GPU setelah dibagi delapan, tetapi SKU tersebut mencakup satu mesin besar delapan GPU, bukan delapan kartu independen. |
Listing perangkat keras berasal dari halaman marketplace H100 PCIe 80 GB GPU Vendors. Tarif pod berasal dari halaman harga publik Runpod, yang diperbarui di sana pada 8 Oktober 2026. Angka AWS berasal dari tabel harga EC2 Capacity Blocks untuk ML; contoh Google berasal dari tabel harga VM yang dioptimalkan untuk akselerator. Periksa kembali setiap sumber sebelum persetujuan atau pembelian.
Kesimpulan praktisnya: gunakan harga GPU H100 untuk menyusun daftar opsi, tetapi gunakan anggaran beban kerja untuk mengambil keputusan.
Pertama, identifikasi H100 mana yang ditawarkan kepada Anda
Label “H100” menyembunyikan keputusan yang secara material memengaruhi kapabilitas dan biaya.
| Konfigurasi | Apa yang perlu diverifikasi sebelum membandingkan harga | Mengapa ini mengubah keputusan |
|---|---|---|
| H100 PCIe | Memori 80 GB, CPU/RAM host, aliran udara chassis, jumlah GPU, jaringan | Ini dapat menjadi opsi yang masuk akal untuk satu GPU atau skala lebih kecil, tetapi host dan jaringan tetap harus dihitung dalam total biaya. |
| H100 SXM | Memori 80 GB, platform bergaya HGX/DGX, topologi fabric, daya dan pendinginan | SXM lebih erat terkait dengan platform server berdensitas tinggi dan fabric multi-GPU; jangan bandingkan harga ekuivalen kartunya hanya dengan PCIe. |
| H100 NVL | SKU papan/pasangan/server yang tepat, memori yang dapat digunakan, interkoneksi, host yang disertakan | Label marketplace bervariasi. Konfirmasikan apa yang dimaksud sebagai satu “GPU” yang dapat ditagihkan dan apakah listing tersebut berupa kartu, pasangan, atau konfigurasi server. |
| Node 4 atau 8 GPU | Jumlah GPU, topologi NVLink/NVSwitch, NIC, penyimpanan lokal, ketentuan reservasi | Node sering kali merupakan unit pengadaan sebenarnya untuk pelatihan terdistribusi, bukan akselerator individual. |
Datasheet H100 NVIDIA mencantumkan 80 GB pada versi SXM dan PCIe, dengan bandwidth memori, batas daya, interkoneksi, dan opsi server yang berbeda. Datasheet tersebut menetapkan 3 TB/s dan hingga 700 W untuk versi SXM, dibandingkan 2 TB/s dan 350 W untuk versi PCIe, sehingga harga GPU H100 harus selalu mencantumkan faktor bentuk dan platform dalam item baris yang sama. Baca datasheet NVIDIA H100 bersamaan dengan penawaran, alih-alih memperlakukan “H100 80 GB” sebagai spesifikasi lengkap.
Untuk panduan arsitektur dan penerapan yang lebih mendalam, lihat panduan GPU NVIDIA H100 kami. Jika pilihannya sebenarnya antara generasi, bandingkan beban kerja dan biaya output yang diterima dalam H100 vs. A100 atau panduan harga GPU H200 sebelum menganggap tarif per jam yang lebih rendah sebagai kemenangan.
Mengapa harga GPU H100 yang sama dapat menghasilkan tagihan bulanan yang sangat berbeda
Tarif per jam hanyalah item baris akselerator. Rencana bulanan yang dapat digunakan memerlukan seluruh jalur penyampaian:
Cloud workload cost
= accelerator or instance rate × scheduled hours
+ attached storage
+ data transfer / egress
+ CPU, RAM, and networking not bundled in the rate
+ support, platform, and software charges
+ idle time, retries, and failed-job allowance
Google Cloud secara eksplisit memisahkan pertimbangan GPU, jenis mesin, penyimpanan, dan jaringan dalam dokumentasi harga GPU-nya. Ini merupakan pengingat yang berguna agar tidak mengalikan tarif GPU dengan 730 lalu menyebut hasilnya sebagai anggaran produksi.
Misalnya, 730 jam yang dipesan pada dua referensi tarif pod publik di atas akan berjumlah sekitar $2.110 per bulan untuk contoh PCIe $2,89/jam dan $2.913 per bulan untuk contoh SXM $3,99/jam, sebelum biaya apa pun di luar konfigurasi pod yang ditampilkan. Angka-angka tersebut adalah ilustrasi penganggaran, bukan penawaran harga.
Harga GPU H100 juga berubah berdasarkan model penagihan:
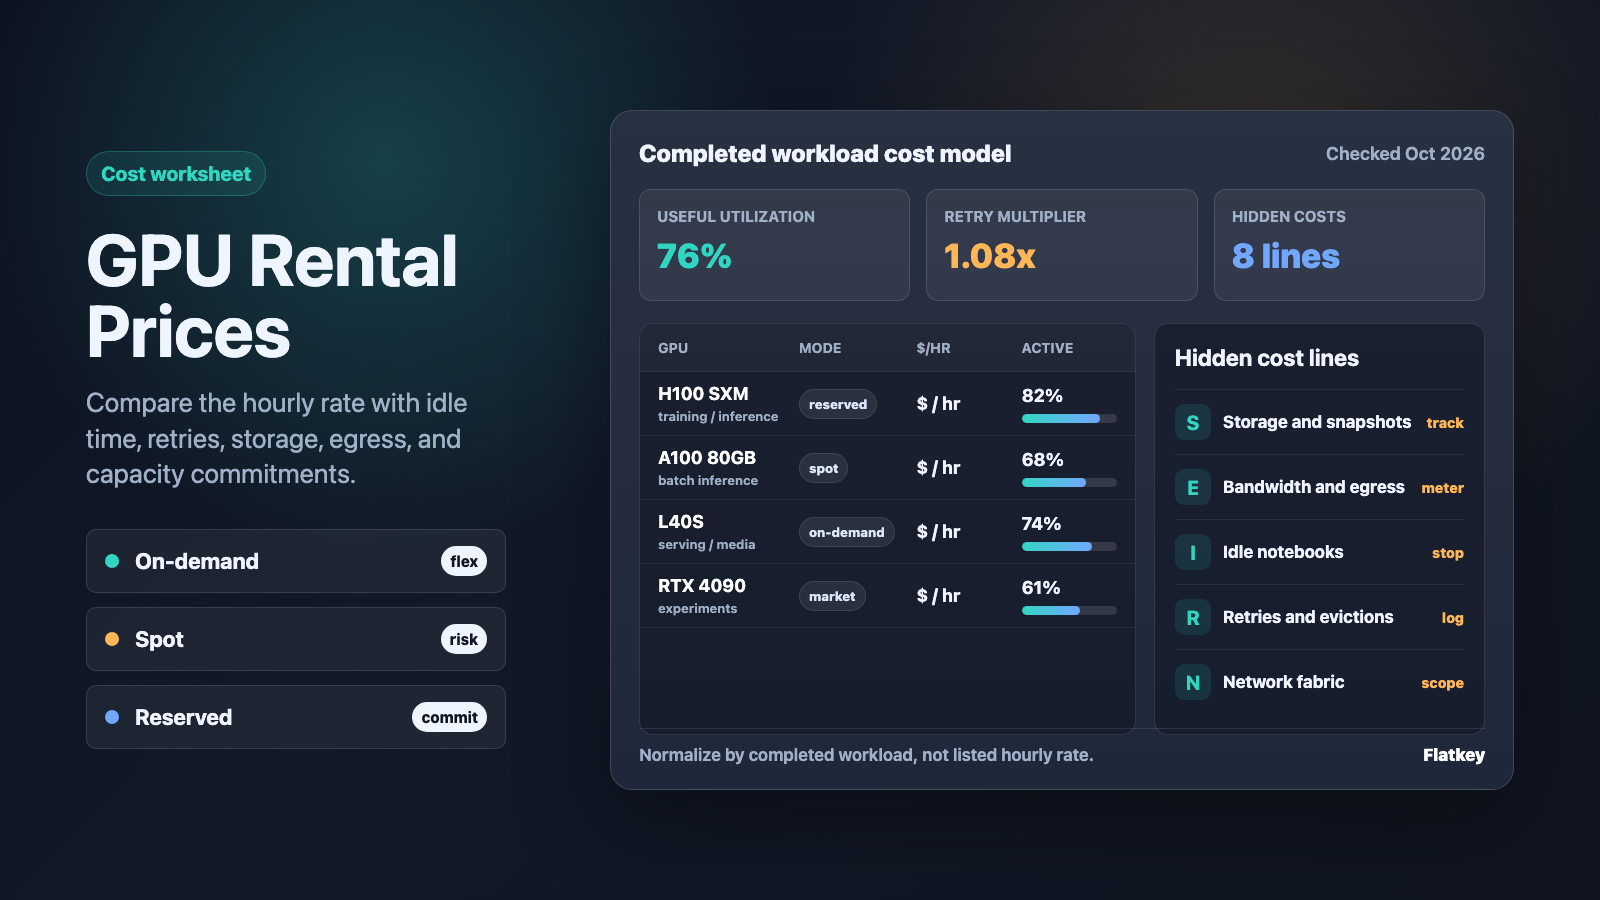
- On-demand cocok untuk pengembangan, evaluasi, dan utilisasi yang tidak pasti dalam jangka pendek. Anda membayar untuk fleksibilitas.
- Kapasitas spot atau interruptible dapat menurunkan tarif utama, tetapi pekerjaan pelatihan memerlukan checkpointing dan logika mulai ulang. Harga rendah bukan berarti murah jika gangguan menyebabkan hilangnya satu hari kerja.
- Kapasitas terpesan atau blok kapasitas menukar fleksibilitas dengan komitmen pasokan berbatas waktu. Tabel P5 AWS adalah salah satu contoh produk yang harus dibandingkan sebagai pembelian kapasitas terjadwal, bukan sekadar sebagai jam-GPU.
- Kapasitas cloud khusus atau berbasis kontrak dapat mencakup profil dukungan, ketersediaan, atau jaringan yang berbeda dari pod swalayan. Bandingkan cakupan kontraknya, bukan hanya model GPU-nya.
Panduan harga sewa GPU kami menjelaskan perbedaan on-demand, spot, dan reserved secara lebih terperinci. Untuk item baris yang cenderung muncul setelah prototipe lolos, gunakan panduan biaya tersembunyi cloud GPU sebagai daftar periksa pra-persetujuan.
Membeli H100: hitung TCO keseluruhan, bukan harga kartu
Membeli dapat masuk akal untuk beban kerja yang berjangka panjang dan dapat diprediksi—tetapi listing kartu hanyalah awal. Gunakan model kepemilikan ini:
Monthly owned-capacity cost
= (all-in acquisition cost − expected residual value) ÷ depreciation months
+ power and cooling
+ rack or colocation
+ network and storage
+ warranty, spares, and support
+ platform operations and on-call time
+ downtime / utilization reserve
Biaya akuisisi keseluruhan harus mencakup konfigurasi akselerator yang tepat, server atau platform HGX yang kompatibel, CPU, memori, NIC, penyimpanan, distribusi daya, pengiriman, pajak, instalasi, dan dukungan. Untuk sistem SXM, meminta penawaran harga kartu saja sangat mungkin mengabaikan komponen yang membuat konfigurasi tersebut dapat diterapkan.
Berikut cara yang tepat untuk menafsirkan referensi PCIe $32.200:
- Ini adalah harga awal marketplace untuk satu kartu, bukan harga pembelian tervalidasi untuk organisasi Anda.
- Dibandingkan dengan ilustrasi sewa $2,89/jam, $32.200 setara dengan kira-kira 11.142 jam-GPU, atau sekitar 15,3 bulan pada 730 jam yang dipesan per bulan.
- Perhitungan tersebut bukan rekomendasi untuk membeli. Perhitungan ini tidak mencakup server, daya, pendinginan, jaringan, dukungan, pembiayaan, dan risiko utilisasi. Pada utilisasi 50%, waktu kalender yang diperlukan untuk menggunakan 11.142 jam tersebut menjadi dua kali lipat.
Inilah alasan harga GPU H100 yang tampak menguntungkan sering kali gagal dalam evaluasi titik impas yang nyata. Pertama, hitung biaya pekerjaan yang selesai dan diterima—bukan sekadar biaya per jam akselerator yang dialokasikan.
Lembar kerja pembelian H100 yang dapat disalin
Gunakan ini sebelum Anda meminta penawaran harga atau menyetujui komitmen cloud.
| Pertanyaan | Catat ini | Mengapa penting |
|---|---|---|
| Apa SKU yang tepat? | PCIe, SXM, NVL; memori; jumlah GPU; status baru/rekondisi | Mencegah perbandingan kartu/server/pasangan disamarkan sebagai perbandingan harga. |
| Apa yang dibutuhkan beban kerja? | VRAM puncak, jumlah GPU, interkoneksi, target throughput/latensi, persistensi | Mencegah harga GPU H100 yang lebih rendah mengarahkan Anda ke konfigurasi yang tidak dapat digunakan. |
| Seberapa sibuk perangkat ini akan digunakan? | Jam-GPU terjadwal/bulan dan utilisasi yang diharapkan | Menentukan apakah fleksibilitas atau kapasitas milik sendiri berpeluang lebih unggul. |
| Apa saja yang termasuk? | vCPU, RAM, disk lokal, penyimpanan persisten, NIC, egress, dukungan, SLA | Mengungkap biaya yang tidak muncul dalam tarif akselerator. |
| Apa yang terjadi saat terjadi interupsi? | Interval checkpoint, waktu pemulihan, biaya percobaan ulang, cadangan kapasitas | Membuat harga spot dapat dibandingkan dengan kapasitas yang andal. |
| Apa metrik bisnisnya? | Pekerjaan yang diterima, token, gambar, langkah pelatihan, atau eksperimen yang selesai | Memungkinkan Anda mengoptimalkan biaya per hasil yang bermanfaat alih-alih biaya per jam. |
| Apa alternatifnya? | GPU alternatif, wilayah lain, API terkelola, atau kebijakan antrean | Mengurangi biaya akibat kekurangan kapasitas dan peluncuran yang gagal. |
Daftar periksa perbandingan penawaran harga
Mintalah setiap pemasok menjawab pertanyaan-pertanyaan ini secara tertulis:
- Apakah penawaran ini untuk kartu PCIe, modul SXM, konfigurasi NVL, server lengkap, atau alokasi klaster?
- Berapa banyak H100 yang disertakan, dan interkoneksi apa yang menghubungkannya?
- Item CPU, RAM, penyimpanan, jaringan, daya, dan dukungan mana yang disertakan?
- Apakah harganya on-demand, spot, reserved, terjadwal, prabayar, atau blok kapasitas?
- Wilayah atau fasilitas mana yang berlaku, dan apakah kapasitas benar-benar tersedia untuk jangka waktu yang diminta?
- Biaya mana yang tetap berada di luar penawaran: penyimpanan, egress, lisensi, penyiapan, pajak, atau dukungan?
- Bagaimana kebijakan pembatalan, interupsi, penggantian, dan dukungan perangkat keras?
- Uji beban kerja apa yang akan Anda jalankan untuk membandingkan biaya per hasil yang diterima?
Kapan menyewa, memesan, membeli, atau menggunakan API menjadi pilihan yang lebih baik
Pilih model operasional terlebih dahulu; harga GPU H100 kemudian jauh lebih mudah dievaluasi.
| Situasi | Biasanya mulai dengan | Alasan |
|---|---|---|
| Prototipe, eksperimen fine-tuning, atau permintaan yang tidak pasti | Sewa on-demand | Akses cepat dan tanpa komitmen modal; ukur utilisasi dan waktu menganggur. |
| Pekerjaan batch yang toleran terhadap kesalahan dengan checkpointing yang kuat | Kapasitas spot / interruptible | Dapat ekonomis ketika restart murah dan kehilangan kapasitas telah diperhitungkan. |
| Jangka waktu pelatihan yang dapat diprediksi dengan tenggat waktu ketat | Kapasitas reserved atau blok kapasitas | Anda membayar untuk jaminan waktu dan ketersediaan, selain komputasi. |
| Utilisasi tinggi yang berkelanjutan dengan tim platform yang berpengalaman | Beli atau kolokasi setelah model TCO menyeluruh | Kepemilikan mungkin layak hanya setelah fasilitas, dukungan, dan utilisasi dapat dipertanggungjawabkan. |
| Kasus penggunaan produk tidak mengharuskan menjalankan bobot kustom | Baseline API model | Bandingkan dengan jalur API sebelum memperoleh perangkat keras; batasan operasional mungkin lebih penting daripada harga GPU H100. |
Jika pilihan akhirnya adalah antara inferensi yang di-host sendiri dan antarmuka model terkelola, gunakan panduan cloud GPU vs. API model kami untuk menyusun perbandingan. API AI terpadu juga dapat mempermudah pengujian baseline terkelola di berbagai model sebelum berkomitmen pada jalur pengadaan perangkat keras.
Pertanyaan umum tentang harga H100
Berapa biaya untuk membeli GPU H100?
Tidak ada MSRP H100 publik universal yang dapat digunakan sebagai angka pengadaan. Harga GPU H100 bergantung pada faktor bentuk, penjual, dukungan, volume, lokasi, dan apakah penawaran tersebut untuk kartu atau sistem lengkap. Dalam snapshot panduan ini pada 22 Oktober 2026, sebuah marketplace mencantumkan kartu H100 PCIe 80 GB mulai dari $32.200. Perlakukan itu sebagai referensi bertanggal, lalu minta penawaran pemasok yang dirinci per item.
Berapa biaya menyewa H100 per jam?
Tarif publik dapat sangat berbeda menurut penyedia dan produk. Runpod mencantumkan H100 PCIe seharga $2,89/jam dan H100 SXM seharga $3,99/jam di halaman harganya, sementara AWS mencantumkan $5,97 per accelerator-hour untuk Capacity Block P5.4xlarge satu H100. Masing-masing mencakup model penyediaan yang berbeda, jadi jangan mengurutkannya hanya berdasarkan angkanya.
Apakah H100 SXM lebih mahal daripada H100 PCIe?
H100 SXM sering muncul dalam platform yang lebih mahal karena kebutuhan perangkat keras, daya, pendinginan, dan fabric berbeda. Bandingkan konfigurasi host yang tepat dan hasil pekerjaan yang telah diselesaikan. Pertanyaan yang relevan adalah apakah platform SXM cukup meningkatkan beban kerja Anda untuk menurunkan biaya per pekerjaan yang diterima, bukan apakah harga GPU H100-nya lebih rendah di spreadsheet.
Kapan membeli lebih menguntungkan daripada menyewa?
Hanya setelah biaya kapasitas milik sendiri yang menyeluruh lebih rendah daripada jalur cloud yang sebanding pada utilisasi realistis. Sertakan server, jaringan, daya, pendinginan, dukungan, cadangan untuk downtime, dan biaya pengoperasian platform. Perhitungan titik impas hanya untuk kartu adalah alat penyaringan, bukan keputusan.
Jadikan penawaran H100 berikutnya dapat dibandingkan
Harga GPU H100 menjadi berguna hanya ketika dikaitkan dengan konfigurasi dan beban kerja yang presisi. Mulailah dengan faktor bentuk GPU, normalisasi satuan waktu, tambahkan setiap item biaya infrastruktur, dan hitung biaya per hasil yang diselesaikan. Kemudian bandingkan fleksibilitas, risiko kapasitas, dan beban operasional—bukan hanya harga kartu atau tarif per jam.
Sebelum berkomitmen, jalankan satu beban kerja yang representatif pada dua atau tiga opsi yang layak. Pengujian kecil itu biasanya lebih murah daripada kemudian mengetahui bahwa harga GPU H100 terendah terkait dengan faktor bentuk yang salah, anggaran server yang tidak lengkap, atau SKU cloud yang sebenarnya tidak dapat digunakan oleh beban kerja Anda.