Цена GPU H100: стоимость, факторы ценообразования и руководство по покупке
Последняя проверка: 22 октября 2026 г.
Цена GPU H100 — это не одно число. Объявление о продаже карты, облачный инстанс с восемью GPU и готовый к эксплуатации сервер отвечают на три разные закупочные задачи. Если в предложении не указаны форм-фактор, количество GPU, модель оплаты, местоположение и включённая инфраструктура, его пока нельзя сопоставлять с другими.
В качестве актуальной контрольной точки: при проверке цена в объявлении маркетплейса на одну карту H100 PCIe 80 GB начиналась от $32,200. Примеры из публичных облаков варьировались от заявленных $2.89 в час за pod с H100 PCIe до $3.99 в час за pod с H100 SXM, тогда как AWS указывал для P5 Capacity Block с одним H100 цену $5.97 за accelerator-hour. Это примеры, а не рекомендованная розничная цена и не универсальный тариф: на итоговую сумму влияют доступность, регион, срок обязательств, комплект CPU/RAM, хранилище, поддержка и точная конфигурация H100.
Это руководство показывает, как превратить предложение по H100 в решение, а не в вводящую в заблуждение заголовочную цену.
Цена GPU H100: краткий ответ
Используйте единицу измерения, соответствующую тому, что вы фактически закупаете:
| Что вы оцениваете | Актуальная публичная справочная цена | Что означает и не означает это число |
|---|---|---|
| Одна карта H100 PCIe 80 GB | От $32,200 | Стартовая цена карты на маркетплейсе, а не рекомендованная розничная цена NVIDIA и не готовый сервер. |
| Один облачный pod с H100 PCIe | $2.89/час | Пример публичного тарифа pod; при оформлении проверьте облачный тариф, регион, хранилище и комплект CPU/RAM. |
| Один облачный pod с H100 SXM | $3.99/час | Пример публичного тарифа pod для другого форм-фактора и конфигурации хоста в комплекте. |
| AWS P5.4xlarge Capacity Block | $5.97/accelerator-hour | Продукт с зарезервированной мощностью по расписанию и одним H100; это не сопоставимая аренда одной карты. |
| Google Cloud A3 High | $88.49/instance-hour за 8 H100 | Примерно $11.06 за GPU-hour после деления на восемь, но SKU включает крупную восьми-GPU-машину, а не восемь независимых карт. |
Информация об аппаратном обеспечении взята со страницы маркетплейса GPU Vendors для H100 PCIe 80 GB. Тарифы pod приведены на странице публичных цен Runpod, обновлённой там 8 октября 2026 г. Значение AWS взято из таблицы цен EC2 Capacity Blocks for ML; пример Google — из таблицы цен на VM, оптимизированные для ускорителей. Повторно проверьте каждый источник перед согласованием или покупкой.
Практический вывод: используйте цену GPU H100, чтобы сформировать короткий список вариантов, но принимайте решение на основе бюджета рабочей нагрузки.
Сначала определите, на какой именно H100 вы получили предложение
За обозначением «H100» скрываются решения, существенно влияющие и на возможности, и на стоимость.
| Конфигурация | Что проверить перед сравнением цен | Почему это меняет решение |
|---|---|---|
| H100 PCIe | Память 80 GB, CPU/RAM хоста, охлаждение корпуса, количество GPU, сеть | Это может быть разумным вариантом для одного GPU или меньшего масштаба, но хост и сеть всё равно должны учитываться в общей стоимости. |
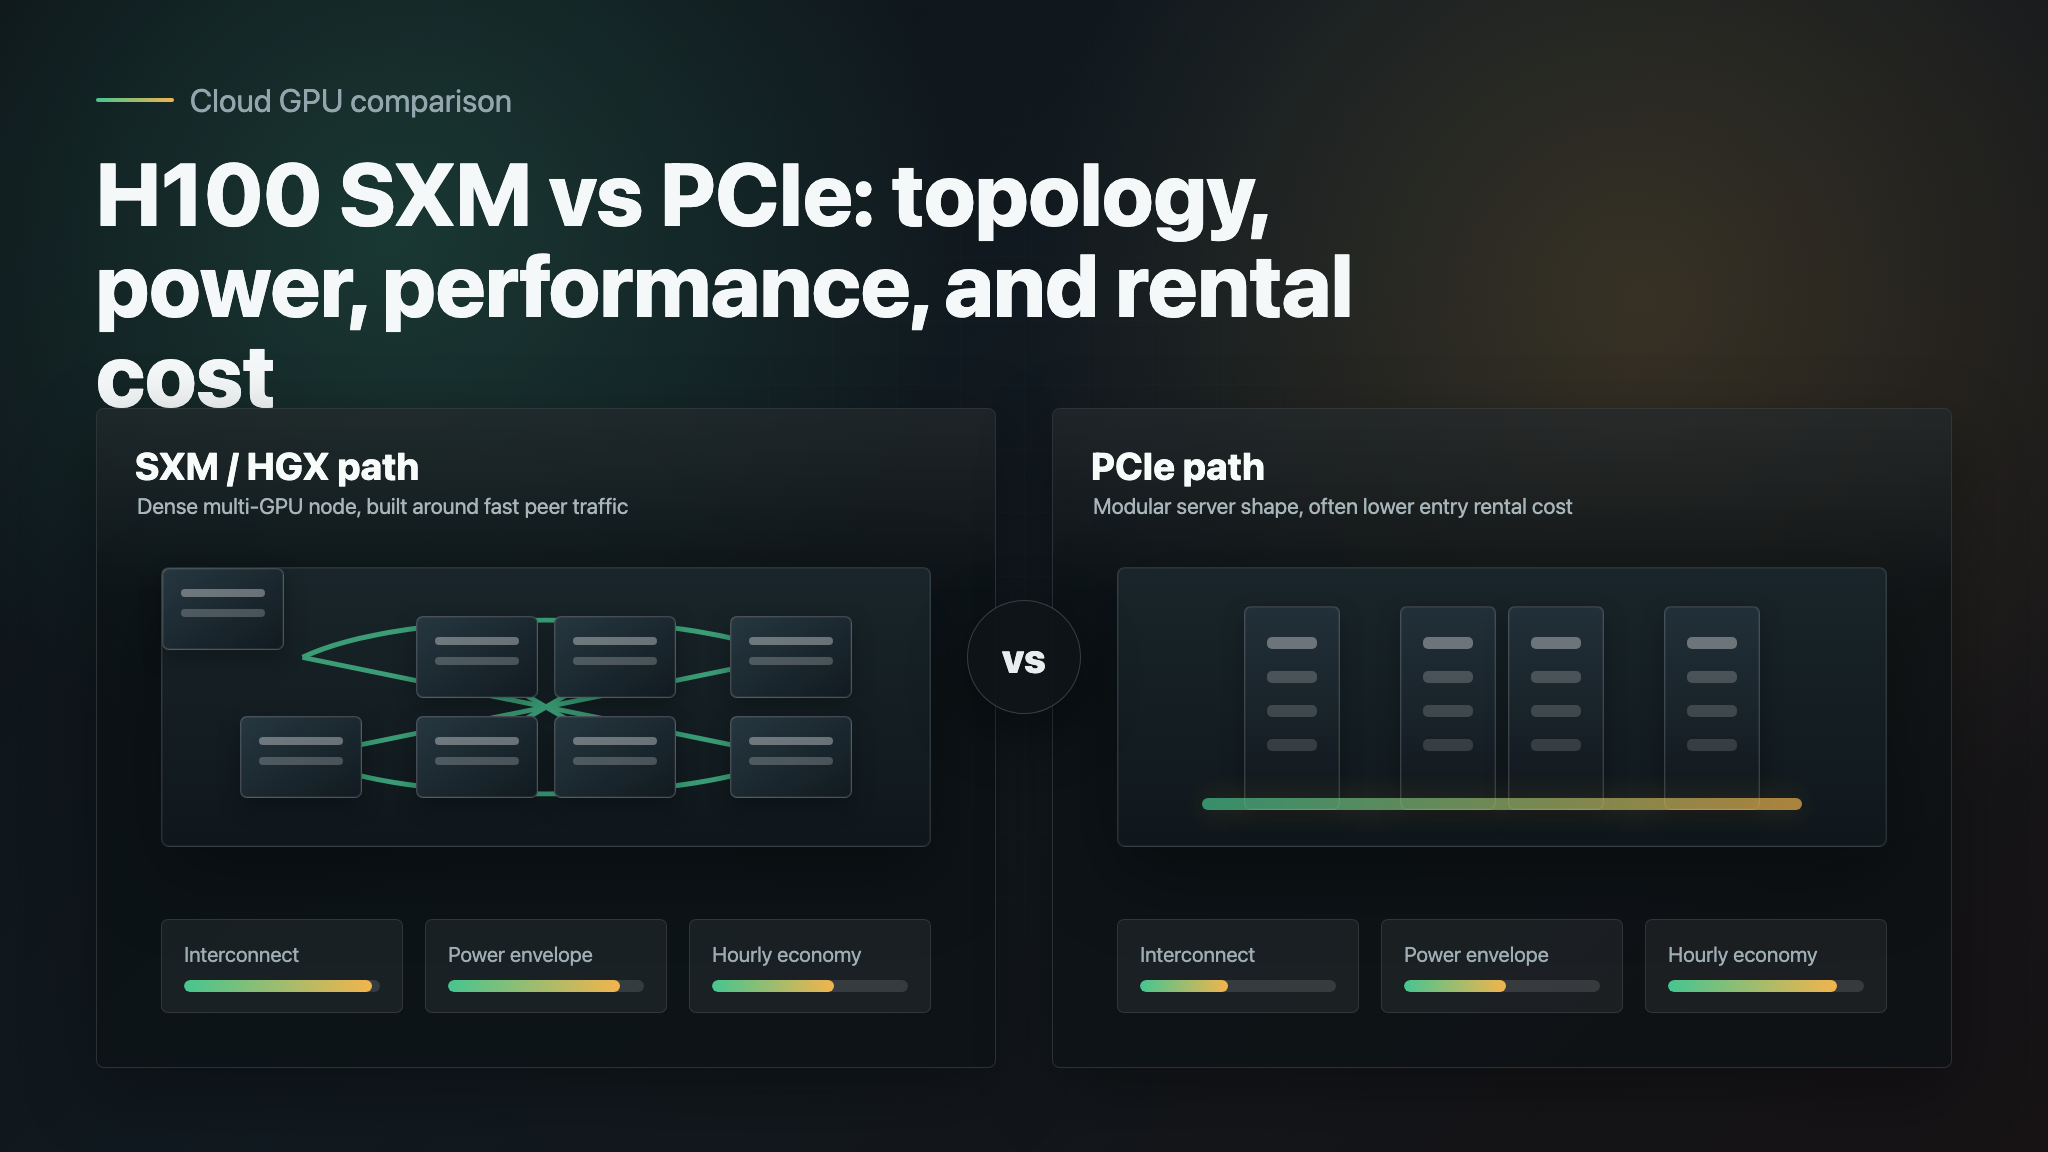
| H100 SXM | Память 80 GB, платформа уровня HGX/DGX, топология fabric, питание и охлаждение | SXM теснее связан с высокоплотной серверной платформой и многопроцессорной GPU-fabric; не сравнивайте его цену в пересчёте на карту только с PCIe. |
| H100 NVL | Точный SKU платы/пары/сервера, доступная память, межсоединение, включённый хост | Обозначения на маркетплейсах различаются. Подтвердите, что считается одним оплачиваемым «GPU», и является ли объявление картой, парой или конфигурацией сервера. |
| Узел с 4 или 8 GPU | Количество GPU, топология NVLink/NVSwitch, NIC, локальное хранилище, условия резервирования | Для распределённого обучения фактической единицей закупки часто является узел, а не отдельный ускоритель. |
В спецификации H100 NVIDIA указано 80 GB как у версий SXM, так и PCIe, при различиях в пропускной способности памяти, энергопотреблении, межсоединении и серверных вариантах. В ней указаны 3 TB/s и до 700 W для версии SXM против 2 TB/s и 350 W для версии PCIe, поэтому цена GPU H100 всегда должна включать форм-фактор и платформу в той же строке предложения. Изучайте спецификацию NVIDIA H100 вместе с предложением, а не считайте «80 GB H100» полной спецификацией.
Более подробное описание архитектуры и развертывания см. в нашем руководстве по NVIDIA H100 GPU. Если выбор фактически стоит между поколениями, сравните рабочую нагрузку и стоимость принятого результата в материалах H100 vs. A100 или руководстве по цене H200 GPU, прежде чем считать более низкую почасовую ставку преимуществом.
Почему одинаковая цена GPU H100 может приводить к очень разным ежемесячным счетам
Почасовой тариф — это лишь строка за ускоритель. Для реального месячного плана нужен полный путь предоставления:
Cloud workload cost
= accelerator or instance rate × scheduled hours
+ attached storage
+ data transfer / egress
+ CPU, RAM, and networking not bundled in the rate
+ support, platform, and software charges
+ idle time, retries, and failed-job allowance
Google Cloud явно разделяет вопросы, связанные с GPU, типом машины, хранилищем и сетью, в своей документации по ценам на GPU. Это полезное напоминание о том, что не стоит умножать ставку за GPU на 730 и называть результат производственным бюджетом.
Например, 730 забронированных часов при двух указанных выше публичных ориентирах ставок за pod составят около 2 110 $ в месяц для примера PCIe по 2,89 $/час и 2 913 $ в месяц для примера SXM по 3,99 $/час — без учета затрат вне отображаемой конфигурации pod. Эти цифры являются иллюстрациями для бюджетирования, а не коммерческими предложениями.
Цена GPU H100 также меняется в зависимости от модели оплаты:
- Оплата по требованию хорошо подходит для краткосрочной разработки, оценки и непредсказуемой загрузки. Вы платите за гибкость.
- Spot- или прерываемые мощности могут снизить заявленную ставку, но для задачи обучения необходимы контрольные точки и логика перезапуска. Низкая цена не означает дешевизну, если прерывание приводит к потере дня работы.
- Зарезервированные мощности или блоки мощностей обменивают гибкость на обязательство по поставке ресурсов на определенный срок. Таблица P5 AWS — один из примеров продукта, который следует сравнивать как запланированную покупку мощностей, а не просто как GPU-час.
- Выделенные или законтрактованные облачные мощности могут включать иной профиль поддержки, доступности или сети, чем pod самообслуживания. Сравнивайте объем контракта, а не только модель GPU.
В нашем руководстве по ценам аренды GPU различия между оплатой по требованию, spot-ценами и резервированием объясняются подробнее. Для статей расходов, которые обычно появляются после прохождения прототипа, используйте руководство по скрытым расходам GPU в облаке в качестве контрольного списка перед утверждением.
Покупка H100: рассчитывайте совокупную стоимость владения, а не цену карты
Покупка может иметь смысл для долгосрочных, предсказуемых рабочих нагрузок, но объявление о продаже карты — лишь начало. Используйте эту модель владения:
Monthly owned-capacity cost
= (all-in acquisition cost − expected residual value) ÷ depreciation months
+ power and cooling
+ rack or colocation
+ network and storage
+ warranty, spares, and support
+ platform operations and on-call time
+ downtime / utilization reserve
Совокупная стоимость приобретения должна включать точную конфигурацию ускорителя, совместимый сервер или платформу HGX, CPU, память, NIC, хранилище, распределение питания, доставку, налоги, установку и поддержку. Для систем SXM запрос цены только на карту особенно часто исключает компоненты, которые делают конфигурацию пригодной к развертыванию.
Вот как следует интерпретировать ориентир PCIe в 32 200 $:
- Это стартовая цена одной карты на маркетплейсе, а не подтвержденная цена покупки для вашей организации.
- По сравнению с иллюстрацией аренды за 2,89 $/час 32 200 $ соответствуют примерно 11 142 GPU-часам, или приблизительно 15,3 месяца при 730 забронированных часах в месяц.
- Этот расчет не является рекомендацией к покупке. Он не учитывает сервер, электропитание, охлаждение, сеть, поддержку, финансирование и риск неполной загрузки. При 50% загрузке календарное время, необходимое для использования этих 11 142 часов, удваивается.
Именно поэтому даже кажущаяся выгодной цена GPU H100 часто не выдерживает реальной проверки точки безубыточности. Сначала рассчитайте стоимость завершенной, принятой работы, а не только стоимость выделенного часа ускорителя.
Рабочая таблица для покупки H100, которую можно скопировать
Используйте ее перед запросом коммерческих предложений или утверждением облачного обязательства.
| Вопрос | Зафиксируйте это | Почему это важно |
|---|---|---|
| Какой точный SKU? | PCIe, SXM, NVL; память; количество GPU; состояние: новый/восстановленный | Не дает сравнению карты/сервера/пары маскироваться под сравнение цен. |
| Что требуется рабочей нагрузке? | Пиковый VRAM, количество GPU, межсоединение, целевой показатель пропускной способности/задержки, постоянное хранение | Не позволяет более низкой цене GPU H100 направить вас к непригодной конфигурации. |
| Насколько высокой будет загрузка? | Запланированные GPU-часы/месяц и ожидаемая загрузка | Определяет, могут ли гибкость или собственные мощности оказаться выгоднее. |
| Что включено? | vCPU, RAM, локальный диск, постоянное хранилище, NIC, исходящий трафик, поддержка, SLA | Выявляет расходы, не отраженные в ставке за ускоритель. |
| Что происходит при прерывании? | Интервал контрольных точек, время восстановления, стоимость повторной попытки, резервные мощности | Делает spot-цены сопоставимыми с надежными мощностями. |
| Какова бизнес-метрика? | Принятые задания, токены, изображения, шаги обучения или завершенные эксперименты | Позволяет оптимизировать стоимость полезного результата, а не стоимость часа. |
| Какой резервный вариант? | Альтернативный GPU, другой регион, управляемый API или политика очереди | Снижает стоимость дефицита мощностей и неудачных запусков. |
Контрольный список для сравнения коммерческих предложений
Попросите каждого поставщика письменно ответить на следующие вопросы:
- Относится ли предложение к карте PCIe, модулю SXM, конфигурации NVL, полному серверу или кластерной ёмкости?
- Сколько H100 включено и какое межсоединение их связывает?
- Какие CPU, ОЗУ, хранилище, сеть, питание и услуги поддержки включены?
- Указана цена по требованию, спотовая, зарезервированная, плановая, предоплаченная или за блок ёмкости?
- Какой регион или объект применяется и действительно ли ёмкость доступна на запрошенный период?
- Какие расходы остаются за пределами предложения: хранилище, исходящий трафик, лицензии, настройка, налоги или поддержка?
- Какова политика отмены, прерывания, замены и аппаратной поддержки?
- Какой тест рабочей нагрузки вы проведёте, чтобы сравнить стоимость одного принятого результата?
Когда аренда, резервирование, покупка или использование API — лучший выбор
Сначала выберите операционную модель; после этого цену GPU H100 будет гораздо проще оценить.
| Ситуация | Обычно начинают с | Почему |
|---|---|---|
| Прототип, эксперимент по дообучению или неопределённый спрос | Аренды по требованию | Быстрый доступ и отсутствие капитальных обязательств; измеряйте загрузку и время простоя. |
| Отказоустойчивая пакетная работа с надёжным чекпоинтингом | Спотовой / прерываемой ёмкости | Это может быть экономичным, когда перезапуск обходится недорого и потеря ёмкости учтена в планировании. |
| Предсказуемое окно обучения с жёстким дедлайном | Зарезервированной ёмкости или блока ёмкости | Вы платите как за гарантию времени и доступности, так и за вычисления. |
| Постоянная высокая загрузка при наличии опытной платформенной команды | Покупки или колокации после расчёта совокупной стоимости владения | Владение может быть оправдано только после обоснования затрат на инфраструктуру, поддержку и загрузку. |
| Сценарий использования продукта не требует запуска пользовательских весов | Базового варианта с API модели | Сравните с вариантом на основе API до приобретения оборудования; операционная граница может быть важнее, чем цена GPU H100. |
Если окончательный выбор стоит между самостоятельным хостингом инференса и управляемым интерфейсом модели, используйте наше руководство по сравнению GPU-облака и API модели, чтобы структурировать сравнение. Унифицированный AI API также может упростить тестирование управляемого базового варианта для разных моделей до выбора пути закупки оборудования.
Распространённые вопросы о цене H100
Сколько стоит купить GPU H100?
Не существует универсальной публичной рекомендованной розничной цены H100, которую можно использовать для закупок. Цена GPU H100 зависит от форм-фактора, продавца, поддержки, объёма, местоположения и от того, относится ли предложение к карте или полной системе. В снимке данных этого руководства от 22 октября 2026 года на маркетплейсе была указана карта H100 PCIe 80 GB по цене от $32,200. Рассматривайте это как датированную справочную информацию, а затем запросите детализированное предложение поставщика.
Сколько стоит арендовать H100 в час?
Публичные тарифы могут существенно различаться в зависимости от поставщика и продукта. На странице цен Runpod указаны H100 PCIe по $2.89/час и H100 SXM по $3.99/час, тогда как AWS указала $5.97 за час работы одного ускорителя для своего блока ёмкости P5.4xlarge с одним H100. В каждом случае используется разная модель предоставления, поэтому не сравнивайте их только по числу.
H100 SXM дороже H100 PCIe?
Он часто используется в более дорогой платформе, поскольку различаются требования к оборудованию, питанию, охлаждению и фабрике межсоединений. Сравнивайте точную конфигурацию хоста и результат выполненной работы. Важный вопрос заключается в том, улучшает ли платформа SXM вашу рабочую нагрузку настолько, чтобы снизить стоимость одного принятого задания, а не в том, ниже ли её цена GPU H100 в электронной таблице.
Когда покупка выгоднее аренды?
Только когда совокупная стоимость собственной ёмкости ниже сопоставимого облачного варианта при реалистичной загрузке. Учитывайте сервер, сеть, питание, охлаждение, поддержку, резерв на простои и стоимость эксплуатации платформы. Расчёт точки безубыточности только для карты — это инструмент первичной оценки, а не решение.
Сделайте следующее предложение по H100 сопоставимым
Цена GPU H100 становится полезной только тогда, когда она привязана к точной конфигурации и рабочей нагрузке. Начните с форм-фактора GPU, нормализуйте единицу времени, добавьте каждую статью инфраструктурных затрат и рассчитайте стоимость на завершённый результат. Затем сравните гибкость, риск нехватки ёмкости и операционную нагрузку, а не только цену карты или почасовую ставку.
Прежде чем принять обязательства, запустите одну репрезентативную рабочую нагрузку на двух или трёх жизнеспособных вариантах. Этот небольшой тест обычно обходится дешевле, чем позднее обнаружить, что самая низкая цена GPU H100 относилась к неподходящему форм-фактору, неполному бюджету сервера или облачному SKU, который ваша рабочая нагрузка фактически не могла использовать.