Leitfaden zur Auswahl von AI-GPUs: Die passende GPU für Training und Inferenz finden
Ein Leitfaden zur Auswahl von AI-GPUs sollte mit der Arbeitslast beginnen, nicht mit dem Namen des neuesten Beschleunigers. Training, Fine-Tuning, Batch-Inferenz, Echtzeit-Inferenz, Suchpipelines, Mediengenerierung und Evaluierungsaufgaben belasten GPUs auf unterschiedliche Weise. Eine ungeeignete GPU kann auf einer Preisliste attraktiv aussehen und dennoch unterliegen, wenn man Speicheranforderungen, Netzwerktopologie, Ausfallzeiten, Warteschlangen, den Betrieb von Serving-Stacks und die Qualität des akzeptierten Ergebnisses berücksichtigt.
Nutzen Sie diesen Leitfaden zur Auswahl von AI-GPUs als Checkliste für Beschaffung und Architektur. Er ordnet gängige AI-Arbeitslasten den wichtigen GPU-Eigenschaften zu, erklärt, wann H100, H200, B200, A100, L40S, Systeme der GB200-Klasse und lokale GPUs der RTX-Klasse sinnvoll sind, und bietet einen Benchmarking-Plan, der die Kaufentscheidung an abgeschlossene Arbeit statt an synthetische Spitzenwerte bindet.
Praktische Flatkey-Regel: Wählen Sie eine GPU nach den Kosten pro abgeschlossenem Trainingslauf, den Kosten pro akzeptiertem Token, den Kosten pro akzeptiertem Bild oder Video sowie nach dem operativen Risiko, das Sie bereit sind zu übernehmen. Wenn Sie lediglich Modellzugriff, Verwaltung, einen Fallback und ein einheitliches Nutzungsprotokoll benötigen, vergleichen Sie GPU-Miete mit Modell-/API-Routen, bevor Sie in Hardware investieren.
Kurzantwort im Leitfaden zur Auswahl von AI-GPUs
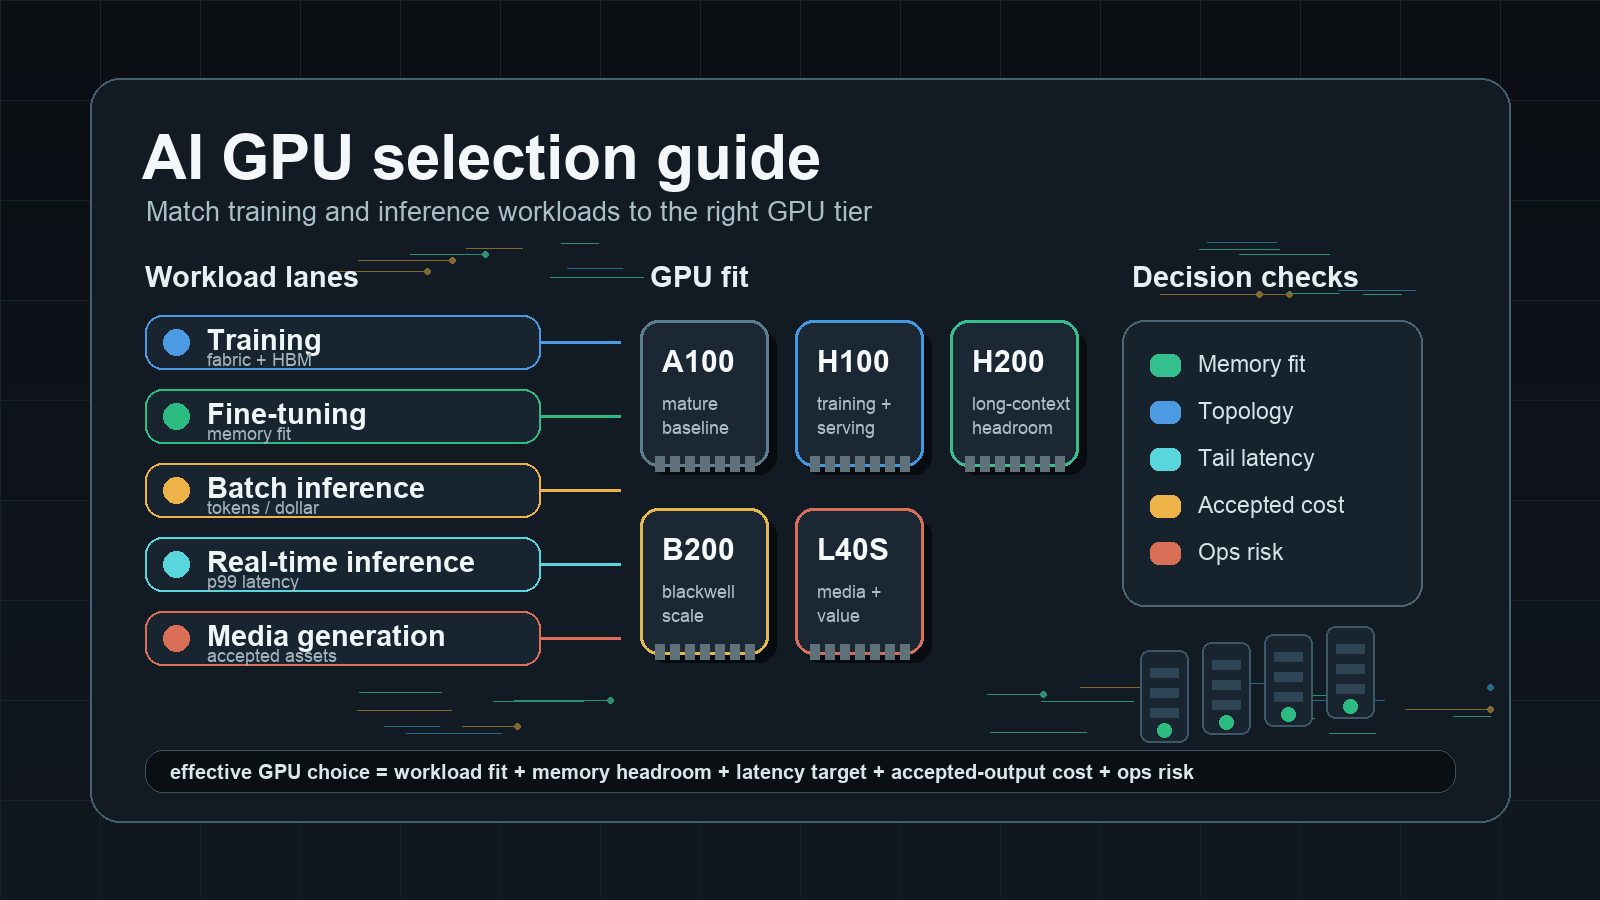
Beginnen Sie mit dieser Matrix, bevor Sie Angebote von Anbietern vergleichen.
| Arbeitslast | Typische Prioritäten | GPU-Empfehlung | Worauf Sie achten sollten |
|---|---|---|---|
| Vortraining oder Training im großen Maßstab | Mehrknoten-Netzwerk, HBM-Kapazität, Speicherbandbreite, BF16-/FP8-Leistung, Checkpoint-I/O | H100/H200, Systeme der B200-/GB200-Klasse, verwaltete Trainingscluster | Der Stundenpreis ist gegenüber der Zeit bis zum Abschluss des Laufs und dem Risiko eines Neustarts zweitrangig |
| Vollständiges Fine-Tuning | Speicherreserve, Kapazität für Optimizer-Zustände, Tensor-Parallelismus, Speicherlokalität | H100, H200, B200, A100 für kleinere Modelle | Ein Mangel an VRAM kann zu langsamerem Sharding oder kleineren Batch-Größen zwingen |
| LoRA-/QLoRA-Fine-Tuning | VRAM-Anpassung, CUDA-Kompatibilität, Leistung pro Dollar | A100, L40S, H100, H200, leistungsstarke lokale GPUs für kleinere Aufgaben | Datensatz und Kontextlänge können die Speicheranforderungen verändern |
| LLM-Batch-Inferenz | Speicheranpassung, Batch-Effizienz, Tokens pro Dollar, Warteschlangentoleranz | L40S, A100, H100, H200, B200 abhängig von der Modellgröße | Niedrige Auslastung kann günstigere GPU-Tarife zunichtemachen |
| LLM-Echtzeit-Inferenz | p95-/p99-Latenz, KV-Cache-Kapazität, Streaming-Stabilität, Unterstützung für Serving-Frameworks | H100/H200/B200 für große Modelle oder Modelle mit langem Kontext; L40S/A100 für kleinere Modelle | Tail-Latenz und Wiederholungsversuche sind wichtiger als Spitzenwerte bei Tokens/s |
| Embeddings und Reranking | Durchsatz pro Dollar, CPU-/GPU-Balance, Batch-Größe, einfache Bereitstellung | L40S, A100, kleinere Cloud-GPUs, bei geringem Volumen manchmal CPU | Überdimensionierte GPUs sind bei niedrigem Traffic sehr verbreitet |
| Bild- und Videogenerierung | VRAM, Medien-Kernels, Speicherbandbreite, Warteschlangentoleranz | L40S, H100/H200/B200 für anspruchsvollere Pipelines, lokale Workstations der RTX-Klasse für Kreative | Die Gesamtkosten pro akzeptiertem Bild/Clip sind wichtiger als die reine Rendering-Geschwindigkeit |
| Evaluierung und synthetische Daten | Spitzenkapazität, Kostenkontrolle, Modellvielfalt | Spot-/Marketplace-GPUs, Batch-APIs oder Modell-/API-Routen | Vermeiden Sie den Besitz ungenutzter Kapazität für seltene Lastspitzen |
Die Kurzantwort lautet bewusst nicht „Kaufen Sie die schnellste GPU“. Für Enterprise-AI-Teams ist die beste GPU diejenige, die zum Modell, zur Kontextlänge, zur Ziellatenz, zur Anfragekonkurrenz, zur Datengrenze und zum Betriebsmodell des Teams passt.
Schritt 1: Klassifizieren Sie die Arbeitslast
Der erste Schritt in jedem Leitfaden zur Auswahl von AI-GPUs ist die Klassifizierung der Arbeitslast. Ohne sie reduziert sich jeder spätere Vergleich auf eine allgemeine Diskussion über Beschleuniger.
Jede GPU-Diskussion sollte mit einer kurzen Beschreibung der Arbeitslast beginnen. Halten Sie diese schriftlich fest, bevor Sie bei Anbietern kommerzielle Angebote einholen.
| Feld | Was dokumentiert werden muss |
|---|---|
| Lasttyp | Training, Fine-Tuning, Batch-Inferenz, Online-Inferenz, Mediengenerierung, Embeddings, Evaluierung oder Notebooks |
| Modellform | Anzahl der Parameter, Architektur, Präzision, Quantisierung, Größe des Kontextfensters, Modalität und Verhalten des Tokenizers |
| Anfrageform | Durchschnittliche und p95-Anzahl der Eingabe-Token, Ausgabe-Token, Bildgröße, Videolänge, Batchgröße, Anzahl gleichzeitiger Sitzungen oder Datensätze pro Aufgabe |
| Erfolgseinheit | Abgeschlossener Trainingslauf, akzeptierter Patch, akzeptierte Antwort, akzeptiertes Token, akzeptiertes Bild, akzeptierter Clip oder akzeptierter Datensatz |
| Zielwert für die Latenz | Offline, Minuten, Sekunden, weniger als eine Sekunde, p95/p99-Anforderung oder Streaming-Anforderung |
| Betriebsmodus | Dauerhaft eingeschaltet, geplanter Batch, saisonaler Spitzenbedarf, Experiment oder Entwickler-Notebook |
| Betriebliche Grenze | Public Cloud, privates Netzwerk, dedizierter Cluster, On-Premises, Datenlokalisierung oder verwaltete API |
| Tools | vLLM, SGLang, TensorRT-LLM, Triton, Ray, Slurm, Kubernetes, ComfyUI oder vom Anbieter verwaltete Endpoints |
Wenn Sie diese Tabelle nicht ausfüllen können, setzen Sie die GPU-Auswahl aus. Sie kaufen weiterhin Kapazität statt Leistung.
Schritt 2: Wählen Sie die richtige Entscheidungsmetrik
Der zweite Schritt im Leitfaden zur Auswahl von AI-GPUs besteht darin, den Nenner zu wählen. Ein guter Nenner verknüpft die GPU-Entscheidung mit abgeschlossener Arbeit statt mit dem Datenblatt eines Anbieters.
Spitzen-FLOPS, die Anzahl der Tensor Cores und der GPU-Stundenpreis sind nützliche Eingabedaten, aber keine Entscheidungsmetrik. Verwenden Sie einen Nenner, der an das Geschäftsergebnis gebunden ist.
| Last | Beste Metrik |
|---|---|
| Training | Kosten eines abgeschlossenen Trainingslaufs, der den Ziel-Eval-Score erreicht |
| Fine-Tuning | Kosten eines akzeptierten fine-tuned Checkpoints |
| Online-Inferenz | Kosten einer akzeptierten Antwort bei Ziel-p95/p99-Latenz |
| Batch-Inferenz | Kosten eines akzeptierten Datensatzes oder eines akzeptierten Output-Tokens |
| Code Agents | Kosten einer akzeptierten Aufgabe, eines akzeptierten Patches oder eines gelösten Issues |
| Bildgenerierung | Kosten eines akzeptierten Bildes nach Qualitätsfiltern |
| Videogenerierung | Kosten einer akzeptierten Sekunde oder eines akzeptierten Clips |
| Evaluierung | Kosten einer abgeschlossenen Eval-Suite und Zeit bis zur Antwort |
Verwenden Sie diese Grundformel:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
Für das Training:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
Für die Inferenz:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
Genau hier verändert sich die GPU-Auswahl. Eine GPU, die bei der Benchmark-Durchsatzleistung gewinnt, kann verlieren, wenn sie eine teure Topologie erfordert, bei geringer Auslastung betrieben wird, die Ziellatenz nicht erreicht oder zusätzliche Betriebskosten verursacht.
GPU-Auswahl für das Training
Beim Training sollte sich der Leitfaden zur Auswahl von AI-GPUs wie ein Cluster-Leitfaden verhalten. Die einzelne GPU ist wichtig, doch Platzierung, Interconnect, Storage und das Verhalten bei Neustarts bestimmen oft die Kosten eines abgeschlossenen Trainingslaufs.
Training benötigt viel Speicher, hohe Speicherbandbreite, ein Hochgeschwindigkeitsnetzwerk von GPU zu GPU, stabile Platzierung in Multi-Node-Umgebungen und zuverlässiges Checkpointing. Es ist weniger fehlertolerant als Inferenz, da der Ausfall eines Knotens zum Verlust von Stunden oder Tagen an Rechenzeit führen kann.
Was beim Training am wichtigsten ist
- HBM-Kapazität: Modellparameter, Gradienten, Optimizer-Zustände, Activations, Sequenzlänge und Batchgröße konkurrieren alle um Speicher.
- Speicherbandbreite: Große Matrixoperationen und Optimizer-Schritte können durch die Bandbreite begrenzt werden.
- Interconnect: NVLink, NVSwitch, InfiniBand, RoCE, EFA oder die AI Fabric eines Anbieters können darüber entscheiden, ob die Skalierung effizient ist.
- Präzisionsunterstützung: BF16, FP8 und neuere Pfade mit niedriger Präzision sind nur wichtig, wenn Ihr Framework und das Modellrezept sie sicher nutzen.
- Storage und Checkpoint-I/O: Die Zeit zum Schreiben und Wiederherstellen eines Checkpoints fließt in die Kosten eines abgeschlossenen Trainingslaufs ein.
- Zuverlässigkeit der Platzierung: Die richtigen GPUs, verteilt über eine schwache Fabric, sind nicht dasselbe wie ein zusammenhängender Trainingscluster.
Orientierung für die GPU-Auswahl beim Training
Verwenden Sie H100 oder H200, wenn Sie bewährte Trainingsunterstützung auf Hopper-Niveau und eine breite Reife der Frameworks benötigen. H200 bietet mehr HBM-Kapazität und Bandbreite als H100, was für speicherintensives Training und Fine-Tuning nützlich ist. Verwenden Sie Systeme der Klasse B200 oder GB200, wenn die Last von Durchsatz auf Blackwell-Niveau und Pfaden mit niedrigerer Präzision profitieren kann und der Anbieter die benötigte Topologie, Framework-Unterstützung und Abnahmetests tatsächlich bereitstellen kann. Verwenden Sie A100, wenn das Modell kleiner ist, das Trainingsrezept ausgereift ist, das Budget begrenzt ist oder Verfügbarkeit wichtiger als Spitzenleistung ist.
Wählen Sie eine GPU für das Training nicht anhand eines einzelnen Benchmarks aus. Führen Sie Ihr exaktes Rezept oder einen ähnlichen Proxy aus. Messen Sie die Zeit bis zum Erreichen des Ziel-Eval-Scores, das Verhalten bei Neustarts, die Checkpoint-Zeit und die Gesamtkosten. Entscheidungen zwischen H100 und A100 sowie zwischen H200 und H100 werden in der Regel anhand der Kosten eines abgeschlossenen Zyklus getroffen, nicht anhand des Stundensatzes.
Nützliche weiterführende Beiträge: H100 vs A100, H200 vs H100, B200 vs H200 und B300 vs B200.
GPU-Auswahl für Fine-Tuning
Fine-Tuning liegt zwischen Training und Inferenz. Vollständiges Fine-Tuning verhält sich wie Training, während LoRA und QLoRA auf kompakterer Hardware Platz finden können, wenn Modellgröße, Kontextlänge, Batch-Größe und Präzision kontrolliert werden.
Vollständiges Fine-Tuning
Beim vollständigen Fine-Tuning sollten Sie zuerst Speicher und Topologie priorisieren. Die GPU muss entweder den Trainingszustand aufnehmen oder ihn effizient sharden können. H100, H200, B200 und Multi-GPU-Cluster mit A100 sind je nach Modellgröße und Budget gängige Optionen. GPUs der Klassen H200 und B200 können den Sharding-Druck bei speicherintensiven Aufgaben verringern, aber nur, wenn der Provider-Stack und die Framework-Version bereit sind.
Fragen, die Sie stellen sollten:
- Welches ist das größte Modell und die längste Kontextlänge, die Sie fine-tunen müssen?
- Werden Optimizer-Zustände vollständig geladen, geshardet, ausgelagert oder quantisiert?
- Benötigt die Aufgabe Tensor Parallelism, Pipeline Parallelism, FSDP, DeepSpeed oder einen anderen Distributed-Ansatz?
- Befindet sich der Datensatz lokal in der GPU-Region?
- Wie kostspielig wäre ein fehlgeschlagener Checkpoint?
Adapter-Fine-Tuning
Für LoRA, QLoRA, Instruction Tuning und kleinere Domain Adaptation kann die Antwort flexibler sein. A100, L40S, H100, H200 und lokale GPUs der RTX-Klasse können für unterschiedliche Teile des Workflows geeignet sein. Das Risiko besteht darin anzunehmen, dass eine kleine Demo bedeutet, dass auch die Produktionsaufgabe hineinpasst. Längere Kontexte, größere Batch-Größen, mehr Beispiele und Validierungsläufe können die Aufgabe in eine andere Klasse verschieben.
Dies ist ein guter Zeitpunkt für einen zweistufigen Benchmark: Bestätigen Sie zunächst, dass die Speicherkapazität ausreicht, und bestätigen Sie dann die Zeit bis zum Checkpoint sowie die Kosten pro akzeptiertem fine-getunten Modell.
GPU-Auswahl für LLM-Inferenz
Für die Inferenz sollte ein Leitfaden zur Auswahl von AI-GPUs die Eignung hinsichtlich Speicher von der Eignung hinsichtlich Latenz trennen. Eine GPU kann ein Modell laden und dennoch das Produktionsziel für p99 nicht erreichen.
Inferenz ist nicht nur eine einzige Arbeitslast. Die richtige GPU hängt von Modellgröße, Kontextlänge, Parallelität, Latenzziel und davon ab, ob Anfragen gebündelt oder in Echtzeit verarbeitet werden.
Speichereignung kommt zuerst
Für die LLM-Inferenz muss der GPU-Speicher die Modellgewichte und den KV-Cache mit ausreichender Reserve für das Serving-Framework aufnehmen. Langer Kontext und hohe Parallelität können den KV-Cache zum wichtigsten Faktor für den Speicherdruck machen. Eine GPU, die für eine Modellinstanz für einen einzelnen Nutzer geeignet ist, kann bei Produktionsparallelität ungeeignet sein.
Verwenden Sie diese Checkliste:
- Größe der Gewichte bei Ihrer Präzision: FP16, BF16, FP8, INT8, INT4 oder ein anderes quantisiertes Format.
- Kontextfenster und erwartete p95-Eingabelänge.
- Ausgabelänge und Streaming-Verhalten.
- Parallele Sitzungen und Batch-Größe.
- KV-Cache-Strategie, Prefix-Cache und Verhalten bei Verdrängung.
- Overhead des Serving-Frameworks.
- Sicherheitsreserve für Spitzenlasten und Fragmentierung.
Wenn der Speicher gerade so ausreicht, kann eine GPU mit mehr Speicher besser sein als eine theoretisch schnellere GPU mit weniger Speicher, da sie Sharding, Offloading oder Quantisierung mit geringerer Qualität vermeiden kann.
Echtzeit-Inferenz
Bei Echtzeit-Inferenz sind p95- und p99-Latenz wichtiger als nur der durchschnittliche Durchsatz. GPUs der Klassen H100, H200 und B200 eignen sich in der Regel besser für große Modelle, lange Kontexte und latenzsensitive Arbeitslasten. L40S und A100 können für kleinere Modelle, geringere Parallelität oder Arbeitslasten mit weniger strengen p99-Anforderungen kosteneffizient sein.
Messen Sie:
- Zeit bis zum ersten Token.
- Latenz zwischen Tokens.
- End-to-End-Latenz p95/p99.
- Tokens pro Sekunde und GPU.
- Akzeptierte Tokens pro Dollar.
- Fehlerrate bei Traffic-Spitzen.
- Verstärkung von Wiederholungsversuchen bei Rate Limits, OOM oder Deployments.
Für die Auswahl des Serving-Stacks verwenden Sie vLLM vs SGLang und den Leitfaden zur Bereitstellung von vLLM.
Batch-Inferenz
Batch-Inferenz kann Latenz gegen Durchsatz eintauschen. Dadurch eröffnen sich mehr GPU-Optionen. L40S, A100, H100, H200 und B200 können geeignet sein, wenn das Modell hineinpasst und die Auslastung hoch ist. Die zentrale Metrik ist in der Regel die Anzahl akzeptierter Ergebnisse pro Dollar innerhalb eines Batch-Fensters.
Batch-Arbeitslasten eignen sich auch gut für Spot-Instanzen, reservierte Zeitfenster oder serverlose GPU-Kapazität, wenn das Verhalten bei Wiederholungsversuchen unter Kontrolle ist. Wenn derselbe Batch mit geringerem Betriebsaufwand an eine Modell-API gesendet werden kann, vergleichen Sie beide Wege mithilfe der Tabelle GPU cloud vs model API.
GPU-Auswahl für die Mediengenerierung
Die Bild- und Videogenerierung verhält sich häufig anders als die Textinferenz. VRAM, die Komplexität der Modell-Pipeline, Speicher-I/O und die Toleranz gegenüber Warteschlangen sind wichtiger als die Latenz in Konversationen.
L40S ist häufig attraktiv für Bilder und kleinere Medien-Workloads, da es starke Inferenz- und Grafikfunktionen zu geringeren Beschaffungskosten als GPUs der H100-Klasse bietet. H100, H200 und B200 werden relevanter, wenn Workloads anspruchsvoller, größer, multimodal oder streng latenzgebunden sind. Lokale Workstations der RTX-Klasse können für Content-Ersteller, Prototyping und Pipelines mit geringem Volumen nützlich sein, doch Produktionsteams benötigen weiterhin Warteschlangen, Speicher, Wiederholungsversuche und Observability.
Verwenden Sie die Kosten pro akzeptiertem Bild oder Clip, nicht die reine Renderzeit:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
Wenn Ihr Team nur Zugriff auf einige Modelle für Bilder oder Videos benötigt, kann der Weg über Modelle/APIs einfacher sein als der Betrieb von GPU-Medien-Pipelines. Wenden Sie dieselbe Beschaffungsdisziplin wie bei Text an: Kosten pro akzeptiertem Ergebnis, nicht nur die Preisliste.
GPU-Modellübersicht
Verwenden Sie diese Tabelle als Ausgangspunkt und prüfen Sie anschließend die aktuellen Spezifikationen und die Verfügbarkeit auf den offiziellen Seiten der Anbieter. Betrachten Sie sie nicht als Preistabelle.
| GPU-Familie | Praktische Rolle | Signale für die beste Eignung | Häufige Vorbehalte |
|---|---|---|---|
| NVIDIA A100 | Ausgereifte Basisplattform für Training und Inferenz | Bestehende Rezepte, 40GB-/80GB-Varianten, breite Cloud-Verfügbarkeit, budgetempfindliche Workloads | Ältere Generation; geringere Speicherbandbreite und weniger neuere Präzisionspfade als H100/H200/B200 |
| NVIDIA H100 | Arbeitspferd der Hopper-Klasse für Training und Inferenz | Hohe Framework-Reife, FP8-Transformer-Engine-Unterstützung, hohe Speicherbandbreite, NVLink-/NVSwitch-Optionen | Verfügbarkeit und Preis können weiterhin eingeschränkt sein; der Speicher kann für Inferenz mit sehr langem Kontext und hoher Parallelität unzureichend sein |
| NVIDIA H200 | Hopper-Variante mit größerer Speicherkapazität | Mehr HBM-Kapazität und Bandbreite als H100; nützlich für Inferenz mit langem Kontext und speicherintensive Aufgaben | Verfügbarkeit und Preis variieren; vergleichen Sie mit H100 für Ihren konkreten Workload |
| NVIDIA B200 | Beschleuniger der Blackwell-Klasse | Anspruchsvolles Training und Inferenz, neue Niedrigpräzisionspfade, große Speicherkapazität und hohe Bandbreite | Erfordert Stack-Bereitschaft, Anbieter-Verfügbarkeit und eine Prüfung der Topologie |
| NVIDIA GB200 / Rack-Scale-Systeme | Großskaliges Training und Inferenz mit hoher Dichte | Aufgaben im Cluster-Maßstab, bei denen die Systemarchitektur mindestens ebenso wichtig ist wie das GPU-Silizium selbst | Beschaffung und Betrieb sind Entscheidungen auf Systemebene, nicht für eine einzelne GPU |
| NVIDIA L40S | Kostensensitive Inferenz- und Medienaufgaben | Speicher in der 48GB-Klasse, Bild-/Video-Pipelines, Inferenz kleinerer LLMs, Batch-Aufgaben | Kein universeller Ersatz für H100/H200 bei großem Training oder strenger LLM-Inferenz nach p99 |
| Lokale GPUs der RTX-Klasse | Lokale Experimente und Workflows für Content-Ersteller | Prototyping, kleine Modelle, Iterationen auf einer persönlichen Workstation | Begrenzte Speicherkapazität, schwächere Betriebserfahrung im Rechenzentrum, allein kein Produktionscluster |
In der Tabelle verbirgt sich eine wichtige Beschaffungstatsache: Das GPU-Modell ist nur ein Teil der Antwort. Knotenformfaktor, Speicher, Scheduler, Interconnect, Quotenmodell und Supportqualität können darüber entscheiden, ob eine GPU nutzbar ist.
Beschaffungs-Checkliste
Fordern Sie vor dem Kauf oder der Anmietung bei Anbietern die folgenden Informationen an.
Hardware und Topologie
- Genaues GPU-Modell, Speicherkapazität, Knotenformfaktor und Anzahl der GPUs pro Knoten.
- Interconnect innerhalb des Knotens und zwischen Knoten.
- CPU, RAM, lokales NVMe, Speicherdurchsatz und Netzwerkbandbreite.
- Region, Zone, Placement Group, Rack oder Annahmen zu einem dedizierten Cluster.
- Verfahren zum Austausch ausgefallener GPUs, Knoten, Speicher- und Netzwerkgeräte.
Software-Stack
- Versionen von Treibern, CUDA, cuDNN, NCCL, Container Runtime und unterstützten Frameworks.
- Zugriffsmodell: Kubernetes, Slurm, verwalteter Endpoint oder Bare Metal.
- Unterstützung für vLLM, SGLang, TensorRT-LLM, Triton, Ray oder Medien-Pipelines.
- Observability-Felder für GPU-Auslastung, Speicher, Wartezeit in der Warteschlange, Latenz, Fehler und Kosten.
- Prozess für Updates und Rollbacks.
Geschäftsmodell
- On-Demand, Spot, Reserved, Marketplace, dedizierter Cluster, Private Cloud oder Managed Endpoint.
- Mindestbindung, Kündigungsrechte, Gebühren bei Überschreitung und Support-Stufen.
- Kosten für Speicher, Egress, Snapshots, öffentliche IPs, Load Balancer und private Netzwerke.
- Format des Nutzungsdatenexports und Detailgrad der Rechnung.
- Ob Gebühren für ungenutzte Kapazität anfallen und wie die Automatisierung der Abschaltung funktioniert.
Sicherheit und Governance
- Netzwerkgrenze, VPC/VNet-Modell, Unterstützung für private Endpoints und Egress-Richtlinie.
- IAM, Umgang mit Secrets, Audit-Logs, Supportzugriff und Benachrichtigung bei Vorfällen.
- Datenspeicherung, Aufbewahrungsdauer von Checkpoints, Backups, Löschung und Legal Hold.
- Nachweise zur Erfüllung von Anforderungen und Unterstützung bei Vendor Reviews.
- Budgets nach Teams, Kontingente, Tags und Unterstützung für Chargeback/Showback.
Diese Checkliste ist auf öffentliche GPU-Clouds, private GPU-Clouds und die Anmietung von GPU-Clustern anwendbar. Je weitreichender die Verpflichtungen, desto mehr Nachweise sollten Sie verlangen.
Benchmark-Plan: So testen Sie, bevor Sie sich verpflichten
Dies ist der Teil des Leitfadens zur Auswahl von AI-GPUs, der als Nachweis für Ihre Beschaffung dienen sollte. Bewahren Sie Eingaben, Ergebnisse und Abnahmekriterien auf, damit Finanz- und Plattformteam die Entscheidung später prüfen können.
Führen Sie einen Benchmark aus, der Ihrer Arbeitslast ähnelt. Verlassen Sie sich nicht ausschließlich auf öffentliche Benchmark-Tabellen.
Phase 1: Test der Speichereignung
- Laden Sie das genaue Modell oder die nächstbeste Alternative.
- Verwenden Sie die Zielpräzision und Quantisierung.
- Legen Sie die erforderliche Kontextlänge und Batch-Größe fest.
- Führen Sie repräsentative Anfragen oder Datensätze aus.
- Erfassen Sie Spitzenverbrauch des Speichers, Fragmentierung, OOM-Häufigkeit und Sicherheitsreserve.
Phase 2: Test von Durchsatz und Latenz
- Testen Sie gleichmäßigen und spitzenartigen Datenverkehr.
- Messen Sie die Latenz p50, p95 und p99.
- Messen Sie die Zeit bis zum ersten Token für Streaming-LLM-Aufgaben.
- Messen Sie tokens/sec, images/hour, clips/hour oder records/hour.
- Erfassen Sie akzeptierte Ergebnisse, nicht nur generierte.
Phase 3: Test von Ausfällen und Betrieb
- Stoppen Sie einen Worker, nehmen Sie einen Knoten außer Betrieb, starten Sie den Serving-Stack neu und simulieren Sie ein fehlgeschlagenes Deployment.
- Testen Sie die Checkpoint-Wiederherstellung für Training und Fine-Tuning.
- Testen Sie Cold-Start-Zeit und Modellladezeit.
- Bestätigen Sie, dass Logs und Metriken für die Plattform-, Sicherheits- und Finanzteams verfügbar sind.
- Stellen Sie sicher, dass die Kostenzuordnung bei Wiederholungsversuchen und Ausfällen erhalten bleibt.
Phase 4: Finanzielle Normalisierung
Erstellen Sie für jeden Kandidaten eine Zeile:
| Kandidat | GPU-Kosten | Speicher/Netzwerk | Plattformaufwand | Verluste durch Ausfälle | Akzeptierte Ausgaben | Effektive Stückkosten | Anmerkungen |
|---|---|---|---|---|---|---|---|
| Provider A H100 | Eingabe aus dem Angebot | Quellengeprüfte Zusatzkosten hinzufügen | Schätzung | Gemessen | Gemessen | Berechnet | p95-Latenz einbeziehen |
| Provider B H200 | Eingabe aus dem Angebot | Quellengeprüfte Zusatzkosten hinzufügen | Schätzung | Gemessen | Gemessen | Berechnet | Speicherreserve einbeziehen |
| Model/API route | Quellengeprüfte API-Kosten | Gateway-/Betriebskosten | Niedrigere Schätzung der Betriebskosten | Gemessene Wiederholungen | Gemessen | Berechnet | Qualitätsabnahme einbeziehen |
Damit wird der Leitfaden zur Auswahl von AI-GPUs zu einem Entscheidungsdokument, das Finanz-, Plattform- und Produktteams prüfen können.
Mieten, reservieren, kaufen oder eine Modell-API nutzen?
Der letzte Schritt in diesem Leitfaden zur Auswahl von AI-GPUs besteht darin, zu entscheiden, ob Sie Kapazität mieten, reservieren, kaufen oder stattdessen eine Modell-API verwenden sollten.
Die Wahl des GPU-Modells und die Wahl des Kapazitätsmodells sind unterschiedliche Entscheidungen.
| Situation | Bester Ausgangspunkt |
|---|---|
| Unsichere Nachfrage, wechselnde Modelle oder Prototypen | Modell-API oder kurzfristige Anmietung |
| Unregelmäßige Experimente und Evaluierungsaufgaben | Spot-/Marketplace-GPUs oder Batch-Modell-API |
| Stabile Inferenz mit hoher Auslastung auf einem Modell | Reservierte GPU, dedizierter Endpoint oder reservierter Cluster |
| Training über mehrere Knoten mit Topologieanforderungen | Dedizierter Trainingscluster oder reserviertes Hochgeschwindigkeits-Fabric |
| Strikte private Netzwerk- oder Hardwareisolierung | Private GPU-Cloud oder dedizierter Cluster |
| Viele offizielle Modelle, eine Rechnung und eine Fallback-Option erforderlich | Von Flatkey verwaltete Modell-/API-Routen |
Wenn das Argument für GPUs hauptsächlich lautet: „Wir benötigen Zugriff auf AI-Modelle“, beginnen Sie mit Routing über Modell/API. Wenn das Argument lautet: „Wir müssen Topologie, Runtime, Gewichte, Datengrenze oder benutzerdefinierte Kernel kontrollieren“, halten Sie den GPU-Pfad offen. Der Unterschied ist wichtig, da GPU-Infrastruktur Verantwortung für Scheduler, Runtime, Sicherheit, FinOps und Vorfälle umfasst.
Flatkey hilft bei der API-Seite dieser Entscheidung: ein Schlüssel, ein Guthaben, eine Rechnung, Verwaltung der Nutzungsabrechnung und offizielle Modell-/Tool-Routen. Dies ist kein Ersatz für Hardwarekontrolle, wenn Hardwarekontrolle tatsächlich erforderlich ist. Es ist eine einfachere Alternative, wenn die tatsächliche Anforderung verwalteter Modellzugriff und Kostentransparenz ist.
Häufige Fehler bei der GPU-Auswahl
Fehler 1: Auswahl nach Stundensatz
Der Stundensatz berücksichtigt nicht Auslastung, Wiederholungen, Leerlaufzeiten, Speicher, Netzwerk, Support und die Zeit der Ingenieure. Verwenden Sie die Kosten pro abgeschlossener Arbeitslast. Der Leitfaden zu GPU-Mietpreisen behandelt versteckte Kostenpositionen.
Fehler 2: Speicherbedarf als Ja/Nein-Frage betrachten
Dass der Speicher bei einer bestimmten Anfragelänge oder Batch-Größe ausreicht, belegt nicht die Eignung für die Produktion. Langer Kontext, hohe Parallelität, Modellwechsel und der Overhead des Serving-Frameworks können die Antwort verändern.
Fehler 3: Interconnect ignorieren
Bei Aufgaben mit mehreren GPUs und mehreren Knoten ist die Topologie Teil der GPU-Lösung. Ein günstigerer GPU-Pool mit schwacher Platzierung kann einem teureren, aber abgestimmten Cluster unterlegen sein.
Fehler 4: Generierte statt akzeptierte Ergebnisse benchmarken
AI-Workloads umfassen Qualitätsfilter, Sicherheitsfilter, Wiederholungen, fehlgeschlagene Generierungen, fehlgeschlagene Patches und fehlgeschlagene Evaluierungen. Messen Sie die Kosten akzeptierter Ergebnisse.
Fehler 5: Die Verantwortung für die Plattform vergessen
Jemand muss Treiber, CUDA, Container, Modellserver, Autoscaling, Quoten, Logging, Warnmeldungen, Incidents und die Ausgabenberichterstattung betreiben. Wenn es kein solches Team gibt, berücksichtigen Sie das.
Fehler 6: Nur für das heutige Modell kaufen
Die Modellauswahl ändert sich. Kontextfenster werden größer. Quantisierung verbessert sich. Die Verfügbarkeit von Anbietern ändert sich. Gestalten Sie das Entscheidungsdokument flexibel und vermeiden Sie Verpflichtungen, die voraussetzen, dass ein Modell dominant bleibt.
Offizielle Quellen zur Überprüfung
Verwenden Sie offizielle Seiten für volatile oder anbieterspezifische Details:
- NVIDIA-H100-Übersicht für den Kontext von GPUs der Hopper-Klasse: NVIDIA H100 Tensor Core GPU.
- NVIDIA-H200-Übersicht für den Kontext von mehr HBM3e-Speicher und Bandbreite: NVIDIA H200 Tensor Core GPU.
- Materialien zu NVIDIA Blackwell/DGX B200 und GB200 für den Kontext des Blackwell-Systems: NVIDIA DGX B200 und NVIDIA GB200 NVL72.
- NVIDIA-A100-Übersicht für den Kontext der ausgereiften Ampere-Basisplattform: NVIDIA A100 Tensor Core GPU.
- NVIDIA-L40S-Seite für den Kontext von Inferenz- sowie Grafik-/Medien-Workloads: NVIDIA L40S.
- NVIDIA-MIG-Dokumentation zur Partitionierung unterstützter GPUs: NVIDIA Multi-Instance GPU User Guide.
- Framework-Dokumentation für Serving und Runtime-Kompatibilität: vLLM OpenAI-compatible server, SGLang-Dokumentation und NVIDIA TensorRT-LLM.
- Angebots- und Preisseiten von Anbietern für aktuelle Verfügbarkeit und Kosten. Geben Sie für jeden Preis, den Sie in eine Beschaffungstabelle übernehmen, einen Zeitstempel an.
Häufig gestellte Fragen
Welche GPU eignet sich am besten für AI-Training?
Die beste GPU für AI-Training hängt von Modellgröße, Trainingsschema, Speicheranforderungen, Interconnect, Checkpoint-Verhalten und der Zeit bis zum Erreichen des angestrebten Eval-Scores ab. Systeme der Klasse H100, H200, B200 und GB200 sind starke Kandidaten für große Trainingsaufgaben, während die A100 für kleinere oder budgetempfindliche Workloads weiterhin geeignet sein kann. Vergleichen Sie vor der Auswahl die Kosten eines abgeschlossenen Runs.
Welche GPU eignet sich am besten für LLM-Inferenz?
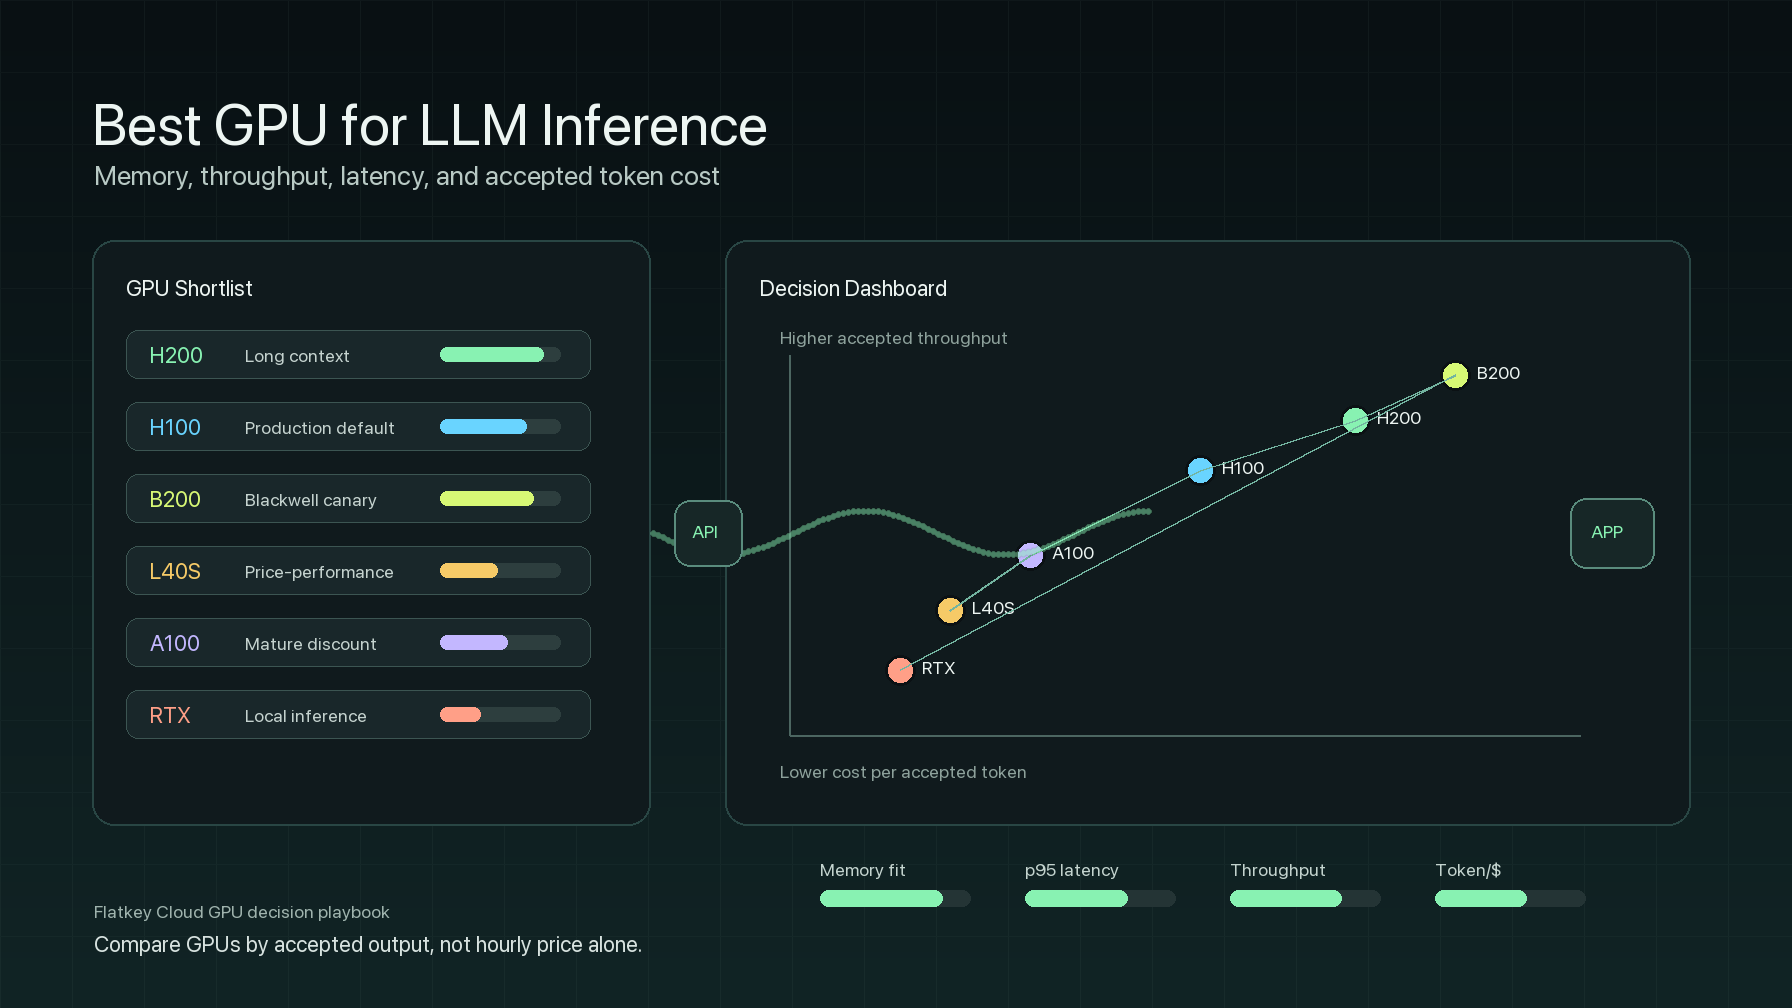
Die beste GPU für LLM-Inferenz ist diejenige, die Modellgewichte und KV-Cache aufnimmt und gleichzeitig die Zielwerte für p95/p99-Latenz und Kosten pro akzeptiertem Token erreicht. H100, H200 und B200 eignen sich gut für große oder Workloads mit langem Kontext. L40S und A100 können für kleinere Modelle, Batch-Inferenz und weniger strenge Latenzanforderungen effizient sein. Für inferenzspezifische Berechnungen verwenden Sie den ausführlichen Leitfaden zu best GPU for LLM inference.
Ist die H200 immer besser als die H100?
Nein. Die H200 bietet mehr Speicherreserven und eine höhere Bandbreite als die H100, was bei speicherintensiver Inferenz und beim Training helfen kann. Die beste Wahl hängt jedoch von Preis, Verfügbarkeit, Reife der Frameworks, Batch-Größe, Latenz und davon ab, ob die Arbeitslast tatsächlich speicherbegrenzt ist. Wenn die H100 das Ziel bei niedrigeren effektiven Kosten erreicht, kann die H100 weiterhin die bessere Wahl sein.
Wann sollte ich die L40S statt der H100 wählen?
Wählen Sie die L40S, wenn das Modell hineinpasst, die Latenzanforderungen moderat sind, eine gute Media-/Inference-Performance pro Dollar wichtig ist und die Leistung der H100-Klasse nicht vollständig genutzt wird. Wählen Sie die H100, wenn größere Modelle, strengere p99-Latenz, Training oder Inferenz mit hoher Parallelität die höhere Leistung eines Rechenzentrumsbeschleunigers erfordern.
Sollte ich GPUs mieten oder eine Model API verwenden?
Mieten Sie GPUs, wenn Sie Kontrolle über die Hardware, eigene Runtimes, eine private Topologie oder eine stabile Auslastung für ein Modell mit konstanter Nachfrage benötigen. Nutzen Sie eine Model-API, wenn die Nachfrage unsicher ist, sich Modelle häufig ändern, der Zugang zu Frontier-Modellen wichtig ist oder Ihrem Team Governance, Fallbacks, Nutzungsprotokolle und eine einzige Rechnung wichtiger sind als die Kontrolle über die Hardware. Vergleichen Sie dies mit GPU-Cloud vs. Model-API.
Wie vermeide ich den Überkauf von GPUs?
Vermeiden Sie Überkäufe, indem Sie die exakte Arbeitslast benchmarken, akzeptierte Ergebnisse messen, Leerlaufzeiten und Betrieb einbeziehen und zunächst kleinere oder verwaltete Alternativen testen. Reservieren oder kaufen Sie erst, nachdem Traffic, Modellauswahl und Auslastung bestätigt sind.
Fazit
Dieser Leitfaden zur Auswahl von AI-GPUs ist keine Rangliste von Beschleunigern. Er ist eine Methode, um GPU-Entscheidungen fundiert zu treffen. Beginnen Sie mit der Arbeitslast, wählen Sie eine mit dem Geschäft abgestimmte Metrik, bestätigen Sie, dass der Speicher ausreicht, prüfen Sie Throughput und Tail-Latenz, berücksichtigen Sie Betrieb und Verluste durch Ausfälle und vergleichen Sie die Optionen mit Model-/API-Alternativen, bevor Sie Verpflichtungen eingehen.
Für viele Teams ist die richtige Antwort ein Hybrid: GPUs für Arbeitslasten, die tatsächlich Kontrolle über die Hardware benötigen, und von Flatkey verwalteter Model-/API-Zugang für Overflow, Frontier-Modelle, Fallbacks, Nutzungsprotokolle und Teams, die keinen Serving-Stack betreiben sollten. Die beste GPU-Wahl ist diejenige, die akzeptierte Aufgaben zu den erforderlichen Kosten liefert, ohne Ihr Team dazu zu zwingen, Infrastruktur zu besitzen, die es nicht benötigt.