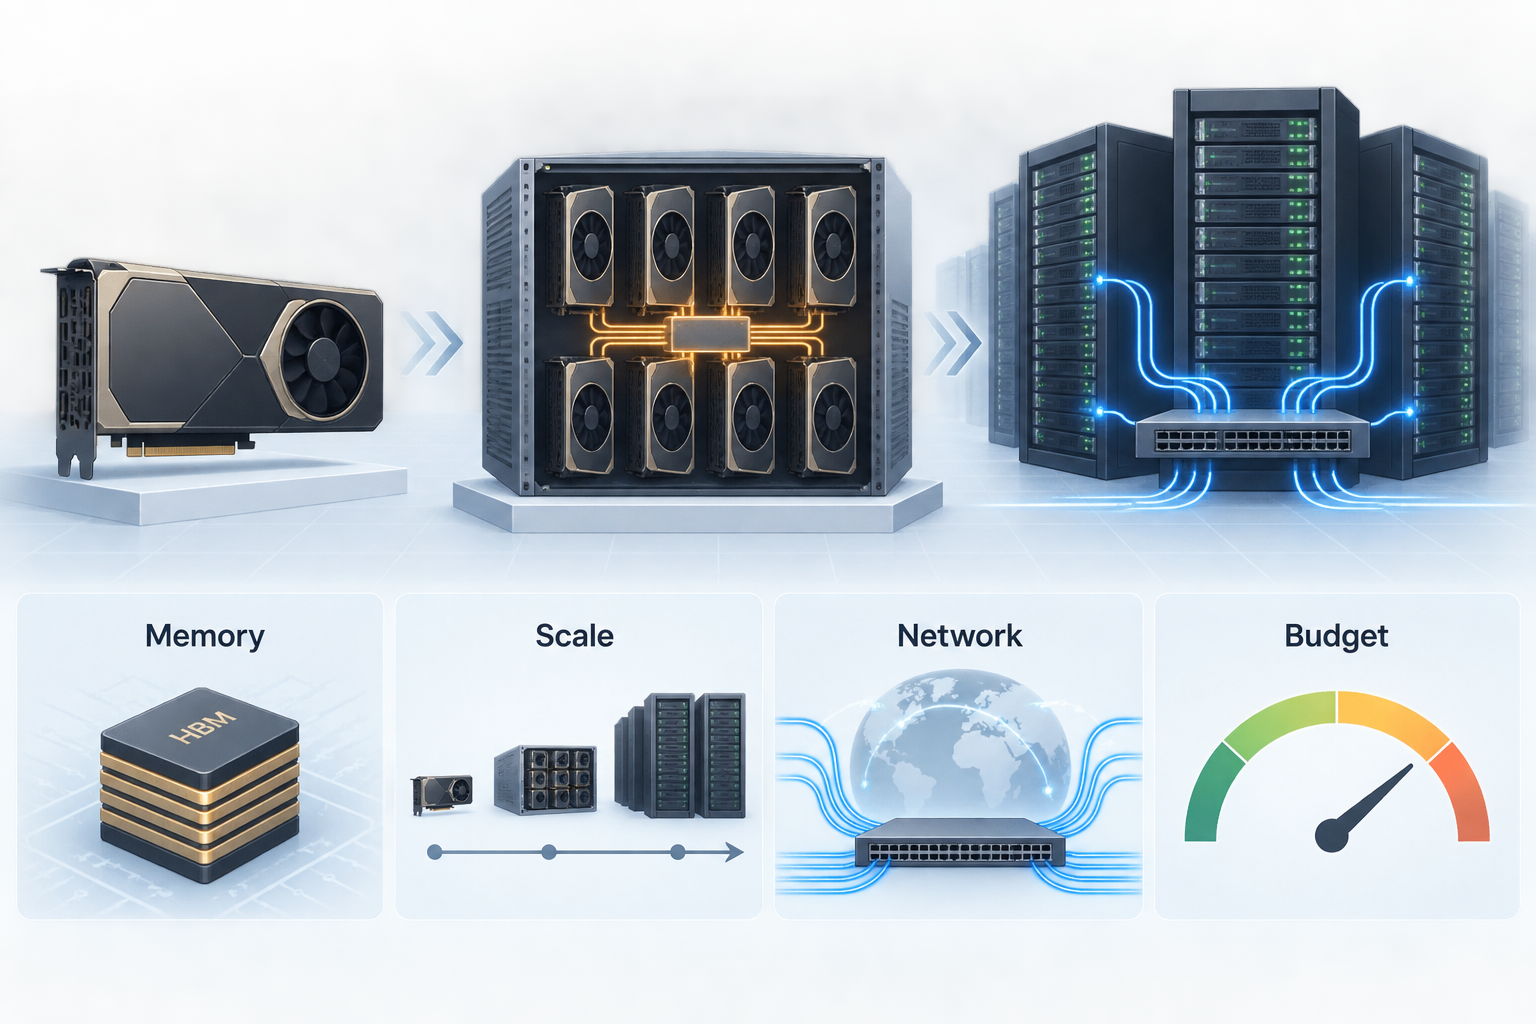
Panduan Pemilihan AI GPU: temukan GPU yang tepat untuk pelatihan dan inferensi
Panduan pemilihan AI GPU harus dimulai dari beban kerja, bukan dari nama akselerator terbaru. Pelatihan, fine-tuning, inferensi batch, inferensi waktu nyata, pipeline pencarian, pembuatan media, dan tugas evaluasi membebani GPU dengan cara yang berbeda. GPU yang tidak tepat dapat terlihat menarik dalam daftar harga, tetapi tetap kalah ketika mempertimbangkan kecocokan memori, topologi jaringan, waktu henti, antrean, pengoperasian stack layanan, dan kualitas hasil yang diterima.
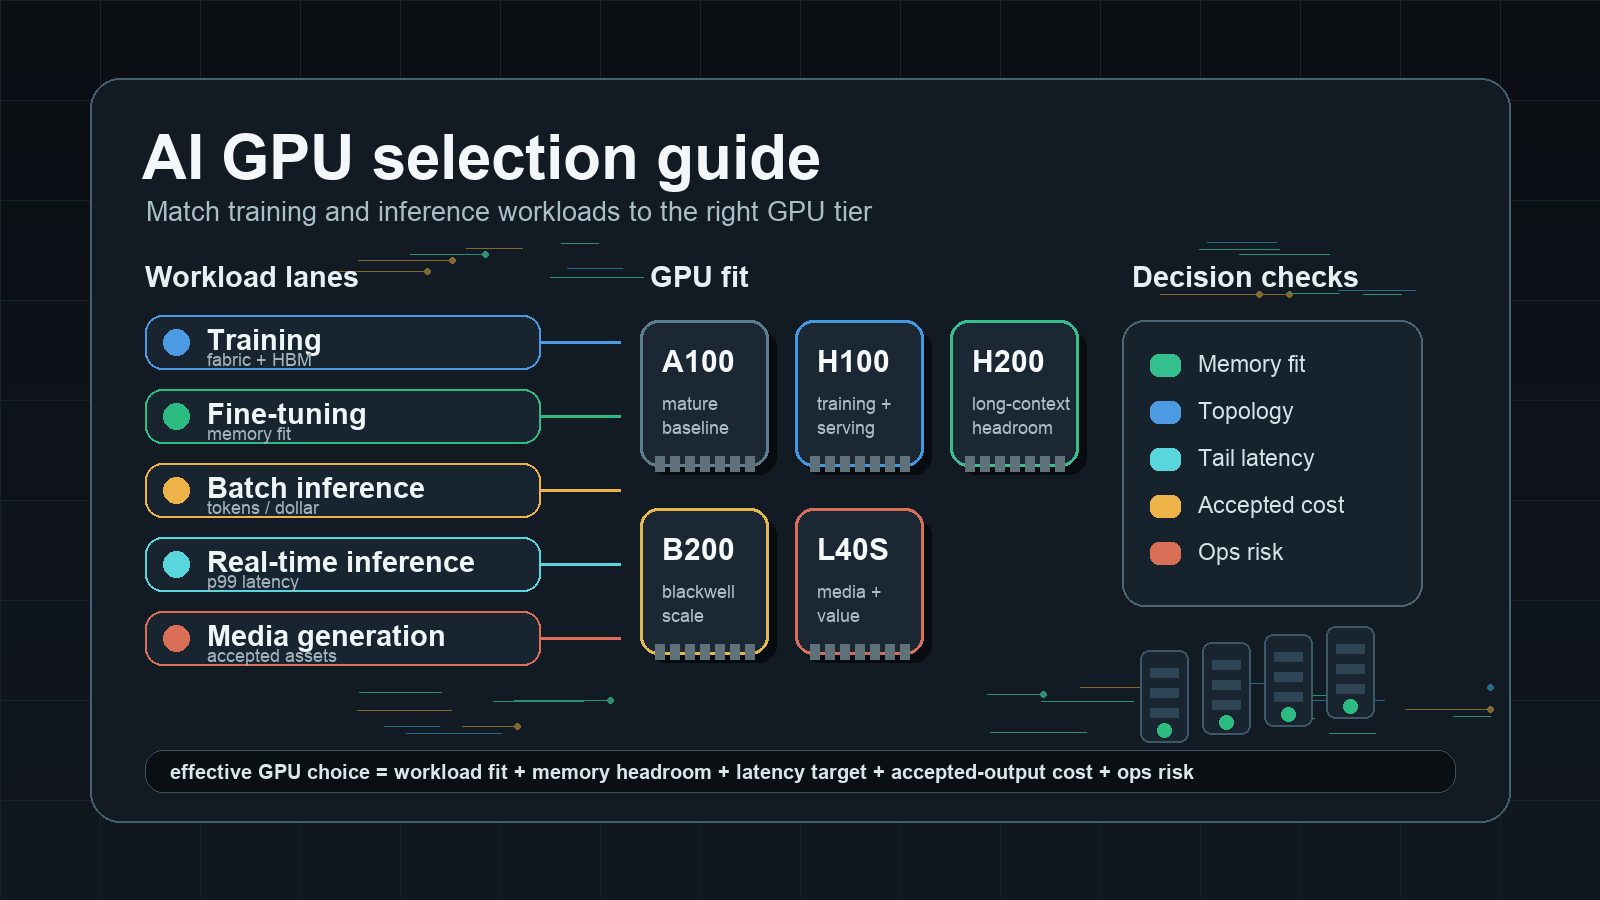
Gunakan panduan pemilihan AI GPU ini sebagai daftar periksa untuk pengadaan dan arsitektur. Panduan ini memetakan beban kerja AI umum ke karakteristik GPU yang penting, menjelaskan kapan H100, H200, B200, A100, L40S, sistem kelas GB200, dan GPU lokal kelas RTX masuk akal, serta menawarkan rencana benchmarking yang mengaitkan keputusan pembelian dengan pekerjaan yang selesai, bukan angka puncak sintetis.
Aturan praktis Flatkey: pilih GPU berdasarkan biaya per proses pelatihan yang selesai, biaya per token yang diterima, biaya per gambar atau video yang diterima, serta risiko operasional yang siap Anda tanggung. Jika Anda hanya memerlukan akses ke model, pengelolaan, opsi cadangan, dan satu log penggunaan terpadu, bandingkan penyewaan GPU dengan jalur melalui model/API sebelum berinvestasi dalam perangkat keras.
Jawaban singkat dalam panduan pemilihan AI GPU
Mulailah dengan matriks ini sebelum membandingkan penawaran penyedia.
| Beban kerja | Biasanya diprioritaskan | Arah GPU | Hal yang perlu diperhatikan |
|---|---|---|---|
| Pra-pelatihan atau pelatihan skala besar | Jaringan multinode, kapasitas HBM, bandwidth memori, performa BF16/FP8, I/O checkpoint | H100/H200, sistem kelas B200/GB200, klaster pelatihan terkelola | Harga per jam bersifat sekunder dibandingkan waktu penyelesaian proses dan risiko memulai ulang |
| Fine-tuning penuh | Cadangan memori, kapasitas status optimizer, paralelisme tensor, lokalitas penyimpanan | H100, H200, B200, A100 untuk model yang lebih kecil | Kekurangan VRAM dapat memaksa penggunaan sharding yang lebih lambat atau ukuran batch yang lebih kecil |
| Fine-tuning LoRA/QLoRA | Kecocokan VRAM, kompatibilitas CUDA, performa per dolar | A100, L40S, H100, H200, GPU lokal berperforma tinggi untuk tugas kecil | Dataset dan panjang konteks dapat mengubah kebutuhan memori |
| Inferensi batch LLM | Kecocokan memori, efisiensi batching, token per dolar, toleransi antrean | L40S, A100, H100, H200, B200 tergantung ukuran model | Pemanfaatan rendah dapat meniadakan tarif GPU yang lebih murah |
| Inferensi LLM waktu nyata | Latensi p95/p99, kapasitas cache KV, stabilitas streaming, dukungan framework penyajian | H100/H200/B200 untuk model besar atau model dengan konteks panjang; L40S/A100 untuk model yang lebih kecil | Latensi ekor dan percobaan ulang lebih penting daripada puncak token/detik |
| Embedding dan reranking | Throughput per dolar, keseimbangan CPU/GPU, ukuran batch, kesederhanaan layanan | L40S, A100, GPU cloud yang lebih kecil, terkadang CPU pada volume rendah | GPU yang berlebihan sangat umum terjadi pada lalu lintas rendah |
| Pembuatan gambar dan video | VRAM, kernel media, bandwidth penyimpanan, toleransi antrean | L40S, H100/H200/B200 untuk pipeline yang lebih berat, workstation lokal kelas RTX untuk kreator | Biaya akhir per gambar/klip yang diterima lebih penting daripada kecepatan render mentah |
| Evaluasi dan data sintetis | Kapasitas puncak, pengendalian biaya, keragaman model | GPU spot/marketplace, API batch, atau jalur melalui model/API | Hindari memiliki kapasitas menganggur demi lonjakan yang jarang terjadi |
Jawaban singkat ini sengaja tidak berbunyi seperti “beli GPU tercepat”. Bagi tim AI enterprise, GPU terbaik adalah yang sesuai dengan model, panjang konteks, target latensi, konkurensi permintaan, batas data, dan model operasional tim.
Langkah 1: klasifikasikan beban kerja
Langkah pertama dalam setiap panduan pemilihan AI GPU adalah klasifikasi beban kerja. Tanpa hal ini, setiap perbandingan berikutnya akan berubah menjadi perdebatan umum tentang akselerator.
Setiap diskusi GPU harus dimulai dengan deskripsi singkat tentang beban kerja. Dokumentasikan secara tertulis sebelum meminta penawaran komersial dari penyedia.
| Bidang | Hal yang perlu ditetapkan |
|---|---|
| Jenis beban kerja | Pelatihan, fine-tuning, inferensi batch, inferensi online, pembuatan media, embedding, evaluasi, atau notebook |
| Bentuk model | Jumlah parameter, arsitektur, presisi, kuantisasi, ukuran jendela konteks, modalitas, dan perilaku tokenizer |
| Bentuk permintaan | Jumlah rata-rata dan p95 token input, token output, ukuran gambar, durasi video, ukuran batch, jumlah sesi bersamaan, atau record per tugas |
| Satuan keberhasilan | Proses pelatihan yang selesai, patch yang diterima, respons yang diterima, token yang diterima, gambar yang diterima, klip yang diterima, atau record yang diterima |
| Target latensi | Offline, menit, detik, kurang dari satu detik, persyaratan p95/p99, atau persyaratan streaming |
| Mode operasi | Selalu aktif, batch terjadwal, lonjakan musiman, eksperimen, atau notebook pengembang |
| Batas operasional | Cloud publik, jaringan privat, klaster khusus, on-prem, lokalisasi data, atau API terkelola |
| Alat | vLLM, SGLang, TensorRT-LLM, Triton, Ray, Slurm, Kubernetes, ComfyUI, atau endpoint yang dikelola penyedia |
Jika Anda tidak dapat mengisi tabel ini, tunda pemilihan GPU. Anda masih membeli kemampuan, bukan daya.
Langkah 2: pilih metrik yang tepat untuk pengambilan keputusan
Langkah kedua dalam panduan pemilihan AI GPU adalah memilih penyebutnya. Penyebut yang baik menghubungkan keputusan GPU dengan pekerjaan yang selesai, bukan dengan lembar spesifikasi vendor.
FLOPS puncak, jumlah Tensor Core, dan harga GPU per jam adalah input yang berguna, tetapi bukan metrik untuk pengambilan keputusan. Gunakan penyebut yang terkait dengan hasil bisnis.
| Beban kerja | Metrik terbaik |
|---|---|
| Pelatihan | Biaya satu siklus pelatihan selesai yang mencapai skor evaluasi target |
| Fine-tuning | Biaya satu checkpoint hasil fine-tuning yang diterima |
| Inferensi online | Biaya satu respons yang diterima pada latensi p95/p99 target |
| Inferensi batch | Biaya satu record yang diterima atau satu token output yang diterima |
| Agen kode | Biaya satu tugas yang diterima, patch yang diterima, atau issue yang diselesaikan |
| Pembuatan gambar | Biaya satu gambar yang diterima setelah filter kualitas |
| Pembuatan video | Biaya satu detik yang diterima atau satu klip yang diterima |
| Evaluasi | Biaya satu rangkaian evaluasi yang selesai dan waktu hingga respons |
Gunakan rumus dasar ini:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
Untuk pelatihan:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
Untuk inferensi:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
Di sinilah pemilihan GPU berubah. GPU yang unggul dalam benchmark throughput dapat kalah jika memerlukan topologi mahal, beroperasi pada utilisasi rendah, tidak memenuhi target latensi, atau memaksa biaya operasional tambahan.
Pemilihan GPU untuk pelatihan
Untuk pelatihan, panduan pemilihan AI GPU harus berperilaku seperti panduan klaster. GPU individual penting, tetapi penempatan, interconnect, storage, dan perilaku saat restart sering menentukan biaya siklus yang selesai.
Pelatihan memerlukan kapasitas memori besar, bandwidth memori tinggi, jaringan GPU-ke-GPU berkecepatan tinggi, penempatan multi-node yang stabil, dan checkpointing yang andal. Pelatihan lebih tidak toleran dibanding inferensi karena kegagalan node dapat menyebabkan hilangnya jam atau hari komputasi.
Hal yang paling penting untuk pelatihan
- Kapasitas HBM: parameter model, gradien, status optimizer, activations, panjang sequence, dan batch size semuanya bersaing untuk memori.
- Bandwidth memori: operasi matriks besar dan langkah optimizer dapat dibatasi oleh bandwidth.
- Interconnect: NVLink, NVSwitch, InfiniBand, RoCE, EFA, atau AI fabric dari penyedia dapat menentukan apakah penskalaan akan efisien.
- Dukungan presisi: BF16, FP8, dan jalur presisi rendah yang lebih baru hanya penting jika framework dan recipe model Anda menggunakannya dengan aman.
- Storage dan checkpoint I/O: waktu untuk menulis checkpoint dan waktu pemulihan termasuk dalam biaya siklus yang selesai.
- Keandalan penempatan: GPU yang tepat tetapi tersebar di fabric yang lemah tidak sama dengan training cluster yang kohesif.
Arah pemilihan GPU untuk pelatihan
Gunakan H100 atau H200 ketika Anda memerlukan dukungan pelatihan tingkat Hopper yang telah terbukti dan kematangan framework yang luas. H200 menambahkan kapasitas HBM dan bandwidth lebih besar daripada H100, yang berguna untuk pelatihan dan fine-tuning yang intensif memori. Gunakan sistem kelas B200 atau GB200 ketika beban kerja dapat memperoleh manfaat dari throughput tingkat Blackwell, jalur presisi lebih rendah, serta ketika penyedia benar-benar dapat menyediakan topology, dukungan framework, dan acceptance tests yang diperlukan. Gunakan A100 ketika model lebih kecil, recipe pelatihan sudah matang, anggaran terbatas, atau ketersediaan lebih penting daripada karakteristik puncak.
Jangan memilih GPU untuk pelatihan berdasarkan satu benchmark saja. Jalankan recipe Anda yang tepat atau proxy yang mendekati. Ukur waktu untuk mencapai target skor eval, perilaku saat restart, waktu checkpoint, dan total biaya. Keputusan H100 vs A100 dan H200 vs H100 biasanya dibuat berdasarkan biaya siklus yang selesai, bukan tarif per jam.
Materi terkait yang bermanfaat: H100 vs A100, H200 vs H100, B200 vs H200, dan B300 vs B200.
Pemilihan GPU untuk Fine-Tuning
Fine-tuning berada di antara pelatihan dan inferensi. Fine-tuning penuh berperilaku seperti pelatihan, sedangkan LoRA dan QLoRA dapat dijalankan pada perangkat keras yang lebih ringkas jika Anda mengendalikan ukuran model, panjang context, batch size, dan precision.
Fine-tuning penuh
Untuk fine-tuning penuh, prioritaskan memori dan topology terlebih dahulu. GPU harus dapat menampung training state atau melakukan shard terhadapnya secara efisien. H100, H200, B200, dan klaster A100 multi-GPU adalah opsi umum, bergantung pada ukuran model dan anggaran. GPU kelas H200 dan B200 dapat mengurangi kebutuhan sharding untuk tugas yang berat pada memori, tetapi hanya jika stack penyedia dan versi framework sudah siap.
Pertanyaan yang perlu diajukan:
- Model terbesar dan panjang context berapa yang perlu Anda fine-tune?
- Apakah optimizer state dimuat sepenuhnya, di-shard, di-offload, atau di-quantized?
- Apakah tugas memerlukan tensor parallelism, pipeline parallelism, FSDP, DeepSpeed, atau distributed approach lainnya?
- Apakah dataset berada secara lokal di region GPU?
- Seberapa mahal checkpoint yang gagal?
Fine-tuning adapter
Untuk LoRA, QLoRA, instruction tuning, dan domain adaptation yang lebih kecil, jawabannya bisa lebih fleksibel. A100, L40S, H100, H200, dan GPU lokal kelas RTX dapat sesuai untuk berbagai bagian workflow. Risikonya adalah mengasumsikan bahwa demo kecil berarti tugas production juga akan muat. Context yang lebih panjang, batch size yang lebih besar, lebih banyak contoh, dan validation runs dapat memindahkan tugas ke kelas yang berbeda.
Ini adalah tempat yang baik untuk melakukan benchmark dua tahap: pertama, pastikan kapasitas memori mencukupi, lalu pastikan waktu menuju checkpoint dan biaya per model hasil fine-tuning yang diterima.
Pemilihan GPU untuk Inferensi LLM
Untuk inferensi, panduan pemilihan AI GPU harus memisahkan kecocokan memori dari kecocokan latensi. GPU dapat memuat model tetapi tetap tidak memenuhi target p99 production.
Inferensi bukanlah satu jenis workload. GPU yang tepat berubah bergantung pada ukuran model, panjang konteks, konkurensi, target latensi, serta apakah request diproses secara batch atau real-time.
Kecocokan memori terlebih dahulu
Untuk inferensi LLM, memori GPU harus menampung bobot model dan KV cache dengan ruang yang cukup untuk serving framework. Context panjang dan konkurensi tinggi dapat menjadikan KV cache sebagai faktor utama tekanan memori. GPU yang sesuai untuk satu versi model bagi satu pengguna mungkin tidak sesuai pada production concurrency.
Gunakan checklist ini:
- Ukuran bobot pada presisi Anda: FP16, BF16, FP8, INT8, INT4, atau format terkuantisasi lainnya.
- Jendela konteks dan perkiraan panjang input p95.
- Panjang output dan perilaku streaming.
- Sesi konkuren dan ukuran batch.
- Strategi KV cache, prefix cache, dan perilaku eviction.
- Overhead serving framework.
- Margin keamanan untuk lonjakan dan fragmentasi.
Jika kapasitas memori sangat terbatas, GPU dengan memori lebih besar dapat lebih baik daripada GPU yang secara teoretis lebih cepat tetapi memiliki memori lebih kecil, karena GPU tersebut dapat menghindari sharding, offload, atau kuantisasi dengan kualitas lebih rendah.
Inferensi real-time
Inferensi real-time lebih mengutamakan latency p95 dan p99, bukan hanya throughput rata-rata. GPU kelas H100, H200, dan B200 biasanya lebih sesuai untuk model besar, context panjang, dan workload yang sensitif terhadap latensi. L40S dan A100 dapat hemat biaya untuk model yang lebih kecil, konkurensi lebih rendah, atau workload dengan persyaratan p99 yang tidak terlalu ketat.
Ukur:
- Waktu hingga token pertama.
- Latensi antar-token.
- End-to-end latency p95/p99.
- Token per detik per GPU.
- Token yang diterima per dolar.
- Tingkat error saat lonjakan traffic.
- Amplifikasi retry saat rate limits, OOM, atau deployment.
Untuk memilih serving stack, gunakan vLLM vs SGLang dan panduan deployment vLLM.
Inferensi batch
Inferensi batch dapat menukar latensi dengan throughput. Ini membuka lebih banyak opsi GPU. L40S, A100, H100, H200, dan B200 dapat sesuai jika model dapat dimuat dan utilisasinya tinggi. Metrik utama biasanya adalah jumlah hasil yang diterima per dolar dalam satu jendela batch.
Workload batch juga cocok untuk spot, jendela reservasi, atau serverless GPU capacity ketika perilaku retry terkendali. Jika batch yang sama dapat dikirim ke model API dengan beban operasional yang lebih rendah, bandingkan kedua jalur menggunakan tabel GPU cloud vs model API.
Pemilihan GPU untuk Generasi Media
Generasi gambar dan video sering kali memiliki karakteristik yang berbeda dari inferensi teks. VRAM, kompleksitas pipeline model, I/O penyimpanan, dan toleransi terhadap antrean lebih penting daripada latensi percakapan.
L40S sering menjadi pilihan menarik untuk gambar dan beban kerja media berskala kecil karena memiliki kemampuan inferensi dan grafis yang kuat dengan biaya pengadaan lebih rendah daripada GPU kelas H100. H100, H200, dan B200 menjadi lebih relevan ketika beban kerja lebih berat, berukuran lebih besar, multimodal, atau memiliki batasan latensi yang ketat. Workstation lokal kelas RTX dapat berguna bagi kreator konten, pembuatan prototipe, dan pipeline bervolume rendah, tetapi tim produksi tetap membutuhkan antrean, penyimpanan, percobaan ulang, dan observabilitas.
Gunakan biaya per gambar atau klip yang diterima, bukan sekadar waktu rendering:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
Jika tim Anda hanya membutuhkan akses ke beberapa model untuk gambar atau video, menggunakan model/API mungkin lebih sederhana daripada menjalankan pipeline media GPU. Terapkan disiplin pengadaan yang sama seperti untuk teks: perhatikan biaya per hasil yang diterima, bukan hanya daftar harga.
Panduan ringkas model GPU
Gunakan tabel ini sebagai titik awal, lalu periksa spesifikasi dan ketersediaan terkini di halaman resmi penyedia. Jangan menganggapnya sebagai tabel harga.
| Seri GPU | Peran praktis | Indikator kecocokan terbaik | Hal-hal yang perlu diperhatikan |
|---|---|---|---|
| NVIDIA A100 | Platform dasar yang matang untuk pelatihan dan inferensi | Resep yang sudah ada, varian 40GB/80GB, ketersediaan luas di cloud, beban kerja yang sensitif terhadap anggaran | Generasi lebih lama; bandwidth memori lebih rendah dan dukungan untuk format presisi yang lebih baru lebih terbatas dibandingkan H100/H200/B200 |
| NVIDIA H100 | Andalan kelas Hopper untuk pelatihan dan inferensi | Framework yang sangat matang, dukungan FP8 Transformer Engine, bandwidth memori tinggi, opsi NVLink/NVSwitch | Pasokan dan harga masih dapat menjadi kendala; memori mungkin tidak mencukupi untuk inferensi dengan konteks sangat panjang dan tingkat konkurensi tinggi |
| NVIDIA H200 | Varian Hopper dengan kapasitas memori yang lebih besar | Kapasitas HBM dan bandwidth lebih besar daripada H100; berguna untuk inferensi dengan konteks panjang dan tugas yang membutuhkan banyak memori | Ketersediaan dan harga bervariasi; bandingkan dengan H100 untuk beban kerja spesifik Anda |
| NVIDIA B200 | Akselerator kelas Blackwell | Pelatihan dan inferensi berat, dukungan format presisi rendah yang lebih baru, kapasitas memori besar, dan bandwidth tinggi | Memerlukan kesiapan stack, ketersediaan di penyedia, dan pemeriksaan topologi |
| NVIDIA GB200 / sistem skala rak | Pelatihan berskala besar dan inferensi berdensitas tinggi | Tugas berskala klaster yang arsitektur sistemnya sama pentingnya dengan chip GPU itu sendiri | Pengadaan dan pengoperasian merupakan keputusan tingkat sistem, bukan sekadar satu GPU |
| NVIDIA L40S | Inferensi dan tugas media yang sensitif terhadap biaya | Memori berkapasitas 48GB, pipeline gambar/video, inferensi LLM kecil, tugas batch | Bukan pengganti universal untuk H100/H200 dalam pelatihan skala besar atau inferensi LLM dengan persyaratan p99 yang ketat |
| GPU lokal kelas RTX | Eksperimen lokal dan alur kerja untuk kreator konten | Pembuatan prototipe, model kecil, iterasi pada workstation pribadi | Kapasitas memori terbatas, rekam jejak pengoperasian di pusat data yang lebih terbatas, dan dengan sendirinya bukan merupakan klaster produksi |
Ada fakta pengadaan penting yang tersirat dalam tabel ini: model GPU hanyalah sebagian dari jawaban. Faktor bentuk node, penyimpanan, penjadwal, interkoneksi, model kuota, dan kualitas dukungan dapat menentukan apakah GPU tersebut akan berguna.
Daftar periksa pengadaan
Sebelum membeli atau menyewa, mintalah informasi berikut kepada penyedia.
Perangkat keras dan topologi
- Model GPU yang tepat, kapasitas memori, faktor bentuk node, dan jumlah GPU per node.
- Interkoneksi di dalam node dan antarnode.
- CPU, RAM, NVMe lokal, bandwidth penyimpanan, dan bandwidth jaringan.
- Asumsi mengenai region, zona, placement group, rak, atau klaster khusus.
- Proses penggantian GPU, node, penyimpanan, dan perangkat jaringan yang rusak.
Stack perangkat lunak
- Versi driver, CUDA, cuDNN, NCCL, container runtime, dan framework yang didukung.
- Model akses: Kubernetes, Slurm, endpoint terkelola, atau bare-metal.
- Dukungan untuk vLLM, SGLang, TensorRT-LLM, Triton, Ray, atau pipeline media.
- Kolom observabilitas untuk penggunaan GPU, memori, waktu tunggu dalam antrean, latensi, kesalahan, dan biaya.
- Proses pembaruan dan pengembalian ke versi sebelumnya.
Model komersial
- On-demand, spot, reserved, marketplace, klaster khusus, private cloud, atau endpoint terkelola.
- Komitmen minimum, hak pembatalan, tarif penggunaan berlebih, dan tingkat dukungan.
- Biaya penyimpanan, egress, snapshot, IP publik, load balancer, dan jaringan privat.
- Format ekspor penggunaan dan perincian tagihan.
- Apakah kapasitas yang tidak terpakai dikenai biaya dan bagaimana otomatisasi penghentian bekerja.
Keamanan dan tata kelola
- Batas jaringan, model VPC/VNet, dukungan private endpoint, dan kebijakan egress.
- IAM, penanganan secret, audit logs, akses dukungan, dan notifikasi insiden.
- Penyimpanan data, periode retensi checkpoint, pencadangan, penghapusan, dan legal hold.
- Bukti kepatuhan terhadap persyaratan dan dukungan vendor review.
- Anggaran per tim, kuota, tag, serta dukungan chargeback/showback.
Checklist ini berlaku untuk cloud GPU publik, cloud GPU privat, dan penyewaan klaster GPU. Semakin besar komitmennya, semakin banyak bukti yang harus diminta.
Rencana benchmark: cara menguji sebelum membuat komitmen
Ini adalah bagian dari panduan pemilihan AI GPU yang harus menjadi bukti Anda untuk pengadaan. Simpan input, hasil, dan kriteria penerimaan agar tim keuangan dan platform dapat meninjau keputusan tersebut di kemudian hari.
Jalankan benchmark yang menyerupai beban kerja Anda. Jangan hanya mengandalkan tabel benchmark publik.
Tahap 1: uji kecocokan memori
- Muat model yang tepat atau analog terdekat.
- Gunakan presisi dan kuantisasi target.
- Tetapkan panjang konteks dan ukuran batch yang diperlukan.
- Jalankan permintaan atau rekaman yang representatif.
- Catat penggunaan memori puncak, fragmentasi, frekuensi OOM, dan margin aman.
Tahap 2: uji throughput dan latensi
- Uji trafik stabil dan trafik lonjakan.
- Ukur latensi p50, p95, dan p99.
- Ukur waktu hingga token pertama untuk tugas LLM streaming.
- Ukur tokens/sec, images/hour, clips/hour, atau records/hour.
- Catat hasil yang diterima, bukan hanya yang dihasilkan.
Tahap 3: uji kegagalan dan operasional
- Hentikan worker, keluarkan node dari operasi, mulai ulang serving stack, dan simulasikan deployment yang gagal.
- Uji pemulihan checkpoint untuk pelatihan dan fine-tuning.
- Uji waktu cold-start dan waktu pemuatan model.
- Konfirmasikan bahwa log dan metrik dapat diakses oleh tim platform, keamanan, dan keuangan.
- Pastikan pencatatan biaya tetap terjaga saat retry dan kegagalan terjadi.
Tahap 4: Normalisasi keuangan
Buat satu baris untuk setiap kandidat:
| Kandidat | Biaya GPU | Penyimpanan/jaringan | Upaya kerja platform | Kerugian akibat kegagalan | Output yang diterima | Biaya unit efektif | Catatan |
|---|---|---|---|---|---|---|---|
| Provider A H100 | Input dari penawaran komersial | Tambahkan biaya tambahan yang diverifikasi berdasarkan sumber | Estimasi | Diukur | Diukur | Dihitung | Sertakan latensi p95 |
| Provider B H200 | Input dari penawaran komersial | Tambahkan biaya tambahan yang diverifikasi berdasarkan sumber | Estimasi | Diukur | Diukur | Dihitung | Sertakan margin memori |
| Model/API route | Biaya API yang diverifikasi berdasarkan sumber | Biaya gateway/operasional | Estimasi biaya operasional yang lebih rendah | Retry yang diukur | Diukur | Dihitung | Sertakan penerimaan kualitas |
Ini mengubah panduan pemilihan AI GPU menjadi dokumen pengambilan keputusan yang dapat ditinjau oleh tim keuangan, platform, dan produk.
Menyewa, memesan, membeli, atau menggunakan API model?
Langkah terakhir dalam panduan pemilihan AI GPU ini adalah memutuskan apakah akan menyewa kapasitas, memesannya, membelinya, atau menggunakan API model sebagai gantinya.
Pemilihan model GPU dan pemilihan model kapasitas adalah keputusan yang berbeda.
| Situasi | Titik awal terbaik |
|---|---|
| Permintaan tidak pasti, model yang berubah, atau prototipe | API model atau sewa jangka pendek |
| Eksperimen tidak teratur dan tugas evaluasi | GPU spot/marketplace atau API model batch |
| Inferensi stabil dengan beban tinggi pada satu model | GPU terpesan, endpoint khusus, atau klaster terpesan |
| Pelatihan multinode dengan persyaratan topologi | Klaster pelatihan khusus atau fabric berkecepatan tinggi yang dipesan |
| Isolasi jaringan atau perangkat keras privat yang ketat | Cloud GPU privat atau klaster khusus |
| Membutuhkan banyak model resmi, satu saldo, dan opsi cadangan | Rute model/API yang dikelola Flatkey |
Jika argumen untuk GPU pada dasarnya adalah “kami memerlukan akses ke model AI”, mulailah dengan perutean melalui model/API. Jika argumennya adalah “kami perlu mengendalikan topologi, runtime, bobot, batas data, atau kernel kustom”, pertahankan opsi GPU tetap terbuka. Perbedaannya penting karena infrastruktur GPU mencakup tanggung jawab atas scheduler, runtime, keamanan, FinOps, dan insiden.
Flatkey membantu pada sisi API dari keputusan ini: satu kunci, satu saldo, satu tagihan, pengelolaan pencatatan penggunaan, serta rute model/alat resmi. Ini bukan pengganti kontrol perangkat keras ketika kontrol perangkat keras benar-benar diperlukan. Ini adalah alternatif yang lebih sederhana ketika kebutuhan sebenarnya adalah akses model yang dikelola dan transparansi biaya.
Kesalahan umum dalam pemilihan GPU
Kesalahan 1: Memilih berdasarkan tarif per jam
Tarif per jam mengabaikan utilisasi, percobaan ulang, waktu henti, penyimpanan, jaringan, dukungan, dan waktu engineer. Gunakan biaya per beban kerja yang selesai. Panduan harga sewa GPU mencakup pos biaya tersembunyi.
Kesalahan 2: Menganggap kecocokan memori sebagai pertanyaan "ya/tidak"
Kecocokan memori pada satu panjang permintaan atau ukuran batch tidak membuktikan kelayakan untuk produksi. Konteks panjang, konkurensi tinggi, pergantian model, dan overhead framework serving dapat mengubah jawabannya.
Kesalahan 3: Mengabaikan interconnect
Untuk tugas multi-GPU dan multi-node, topologi adalah bagian dari GPU. Pool GPU yang lebih murah dengan penempatan yang lemah dapat kalah dari klaster yang lebih mahal tetapi terkoordinasi.
Kesalahan 4: Melakukan benchmark berdasarkan output yang dihasilkan, bukan output yang diterima
Beban kerja AI mencakup filter kualitas, filter keamanan, percobaan ulang, generasi yang gagal, patch yang gagal, dan eval yang gagal. Ukur biaya per output yang diterima.
Kesalahan 5: Melupakan tanggung jawab platform
Seseorang harus memelihara driver, CUDA, container, server model, autoscaling, kuota, logging, peringatan, insiden, dan pelaporan pengeluaran. Jika tim seperti itu tidak ada, perhitungkan hal tersebut.
Kesalahan 6: Membeli hanya untuk model saat ini
Pilihan model berubah. Jendela konteks bertambah. Kuantisasi membaik. Ketersediaan provider berubah. Buat dokumen keputusan tetap fleksibel dan hindari komitmen yang mengasumsikan satu model akan tetap dominan.
Sumber resmi untuk diperiksa
Gunakan halaman resmi untuk detail yang berubah-ubah atau bergantung pada vendor:
- Ikhtisar NVIDIA H100 untuk konteks GPU kelas Hopper: NVIDIA H100 Tensor Core GPU.
- Ikhtisar NVIDIA H200 untuk konteks memori HBM3e dan bandwidth yang lebih besar: NVIDIA H200 Tensor Core GPU.
- Materi NVIDIA Blackwell/DGX B200 dan GB200 untuk konteks sistem Blackwell: NVIDIA DGX B200 dan NVIDIA GB200 NVL72.
- Ikhtisar NVIDIA A100 untuk konteks platform dasar Ampere yang matang: NVIDIA A100 Tensor Core GPU.
- Halaman NVIDIA L40S untuk konteks beban kerja inferensi dan grafis/media: NVIDIA L40S.
- Dokumentasi NVIDIA MIG saat melakukan partisi GPU yang didukung: NVIDIA Multi-Instance GPU User Guide.
- Dokumentasi framework untuk serving dan kecocokan runtime: vLLM OpenAI-compatible server, dokumentasi SGLang, dan NVIDIA TensorRT-LLM.
- Halaman penawaran dan harga provider untuk ketersediaan dan biaya terkini. Cantumkan cap waktu untuk setiap harga yang Anda masukkan ke dalam tabel pengadaan.
Pertanyaan yang sering diajukan
GPU apa yang paling cocok untuk pelatihan AI?
GPU terbaik untuk pelatihan AI bergantung pada ukuran model, skema pelatihan, kebutuhan memori, interconnect, perilaku checkpoint, dan waktu untuk mencapai target eval score. Sistem kelas H100, H200, B200, dan GB200 merupakan kandidat kuat untuk tugas pelatihan besar, sedangkan A100 masih dapat memadai untuk beban kerja yang lebih kecil atau sensitif terhadap anggaran. Sebelum memilih, bandingkan biaya per run yang selesai.
GPU apa yang paling cocok untuk inferensi LLM?
GPU terbaik untuk inferensi LLM adalah yang dapat menampung bobot model dan KV cache, sekaligus memenuhi target p95/p99 latency dan biaya per token yang diterima. H100, H200, dan B200 sangat cocok untuk beban kerja besar atau berkonteks panjang. L40S dan A100 dapat efektif untuk model yang lebih kecil, batch inference, dan persyaratan latency yang lebih longgar. Untuk perhitungan khusus inferensi, gunakan panduan terperinci tentang best GPU for LLM inference.
Apakah H200 selalu lebih baik daripada H100?
Tidak. H200 menawarkan kapasitas memori yang lebih besar dan bandwidth lebih tinggi daripada H100, yang dapat membantu untuk inferensi dan pelatihan yang berat pada memori. Namun, pilihan terbaik bergantung pada harga, ketersediaan, kematangan framework, ukuran batch, latency, dan apakah beban kerja benar-benar dibatasi oleh memori. Jika H100 mencapai target dengan biaya efektif yang lebih rendah, H100 masih dapat menjadi pilihan terbaik.
Kapan saya harus memilih L40S alih-alih H100?
Pilih L40S ketika model muat, persyaratan latency moderat, performa media/inference per dolar penting, dan kemampuan kelas H100 tidak akan dimanfaatkan sepenuhnya. Pilih H100 ketika model yang lebih besar, p99 latency yang lebih ketat, pelatihan, atau inferensi dengan konkurensi tinggi memerlukan performa akselerator pusat data yang lebih tinggi.
Haruskah saya menyewa GPU atau menggunakan model API?
Sewa GPU ketika Anda memerlukan kontrol atas perangkat keras, runtime sendiri, topologi privat, atau beban stabil untuk model dengan permintaan yang konstan. Gunakan model API ketika permintaan tidak pasti, model sering berubah, akses ke model frontier penting, atau bagi tim Anda governance, fallback, ledger, dan satu tagihan lebih penting daripada kontrol atas perangkat keras. Bandingkan dengan GPU cloud vs model API.
Bagaimana cara menghindari pembelian GPU berlebihan?
Hindari pembelian berlebihan dengan melakukan benchmark pada beban kerja yang tepat, mengukur hasil yang diterima, termasuk waktu idle dan operasional, serta terlebih dahulu menguji alternatif yang lebih kecil atau terkelola. Lakukan reservasi atau pembelian hanya setelah trafik, pilihan model, dan utilisasi terkonfirmasi.
Kesimpulan
Panduan pemilihan AI GPU ini bukanlah peringkat akselerator. Ini adalah cara untuk membuat keputusan GPU lebih terinformasi. Mulailah dari beban kerja, pilih metrik yang selaras dengan bisnis, pastikan memori memadai, periksa throughput dan tail latency, perhitungkan operasional dan kerugian akibat kegagalan, lalu bandingkan dengan opsi model/API sebelum membuat komitmen.
Bagi banyak tim, jawaban yang tepat adalah hibrida: GPU untuk beban kerja yang benar-benar memerlukan kontrol atas perangkat keras, serta akses model/API yang dikelola Flatkey untuk overflow, model frontier, fallback, ledger penggunaan, dan tim yang sebaiknya tidak mengelola serving stack. Pilihan GPU yang unggul adalah yang menyediakan tugas yang diterima dengan biaya yang tepat, tanpa memaksa tim Anda memiliki infrastruktur yang tidak mereka perlukan.