
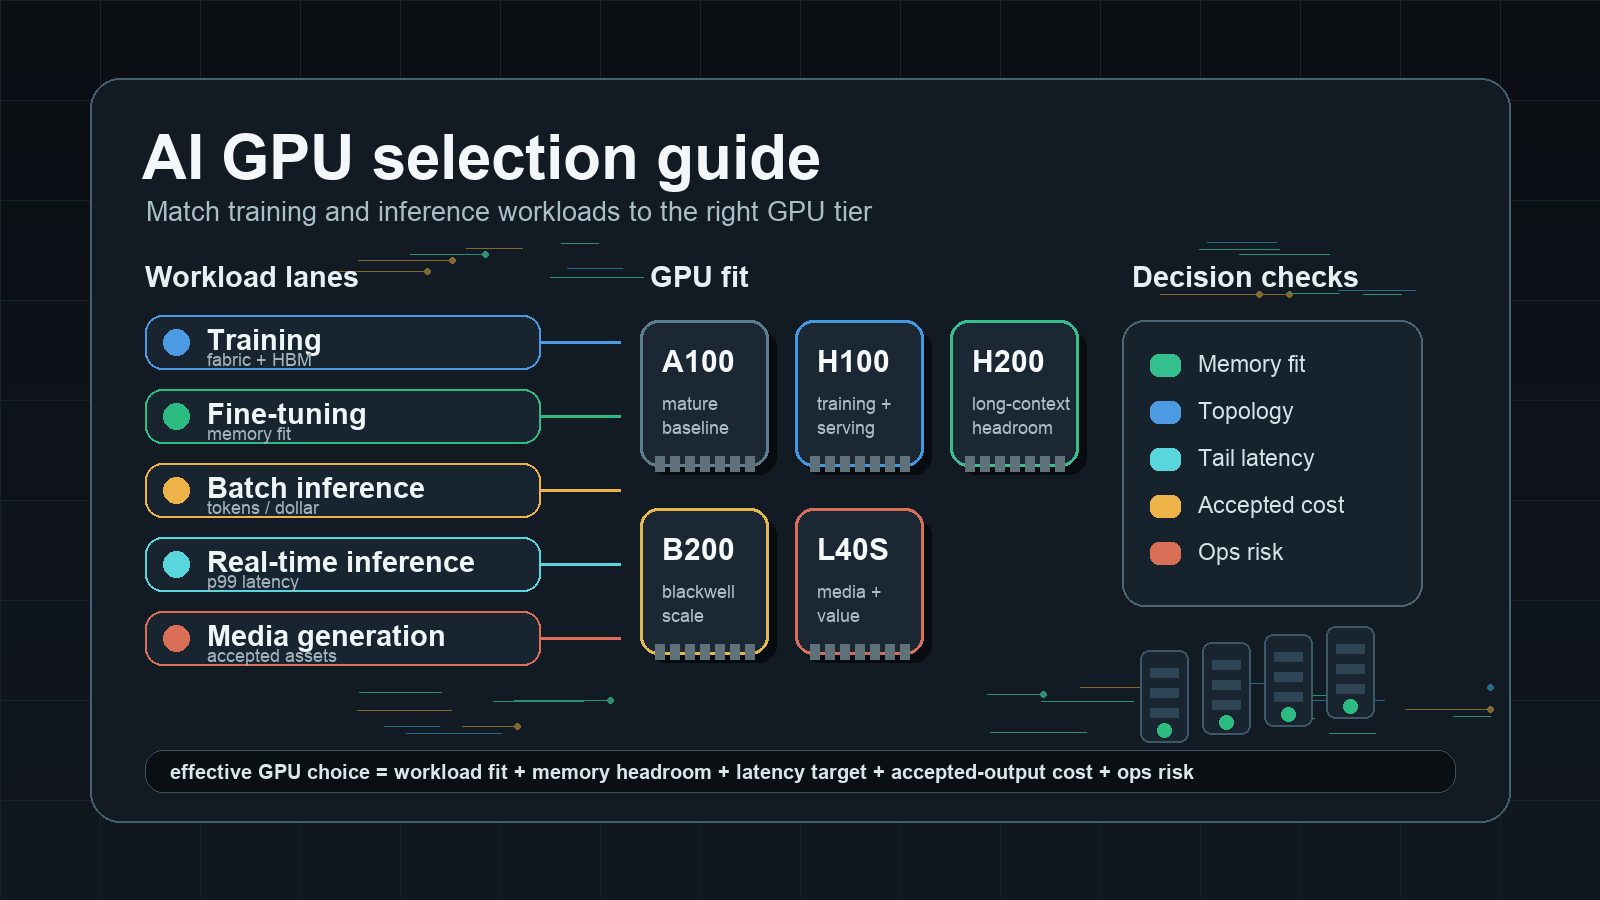
Guide de sélection de GPU IA : associez les charges de travail d’entraînement et d’inférence au bon GPU
Un guide de sélection de GPU IA devrait commencer par la charge de travail, et non par le nom du dernier accélérateur à la mode. L’entraînement, le fine-tuning, l’inférence par lots, l’inférence en temps réel, les pipelines de récupération, la génération de médias et les tâches d’évaluation sollicitent les GPU de différentes manières. Le mauvais GPU peut sembler attrayant sur une grille tarifaire et malgré tout perdre dès que l’on inclut l’adéquation mémoire, la topologie réseau, le temps d’inactivité, la mise en file d’attente, le travail de la pile de service et la qualité de la sortie acceptée.
Utilisez ce guide de sélection de GPU IA comme une checklist d’achat et d’architecture. Il met en correspondance les charges de travail IA courantes avec les caractéristiques des GPU qui comptent, explique quand les H100, H200, B200, A100, L40S, les systèmes de classe GB200 et les GPU locaux de classe RTX ont du sens, et fournit un plan de benchmark qui relie la décision d’achat au travail effectivement réalisé plutôt qu’à des chiffres de pointe synthétiques.
La règle pratique de Flatkey : choisissez les GPU en fonction du coût par exécution d’entraînement terminée, du coût par jeton accepté, du coût par image ou vidéo acceptée, et du risque opérationnel que vous êtes prêt à assumer. Si vous n’avez besoin que de l’accès au modèle, de la gouvernance, d’un mécanisme de repli et d’un registre d’utilisation unique, comparez la location de GPU aux options de type modèle/API avant de vous engager dans du matériel.
Réponse rapide du guide de sélection de GPU IA
Commencez par cette matrice avant de comparer les devis des fournisseurs.
| Charge de travail | À prioriser généralement | Orientation GPU | Points de vigilance |
|---|---|---|---|
| Pré-entraînement ou entraînement à grande échelle | Maillage multi-nœuds, capacité HBM, bande passante mémoire, débit BF16/FP8, I/O des checkpoints | H100/H200, systèmes de classe B200/GB200, clusters d’entraînement managés | Le prix horaire est secondaire par rapport au temps d’exécution terminé et au risque de redémarrage |
| Fine-tuning complet | Marge mémoire, adéquation de l’état de l’optimiseur, parallélisme tensoriel, proximité du stockage | H100, H200, B200, A100 pour les modèles plus petits | Une pénurie de VRAM peut imposer un sharding plus lent ou des tailles de lot plus petites |
| Fine-tuning LoRA/QLoRA | Adéquation VRAM, compatibilité CUDA, débit par dollar | A100, L40S, H100, H200, GPU locaux haut de gamme pour les petites tâches | Le jeu de données et la longueur du contexte peuvent modifier la réponse mémoire |
| Inférence LLM par lots | Adéquation mémoire, efficacité du batching, jetons par dollar, tolérance à la file d’attente | L40S, A100, H100, H200, B200 selon la taille du modèle | Une faible utilisation peut annuler l’avantage de tarifs GPU plus bas |
| Inférence LLM en temps réel | Latence p95/p99, capacité du cache KV, stabilité du streaming, prise en charge du framework de service | H100/H200/B200 pour les modèles volumineux ou à long contexte ; L40S/A100 pour les modèles plus petits | La latence en queue de distribution et les nouvelles tentatives comptent plus que le débit maximal en jetons/s |
| Embeddings et reranking | Débit par dollar, équilibre CPU/GPU, taille de lot, simplicité du service | L40S, A100, petits GPU cloud, parfois CPU pour les faibles volumes | Le surdimensionnement GPU est fréquent à faible trafic |
| Génération d’images et de vidéos | VRAM, kernels médias, débit de stockage, tolérance à la file d’attente | L40S, H100/H200/B200 pour les pipelines plus lourds, stations de travail locales de classe RTX pour les créateurs | Le coût de bout en bout par image/clip accepté l’emporte sur la vitesse brute de rendu |
| Évaluation et données synthétiques | Capacité de pointe, contrôles de coûts, variété des modèles | GPU spot/de place de marché, API batch, ou routes modèle/API | Évitez de posséder une capacité inactive pour des pics occasionnels |
La réponse rapide n’est volontairement pas « achetez le GPU le plus rapide ». Pour les équipes IA d’entreprise, le meilleur GPU est celui qui correspond au modèle, à la longueur du contexte, à l’objectif de latence, à la concurrence, à la frontière des données et au modèle opérationnel de l’équipe.
Étape 1 : classer la charge de travail
La première étape de tout guide de sélection de GPU IA est la classification de la charge de travail. Sans cela, toute comparaison ultérieure se réduit à un débat générique sur les accélérateurs.
Chaque discussion sur les GPU devrait commencer par une synthèse de la charge de travail. Rédigez-la avant de demander des devis aux fournisseurs.
| Champ | Ce qu’il faut capturer |
|---|---|
| Type de charge de travail | Entraînement, fine-tuning, inférence par lots, inférence en ligne, génération de médias, embeddings, évaluation ou notebooks |
| Forme du modèle | Nombre de paramètres, architecture, précision, quantification, fenêtre de contexte, modalité et comportement du tokenizer |
| Forme de la requête | Jetons d’entrée moyens et p95, jetons de sortie, taille d’image, durée de vidéo, taille de lot, sessions simultanées ou enregistrements par tâche |
| Unité de réussite | Exécution d’entraînement terminée, patch accepté, réponse acceptée, jeton accepté, image acceptée, clip accepté ou enregistrement accepté |
| Objectif de latence | Hors ligne, minutes, secondes, sous-seconde, exigence p95/p99 ou exigence de streaming |
| Cycle d’utilisation | En continu, batch planifié, pic saisonnier, expérimental ou notebook de développement |
| Périmètre d’exploitation | Cloud public, réseau privé, cluster dédié, sur site, résidence des données ou API managée |
| Outils | vLLM, SGLang, TensorRT-LLM, Triton, Ray, Slurm, Kubernetes, ComfyUI ou endpoints gérés par le fournisseur |
Si vous ne pouvez pas remplir ce tableau, suspendez la sélection du GPU. Vous achetez encore une possibilité, pas une capacité.
Étape 2 : choisir la bonne métrique de décision
La deuxième étape d’un guide de sélection de GPU IA consiste à choisir le dénominateur. Un bon dénominateur relie la décision GPU au travail accompli, et non à une fiche technique de fournisseur.
Les FLOPS de pointe, les nombres de Tensor Core et le prix horaire du GPU sont des entrées utiles, mais ce ne sont pas les métriques de décision. Utilisez un dénominateur lié au résultat métier.
| Charge de travail | Meilleure métrique |
|---|---|
| Entraînement | Coût par exécution d’entraînement terminée atteignant le score d’évaluation cible |
| Fine-tuning | Coût par checkpoint affiné accepté |
| Inférence en ligne | Coût par réponse acceptée au seuil de latence p95/p99 |
| Inférence par lot | Coût par enregistrement accepté ou par jeton de sortie accepté |
| Agents de code | Coût par tâche acceptée, patch accepté ou problème résolu |
| Génération d’images | Coût par image acceptée après les filtres de qualité |
| Génération de vidéo | Coût par seconde acceptée ou clip accepté |
| Évaluation | Coût par suite d’évaluation terminée et temps de réponse |
Utilisez cette formule de base :
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
Pour l’entraînement :
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
Pour l’inférence :
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
C’est ici que les choix de GPU changent. Un GPU qui gagne un benchmark de débit peut perdre s’il nécessite une topologie coûteuse, fonctionne à faible utilisation, manque l’objectif de latence ou impose un travail opérationnel supplémentaire.
Sélection de GPU pour l’entraînement
Pour l’entraînement, un guide de sélection de GPU IA doit se comporter comme un guide de cluster. Le GPU individuel compte, mais le placement, l’interconnexion, le stockage et le comportement au redémarrage déterminent souvent le coût d’une exécution terminée.
L’entraînement exige une grande mémoire, une bande passante mémoire élevée, un réseau GPU-à-GPU haut débit, un placement stable multi-nœuds et une fiabilité du checkpointing. Il est moins tolérant que l’inférence, car un nœud défaillant peut gaspiller des heures ou des jours de calcul.
Ce qui compte le plus pour l’entraînement
- Capacité HBM : les paramètres du modèle, les gradients, les états de l’optimiseur, les activations, la longueur de séquence et la taille de lot se disputent tous la mémoire.
- Bande passante mémoire : les grandes opérations matricielles et les étapes de l’optimiseur peuvent être limitées par la bande passante.
- Interconnexion : NVLink, NVSwitch, InfiniBand, RoCE, EFA ou un tissu IA spécifique au fournisseur peuvent déterminer si la montée en charge est efficace.
- Prise en charge de la précision : BF16, FP8 et les nouveaux chemins de faible précision ne sont pertinents que si votre framework et la recette de votre modèle les utilisent en toute sécurité.
- Stockage et I/O de checkpointing : le temps d’écriture du checkpoint et le temps de récupération font partie du coût d’une exécution terminée.
- Fiabilité du placement : les bons GPU dispersés sur un tissu faible ne sont pas équivalents à un cluster d’entraînement cohérent.
Orientation GPU pour l’entraînement
Utilisez H100 ou H200 lorsque vous avez besoin d’une prise en charge éprouvée de l’entraînement de classe Hopper et d’une grande maturité des frameworks. H200 ajoute davantage de capacité et de bande passante HBM que H100, ce qui est utile pour l’entraînement et le fine-tuning gourmands en mémoire. Utilisez des systèmes de classe B200 ou GB200 lorsque la charge de travail peut bénéficier du débit de classe Blackwell, de chemins de précision plus faibles, et qu’un fournisseur peut réellement fournir la topologie, la prise en charge des frameworks et les tests d’acceptation dont vous avez besoin. Utilisez A100 lorsque le modèle est plus petit, que la recette d’entraînement est mature, que le budget est contraint ou que la disponibilité compte plus que la performance de pointe.
Ne choisissez pas un GPU d’entraînement sur la base d’un seul benchmark. Exécutez votre recette exacte ou un proxy proche. Mesurez le temps pour atteindre le score d’évaluation cible, le comportement au redémarrage, le temps de checkpointing et le coût total. Les décisions H100 vs A100 et H200 vs H100 sont généralement des décisions liées à l’exécution terminée, pas au tarif horaire.
Lectures complémentaires utiles : H100 vs A100, H200 vs H100, B200 vs H200, et B300 vs B200.
Sélection de GPU pour le fine-tuning
Le fine-tuning se situe entre l’entraînement et l’inférence. Le fine-tuning complet se comporte comme l’entraînement, tandis que LoRA et QLoRA peuvent tenir sur du matériel plus petit si la taille du modèle, la longueur de contexte, la taille de lot et la précision sont maîtrisées.
Fine-tuning complet
Pour le fine-tuning complet, donnez la priorité à la mémoire et à la topologie. Le GPU doit contenir l’état d’entraînement ou le fragmenter efficacement. H100, H200, B200 et les clusters multi-GPU A100 sont des orientations courantes selon la taille du modèle et le budget. Les GPU de classe H200 et B200 peuvent réduire la pression de fragmentation pour les jobs gourmands en mémoire, mais seulement si la pile du fournisseur et la version du framework sont prêtes.
Questions à poser :
- Quel est le plus grand modèle et la plus grande longueur de contexte que vous devez fine-tuner ?
- Les états de l’optimiseur sont-ils entièrement chargés, fragmentés, déchargés ou quantifiés ?
- Le job nécessite-t-il du parallélisme tensoriel, du parallélisme pipeline, FSDP, DeepSpeed ou une autre approche distribuée ?
- Le jeu de données est-il local à la région GPU ?
- Quelle est la dépense d’un checkpoint échoué ?
Fine-tuning par adaptateur
Pour LoRA, QLoRA, l’instruction tuning et une adaptation de domaine plus légère, la réponse peut être plus flexible. A100, L40S, H100, H200 et des GPU locaux de classe RTX peuvent tous convenir à différentes parties du workflow. Le risque est de supposer qu’une petite démonstration signifie que le job de production tiendra. Des contextes plus longs, des tailles de lot plus grandes, davantage d’exemples et des exécutions de validation peuvent faire basculer le job dans une autre catégorie.
C’est un bon endroit pour exécuter un benchmark en deux étapes : d’abord prouver l’adéquation mémoire, puis prouver le temps jusqu’au checkpoint et le coût par modèle fine-tuné accepté.
Sélection de GPU pour l’inférence LLM
Pour l’inférence, un guide de sélection de GPU IA doit distinguer l’adéquation mémoire de l’adéquation en latence. Un GPU peut charger le modèle et malgré tout manquer la cible p99 de production.
L’inférence n’est pas une seule charge de travail. Le bon GPU change selon la taille du modèle, la longueur du contexte, la concurrence, l’objectif de latence et le fait que les requêtes soient batch ou en temps réel.
L’adéquation mémoire vient en premier
Pour l’inférence LLM, la mémoire GPU doit contenir les poids du modèle et le cache KV avec suffisamment d’espace pour le framework de service. Un contexte long et une forte concurrence peuvent faire du cache KV la principale pression mémoire. Un GPU qui convient à un modèle pour un utilisateur peut échouer à la concurrence de production.
Utilisez cette liste de contrôle :
- Taille des poids à votre précision : FP16, BF16, FP8, INT8, INT4 ou un autre format quantifié.
- Fenêtre de contexte et longueur d’entrée p95 attendue.
- Longueur de sortie et comportement de streaming.
- Séances simultanées et taille du batch.
- Stratégie de cache KV, cache de préfixe et comportement d’éviction.
- Overhead du framework de service.
- Marge de sécurité pour les pics et la fragmentation.
Si la mémoire est serrée, un GPU doté de plus de mémoire peut surpasser un GPU théoriquement plus rapide mais moins bien doté en mémoire, car il évite le sharding, l’offload ou une quantification de moindre qualité.
Inférence en temps réel
L’inférence en temps réel se soucie de la latence p95 et p99, pas seulement du débit moyen. Les GPU de classe H100, H200 et B200 sont généralement plus adaptés aux grands modèles, aux contextes longs et aux charges sensibles à la latence. Les L40S et A100 peuvent être rentables pour des modèles plus petits, une concurrence plus faible ou des charges avec des objectifs p99 moins stricts.
Mesurez :
- Temps jusqu’au premier token.
- Latence entre les tokens.
- Latence de bout en bout p95/p99.
- Tokens par seconde par GPU.
- Tokens acceptés par dollar.
- Taux d’erreur sous trafic en rafale.
- Amplification des retries sous limites de débit, OOM ou déploiements.
Pour le choix de la pile de service, utilisez vLLM vs SGLang et le guide de déploiement vLLM.
Inférence batch
L’inférence batch peut échanger de la latence contre du débit. Cela ouvre davantage de choix de GPU. Les L40S, A100, H100, H200 et B200 peuvent tous convenir si le modèle tient en mémoire et si l’utilisation est élevée. La métrique décisive est généralement le nombre de sorties acceptées par dollar sur la fenêtre de batch.
Les charges batch conviennent aussi bien aux capacités spot, aux fenêtres réservées ou au GPU serverless lorsque le comportement de retry est maîtrisé. Si le même batch peut être envoyé à une API de modèle avec moins de charge opérationnelle, comparez les deux voies avec la feuille de calcul GPU cloud vs model API.
Sélection de GPU pour la génération de médias
La génération d’images et de vidéos se comporte souvent différemment de l’inférence texte. La VRAM, la complexité du pipeline de modèle, les I/O de stockage et la tolérance à la mise en file d’attente comptent davantage que la latence conversationnelle.
Le L40S est souvent attractif pour les charges d’images et de médias plus modestes, car il offre de solides caractéristiques d’inférence et orientées graphiques à un niveau d’achat inférieur à celui des GPU de classe H100. Les H100, H200 et B200 deviennent plus pertinents lorsque les charges sont plus lourdes, plus grandes, multimodales ou fortement contraintes en latence. Les stations de travail locales de classe RTX peuvent être utiles pour les créateurs, le prototypage et les pipelines à faible volume, mais les équipes de production ont toujours besoin de mise en file d’attente, de stockage, de retries et d’observabilité.
Utilisez le coût par image ou clip accepté, et non le temps de rendu brut :
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
Si votre équipe a seulement besoin d’accéder à plusieurs modèles d’image ou de vidéo, une approche par modèle/API peut être plus simple que l’exploitation de pipelines médias sur GPU. Appliquez la même discipline d’achat que pour le texte : coût par résultat accepté, et non prix catalogue seul.
Aide-mémoire des modèles de GPU
Utilisez ce tableau comme point de départ, puis vérifiez les spécifications et la disponibilité actuelles sur les pages officielles des fournisseurs. Ne l’interprétez pas comme un tableau de prix.
| Famille de GPU | Rôle pratique | Indicateurs d’adéquation | Réserves courantes |
|---|---|---|---|
| NVIDIA A100 | Référence mature pour l’entraînement et l’inférence | Recettes existantes, variantes 40 Go/80 Go, large disponibilité cloud, charges de travail sensibles au budget | Génération plus ancienne ; bande passante mémoire plus faible et voies de précision plus récentes que H100/H200/B200 |
| NVIDIA H100 | Cheval de bataille de classe Hopper pour l’entraînement et l’inférence | Bonne maturité des frameworks, prise en charge de Transformer Engine FP8, bande passante mémoire élevée, options NVLink/NVSwitch | L’approvisionnement et le prix peuvent rester contraints ; la mémoire peut être juste pour une inférence à très long contexte/forte concurrence |
| NVIDIA H200 | Option Hopper à mémoire plus élevée | Capacité et bande passante HBM plus importantes que H100 ; utile pour l’inférence à long contexte et les tâches gourmandes en mémoire | Disponibilité et prix variables ; comparez avec H100 pour votre charge de travail exacte |
| NVIDIA B200 | Accélérateur de classe Blackwell | Entraînement et inférence intensifs, nouvelles voies basse précision, mémoire et bande passante importantes | Exige une pile prête, la disponibilité du fournisseur et une validation de la topologie |
| NVIDIA GB200 / systèmes à l’échelle du rack | Grand entraînement et inférence à haute densité | Tâches à l’échelle du cluster où l’architecture système compte autant que le silicium GPU | L’approvisionnement et les opérations relèvent de décisions système, pas de décisions concernant un seul GPU |
| NVIDIA L40S | Inférence et médias sensibles au coût | Mémoire de classe 48 Go, pipelines image/vidéo, inférence de petits LLM, tâches batch | Pas de substitut universel à H100/H200 pour un grand entraînement ou une inférence LLM p99 stricte |
| GPU locaux de classe RTX | Expérimentation locale et flux de travail créatifs | Prototypage, petits modèles, itération sur poste de travail privé | Mémoire limitée, modèle d’exploitation datacenter plus faible, pas un cluster de production à lui seul |
Le tableau masque une vérité importante en matière d’approvisionnement : le modèle de GPU n’est qu’une partie de la réponse. La forme du nœud, le stockage, le planificateur, l’interconnexion, le modèle de quota et la qualité du support peuvent décider si le GPU est utile.
La liste de contrôle d’achat
Avant d’acheter ou de louer, demandez aux fournisseurs ces détails.
Matériel et topologie
- Modèle exact de GPU, capacité mémoire, forme du nœud et nombre de GPU par nœud.
- Interconnexion à l’intérieur du nœud et entre les nœuds.
- CPU, RAM, NVMe local, bande passante de stockage et bande passante réseau.
- Région, zone, groupe de placement, rack ou hypothèses de cluster dédié.
- Processus de remplacement pour les GPU, nœuds, stockage et périphériques réseau défaillants.
Pile logicielle
- Versions prises en charge du pilote, de CUDA, cuDNN, NCCL, du runtime de conteneurs et des frameworks.
- Modèle d’accès Kubernetes, Slurm, endpoint géré ou bare metal.
- Prise en charge de vLLM, SGLang, TensorRT-LLM, Triton, Ray ou de pipelines média.
- Champs d’observabilité pour l’utilisation du GPU, la mémoire, le temps d’attente en file, la latence, les erreurs et les dépenses.
- Processus de mise à niveau et de retour arrière.
Modèle commercial
- À la demande, spot, réservé, marketplace, cluster dédié, cloud privé ou endpoint géré.
- Engagement minimum, droits d’annulation, tarifs de dépassement et niveaux de support.
- Coûts de stockage, d’egress, de snapshots, d’IP publique, de load balancer et de réseau privé.
- Format d’export de l’utilisation et granularité de la facture.
- Si la capacité inactive est facturée et comment fonctionne l’automatisation d’arrêt.
Sécurité et gouvernance
- Frontière réseau, modèle VPC/VNet, prise en charge des endpoints privés et politique d’egress.
- IAM, gestion des secrets, journaux d’audit, accès du support et notification d’incident.
- Stockage des données, rétention des checkpoints, sauvegarde, suppression et conservation légale.
- Preuves de conformité et support à la revue fournisseur.
- Budgets par équipe, quotas, tags et support de refacturation/showback.
Cette liste de contrôle s’applique au cloud GPU public, au cloud GPU privé et à la location de cluster GPU. Plus l’engagement est important, plus vous devez exiger de preuves.
Plan de benchmark : comment tester avant de vous engager
C’est la partie du guide de sélection de GPU IA qui devrait devenir votre preuve d’approvisionnement. Enregistrez les entrées, les sorties et les critères d’acceptation afin que les équipes finance et plateforme puissent réexaminer la décision plus tard.
Exécutez un benchmark qui ressemble à votre charge de travail. Ne vous fiez pas uniquement aux tableaux de benchmarks publics.
Phase 1 : test d’adéquation mémoire
- Chargez le modèle exact ou le proxy le plus proche.
- Utilisez la précision et la quantification prévues.
- Définissez la longueur de contexte cible et la taille du batch.
- Exécutez des prompts ou enregistrements représentatifs.
- Notez le pic mémoire, la fragmentation, le taux d’OOM et la marge de sécurité.
Phase 2 : test de débit et de latence
- Testez le trafic soutenu et le trafic en rafale.
- Mesurez la latence p50, p95 et p99.
- Mesurez le temps jusqu’au premier token pour les charges de travail LLM en streaming.
- Mesurez les tokens/s, images/heure, clips/heure ou enregistrements/heure.
- Enregistrez les sorties acceptées, pas seulement les sorties générées.
Phase 3 : test de défaillance et d’exploitation
- Tuez un worker, videz un nœud, redémarrez la pile de service et simulez un mauvais déploiement.
- Vérifiez la récupération des checkpoints pour l’entraînement et le fine-tuning.
- Contrôlez le temps de démarrage à froid et le temps de chargement du modèle.
- Confirmez que les journaux et les métriques sont disponibles pour les équipes plateforme, sécurité et finance.
- Validez que l’attribution des coûts survit aux nouvelles tentatives et aux défaillances.
Phase 4 : normalisation financière
Créez une ligne pour chaque candidat :
| Candidat | Coût GPU | Stockage/réseau | Charge de travail de la plateforme | Déperdition liée aux échecs | Sorties acceptées | Coût unitaire effectif | Notes |
|---|---|---|---|---|---|---|---|
| Provider A H100 | Entrée à partir du devis | Ajouter les éléments supplémentaires vérifiés à la source | Estimation | Mesuré | Mesuré | Calculé | Inclure la latence p95 |
| Provider B H200 | Entrée à partir du devis | Ajouter les éléments supplémentaires vérifiés à la source | Estimation | Mesuré | Mesuré | Calculé | Inclure la marge mémoire |
| Model/API route | Coût API vérifié à la source | Coût de passerelle/d’exploitation | Estimation d’exploitation plus faible | Reprises mesurées | Mesuré | Calculé | Inclure l’acceptation qualité |
Cela transforme le guide de sélection de GPU IA en un dossier de décision que la finance, la plateforme et le produit peuvent examiner.
Louer, réserver, acheter ou utiliser une API de modèle ?
L’étape finale de ce guide de sélection de GPU IA consiste à décider si la capacité doit être louée, réservée, achetée ou évitée via une API de modèle.
La sélection du modèle GPU et la sélection du modèle de capacité sont deux décisions distinctes.
| Situation | Meilleur point de départ |
|---|---|
| Demande incertaine, modèles changeants ou prototypes | API de modèle ou location à court terme |
| Expérimentations par à-coups et jobs d’évaluation | GPU spot/marché ou API de modèle batch |
| Inférence stable à fort volume sur un seul modèle | GPU réservé, point de terminaison dédié ou cluster engagé |
| Entraînement multi-nœuds avec exigences de topologie | Cluster d’entraînement dédié ou fabric haut débit réservée |
| Besoin d’un réseau privé strict ou d’une isolation matérielle | Cloud GPU privé ou cluster dédié |
| Besoin de nombreux modèles officiels, d’une seule facture et d’un plan de repli | Routes modèle/API régies par Flatkey |
Si l’argument en faveur des GPU est surtout « nous avons besoin d’accéder à des modèles d’IA », commencez par l’acheminement via modèle/API. Si l’argument est « nous devons contrôler la topologie, l’environnement d’exécution, les poids, la frontière des données ou des kernels personnalisés », gardez ouverte la voie GPU. La différence compte, car l’infrastructure GPU implique la responsabilité du planificateur, de l’environnement d’exécution, de la sécurité, du FinOps et des incidents.
Flatkey aide pour le volet API de cette décision : une clé, un solde, une facture, des contrôles de registre d’utilisation et des routes officielles vers les modèles/outils. Ce n’est pas un remplacement du contrôle matériel lorsque le contrôle matériel est l’exigence. C’est l’alternative la plus simple lorsque le besoin réel est un accès gouverné aux modèles et une visibilité sur les coûts.
Erreurs courantes dans la sélection de GPU
Erreur 1 : choisir en fonction du tarif horaire
Le tarif horaire ignore l’utilisation, les reprises, le temps d’inactivité, le stockage, le réseau, le support et le temps des ingénieurs. Utilisez plutôt le coût de la charge de travail terminée. Le guide des prix de location de GPU couvre les lignes de coût cachées.
Erreur 2 : traiter l’adéquation mémoire comme une question oui/non
L’adéquation mémoire à une longueur de prompt ou une taille de lot donnée ne prouve pas l’adéquation en production. Un long contexte, une forte concurrence, des changements de modèle et la surcharge du framework de service peuvent modifier la réponse.
Erreur 3 : ignorer l’interconnexion
Pour les tâches multi-GPU et multi-nœuds, la topologie fait partie du GPU. Un pool de GPU moins cher avec un placement faible peut être dépassé par un cluster plus coûteux mais cohérent.
Erreur 4 : benchmarker les sorties générées au lieu des sorties acceptées
Les charges de travail IA comportent des filtres de qualité, des filtres de sécurité, des reprises, des générations échouées, des correctifs échoués et des évaluations échouées. Mesurez le coût des sorties acceptées.
Erreur 5 : oublier la responsabilité de la plateforme
Quelqu’un doit gérer les pilotes, CUDA, les conteneurs, les serveurs de modèles, l’autoscaling, les quotas, la journalisation, les alertes, les incidents et les rapports de dépenses. Si cette équipe n’existe pas, prenez-la en compte.
Erreur 6 : acheter uniquement pour le modèle d’aujourd’hui
Le choix du modèle change. Les fenêtres de contexte grandissent. La quantification s’améliore. La disponibilité des fournisseurs évolue. Gardez le dossier de décision flexible et évitez les engagements qui supposent qu’un seul modèle restera dominant.
Sources officielles à vérifier
Utilisez les pages officielles pour les détails variables ou spécifiques à un fournisseur :
- Présentation du NVIDIA H100 pour le contexte des GPU de classe Hopper : NVIDIA H100 Tensor Core GPU.
- Présentation du NVIDIA H200 pour le contexte d’une mémoire HBM3e et d’une bande passante plus importantes : NVIDIA H200 Tensor Core GPU.
- Documentation NVIDIA Blackwell/DGX B200 et GB200 pour le contexte des systèmes Blackwell : NVIDIA DGX B200 et NVIDIA GB200 NVL72.
- Présentation du NVIDIA A100 pour le contexte d’une base de référence Ampere mature : NVIDIA A100 Tensor Core GPU.
- Page NVIDIA L40S pour le contexte des charges de travail d’inférence et de graphisme/média : NVIDIA L40S.
- Documentation NVIDIA MIG lorsque vous partitionnez des GPU pris en charge : NVIDIA Multi-Instance GPU User Guide.
- Documentation des frameworks de service pour l’adéquation à l’exécution : vLLM OpenAI-compatible server, documentation SGLang, et NVIDIA TensorRT-LLM.
- Pages de devis et de tarification des fournisseurs pour la disponibilité et les coûts actuels. Horodatez chaque prix que vous copiez dans une feuille de calcul d’approvisionnement.
Questions fréquemment posées
Quel est le meilleur GPU pour l’entraînement de l’IA ?
Le meilleur GPU pour l’entraînement de l’IA dépend de la taille du modèle, de la recette d’entraînement, des besoins en mémoire, de l’interconnexion, du comportement des points de contrôle et du temps nécessaire pour atteindre le score d’évaluation cible. Les systèmes H100, H200, B200 et de classe GB200 sont de bons candidats pour les grands travaux d’entraînement, tandis qu’un A100 peut encore convenir à des charges de travail plus petites ou sensibles au budget. Évaluez le coût d’une exécution complète avant de choisir.
Quel est le meilleur GPU pour l’inférence de LLM ?
Le meilleur GPU pour l’inférence de LLM est celui qui peut héberger les poids du modèle et le cache KV tout en respectant les objectifs de latence p95/p99 et de coût par jeton accepté. Les H100, H200 et B200 sont très adaptés aux charges de travail volumineuses ou à contexte long. Les L40S et A100 peuvent être efficaces pour des modèles plus petits, l’inférence par lots et des objectifs de latence moins stricts. Utilisez le guide plus détaillé sur le meilleur GPU pour l’inférence de LLM pour les calculs spécifiques à l’inférence.
Le H200 est-il toujours meilleur que le H100 ?
Non. Le H200 offre davantage de marge mémoire et de bande passante que le H100, ce qui peut aider pour l’inférence et l’entraînement gourmands en mémoire. Mais le meilleur choix dépend du prix, de la disponibilité, de la maturité du framework, de la taille du lot, de la latence et du fait que la charge de travail soit réellement limitée par la mémoire. Si le H100 atteint la cible à un coût effectif inférieur, il peut malgré tout l’emporter.
Quand dois-je choisir un L40S plutôt qu’un H100 ?
Choisissez un L40S lorsque le modèle tient en mémoire, que les objectifs de latence sont modérés, que le débit média/inférence par dollar est important et que la capacité de classe H100 serait sous-utilisée. Choisissez un H100 lorsque des modèles plus grands, une latence p99 plus stricte, l’entraînement ou une inférence à forte concurrence exigent de meilleures performances d’accélérateur de centre de données.
Dois-je louer des GPU ou utiliser une API de modèle ?
Louez des GPU lorsque vous avez besoin de contrôle matériel, d’exécutions personnalisées, d’une topologie privée ou d’une utilisation soutenue sur un modèle stable. Utilisez une API de modèle lorsque la demande est incertaine, que les modèles changent souvent, que l’accès à des modèles de pointe est important, ou que votre équipe a davantage besoin de gouvernance, de repli, de journaux et d’une facture unique que de contrôle matériel. Comparez avec GPU cloud vs model API.
Comment éviter d’acheter trop de GPU ?
Évitez le surachat en benchmarkant la charge de travail exacte, en mesurant les sorties acceptées, en incluant le temps d’inactivité et les opérations, et en testant d’abord des alternatives plus petites ou managées. Réservez ou achetez uniquement après avoir validé le trafic, le choix du modèle et l’utilisation.
En résumé
Ce guide de sélection de GPU IA n’est pas un classement des accélérateurs. C’est une façon de rendre les décisions relatives aux GPU défendables. Commencez par la charge de travail, choisissez une métrique alignée sur l’activité, prouvez l’adéquation mémoire, testez le débit et la latence de queue, incluez les opérations et les pertes liées aux pannes, et comparez avec les options de modèle/API avant de signer un engagement.
Pour de nombreuses équipes, la bonne réponse est hybride : des GPU pour les charges de travail qui nécessitent réellement un contrôle matériel, et un accès aux modèles/API gouverné par Flatkey pour le débordement, les modèles de pointe, le repli, les journaux d’utilisation et les équipes qui ne devraient pas exploiter une pile de service. Le bon choix de GPU est celui qui fournit le travail accepté au bon coût, sans obliger votre équipe à gérer une infrastructure dont elle n’a pas besoin.


