
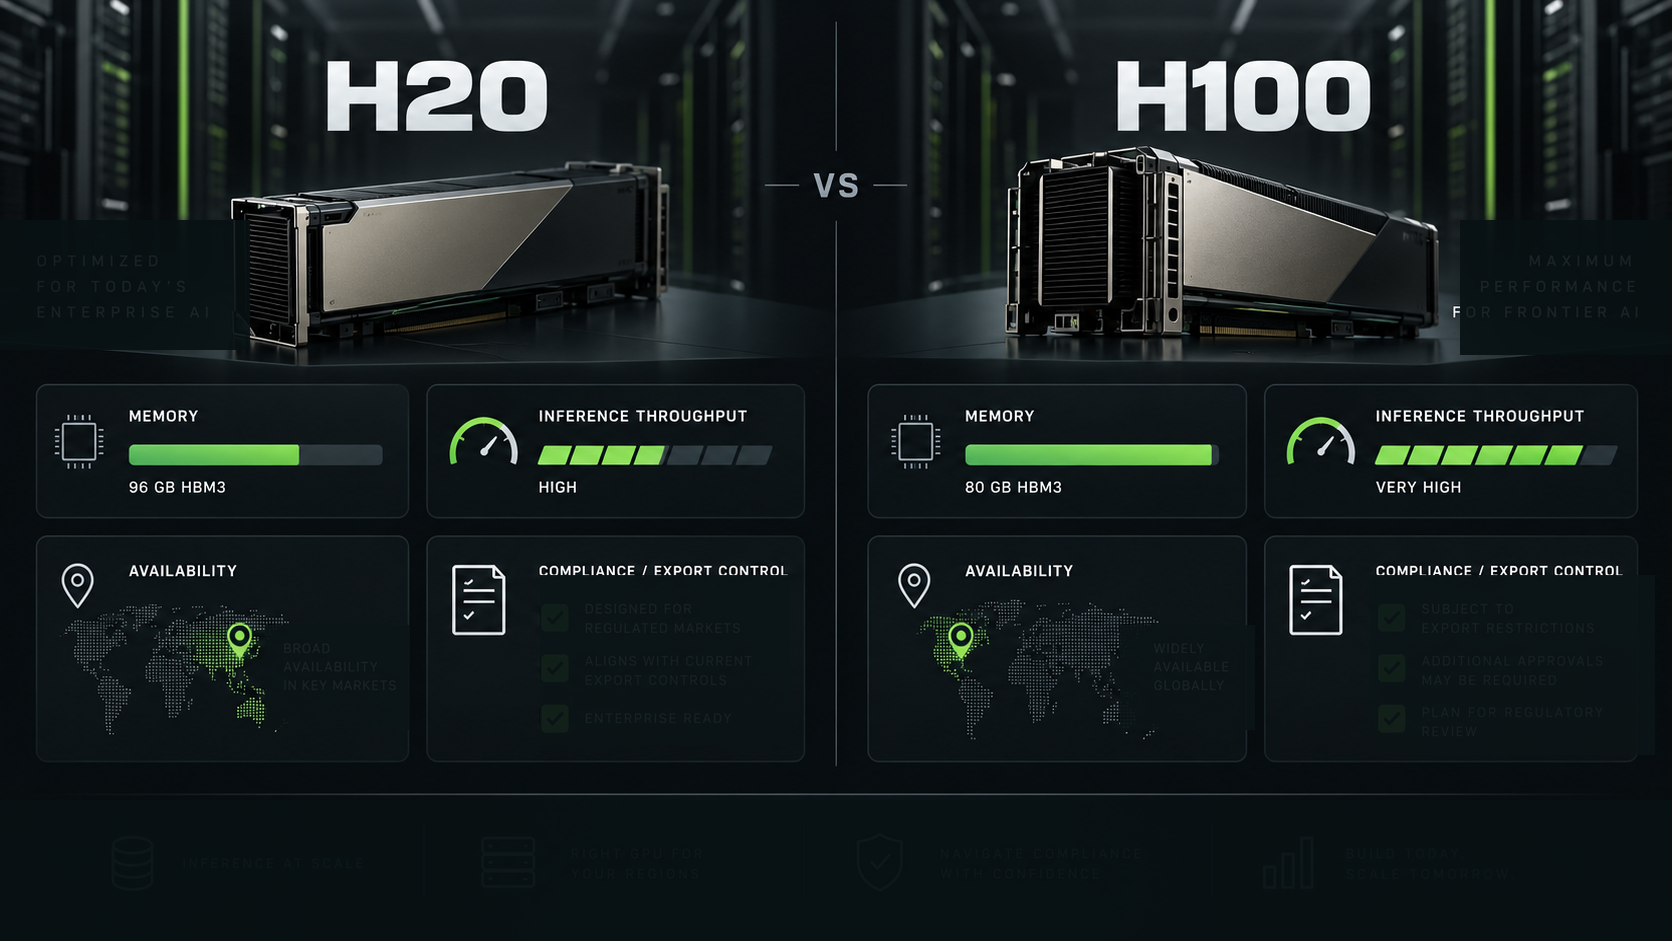
Si está comparando H20 vs H100, la versión corta es esta: H100 es la opción predeterminada más sólida cuando puede adquirirla legalmente, obtenerla de forma fiable y mantenerla en uso. H20 solo se vuelve atractiva cuando las restricciones de control de exportaciones, la disponibilidad en el mercado chino o las reglas de compra locales hacen que H100 sea poco práctico.
Eso convierte a NVIDIA H20 vs H100 en algo menos parecido a una comparación normal de tabla de especificaciones y más a una decisión de capacidad con consideración de cumplimiento. H100 es la GPU Hopper más conocida para entrenamiento e inferencia. H20 es una vía restringida de la familia Hopper que los compradores evalúan cuando el contexto de adquisición está condicionado por licencias de exportación, normas del mercado de la RPC y disponibilidad de SKU específica del proveedor.
Para los equipos de IA empresariales, la pregunta útil h20 vs h100 no es "¿qué GPU es más rápida?" Es: ¿qué opción puede entregar una salida de inferencia aceptada al menor riesgo total después de incluir ajuste de memoria, tiempo de cola, aprobación de cumplimiento y disponibilidad?
H20 vs H100: respuesta rápida
Elija H100 cuando:
- Pueda adquirir o alquilar capacidad H100 en la región de despliegue sin bloqueos de control de exportaciones.
- Su carga de trabajo necesite una base Hopper madura para entrenamiento, ajuste fino o inferencia de alto rendimiento.
- Necesite una gran madurez de software, amplio soporte en la nube y referencias de benchmarks predecibles.
- Su modelo no requiera una ruta de adquisición de GPU específica para China.
Elija H20 solo cuando:
- El despliegue tenga que ajustarse a un mercado restringido o a una ubicación de cliente donde H100 no esté disponible o sea difícil de licenciar.
- El proveedor pueda mostrar el SKU exacto de H20, el tamaño de memoria, la interconexión, la imagen del controlador y los términos comerciales.
- El cumplimiento, la ubicación del cliente, la reventa y los controles de uso final ya formen parte del proceso de compra.
- Esté comparando una carga de trabajo de inferencia real, no confiando en tablas de especificaciones pico de terceros.
Para la mayoría de los equipos, H20 vs H100 se decide antes por disponibilidad y cumplimiento que por rendimiento bruto de inferencia. Si ambos están disponibles en términos legales y comerciales aceptables, H100 es la opción predeterminada más segura.
Especificaciones de NVIDIA H20 vs H100 que importan
La parte difícil de una comparación de especificaciones de NVIDIA H20 vs H100 es que H100 tiene una página pública de producto, mientras que los datos públicos de H20 están más fragmentados. La página pública de H100 de NVIDIA enumera la GPU H100 Tensor Core como una GPU de centro de datos Hopper con opciones de memoria HBM y cifras pico publicadas de IA/HPC. La documentación de NVIDIA AI Enterprise enumera públicamente variantes de H20 en la matriz de compatibilidad de vGPU de Hopper, incluidos perfiles H20 SXM5 con entradas de framebuffer de 96GB y 141GB.
Considere esta tabla como una lista de verificación de compras, no como una hoja de cotización final.
| Área de especificación | H100 | H20 |
|---|---|---|
| Posicionamiento público | GPU Hopper de centro de datos convencional para IA, HPC, entrenamiento e inferencia | Ruta de GPU de centro de datos de la familia Hopper evaluada en contextos de compra restringidos |
| Página pública de producto de NVIDIA | Sí, H100 tiene una página de producto dedicada | No hay una página pública equivalente y amplia de producto H20 usada para las especificaciones finales del comprador |
| Señal pública de memoria | H100 SXM suele evaluarse en torno a 80GB de HBM3; H100 NVL aparece en contextos de servicio de LLM con mayor memoria | La documentación de vGPU de NVIDIA AI Enterprise enumera perfiles H20 SXM5 de 96GB y 141GB de framebuffer |
| Conclusión para inferencia | Opción predeterminada más sólida para rendimiento bruto, soporte del ecosistema, entrenamiento e inferencia general | Evalúe solo con benchmarks del SKU exacto; la capacidad de memoria puede ser atractiva, pero el cumplimiento y la disponibilidad dominan |
| Riesgo de adquisición | La disponibilidad y el precio en la nube varían, pero el producto cuenta con amplio soporte | La concesión de licencias de exportación, las normas del mercado de la RPC y el suministro específico del proveedor pueden determinar si una cotización es utilizable |
La forma correcta de leer nvidia h20 vs h100 specs es separar tres capas:
- Hechos públicos confirmados de NVIDIA, como la documentación del producto H100 y las entradas de compatibilidad H20 de NVIDIA AI Enterprise.
- Hechos de la cotización del proveedor, como la memoria exacta de H20, la interconexión, el controlador, la forma del nodo, la región y la garantía.
- Hechos de su carga de trabajo, como tokens por segundo, tiempo hasta el primer token, retraso de cola, tasa de fallos y coste por salida aceptada.
No mezcle esas capas en una sola puntuación sintética de "ganador".
Rendimiento de NVIDIA H20 vs H100: qué cambia en la inferencia
Para el rendimiento de nvidia h20 vs h100, compare la inferencia en dos fases: prefill y decode.
Prefill es sensible a la longitud del prompt, la estrategia de lotes, la implementación de atención y el ancho de banda de memoria. Decode es sensible a la concurrencia, la presión sobre la caché KV, el comportamiento del planificador y la eficiencia de la pila de servicio. Un equipo de compras que solo pida números pico de tensor cores pasará por alto los verdaderos impulsores del coste.
Use H100 como referencia cuando:
- Esté sirviendo modelos de 7B a 70B con vLLM, TensorRT-LLM, SGLang o imágenes gestionadas de Kubernetes maduras.
- Necesite una comparación limpia frente a la capacidad en la nube existente de H100, H200 o B200.
- Planee reutilizar el trabajo de benchmarking de flotas H100 más amplias.
- El entrenamiento o el ajuste fino sigan siendo parte de la mezcla de cargas de trabajo.
Use H20 solo después de una prueba en vivo cuando:
- No se pueda comprar, importar, desplegar o aprobar H100 para el entorno objetivo.
- El nodo H20 tenga suficiente memoria para el modelo y la longitud de contexto sin compromisos forzados de calidad.
- El proveedor pueda demostrar controladores estables, imágenes de contenedor y compatibilidad con su framework de serving.
- La revisión de cumplimiento acepte el usuario final, el uso final, la región y la ruta de transferencia.
En la práctica, H20 vs H100 rara vez es un punto de referencia de laboratorio justo. Suele ser «H100 en una región sin restricciones» frente a «H20 u otra opción local en un entorno de adquisición restringido». Por eso el benchmark debe incluir la disponibilidad legal y el tiempo de espera, no solo los tokens por segundo.
Memoria: cuando H20 puede parecer interesante
La memoria es el único ámbito en el que H20 merece una verificación cuidadosa. La documentación de NVIDIA AI Enterprise enumera perfiles vGPU H20 SXM5 con entradas de framebuffer de 96GB y 141GB. Esas entradas públicas son útiles porque muestran que las conversaciones sobre H20 no deben asumir un único tamaño de memoria fijo.
Para la inferencia de LLM, la memoria afecta a:
- Si el modelo cabe sin cuantización agresiva.
- Cuánto caché KV puede mantenerse por réplica.
- Si un contexto más largo o una mayor concurrencia es práctico.
- Si una carga de trabajo necesita paralelismo de tensor entre varias GPU.
- Con qué frecuencia los prompts de producción desencadenan reintentos por falta de memoria.
Eso significa que una configuración H20 con más memoria a veces puede ser operativamente interesante, incluso si H100 es el acelerador general más potente. Pero una cifra de memoria mayor no hace automáticamente que H20 sea más rápido o más barato. El nodo sigue teniendo que superar benchmarks de inferencia, comprobaciones de disponibilidad, revisión de cumplimiento y modelado del coste total.
Si la carga de trabajo está limitada por memoria y H100 está disponible, compare también H100 con H200. La decisión más amplia H200 vs H100 suele ser una vía de actualización de memoria más limpia que depender de una cadena de suministro de H20 construida en torno a restricciones de exportación.
La disponibilidad y el cumplimiento son requisitos de primer orden
Para NVIDIA H20 vs H100, el cumplimiento no es una nota al pie. La última presentación pública ante la SEC de NVIDIA describe una serie de restricciones de control de exportaciones que afectan a productos A100, H100, H20, H200, B200, de clase GB200 y sistemas relacionados. Indica que los productos H100 se vieron afectados por restricciones anteriores relacionadas con China, que las exportaciones de H20 a China y a países D:5 pasaron a estar sujetas a requisitos de licencia en abril de 2025, y que las licencias posteriores no se tradujeron en ventas de H20 sin restricciones porque las restricciones del lado de la RPC también afectaron a las ventas.
Para los compradores, eso crea tres reglas prácticas:
- No trate la disponibilidad de H20 como una cuestión normal de inventario.
- No asuma que una licencia, una cotización o un anuncio en un marketplace sea suficiente para su cliente final.
- No modele la capacidad de H20 sin una ruta alternativa.
Haga estas preguntas a los proveedores antes de aceptar una cotización de H20:
- ¿Qué SKU exacto de H20 se está cotizando?
- ¿Qué país, región, centro de datos y entidad legal alojarán las GPU?
- ¿El comprador, el usuario final, la carga de trabajo, la empresa matriz o la ubicación del cliente están sujetos a alguna revisión de control de exportaciones?
- ¿Son relevantes las restricciones de reventa, transferencia, acceso remoto o servicio en la nube?
- ¿La GPU está disponible ahora, reservada, pendiente de licencia, pendiente de importación o dependiente de una asignación futura?
- ¿Qué ocurre si una licencia, arancel, inspección o norma gubernamental cambia antes de la implementación?
- ¿Puede la misma carga de trabajo ejecutarse en H100, H200, L40S, alternativas locales o una API de modelo si H20 se retrasa?
Ese listado importa más que otra nvidia h20 vs h100 performance comparison sintética.
H20 vs H100 vs H200
Muchos equipos buscan h20 vs h100 vs h200 porque la decisión real no es binaria. Use este enfoque más simple:
| Ruta de GPU | Uso predeterminado ideal | Pregunta principal del comprador |
|---|---|---|
| H100 | Base madura Hopper para entrenamiento, ajuste fino e inferencia | ¿Podemos conseguir suficiente capacidad a un precio y en una región que podamos usar? |
| H200 | Inferencia intensiva en memoria, contexto más largo, lotes más grandes, HPC limitado por memoria | ¿La memoria HBM3e más grande reduce lo suficiente el número de GPU, el sharding o los reintentos como para justificar la prima? |
| H20 | Contextos de adquisición restringidos en los que H100/H200 no son sencillos | ¿Puede esta implementación exacta de H20 superar el cumplimiento, la disponibilidad y los benchmarks de carga de trabajo? |
Si el equipo solo necesita la salida del modelo, añada una cuarta vía: una API de modelo gestionada. La propiedad del hardware se justifica cuando necesita pesos privados, kernels personalizados, capacidad dedicada fija o control de bajo nivel del servicio. Si no, una línea base basada en API de modelo puede superar al alquiler de GPU una vez que se incluyen el tiempo de inactividad, la gestión de colas, el trabajo de drivers y los trabajos fallidos.
Flatkey es útil para esa línea base: una clave, un saldo, enrutamiento compatible con OpenAI, visibilidad del uso y acceso a muchas API oficiales de modelos sin operar servidores GPU. No sustituye a H20 o H100 para los equipos que deben poseer la capa de hardware, pero ofrece a compras una comparación realista de «¿necesitamos GPU en absoluto?».
Guías de planificación relacionadas:
- Precios del alquiler de GPU explicados
- Costes ocultos de la nube de GPU
- TCO de clúster GPU
- Nube de GPU vs API de modelo
- La mejor GPU para inferencia de LLM
- Comparación de nube de GPU 2026
Lista de verificación de benchmarks para inferencia H20 vs H100
Ejecute la misma carga de trabajo en la forma exacta de despliegue que planea comprar. Para la inferencia h20 vs h100, use prompts con forma de producción y mida la salida aceptada.
| Métrica | Por qué importa |
|---|---|
| Tiempo hasta el primer token | Captura la latencia visible para el usuario y el comportamiento de prefill |
| Latencia entre tokens | Muestra la velocidad de decodificación bajo concurrencia real |
| Tokens por segundo por GPU | Útil, pero incompleto sin utilización y tasa de aceptación |
| Concurrencia máxima estable | Expone la presión sobre la caché KV y el programador |
| Memoria asignada y reservada | Muestra si el modelo realmente cabe con los prompts de producción |
| Retraso en la cola | Convierte la capacidad escasa en latencia real para el usuario |
| Tasa de OOM y reintentos | Convierte los límites de memoria en impacto de coste y fiabilidad |
| Coste por salida aceptada | Normaliza hora de GPU, utilización, fallos y tiempo de ingeniería |
| Tiempo de aprobación de cumplimiento | Crítico para H20 y cualquier despliegue en una región restringida |
| Ruta de contingencia | Protege las fechas de lanzamiento cuando cambian el suministro o las licencias |
La métrica importante de compras no es "H20 vs H100 en rendimiento pico." Es el coste de la carga de trabajo completada después de incluir disponibilidad, intentos fallidos, colas, revisión de cumplimiento y operaciones.
Matriz de decisión de compras
Usa esta matriz en la reunión de compra.
| Si esto es cierto | Preferir | Por qué |
|---|---|---|
| H100 está legalmente disponible, la capacidad es real y el precio es aceptable | H100 | Es la base Hopper más limpia, con amplio soporte |
| La carga de trabajo está limitada por memoria y H200 está disponible | Probar H200 frente a H100 | La mejora de memoria puede ser más directa que usar H20 |
| El despliegue debe atender un mercado restringido donde H100/H200 están bloqueados | Probar H20 con ruta de contingencia | La ruta de cumplimiento puede determinar la elección del hardware |
| El modelo es pequeño o mediano y el tráfico es irregular | API de modelo o GPU serverless | Evitar capacidad GPU dedicada ociosa |
| El equipo necesita kernels personalizados, pesos privados y utilización sostenida | Capacidad GPU directa | El control del hardware puede justificar la carga operativa |
| El suministro, las licencias o las normas geopolíticas pueden cambiar antes del lanzamiento | Mantener dos rutas activas | No comprometas una hoja de ruta de producto con un único SKU restringido |
Errores comunes en la planificación de NVIDIA H20 vs H100
El primer error es tratar H20 como "solo un H100 más lento". La diferencia real es el contexto de compra. Si tus restricciones legales, de cumplimiento y de disponibilidad no requieren H20, la base H100 suele ser más sencilla.
El segundo error es copiar las especificaciones de NVIDIA H20 vs H100 públicas sin comprobar el SKU exacto. Las referencias a H20 pueden variar según el tamaño de memoria y la forma de despliegue. Tu cotización debe indicar la GPU, la memoria, la interconexión, el diseño del nodo, la imagen del controlador, los términos del servicio y la región.
El tercer error es ignorar H200. Si el problema es la presión de memoria de H100, H200 puede ser la comparación más natural. Usa H20 cuando el contexto de compra obligue a ese camino, no simplemente porque un número de memoria parezca atractivo.
El cuarto error es olvidar la base de la API de modelo. Si la carga de trabajo solo necesita salidas fiables del modelo, no control directo de GPU, la ruta más simple puede ser una API con seguimiento de uso, contingencia y economía de pago por llamada.
Recomendación final
Para H20 vs H100, elige H100 cuando esté disponible y sea compatible con el cumplimiento para tu despliegue. Sigue siendo la base Hopper más segura para la mayoría de trabajos de entrenamiento, ajuste fino e inferencia.
Elige H20 solo cuando el entorno de compra lo haga necesario y el despliegue exacto de H20 supere tres pruebas: el modelo cabe, el benchmark de inferencia funciona bajo una carga similar a la producción y el cumplimiento puede aprobar el usuario final, la región y la ruta de transferencia.
Luego compáralo con H200 y con una base de API de modelo. La ruta ganadora es la que produce salida aceptada de forma fiable, no la que tiene la tabla de especificaciones más interesante.
Preguntas frecuentes
¿H20 es mejor que H100 para inferencia?
Normalmente no. H100 es la opción predeterminada más sólida cuando está disponible y cumple con el cumplimiento. H20 puede ser relevante cuando H100 está bloqueado por restricciones de compra, control de exportaciones o disponibilidad regional. Evalúa el SKU exacto de H20 antes de asumir que es un buen sustituto para inferencia.
¿Cuál es la principal diferencia entre NVIDIA H20 y H100?
La principal diferencia es el contexto de compra. H100 es una GPU de centro de datos Hopper ampliamente compatible. H20 se evalúa en contextos de compra restringidos donde la licencia de exportación, las normas del mercado de la RPC, la disponibilidad exacta del SKU y la revisión de cumplimiento pueden determinar si la capacidad es utilizable.
¿Cómo debo comparar las especificaciones de NVIDIA H20 vs H100?
Compara el SKU exacto, la memoria, la interconexión, la forma del nodo, la imagen del controlador, la región, la garantía y el estado de cumplimiento. No dependas solo de tablas de especificaciones de terceros. Para producción, valida con prompts reales, concurrencia objetivo y coste por salida aceptada.
¿Debería comparar H20 vs H100 vs H200?
Sí. Si la carga de trabajo está limitada por memoria y H200 está disponible, H200 puede ser una mejora más limpia desde H100. H20 es más relevante cuando el cumplimiento o la compra regional bloquean H100/H200.
¿Cuándo debo usar una API de modelo en lugar de H20 o H100?
Usa una API de modelo cuando no necesites kernels personalizados, pesos privados o capacidad dedicada fija. Para tráfico de producto irregular, una API de modelo puede reducir el gasto de GPU ociosa y el trabajo operativo, a la vez que mantiene la visibilidad de uso y la flexibilidad de enrutamiento.


