
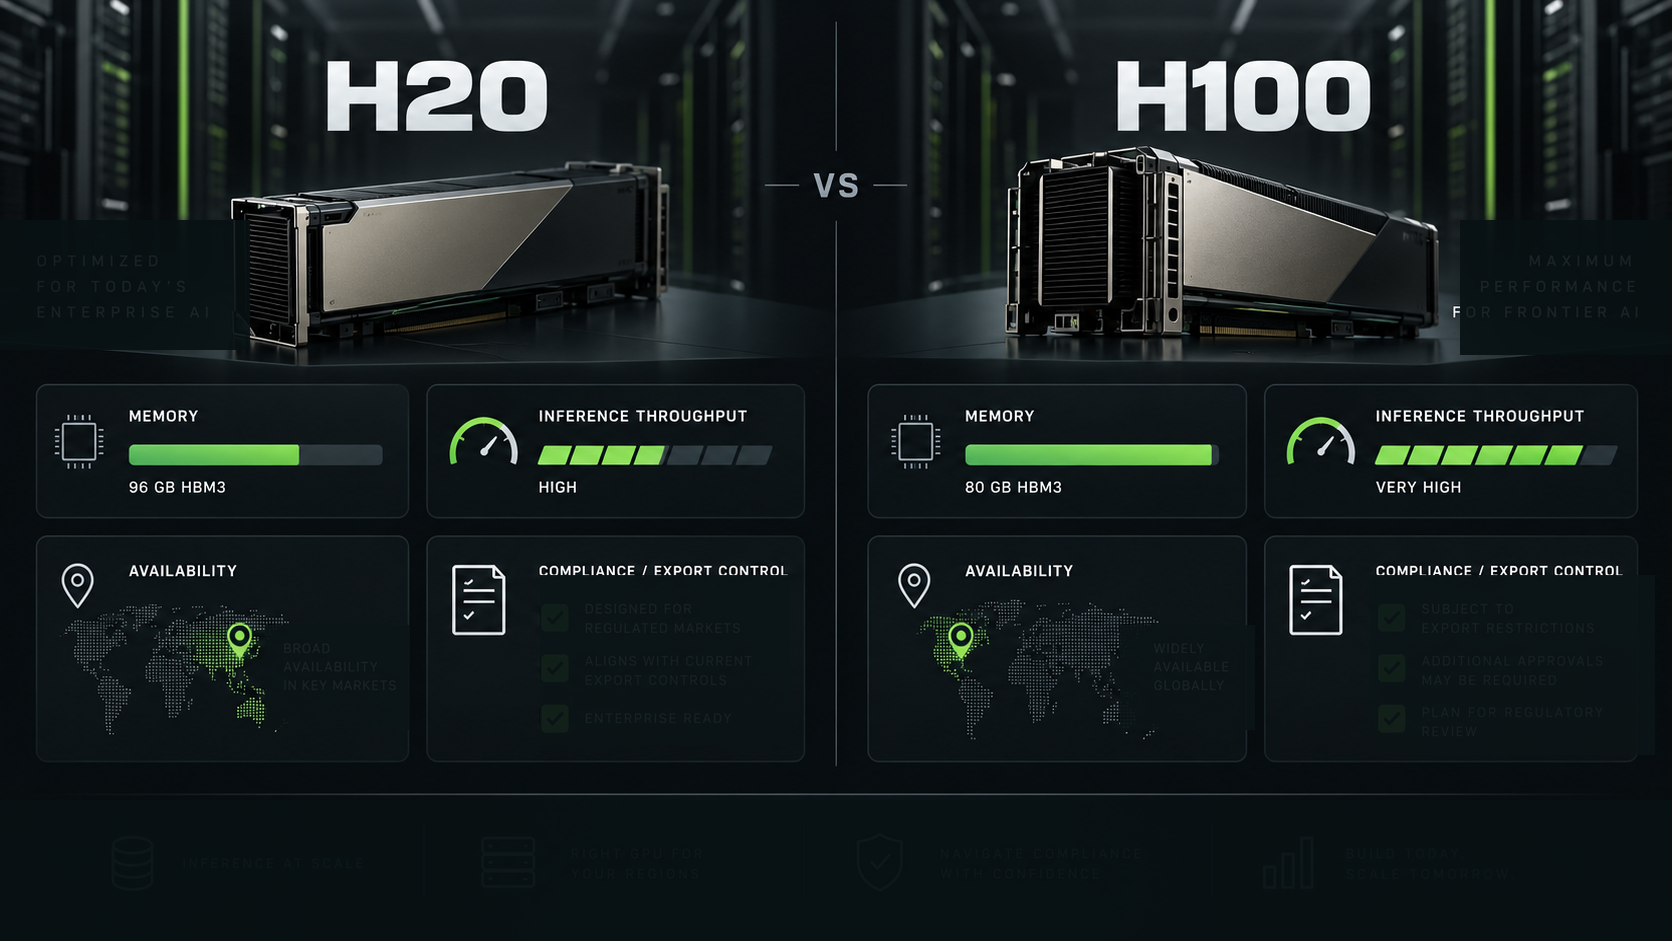
Jika Anda membandingkan H20 vs H100, versi singkatnya adalah ini: H100 adalah pilihan default yang lebih kuat ketika Anda dapat memperolehnya secara legal, mendapatkannya dengan andal, dan tetap memanfaatkannya secara optimal. H20 hanya menjadi menarik ketika kendala kontrol ekspor, ketersediaan di pasar Tiongkok, atau aturan pengadaan lokal membuat H100 tidak praktis.
Itu membuat NVIDIA H20 vs H100 lebih mirip keputusan kapasitas yang mempertimbangkan kepatuhan daripada perbandingan tabel spesifikasi biasa. H100 adalah GPU Hopper yang lebih dikenal untuk pelatihan dan inferensi. H20 adalah jalur keluarga Hopper yang dibatasi, yang dievaluasi pembeli ketika konteks pengadaan dibentuk oleh lisensi ekspor, aturan pasar RRT, dan ketersediaan SKU spesifik dari penyedia.
Bagi tim AI enterprise, pertanyaan h20 vs h100 yang berguna bukanlah "GPU mana yang lebih cepat?" Melainkan: jalur mana yang dapat menghasilkan output inferensi yang diterima dengan total risiko terendah setelah kecocokan memori, waktu antrean, persetujuan kepatuhan, dan ketersediaan diperhitungkan?
H20 vs H100: jawaban cepat
Pilih H100 ketika:
- Anda dapat mengadakan atau menyewa kapasitas H100 di wilayah deployment tanpa hambatan kontrol ekspor.
- Beban kerja Anda membutuhkan basis Hopper yang matang untuk pelatihan, fine-tuning, atau inferensi ber-throughput tinggi.
- Anda membutuhkan kematangan perangkat lunak yang kuat, dukungan cloud yang luas, dan referensi benchmark yang dapat diprediksi.
- Model Anda tidak memerlukan jalur pengadaan GPU khusus Tiongkok.
Pilih H20 hanya ketika:
- Deployment harus sesuai dengan pasar atau lokasi pelanggan yang dibatasi, di mana H100 tidak tersedia atau sulit dilisensikan.
- Penyedia dapat menunjukkan SKU H20 yang tepat, ukuran memori, interkoneksi, image driver, dan ketentuan komersial.
- Kepatuhan, lokasi pelanggan, penjualan kembali, dan pemeriksaan penggunaan akhir sudah menjadi bagian dari proses pembelian.
- Anda melakukan benchmark beban kerja inferensi nyata, bukan mengandalkan tabel spesifikasi puncak dari pihak ketiga.
Bagi sebagian besar tim, H20 vs H100 ditentukan oleh ketersediaan dan kepatuhan sebelum performa inferensi mentah. Jika keduanya tersedia dengan syarat legal dan komersial yang dapat diterima, H100 adalah pilihan default yang lebih aman.
Spesifikasi NVIDIA H20 vs H100 yang penting
Bagian tersulit dari perbandingan spesifikasi NVIDIA H20 vs H100 adalah bahwa H100 memiliki halaman produk publik, sedangkan data publik H20 lebih terfragmentasi. Halaman publik H100 milik NVIDIA mencantumkan H100 Tensor Core GPU sebagai GPU data-center Hopper dengan opsi memori HBM dan angka puncak AI/HPC yang dipublikasikan. Dokumentasi NVIDIA AI Enterprise secara publik mencantumkan varian H20 dalam matriks dukungan vGPU Hopper, termasuk profil H20 SXM5 dengan entri framebuffer 96GB dan 141GB.
Anggap tabel ini sebagai daftar periksa pengadaan, bukan lembar penawaran final.
| Area spesifikasi | H100 | H20 |
|---|---|---|
| Posisi publik | GPU data-center Hopper arus utama untuk AI, HPC, pelatihan, dan inferensi | Jalur GPU data-center keluarga Hopper yang dievaluasi dalam konteks pengadaan terbatas |
| Halaman produk publik NVIDIA | Ya, H100 memiliki halaman produk khusus | Tidak ada halaman produk H20 publik yang setara dan luas untuk spesifikasi pembeli akhir |
| Sinyal memori publik | H100 SXM umumnya dievaluasi sekitar 80GB HBM3; H100 NVL muncul dalam konteks penyajian LLM dengan memori yang lebih besar | Dokumen vGPU NVIDIA AI Enterprise mencantumkan profil framebuffer H20 SXM5 96GB dan 141GB |
| Inti untuk inferensi | Default yang lebih kuat untuk performa mentah, dukungan ekosistem, pelatihan, dan inferensi umum | Evaluasi hanya dengan benchmark SKU yang tepat; kapasitas memori bisa menarik, tetapi kepatuhan dan ketersediaan lebih dominan |
| Risiko pengadaan | Ketersediaan dan harga cloud bervariasi, tetapi produknya didukung secara luas | Lisensi ekspor, aturan pasar RRT, dan pasokan spesifik penyedia dapat menentukan apakah penawaran dapat digunakan |
Cara yang tepat membaca spesifikasi nvidia h20 vs h100 adalah memisahkan tiga lapisan:
- Fakta publik NVIDIA yang terkonfirmasi, seperti dokumentasi produk H100 dan entri dukungan H20 NVIDIA AI Enterprise.
- Fakta penawaran dari penyedia, seperti memori H20 yang tepat, interkoneksi, driver, bentuk node, wilayah, dan garansi.
- Fakta beban kerja Anda, seperti token per detik, waktu ke token pertama, jeda antrean, tingkat kegagalan, dan biaya per output yang diterima.
Jangan mencampur lapisan-lapisan itu menjadi satu skor "pemenang" sintetis.
Performa NVIDIA H20 vs H100: apa yang berubah dalam inferensi
Untuk performa nvidia h20 vs h100, benchmark inferensi dalam dua fase: prefill dan decode.
Prefill sensitif terhadap panjang prompt, strategi batch, implementasi attention, dan bandwidth memori. Decode sensitif terhadap konkurensi, tekanan KV cache, perilaku scheduler, dan efisiensi serving stack. Tim pengadaan yang hanya meminta angka puncak tensor-core akan melewatkan pendorong biaya yang sebenarnya.
Gunakan H100 sebagai baseline ketika:
- Anda melayani model 7B hingga 70B dengan vLLM, TensorRT-LLM, SGLang, atau image Kubernetes terkelola yang matang.
- Anda membutuhkan perbandingan yang bersih terhadap kapasitas cloud H100, H200, atau B200 yang sudah ada.
- Anda berencana menggunakan kembali hasil benchmark dari armada H100 yang lebih luas.
- Pelatihan atau fine-tuning tetap menjadi bagian dari campuran beban kerja.
Gunakan H20 hanya setelah uji langsung ketika:
- H100 tidak dapat dibeli, diimpor, dideploy, atau disetujui untuk lingkungan target.
- Node H20 memiliki memori yang cukup untuk model dan panjang konteks tanpa kompromi kualitas yang dipaksakan.
- Penyedia dapat membuktikan driver yang stabil, image kontainer, dan dukungan untuk kerangka serving Anda.
- Tinjauan kepatuhan menerima pengguna akhir, penggunaan akhir, wilayah, dan jalur transfer.
Dalam praktiknya, H20 vs H100 jarang menjadi benchmark lab yang adil. Biasanya ini adalah "H100 di wilayah tanpa pembatasan" versus "H20 atau opsi lokal lainnya di lingkungan pengadaan yang dibatasi." Itulah sebabnya benchmark harus mencakup ketersediaan legal dan waktu antre, bukan hanya token per detik.
Memori: saat H20 bisa terlihat menarik
Memori adalah satu area yang perlu diverifikasi dengan cermat pada H20. Dokumen NVIDIA AI Enterprise mencantumkan profil vGPU H20 SXM5 dengan entri framebuffer 96GB dan 141GB. Entri publik tersebut berguna karena menunjukkan bahwa pembahasan H20 tidak boleh mengasumsikan satu ukuran memori tetap.
Untuk inferensi LLM, memori memengaruhi:
- Apakah model muat tanpa kuantisasi agresif.
- Seberapa besar KV cache yang bisa ditampung per replika.
- Apakah konteks yang lebih panjang atau konkurensi yang lebih tinggi praktis dijalankan.
- Apakah workload memerlukan paralelisme tensor di beberapa GPU.
- Seberapa sering prompt produksi memicu retry karena kehabisan memori.
Artinya, konfigurasi H20 dengan memori lebih besar kadang bisa menarik secara operasional, meskipun H100 adalah akselerator umum yang lebih kuat. Namun angka memori yang lebih besar tidak otomatis membuat H20 lebih cepat atau lebih murah. Node tetap harus lolos benchmark inferensi, pengecekan ketersediaan, peninjauan kepatuhan, dan pemodelan total biaya.
Jika workload terikat pada memori dan H100 tersedia, bandingkan H100 dengan H200 juga. Keputusan yang lebih luas mengenai H200 vs H100 sering kali merupakan jalur peningkatan memori yang lebih bersih daripada bergantung pada jalur pasokan H20 yang dibangun di atas pembatasan ekspor.
Ketersediaan dan kepatuhan adalah kebutuhan utama
Untuk NVIDIA H20 vs H100, kepatuhan bukanlah catatan kaki. Pengajuan SEC publik terbaru NVIDIA menjelaskan serangkaian pembatasan kontrol ekspor yang memengaruhi produk kelas A100, H100, H20, H200, B200, GB200, dan sistem terkait. Dokumen tersebut menyatakan bahwa produk H100 terdampak oleh pembatasan terkait China sebelumnya, bahwa ekspor H20 ke China dan negara D:5 menjadi tunduk pada persyaratan lisensi pada April 2025, dan bahwa lisensi berikutnya tidak berarti penjualan H20 tanpa pembatasan karena pembatasan sisi PRC juga memengaruhi penjualan.
Bagi pembeli, hal itu menciptakan tiga aturan praktis:
- Jangan anggap ketersediaan H20 sebagai pertanyaan inventaris biasa.
- Jangan berasumsi lisensi, penawaran harga, atau listing marketplace sudah cukup untuk pelanggan akhir Anda.
- Jangan memodelkan kapasitas H20 tanpa jalur cadangan.
Tanyakan pertanyaan berikut kepada vendor sebelum menerima penawaran H20:
- SKU H20 yang tepat apa yang ditawarkan?
- Negara, wilayah, pusat data, dan badan hukum mana yang akan menjadi host GPU?
- Apakah pembeli, pengguna akhir, workload, perusahaan induk, atau lokasi pelanggan tunduk pada tinjauan kontrol ekspor apa pun?
- Apakah pembatasan penjualan kembali, transfer, akses jarak jauh, atau layanan cloud relevan?
- Apakah GPU tersedia sekarang, dipesan, menunggu lisensi, menunggu impor, atau bergantung pada alokasi di masa depan?
- Apa yang terjadi jika lisensi, tarif, inspeksi, atau aturan pemerintah berubah sebelum deployment?
- Bisakah workload yang sama berjalan pada H100, H200, L40S, alternatif lokal, atau API model jika H20 tertunda?
Daftar periksa itu lebih penting daripada satu lagi perbandingan performa nvidia h20 vs h100 performance comparison sintetis.
H20 vs H100 vs H200
Banyak tim mencari h20 vs h100 vs h200 karena keputusan nyata bukan keputusan biner. Gunakan kerangka yang lebih sederhana ini:
| Jalur GPU | Penggunaan default terbaik | Pertanyaan utama pembeli |
|---|---|---|
| H100 | Baseline Hopper yang matang untuk training, fine-tuning, dan inferensi | Apakah kita bisa mendapatkan kapasitas yang cukup dengan harga dan wilayah yang bisa kita gunakan? |
| H200 | Inferensi intensif memori, konteks lebih panjang, batch lebih besar, HPC yang terikat memori | Apakah memori HBM3e yang lebih besar mengurangi jumlah GPU, sharding, atau retry cukup untuk membenarkan premi? |
| H20 | Konteks pengadaan yang dibatasi ketika H100/H200 tidak langsung tersedia | Apakah deployment H20 yang spesifik ini dapat lolos benchmark kepatuhan, ketersediaan, dan workload? |
Jika tim hanya membutuhkan keluaran model, tambahkan jalur keempat: API model terkelola. Kepemilikan hardware dibenarkan ketika Anda membutuhkan bobot privat, kernel kustom, kapasitas khusus yang tetap, atau kontrol serving tingkat rendah. Jika tidak, baseline API model mungkin mengungguli sewa GPU setelah waktu idle, manajemen antrean, pekerjaan driver, dan job yang gagal diperhitungkan.
Flatkey berguna untuk baseline itu: satu kunci, satu saldo, routing yang kompatibel dengan OpenAI, visibilitas penggunaan, dan akses ke banyak API model resmi tanpa mengoperasikan server GPU. Ini tidak menggantikan H20 atau H100 untuk tim yang harus memiliki lapisan hardware, tetapi memberi pengadaan perbandingan yang realistis tentang "apakah kita butuh GPU sama sekali?"
Panduan perencanaan terkait:
- Harga sewa GPU dijelaskan
- Biaya tersembunyi cloud GPU
- TCO klaster GPU
- Cloud GPU vs API model
- GPU terbaik untuk inferensi LLM
- Perbandingan cloud GPU 2026
Daftar periksa benchmark untuk inferensi H20 vs H100
Jalankan workload yang sama pada bentuk deployment persis yang ingin Anda beli. Untuk inferensi h20 vs h100, gunakan prompt yang menyerupai produksi dan ukur output yang diterima.
| Metrik | Mengapa ini penting |
|---|---|
| Waktu hingga token pertama | Menangkap latensi yang terlihat oleh pengguna dan perilaku prefill |
| Latensi antar-token | Menunjukkan kecepatan decode dalam concurrency nyata |
| Token per detik per GPU | Berguna, tetapi tidak lengkap tanpa utilisasi dan tingkat penerimaan |
| Concurrency stabil maksimum | Mengungkap tekanan pada cache KV dan scheduler |
| Memori yang dialokasikan dan dicadangkan | Menunjukkan apakah model benar-benar muat dengan prompt produksi |
| Delay antrean | Mengubah kapasitas yang langka menjadi latensi pengguna yang nyata |
| OOM dan tingkat retry | Mengonversi batas memori menjadi biaya dan dampak keandalan |
| Biaya per output yang diterima | Menormalkan jam-GPU, utilisasi, kegagalan, dan waktu engineering |
| Waktu persetujuan kepatuhan | Kritis untuk H20 dan penerapan apa pun di wilayah yang dibatasi |
| Jalur fallback | Melindungi tanggal peluncuran saat pasokan atau lisensi berubah |
Metrik pengadaan yang penting bukanlah "performa puncak H20 vs H100." Yang penting adalah biaya beban kerja yang selesai setelah ketersediaan, percobaan yang gagal, antrean, tinjauan kepatuhan, dan operasi diperhitungkan.
Matriks keputusan pengadaan
Gunakan matriks ini dalam rapat pembelian.
| Jika ini benar | Lebih pilih | Mengapa |
|---|---|---|
| H100 tersedia secara legal, kapasitasnya nyata, dan harganya dapat diterima | H100 | Ini adalah baseline Hopper yang lebih bersih dengan dukungan luas |
| Beban kerja dibatasi memori dan H200 tersedia | Uji H200 terhadap H100 | Upgrade memori mungkin lebih langsung daripada menggunakan H20 |
| Penerapan harus melayani pasar yang dibatasi di mana H100/H200 diblokir | Uji H20 plus fallback | Jalur kepatuhan dapat menentukan pilihan hardware |
| Model berukuran kecil atau menengah dan traffic bersifat bursty | Model API atau GPU serverless | Hindari kapasitas GPU khusus yang menganggur |
| Tim membutuhkan kernel kustom, bobot privat, dan utilisasi berkelanjutan | Kapasitas GPU langsung | Kontrol hardware mungkin membenarkan beban operasional |
| Aturan pasokan, lisensi, atau geopolitik dapat berubah sebelum peluncuran | Pertahankan dua jalur tetap hidup | Jangan mengikat roadmap produk ke satu SKU yang dibatasi |
Kesalahan umum dalam perencanaan NVIDIA H20 vs H100
Kesalahan pertama adalah memperlakukan H20 sebagai "sekadar H100 yang lebih lambat." Perbedaan sebenarnya ada pada konteks pengadaan. Jika batasan legal, kepatuhan, dan ketersediaan Anda tidak mengharuskan H20, baseline H100 biasanya lebih sederhana.
Kesalahan kedua adalah menyalin spesifikasi nvidia h20 vs h100 publik tanpa memeriksa SKU yang tepat. Referensi H20 dapat bervariasi berdasarkan ukuran memori dan bentuk penerapan. Penawaran Anda harus menyebutkan GPU, memori, interkoneksi, desain node, image driver, ketentuan layanan, dan wilayah.
Kesalahan ketiga adalah mengabaikan H200. Jika masalahnya adalah tekanan memori H100, H200 mungkin perbandingan yang lebih alami. Gunakan H20 ketika konteks pengadaan memaksa jalurnya, bukan hanya karena satu angka memori terlihat menarik.
Kesalahan keempat adalah melupakan baseline model API. Jika beban kerja hanya membutuhkan output model yang andal, bukan kontrol GPU langsung, jalur yang lebih sederhana mungkin adalah API dengan pelacakan penggunaan, fallback, dan ekonomi bayar per panggilan.
Rekomendasi akhir
Untuk H20 vs H100, pilih H100 ketika tersedia dan patuh untuk deployment Anda. Ini tetap menjadi baseline Hopper yang lebih aman untuk sebagian besar pekerjaan training, fine-tuning, dan inferensi.
Pilih H20 hanya ketika lingkungan pengadaan membuatnya diperlukan dan deployment H20 yang tepat lolos tiga tes: model muat, benchmark inferensi bekerja di bawah beban yang menyerupai produksi, dan kepatuhan dapat menyetujui pengguna akhir, wilayah, serta jalur transfer.
Lalu bandingkan keduanya dengan H200 dan baseline model API. Jalur pemenang adalah yang menghasilkan output yang diterima secara andal, bukan yang memiliki tabel spesifikasi paling menarik.
FAQ
Apakah H20 lebih baik daripada H100 untuk inferensi?
Biasanya tidak. H100 adalah pilihan default yang lebih kuat ketika tersedia dan patuh. H20 bisa relevan ketika H100 diblokir oleh kendala pengadaan, kontrol ekspor, atau ketersediaan regional. Benchmark SKU H20 yang tepat sebelum menganggapnya sebagai pengganti inferensi yang baik.
Apa perbedaan utama NVIDIA H20 vs H100?
Perbedaan utamanya adalah konteks pengadaan. H100 adalah GPU data center Hopper yang didukung secara luas. H20 dievaluasi dalam konteks pengadaan yang dibatasi, di mana lisensi ekspor, aturan pasar RRT, ketersediaan SKU yang tepat, dan tinjauan kepatuhan dapat menentukan apakah kapasitas tersebut dapat digunakan.
Bagaimana sebaiknya saya membandingkan spesifikasi NVIDIA H20 vs H100?
Bandingkan SKU yang tepat, memori, interkoneksi, bentuk node, image driver, wilayah, garansi, dan status kepatuhan. Jangan hanya mengandalkan tabel spesifikasi pihak ketiga. Untuk produksi, validasi dengan prompt nyata, concurrency target, dan biaya per output yang diterima.
Haruskah saya membandingkan H20 vs H100 vs H200?
Ya. Jika beban kerja dibatasi memori dan H200 tersedia, H200 mungkin merupakan upgrade yang lebih bersih dari H100. H20 lebih relevan ketika kepatuhan atau pengadaan regional memblokir H100/H200.
Kapan saya harus menggunakan model API alih-alih H20 atau H100?
Gunakan model API ketika Anda tidak memerlukan kernel kustom, bobot privat, atau kapasitas khusus yang tetap. Untuk traffic produk yang bursty, model API dapat mengurangi biaya GPU yang menganggur dan pekerjaan operasional sambil mempertahankan visibilitas penggunaan dan fleksibilitas routing.


