
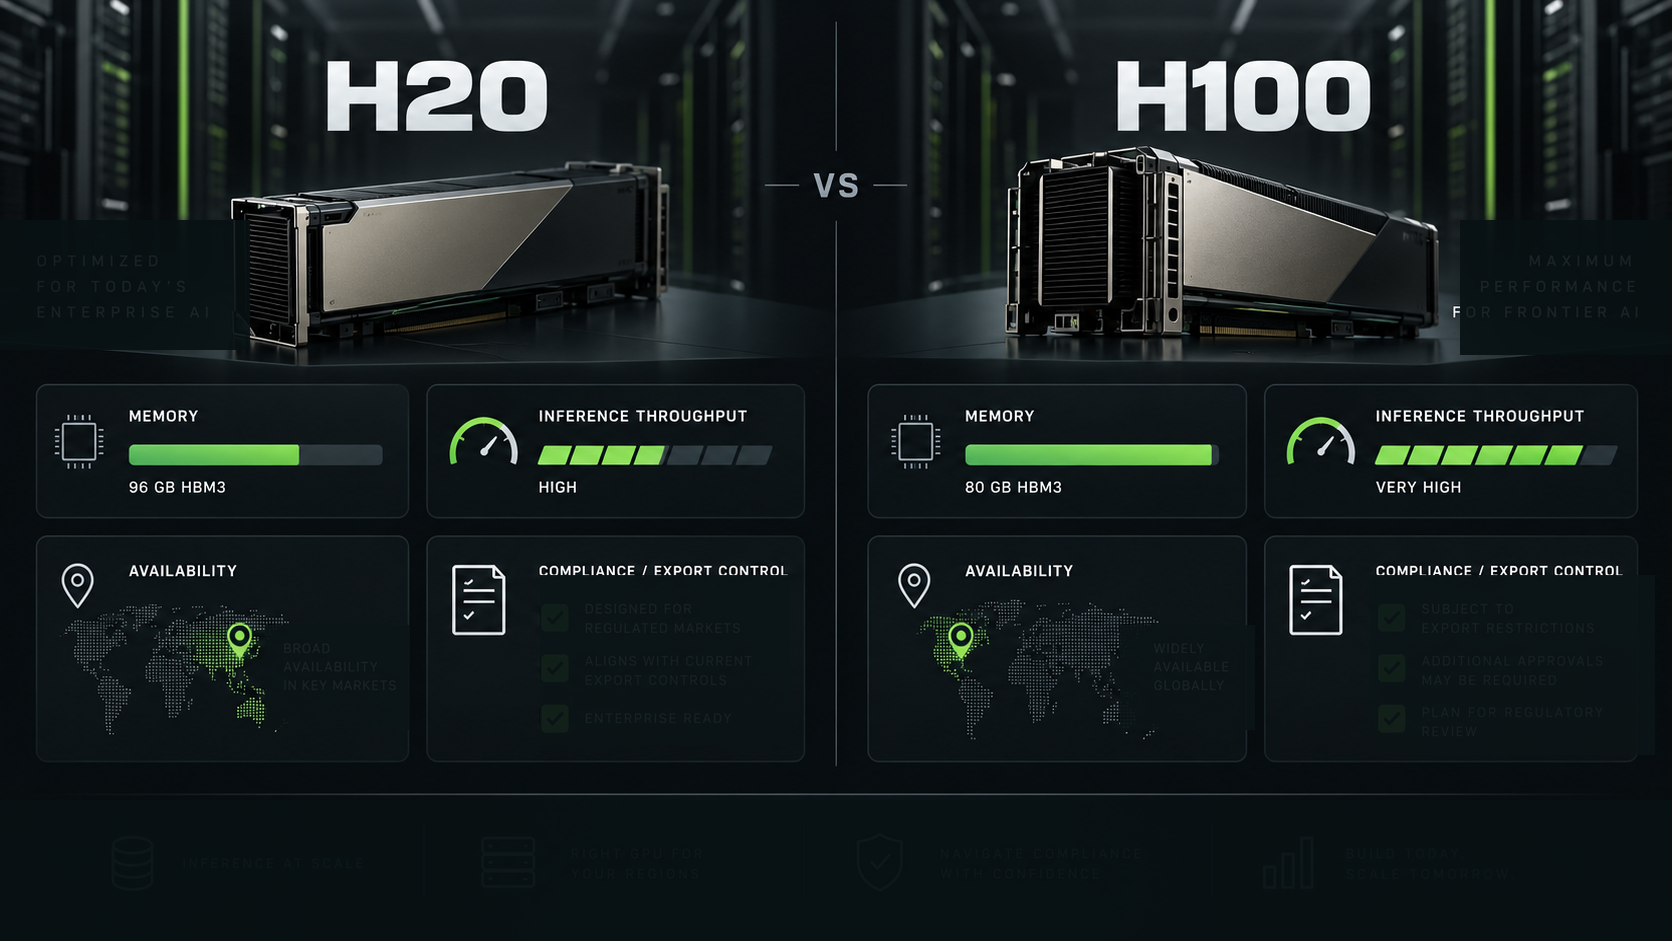
Si vous comparez H20 vs H100, la version courte est la suivante : le H100 est le choix par défaut le plus solide lorsque vous pouvez l’acheter légalement, vous le procurer de manière fiable et le maintenir à un niveau d’utilisation élevé. Le H20 ne devient intéressant que lorsque des contraintes de contrôle des exportations, la disponibilité sur le marché chinois ou des règles d’approvisionnement locales rendent le H100 impraticable.
Cela fait de NVIDIA H20 vs H100 moins une comparaison classique de fiche technique qu’une décision de capacité tenant compte de la conformité. Le H100 est le GPU Hopper le mieux connu pour l’entraînement et l’inférence. Le H20 est une voie contrainte de la famille Hopper que les acheteurs évaluent lorsque le contexte d’approvisionnement est façonné par les licences d’exportation, les règles du marché de la RPC et la disponibilité des SKU spécifiques aux fournisseurs.
Pour les équipes IA d’entreprise, la question utile h20 vs h100 n’est pas « quel GPU est le plus rapide ? » C’est : quelle option peut fournir un résultat d’inférence accepté au coût total le plus faible, une fois pris en compte l’adéquation mémoire, le temps d’attente, l’approbation de conformité et la disponibilité ?
H20 vs H100 : réponse rapide
Choisissez H100 lorsque :
- Vous pouvez acheter ou louer de la capacité H100 dans la région de déploiement sans blocage lié au contrôle des exportations.
- Votre charge de travail a besoin d’une base Hopper mature pour l’entraînement, le fine-tuning ou une inférence à haut débit.
- Vous avez besoin d’une maturité logicielle solide, d’un large support cloud et de références de benchmark prévisibles.
- Votre modèle ne nécessite pas de voie d’approvisionnement GPU spécifique à la Chine.
Choisissez H20 uniquement lorsque :
- Le déploiement doit s’inscrire dans un marché restreint ou une localisation client où le H100 n’est pas disponible ou difficile à homologuer.
- Le fournisseur peut présenter le SKU H20 exact, la taille mémoire, l’interconnexion, l’image de pilote et les conditions commerciales.
- La conformité, la localisation du client, la revente et les vérifications d’usage final font déjà partie du processus d’achat.
- Vous évaluez une charge d’inférence réelle, et non des tableaux de spécifications de pointe provenant de tiers.
Pour la plupart des équipes, H20 vs H100 se décide d’abord par la disponibilité et la conformité avant la performance brute en inférence. Si les deux sont disponibles à des conditions juridiques et commerciales acceptables, le H100 est le choix par défaut le plus sûr.
Spécifications NVIDIA H20 vs H100 qui comptent
La partie difficile d’une comparaison des spécifications NVIDIA H20 vs H100 est que le H100 dispose d’une page produit publique, tandis que les données publiques sur le H20 sont plus fragmentées. La page publique du H100 de NVIDIA répertorie le GPU H100 Tensor Core comme un GPU de centre de données Hopper avec des options de mémoire HBM et des chiffres de pointe publiés pour l’IA/HPC. La documentation NVIDIA AI Enterprise répertorie publiquement des variantes H20 dans la matrice de prise en charge Hopper vGPU, y compris des profils H20 SXM5 avec des entrées de framebuffer de 96 Go et 141 Go.
Considérez ce tableau comme une liste de contrôle d’approvisionnement, et non comme une fiche de devis finale.
| Domaine de spécification | H100 | H20 |
|---|---|---|
| Positionnement public | GPU Hopper grand public pour centres de données, pour l’IA, le HPC, l’entraînement et l’inférence | Voie GPU de centre de données de la famille Hopper évaluée dans des contextes d’approvisionnement restreints |
| Page produit NVIDIA publique | Oui, le H100 dispose d’une page produit dédiée | Pas de page produit publique H20 équivalente et largement utilisée pour les spécifications finales de l’acheteur |
| Signal mémoire public | Le H100 SXM est couramment évalué autour de 80 Go de HBM3 ; le H100 NVL apparaît dans les contextes de service LLM avec une mémoire plus importante | La documentation vGPU de NVIDIA AI Enterprise répertorie des profils H20 SXM5 de 96 Go et 141 Go de framebuffer |
| Conclusion pour l’inférence | Choix par défaut plus performant pour les performances brutes, le support de l’écosystème, l’entraînement et l’inférence générale | À évaluer uniquement avec des benchmarks SKU exacts ; la capacité mémoire peut être attrayante, mais la conformité et la disponibilité dominent |
| Risque d’approvisionnement | La disponibilité et le prix cloud varient, mais le produit est largement pris en charge | La licence d’exportation, les règles du marché de la RPC et l’offre spécifique du fournisseur peuvent déterminer si un devis est exploitable |
La bonne manière de lire les nvidia h20 vs h100 specs consiste à séparer trois niveaux :
- Les faits publics confirmés par NVIDIA, comme la documentation produit du H100 et les entrées de prise en charge H20 de NVIDIA AI Enterprise.
- Les faits du devis fournisseur, comme la mémoire H20 exacte, l’interconnexion, le pilote, la forme du nœud, la région et la garantie.
- Les faits de votre charge de travail, comme les jetons par seconde, le temps jusqu’au premier jeton, le délai de file d’attente, le taux d’échec et le coût par résultat accepté.
Ne fusionnez pas ces niveaux en un seul score synthétique de « gagnant ».
Performance NVIDIA H20 vs H100 : ce qui change en inférence
Pour la performance nvidia h20 vs h100, comparez l’inférence en deux phases : préremplissage et décodage.
Le préremplissage est sensible à la longueur du prompt, à la stratégie de lot, à l’implémentation de l’attention et à la bande passante mémoire. Le décodage est sensible à la concurrence, à la pression sur le cache KV, au comportement du planificateur et à l’efficacité de la pile de service. Une équipe d’approvisionnement qui ne demande que des chiffres de pointe des cœurs tensoriels passera à côté des véritables facteurs de coût.
Utilisez le H100 comme référence lorsque :
- Vous servez des modèles de 7B à 70B avec vLLM, TensorRT-LLM, SGLang ou des images Kubernetes gérées matures.
- Vous avez besoin d’une comparaison propre avec une capacité cloud H100, H200 ou B200 existante.
- Vous prévoyez de réutiliser le travail de benchmark d’autres parcs H100 plus larges.
- L’entraînement ou le fine-tuning fait toujours partie du mix de charge de travail.
Utilisez le H20 uniquement après un test en conditions réelles lorsque :
- Le H100 ne peut pas être acheté, importé, déployé ou approuvé pour l’environnement cible.
- Le nœud H20 dispose de suffisamment de mémoire pour le modèle et la longueur de contexte sans compromis forcé sur la qualité.
- Le fournisseur peut prouver la stabilité des pilotes, des images de conteneurs et la prise en charge de votre framework de service.
- L’examen de conformité accepte l’utilisateur final, l’usage final, la région et le chemin de transfert.
En pratique, H20 vs H100 est rarement un benchmark de laboratoire équitable. Il s’agit généralement de « H100 dans une région sans restriction » contre « H20 ou une autre option locale dans un environnement d’approvisionnement restreint ». C’est pourquoi le benchmark doit inclure la disponibilité légale et le temps d’attente, et pas seulement les jetons par seconde.
Mémoire : quand le H20 peut sembler intéressant
La mémoire est le seul domaine où le H20 mérite une vérification minutieuse. La documentation NVIDIA AI Enterprise répertorie des profils vGPU H20 SXM5 avec des entrées de framebuffer de 96 Go et 141 Go. Ces entrées publiques sont utiles car elles montrent que les discussions autour du H20 ne doivent pas supposer une seule taille de mémoire fixe.
Pour l’inférence LLM, la mémoire influe sur :
- Le fait que le modèle tienne sans quantification agressive.
- La quantité de cache KV pouvant être conservée par réplique.
- La possibilité d’utiliser un contexte plus long ou une concurrence plus élevée.
- La nécessité d’un parallélisme tensoriel sur plusieurs GPU.
- La fréquence des tentatives de réexécution liées à un manque de mémoire dans les requêtes de production.
Cela signifie qu’une configuration H20 avec plus de mémoire peut parfois présenter un intérêt opérationnel, même si le H100 reste l’accélérateur généraliste le plus solide. Mais une valeur de mémoire plus élevée ne rend pas automatiquement le H20 plus rapide ou moins cher. Le nœud doit toujours passer les benchmarks d’inférence, les vérifications de disponibilité, l’examen de conformité et la modélisation du coût total.
Si la charge de travail est limitée par la mémoire et que le H100 est disponible, comparez aussi le H100 au H200. La décision plus large H200 vs H100 est souvent une voie de mise à niveau mémoire plus claire que de compter sur une chaîne d’approvisionnement H20 bâtie autour de contraintes d’exportation.
La disponibilité et la conformité sont des exigences de premier ordre
Pour NVIDIA H20 vs H100, la conformité n’est pas un détail. Le dernier dépôt public auprès de la SEC par NVIDIA décrit une série de restrictions de contrôle des exportations affectant les produits A100, H100, H20, H200, B200, GB200 et les systèmes associés. Il précise que les produits H100 ont été affectés par des restrictions antérieures liées à la Chine, que les exportations de H20 vers la Chine et les pays D:5 sont devenues soumises à des exigences de licence en avril 2025, et que des licences ultérieures ne se sont pas traduites par des ventes de H20 sans restriction, car des restrictions côté RPC ont également affecté les ventes.
Pour les acheteurs, cela crée trois règles pratiques :
- Ne considérez pas la disponibilité du H20 comme une simple question de stock normal.
- N’assumez pas qu’une licence, un devis ou une annonce sur une place de marché suffit pour votre client final.
- Ne modélisez pas la capacité H20 sans solution de repli.
Posez ces questions aux fournisseurs avant d’accepter un devis H20 :
- Quel SKU H20 exact est devisé ?
- Quel pays, quelle région, quel centre de données et quelle entité juridique hébergeront les GPU ?
- L’acheteur, l’utilisateur final, la charge de travail, la société mère ou le lieu du client sont-ils soumis à un examen de contrôle des exportations ?
- Des restrictions de revente, de transfert, d’accès à distance ou de service cloud sont-elles pertinentes ?
- Le GPU est-il disponible immédiatement, réservé, en attente de licence, en attente d’importation ou dépendant d’une allocation future ?
- Que se passe-t-il si une licence, un tarif douanier, une inspection ou une règle gouvernementale change avant le déploiement ?
- La même charge de travail peut-elle s’exécuter sur H100, H200, L40S, des alternatives locales ou une API de modèle si le H20 est retardé ?
Cette liste compte davantage qu’une autre comparaison synthétique de nvidia h20 vs h100 performance comparison.
H20 vs H100 vs H200
De nombreuses équipes recherchent h20 vs h100 vs h200 parce que la vraie décision n’est pas binaire. Utilisez ce cadrage plus simple :
| Chemin GPU | Usage par défaut le plus adapté | Question principale de l’acheteur |
|---|---|---|
| H100 | Base Hopper mature pour l’entraînement, le fine-tuning et l’inférence | Pouvons-nous nous procurer assez de capacité à un prix et dans une région que nous pouvons utiliser ? |
| H200 | Inférence gourmande en mémoire, contexte plus long, lots plus importants, HPC limité par la mémoire | Une mémoire HBM3e plus grande réduit-elle assez le nombre de GPU, le sharding ou les nouvelles tentatives pour justifier la prime ? |
| H20 | Contextes d’approvisionnement restreints où H100/H200 ne sont pas simples | Ce déploiement H20 précis peut-il passer les tests de conformité, de disponibilité et de charge de travail ? |
Si l’équipe n’a besoin que de la sortie du modèle, ajoutez une quatrième voie : une API de modèle gérée. La possession du matériel se justifie lorsqu’il faut des poids privés, des kernels personnalisés, une capacité dédiée fixe ou un contrôle de bas niveau du service. Sinon, une base d’API de modèle peut dépasser la location de GPU une fois le temps d’inactivité, la gestion des files d’attente, le travail sur les pilotes et les échecs de jobs pris en compte.
Flatkey est utile pour cette base : une clé, un solde unique, un routage compatible OpenAI, la visibilité de l’usage et l’accès à de nombreuses API de modèles officielles sans exploiter de serveurs GPU. Cela ne remplace pas le H20 ou le H100 pour les équipes qui doivent posséder la couche matérielle, mais cela donne aux achats une comparaison réaliste de type « avons-nous besoin de GPU du tout ? ».
Guides de planification associés :
- Explication des prix de location GPU
- Coûts cachés du cloud GPU
- TCO d’un cluster GPU
- Cloud GPU vs API de modèle
- Meilleur GPU pour l’inférence LLM
- Comparaison des clouds GPU 2026
Liste de contrôle des benchmarks pour l’inférence H20 vs H100
Exécutez la même charge de travail sur la forme exacte de déploiement que vous prévoyez d’acheter. Pour l’inférence h20 vs h100, utilisez des prompts représentatifs de la production et mesurez la sortie acceptée.
| Métrique | Pourquoi c’est important |
|---|---|
| Temps jusqu’au premier jeton | Mesure la latence visible par l’utilisateur et le comportement du préremplissage |
| Latence entre jetons | Montre la vitesse de décodage sous une concurrence réelle |
| Jetons par seconde et par GPU | Utile, mais incomplet sans l’utilisation et le taux d’acceptation |
| Concurrence maximale stable | Révèle la pression sur le cache KV et sur l’ordonnanceur |
| Mémoire allouée et réservée | Montre si le modèle tient réellement avec des prompts de production |
| Délai de file d’attente | Transforme une capacité rare en latence réelle pour l’utilisateur |
| Taux d’OOM et de réessai | Convertit les limites mémoire en impact sur les coûts et la fiabilité |
| Coût par sortie acceptée | Normalise les heures GPU, l’utilisation, les échecs et le temps d’ingénierie |
| Délai d’approbation de conformité | Critique pour H20 et tout déploiement dans une région restreinte |
| Chemin de repli | Protège les dates de lancement lorsque l’approvisionnement ou les licences changent |
La métrique d’approvisionnement importante n’est pas la « performance de pointe H20 vs H100 ». C’est le coût du workload terminé après prise en compte de la disponibilité, des tentatives échouées, de l’attente en file, de l’examen de conformité et des opérations.
Matrice de décision d’achat
Utilisez cette matrice lors de la réunion d’achat.
| Si c’est vrai | Préférer | Pourquoi |
|---|---|---|
| Le H100 est légalement disponible, la capacité est réelle et le prix est acceptable | H100 | C’est la base Hopper la plus propre, avec un large support |
| Le workload est limité par la mémoire et le H200 est disponible | Tester H200 par rapport à H100 | L’amélioration mémoire peut être plus directe que l’utilisation du H20 |
| Le déploiement doit desservir un marché restreint où le H100/H200 est bloqué | Tester H20 avec solution de repli | Le chemin de conformité peut déterminer le choix du matériel |
| Le modèle est petit ou moyen et le trafic est irrégulier | API de modèle ou GPU serverless | Éviter une capacité GPU dédiée inactive |
| L’équipe a besoin de kernels personnalisés, de poids privés et d’une utilisation soutenue | Capacité GPU directe | Le contrôle du matériel peut justifier la charge opérationnelle |
| L’approvisionnement, les licences ou les règles géopolitiques peuvent changer avant le lancement | Maintenir deux options actives | Ne pas engager la feuille de route d’un produit sur un seul SKU restreint |
Erreurs courantes dans la planification NVIDIA H20 vs H100
La première erreur consiste à considérer le H20 comme « simplement un H100 plus lent ». La vraie différence est le contexte d’approvisionnement. Si vos contraintes juridiques, de conformité et de disponibilité n’exigent pas le H20, la base H100 est généralement plus simple.
La deuxième erreur consiste à recopier les spécifications nvidia h20 vs h100 publiques sans vérifier le SKU exact. Les références H20 peuvent varier selon la taille mémoire et la forme de déploiement. Votre devis doit préciser le GPU, la mémoire, l’interconnexion, la conception du nœud, l’image du pilote, les conditions de service et la région.
La troisième erreur consiste à ignorer le H200. Si le problème est la pression mémoire sur le H100, le H200 peut être la comparaison la plus naturelle. Utilisez le H20 lorsque le contexte d’approvisionnement impose cette voie, et non simplement parce qu’un chiffre de mémoire paraît attrayant.
La quatrième erreur consiste à oublier la base de l’API de modèle. Si le workload n’a besoin que de sorties de modèle fiables, sans contrôle direct du GPU, la voie la plus simple peut être une API avec suivi d’usage, solution de repli et économie à la consommation.
Recommandation finale
Pour H20 vs H100, choisissez le H100 lorsqu’il est disponible et conforme à votre déploiement. Il reste la base Hopper la plus sûre pour la plupart des tâches d’entraînement, de fine-tuning et d’inférence.
Choisissez le H20 uniquement lorsque l’environnement d’approvisionnement le rend nécessaire et que le déploiement H20 exact passe trois tests : le modèle tient, le benchmark d’inférence fonctionne sous une charge représentative de la production, et la conformité peut approuver l’utilisateur final, la région et le chemin de transfert.
Comparez ensuite les deux avec le H200 et une base d’API de modèle. La voie gagnante est celle qui produit de manière fiable une sortie acceptée, et non celle qui possède le tableau de spécifications le plus intéressant.
Questions fréquentes
Le H20 est-il meilleur que le H100 pour l’inférence ?
En général non. Le H100 est le meilleur choix par défaut lorsqu’il est disponible et conforme. Le H20 peut être pertinent lorsque le H100 est bloqué par des contraintes d’approvisionnement, de contrôle des exportations ou de disponibilité régionale. Benchmarkez le SKU H20 exact avant de supposer qu’il s’agit d’un bon substitut pour l’inférence.
Quelle est la principale différence NVIDIA H20 vs H100 ?
La principale différence est le contexte d’approvisionnement. Le H100 est un GPU de centre de données Hopper largement pris en charge. Le H20 est évalué dans des contextes d’approvisionnement restreints où les licences d’exportation, les règles du marché chinois (RPC), la disponibilité exacte du SKU et l’examen de conformité peuvent déterminer si la capacité est utilisable.
Comment dois-je comparer les spécifications NVIDIA H20 vs H100 ?
Comparez le SKU exact, la mémoire, l’interconnexion, la forme du nœud, l’image du pilote, la région, la garantie et le statut de conformité. Ne vous fiez pas uniquement aux tableaux de spécifications de tiers. En production, validez avec de vrais prompts, la concurrence cible et le coût par sortie acceptée.
Dois-je comparer H20 vs H100 vs H200 ?
Oui. Si le workload est limité par la mémoire et que le H200 est disponible, le H200 peut constituer une mise à niveau plus propre depuis le H100. Le H20 est plus pertinent lorsque la conformité ou l’approvisionnement régional bloque le H100/H200.
Quand dois-je utiliser une API de modèle au lieu du H20 ou du H100 ?
Utilisez une API de modèle lorsque vous n’avez pas besoin de kernels personnalisés, de poids privés ou d’une capacité dédiée fixe. Pour un trafic produit irrégulier, une API de modèle peut réduire les dépenses GPU inactives et le travail opérationnel tout en conservant la visibilité sur l’usage et la flexibilité de routage.


