
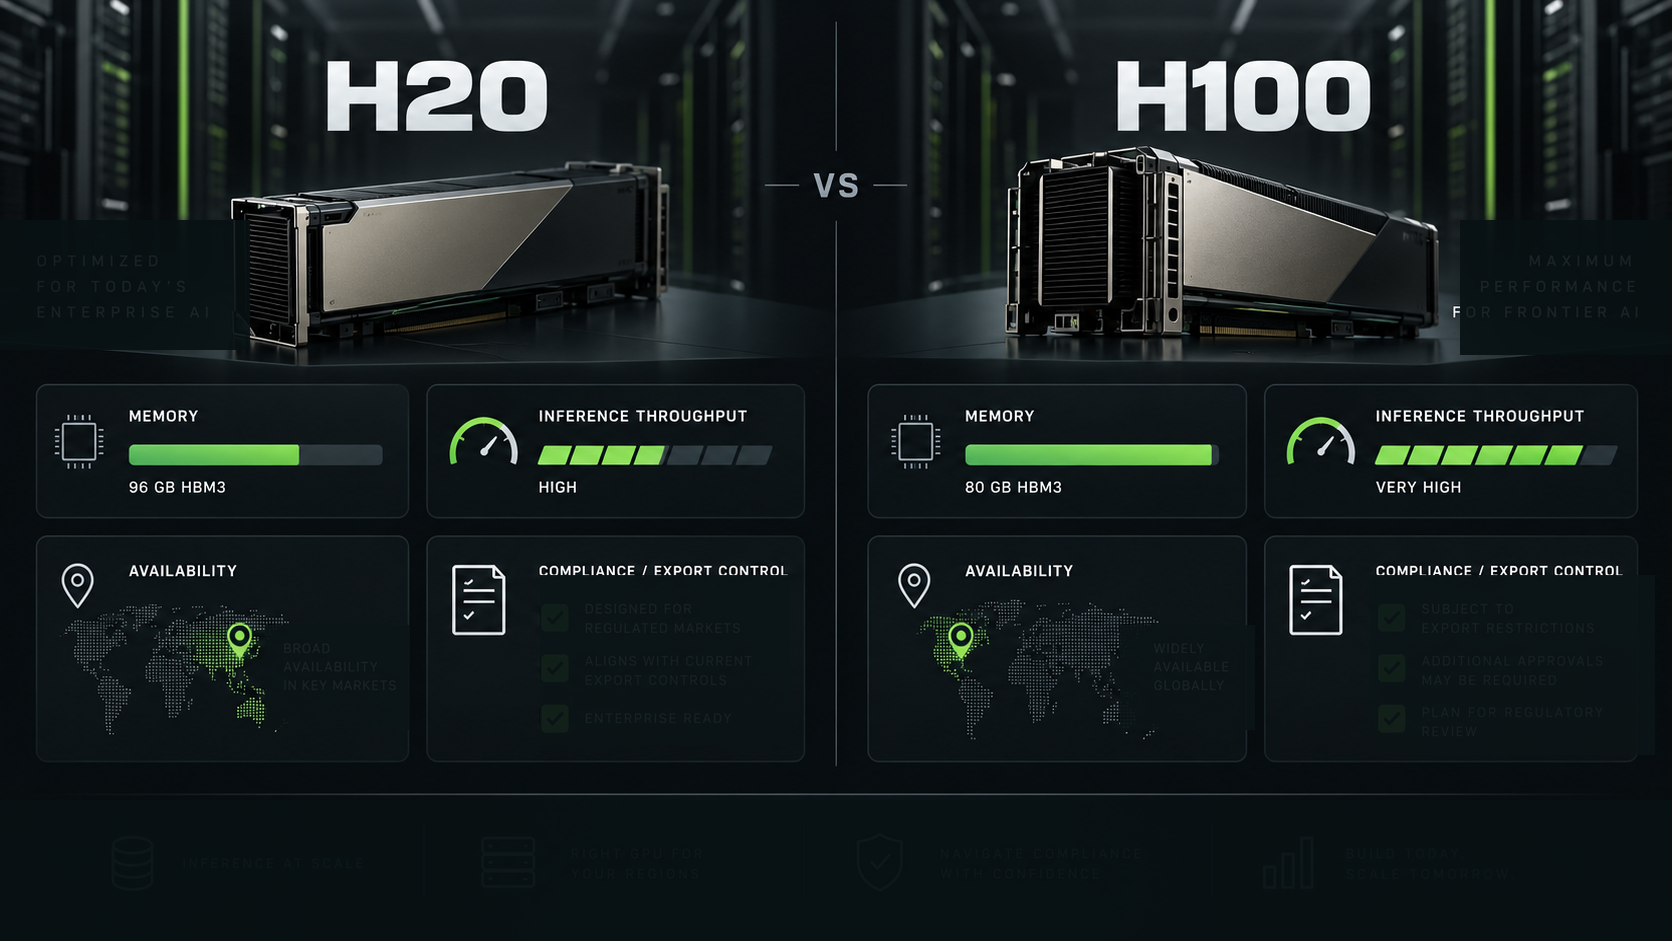
Если вы сравниваете H20 vs H100, краткий вывод таков: H100 — более сильный вариант по умолчанию, если его можно законно приобрести, надежно получить и эффективно использовать. H20 становится привлекательным только тогда, когда ограничения экспортного контроля, доступность на рынке Китая или местные правила закупок делают H100 непрактичным.
Это делает сравнение NVIDIA H20 vs H100 скорее не обычным сопоставлением характеристик, а решением по мощности с учетом соответствия требованиям. H100 — более известный GPU Hopper для обучения и инференса. H20 — это ограниченный путь семейства Hopper, который покупатели оценивают, когда контекст закупки определяется лицензированием экспорта, правилами рынка КНР и доступностью конкретных SKU у провайдера.
Для корпоративных команд ИИ полезный вопрос h20 vs h100 — не «какой GPU быстрее?». Вопрос в другом: какой вариант сможет обеспечить приемлемый результат инференса при наименьшем общем риске после учета соответствия памяти, времени ожидания в очереди, одобрения по комплаенсу и доступности?
H20 vs H100: краткий ответ
Выбирайте H100, если:
- Вы можете приобрести или арендовать мощность H100 в регионе развертывания без блокеров экспортного контроля.
- Вашей нагрузке нужен зрелый базовый уровень Hopper для обучения, дообучения или высокопроизводительного инференса.
- Вам важны высокая зрелость ПО, широкая поддержка облаков и предсказуемые референсы бенчмарков.
- Ваша модель не требует специфического для Китая пути закупки GPU.
Выбирайте H20 только когда:
- Развертывание должно вписываться в ограниченный рынок или клиентскую локацию, где H100 недоступен или его трудно лицензировать.
- Провайдер может показать точный SKU H20, объем памяти, interconnect, образ драйвера и коммерческие условия.
- Проверки по комплаенсу, местоположению клиента, перепродаже и конечному использованию уже являются частью процесса закупки.
- Вы проводите бенчмарк реальной нагрузки инференса, а не опираетесь на сторонние таблицы пиковых характеристик.
Для большинства команд решение H20 vs H100 принимается по доступности и соответствию требованиям еще до оценки сырой производительности инференса. Если оба варианта доступны на приемлемых юридических и коммерческих условиях, H100 — более безопасный вариант по умолчанию.
Спецификации NVIDIA H20 vs H100, которые имеют значение
Сложность сравнения NVIDIA H20 vs H100 specs в том, что у H100 есть публичная страница продукта, тогда как публичные данные по H20 более фрагментированы. На публичной странице H100 NVIDIA указывает H100 Tensor Core GPU как дата-центровый GPU Hopper с вариантами памяти HBM и опубликованными пиковыми показателями AI/HPC. В документации NVIDIA AI Enterprise публично перечислены варианты H20 в матрице поддержки Hopper vGPU, включая профили H20 SXM5 с 96GB и 141GB framebuffer.
Используйте эту таблицу как чек-лист для закупки, а не как окончательный прайс-лист.
| Область спецификации | H100 | H20 |
|---|---|---|
| Публичное позиционирование | Основной дата-центровый GPU Hopper для AI, HPC, обучения и инференса | Дата-центровый GPU семейства Hopper, оцениваемый в ограниченных сценариях закупки |
| Публичная страница продукта NVIDIA | Да, у H100 есть отдельная страница продукта | Нет эквивалентной широкой публичной страницы H20, используемой для финальных спецификаций покупателя |
| Публичный сигнал по памяти | H100 SXM обычно рассматривается примерно с 80GB HBM3; H100 NVL фигурирует в сценариях обслуживания LLM с большей памятью | Документация NVIDIA AI Enterprise vGPU перечисляет профили H20 SXM5 с 96GB и 141GB framebuffer |
| Вывод для инференса | Более сильный вариант по умолчанию для сырой производительности, поддержки экосистемы, обучения и общего инференса | Оценивать только по бенчмаркам конкретного SKU; объем памяти может быть привлекательным, но решающими остаются соответствие требованиям и доступность |
| Риск закупки | Доступность и облачная цена варьируются, но продукт широко поддерживается | Лицензирование экспорта, правила рынка КНР и поставки конкретного провайдера могут определять, пригодна ли вообще смета |
Правильный способ читать nvidia h20 vs h100 specs — разделить три уровня:
- Подтвержденные публичные факты NVIDIA, такие как документация по H100 и записи о поддержке H20 в NVIDIA AI Enterprise.
- Факты из коммерческого предложения провайдера, такие как точный объем памяти H20, interconnect, драйвер, форма узла, регион и гарантия.
- Факты вашей нагрузки, такие как токены в секунду, время до первого токена, задержка в очереди, частота ошибок и стоимость одного принятого результата.
Не объединяйте эти уровни в один искусственный показатель «победителя».
Производительность NVIDIA H20 vs H100: что меняется в инференсе
Для nvidia h20 vs h100 performance оценивайте инференс в два этапа: prefill и decode.
Prefill чувствителен к длине промпта, стратегии батчинга, реализации attention и пропускной способности памяти. Decode чувствителен к конкуренции запросов, нагрузке на KV cache, поведению планировщика и эффективности serving-стека. Команда закупок, которая запрашивает только пиковые показатели tensor-core, упустит реальные драйверы стоимости.
Используйте H100 как базовый вариант, если:
- Вы обслуживаете модели 7B–70B с mature vLLM, TensorRT-LLM, SGLang или управляемыми образами Kubernetes.
- Вам нужно чистое сравнение с уже имеющейся облачной мощностью H100, H200 или B200.
- Вы планируете переиспользовать результаты бенчмарков для более широких флотилий H100.
- Обучение или дообучение все еще входят в состав рабочей нагрузки.
Используйте H20 только после live-теста, если:
- H100 нельзя купить, импортировать, развернуть или согласовать для целевой среды.
- У узла H20 достаточно памяти для модели и длины контекста без вынужденного ухудшения качества.
- Провайдер может подтвердить стабильные драйверы, контейнерные образы и поддержку вашего serving framework.
- Проверка комплаенса принимает конечного пользователя, конечное использование, регион и путь передачи.
На практике H20 vs H100 — это редко честный лабораторный бенчмарк. Обычно это сценарий «H100 в регионе без ограничений» против «H20 или другой локальный вариант в среде закупок с ограничениями». Именно поэтому бенчмарк должен учитывать юридическую доступность и время ожидания в очереди, а не только количество токенов в секунду.
Память: когда H20 может выглядеть интересно
Память — это та область, где H20 заслуживает тщательной проверки. В документации NVIDIA AI Enterprise перечислены профили vGPU для H20 SXM5 с указанием framebuffer на 96GB и 141GB. Эти публичные записи полезны, потому что показывают: в разговорах о H20 нельзя исходить из одного фиксированного размера памяти.
Для инференса LLM память влияет на:
- Помещается ли модель без агрессивной квантизации.
- Сколько KV cache можно держать на одну реплику.
- Практичны ли более длинный контекст или более высокая конкуррентность.
- Требуется ли тензорный параллелизм между несколькими GPU.
- Как часто производственные запросы вызывают повторные попытки из-за нехватки памяти.
Это означает, что конфигурация H20 с большим объемом памяти иногда может быть операционно интересной, даже если H100 — более сильный универсальный ускоритель. Но больший объем памяти сам по себе не делает H20 быстрее или дешевле. Узел все равно должен пройти бенчмарки инференса, проверки доступности, комплаенс-ревью и моделирование совокупной стоимости владения.
Если нагрузка упирается в память и H100 доступен, сравните H100 также с H200. Более широкий выбор H200 vs H100 часто является более чистым путем к апгрейду памяти, чем ставка на цепочку поставок H20, построенную вокруг экспортных ограничений.
Доступность и соответствие требованиям — первоочередные условия
Для NVIDIA H20 vs H100 соответствие требованиям — не сноска. В последней публичной форме 10-K NVIDIA в SEC описан ряд экспортных ограничений, затрагивающих продукты классов A100, H100, H20, H200, B200, GB200 и связанные системы. В ней говорится, что продукты H100 были затронуты более ранними ограничениями, связанными с Китаем, что экспорт H20 в Китай и страны D:5 стал требовать лицензирования в апреле 2025 года, а позднее выданные лицензии не означали беспрепятственных продаж H20, поскольку ограничения со стороны КНР также повлияли на продажи.
Для покупателей это создает три практических правила:
- Не рассматривайте доступность H20 как обычный вопрос наличия на складе.
- Не предполагайте, что лицензии, котировки или листинг на маркетплейсе достаточно для вашего конечного заказчика.
- Не планируйте емкость H20 без резервного варианта.
Задайте поставщикам следующие вопросы, прежде чем принимать предложение на H20:
- Какой именно SKU H20 предлагается?
- В какой стране, регионе, дата-центре и у какого юридического лица будут размещены GPU?
- Подпадает ли покупатель, конечный пользователь, рабочая нагрузка, материнская компания или местоположение клиента под какой-либо экспортный контроль?
- Имеют ли значение ограничения на перепродажу, передачу, удаленный доступ или облачный сервис?
- Доступен ли GPU сейчас, зарезервирован, ожидает лицензию, ожидает импорт или зависит от будущего распределения?
- Что произойдет, если до развертывания изменятся лицензия, тариф, проверка или государственное правило?
- Может ли та же нагрузка работать на H100, H200, L40S, локальных альтернативах или через model API, если H20 задержится?
Этот чек-лист важнее, чем очередное синтетическое nvidia h20 vs h100 performance comparison.
H20 vs H100 vs H200
Многие команды ищут h20 vs h100 vs h200, потому что реальное решение не бинарное. Используйте более простую рамку:
| Путь GPU | Лучшее стандартное применение | Главный вопрос покупателя |
|---|---|---|
| H100 | Зрелая базовая платформа Hopper для обучения, дообучения и инференса | Можем ли мы получить достаточно мощности по цене и в регионе, которые можем использовать? |
| H200 | Инференс с высокой нагрузкой на память, более длинный контекст, больший batch, HPC, упирающийся в память | Снижает ли больший объем памяти HBM3e число GPU, необходимость шардирования или повторных попыток настолько, чтобы оправдать премию? |
| H20 | Сценарии закупок с ограничениями, где H100/H200 не являются простым вариантом | Пройдет ли именно это развертывание H20 проверки на соответствие требованиям, доступность и бенчмарки нагрузки? |
Если команде нужен только результат модели, добавьте четвертый путь: управляемый model API. Владение оборудованием оправдано, когда нужны приватные веса, собственные ядра, фиксированная выделенная емкость или низкоуровневый контроль обслуживания. Если нет, базовый вариант через model API может оказаться лучше аренды GPU после учета простоя, управления очередью, работы с драйверами и сбоев заданий.
Flatkey полезен как такой базовый вариант: один ключ, один баланс, маршрутизация, совместимая с OpenAI, прозрачность использования и доступ к множеству официальных model API без эксплуатации GPU-серверов. Он не заменяет H20 или H100 для команд, которым нужно владеть уровнем оборудования, но дает закупкам реалистичное сравнение «а нужны ли нам GPU вообще?».
Связанные руководства по планированию:
- Как устроены цены на аренду GPU
- Скрытые расходы GPU cloud
- TCO кластера GPU
- GPU cloud против model API
- Лучшая GPU для инференса LLM
- Сравнение GPU cloud 2026
Чек-лист бенчмарка для инференса H20 vs H100
Запускайте ту же нагрузку на точно такой конфигурации развертывания, которую планируете покупать. Для инференса h20 vs h100 используйте промпты, похожие на производственные, и измеряйте принятый output.
| Метрика | Почему это важно |
|---|---|
| Время до первого токена | Отражает задержку, видимую пользователю, и поведение на этапе prefill |
| Задержка между токенами | Показывает скорость декодирования при реальной конкуренции |
| Токенов в секунду на GPU | Полезно, но недостаточно без данных об утилизации и доле принятых результатов |
| Максимальная стабильная конкуренция | Выявляет нагрузку на KV-кэш и планировщик |
| Выделенная и зарезервированная память | Показывает, действительно ли модель помещается с боевыми запросами |
| Задержка в очереди | Превращает дефицитную мощность в реальную задержку для пользователя |
| Частота OOM и повторных попыток | Переводит ограничения памяти в влияние на стоимость и надежность |
| Стоимость на принятый результат | Нормализует GPU-час, утилизацию, сбои и инженерное время |
| Время одобрения соответствия требованиям | Критично для H20 и любого развертывания в ограниченном регионе |
| Путь резервного перехода | Защищает сроки запуска при изменении поставок или лицензирования |
Важная закупочная метрика — не "пиковая производительность H20 против H100." Это стоимость завершенной рабочей нагрузки с учетом доступности, неудачных попыток, очередей, проверки соответствия и операций.
Матрица решения о закупке
Используйте эту матрицу на закупочном совещании.
| Если это правда | Предпочесть | Почему |
|---|---|---|
| H100 законно доступен, мощность реальна, а цена приемлема | H100 | Это более чистая базовая платформа Hopper с широкой поддержкой |
| Нагрузка ограничена памятью, и H200 доступен | Сравнить H200 с H100 | Обновление памяти может быть более прямым, чем использование H20 |
| Развертывание должно обслуживать ограниченный рынок, где H100/H200 заблокированы | Тестировать H20 плюс резервный вариант | Путь соответствия требованиям может определять выбор оборудования |
| Модель небольшая или средняя, а трафик носит всплесковый характер | API модели или serverless GPU | Избегайте простаивающей выделенной GPU-мощности |
| Команде нужны пользовательские ядра, приватные веса и стабильная утилизация | Прямая GPU-мощность | Контроль над оборудованием может оправдать операционную нагрузку |
| Поставки, лицензирование или геополитические правила могут измениться до запуска | Держать два маршрута в рабочем состоянии | Не привязывайте дорожную карту продукта к одному ограниченному SKU |
Типичные ошибки при планировании NVIDIA H20 против H100
Первая ошибка — считать H20 "просто более медленным H100." Реальная разница — в контексте закупки. Если ваши юридические, регуляторные и доступностные ограничения не требуют H20, базовая платформа H100 обычно проще.
Вторая ошибка — копировать публичные характеристики nvidia h20 vs h100, не проверив точный SKU. Упоминания H20 могут различаться по объему памяти и форме развертывания. В вашем коммерческом предложении должны быть указаны GPU, память, межсоединение, дизайн узла, образ драйвера, условия обслуживания и регион.
Третья ошибка — игнорировать H200. Если проблема — это давление по памяти у H100, H200 может быть более естественным сравнением. Используйте H20, когда путь навязывает контекст закупки, а не просто потому, что одна цифра памяти выглядит привлекательнее.
Четвертая ошибка — забывать про базовую линию API модели. Если нагрузке нужны только надежные результаты модели, а не прямой контроль над GPU, более простой путь может заключаться в API с учетом использования, резервным вариантом и экономикой оплаты за запрос.
Итоговая рекомендация
Для H20 против H100 выбирайте H100, когда он доступен и соответствует требованиям для вашего развертывания. Для большинства задач обучения, дообучения и инференса он по-прежнему остается более безопасной базовой платформой Hopper.
Выбирайте H20 только тогда, когда среда закупки делает это необходимым, и конкретное развертывание H20 проходит три проверки: модель помещается, бенчмарк инференса работает под нагрузкой, соответствующей production, а соответствие требованиям может быть одобрено для конечного пользователя, региона и пути передачи.
Затем сравните оба варианта с H200 и базовой линией API модели. Побеждает тот путь, который надежно выдает принятый результат, а не тот, у которого самая интересная таблица характеристик.
FAQ
H20 лучше, чем H100, для инференса?
Обычно нет. H100 — более сильный вариант по умолчанию, когда он доступен и соответствует требованиям. H20 может быть релевантен, когда H100 заблокирован ограничениями закупки, экспортного контроля или региональной доступности. Протестируйте точный SKU H20, прежде чем считать его хорошей заменой для инференса.
В чем главное отличие NVIDIA H20 vs H100?
Главное отличие — в контексте закупки. H100 — широко поддерживаемый дата-центровый GPU Hopper. H20 оценивается в ограниченных сценариях закупки, где экспортное лицензирование, правила рынка КНР, доступность точного SKU и проверка соответствия могут определять, можно ли использовать эту мощность.
Как сравнивать характеристики NVIDIA H20 vs H100?
Сравнивайте точный SKU, память, межсоединение, форму узла, образ драйвера, регион, гарантию и статус соответствия требованиям. Не полагайтесь только на таблицы характеристик от третьих лиц. Для production проверяйте на реальных запросах, целевой конкуренции и стоимости на принятый результат.
Стоит ли сравнивать H20 vs H100 vs H200?
Да. Если нагрузка ограничена памятью и H200 доступен, H200 может быть более чистым обновлением по сравнению с H100. H20 более релевантен, когда соответствие требованиям или региональная закупка блокируют H100/H200.
Когда следует использовать API модели вместо H20 или H100?
Используйте API модели, когда вам не нужны пользовательские ядра, приватные веса или фиксированная выделенная мощность. Для всплескового продуктового трафика API модели может снизить простои GPU и операционные затраты, сохранив видимость использования и гибкость маршрутизации.


