
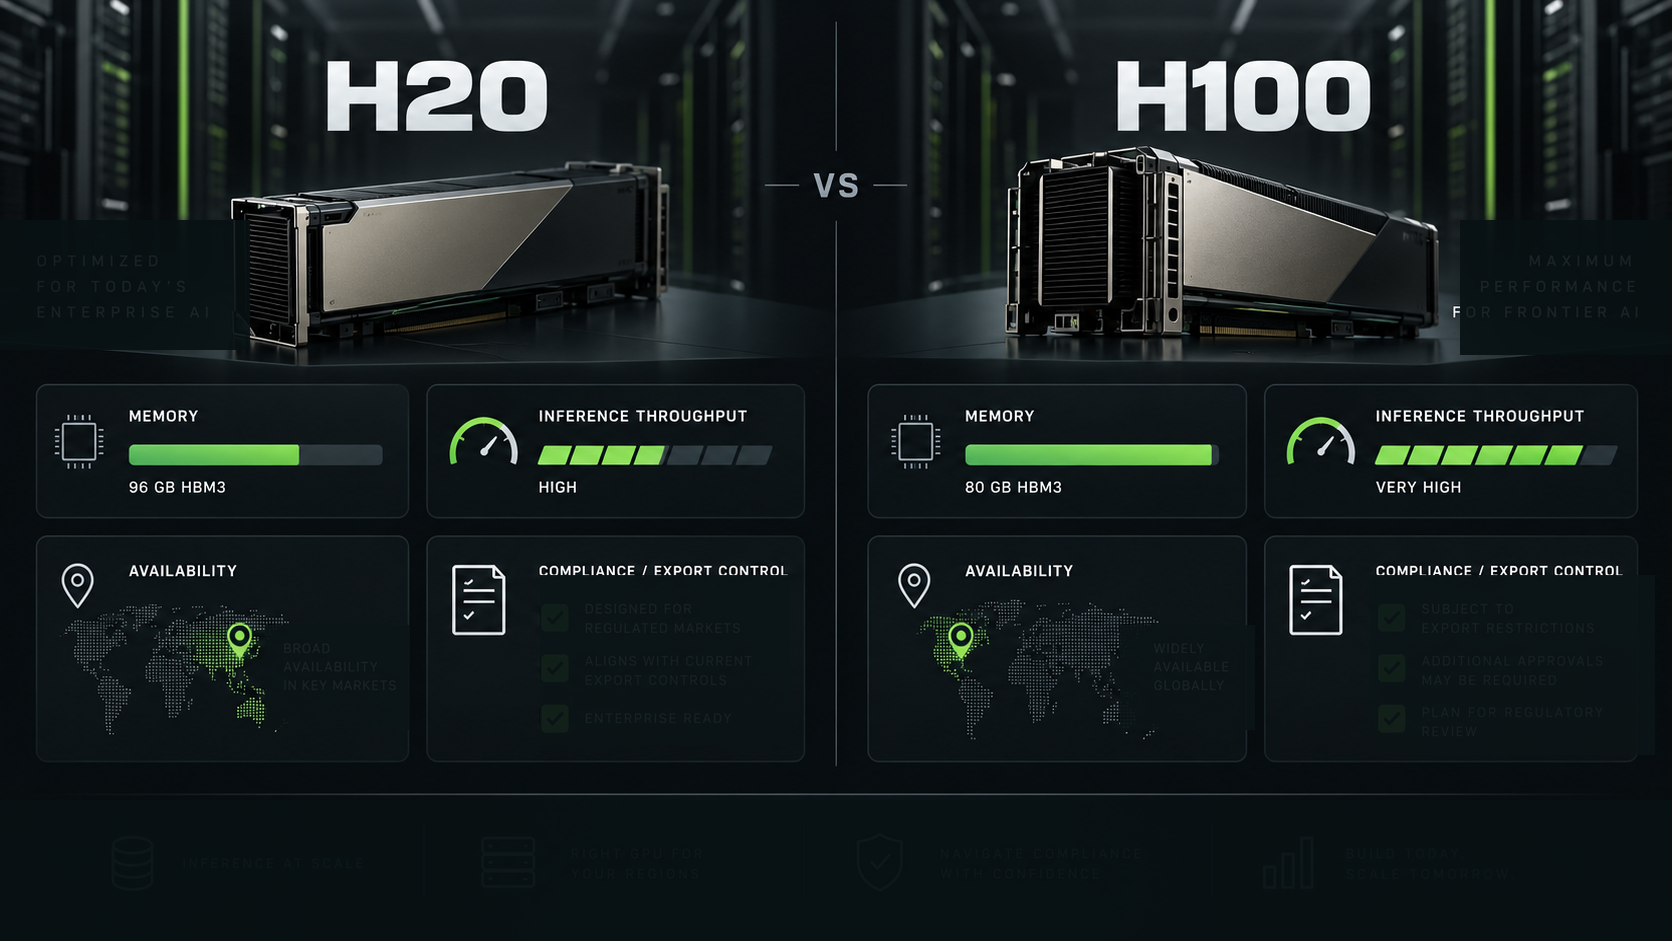
Nếu bạn đang so sánh H20 vs H100, câu trả lời ngắn gọn là: H100 là lựa chọn mặc định mạnh hơn khi bạn có thể mua hợp pháp, nguồn cung ổn định và sử dụng hết công suất. H20 chỉ trở nên hấp dẫn khi các ràng buộc kiểm soát xuất khẩu, khả dụng tại thị trường Trung Quốc, hoặc quy định mua sắm nội bộ khiến H100 trở nên không thực tế.
Điều đó khiến NVIDIA H20 vs H100 giống một quyết định năng lực có xét đến tuân thủ hơn là một so sánh bảng thông số thông thường. H100 là GPU Hopper quen thuộc hơn cho huấn luyện và suy luận. H20 là một lộ trình thuộc họ Hopper bị hạn chế, được người mua đánh giá khi bối cảnh mua sắm bị chi phối bởi cấp phép xuất khẩu, quy định thị trường CHND Trung Hoa, và tình trạng khả dụng SKU cụ thể từ nhà cung cấp.
Đối với các nhóm AI doanh nghiệp, câu hỏi hữu ích về h20 vs h100 không phải là "GPU nào nhanh hơn?" Mà là: con đường nào có thể mang lại kết quả suy luận được chấp nhận với tổng rủi ro thấp nhất sau khi tính đến mức phù hợp bộ nhớ, thời gian chờ hàng đợi, phê duyệt tuân thủ và khả dụng?
H20 vs H100: câu trả lời nhanh
Chọn H100 khi:
- Bạn có thể mua hoặc thuê dung lượng H100 tại khu vực triển khai mà không gặp rào cản kiểm soát xuất khẩu.
- Khối lượng công việc của bạn cần một nền tảng Hopper trưởng thành cho huấn luyện, tinh chỉnh hoặc suy luận thông lượng cao.
- Bạn cần độ chín phần mềm cao, hỗ trợ đám mây rộng rãi và các tham chiếu benchmark có thể dự đoán.
- Mô hình của bạn không yêu cầu lộ trình mua GPU dành riêng cho Trung Quốc.
Chỉ chọn H20 khi:
- Triển khai phải phù hợp với thị trường hạn chế hoặc vị trí khách hàng nơi H100 không khả dụng hoặc khó được cấp phép.
- Nhà cung cấp có thể cung cấp chính xác SKU H20, dung lượng bộ nhớ, liên kết nội bộ, ảnh driver và các điều khoản thương mại.
- Kiểm tra tuân thủ, vị trí khách hàng, chuyển nhượng và mục đích sử dụng cuối cùng đã là một phần của quy trình mua hàng.
- Bạn đang benchmark một khối lượng công việc suy luận thực tế, không dựa vào các bảng thông số đỉnh từ bên thứ ba.
Với đa số đội ngũ, quyết định H20 vs H100 được xác định bởi khả dụng và tuân thủ trước khi xét đến hiệu năng suy luận thô. Nếu cả hai đều khả dụng với các điều khoản pháp lý và thương mại chấp nhận được, H100 là lựa chọn mặc định an toàn hơn.
Thông số NVIDIA H20 vs H100 đáng chú ý
Phần khó nhất của việc so sánh thông số NVIDIA H20 vs H100 là H100 có trang sản phẩm công khai, trong khi dữ liệu công khai của H20 bị phân mảnh hơn. Trang H100 công khai của NVIDIA liệt kê GPU H100 Tensor Core là GPU trung tâm dữ liệu Hopper với các tùy chọn bộ nhớ HBM và các số liệu đỉnh AI/HPC được công bố. Tài liệu NVIDIA AI Enterprise công khai liệt kê các biến thể H20 trong ma trận hỗ trợ Hopper vGPU, bao gồm các cấu hình H20 SXM5 với mục framebuffer 96GB và 141GB.
Hãy xem bảng này như một danh sách kiểm tra mua sắm, không phải bảng báo giá cuối cùng.
| Hạng mục thông số | H100 | H20 |
|---|---|---|
| Định vị công khai | GPU trung tâm dữ liệu Hopper phổ biến cho AI, HPC, huấn luyện và suy luận | Lộ trình GPU trung tâm dữ liệu thuộc họ Hopper được đánh giá trong bối cảnh mua sắm bị hạn chế |
| Trang sản phẩm công khai của NVIDIA | Có, H100 có trang sản phẩm riêng | Không có trang sản phẩm H20 công khai rộng rãi tương đương dùng cho thông số người mua cuối |
| Tín hiệu bộ nhớ công khai | H100 SXM thường được đánh giá quanh 80GB HBM3; H100 NVL xuất hiện trong bối cảnh phục vụ LLM với bộ nhớ lớn hơn | Tài liệu NVIDIA AI Enterprise vGPU liệt kê các cấu hình framebuffer H20 SXM5 96GB và 141GB |
| Kết luận cho suy luận | Lựa chọn mặc định mạnh hơn cho hiệu năng thô, hỗ trợ hệ sinh thái, huấn luyện và suy luận chung | Chỉ đánh giá với benchmark theo SKU chính xác; dung lượng bộ nhớ có thể hấp dẫn, nhưng tuân thủ và khả dụng chi phối |
| Rủi ro mua sắm | Khả dụng và giá đám mây thay đổi, nhưng sản phẩm được hỗ trợ rộng rãi | Cấp phép xuất khẩu, quy định thị trường CHND Trung Hoa và nguồn cung theo nhà cung cấp có thể quyết định báo giá có dùng được hay không |
Cách đúng để đọc thông số nvidia h20 vs h100 là tách thành ba lớp:
- Các तथ्य công khai được NVIDIA xác nhận, như tài liệu sản phẩm H100 và các mục hỗ trợ H20 trong NVIDIA AI Enterprise.
- Các तथ्य báo giá từ nhà cung cấp, như bộ nhớ H20 chính xác, liên kết nội bộ, driver, hình dạng node, khu vực và bảo hành.
- Các तथ्य về khối lượng công việc của bạn, như số token mỗi giây, thời gian đến token đầu tiên, độ trễ hàng đợi, tỷ lệ lỗi và chi phí trên mỗi đầu ra được chấp nhận.
Đừng gộp những lớp đó thành một điểm "kẻ thắng" tổng hợp.
Hiệu năng NVIDIA H20 vs H100: điều gì thay đổi trong suy luận
Với hiệu năng nvidia h20 vs h100, hãy benchmark suy luận theo hai giai đoạn: prefill và decode.
Prefill nhạy với độ dài prompt, chiến lược batch, cách triển khai attention và băng thông bộ nhớ. Decode nhạy với độ đồng thời, áp lực KV cache, hành vi bộ lập lịch và hiệu quả của stack phục vụ. Một đội mua sắm chỉ hỏi các con số đỉnh tensor-core sẽ bỏ lỡ các yếu tố chi phí thực sự.
Dùng H100 làm chuẩn khi:
- Bạn đang phục vụ các mô hình 7B đến 70B với vLLM, TensorRT-LLM, SGLang hoặc ảnh Kubernetes được quản lý đã trưởng thành.
- Bạn cần một so sánh rõ ràng với dung lượng H100, H200 hoặc B200 hiện có trên đám mây.
- Bạn dự định tái sử dụng công trình benchmark từ các cụm H100 lớn hơn.
- Huấn luyện hoặc tinh chỉnh vẫn là một phần của hỗn hợp khối lượng công việc.
Chỉ dùng H20 sau khi thử nghiệm trực tiếp khi:
- H100 không thể được mua, nhập khẩu, triển khai hoặc phê duyệt cho môi trường mục tiêu.
- Node H20 có đủ bộ nhớ cho mô hình và độ dài ngữ cảnh mà không phải đánh đổi chất lượng bắt buộc.
- Nhà cung cấp có thể chứng minh driver ổn định, image container và hỗ trợ cho framework phục vụ của bạn.
- Đánh giá tuân thủ chấp nhận người dùng cuối, mục đích sử dụng cuối, khu vực và đường chuyển giao.
Trên thực tế, H20 vs H100 hiếm khi là một bài benchmark phòng lab công bằng. Nó thường là "H100 ở một khu vực không bị hạn chế" so với "H20 hoặc một lựa chọn nội bộ khác trong môi trường mua sắm bị hạn chế." Đó là lý do vì sao benchmark phải bao gồm cả tính khả dụng hợp pháp và thời gian chờ hàng đợi, chứ không chỉ tokens mỗi giây.
Bộ nhớ: khi H20 có thể trông đáng chú ý
Bộ nhớ là lĩnh vực duy nhất mà H20 xứng đáng được xác minh cẩn thận. Tài liệu NVIDIA AI Enterprise liệt kê các profile vGPU H20 SXM5 với các mục framebuffer 96GB và 141GB. Những mục công khai này hữu ích vì chúng cho thấy các cuộc thảo luận về H20 không nên mặc định rằng chỉ có một mức bộ nhớ cố định.
Đối với suy luận LLM, bộ nhớ ảnh hưởng đến:
- Mô hình có thể vừa khít mà không cần lượng tử hóa quá mạnh hay không.
- Khối KV cache có thể được giữ lại bao nhiêu cho mỗi bản sao.
- Ngữ cảnh dài hơn hoặc mức độ đồng thời cao hơn có thực tế hay không.
- Khối lượng công việc có cần tensor parallelism trên nhiều GPU hay không.
- Tần suất các prompt production kích hoạt các lần thử lại do thiếu bộ nhớ.
Điều đó có nghĩa là cấu hình H20 có bộ nhớ lớn hơn đôi khi có thể đáng chú ý về mặt vận hành ngay cả khi H100 là bộ tăng tốc tổng quát mạnh hơn. Nhưng con số bộ nhớ lớn hơn không tự động làm H20 nhanh hơn hoặc rẻ hơn. Node vẫn phải vượt qua các benchmark suy luận, kiểm tra khả dụng, rà soát tuân thủ và mô hình hóa tổng chi phí.
Nếu khối lượng công việc bị giới hạn bởi bộ nhớ và H100 có sẵn, hãy so sánh H100 với H200 nữa. Quyết định rộng hơn về H200 so với H100 thường là một lộ trình nâng cấp bộ nhớ gọn hơn so với việc dựa vào một chuỗi cung ứng H20 được xây dựng quanh các hạn chế xuất khẩu.
Tính khả dụng và tuân thủ là các yêu cầu hàng đầu
Đối với NVIDIA H20 vs H100, tuân thủ không phải là một ghi chú cuối trang. Hồ sơ SEC công khai mới nhất của NVIDIA mô tả một loạt hạn chế kiểm soát xuất khẩu ảnh hưởng đến các sản phẩm thuộc dòng A100, H100, H20, H200, B200, GB200 và các hệ thống liên quan. Hồ sơ này nêu rằng các sản phẩm H100 đã bị ảnh hưởng bởi các hạn chế liên quan đến Trung Quốc trước đó, rằng xuất khẩu H20 sang Trung Quốc và các quốc gia D:5 trở thành đối tượng của yêu cầu cấp phép vào tháng 4 năm 2025, và rằng các giấy phép sau đó không chuyển thành việc bán H20 không bị ràng buộc vì các hạn chế phía PRC cũng ảnh hưởng đến hoạt động bán hàng.
Đối với người mua, điều đó tạo ra ba quy tắc thực tế:
- Đừng xem tính khả dụng của H20 như một câu hỏi tồn kho thông thường.
- Đừng cho rằng giấy phép, báo giá hoặc danh sách trên marketplace là đủ cho khách hàng cuối của bạn.
- Đừng mô hình hóa năng lực H20 mà không có đường dự phòng.
Hãy hỏi nhà cung cấp những câu hỏi sau trước khi chấp nhận báo giá H20:
- SKU H20 chính xác nào đang được báo giá?
- Quốc gia, khu vực, trung tâm dữ liệu và pháp nhân nào sẽ lưu trữ GPU?
- Người mua, người dùng cuối, khối lượng công việc, công ty mẹ hoặc vị trí khách hàng có chịu bất kỳ rà soát kiểm soát xuất khẩu nào không?
- Các hạn chế về bán lại, chuyển nhượng, truy cập từ xa hoặc dịch vụ đám mây có liên quan không?
- GPU hiện có sẵn ngay, đã được giữ chỗ, đang chờ giấy phép, đang chờ nhập khẩu hay phụ thuộc vào một phân bổ trong tương lai?
- Điều gì xảy ra nếu giấy phép, thuế quan, kiểm tra hoặc quy định của chính phủ thay đổi trước khi triển khai?
- Cùng khối lượng công việc đó có thể chạy trên H100, H200, L40S, các lựa chọn thay thế nội bộ hay API mô hình nếu H20 bị trì hoãn không?
Danh sách kiểm tra đó quan trọng hơn một phép so sánh tổng hợp khác về nvidia h20 vs h100 performance comparison.
H20 vs H100 vs H200
Nhiều nhóm tìm kiếm h20 vs h100 vs h200 vì quyết định thực tế không phải là nhị phân. Hãy dùng cách diễn đạt đơn giản hơn này:
| Đường GPU | Trường hợp sử dụng mặc định tốt nhất | Câu hỏi chính của bên mua |
|---|---|---|
| H100 | Nền tảng Hopper trưởng thành cho training, fine-tuning và inference | Chúng ta có thể mua đủ năng lực ở mức giá và khu vực có thể sử dụng không? |
| H200 | Suy luận nặng về bộ nhớ, ngữ cảnh dài hơn, batch lớn hơn, HPC bị giới hạn bởi bộ nhớ | Bộ nhớ HBM3e lớn hơn có giảm đủ số lượng GPU, sharding hoặc số lần thử lại để xứng đáng với mức giá cao hơn không? |
| H20 | Các bối cảnh mua sắm bị hạn chế nơi H100/H200 không phải là lựa chọn đơn giản | Việc triển khai H20 cụ thể này có vượt qua các benchmark về tuân thủ, khả dụng và khối lượng công việc không? |
Nếu nhóm chỉ cần đầu ra mô hình, hãy thêm một đường thứ tư: API mô hình được quản lý. Quyền sở hữu phần cứng là hợp lý khi bạn cần weights riêng tư, kernel tùy chỉnh, năng lực chuyên dụng cố định hoặc kiểm soát phục vụ ở mức thấp. Nếu không, một baseline API mô hình có thể tốt hơn thuê GPU khi đã tính đến thời gian nhàn rỗi, quản lý hàng đợi, công việc driver và các job thất bại.
Flatkey hữu ích cho baseline đó: một key, một số dư, định tuyến tương thích OpenAI, khả năng hiển thị mức sử dụng và quyền truy cập vào nhiều API mô hình chính thức mà không phải vận hành máy chủ GPU. Nó không thay thế H20 hoặc H100 cho các nhóm buộc phải sở hữu tầng phần cứng, nhưng nó cho bộ phận mua sắm một so sánh thực tế về "chúng ta có thực sự cần GPU không?".
Các hướng dẫn lập kế hoạch liên quan:
- Giải thích giá thuê GPU
- Các chi phí ẩn của GPU cloud
- TCO của cụm GPU
- GPU cloud so với API mô hình
- GPU tốt nhất cho suy luận LLM
- So sánh GPU cloud 2026
Checklist benchmark cho suy luận H20 vs H100
Chạy cùng một khối lượng công việc trên đúng hình thái triển khai mà bạn dự định mua. Đối với suy luận h20 vs h100, hãy dùng các prompt có hình thái giống production và đo output được chấp nhận.
| Chỉ số | Tại sao điều này quan trọng |
|---|---|
| Thời gian đến token đầu tiên | Phản ánh độ trễ mà người dùng nhìn thấy và hành vi prefill |
| Độ trễ giữa các token | Cho thấy tốc độ decode dưới tải đồng thời thực tế |
| Token mỗi giây trên mỗi GPU | Hữu ích, nhưng chưa đầy đủ nếu không có mức sử dụng và tỷ lệ chấp nhận |
| Mức đồng thời ổn định tối đa | Làm lộ áp lực lên KV cache và bộ lập lịch |
| Bộ nhớ đã phân bổ và đã dự trữ | Cho thấy mô hình có thực sự vừa với các prompt sản xuất hay không |
| Độ trễ hàng đợi | Biến năng lực khan hiếm thành độ trễ thực sự đối với người dùng |
| Tỷ lệ OOM và thử lại | Chuyển giới hạn bộ nhớ thành tác động đến chi phí và độ tin cậy |
| Chi phí trên mỗi đầu ra được chấp nhận | Chuẩn hóa giờ GPU, mức sử dụng, lỗi và thời gian kỹ thuật |
| Thời gian phê duyệt tuân thủ | Rất quan trọng đối với H20 và mọi triển khai ở khu vực bị hạn chế |
| Đường dự phòng | Bảo vệ ngày ra mắt khi nguồn cung hoặc giấy phép thay đổi |
Chỉ số mua sắm quan trọng không phải là "hiệu năng đỉnh H20 so với H100." Đó là chi phí của khối lượng công việc đã hoàn thành sau khi tính cả tính sẵn có, các lần thử thất bại, xếp hàng chờ, rà soát tuân thủ và vận hành.
Ma trận quyết định mua sắm
Hãy dùng ma trận này trong cuộc họp mua sắm.
| Nếu điều này đúng | Ưu tiên | Tại sao |
|---|---|---|
| H100 hợp pháp để sử dụng, năng lực là có thật và giá chấp nhận được | H100 | Đây là baseline Hopper gọn gàng hơn với hỗ trợ rộng |
| Khối lượng công việc bị giới hạn bởi bộ nhớ và H200 khả dụng | Kiểm thử H200 với H100 | Nâng cấp bộ nhớ có thể trực tiếp hơn việc dùng H20 |
| Triển khai phải phục vụ một thị trường bị hạn chế nơi H100/H200 bị chặn | Kiểm thử H20 cùng phương án dự phòng | Lộ trình tuân thủ có thể chi phối lựa chọn phần cứng |
| Mô hình nhỏ hoặc vừa và lưu lượng đến theo đợt | API mô hình hoặc GPU serverless | Tránh năng lực GPU chuyên dụng nhàn rỗi |
| Nhóm cần kernel tùy chỉnh, trọng số riêng tư và mức sử dụng duy trì | Năng lực GPU trực tiếp | Kiểm soát phần cứng có thể đáng để đánh đổi với gánh nặng vận hành |
| Nguồn cung, giấy phép hoặc quy định địa chính trị có thể thay đổi trước khi ra mắt | Giữ sống hai lộ trình | Đừng cam kết lộ trình sản phẩm vào một SKU bị hạn chế duy nhất |
Các sai lầm phổ biến trong lập kế hoạch NVIDIA H20 vs H100
Sai lầm đầu tiên là xem H20 như "chỉ là một H100 chậm hơn." Khác biệt thực sự là bối cảnh mua sắm. Nếu các ràng buộc pháp lý, tuân thủ và khả dụng của bạn không yêu cầu H20, baseline H100 thường sẽ đơn giản hơn.
Sai lầm thứ hai là sao chép thông số nvidia h20 vs h100 công khai mà không kiểm tra đúng SKU. Các tham chiếu H20 có thể khác nhau về dung lượng bộ nhớ và hình thái triển khai. Báo giá của bạn nên nêu rõ GPU, bộ nhớ, liên kết nội bộ, thiết kế node, image driver, điều khoản dịch vụ và khu vực.
Sai lầm thứ ba là bỏ qua H200. Nếu vấn đề là áp lực bộ nhớ của H100, H200 có thể là so sánh tự nhiên hơn. Hãy dùng H20 khi bối cảnh mua sắm buộc phải đi theo hướng đó, chứ không chỉ vì một con số bộ nhớ trông hấp dẫn.
Sai lầm thứ tư là quên baseline API mô hình. Nếu khối lượng công việc chỉ cần đầu ra mô hình đáng tin cậy chứ không cần kiểm soát GPU trực tiếp, lộ trình đơn giản hơn có thể là một API với theo dõi mức sử dụng, phương án dự phòng và mô hình kinh tế trả theo lần gọi.
Khuyến nghị cuối cùng
Với H20 so với H100, hãy chọn H100 khi nó khả dụng và tuân thủ cho triển khai của bạn. Đây vẫn là baseline Hopper an toàn hơn cho hầu hết công việc huấn luyện, fine-tuning và suy luận.
Chỉ chọn H20 khi môi trường mua sắm khiến nó trở nên cần thiết và triển khai H20 cụ thể vượt qua ba bài kiểm tra: mô hình vừa, benchmark suy luận hoạt động dưới tải mô phỏng sản xuất, và bộ phận tuân thủ có thể phê duyệt người dùng cuối, khu vực và đường chuyển giao.
Sau đó so sánh cả hai với H200 và baseline API mô hình. Lộ trình thắng là lộ trình tạo ra đầu ra được chấp nhận một cách đáng tin cậy, chứ không phải lộ trình có bảng thông số thú vị nhất.
Câu hỏi thường gặp
H20 có tốt hơn H100 cho suy luận không?
Thường là không. H100 là lựa chọn mặc định mạnh hơn khi nó khả dụng và tuân thủ. H20 có thể phù hợp khi H100 bị chặn bởi mua sắm, kiểm soát xuất khẩu hoặc ràng buộc về khả dụng theo khu vực. Hãy benchmark đúng SKU H20 trước khi cho rằng nó là một phương án thay thế suy luận tốt.
Khác biệt chính giữa NVIDIA H20 và H100 là gì?
Khác biệt chính là bối cảnh mua sắm. H100 là GPU trung tâm dữ liệu Hopper được hỗ trợ rộng rãi. H20 được đánh giá trong các bối cảnh mua sắm bị hạn chế, nơi giấy phép xuất khẩu, quy định thị trường PRC, khả dụng SKU chính xác và rà soát tuân thủ có thể quyết định liệu năng lực đó có thể sử dụng được hay không.
Tôi nên so sánh thông số NVIDIA H20 vs H100 như thế nào?
Hãy so sánh SKU chính xác, bộ nhớ, liên kết nội bộ, hình thái node, image driver, khu vực, bảo hành và trạng thái tuân thủ. Đừng chỉ dựa vào các bảng thông số của bên thứ ba. Với sản xuất, hãy xác thực bằng prompt thực tế, mức đồng thời mục tiêu và chi phí trên mỗi đầu ra được chấp nhận.
Tôi có nên so sánh H20 vs H100 vs H200 không?
Có. Nếu khối lượng công việc bị giới hạn bởi bộ nhớ và H200 khả dụng, H200 có thể là một nâng cấp gọn gàng hơn từ H100. H20 phù hợp hơn khi tuân thủ hoặc mua sắm theo khu vực chặn H100/H200.
Khi nào tôi nên dùng API mô hình thay vì H20 hoặc H100?
Hãy dùng API mô hình khi bạn không cần kernel tùy chỉnh, trọng số riêng tư hoặc năng lực chuyên dụng cố định. Với lưu lượng sản phẩm theo đợt, API mô hình có thể giảm chi phí GPU nhàn rỗi và công sức vận hành trong khi vẫn giữ được khả năng quan sát mức sử dụng và tính linh hoạt định tuyến.


