
Costes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
Precio de la GPU H100: precios, factores de coste y guía de compra
Guía de precios de la GPU H100 para comparar una oferta PCIe de 32.200 $, referencias de alquiler en la nube, formatos y el TCO tras una cotización on-premise.

Servidor GPU: guía de arquitectura, rendimiento y despliegue en la nube
Elige y despliega un servidor GPU en la nube con un enfoque centrado en la carga de trabajo para arquitectura, pruebas de rendimiento y preparación para producción.
API LLM gratuita: límites, costes y concesiones en producción
Una guía práctica sobre niveles gratuitos de API LLM, créditos, límites de velocidad, costes operativos ocultos y los controles de producción que debes añadir antes de que los usuarios dependan de una ruta.
ComfyUI en una GPU en la nube: guía de configuración, almacenamiento y costos
Guía práctica para implementar ComfyUI en una GPU en la nube con almacenamiento persistente, acceso privado, selección de GPU según la carga de trabajo y control de costos.

Las API de LLM más baratas en 2026: compara precios por carga de trabajo, no por moda
Guía con fuentes verificadas para comparar API de LLM de bajo costo por carga de trabajo, incluidos costos de entrada, salida, caché, lotes, herramientas, reintentos y reparación.

Infraestructura de IA soberana: modelos, residencia de datos y control del cómputo (guía 2026)
Una guía práctica de la infraestructura de IA soberana en 2026: las cuatro capas (cómputo, datos, modelos y operaciones), la normativa que la impulsa, cinco niveles de soberanía, una configuración para servir modelos abiertos y un ejemplo de costes de GPU en el país para un modelo de 70B.

Clave API de Anthropic (2026): cómo obtenerla, tipos de clave, Claude Code y errores
Guía paso a paso de la clave API de Anthropic en 2026: configuración en Console, claves personales y de cuenta de servicio, caducidad, primera petición, Claude Code, costes y errores.

Precios de la API de Grok (2026): todos los modelos, tarifas de herramientas y multiplicadores
Precios actuales de la API de xAI Grok: tarifas de texto, imagen, video y voz, los cinco multiplicadores (contexto largo, prioridad, región EE. UU., Batch y herramientas), una calculadora de costes y comparación con GPT, Claude, Gemini y Qwen.
Precios de la API de Mistral (2026): todos los modelos, descuento batch y ejemplos de coste
Tabla completa de precios de la API de Mistral (datos oficiales de octubre de 2026), nivel gratuito, descuentos batch y caché, calculadora de costes, comparativa con GPT, Claude, Gemini y Qwen, y código.
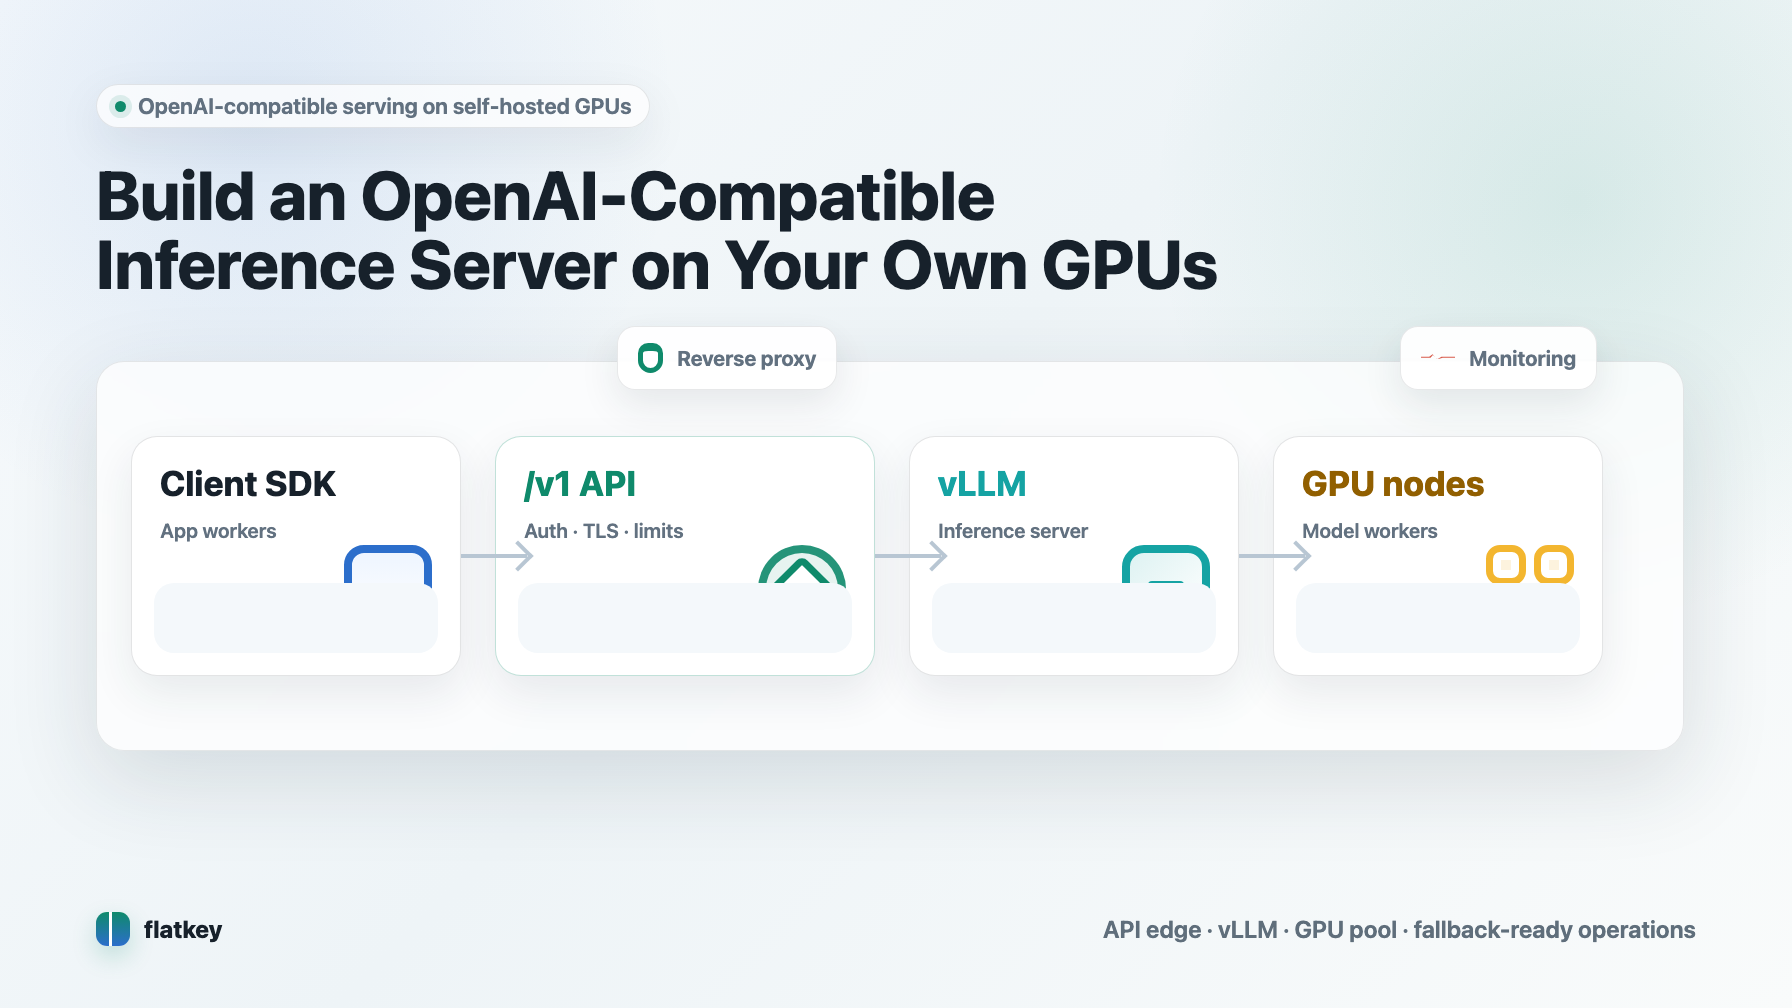
Guía de LLM autoalojados (2026): cuándo compensa, qué hardware necesitas y cómo ofrecer inferencia
Un LLM autoalojado ejecuta modelos de pesos abiertos en GPU que tú controlas. Descubre cuándo sale más barato que una API con tarifas por token (con precios de GPU de octubre de 2026), cómo dimensionar la memoria GPU, qué herramienta de inferencia elegir y cómo desplegar un servidor vLLM compatible con OpenAI con una alternativa de respaldo.
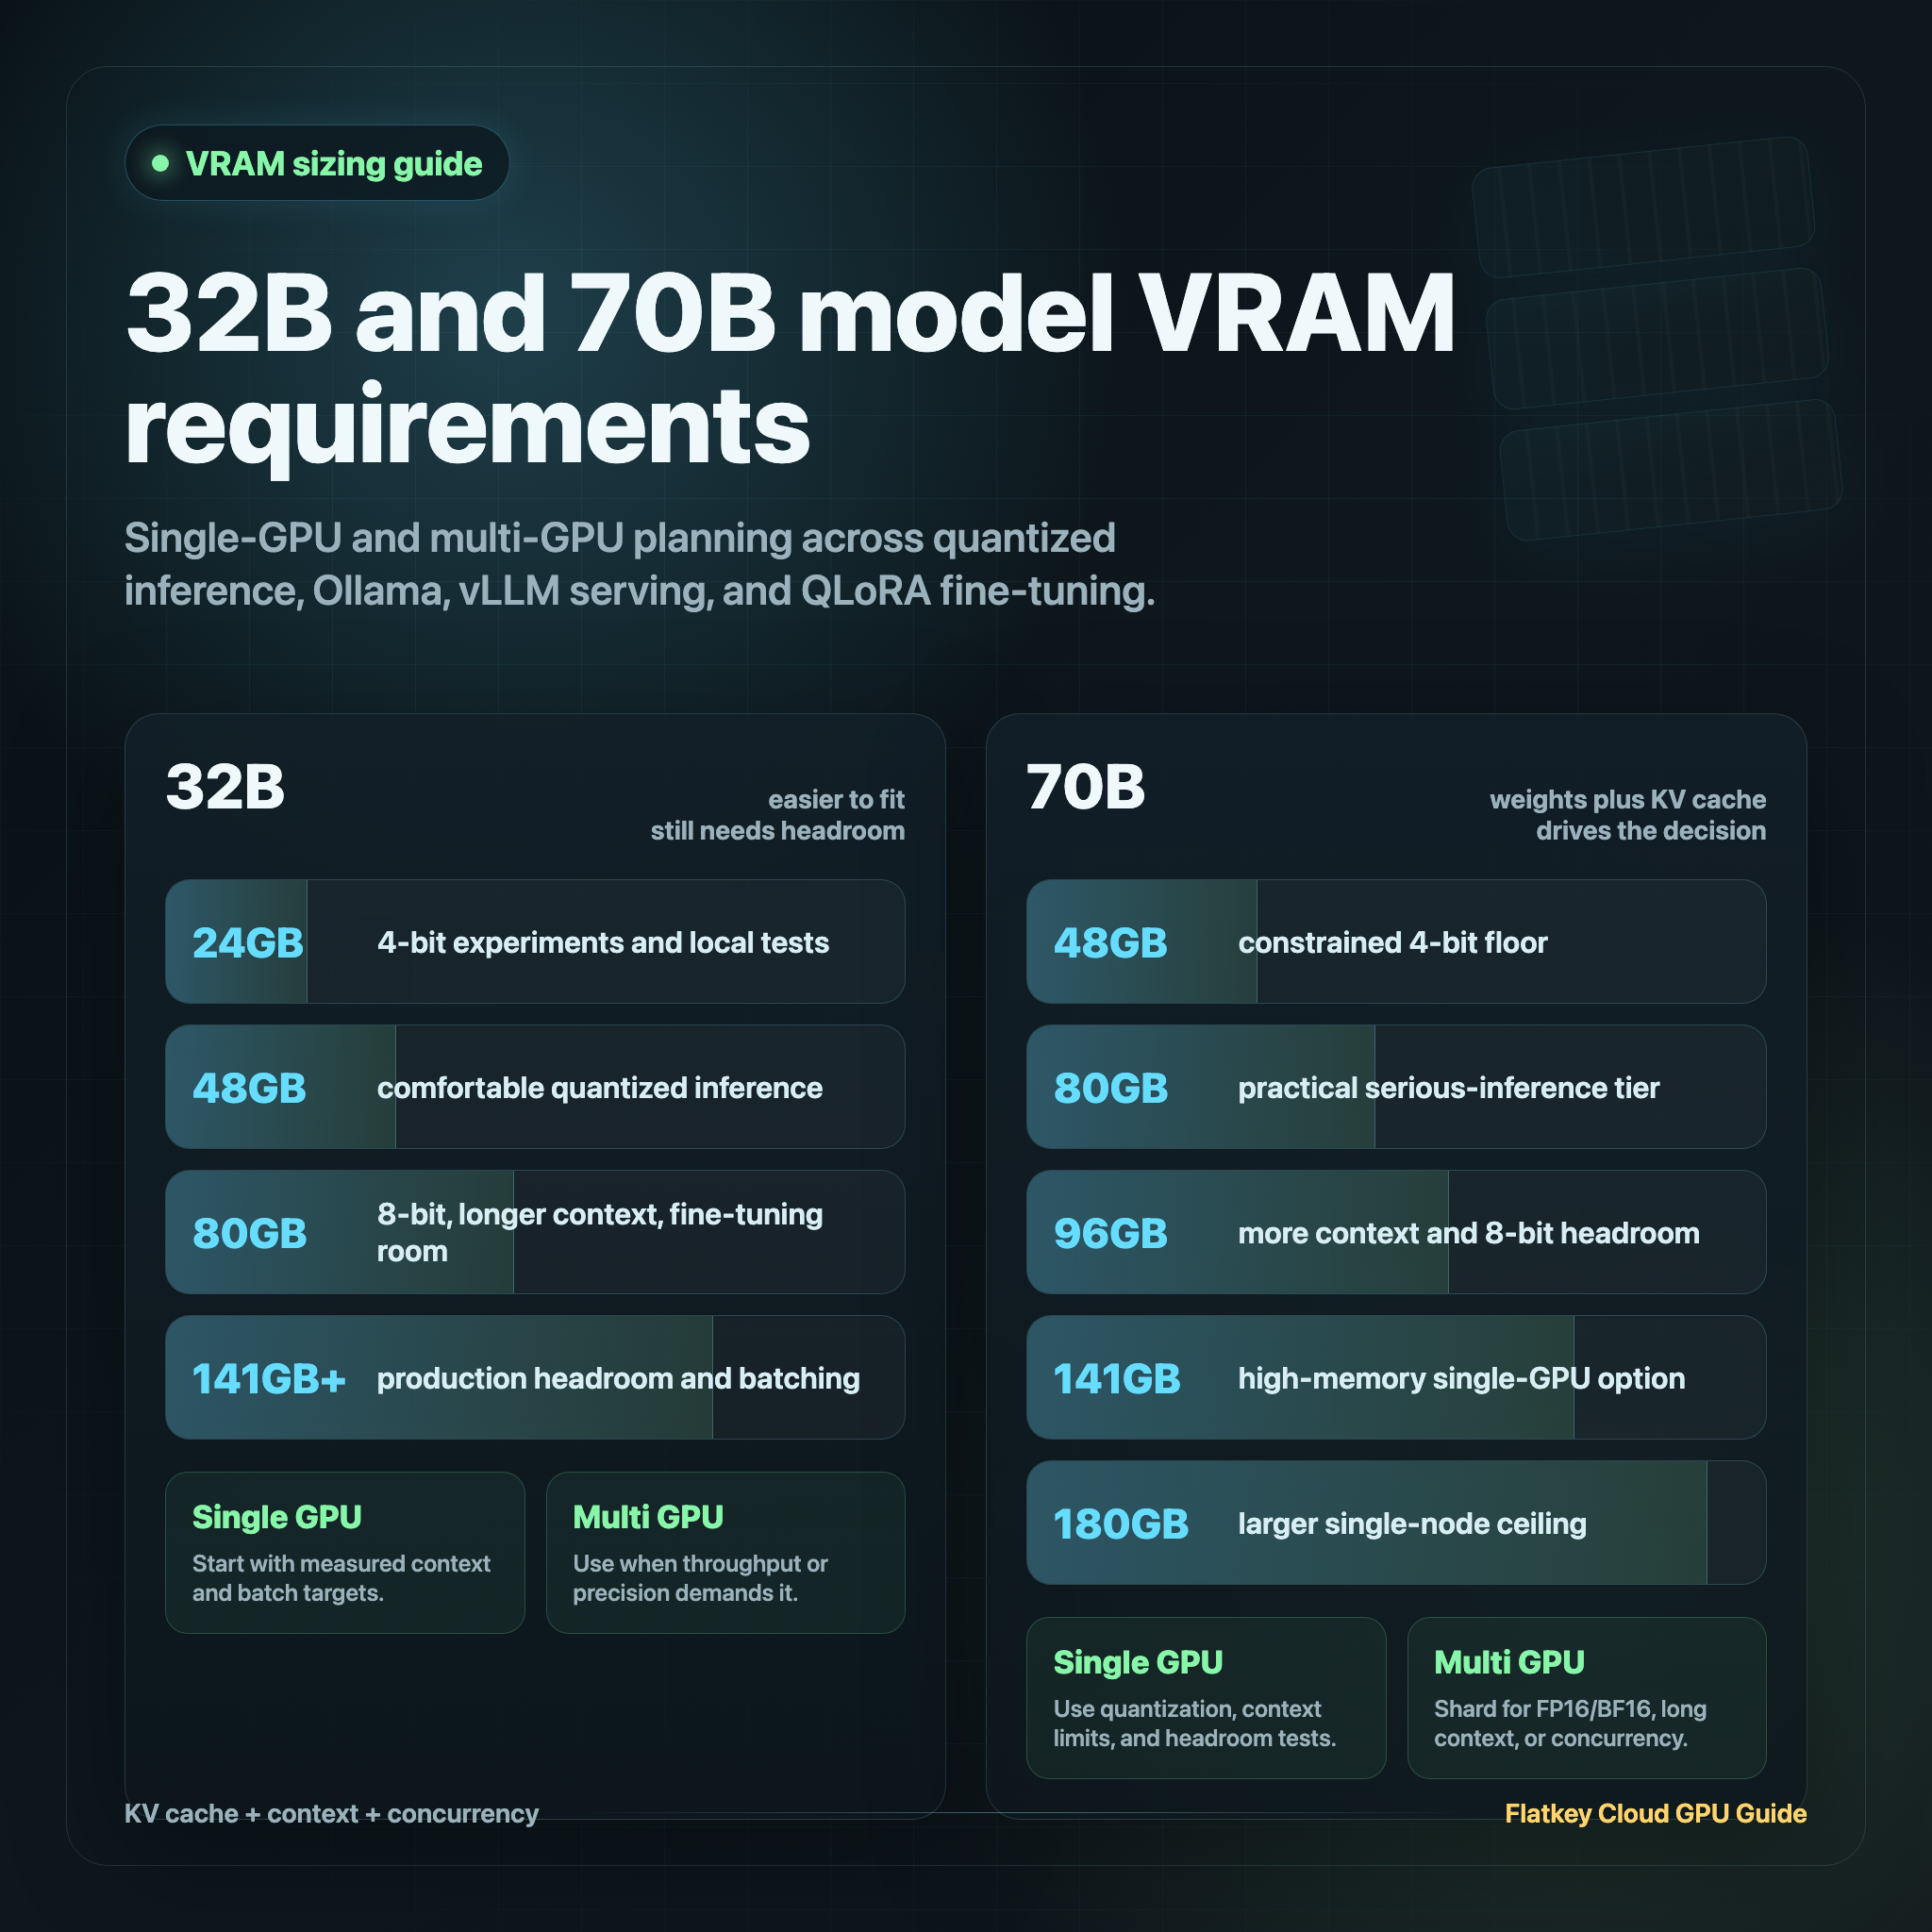
Guía de VRAM para modelos 32B y 70B: opciones con una GPU y con varias GPU
Conoce los requisitos prácticos de VRAM para modelos de 32B y 70B en inferencia 4-bit, 8-bit y FP16/BF16, Ollama, fine-tuning con QLoRA y opciones multi-GPU.
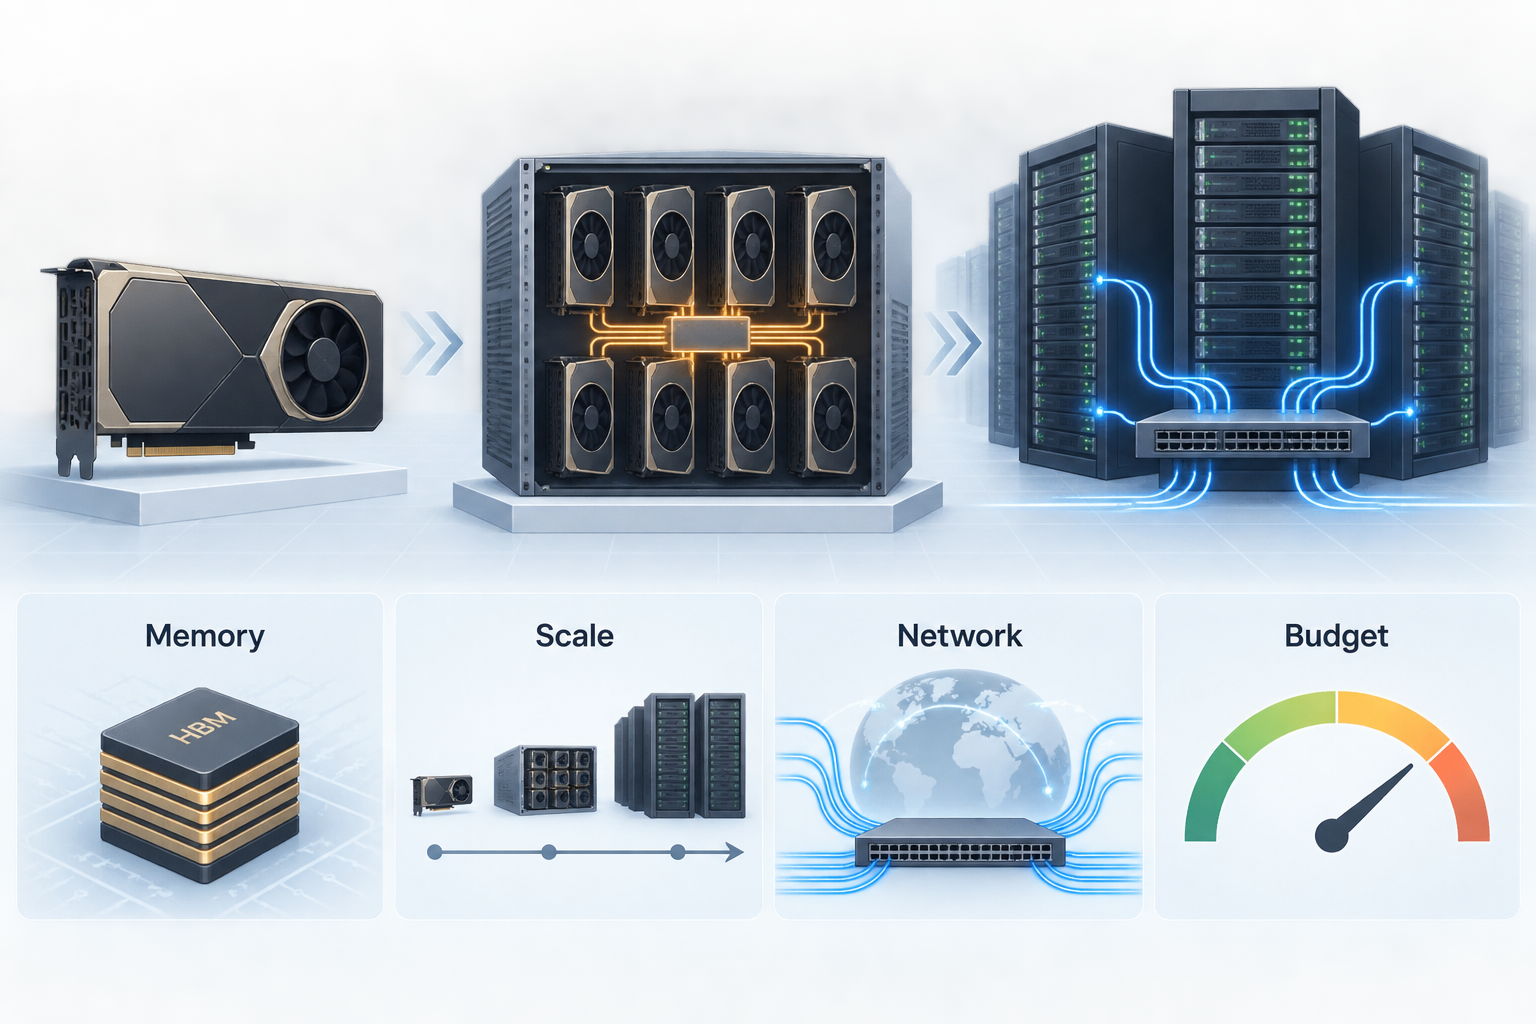
Mejor GPU para entrenamiento de LLM: escala, memoria, redes y presupuesto
Una guía práctica de 2026 para elegir la mejor GPU para entrenamiento de LLM según la escala, la memoria, las redes, la compatibilidad con el proveedor y el costo por checkpoint finalizado.
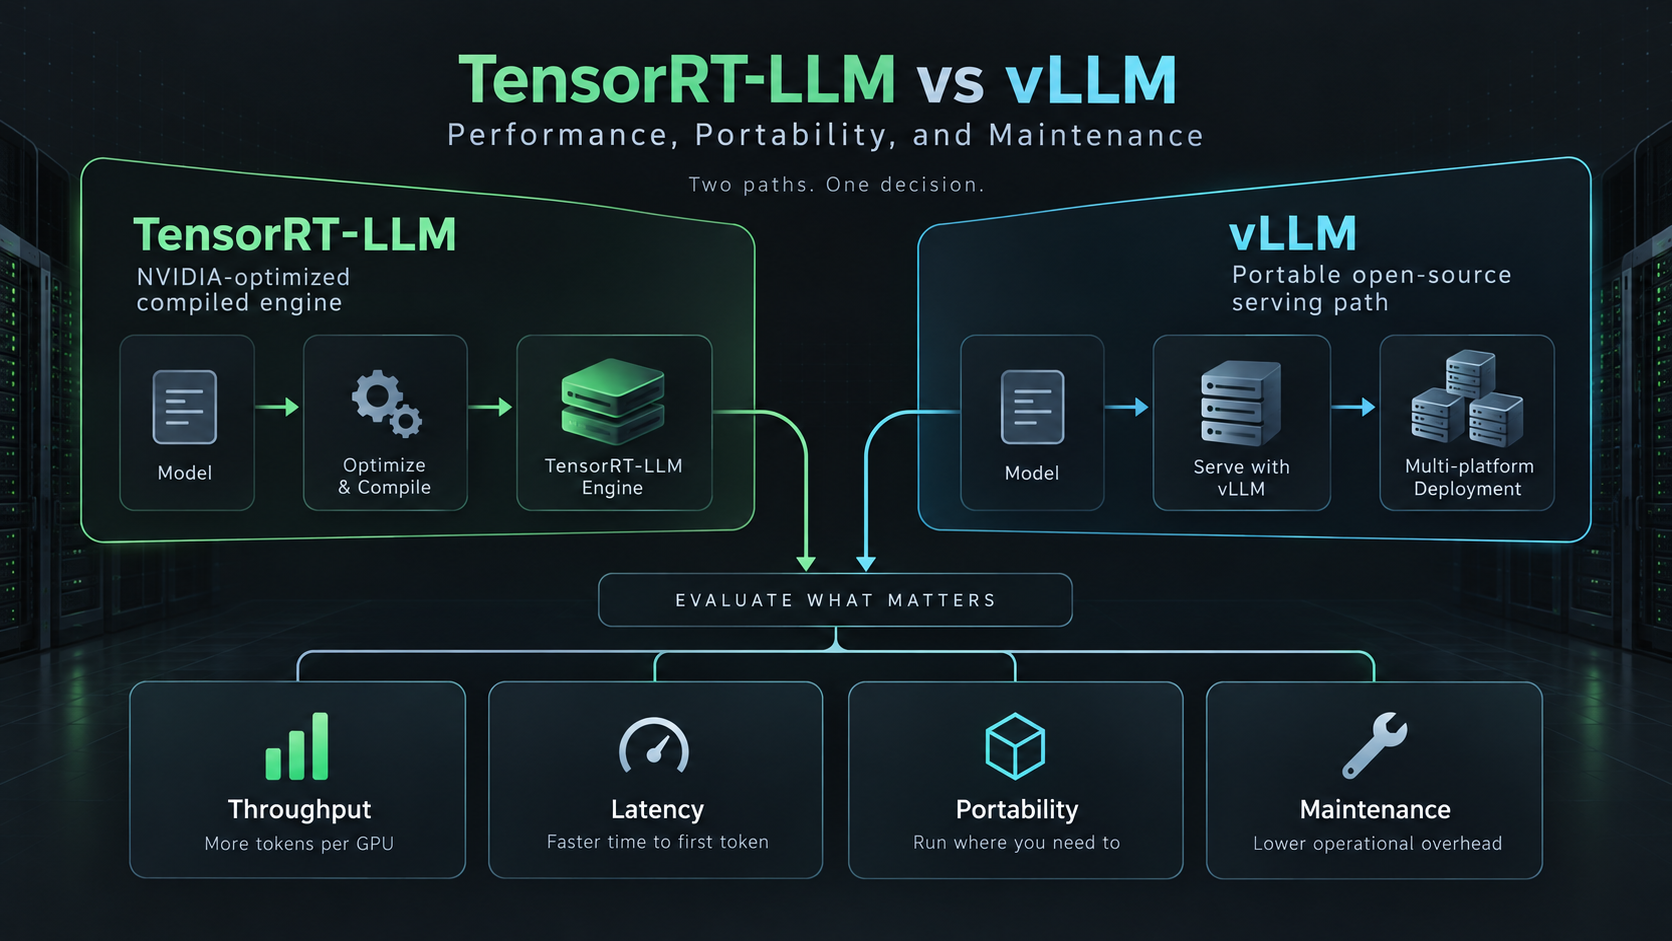
TensorRT-LLM vs vLLM: Rendimiento, portabilidad y mantenimiento
Una comparación práctica de TensorRT-LLM vs vLLM para equipos de infraestructura de IA que eligen un motor de serving de LLM en función del rendimiento, la portabilidad, el mantenimiento y el diseño de benchmarks.
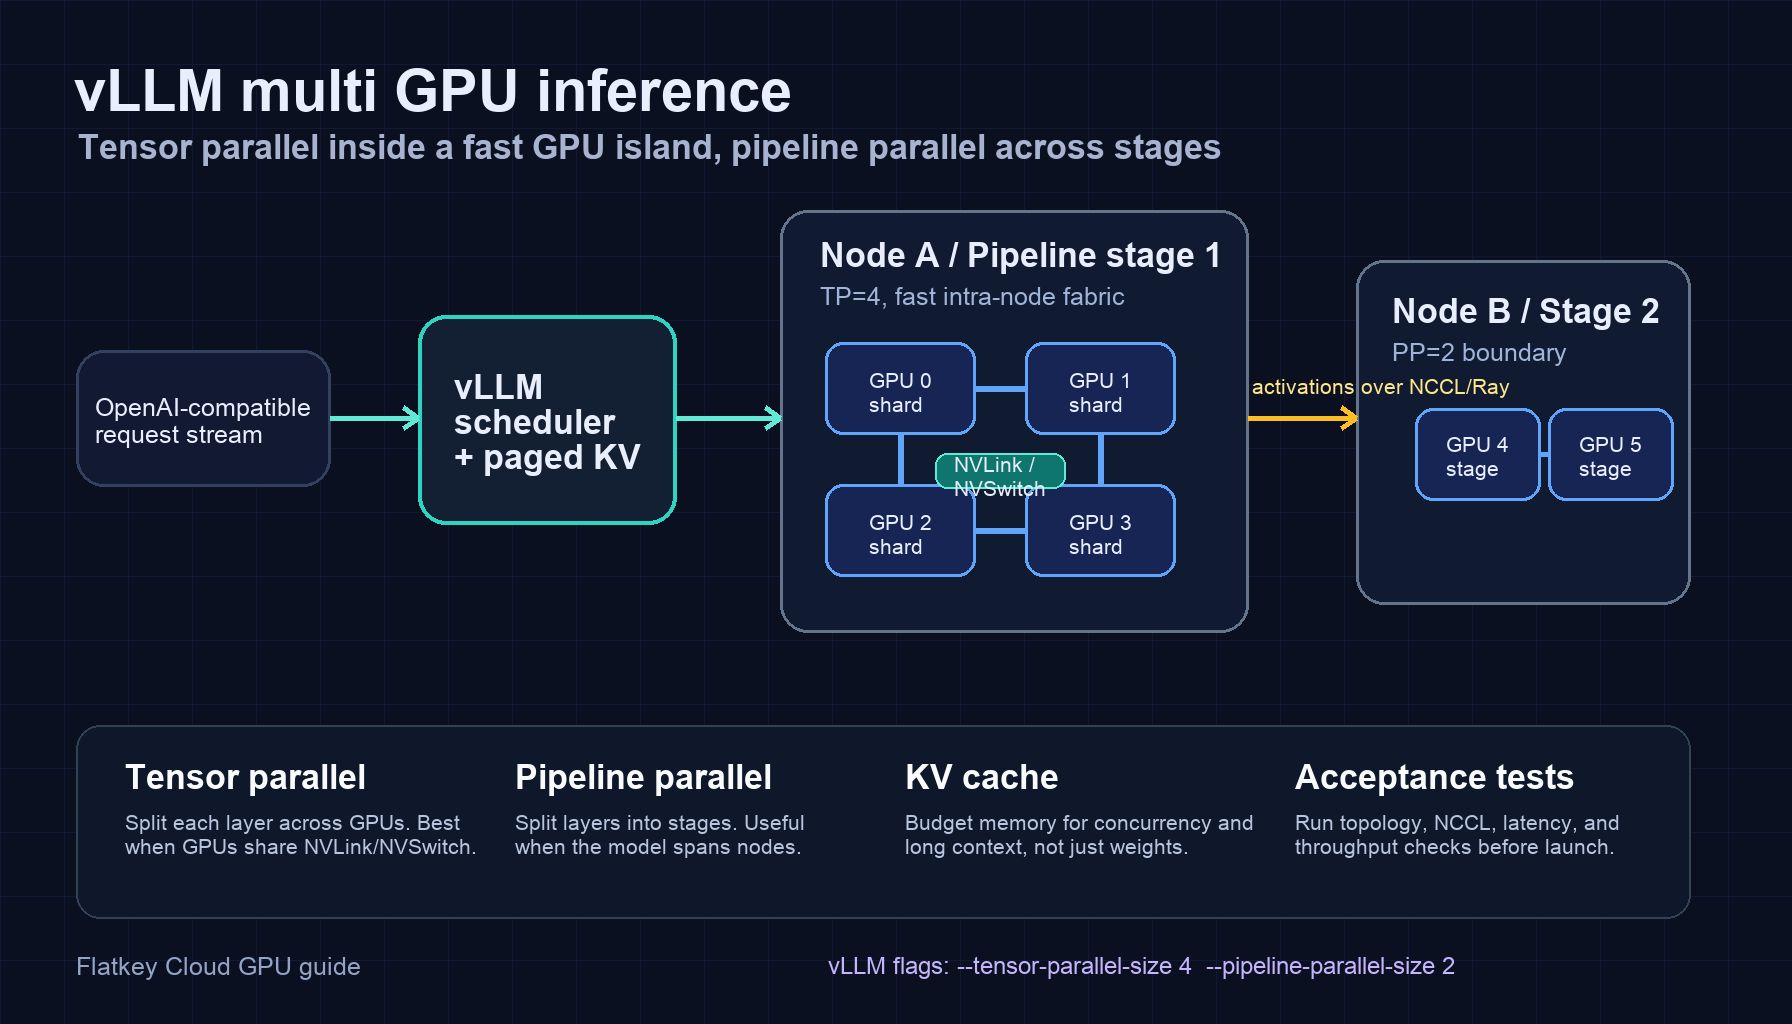
Inferencia multi-GPU de vLLM: configuración de paralelismo tensorial y de canalización
Configura la inferencia multi-GPU con vLLM mediante paralelismo tensorial, paralelismo de canalización, Ray, comprobaciones de topología, ejemplos y pruebas en producción.
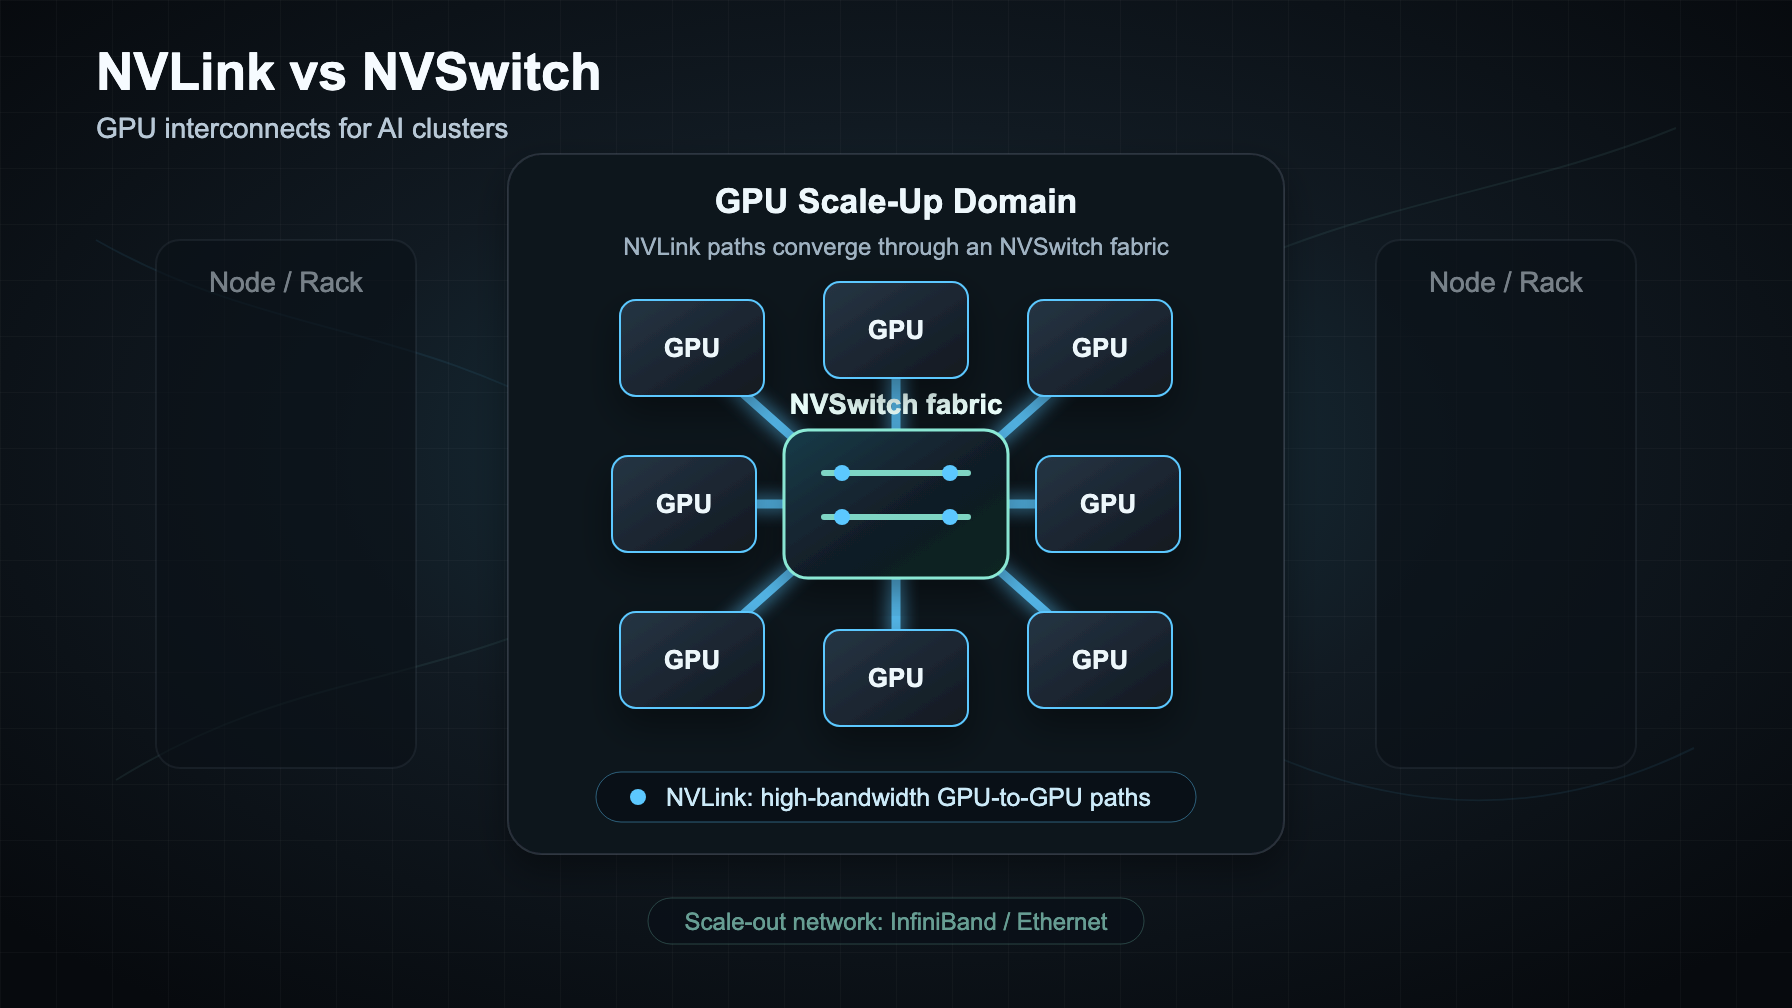
NVLink vs NVSwitch: Interconexiones de GPU explicadas para clústeres de IA
NVLink es el enlace GPU a GPU, NVSwitch es el tejido, e InfiniBand o Ethernet es la red de escalado horizontal. Aquí se explica cómo elegir para clústeres de IA.
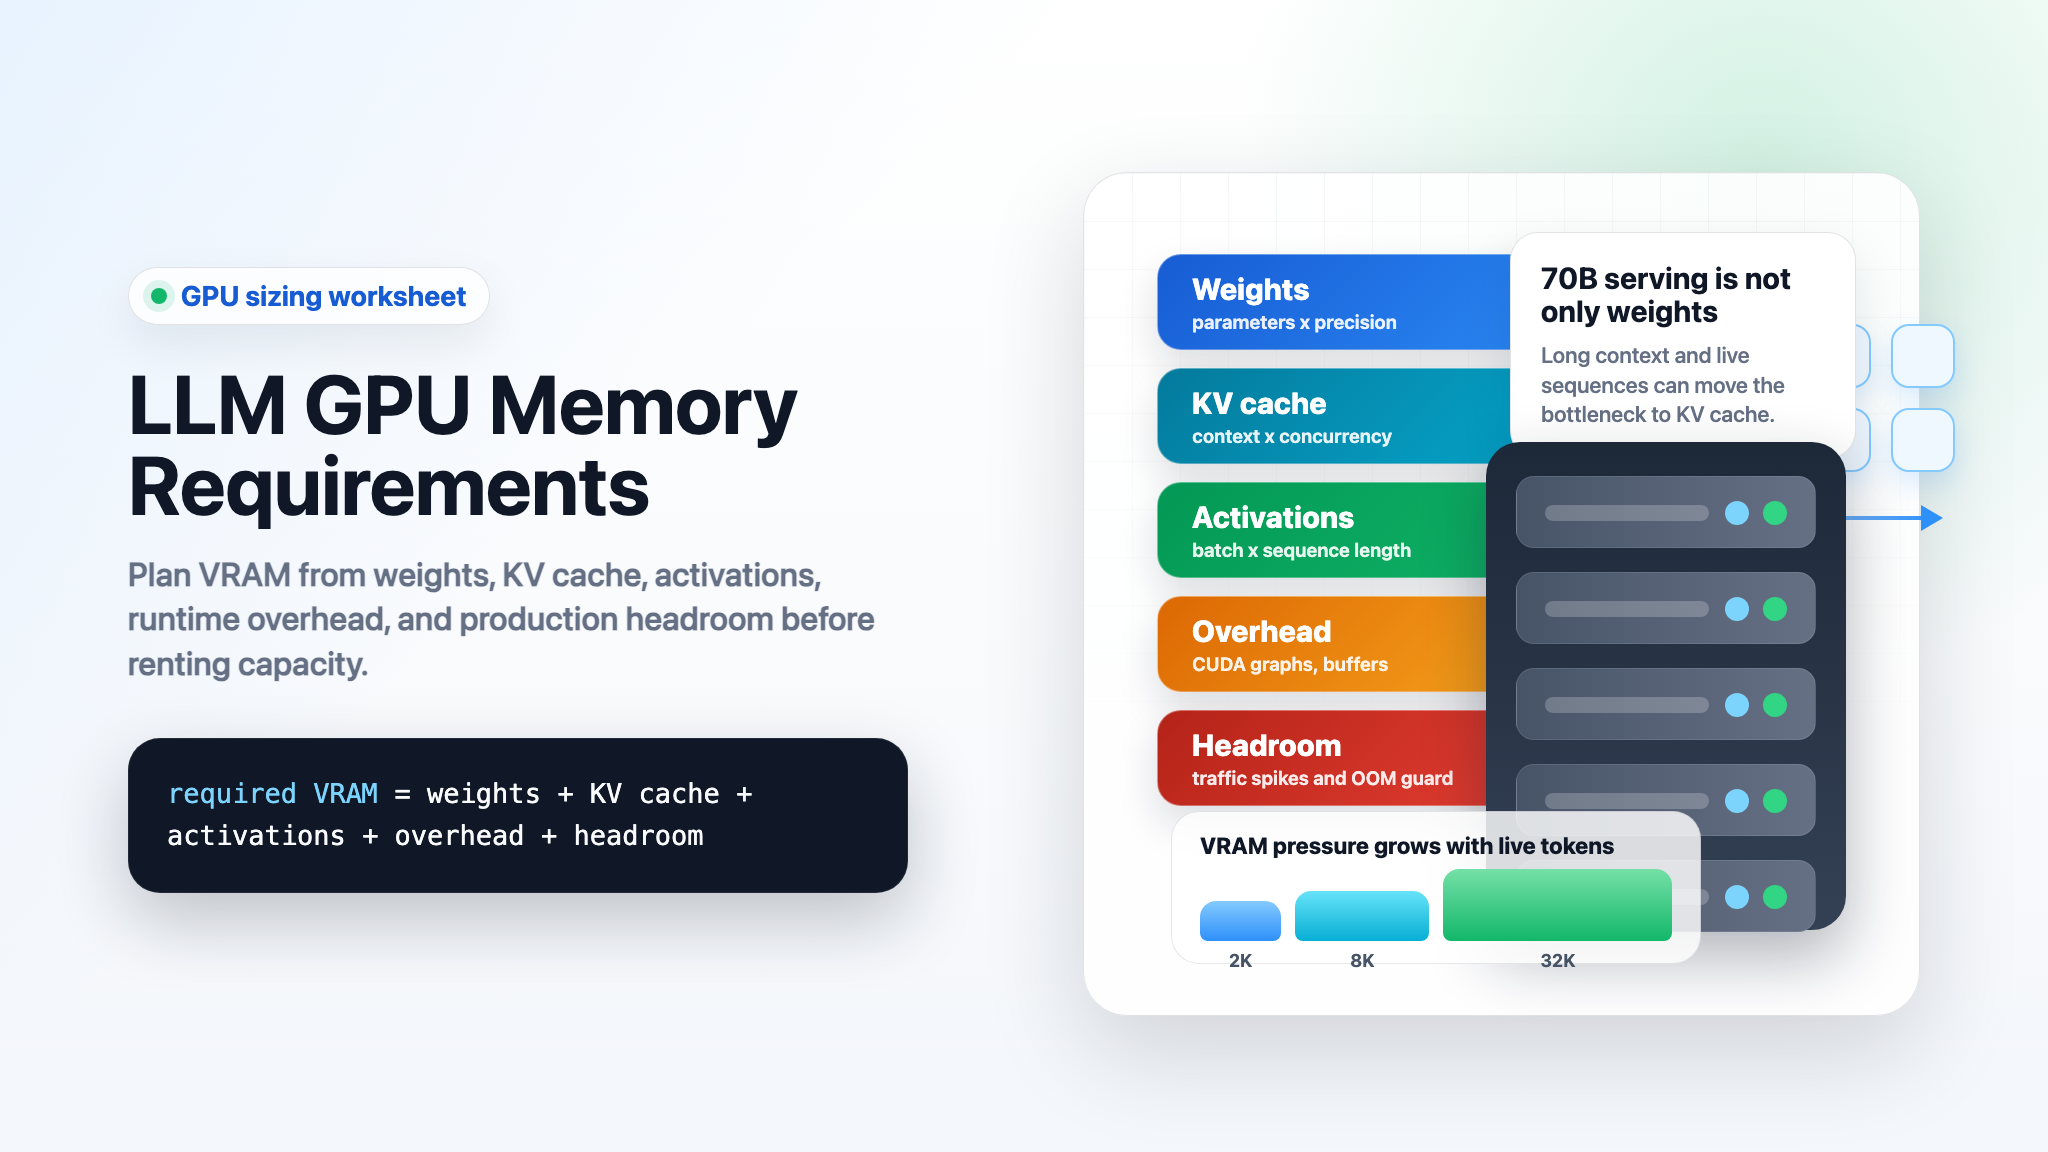
Requisitos de memoria GPU para LLM: pesos, caché KV, activaciones y sobrecarga
Una hoja de trabajo práctica para estimar los requisitos de memoria GPU de LLM en pesos, caché KV, activaciones, sobrecarga de servicio, planificación de vLLM 70B, fine-tuning y entrenamiento.
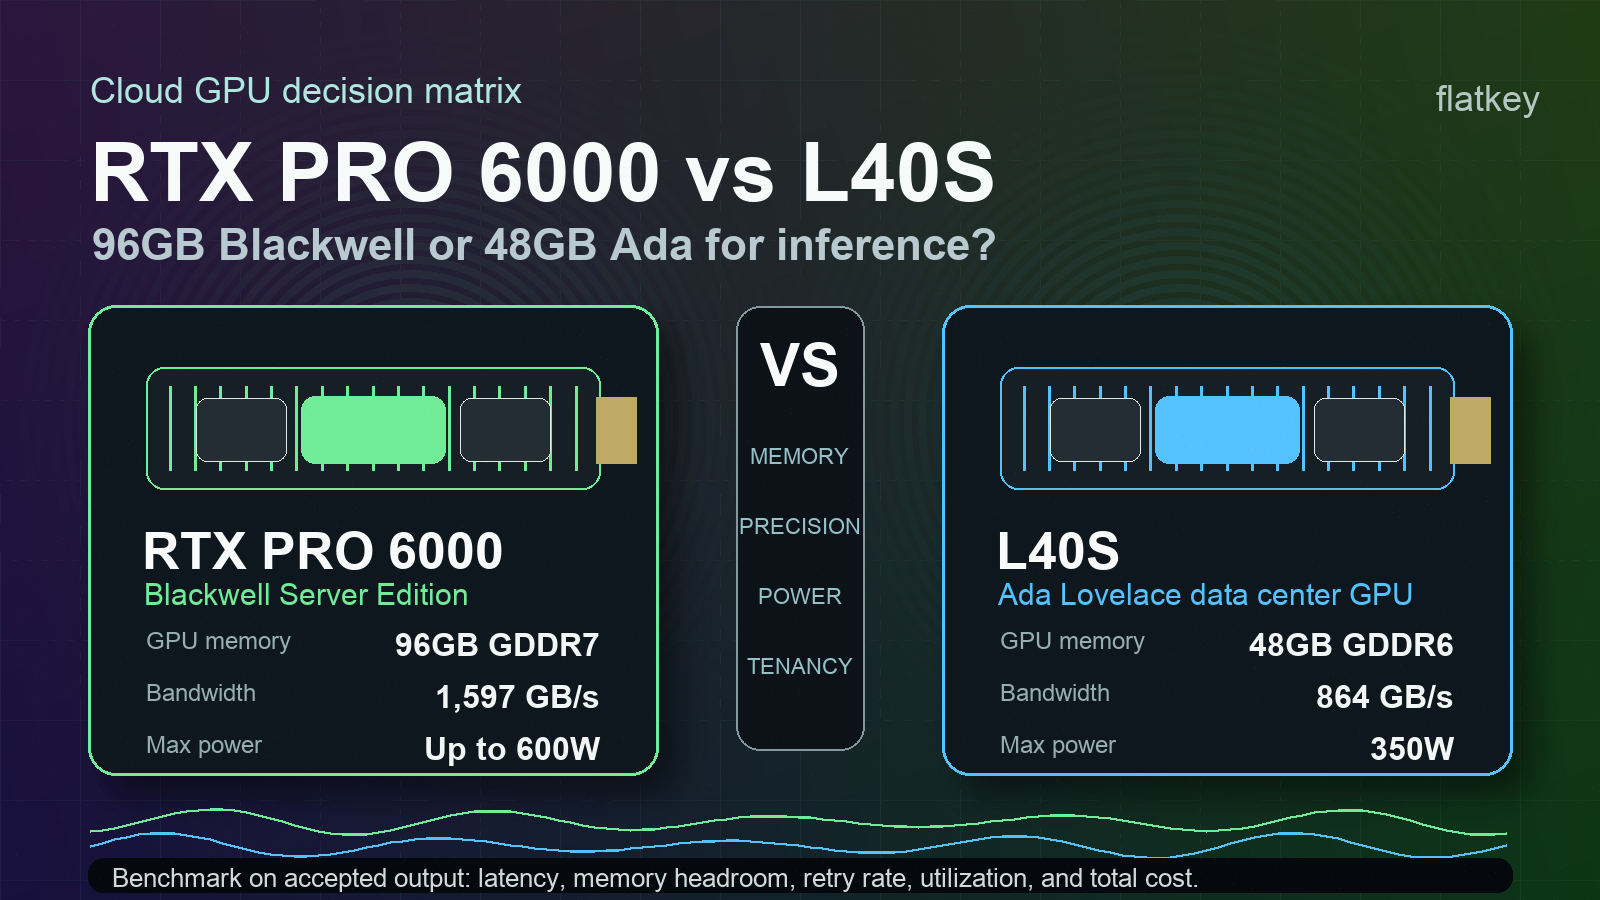
RTX PRO 6000 vs L40S: ¿GPU de inferencia Blackwell de 96 GB o Ada?
Compara NVIDIA L40S vs RTX PRO 6000 Blackwell Server Edition para inferencia de LLM, cargas multimodales, ajuste de memoria, consumo y coste por output aceptado.
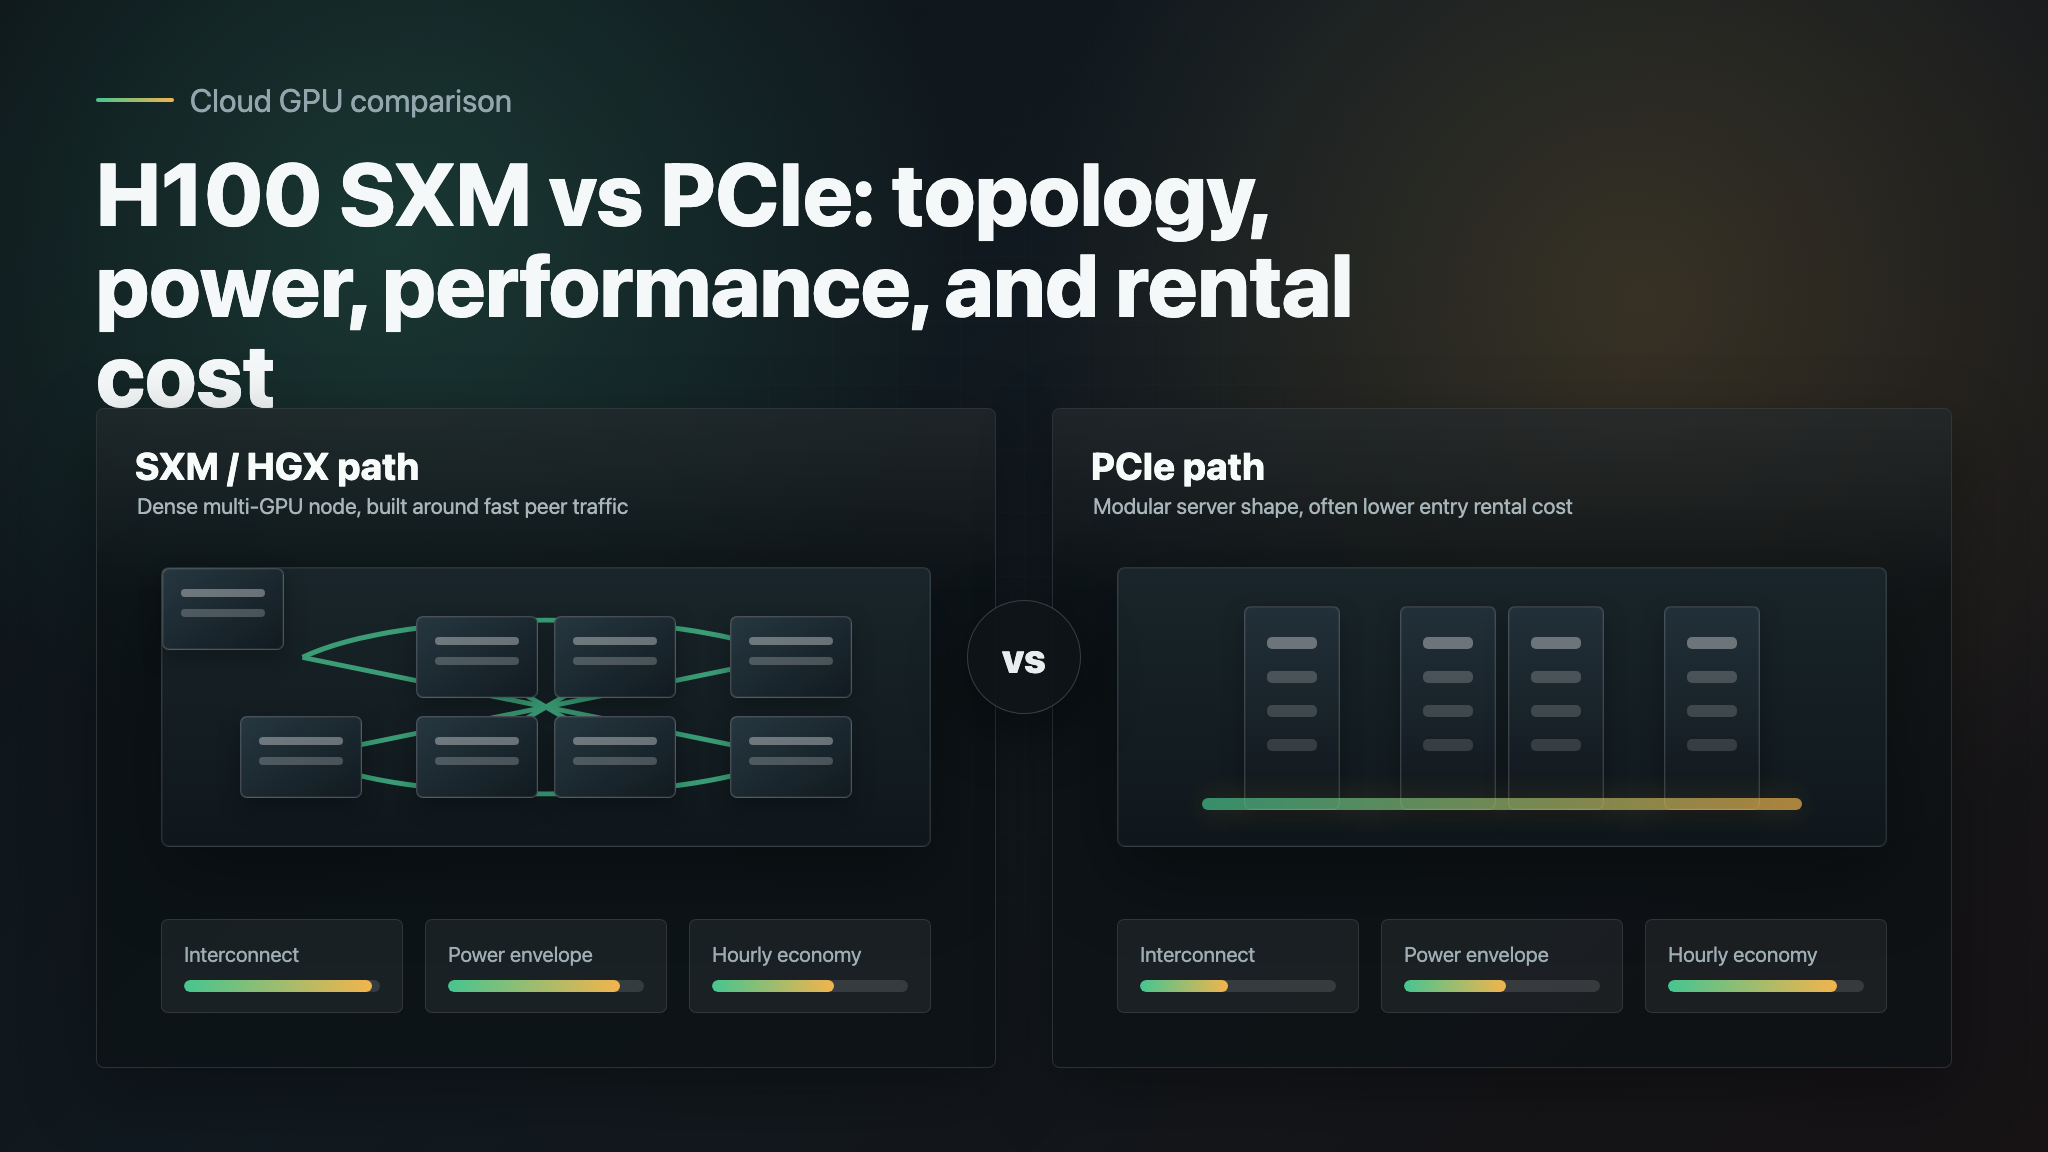
H100 SXM vs PCIe: NVLink, energía, rendimiento y costo de alquiler
Compara H100 PCIe vs SXM en NVLink, consumo de energía, rendimiento de cargas de trabajo y costo de alquiler antes de alquilar GPUs en la nube.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar