
Costes, facturación y operaciones
Últimos artículos en Costes, facturación y operaciones.
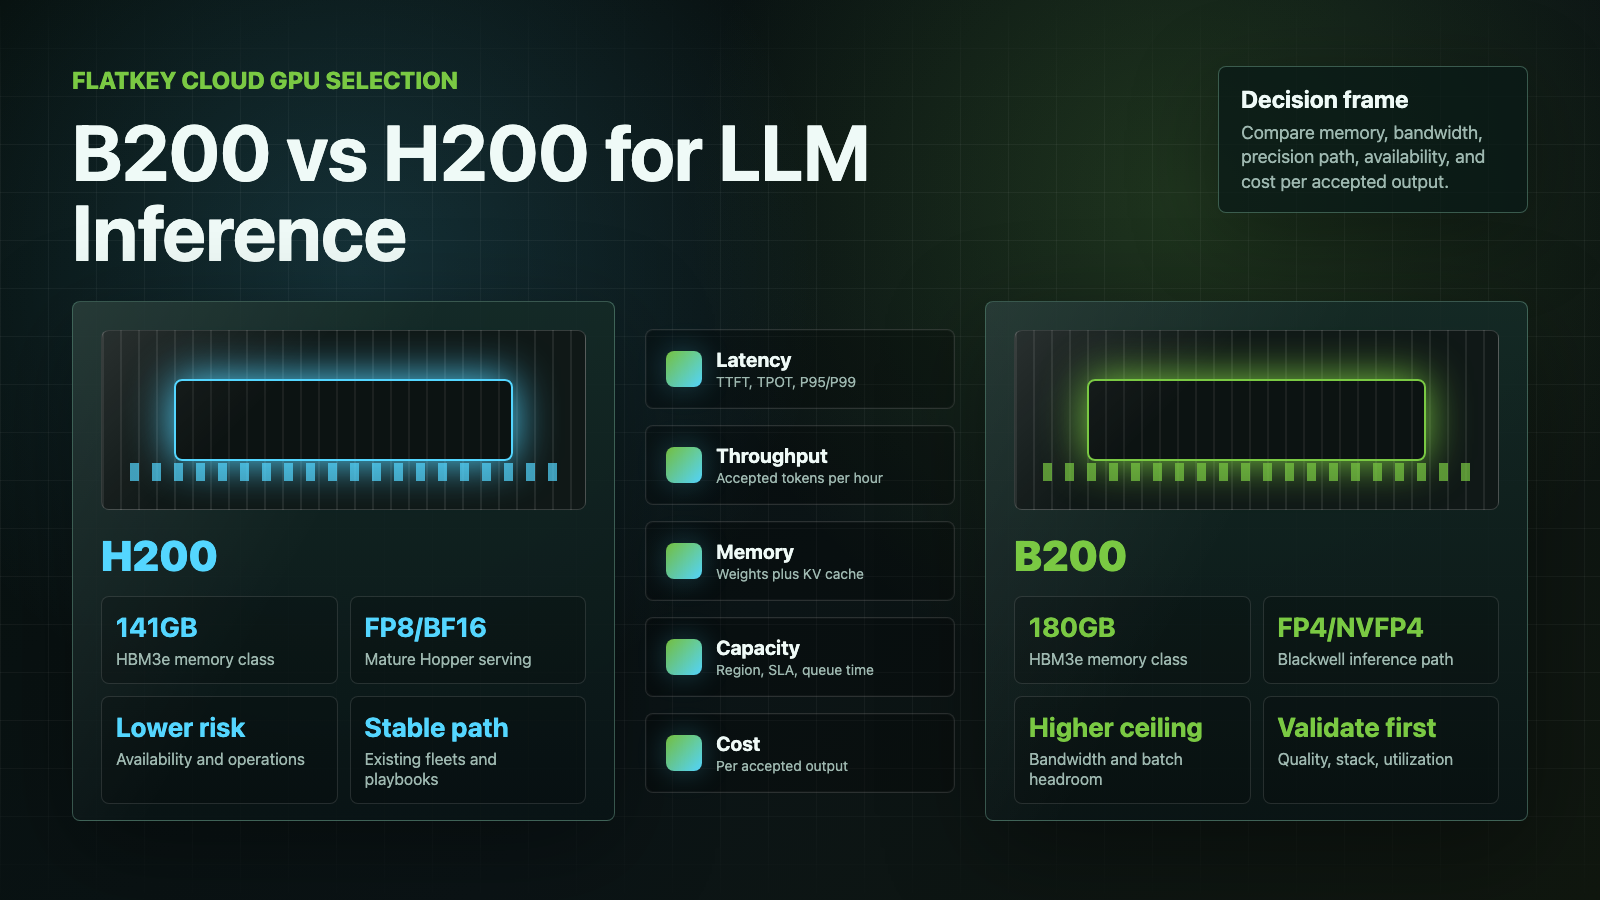
NVIDIA B200 vs H200: ¿Qué GPU es mejor para la inferencia de LLM?
Compara NVIDIA B200 vs H200 para inferencia de LLM por memoria, ancho de banda, soporte de precisión, sistemas DGX, disponibilidad de GPU en la nube y costo por salida aceptada.
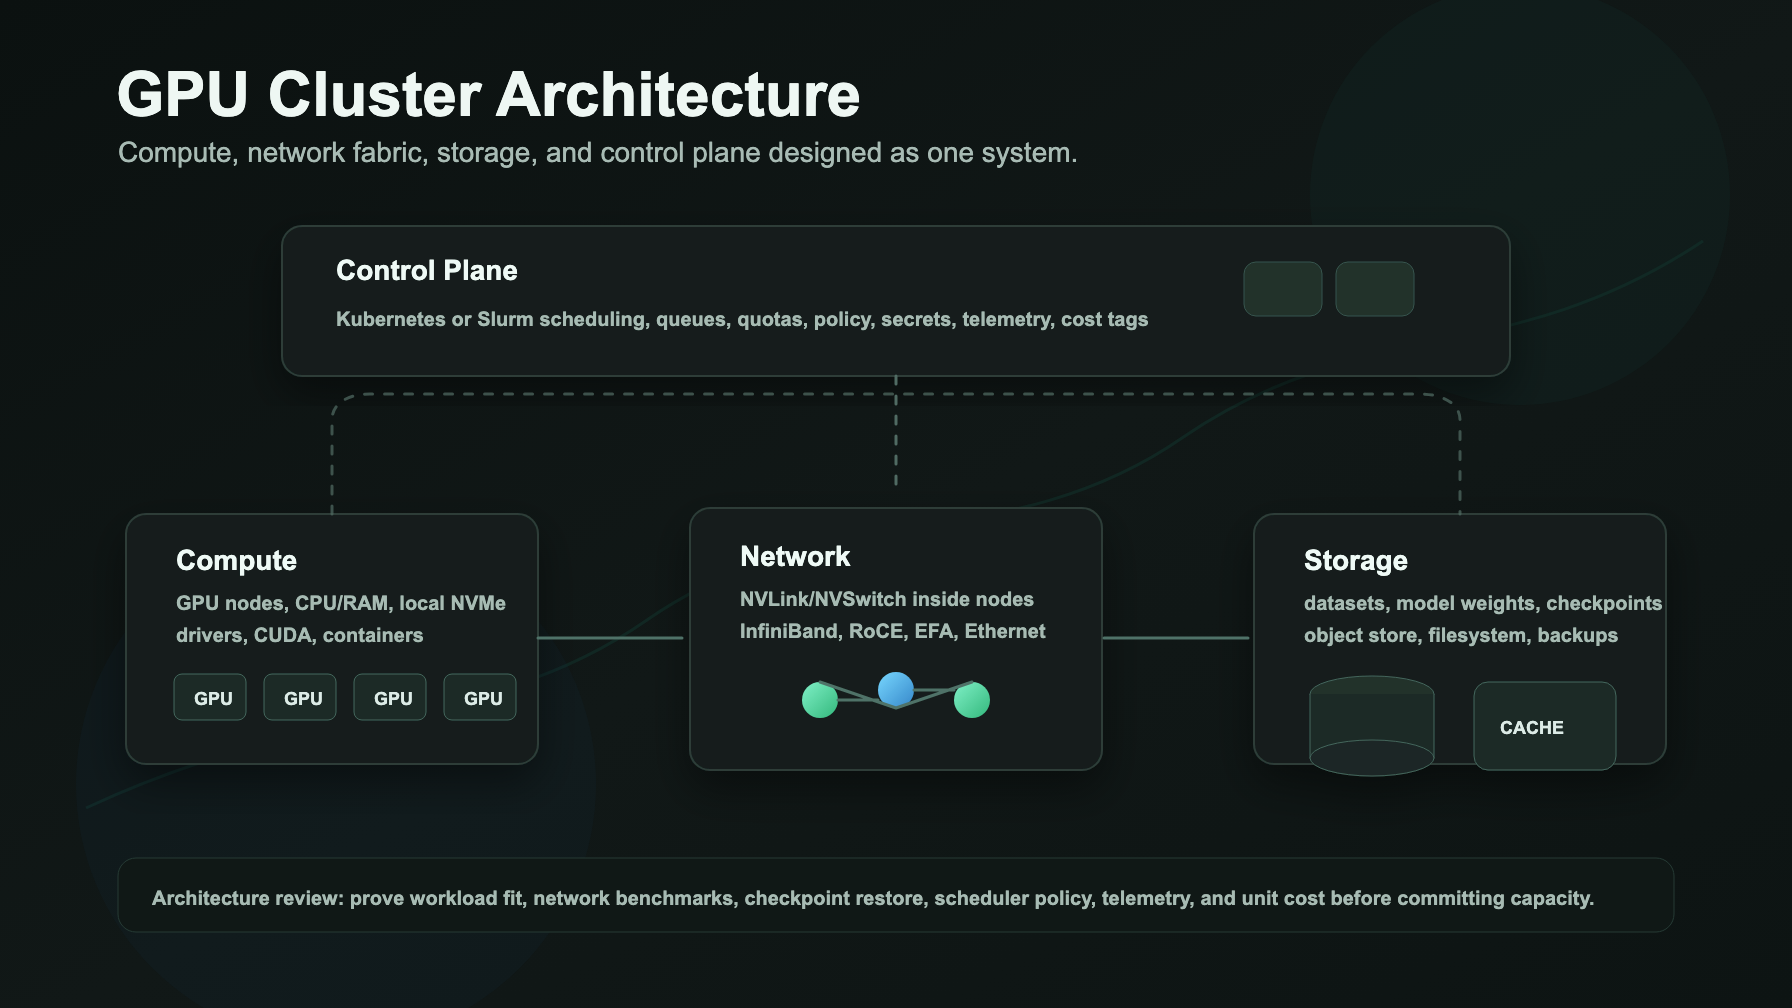
Arquitectura de clúster GPU: cómputo, red, almacenamiento y plano de control
Una guía práctica de arquitectura de clúster GPU para nodos de cómputo, tejido de red, almacenamiento, plano de control de Kubernetes o Slurm, observabilidad y pruebas de aceptación.
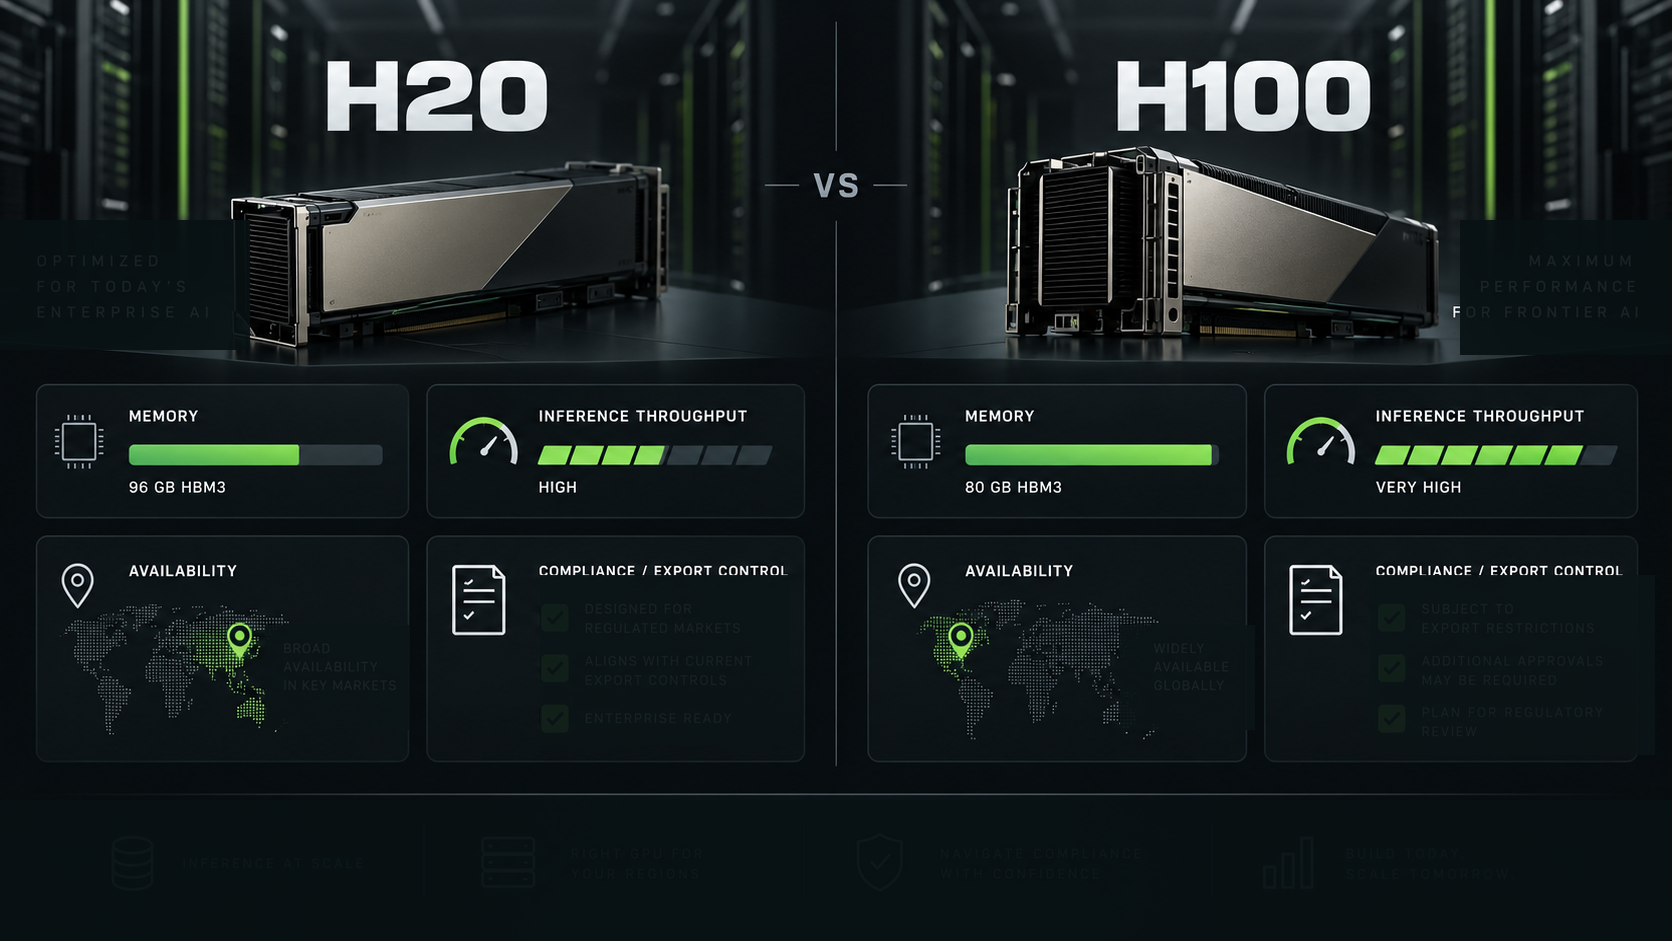
NVIDIA H20 vs H100: inferencia, memoria, disponibilidad y cumplimiento
Una comparación práctica entre H20 y H100 para equipos de IA empresariales, que cubre inferencia, memoria, disponibilidad, riesgo de control de exportaciones y cuándo H200 o las APIs de modelos son mejores referencias.
Mejores plataformas de alquiler de GPU en la nube 2026: precio, capacidad, red y soporte
Una selección práctica de 2026 de plataformas de nube GPU para equipos de IA, comparando precio, capacidad, red, soporte y cuándo una API de modelo es la mejor base.
NVIDIA Blackwell Ultra B300: ¿Qué cambió respecto al B200?
Un seguimiento práctico de NVIDIA B300 Blackwell Ultra para equipos de infraestructura de IA, comparando especificaciones del B300, estado de lanzamiento, advertencias sobre el precio y compatibilidad de cargas de trabajo frente al B200.
AMD MI455X y Helios: rastreador de arquitectura, memoria y disponibilidad
Un rastreador orientado al comprador para AMD MI455X y Helios que cubre arquitectura, memoria HBM4, ancho de banda, disponibilidad, preparación para vLLM, dudas sobre proveedores y estrategia de respaldo de modelos/API.
GPU NVIDIA Vera Rubin: rastreador de GPU, NVL72, memoria, redes y disponibilidad
Un rastreador actualizado de las especificaciones de la GPU NVIDIA Vera Rubin, DGX Vera Rubin NVL72, memoria HBM4, redes e hitos de disponibilidad para compradores de GPU en la nube.
Precios de la API de imágenes de OpenAI: tarifas de GPT Image 2.5, fórmula de coste y controles de presupuesto
Aprende cómo funciona el precio de la API de imágenes de OpenAI para GPT Image 2.5, incluidas las tarifas por token, las reglas de entrada en caché, las imágenes parciales, Batch y el coste por imagen aceptada.
GB200 vs B200: ¿superchip Grace Blackwell o HGX x86?
Compara GB200 vs B200 para la adquisición de infraestructura de IA: sistemas Grace Blackwell NVL72 a escala de rack, nodos B200 HGX/x86, benchmarks y comprobaciones de TCO.
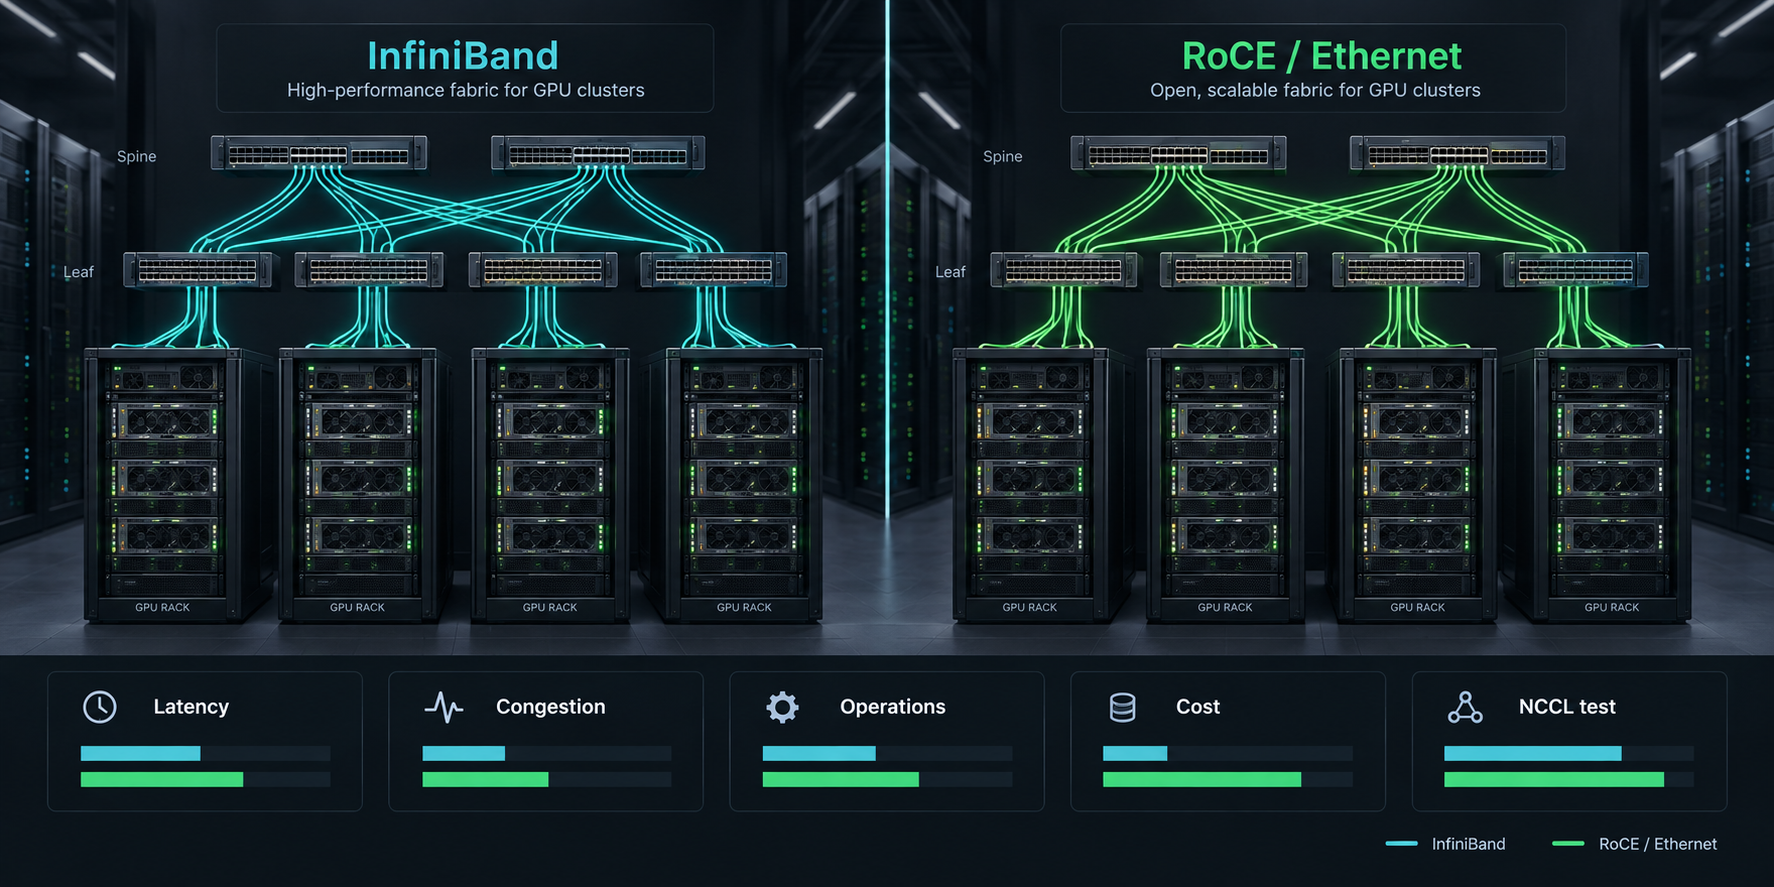
RoCE vs InfiniBand para clústeres de GPU: latencia, operaciones y coste
Compara RoCE e InfiniBand para clústeres de GPU multinodo con una matriz práctica de decisión, una prueba de aceptación de NCCL, un modelo de costes y una lista de verificación de compras.
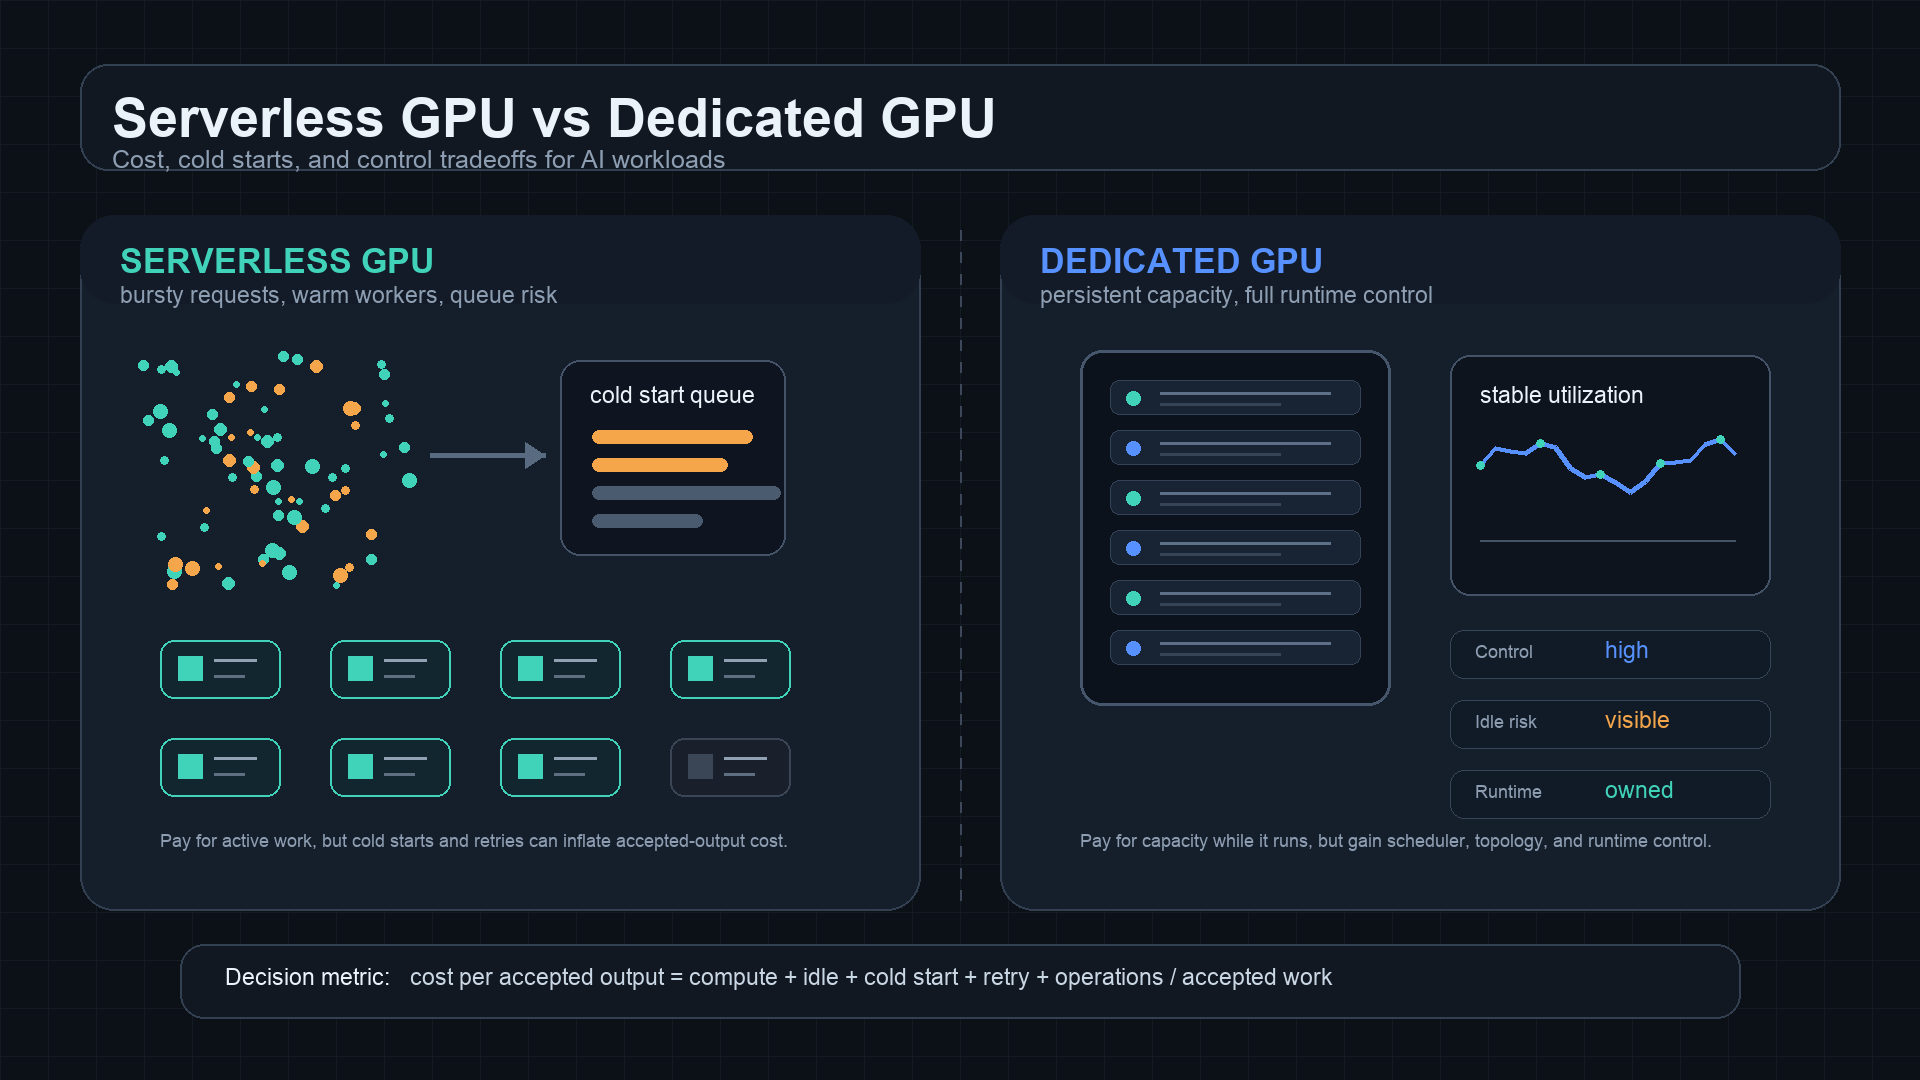
GPU sin servidor vs GPU dedicada: costo, tiempos de arranque en frío y control
Compara GPU sin servidor vs GPU dedicada por costo por salida aceptada, arranques en frío, capacidad ociosa, escalado automático y control operativo.

Comparación de precios de API de generación de imágenes con IA: GPT Image, Gemini, Imagen y fal
Compara los precios de API de generación de imágenes entre GPT Image, Gemini Image, Imagen y fal, normalizando las unidades de facturación en costo por imagen aceptada.
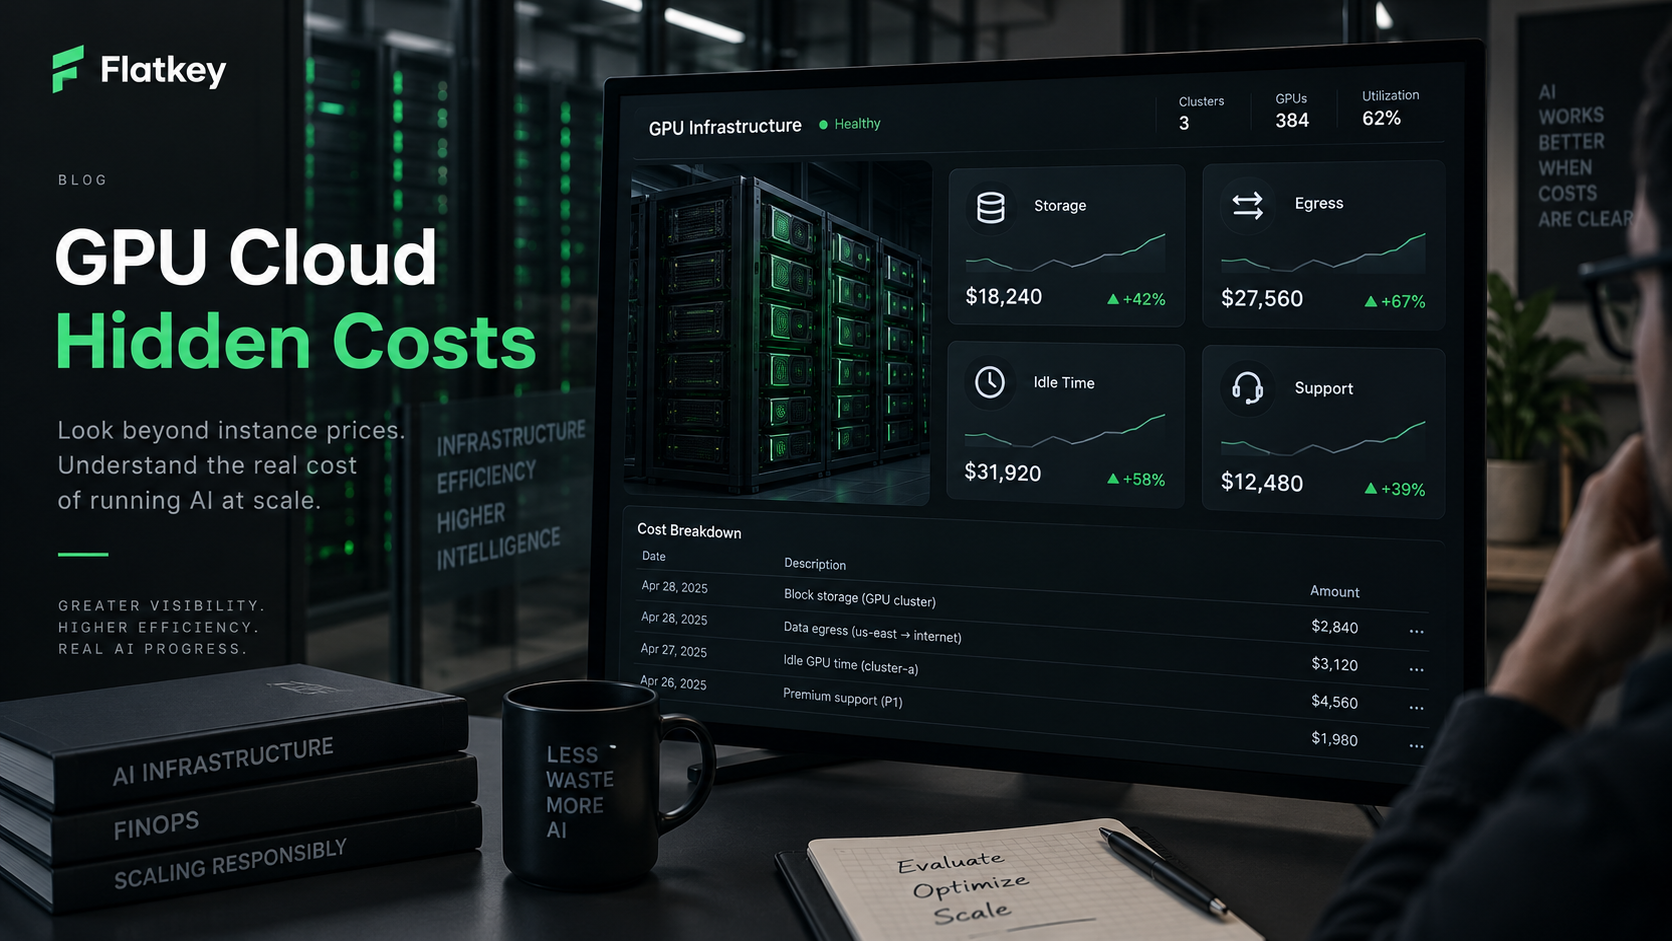
¿Cuáles son los costos ocultos de los servicios de GPU en la nube? Almacenamiento, salida de datos, tiempo inactivo y soporte
Una guía práctica de TCO para GPU en la nube para identificar costos de almacenamiento, salida de datos, tiempo inactivo, trabajos fallidos, soporte, redes y operaciones antes de que llegue la factura.
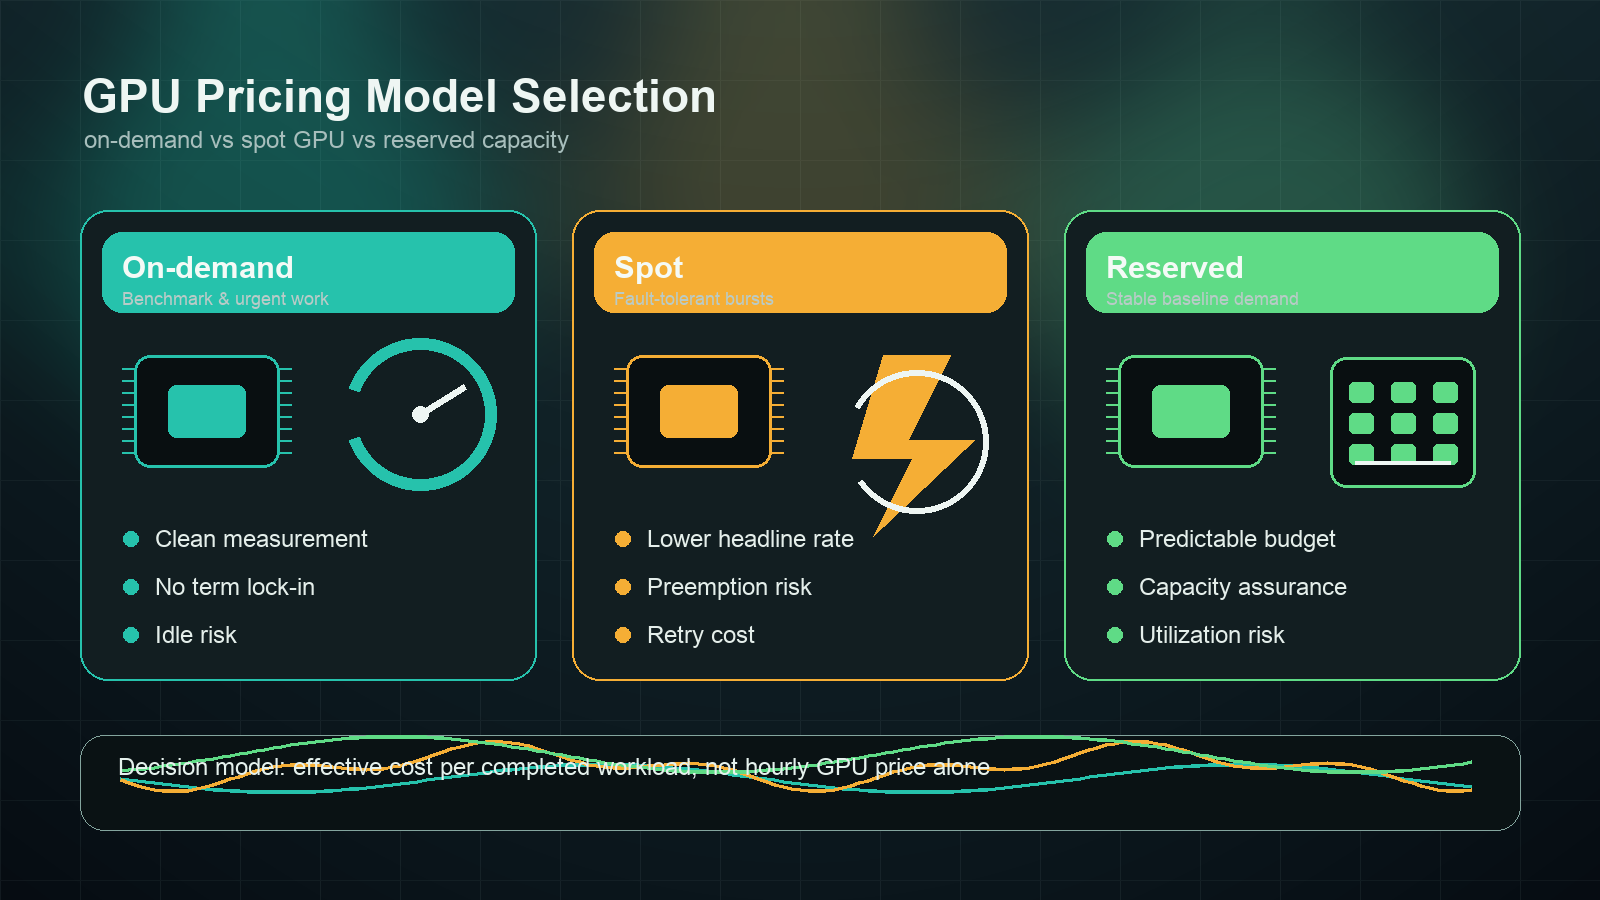
Precios de GPU bajo demanda vs spot vs reservados: ¿qué modelo se adapta a tu carga de trabajo?
Un marco basado en la carga de trabajo para elegir capacidad de GPU bajo demanda, spot o reservada sin confundir la tarifa horaria publicada con el costo de la carga de trabajo completada.
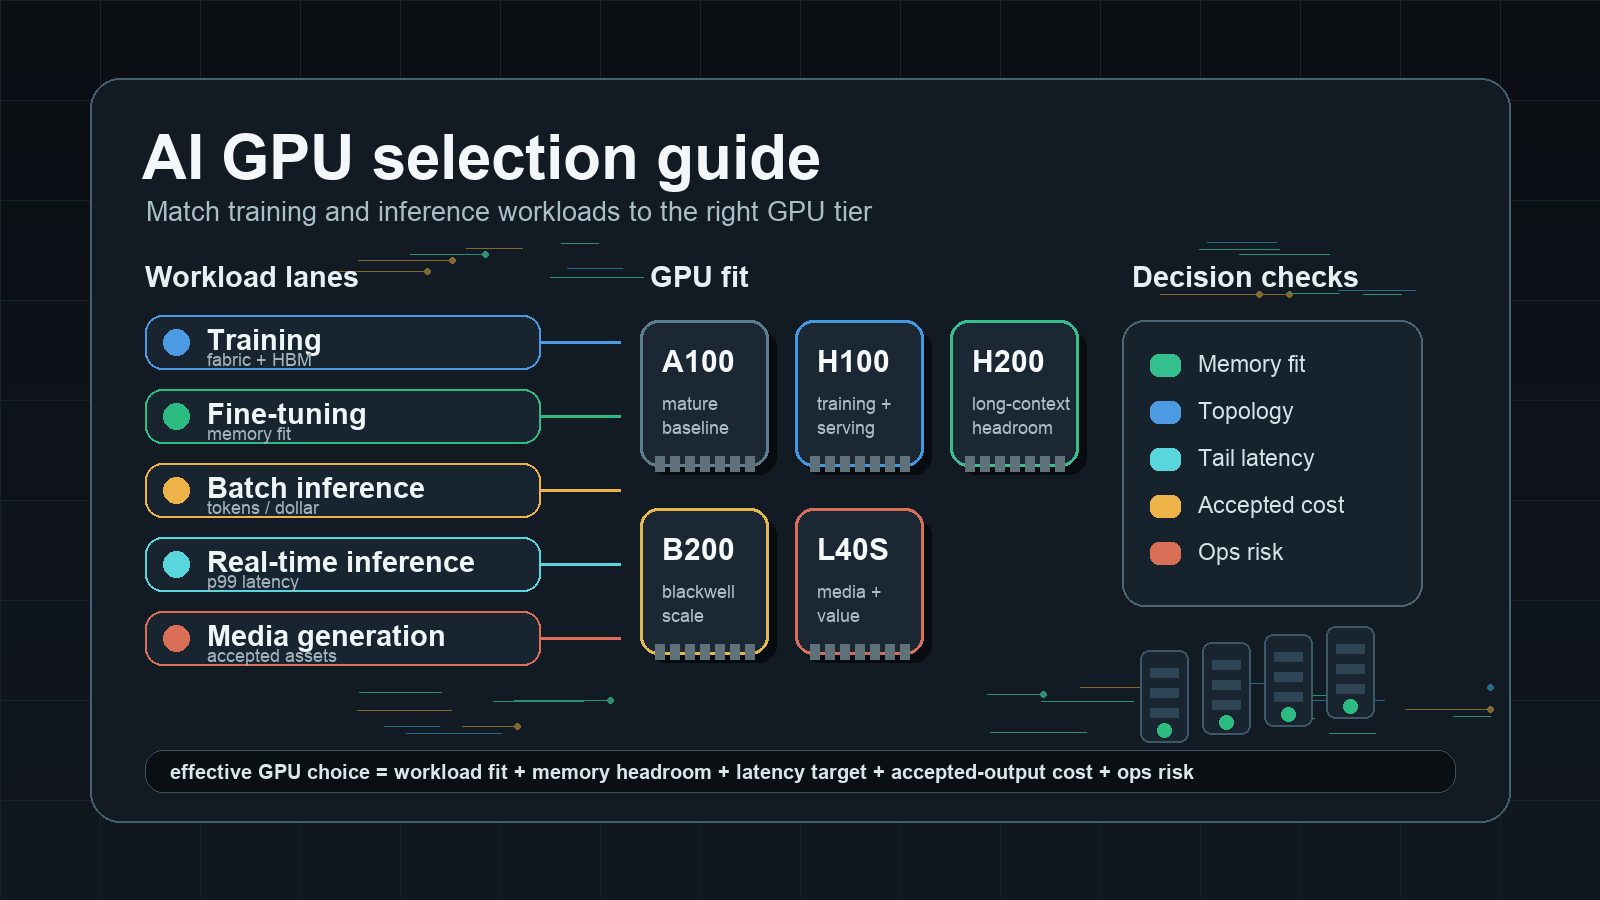
Guía de selección de GPU para IA: adapta las cargas de trabajo de entrenamiento e inferencia a la GPU adecuada
Una guía práctica de selección de GPU para IA para equipos que asignan cargas de trabajo de entrenamiento, ajuste fino, inferencia de LLM, generación de contenido multimedia y evaluación a la GPU y al modelo de capacidad adecuados.
Nube privada de GPU: arquitectura, aislamiento y modelo operativo
Aprende a evaluar la arquitectura de una nube privada de GPU, el aislamiento, la propiedad del scheduler, la evidencia de seguridad, el modelo operativo, el TCO y las pruebas de aceptación.

Guía de despliegue de vLLM: sirve una API de LLM compatible con OpenAI en GPUs
Despliega vLLM como una API compatible con OpenAI en GPUs con Docker, RunPod Serverless, Ray Serve, métricas, controles de despliegue y comprobaciones de coste por salida aceptada.
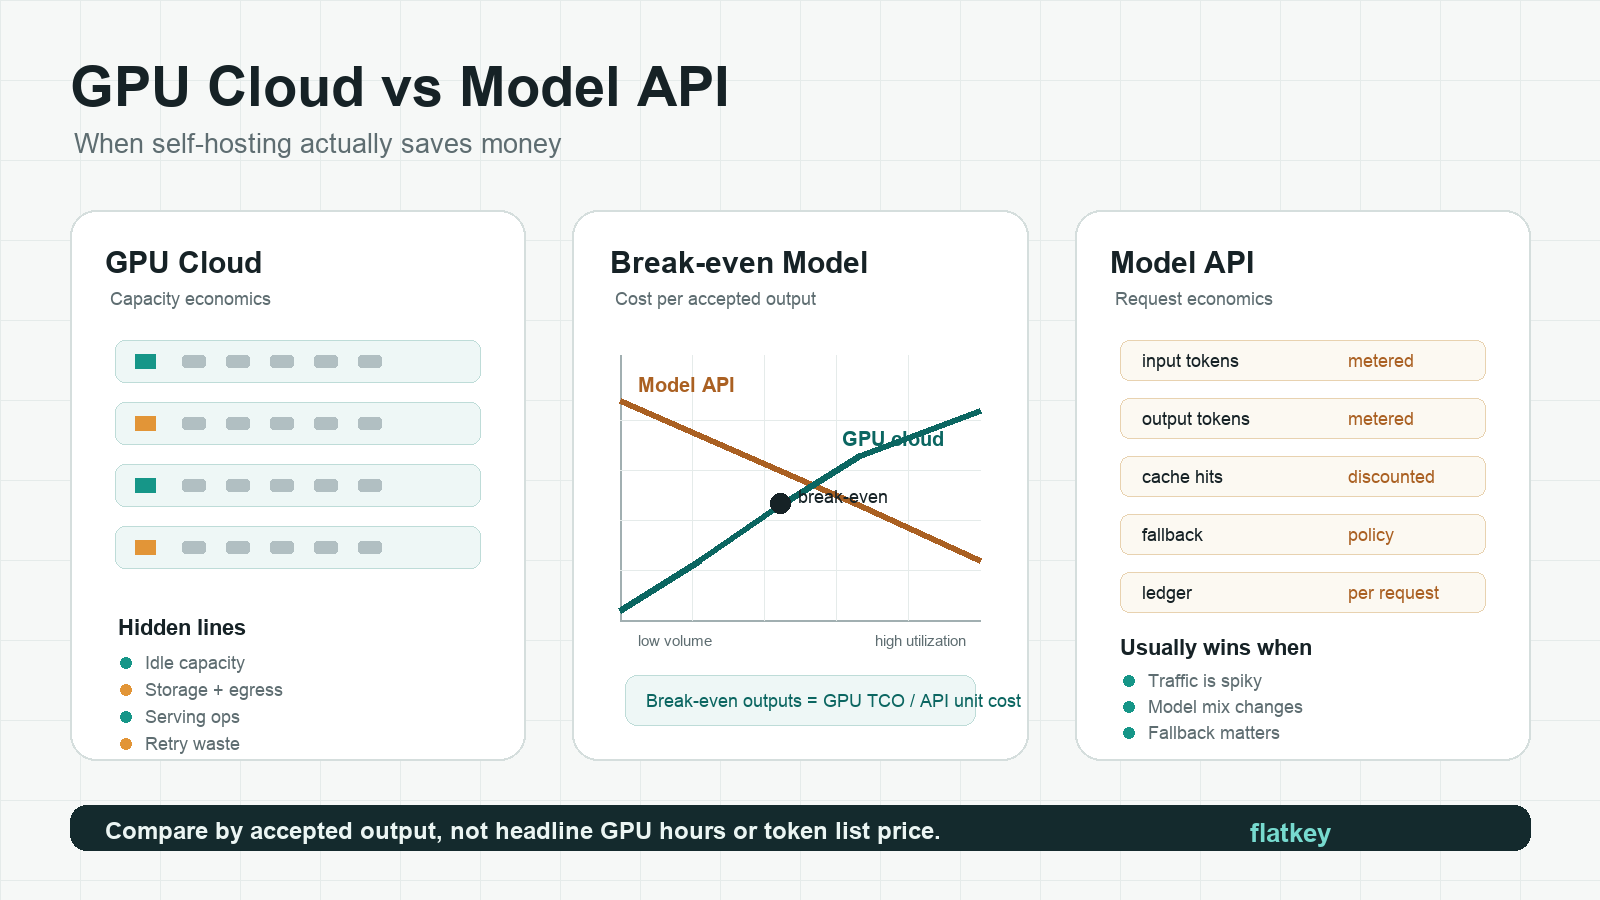
GPU Cloud vs API de modelo: cuándo el autoalojamiento realmente ahorra dinero
Compara la economía de GPU cloud frente a API de modelo con una hoja de cálculo de punto de equilibrio para el coste por salida aceptada, la utilización, los reintentos, la capacidad ociosa y las operaciones de serving.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar