
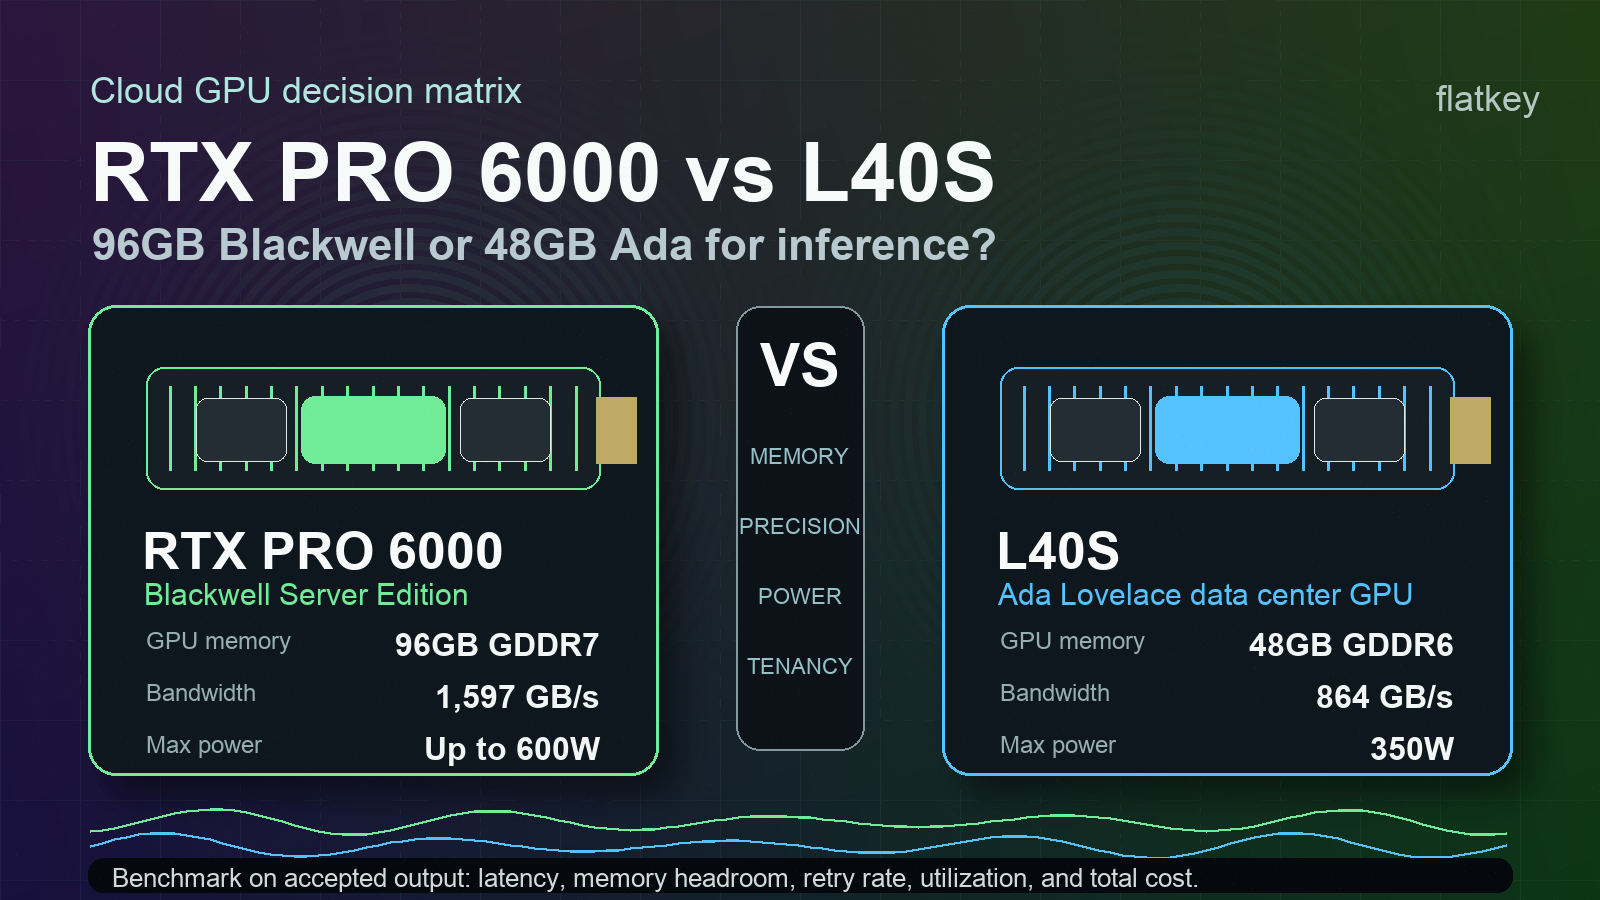
RTX PRO 6000 vs L40S: ¿GPU de inferencia Blackwell de 96 GB o Ada?
La respuesta breve para l40s vs rtx pro 6000: elige NVIDIA RTX PRO 6000 Blackwell Server Edition cuando 96 GB de memoria de GPU, compatibilidad con Blackwell FP4, PCIe Gen 5, particionamiento MIG y motores multimedia más nuevos puedan cambiar tu diseño de serving. Elige NVIDIA L40S cuando tu carga de trabajo ya encaje dentro de 48 GB, tu stack ya esté maduro en GPUs Ada y la diferencia de precio o disponibilidad sea lo bastante grande como para superar a la tarjeta más nueva.
Esta no es una decisión limpia de "la GPU nueva siempre gana". La comparación rtx pro 6000 vs l40s trata realmente sobre ajuste de memoria, compatibilidad de precisión, madurez del software, presupuesto de energía y coste del output aceptado. Si la RTX PRO 6000 te permite usar menos shards, ventanas de contexto más grandes, batches mayores o menos reintentos por falta de memoria, puede ser la GPU de inferencia más fuerte. Si la capacidad de L40S es más barata, más fácil de reservar y ya cumple tu objetivo de latencia, la tarjeta Ada más antigua puede seguir siendo la opción pragmática.
Comprobado el 13 de octubre de 2026.
L40S vs RTX PRO 6000: la diferencia práctica
Usa esta tabla como primer filtro de compra antes de pedir benchmarks al proveedor.
| Punto de decisión | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| Generación de GPU | Blackwell | Ada Lovelace |
| Razón principal de compra | Más memoria, Tensor Cores más nuevos, ruta FP4, PCIe Gen 5, particionamiento de cargas de trabajo | GPU de centro de datos madura de 48 GB para inferencia, renderizado, gráficos y vídeo |
| Memoria de GPU | 96 GB GDDR7 con ECC | 48 GB GDDR6 con ECC |
| Ancho de banda de memoria | 1.597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Titular de precisión Tensor | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1.466 TFLOPS con sparsity, FP16/BF16 362,05 / 733 TFLOPS con sparsity |
| Potencia máxima | Hasta 600 W configurable | 350 W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | Hasta cuatro instancias aisladas en RTX PRO 6000 | No se lista compatibilidad MIG para L40S |
| Mejor primera prueba | Inferencia LLM de contexto largo, modelos multimodales más grandes, compartición de GPU multiarrendatario, serving optimizado para FP4/Blackwell | LLMs compatibles con 48 GB, generación de imágenes estilo Stable Diffusion, renderizado, vídeo, flotas Ada maduras |
Fuentes: página de producto RTX PRO 6000 Blackwell Server Edition de NVIDIA, página de producto L40S de NVIDIA y página de arquitectura Blackwell de NVIDIA.
La recomendación rápida
Empieza el benchmark l40s vs rtx pro 6000 con la memoria, no con el TFLOPS pico.
- Elige RTX PRO 6000 Blackwell Server Edition cuando tu modelo esté limitado por memoria en L40S, cuando la longitud de contexto o la presión del KV cache determinen la cantidad de GPU, cuando quieras probar rutas de inferencia FP4/Blackwell, o cuando las particiones aisladas de GPU sean importantes para clústeres empresariales compartidos.
- Elige L40S cuando tu modelo, tamaño de batch y ventana de contexto quepan cómodamente dentro de 48 GB, cuando tu stack de producción ya esté ajustado para Ada, o cuando la diferencia de precio del proveedor sea lo bastante grande como para que la GPU más antigua gane en coste del output aceptado.
- Usa una línea base de API de modelo cuando no necesites pesos personalizados, control de CUDA, programación privada de GPU o aceleración directa de medios/renderizado. El hardware tiene que superar el coste y la simplicidad operativa de las llamadas gestionadas al modelo después de colas, reintentos, tiempo ocioso y sobrecarga de ingeniería.
Ese último punto es la razón por la que la decisión nvidia rtx pro 6000 vs l40s no debería detenerse en una hoja de especificaciones. Una tarjeta más rápida puede seguir siendo la compra equivocada si la utilización es baja o el equipo no necesita encargarse de las operaciones de GPU.
Por qué RTX PRO 6000 cambia la conversación sobre inferencia
La RTX PRO 6000 Blackwell Server Edition duplica la capacidad de memoria indicada frente a L40S: 96 GB GDDR7 en lugar de 48 GB GDDR6. También incrementa el ancho de banda de memoria indicado de 864 GB/s en L40S a 1.597 GB/s.
Para los equipos de inferencia, la memoria no es solo "tamaño del modelo". También cubre el KV cache, margen para batching, buffers de ejecución, adaptadores, entradas multimodales, margen de seguridad para prompts largos y sobrecarga de tenancy. En un servicio real, la tarjeta que evita errores de out-of-memory o reduce el sharding tensor-parallel puede superar a una tarjeta más barata con menor coste horario indicado.
RTX PRO 6000 merece especialmente la pena probarla cuando:
- Sirves tráfico LLM de contexto largo y el KV cache domina la planificación de memoria.
- Quieres probar modelos cuantizados de clase 70B o superiores con menos shards.
- Ejecutas cargas de trabajo multimodales mixtas donde componentes de imagen, vídeo, embeddings, reranking y LLM compiten por la memoria.
- Necesitas particionar una GPU física para varios usuarios o cargas de trabajo; NVIDIA indica hasta cuatro instancias MIG aisladas para RTX PRO 6000.
- Estás evaluando rutas de serving específicas de Blackwell como FP4/NVFP4, TensorRT-LLM, vLLM o mejoras de SGLang.
La compensación de energía es real. NVIDIA sitúa la RTX PRO 6000 en hasta 600 W configurables, mientras que L40S es de 350 W. Si tu proveedor cobra por servidor comprometido, envolvente de potencia, densidad de rack o capacidad reservada, ese techo más alto entra en el modelo de coste de rtx 6000 pro vs l40s. No compares el precio horario de la GPU sin preguntar qué potencia, refrigeración, configuración del host, soporte y tenancy están incluidos.
Por qué L40S sigue siendo útil
La L40S sigue siendo una GPU práctica muy sólida porque es una tarjeta madura para centros de datos Ada con 48 GB de memoria ECC, 864 GB/s de ancho de banda de memoria, 350 W de potencia máxima y amplia familiaridad en producción. NVIDIA posiciona la L40S para IA generativa, entrenamiento e inferencia de LLM, gráficos, renderizado, Omniverse y cargas de trabajo de video.
Ese nivel de madurez importa en la adquisición en la nube. Una tarjeta algo más antigua puede ganar cuando:
- La capacidad está disponible ahora en la región exacta que necesitas.
- Las imágenes del proveedor, los controladores, los contenedores y la monitorización ya son estables.
- La carga de trabajo cabe dentro de 48 GB sin fragmentación agresiva.
- Tu cuello de botella es el tiempo en cola, la carga de datos, el preprocesamiento de CPU o la planificación del software, en lugar del pico bruto de los Tensor Core.
- Estás ejecutando generación de imágenes, renderizado, video o trabajos de computación visual que ya rinden bien en Ada.
La pregunta nvidia l40s vs rtx pro 6000 a menudo se reduce a si los 48 GB adicionales de la RTX PRO 6000 cambian la forma de despliegue. Si no es así, la L40S puede ser la opción de alquiler o de capacidad reservada de menor riesgo, especialmente para equipos con scripts y líneas base ya existentes.
Matriz de decisión por carga de trabajo
Usa esta matriz antes de pedir un presupuesto a un proveedor.
| Carga de trabajo | Prefiere RTX PRO 6000 cuando... | Prefiere L40S cuando... | Qué medir |
|---|---|---|---|
| Inferencia de LLM de contexto largo | 48 GB limita la longitud de contexto, el tamaño del lote o el margen de la caché KV | 48 GB cumple los objetivos p95 de contexto y concurrencia | Tiempo hasta el primer token, tokens/s, latencia p95, tasa de OOM, respuestas aceptadas/hora |
| Servicio de modelos cuantizados de clase 70B | 96 GB reduce la fragmentación, los reintentos o la complejidad de colocación | Tu modelo cuantizado y la caché KV caben en la L40S con la concurrencia objetivo | GPU por réplica, demora en cola, puntuación de calidad, tasa de reintentos |
| Inferencia multiusuario | El aislamiento MIG y la memoria de 96 GB mejoran la utilización | La multitenencia se gestiona a nivel de nodo o del planificador | Utilización por inquilino, incidencias de vecino ruidoso, trabajos fallidos |
| Stable Diffusion y generación de imágenes | Modelos más grandes, lotes o etapas de medios mixtos necesitan más memoria | Los flujos de trabajo existentes ya cumplen los objetivos de rendimiento y calidad | Imágenes aceptadas/hora, margen de VRAM, coste por imagen aceptada |
| Renderizado y gráficos 3D | Las funciones RT/media de Blackwell mejoran exactamente el renderizador o la canalización | El rendimiento de Ada L40S ya está validado para el renderizador | Tiempo de fotograma/render, renders fallidos, rendimiento de codificación/decodificación de medios |
| Renovación empresarial | Quieres una plataforma de la era Blackwell para los próximos 24 meses | Necesitas capacidad incremental con operaciones conocidas | Base mínima de utilización, esfuerzo de migración, SLA de soporte, disponibilidad de capacidad |
Esta es la forma útil de enfocar l40s vs rtx 6000 pro: no qué página de producto tiene el número más grande, sino qué GPU cambia el número de resultados aceptados que puedes entregar por dólar.
Mide la salida aceptada, no las especificaciones máximas
Un benchmark serio de l40s vs rtx pro 6000 debe reproducir tu carga de trabajo en lugar de depender de picos genéricos. Mide la salida que tus usuarios o clientes aceptan.
Para inferencia de LLM, recopila:
| Métrica | Por qué importa |
|---|---|
| Tiempo hasta el primer token | Captura la latencia interactiva del usuario |
| Latencia entre tokens | Muestra el comportamiento de decodificación bajo concurrencia real |
| Concurrencia estable | Expone si 48 GB o 96 GB cambian el batching |
| Escalera de longitud de contexto | Encuentra cuándo aparece la presión de la caché KV |
| Tasa de OOM y reintentos | Convierte el ajuste de memoria en coste real |
| Respuestas aceptadas por hora | Normaliza filtros de calidad, fallos y reintentos |
| Coste por 1M de tokens de salida aceptados | Permite que RTX PRO 6000, L40S y las API de modelos compartan una sola métrica |
| Horas de ingeniería por mes | Captura el trabajo de controladores, kernel, cola, incidencias y benchmarks |
Para cargas de trabajo de imagen, video, renderizado o multimodales, reemplaza los tokens aceptados por imágenes aceptadas, clips aceptados, fotogramas renderizados o trabajos completados. La lógica es la misma. Una tarjeta que parece más rápida en un benchmark del proveedor puede perder si aumenta la contención de la cola, crea más trabajos fallidos o requiere una migración de software que tu equipo no puede mantener.
Preguntas al proveedor antes de alquilar RTX PRO 6000 o L40S
Haz estas preguntas antes de comprometerte con cualquiera de las dos GPU:
- ¿La capacidad de RTX PRO 6000 es específicamente la Blackwell Server Edition, y es de doble ranura con refrigeración por aire o de una sola ranura con refrigeración líquida?
- ¿La capacidad de L40S es dedicada, fraccionada, contenedorizada o parte de un servicio de trabajos gestionado?
- ¿Qué versiones de driver, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch y contenedor están admitidas?
- ¿El proveedor expone MIG en RTX PRO 6000, y cómo se facturan las instancias?
- ¿Las ejecuciones de benchmark se facturan a tarifa bajo demanda, a tarifa reservada o se incluyen en una ventana de evaluación?
- ¿Cuál es la región, la red, la CPU del host, la clase de almacenamiento y la capacidad local de NVMe?
- ¿Los trabajos fallidos, el tiempo inactivo, el tiempo en cola, las instantáneas y la salida de datos se facturan por separado?
- ¿Qué SLA de soporte y qué ruta de reemplazo se aplican cuando un host de GPU no está en buen estado?
- ¿Puedes exportar la utilización de GPU por trabajo, el uso de memoria, la demora en cola, la tasa de reintentos y el coste?
- ¿Cuál es la ruta de respaldo si la disponibilidad, los controladores o los kernels de Blackwell van por detrás de tu calendario de lanzamiento?
Combine esas respuestas con la guía de precios de alquiler de GPU de Flatkey, la hoja de cálculo del TCO de clústeres de GPU y GPU cloud vs model API. Si todavía estás decidiendo la clase de GPU, lee antes la guía más amplia sobre la mejor GPU para inferencia de LLM antes de acotar a nvidia l40s vs rtx pro 6000.
Dónde encaja Flatkey
Flatkey no reemplaza a RTX PRO 6000 ni a L40S cuando necesitas control directo de la GPU. Si ejecutas pesos privados, kernels personalizados, localización estricta de datos, canalizaciones de renderizado dedicadas o investigación a nivel de hardware, todavía necesitas capacidad de GPU en la nube o infraestructura propia.
Flatkey es la referencia a superar cuando tu equipo necesita principalmente salidas de modelo fiables. Con una sola clave y un solo saldo entre modelos oficiales y herramientas de IA, los equipos pueden enrutar cargas de trabajo de API, seguir el uso, comparar el coste de los modelos y evitar cuentas dispersas de proveedores. Eso da a finanzas e ingeniería un grupo de control limpio antes de comprometerse con capacidad fija de GPU.
En la práctica, ejecuta tres rutas:
| Ruta | Cuándo gana |
|---|---|
| RTX PRO 6000 | Más memoria o las funciones de Blackwell reducen el número de GPU, los fallos o la latencia lo suficiente como para compensar el mayor coste |
| L40S | 48 GB son suficientes y la capacidad madura de Ada tiene el mejor precio por salida aceptada |
| API de modelo gestionada a través de Flatkey | No hace falta control directo de GPU y la simplicidad operativa supera la propiedad de la infraestructura |
El ganador correcto es la ruta con el coste más bajo por salida aceptada para tu objetivo de calidad y latencia.
Recomendación final
Para l40s vs rtx pro 6000, haz de RTX PRO 6000 tu primera referencia cuando el margen de memoria, el soporte FP4/Blackwell, PCIe Gen 5 o la partición MIG puedan cambiar la arquitectura de servicio. Haz de L40S tu primera referencia cuando la carga de trabajo ya encaje dentro de 48 GB y la capacidad madura de Ada sea más barata o más fácil de reservar.
Luego compara ambas contra una referencia de modelo/API. Si Flatkey u otra ruta de API gestionada cumple con los requisitos de calidad, latencia, privacidad y coste, el alquiler de GPU debe justificar su trabajo operativo adicional. Si no puede, la ruta de hardware queda justificada y la elección final se convierte en una reproducción de la carga de trabajo: rtx pro 6000 vs l40s sobre la salida aceptada, no sobre los picos de marketing.
Preguntas frecuentes
¿Es RTX PRO 6000 Blackwell más rápida que L40S?
En las especificaciones públicas de NVIDIA, RTX PRO 6000 Blackwell Server Edition tiene un rendimiento FP32 listado más alto, más memoria, más ancho de banda de memoria, Tensor Cores más nuevos y soporte para FP4. Eso no significa que sea más barata para todas las cargas de trabajo. Compara tu pila de servicio exacta y el coste por salida aceptada.
¿Sigue siendo L40S buena para la inferencia de LLM?
Sí, cuando el modelo, la ventana de contexto y el objetivo de concurrencia caben dentro de 48 GB. L40S aún puede ser práctica para inferencia de LLM, generación de imágenes, renderizado, vídeo y cargas de trabajo mixtas de computación visual, especialmente donde la capacidad del proveedor es madura.
¿Cuál es la mayor diferencia entre NVIDIA RTX PRO 6000 y L40S?
La mayor diferencia práctica es la memoria. RTX PRO 6000 Blackwell Server Edition anuncia 96 GB de GDDR7 y 1.597 GB/s de ancho de banda de memoria; L40S anuncia 48 GB de GDDR6 y 864 GB/s de ancho de banda de memoria. RTX PRO 6000 también añade una vía FP4 de Blackwell y soporte MIG.
¿Debería actualizar de L40S a RTX PRO 6000?
Actualiza cuando los límites de memoria de L40S estén creando más fragmentación, lotes más pequeños, ventanas de contexto más cortas, trabajos fallidos o baja utilización. Quédate en L40S cuando ya cumpla tus objetivos de latencia y calidad con un coste por salida aceptada más bajo.
¿Debería usar una API de modelo en lugar de alquilar cualquiera de estas GPU?
Usa una API de modelo cuando no necesites pesos personalizados, control directo de CUDA, programación privada de GPU o aceleración de renderizado/medios. Una API de modelo puede ser la mejor ruta económica cuando la demanda de la carga de trabajo es volátil o la utilización de la GPU sería baja.
Fuentes consultadas
- Página de producto NVIDIA RTX PRO 6000 Blackwell Server Edition
- Página de producto NVIDIA L40S
- Página de arquitectura Blackwell de NVIDIA
- Mapa temático de GPU en la nube de Flatkey y fuente de palabras clave Cloud GPU con fecha 2026-10-10
- Descripción general del producto de Flatkey y posicionamiento aprobado: una clave, un saldo, modelos oficiales, registro de uso de pago por llamada exitosa


