
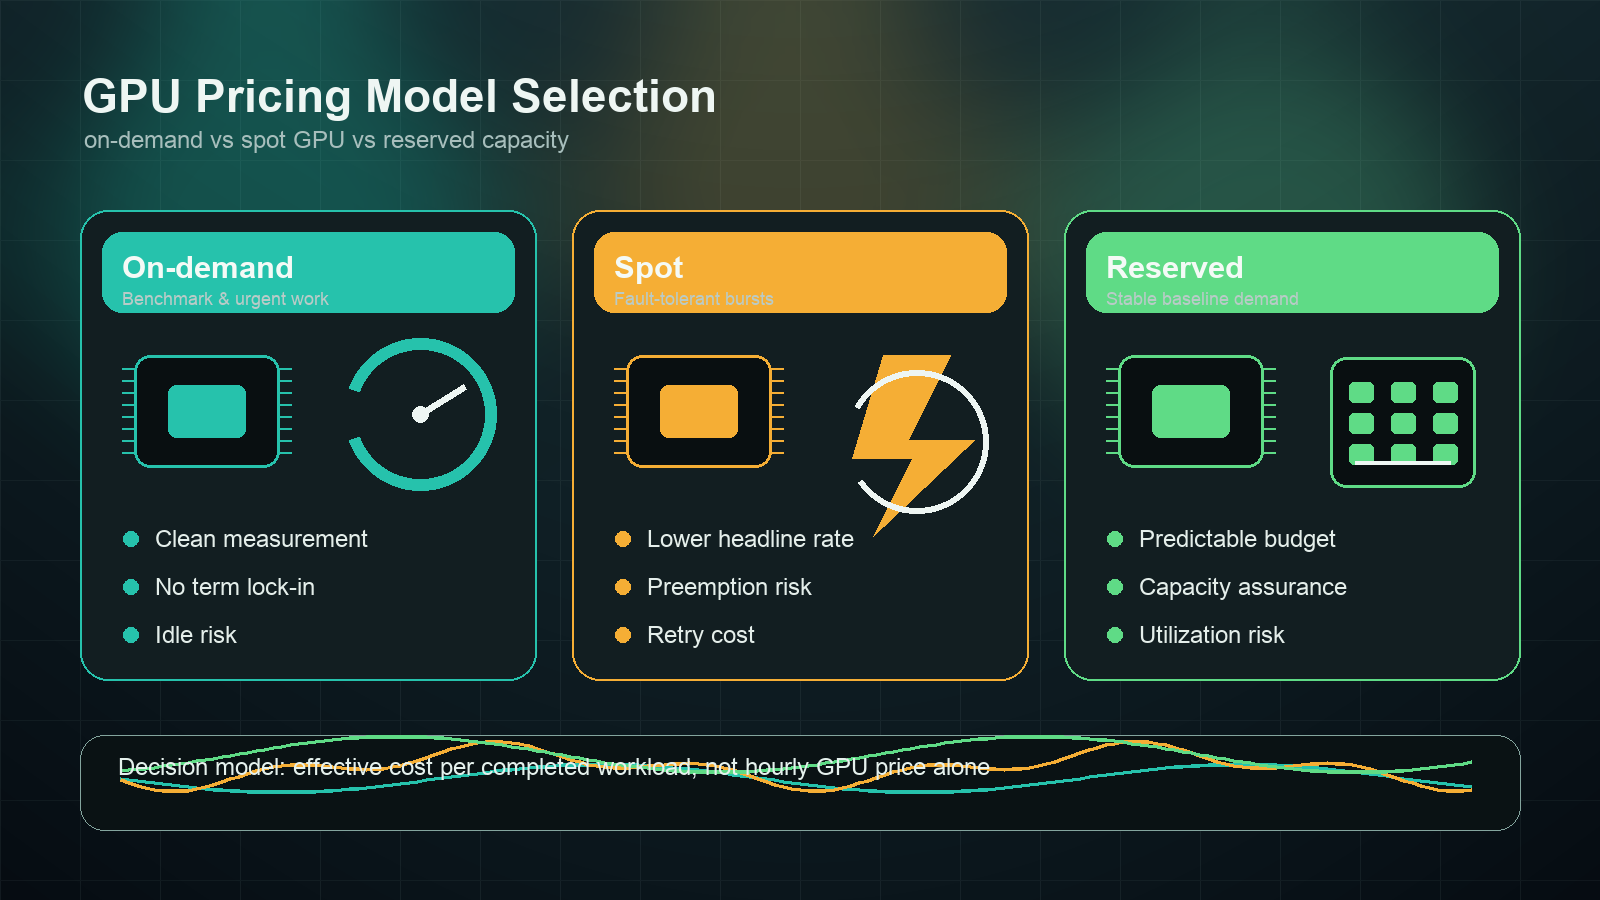
Memilih antara kapasitas GPU on-demand vs spot bukan sekadar latihan membaca daftar harga. Harga per jam yang lebih murah bisa jadi kalah jika job harus restart, checkpoint lemah, data perlu dimuat ulang, atau engineer menghabiskan berhari-hari untuk menjaga mesin yang bisa diinterupsi tetap hidup. Kapasitas GPU reserved juga bisa tampak lebih murah sampai permintaan model bergeser dan tim terkunci pada hardware yang kurang dimanfaatkan.
Panduan ini membandingkan harga GPU on-demand, spot, dan reserved untuk pembeli infrastruktur AI, tim FinOps, dan platform engineer yang membutuhkan model keputusan workload yang praktis. Jawaban singkatnya: gunakan GPU on-demand untuk pengukuran awal dan pekerjaan mendesak, GPU spot untuk workload batch yang tahan terhadap gangguan, dan kapasitas GPU reserved hanya setelah Anda bisa membuktikan utilisasi dasar.
Jika Anda masih memutuskan apakah perlu menyewa GPU sama sekali, mulai dari panduan yang lebih luas tentang harga sewa GPU dan GPU cloud vs model API. Artikel ini berfokus pada pilihan model harga setelah Anda sudah tahu bahwa kapasitas GPU memang masuk dalam rencana.
Jawaban cepat: on-demand vs spot GPU vs reserved
Bagi sebagian besar tim, penilaian awalnya sebaiknya seperti ini:
| Model harga | Paling cocok untuk | Risiko utama | Metrik yang dipantau |
|---|---|---|---|
| GPU on-demand | Benchmark, eksperimen mendesak, demo, produksi awal, utilisasi yang belum diketahui | Waktu menganggur dan tarif per jam yang lebih tinggi | Menit GPU aktif yang berguna / menit yang ditagihkan |
| GPU spot | Batch inference, evaluasi offline, training dengan checkpoint, antrean media, worker yang bisa di-retry | Eviction, penundaan antrean, pemborosan saat restart, pekerjaan duplikat | Job yang selesai setelah biaya gangguan |
| GPU reserved | Inference produksi yang stabil, training terjadwal, window peluncuran, klaster khusus | Utilisasi rendah, lock-in hardware, ketidaksesuaian kontrak | Utilisasi dasar versus titik impas komitmen |
Aturan yang tahan lama untuk keputusan on-demand vs spot GPU itu sederhana: bandingkan biaya efektif per workload yang selesai, bukan harga GPU per jam yang diiklankan.
biaya efektif per workload yang selesai =
  (compute + storage + bandwidth + idle time + restart waste + support + engineering overhead)
  / job yang diterima, token terlatih, token inferensi, gambar, klip, atau run benchmark
Rumus itu penting karena setiap model memindahkan risiko ke tempat yang berbeda. On-demand menaruh risiko pada waktu menganggur. Spot menaruh risiko pada interupsi dan orkestrasi. Kapasitas reserved menaruh risiko pada akurasi perkiraan.
Apa arti harga GPU on-demand
Harga GPU on-demand adalah baseline yang paling bersih. Anda membayar saat instance, pod, atau server berjalan, tanpa komitmen jangka panjang. AWS menggambarkan On-Demand Instances sebagai kapasitas pay-as-you-go tanpa komitmen jangka panjang. Cloud GPU spesialis menggunakan bahasa yang serupa untuk pod, instance, atau server GPU per jam, meskipun unit penagihan dan storage yang disertakan bisa berbeda.
Gunakan on-demand terlebih dahulu saat workload masih belum diketahui:
| Kasus penggunaan | Mengapa on-demand cocok |
|---|---|
| Benchmark pertama dari model atau stack serving | Anda membutuhkan timing yang bersih tanpa variabel interupsi. |
| Validasi driver, CUDA, container, atau framework | Debugging tidak boleh dicampur dengan risiko eviction spot. |
| Demo pelanggan atau environment QA | Prediktabilitas lebih penting daripada tarif terendah. |
| Endpoint produksi awal | Anda membutuhkan ketersediaan sebelum memiliki data utilisasi yang stabil. |
| Training singkat yang mendesak atau run fine-tuning | Keterlambatan antrean bisa lebih mahal daripada penghematan per jam. |
Jebakannya adalah waktu menganggur. Jika sebuah notebook, pod, atau server inferensi berjalan selama 100 jam yang ditagihkan tetapi GPU hanya aktif selama 28 jam yang berguna, biaya riilnya bukan harga per jam yang tercantum dari penyedia. Tarif riilnya meningkat karena pemborosan akibat idle.
tarif efektif per jam on-demand =
  tarif per jam on-demand yang tercantum / porsi utilisasi yang berguna
Jika utilisasinya 35%, GPU $4/hour akan terasa seperti resource $11.43/useful-hour sebelum storage, bandwidth, atau overhead engineering. Untuk keputusan on-demand vs spot GPU, perbaiki shutdown saat idle dan packing antrean sebelum menegosiasikan tarif per jam yang lebih baik.
Apa arti harga GPU spot
Harga GPU spot menggunakan kapasitas cadangan atau yang bisa diinterupsi. AWS mengatakan EC2 Spot Instances menggunakan kapasitas EC2 cadangan dan dapat menawarkan diskon hingga 90% dibandingkan harga On-Demand. Google Cloud Spot VMs dan Azure Spot Virtual Machines mengikuti pola umum yang sama: kapasitas berharga lebih rendah yang dapat di-preempt atau di-evict saat cloud membutuhkannya kembali.
GPU spot menarik untuk workload AI karena training, evaluasi, pembuatan gambar, dan batch inference sering memiliki bagian-bagian besar yang bisa diulang. Tetapi "bisa diulang" tidak otomatis. Anda membutuhkan checkpointing, job yang idempotent, locality data, monitoring, dan scheduler yang bisa restart tanpa merusak hasil.
Spot biasanya merupakan kandidat kuat ketika:
- Job training sering membuat checkpoint dan melanjutkan dengan bersih.
- Batch inference dapat di-retry tanpa kegagalan yang terlihat oleh pengguna.
- Evaluasi offline dapat berjalan di banyak worker.
- Job pembuatan media berada di belakang antrean.
- Worker yang gagal tidak membatalkan seluruh job multi-node.
- Tim sudah memiliki orkestrasi untuk eviction dan pencegahan duplikasi.
Spot biasanya merupakan kandidat yang lemah ketika:
- Satu proses pelatihan multi-hari dimulai ulang dari checkpoint lama.
- Waktu startup didominasi oleh proses menarik model, image, atau dataset.
- Latensi yang menghadap pelanggan bergantung pada mesin tetap hidup.
- Pelatihan multi-node gagal ketika satu worker menghilang.
- Engineer harus secara manual mengawasi restart.
Untuk kelebihan dan kekurangan instance GPU spot vs on-demand, perhitungannya harus mencakup pemborosan akibat interupsi:
tarif efektif per jam spot =
  tarif spot per jam / (1 - porsi pemborosan interupsi)
Jika spot 60% lebih murah tetapi interupsi, pemuatan ulang data, langkah yang gagal, dan penundaan antrian membuang 35% dari pekerjaan yang berlalu, diskon sebenarnya jauh lebih kecil daripada tarif yang tercantum. Jika pemborosan restart mencapai orde yang sama dengan diskon, kapasitas on-demand sering kali lebih bersih.
Apa arti pricing GPU reserved
Pricing GPU reserved adalah model komitmen. Ini dapat muncul sebagai reserved instances, Savings Plans, committed use discounts, reserved clusters, private capacity, capacity blocks, atau dedicated GPU contracts. Nama-namanya berbeda menurut penyedia, tetapi trade-off-nya sama: Anda menukar fleksibilitas dengan kapasitas yang dapat diprediksi atau tarif efektif yang lebih rendah.
Kapasitas GPU reserved masuk akal ketika:
| Signal | Apa artinya |
|---|---|
| Lalu lintas inference baseline yang stabil | Anda dapat menjaga GPU tetap sibuk selama sebagian besar jam dalam sebulan. |
| Kalender pelatihan berulang | Anda tahu kapan kapasitas dibutuhkan dan untuk berapa lama. |
| Kebutuhan kapasitas saat peluncuran | Anda tidak bisa mengandalkan ketersediaan spot berdasarkan best-effort. |
| Kebutuhan topologi multi-node | Penempatan jaringan, fabric, dan lokalitas storage menjadi penting. |
| Procurement membutuhkan pengeluaran tetap | Komitmen bulanan yang diketahui lebih mudah disetujui daripada penggunaan yang berfluktuasi. |
Pertanyaan utama untuk kapasitas reserved adalah titik impas utilisasi:
utilisasi titik impas reserved =
  komitmen bulanan reserved
  / (tarif on-demand per jam * jam dalam sebulan)
Jika komitmen reserved impas pada utilisasi 62% dan baseline nyata Anda 25%, kapasitas reserved bukan diskon. Itu adalah langganan kapasitas yang menganggur. Untuk cluster GPU, gabungkan ini dengan model TCO cluster GPU sehingga networking, storage, support, remote hands, dan operasi ikut diperhitungkan.
Matriks keputusan berdasarkan workload
Model pricing terbaik bergantung pada toleransi kegagalan dan utilisasi, bukan hanya ukuran model.
| Workload | Titik awal yang lebih baik | Mengapa |
|---|---|---|
| Benchmark model pertama | GPU on-demand | Anda membutuhkan baseline yang bersih untuk throughput, latensi, memori, dan mode kegagalan. |
| Evaluasi stack serving baru | GPU on-demand | Validasi vLLM, SGLang, TensorRT-LLM, driver, image, dan pemuatan model sebelum mengoptimalkan harga. |
| Suite evaluasi offline | GPU spot | Hasil dapat dicoba ulang, dipecah, dan diperiksa untuk pekerjaan duplikat. |
| Batch embedding atau batch inference | GPU spot, dengan fallback on-demand | Job dapat masuk antrean jika ada kontrol idempotency dan retry. |
| Baseline inference yang menghadap pelanggan | Reserved plus burst on-demand | Permintaan yang stabil dapat membenarkan komitmen; burst tetap fleksibel. |
| Peluncuran satu kali atau kampanye singkat | On-demand atau capacity block | Jaminan kapasitas mungkin lebih penting daripada diskon jangka panjang. |
| Pelatihan terdistribusi multi-node | Reserved atau dedicated cluster | Penempatan, fabric jaringan, dan domain kegagalan lebih dominan daripada harga per jam. |
| Fitur produk AI dengan volume rendah | Model API atau gateway | Kapasitas GPU yang menganggur bisa lebih mahal daripada inference terkelola berbasis penggunaan. |
Untuk pemilihan model GPU di dalam baris mana pun, pasangkan artikel ini dengan panduan pemilihan GPU AI, GPU terbaik untuk inference LLM, dan panduan deployment vLLM.
Ekonomi GPU on-demand vs spot: contoh sederhana
Misalkan sebuah batch inference dapat dijalankan pada kelas GPU yang sama baik dalam mode on-demand maupun spot.
| Field | On-demand | Spot |
|---|---|---|
| Tarif per jam yang tercantum | $4.00 |
$1.80 |
| Utilisasi yang berguna | 70% |
70% |
| Pemborosan akibat restart dan eviction | 0% |
22% |
| Biaya efektif per jam berguna | $5.71 |
$3.30 |
Spot masih menang dalam contoh ini karena diskonnya lebih besar daripada pemborosannya. Sekarang ubah pemborosan restart menjadi 55% karena job berulang kali memuat ulang bobot dan kehilangan batch parsial.
| Field | On-demand | Spot |
|---|---|---|
| Tarif per jam yang tercantum | $4.00 |
$1.80 |
| Utilisasi yang berguna | 70% |
70% |
| Pemborosan akibat restart dan eviction | 0% |
55% |
| Biaya efektif per jam berguna | $5.71 |
$5.71 |
Pada titik itu, diskon spot yang tampak menghilang. Inilah mengapa perbandingan GPU on-demand vs spot harus memasukkan pemborosan operasional, bukan hanya persentase spot dari penyedia.
Ekonomi GPU reserved: uji utilisasi
Kapasitas reserved memerlukan pengujian yang berbeda. Misalkan sebuah GPU on-demand berharga $4/hour, dan komitmen bulanan reserved untuk kapasitas setara adalah $1,900/month.
monthly on-demand cost at 100% utilization =
  $4 * 730 hours = $2,920

reserved break-even utilization =
  $1,900 / $2,920 = 65%
Reservasi itu hanya menarik jika workload dapat membuat GPU tetap sibuk lebih dari sekitar dua pertiga bulan. Jika endpoint produksi Anda menggunakan GPU secara intens selama jam kerja tetapi menganggur pada malam hari dan akhir pekan, baseline yang sebenarnya mungkin berada di bawah titik impas.
Versi procurement dari pertanyaannya adalah:
- Apa baseline yang terukur, bukan puncak yang diproyeksikan?
- Workload mana yang diizinkan untuk mengisi kapasitas reserved yang menganggur?
- Apa yang terjadi jika model berpindah dari H100 ke H200, B200, L40S, atau API terkelola?
- Apakah storage, support, networking, dan egress termasuk di dalam atau di luar komitmen?
- Apakah kontrak dapat diturunkan skalanya, mengonversi tipe GPU, atau berpindah region?
Jangan melakukan reservasi berdasarkan harapan. Lakukan reservasi berdasarkan utilisasi yang terukur.
Daftar periksa sumber penyedia
Halaman harga GPU sering berubah, dan harga marketplace bisa berubah lebih cepat daripada siklus procurement. Gunakan ini sebagai daftar periksa sumber, bukan kartu tarif yang beku. Periksa ulang pada hari Anda menyetujui pengeluaran.
| Kategori penyedia | Sumber resmi yang perlu diperiksa | Apa yang harus dicatat |
|---|---|---|
| AWS | Harga Amazon EC2, EC2 Spot Instances, EC2 Capacity Blocks for ML | Region, family instance GPU, On-Demand, Spot, Savings Plans atau Reserved Instances, timing capacity block, EBS, transfer data, support. |
| Google Cloud | Harga GPU Compute Engine, Spot VMs, Committed use discounts | Tipe GPU, family mesin, region, status Spot VM, durasi komitmen, kebutuhan reservasi, persistent disk, network egress. |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | SKU VM GPU, region, kebijakan eviction, pengaturan harga maksimum, durasi reservasi, managed disk, bandwidth, support. |
| RunPod | Harga RunPod dan dokumen produk | Secure Cloud vs Community Cloud, harga pod, harga serverless, persistent storage, network volume, perilaku cold start. |
| Vast.ai | Harga Vast.ai dan dokumentasi Vast.ai | Keandalan host, status datacenter/community, flag interruptible, disk, bandwidth, verified host, kebutuhan public IP. |
| Lambda | Harga GPU Lambda Cloud | Jenis instance, jumlah GPU, region, ketersediaan on-demand, ketentuan penawaran cluster reserved, asumsi storage dan networking. |
Tambahkan baris tanggal pengecekan ke spreadsheet Anda. Untuk artikel ini, daftar periksa sumber ditinjau pada 13 Oktober 2026.
Pertanyaan procurement sebelum Anda memilih
Sebelum Anda memilih kapasitas GPU on-demand vs spot atau menandatangani kontrak GPU reserved, ajukan pertanyaan-pertanyaan ini:
| Pertanyaan | Mengapa ini penting |
|---|---|
| Apakah job dapat checkpoint dan resume tanpa perbaikan manual? | Menentukan apakah risiko interupsi spot dapat diterima. |
| Berapa lama startup berlangsung sebelum pekerjaan GPU yang berguna dimulai? | Pemuatan model dan data yang lama mengurangi penghematan spot dan merusak efisiensi on-demand. |
| Berapa tingkat idle yang terukur? | Waktu idle adalah kebocoran biaya utama pada on-demand. |
| Apa baseline-nya, bukan puncaknya? | Harga reserved hanya bekerja ketika permintaan baseline benar-benar nyata. |
| Apakah workload memerlukan region atau network fabric tertentu? | Topologi yang langka dapat membuat tarif spot/on-demand generik menjadi tidak relevan. |
| Apakah storage, snapshot, bandwidth, dan support termasuk? | Jam GPU hanyalah satu baris dalam tagihan sebenarnya. |
| Apa jalur keluar jika pilihan model berubah? | Lock-in hardware mahal ketika arsitektur model bergeser. |
| Bisakah API model terkelola memenuhi kebutuhan sebagai gantinya? | Workload dengan utilisasi rendah atau multi-model mungkin tidak membenarkan operasi GPU. |
Untuk keputusan multi-node dan private capacity, bandingkan ini dengan sewa GPU cluster dan private GPU cloud.
Kapan API model mengalahkan ketiga model harga GPU
GPU on-demand, spot, dan reserved semuanya berasumsi bahwa menyewa dan mengoperasikan hardware adalah lapisan abstraksi yang tepat. Itu tidak selalu benar.
API model terkelola bisa menjadi titik awal yang lebih ekonomis ketika:
- Utilisasi rendah, tidak menentu, atau belum diketahui.
- Produk membutuhkan banyak model, bukan satu model self-hosted.
- Keandalan, pembaruan, dan penskalaan akan mengalihkan fokus dari roadmap produk.
- Tim membutuhkan pencatatan penggunaan, anggaran, dan invoice lebih daripada kontrol atas hardware.
- Workload adalah inferensi produksi, bukan pelatihan model atau riset serving kustom.
Flatkey berada di sisi API dari keputusan ini. Platform ini memberi tim AI satu API key, satu saldo, satu invoice, visibilitas penggunaan, dan akses ke route model resmi lintas penyedia. Jika lembar kerja GPU on-demand vs spot menunjukkan bahwa utilisasi hardware belum cukup tinggi, bandingkan biaya API terkelola per hasil yang diterima sebelum membeli atau mereservasi kapasitas GPU. Langkah berikutnya adalah panduan perbandingan harga model AI dan harga AI gateway.
Rekomendasi akhir
Gunakan urutan ini:
- Mulai dengan kapasitas GPU on-demand sampai angka benchmark dan utilisasi dapat dipercaya.
- Pindahkan job yang bisa diulang ke GPU spot hanya setelah checkpointing, idempotency, dan otomatisasi restart terbukti.
- Reservasi kapasitas GPU hanya untuk permintaan baseline yang terukur, jendela peluncuran yang berkomitmen, atau klaster yang sensitif terhadap topologi.
- Biarkan jalur API model tetap terbuka ketika utilisasi rendah, pilihan model sering berubah, atau keuangan membutuhkan atribusi penggunaan yang lebih rapi.
Keputusan on-demand vs spot GPU terbaik bukanlah yang memiliki tarif per jam terendah di daftar. Melainkan keputusan on-demand vs spot GPU yang meminimalkan biaya per workload yang selesai sambil menjaga risiko keandalan tetap berada pada tingkat yang benar-benar bisa dikelola oleh tim Anda.


