
Блог flatkey.ai
Идеи, заметки о продукте и руководства по внедрению для команд, создающих продукты на AI API.
Архитектура ИИ-шлюзов
Последние статьи в категории Архитектура ИИ-шлюзов.
Читать дальшеМиграция базового URL и SDK
Последние статьи в категории Миграция базового URL и SDK.
Читать дальшеЗатраты, оплата и эксплуатация
Последние статьи в категории Затраты, оплата и эксплуатация.
Читать дальшеКорпоративный контроль и доверие
Последние статьи в категории Корпоративный контроль и доверие.
Читать дальшеСравнение шлюзов
Последние статьи в категории Сравнение шлюзов.
Читать дальшеРуководства по моделям и модальностям
Последние статьи в категории Руководства по моделям и модальностям.
Читать дальшеНадёжность и маршрутизация
Последние статьи в категории Надёжность и маршрутизация.
Читать дальшеИнтеграции инструментов
Последние статьи в категории Интеграции инструментов.
Читать дальше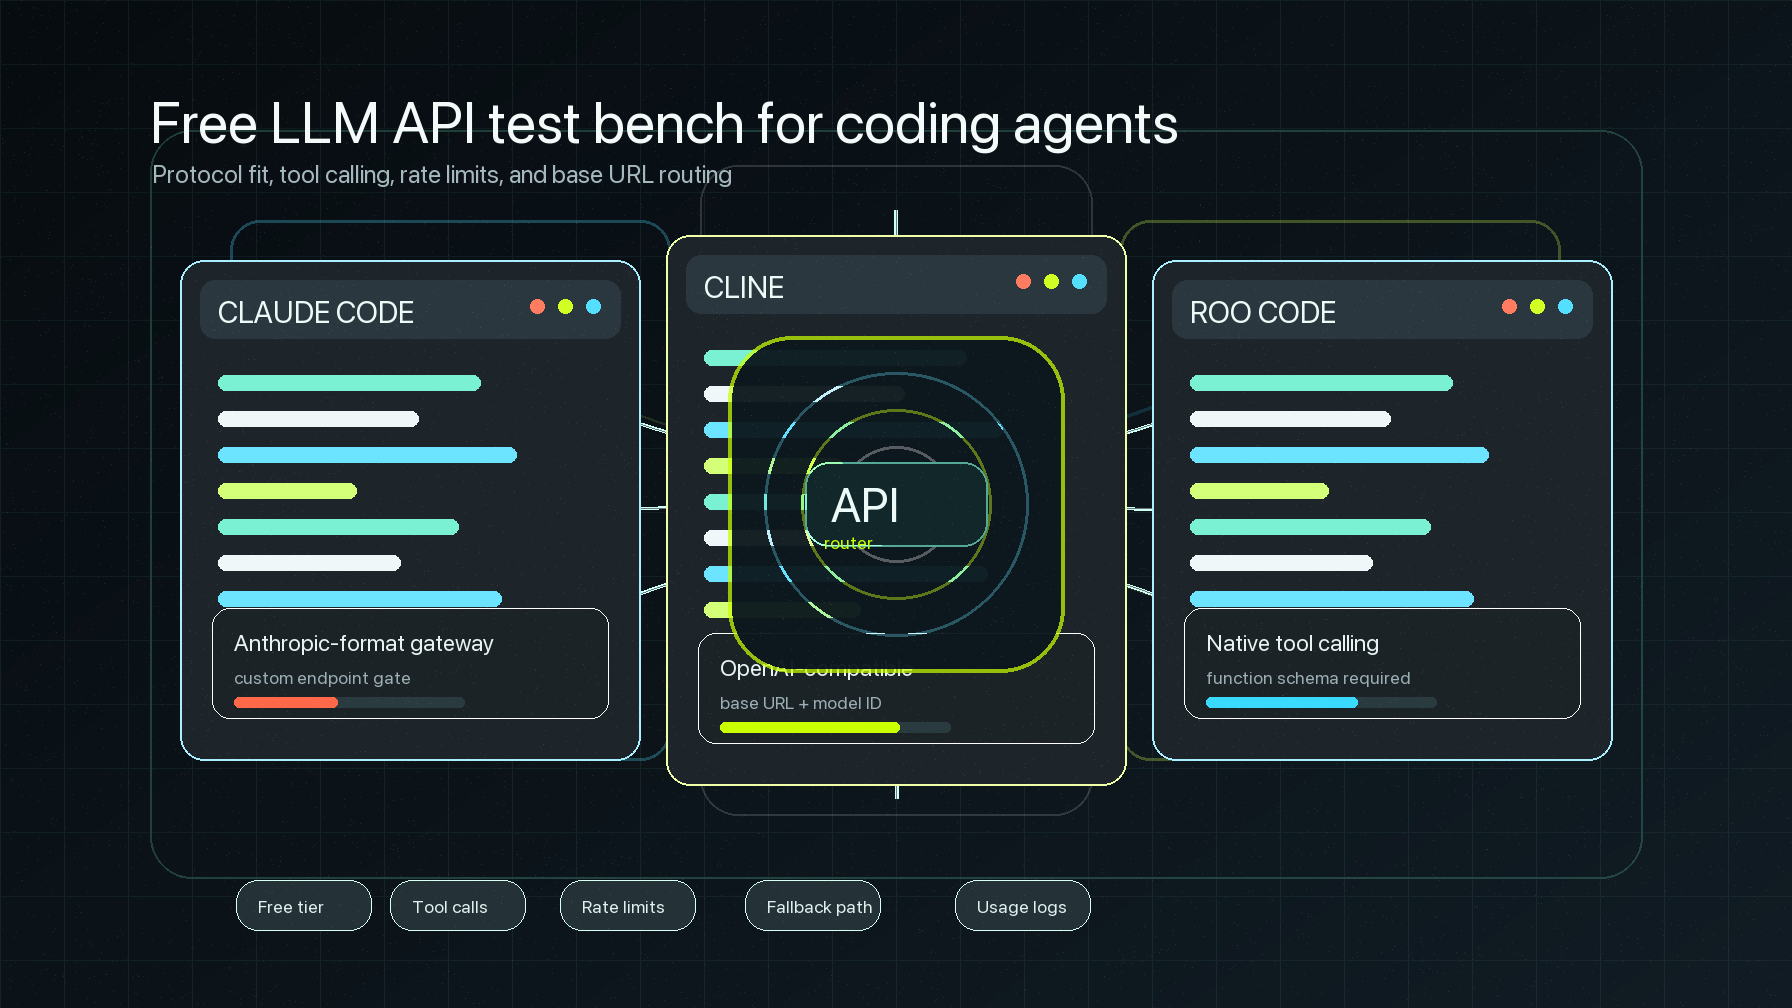
Какой бесплатный LLM лучше всего подходит для кодинга? Тестирование на Claude Code, Cline и Roo Code
Практическое руководство по совместимости бесплатных LLM API для кодирующих агентов: Claude Code, Cline, Roo Code, вызов инструментов, base URL и ограничения квот.
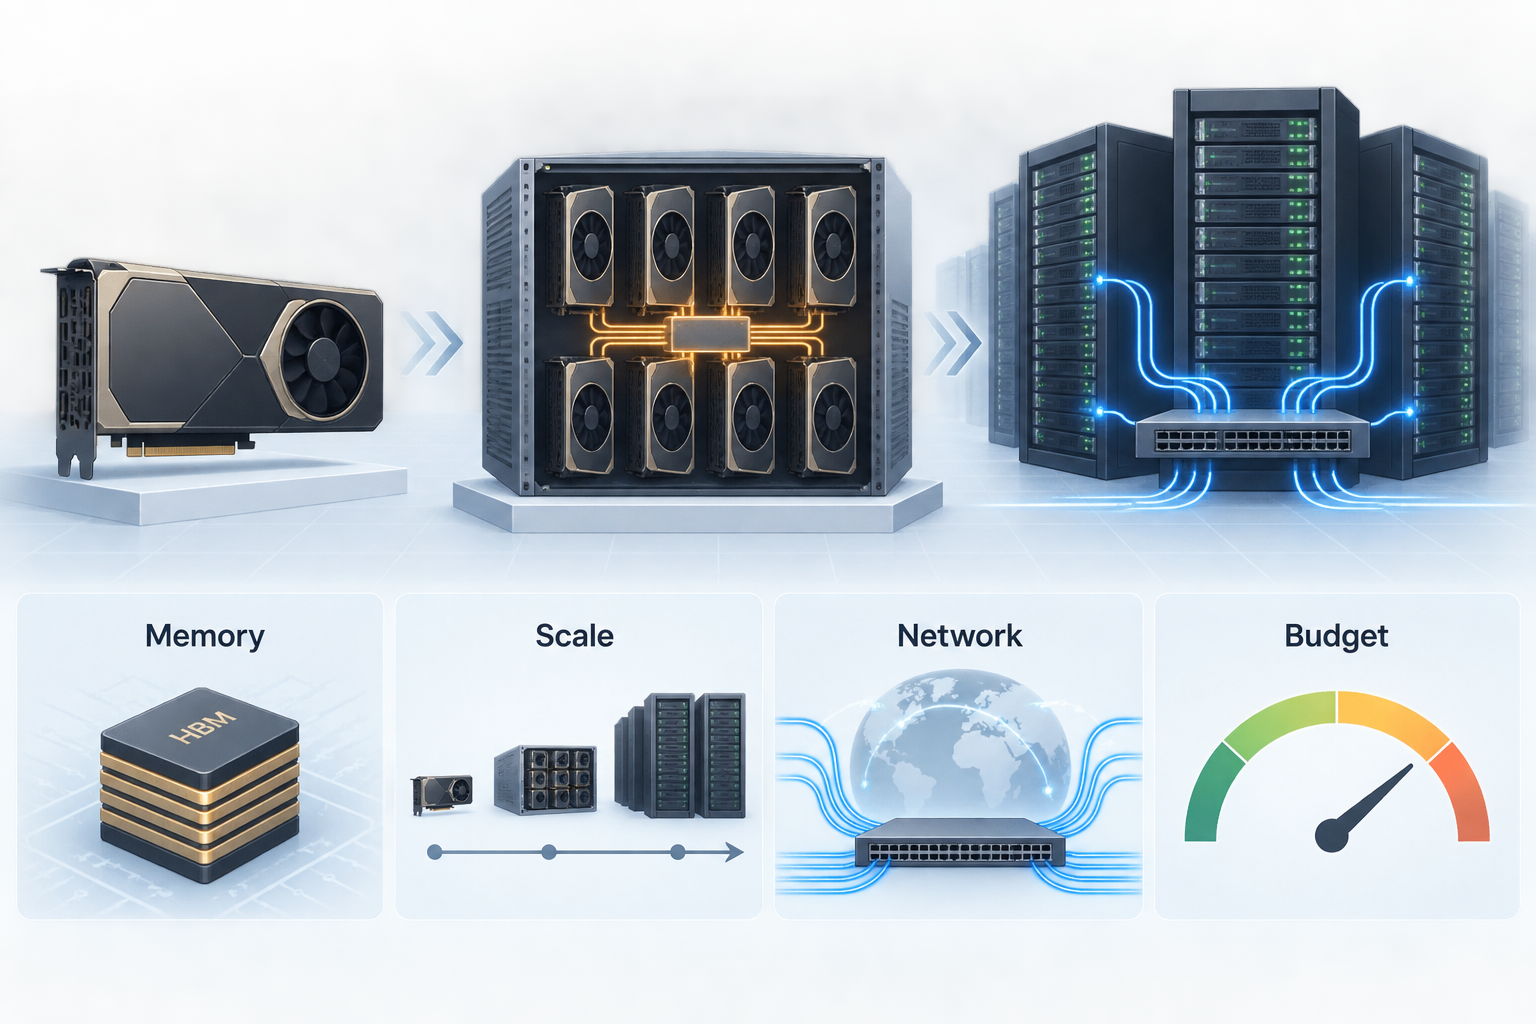
Лучшая GPU для обучения LLM: масштаб, память, сеть и бюджет
Практическое руководство 2026 года по выбору лучшей GPU для обучения LLM с учетом масштаба, памяти, сети, подходящего провайдера и стоимости одного готового checkpoint.
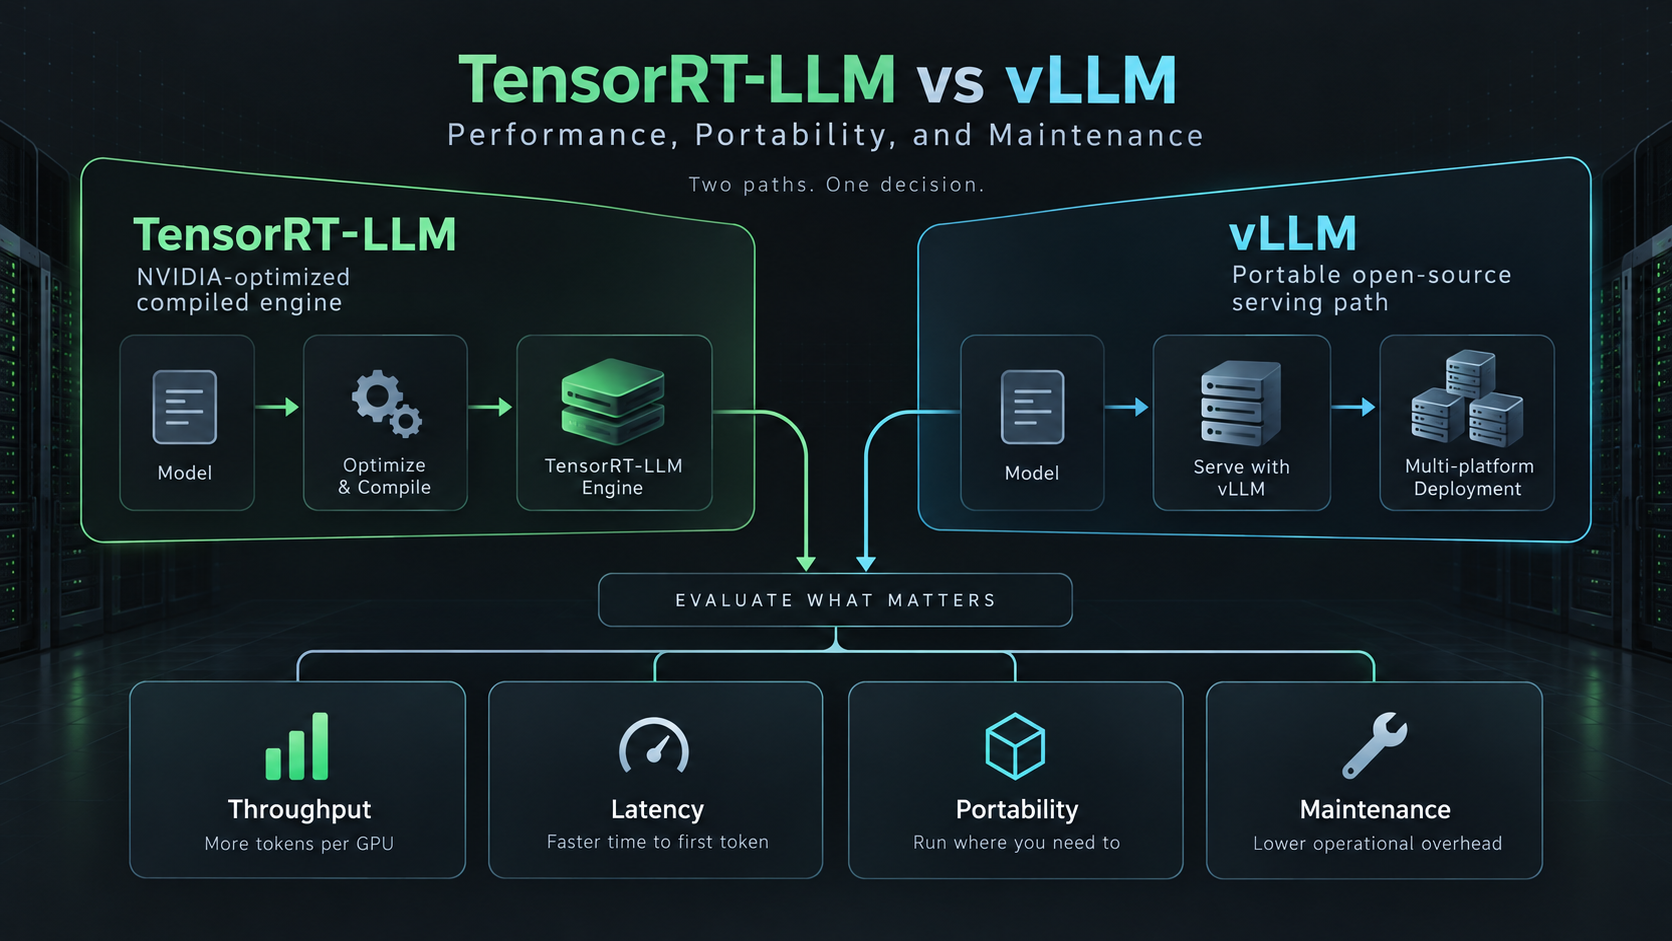
TensorRT-LLM vs vLLM: Производительность, портативность и сопровождение
Практическое сравнение TensorRT-LLM и vLLM для команд AI-инфраструктуры, выбирающих движок для обслуживания LLM с учетом производительности, портативности, сопровождения и дизайна бенчмарков.
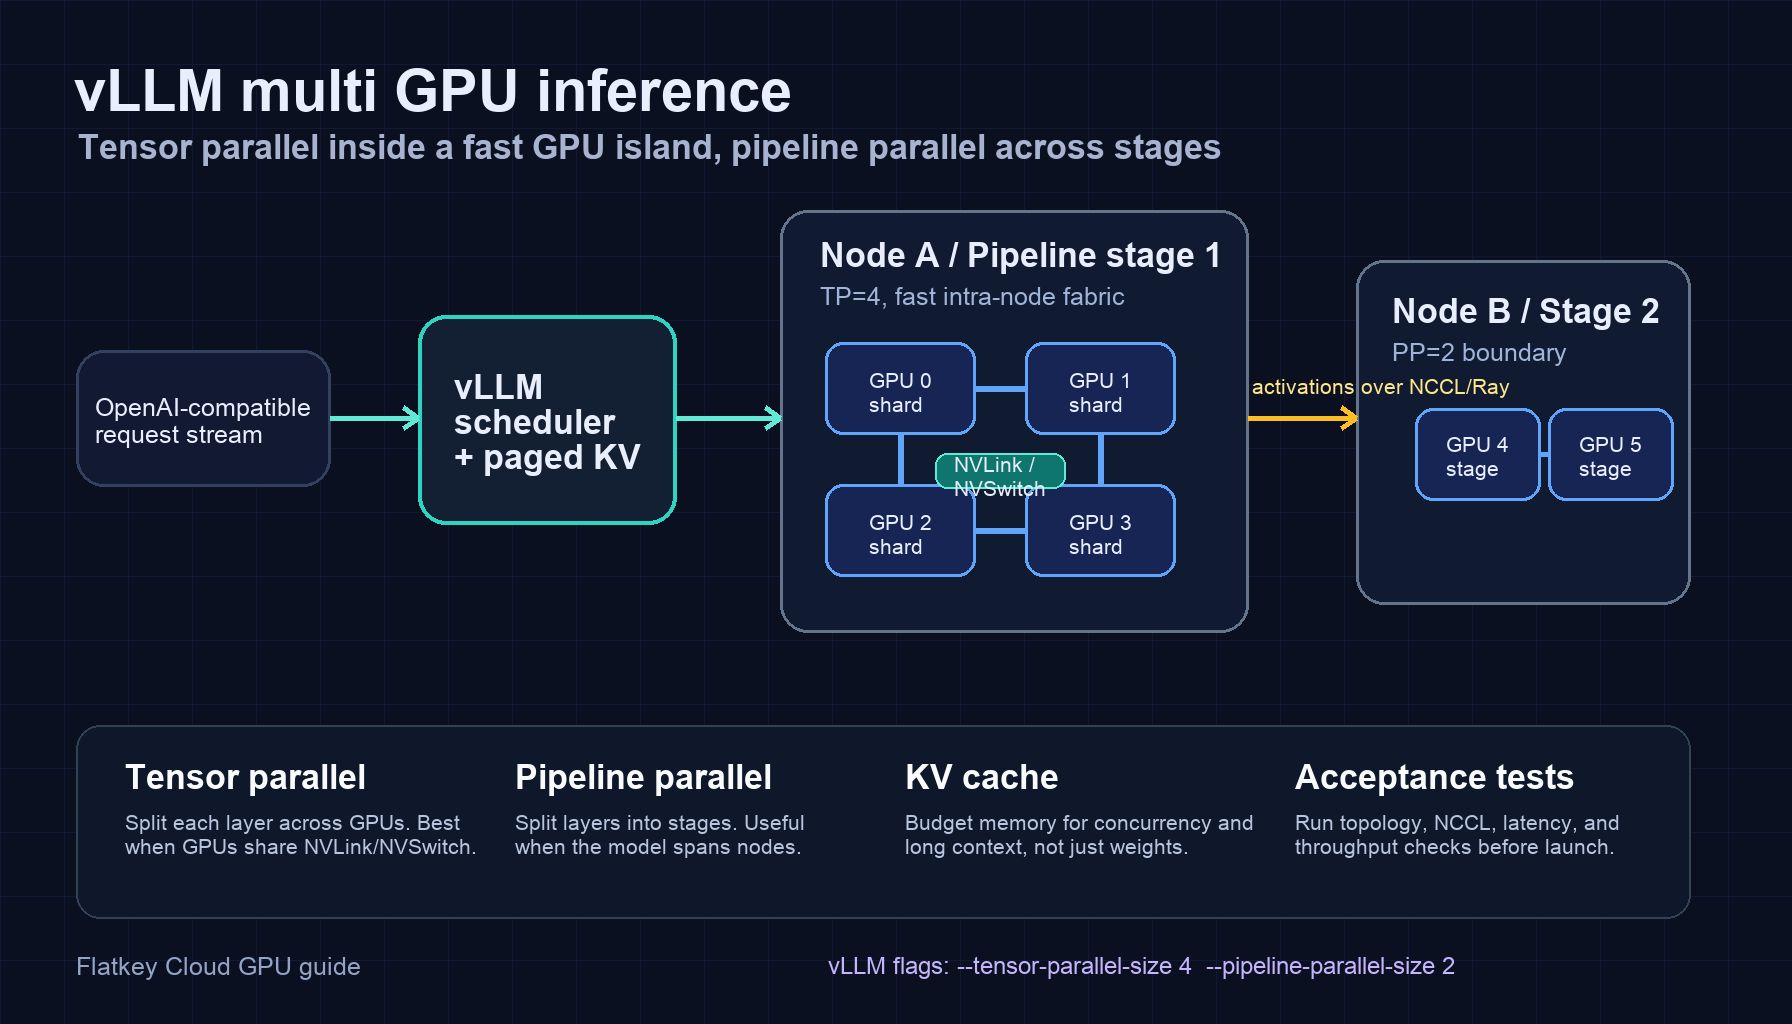
vLLM Multi-GPU Inference: Настройка tensor и pipeline parallelism
Настройте многопроцессорный inference vLLM с tensor parallelism, pipeline parallelism, Ray, проверками топологии, примерами и production-тестами.
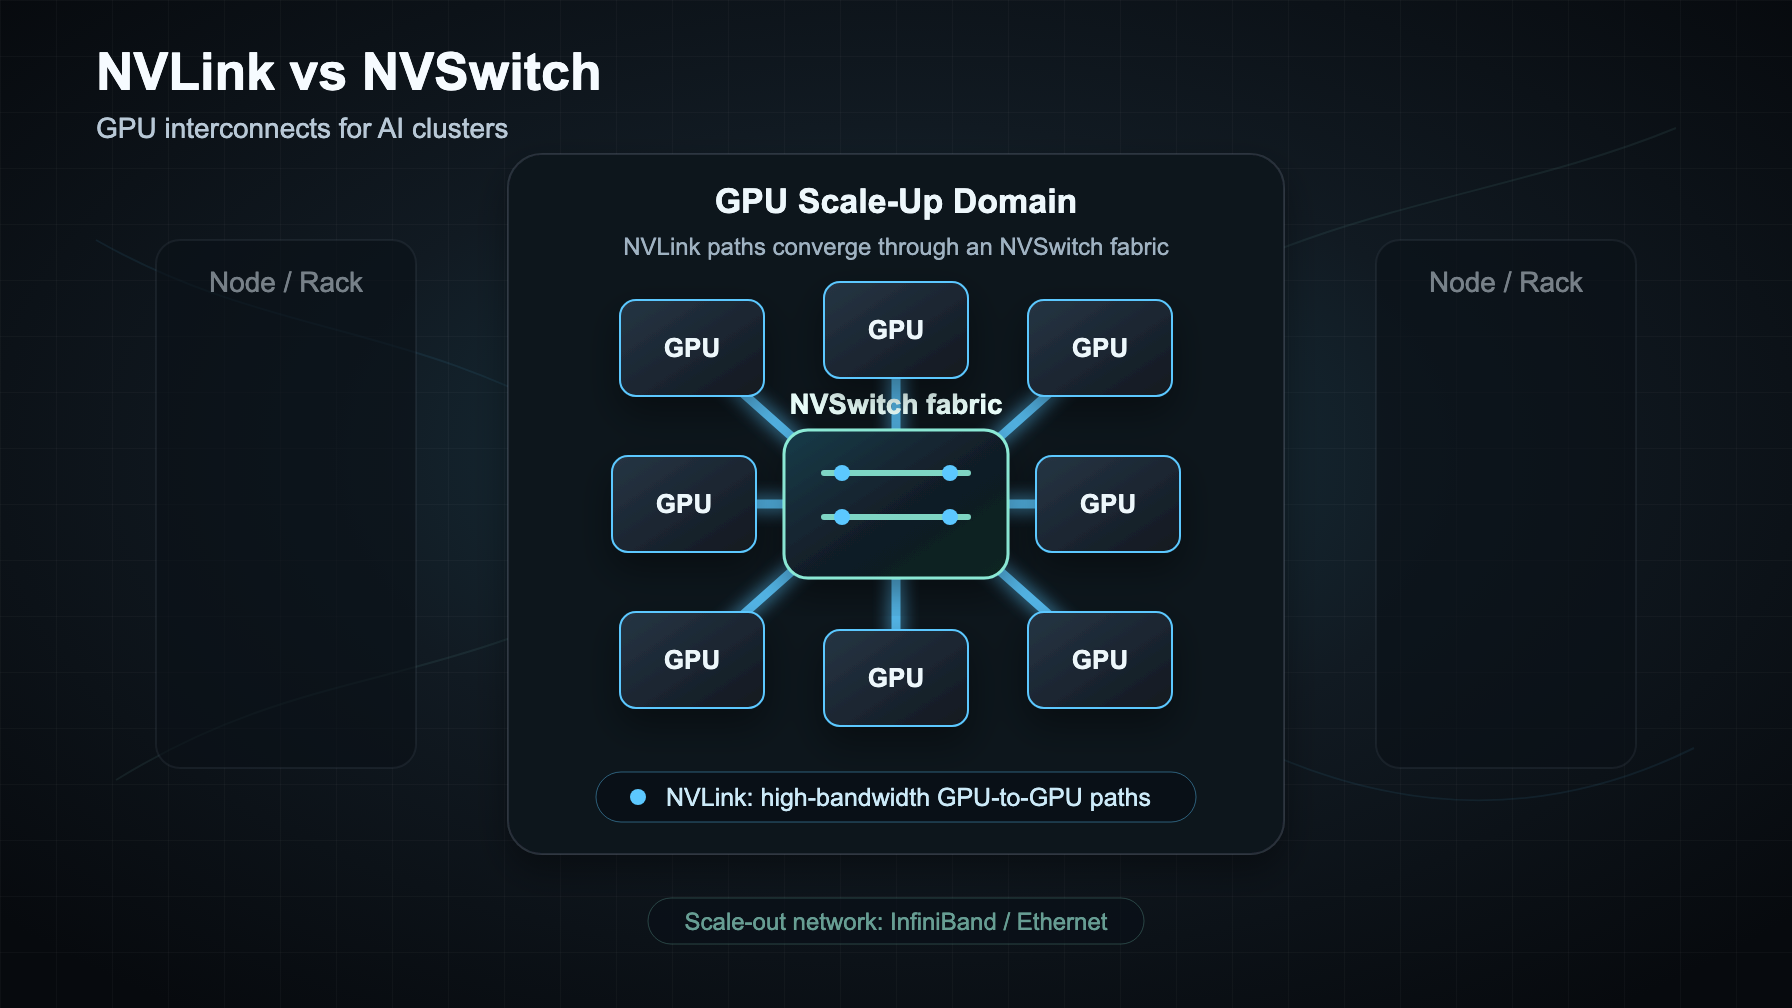
NVLink vs NVSwitch: Объяснение GPU-интерконнектов для AI-кластеров
NVLink — это связь GPU-to-GPU, NVSwitch — это fabric, а InfiniBand или Ethernet — это сеть для масштабирования. Вот как выбрать решение для AI-кластеров.
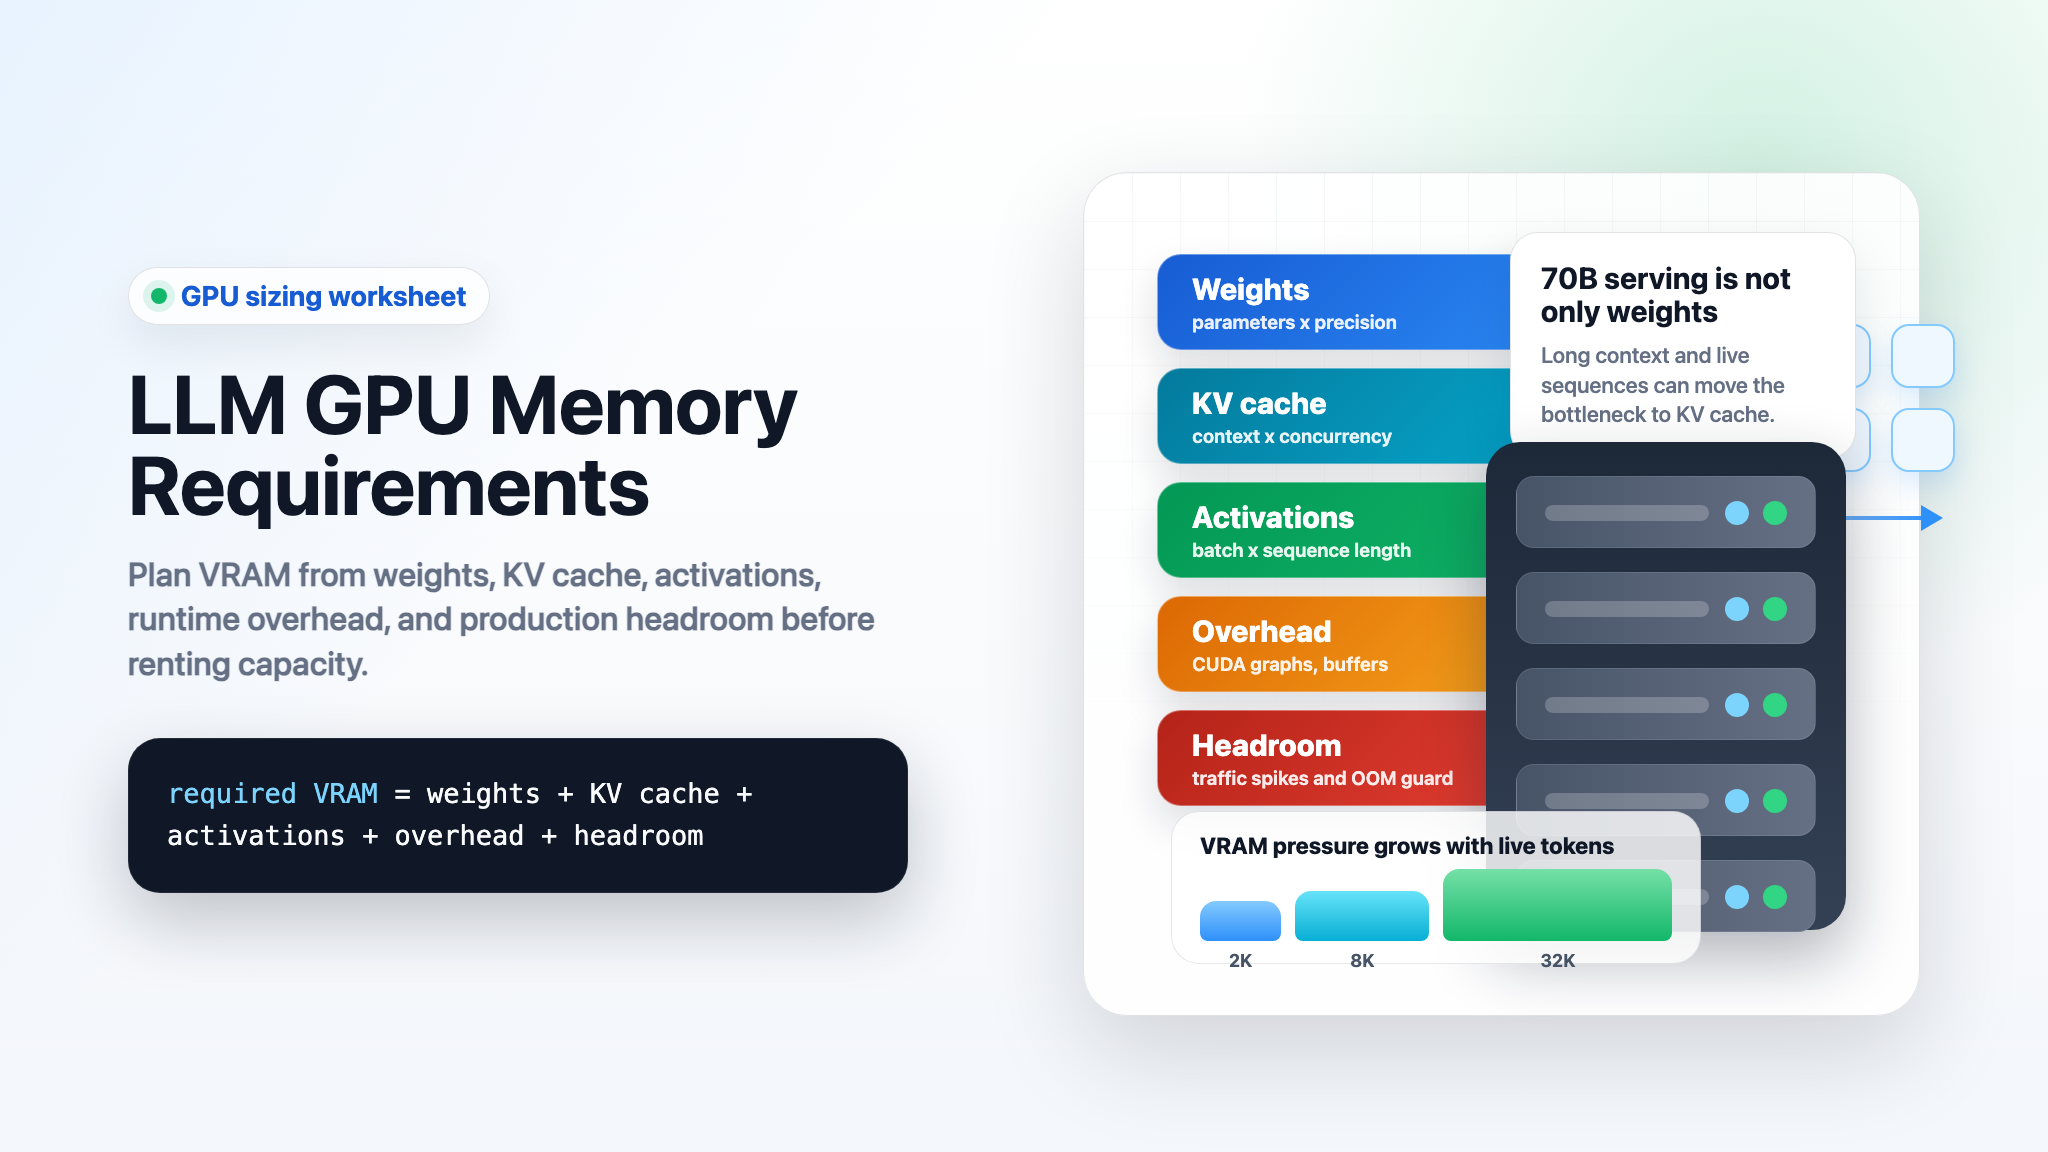
Требования к GPU-памяти для LLM: веса, KV-кэш, активации и накладные расходы
Практический рабочий лист для оценки требований LLM к памяти GPU: веса, KV-кэш, активации, накладные расходы при обслуживании, планирование vLLM для 70B, fine-tuning и обучение.
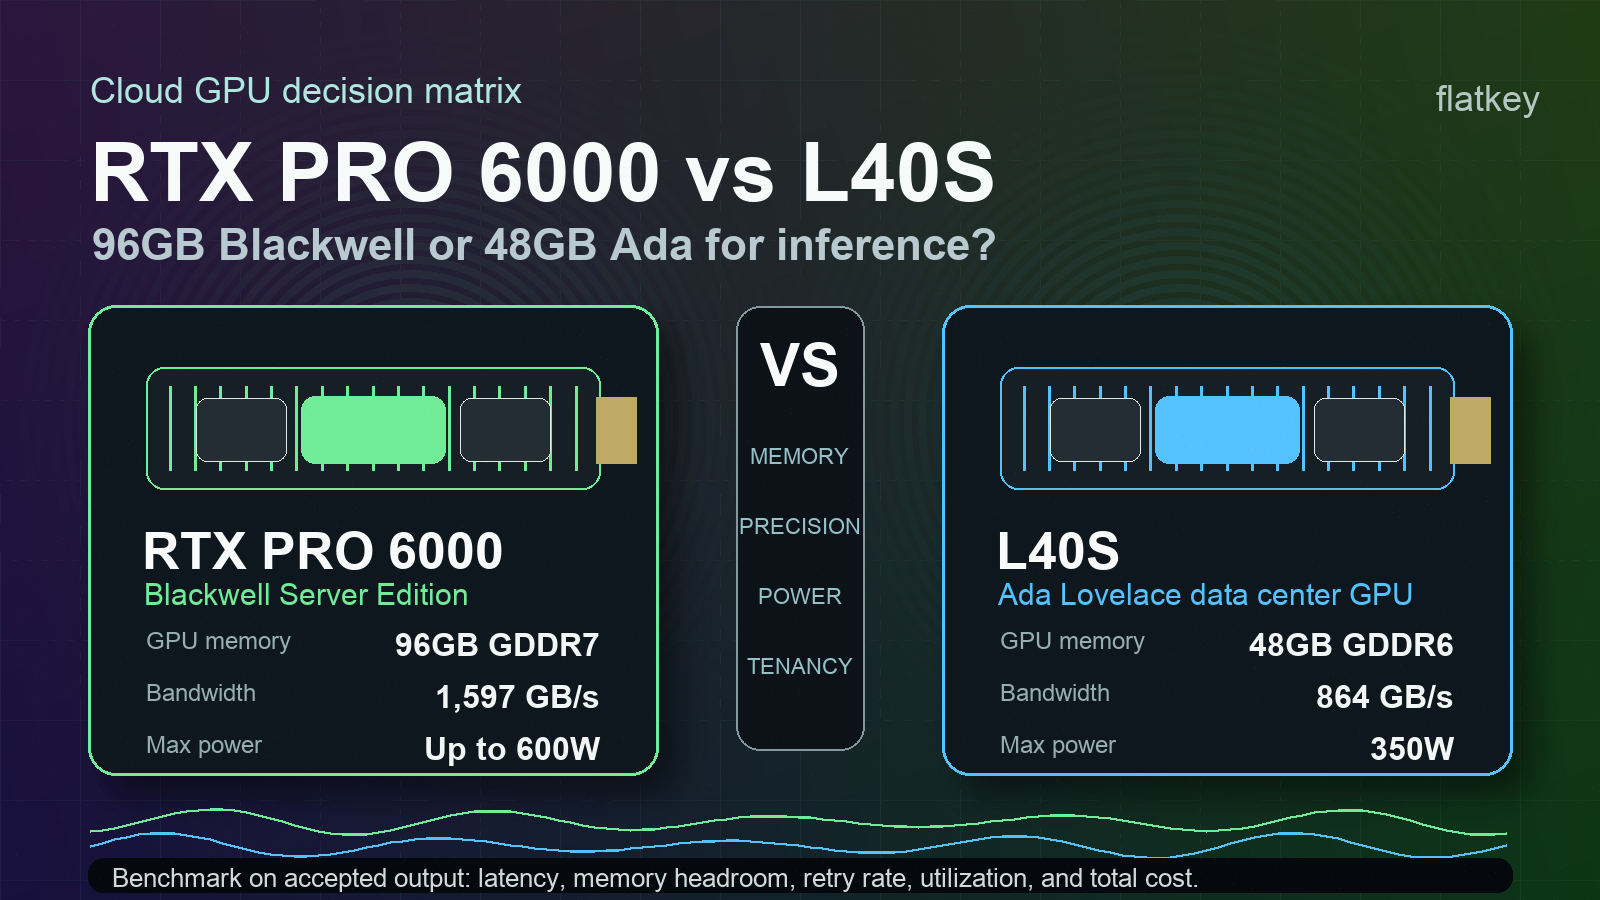
RTX PRO 6000 против L40S: 96 ГБ Blackwell или Ada GPU для инференса?
Сравните NVIDIA L40S и RTX PRO 6000 Blackwell Server Edition для инференса LLM, мультимодальных нагрузок, соответствия объёму памяти, энергопотребления и стоимости принятого выхода.
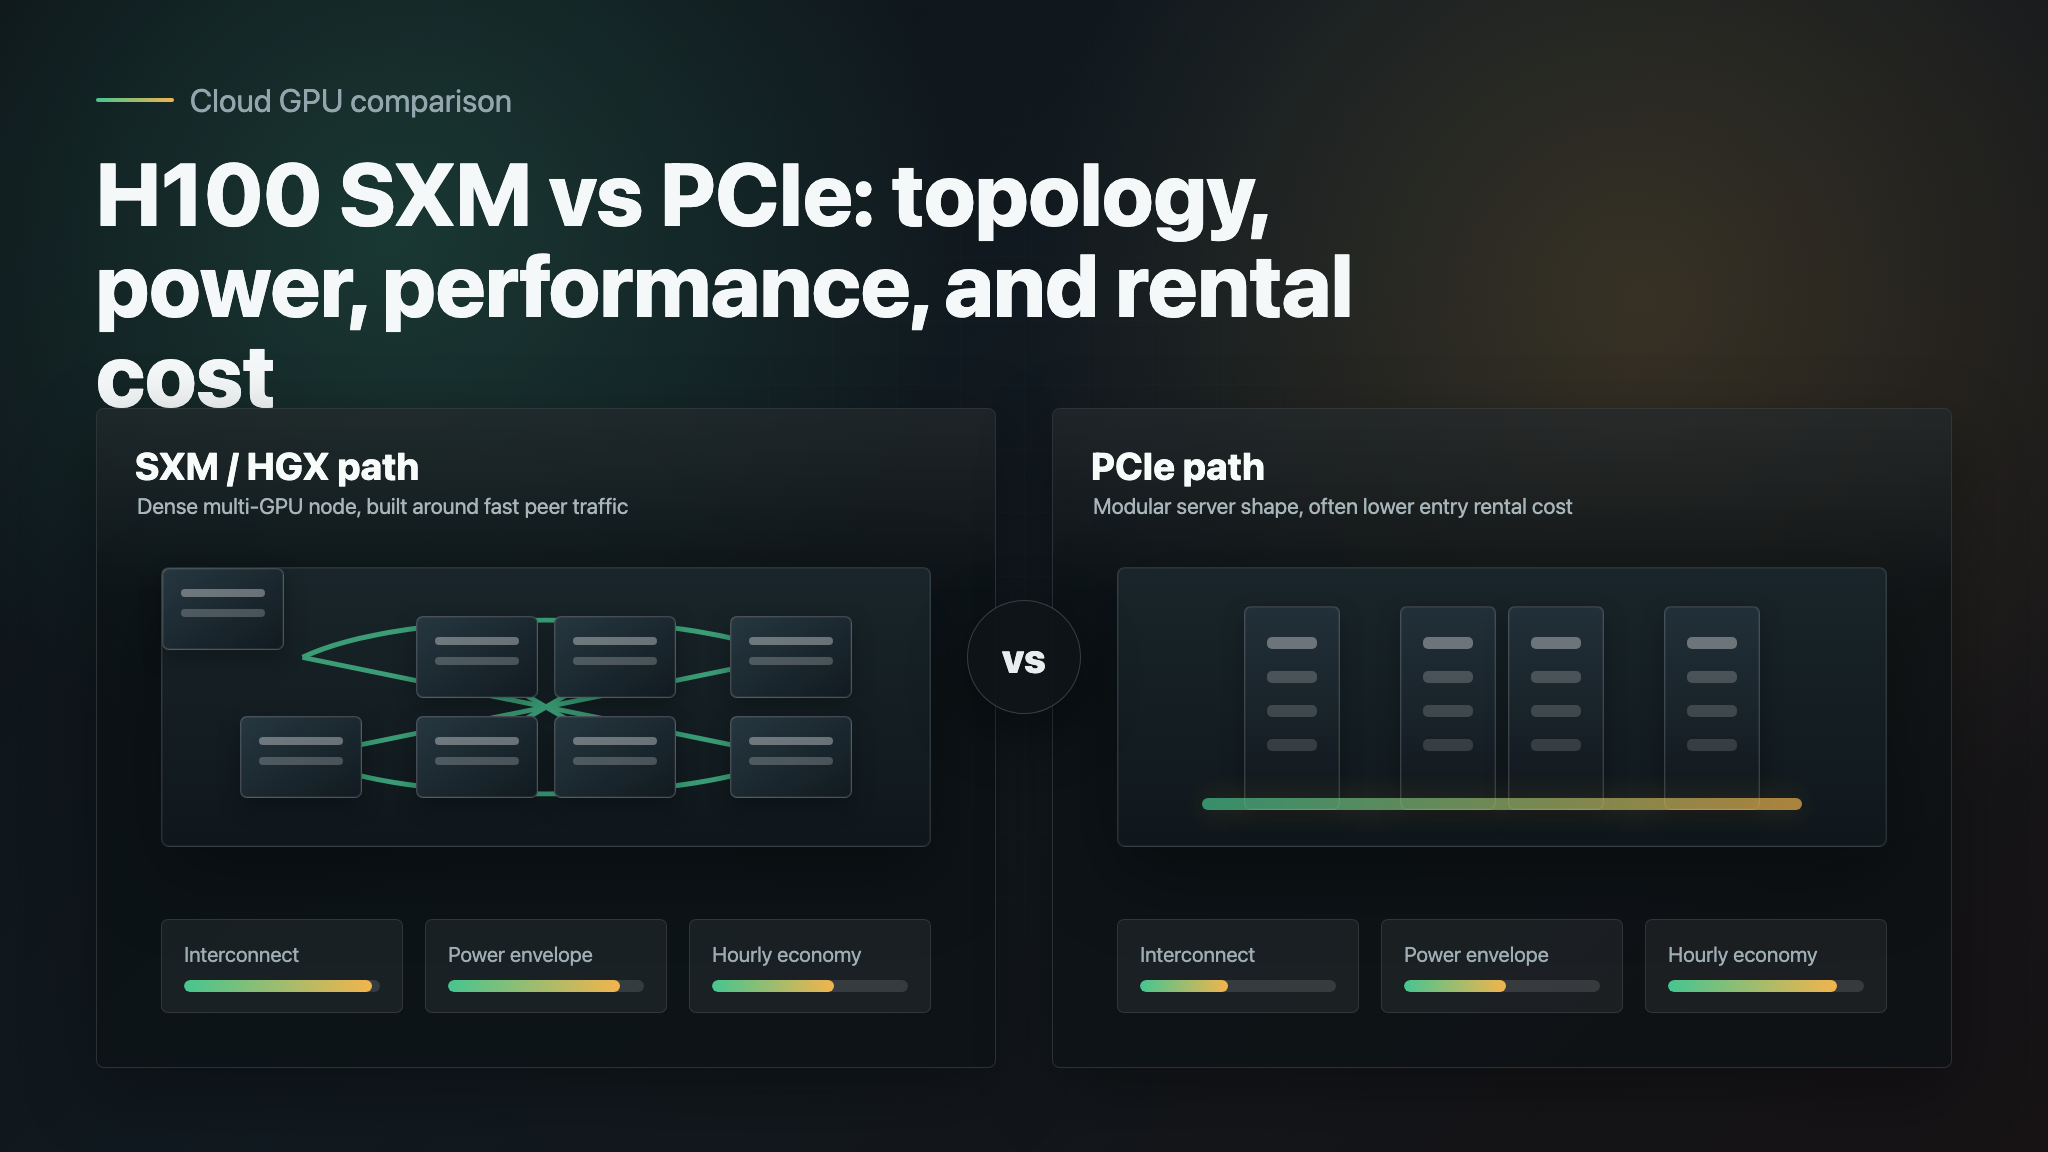
H100 SXM vs PCIe: NVLink, Power, Performance и стоимость аренды
Сравните H100 PCIe и SXM по NVLink, энергопотреблению, производительности рабочих нагрузок и стоимости аренды перед арендой облачных GPU.
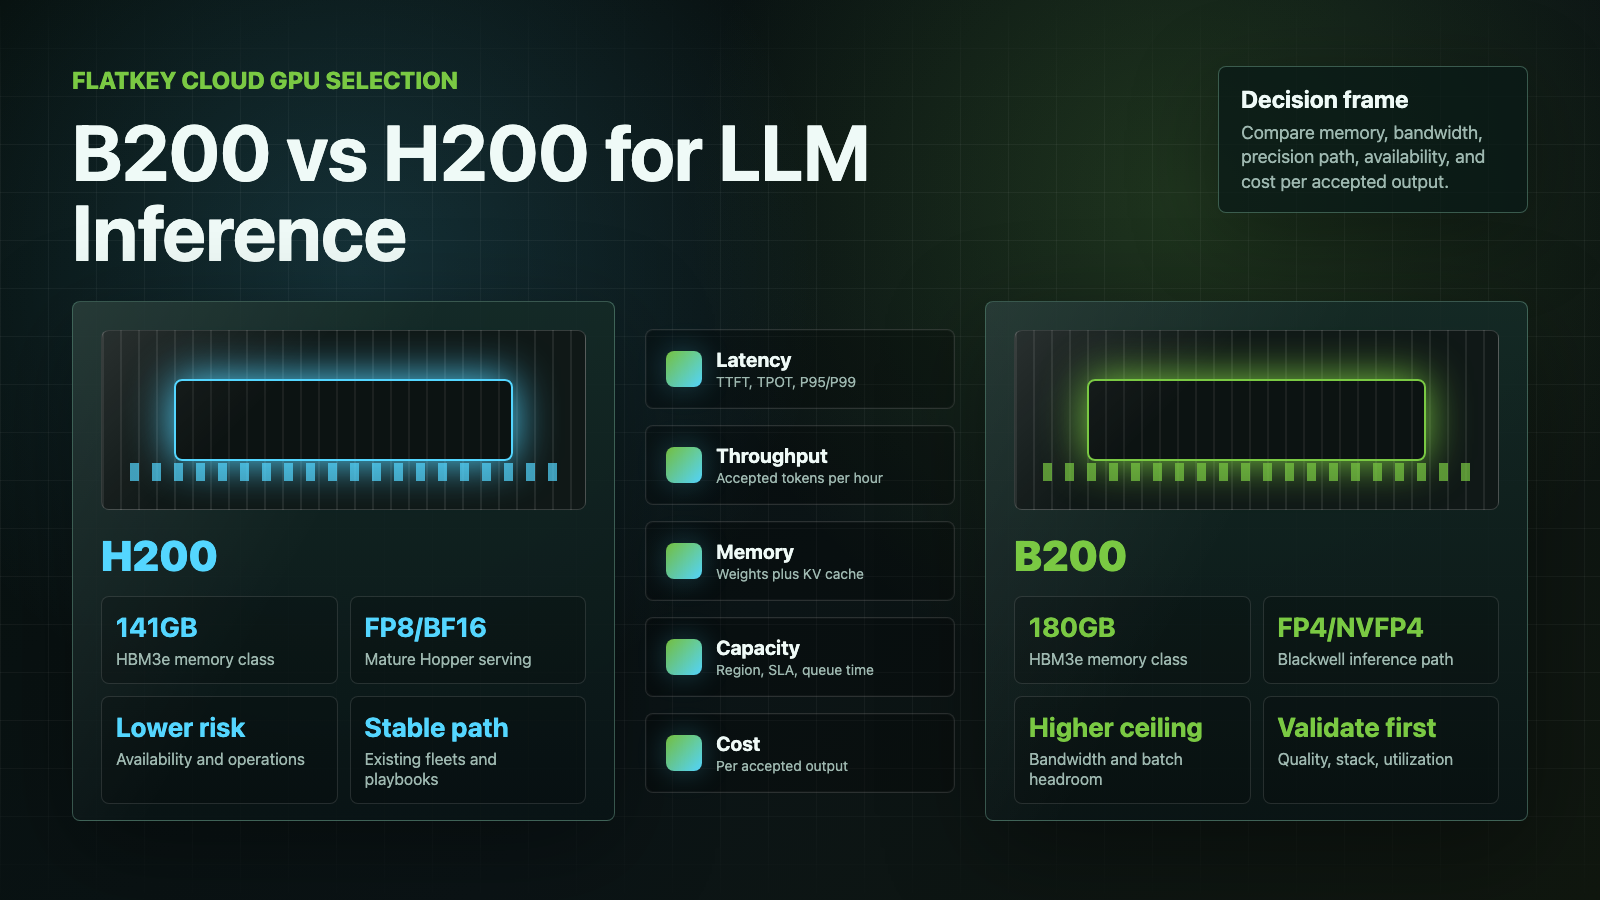
NVIDIA B200 против H200: какой GPU лучше для инференса LLM?
Сравните NVIDIA B200 и H200 для инференса LLM по объёму памяти, пропускной способности, поддержке точности, системам DGX, доступности облачных GPU и стоимости за принятый результат.
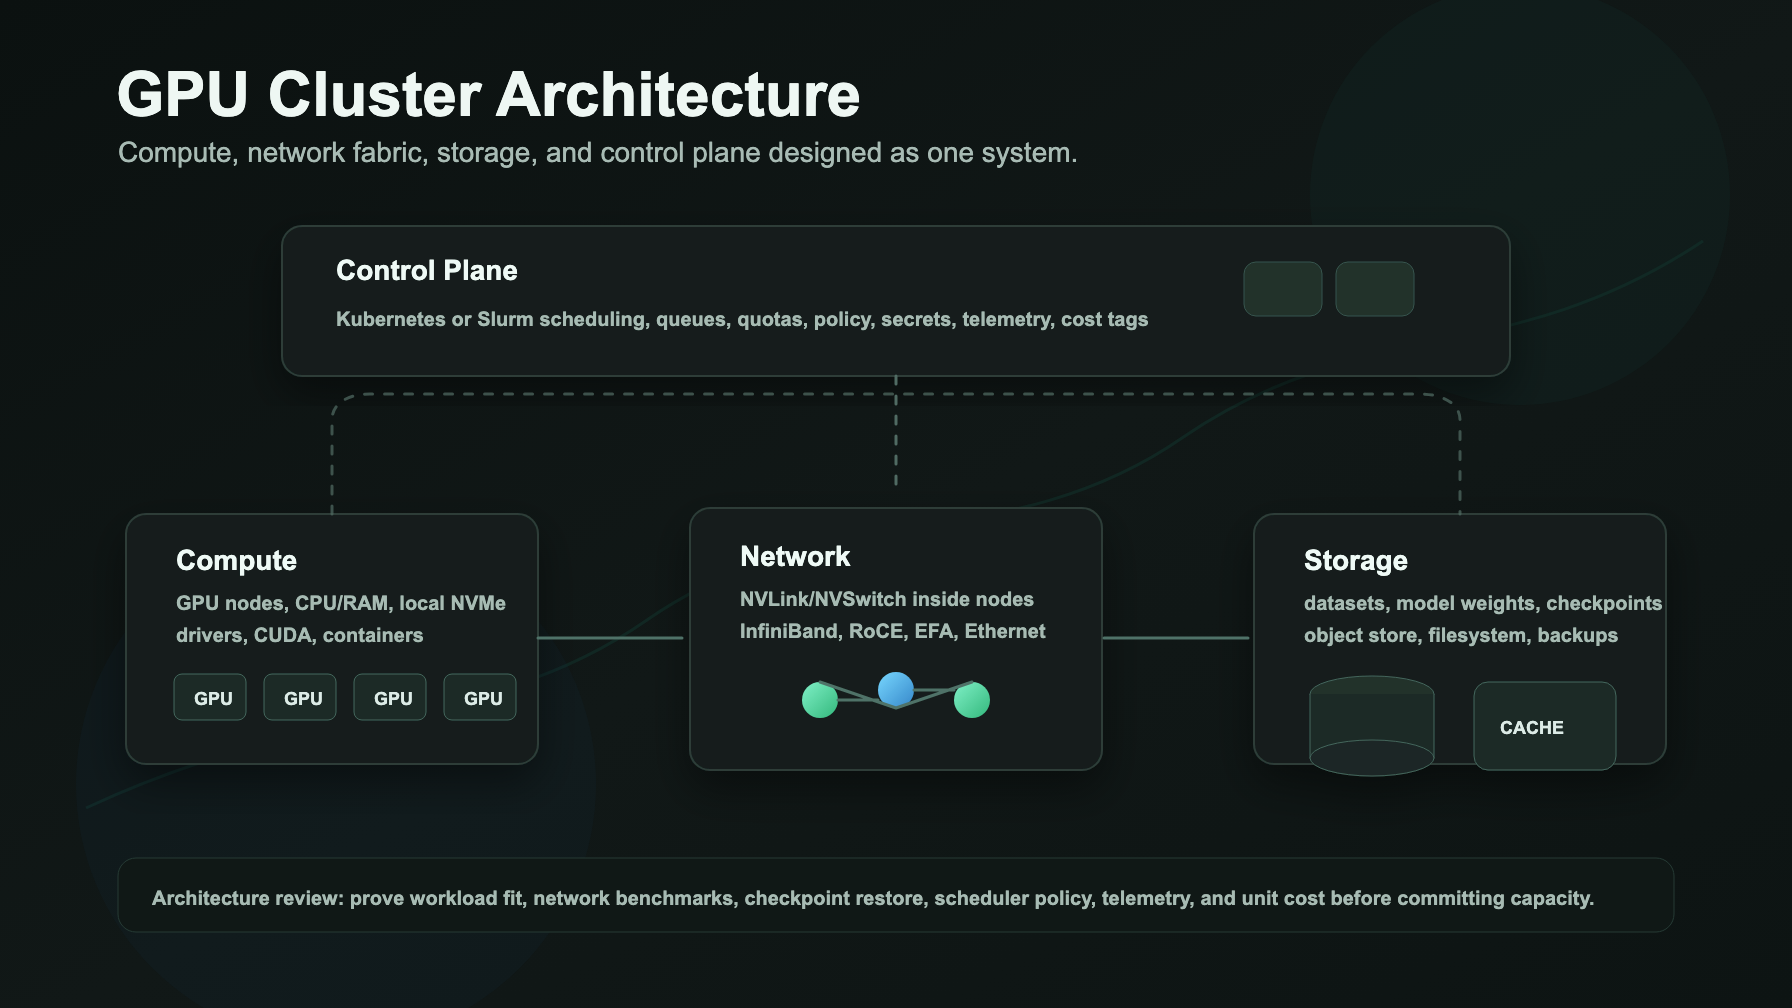
Архитектура GPU-кластера: вычисления, сеть, хранилище и control plane
Практическое руководство по архитектуре GPU-кластера: вычислительные узлы, сетевой fabric, хранилище, control plane Kubernetes или Slurm, наблюдаемость и приемочные тесты.
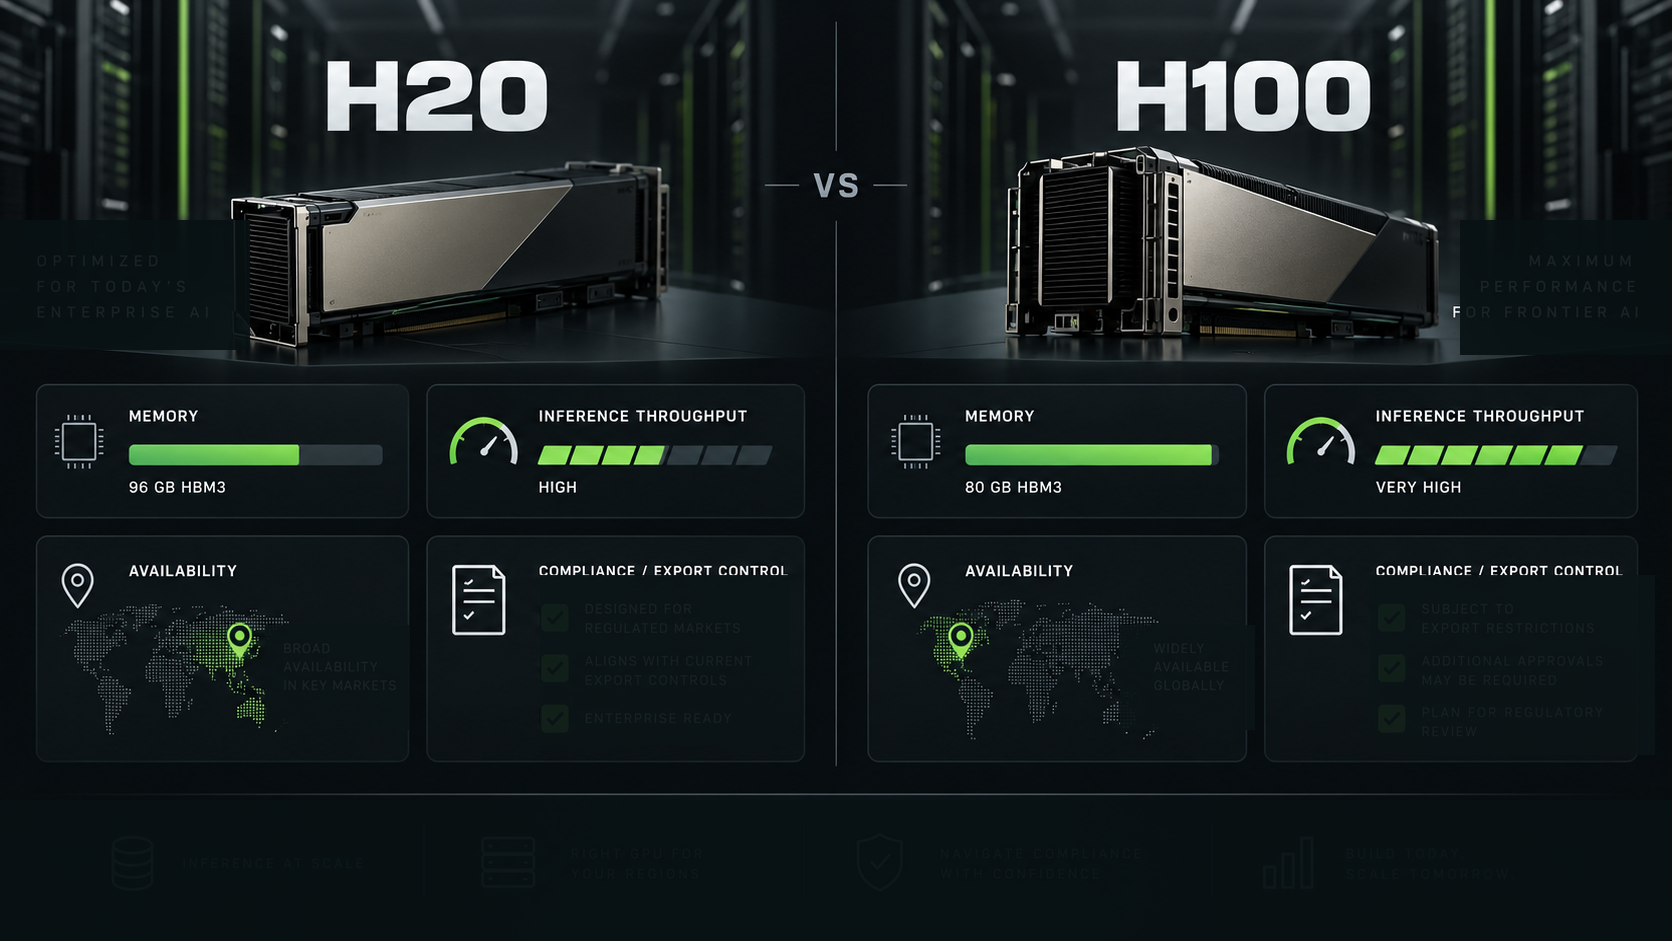
NVIDIA H20 vs H100: инференс, память, доступность и соответствие требованиям
Практическое сравнение H20 и H100 для корпоративных AI-команд: инференс, память, доступность, риски экспортного контроля и случаи, когда H200 или API моделей являются более удачной базой.
Лучшие платформы аренды облачных GPU 2026: цена, мощность, сеть и поддержка
Практическая подборка облачных GPU-платформ на 2026 год для AI-команд: сравнение ценовой политики, доступных мощностей, сети, поддержки и случаев, когда API модели — более удачная отправная точка.
NVIDIA Blackwell Ultra B300: Что изменилось по сравнению с B200?
Практический трекер NVIDIA B300 Blackwell Ultra для команд AI-инфраструктуры: сравнение характеристик B300, статуса выпуска, оговорок по цене и пригодности для рабочих нагрузок с B200.
AMD MI455X и Helios: трекер архитектуры, памяти и доступности
Трекер AMD MI455X и Helios для покупателей: архитектура, память HBM4, пропускная способность, доступность, готовность к vLLM, вопросы к провайдерам и стратегия резервного перехода на модели/API.
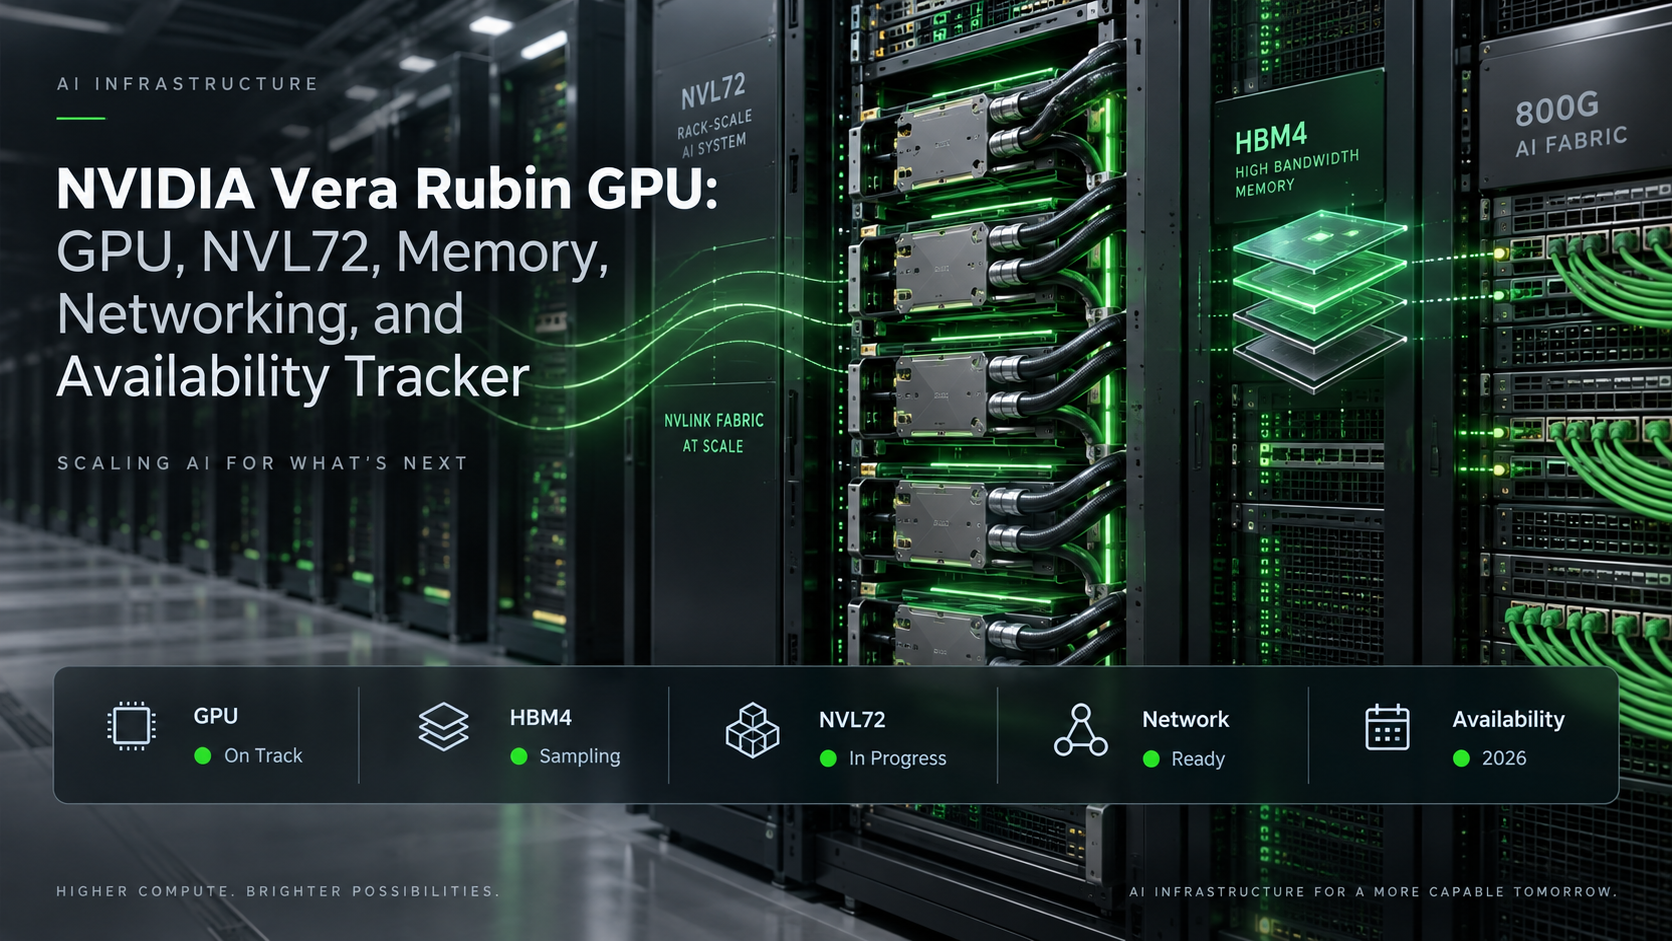
GPU NVIDIA Vera Rubin: трекер GPU, NVL72, памяти, сети и доступности
Актуальный трекер характеристик NVIDIA Vera Rubin GPU, DGX Vera Rubin NVL72, памяти HBM4, сетевых возможностей и этапов доступности для покупателей облачных GPU.
Цены OpenAI Image API: тарифы GPT Image 2.5, формула расчёта стоимости и контроль бюджета
Узнайте, как работает ценообразование OpenAI Image API для GPT Image 2.5, включая тарифы по токенам, правила кэшированного ввода, частичные изображения, Batch и стоимость за принятое изображение.
GB200 vs B200: суперчип Grace Blackwell или x86 HGX?
Сравните GB200 и B200 для закупки AI-инфраструктуры: системы Grace Blackwell масштаба стойки NVL72, узлы B200 HGX/x86, бенчмарки и проверка TCO.
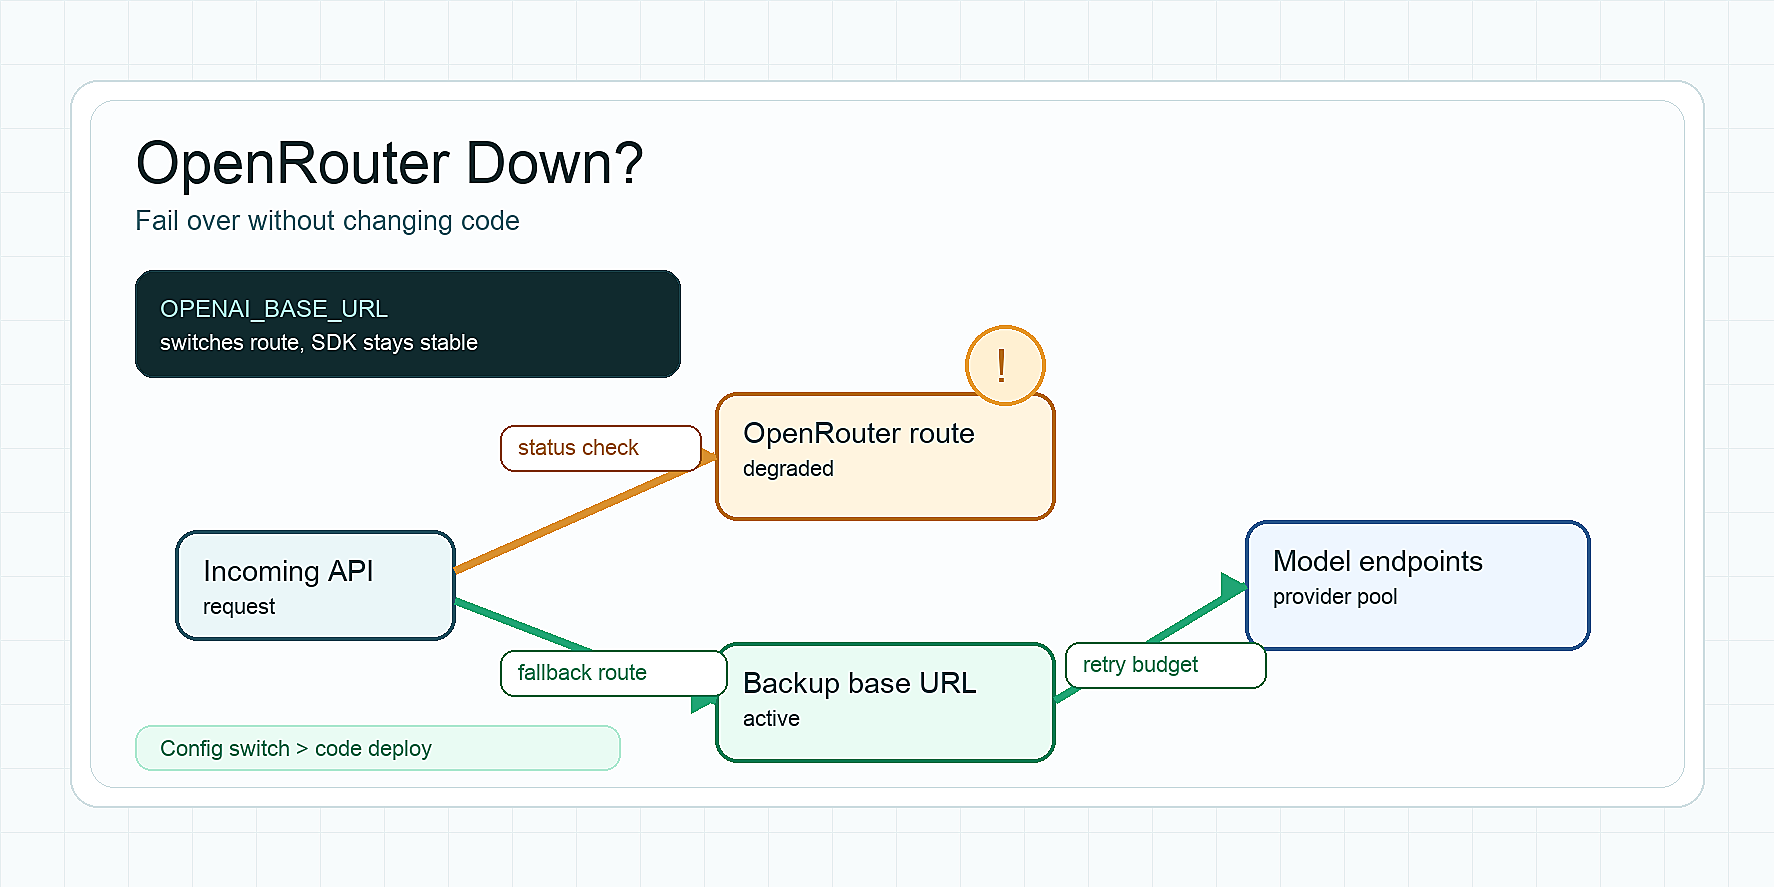
OpenRouter не работает? Как переключиться без изменения кода
Проверьте, не упал ли OpenRouter, отделяйте ошибки провайдера от инцидентов платформы и выполняйте переключение с помощью base_url, retries, fallback по провайдеру и fallback по модели.
Запускайте быстрее с единым AI-шлюзом.
Используйте flatkey.ai, чтобы управлять моделями, ключами, биллингом и наблюдаемостью на одной API-платформе.
Начать