
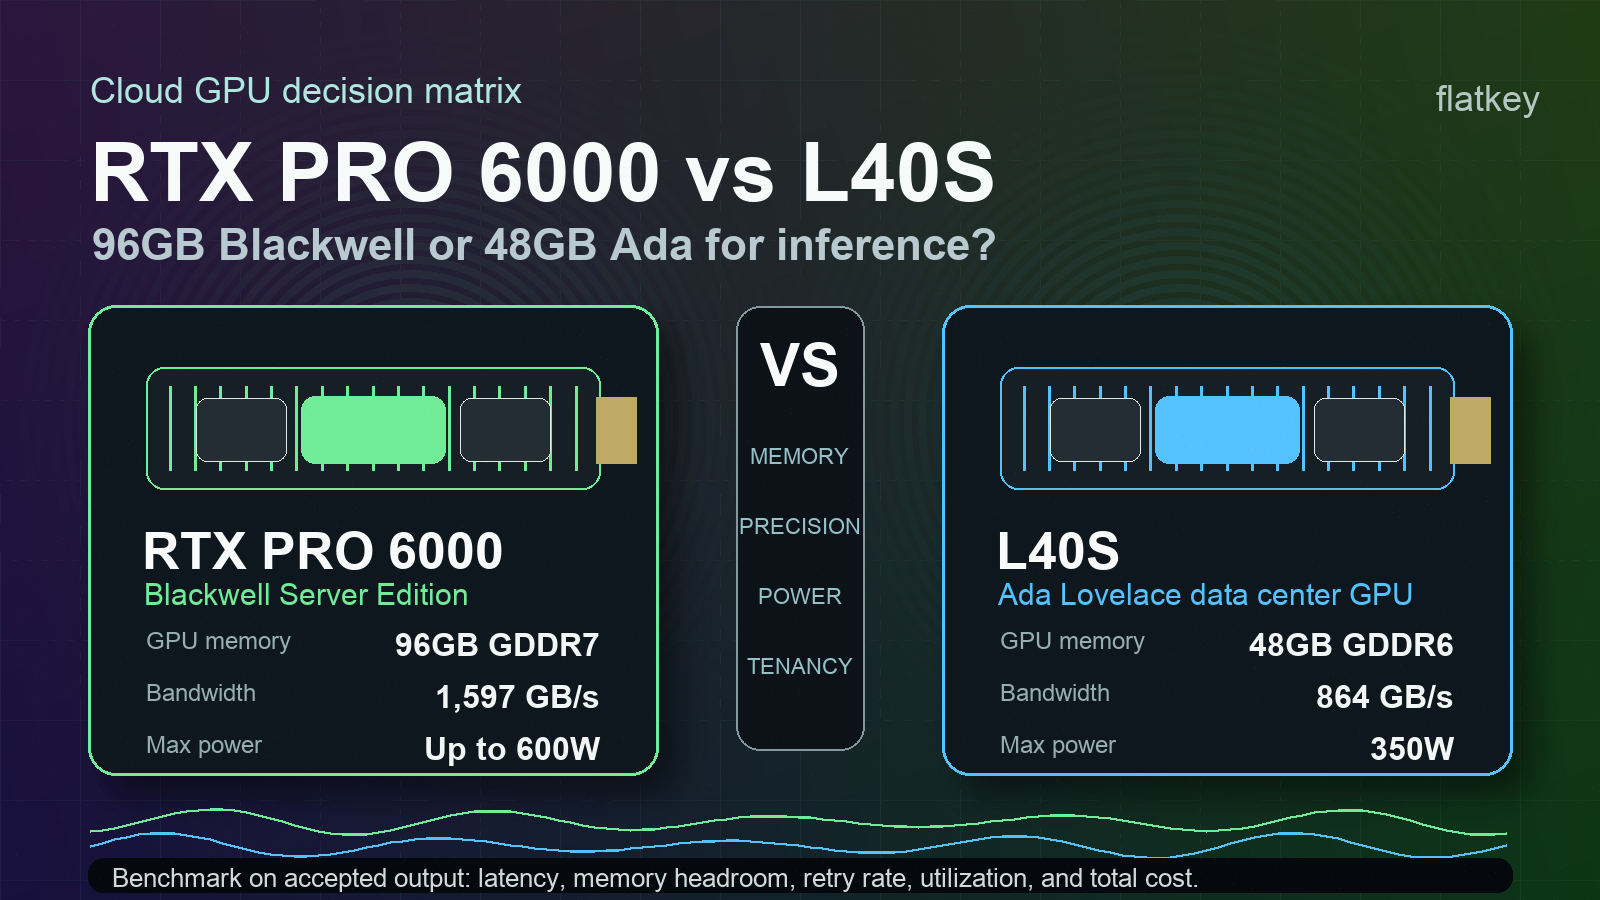
RTX PRO 6000 против L40S: 96 ГБ Blackwell или Ada GPU для инференса?
Короткий ответ для l40s vs rtx pro 6000: выбирайте NVIDIA RTX PRO 6000 Blackwell Server Edition, когда 96 ГБ памяти GPU, поддержка Blackwell FP4, PCIe Gen 5, разбиение MIG и более новые медиа-движки могут изменить вашу схему обслуживания. Выбирайте NVIDIA L40S, когда ваша рабочая нагрузка уже помещается в 48 ГБ, ваш стек зрелый на GPU Ada, а разрыв в цене или доступности достаточно велик, чтобы перевесить более новую карту.
Это не простое решение по принципу «новая GPU всегда лучше». Сравнение rtx pro 6000 vs l40s на самом деле сводится к соответствию объёма памяти, поддержке точности, зрелости ПО, бюджету по питанию и стоимости принятого результата. Если RTX PRO 6000 позволяет использовать меньше шардов, большие окна контекста, более крупные батчи или меньше повторных попыток из-за нехватки памяти, она может оказаться более сильной GPU для инференса. Если ёмкость L40S дешевле, её проще зарезервировать, и она уже соответствует вашему целевому latency, более старая карта Ada всё ещё может быть прагматичным выбором.
Проверено 13 октября 2026 года.
L40S vs RTX PRO 6000: практическая разница
Используйте эту таблицу как первый фильтр при закупке, прежде чем запрашивать бенчмарки у провайдера.
| Пункт решения | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| Поколение GPU | Blackwell | Ada Lovelace |
| Основная причина покупки | Больше памяти, более новые Tensor Cores, поддержка FP4, PCIe Gen 5, разбиение рабочих нагрузок | Зрелая 48-ГБ GPU для ЦОД для инференса, рендеринга, графики и видео |
| Память GPU | 96 ГБ GDDR7 с ECC | 48 ГБ GDDR6 с ECC |
| Пропускная способность памяти | 1 597 ГБ/с | 864 ГБ/с |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Заголовок по Tensor-точности | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1 466 TFLOPS с разреженностью, FP16/BF16 362,05 / 733 TFLOPS с разреженностью |
| Максимальная мощность | До 600 Вт, настраиваемо | 350 Вт |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | До четырёх изолированных экземпляров на RTX PRO 6000 | Поддержка MIG для L40S не указана |
| Лучший первый тест | Инференс LLM с длинным контекстом, более крупные мультимодальные модели, многопользовательское совместное использование GPU, обслуживание с оптимизацией под FP4/Blackwell | LLM, помещающиеся в 48 ГБ, генерация изображений в стиле Stable Diffusion, рендеринг, видео, зрелые парки Ada |
Источники: страница продукта NVIDIA RTX PRO 6000 Blackwell Server Edition, страница продукта NVIDIA L40S и страница архитектуры Blackwell от NVIDIA.
Краткая рекомендация
Начинайте бенчмарк l40s vs rtx pro 6000 с памяти, а не с пиковых TFLOPS.
- Выбирайте RTX PRO 6000 Blackwell Server Edition, когда ваша модель упирается в нехватку памяти на L40S, когда длина контекста или давление KV cache определяет число GPU, когда вы хотите протестировать пути инференса FP4/Blackwell или когда изолированные GPU-сегменты важны для общих корпоративных кластеров.
- Выбирайте L40S, когда ваша модель, размер батча и окно контекста комфортно помещаются в 48 ГБ, когда ваш production-стек уже настроен под Ada или когда разница в цене у провайдера достаточно велика, чтобы старая GPU выигрывала по стоимости принятого результата.
- Используйте базовый уровень API модели, когда вам не нужны собственные веса, контроль CUDA, частное планирование GPU или прямая ускоренная обработка медиа/рендеринга. Оборудование должно превзойти по стоимости и операционной простоте управляемые вызовы модели с учётом очереди, повторов, простоя и инженерных накладных расходов.
Именно поэтому решение nvidia rtx pro 6000 vs l40s не должно заканчиваться на спецификации. Более быстрая карта всё ещё может оказаться неверной покупкой, если загрузка низкая или команде не нужно самой заниматься эксплуатацией GPU.
Почему RTX PRO 6000 меняет разговор об инференсе
RTX PRO 6000 Blackwell Server Edition удваивает указанную ёмкость памяти по сравнению с L40S: 96 ГБ GDDR7 вместо 48 ГБ GDDR6. Кроме того, она увеличивает заявленную пропускную способность памяти с 864 ГБ/с у L40S до 1 597 ГБ/с.
Для команд инференса память — это не только «размер модели». Она также включает KV cache, запас для батчинга, буферы выполнения, адаптеры, мультимодальные входы, запас прочности для длинных промптов и накладные расходы многопользовательской среды. В реальном сервисе карта, которая избегает ошибок out-of-memory или уменьшает необходимость в tensor-parallel sharding, может превзойти более дешёвую карту с более низкой указанной почасовой стоимостью.
RTX PRO 6000 особенно стоит тестировать, когда:
- Вы обслуживаете трафик LLM с длинным контекстом, и KV cache доминирует в планировании памяти.
- Вы хотите протестировать модели класса 70B или больше в квантизованном виде с меньшим числом шардов.
- Вы запускаете смешанные мультимодальные нагрузки, где компоненты изображения, видео, embeddings, reranking и LLM конкурируют за память.
- Вам нужно разделить физическую GPU между несколькими пользователями или нагрузками; NVIDIA указывает до четырёх изолированных экземпляров MIG для RTX PRO 6000.
- Вы оцениваете пути обслуживания, специфичные для Blackwell, такие как FP4/NVFP4, TensorRT-LLM, vLLM или улучшения SGLang.
Компромисс по питанию реален. NVIDIA указывает RTX PRO 6000 как конфигурируемую до 600 Вт, тогда как L40S — 350 Вт. Если ваш провайдер рассчитывает стоимость по закреплённому серверу, энергетическому бюджету, плотности стойки или зарезервированной ёмкости, этот более высокий предел должен учитываться в модели затрат rtx 6000 pro vs l40s. Не сравнивайте почасовую цену GPU, не выяснив, что включено в питание, охлаждение, конфигурацию хоста, поддержку и многопользовательский режим.
Почему L40S всё ещё полезна
L40S по-прежнему остаётся сильной практической GPU, поскольку это зрелая дата-центровая карта Ada с 48 ГБ памяти ECC, пропускной способностью памяти 864 ГБ/с, максимальным энергопотреблением 350 Вт и широкой распространённостью в production. NVIDIA позиционирует L40S для генеративного ИИ, обучения и инференса LLM, графики, рендеринга, Omniverse и видеонагрузок.
Эта зрелость важна при закупках в облаке. Немного более старая карта может выиграть, когда:
- Доступность есть прямо сейчас именно в том регионе, который вам нужен.
- Образы, драйверы, контейнеры и мониторинг у провайдера уже стабильны.
- Нагрузка помещается в 48 ГБ без агрессивного шардирования.
- Ваше узкое место — время ожидания в очереди, загрузка данных, CPU-препроцессинг или программное планирование, а не пиковая производительность Tensor Core.
- Вы запускаете генерацию изображений, рендеринг, видео или задачи визуальных вычислений, которые уже хорошо бенчмаркаются на Ada.
Вопрос nvidia l40s vs rtx pro 6000 часто сводится к тому, меняют ли дополнительные 48 ГБ на RTX PRO 6000 схему развёртывания. Если нет, L40S может быть вариантом аренды или резервированной ёмкости с меньшим риском, особенно для команд с уже существующими скриптами и базовыми метриками.
Матрица принятия решений по типам нагрузок
Используйте эту матрицу, прежде чем запрашивать у провайдера коммерческое предложение.
| Нагрузка | Предпочтительнее RTX PRO 6000, когда... | Предпочтительнее L40S, когда... | Что измерять |
|---|---|---|---|
| Инференс LLM с длинным контекстом | 48 ГБ ограничивают длину контекста, размер батча или запас для KV cache | 48 ГБ удовлетворяют целям p95 по контексту и конкуренции | Время до первого токена, токены/с, задержка p95, частота OOM, принятые ответы/час |
| Обслуживание квантизированной модели класса 70B | 96 ГБ уменьшают шардирование, повторные попытки или сложность размещения | Ваша квантизированная модель и KV cache помещаются на L40S при целевой конкуренции | Число GPU на реплику, задержка в очереди, оценка качества, частота повторных попыток |
| Мультиарендный инференс | Изоляция MIG и 96 ГБ памяти повышают утилизацию | Разделение арендаторов выполняется на уровне узла или планировщика | Утилизация по арендаторам, инциденты из-за «шумного соседа», неудачные задания |
| Stable Diffusion и генерация изображений | Более крупные модели, батчи или этапы с мультимедиа требуют больше памяти | Существующие пайплайны уже достигают целевых показателей пропускной способности и качества | Принятые изображения/час, запас VRAM, стоимость за принятое изображение |
| Рендеринг и 3D-графика | Функции Blackwell RT/media улучшают именно ваш рендерер или пайплайн | Производительность Ada L40S уже подтверждена для этого рендерера | Время кадра/рендера, неудачные рендеры, пропускная способность кодирования/декодирования медиа |
| Корпоративное обновление парка | Вам нужна платформа эпохи Blackwell на следующие 24 месяца | Вам нужна дополнительная ёмкость с известной эксплуатационной моделью | Минимальная утилизация, трудозатраты на миграцию, SLA поддержки, доступность ёмкости |
Это полезный способ формулировать l40s vs rtx 6000 pro: не какой продуктовый лист выглядит внушительнее, а какая GPU увеличивает число принятых результатов, которые вы можете поставлять на каждый доллар.
Бенчмаркайте принятый результат, а не пиковые характеристики
Серьёзный бенчмарк l40s vs rtx pro 6000 должен воспроизводить вашу рабочую нагрузку, а не опираться на общие пики. Измеряйте тот результат, который ваши пользователи или клиенты действительно принимают.
Для LLM-инференса собирайте:
| Метрика | Почему это важно |
|---|---|
| Время до первого токена | Отражает интерактивную задержку для пользователя |
| Межтокенная задержка | Показывает поведение декодирования при реальной конкуренции |
| Стабильная конкуренция | Показывает, меняют ли 48 ГБ или 96 ГБ стратегию батчинга |
| Лесенка длины контекста | Позволяет определить, когда возникает давление на KV cache |
| Частота OOM и повторных попыток | Переводит соответствие по памяти в реальные затраты |
| Принятые ответы в час | Нормализует фильтры качества, сбои и повторы |
| Стоимость за 1 млн принятых выходных токенов | Позволяет RTX PRO 6000, L40S и API моделей использовать одну метрику |
| Инженерные часы в месяц | Учитывает трудозатраты на драйверы, ядра, очереди, инциденты и бенчмарки |
Для задач с изображениями, видео, рендерингом или мультимодальностью заменяйте принятые токены на принятые изображения, принятые клипы, отрендеренные кадры или завершённые задания. Логика та же. Карта, которая выглядит быстрее в вендорском бенчмарке, может проиграть, если она увеличивает конкуренцию в очереди, создаёт больше неудачных заданий или требует программной миграции, которую ваша команда не сможет поддерживать.
Вопросы к провайдеру перед арендой RTX PRO 6000 или L40S
Задайте эти вопросы до выбора любой из GPU:
- Является ли ёмкость RTX PRO 6000 именно Blackwell Server Edition, и она воздушного охлаждения с двухслотовым исполнением или жидкостного охлаждения с однослотовым исполнением?
- Является ли ёмкость L40S выделенной, дробной, контейнеризованной или частью управляемого сервиса заданий?
- Какие версии драйвера, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch и контейнеров поддерживаются?
- Предоставляет ли провайдер MIG на RTX PRO 6000, и как тарифицируются экземпляры?
- Тарифицируются ли тестовые прогоны по on-demand тарифам, по reserved-тарифам или они включены в оценочное окно?
- Каковы регион, сетевая фабрика, CPU хоста, класс хранилища и локальная ёмкость NVMe?
- Отдельно ли тарифицируются неудачные задания, простой, время в очереди, снапшоты и исходящий трафик?
- Какой SLA поддержки и путь замены применяются, когда GPU-хост неисправен?
- Можно ли экспортировать по каждому заданию использование GPU, потребление памяти, задержку в очереди, частоту повторных попыток и стоимость?
- Каков путь запасного варианта, если доступность Blackwell, драйверы или ядра отстают от вашего графика запуска?
Сопоставьте эти ответы с руководством Flatkey по ценам аренды GPU, таблицей расчёта TCO GPU-кластера и сравнением GPU cloud и model API. Если вы всё ещё выбираете класс GPU, прочитайте более широкое руководство лучшая GPU для инференса LLM перед тем, как сузить выбор до nvidia l40s vs rtx pro 6000.
Где Flatkey вписывается
Flatkey не заменяет RTX PRO 6000 или L40S, когда вам нужен прямой контроль над GPU. Если вы используете приватные веса, собственные ядра, строгую локализацию данных, выделенные пайплайны рендеринга или исследования на уровне железа, вам по-прежнему нужна облачная GPU-мощность или собственная инфраструктура.
Flatkey — это базовый ориентир, который нужно превзойти, когда вашей команде в основном нужен надёжный вывод модели. С одним ключом и одним балансом для официальных моделей и AI-инструментов команды могут направлять API-нагрузки, отслеживать использование, сравнивать стоимость моделей и избегать разрозненных аккаунтов у разных провайдеров. Это даёт финансам и инженерным командам чистую контрольную группу перед тем, как брать на себя фиксированную GPU-мощность.
На практике оцените три пути:
| Путь | Когда он выигрывает |
|---|---|
| RTX PRO 6000 | Больше памяти или функции Blackwell уменьшают число GPU, отказов или задержку настолько, что это компенсирует более высокую стоимость |
| L40S | 48 ГБ достаточно, а зрелая мощность Ada даёт лучшую цену за принятый результат |
| Управляемый model API через Flatkey | Прямой контроль над GPU не нужен, а простота эксплуатации важнее владения инфраструктурой |
Правильный победитель — это путь с наименьшей стоимостью за принятый результат при ваших целевых показателях качества и задержки.
Итоговая рекомендация
Для l40s vs rtx pro 6000 сначала рассматривайте RTX PRO 6000, если запас по памяти, поддержка FP4/Blackwell, PCIe Gen 5 или разбиение MIG могут изменить архитектуру обслуживания. Сначала рассматривайте L40S, если рабочая нагрузка уже помещается в 48 ГБ, а зрелая Ada-ёмкость дешевле или её проще зарезервировать.
Затем сравните оба варианта с базовым уровнем model/API. Если Flatkey или другой управляемый маршрут через API обеспечивает качество, задержку, конфиденциальность и стоимость, аренда GPU должна оправдать дополнительные операционные затраты. Если нет, аппаратный путь оправдан, а окончательный выбор сводится к повторному прогону нагрузки: rtx pro 6000 vs l40s по принятым результатам, а не по маркетинговым пикам.
Часто задаваемые вопросы
RTX PRO 6000 Blackwell быстрее, чем L40S?
По публичным спецификациям NVIDIA RTX PRO 6000 Blackwell Server Edition имеет более высокую заявленную производительность FP32, больше памяти, более высокую пропускную способность памяти, более новые Tensor Cores и поддержку FP4. Это не означает, что он дешевле для каждой нагрузки. Проведите бенчмарк вашего конкретного стека обслуживания и стоимости за принятый результат.
L40S всё ещё хорош для инференса LLM?
Да, если модель, размер контекстного окна и целевая конкуррентность помещаются в 48 ГБ. L40S по-прежнему может быть практичным для инференса LLM, генерации изображений, рендеринга, видео и смешанных workload'ов визуальных вычислений, особенно там, где мощности провайдера зрелые.
Какое самое большое различие между NVIDIA RTX PRO 6000 и L40S?
Самое большое практическое различие — это память. RTX PRO 6000 Blackwell Server Edition указывает 96 ГБ GDDR7 и пропускную способность памяти 1,597 ГБ/с; L40S указывает 48 ГБ GDDR6 и пропускную способность памяти 864 ГБ/с. RTX PRO 6000 также добавляет путь Blackwell FP4 и поддержку MIG.
Стоит ли обновляться с L40S до RTX PRO 6000?
Обновляйтесь, когда ограничения памяти L40S создают дополнительные шарды, меньшие батчи, более короткие контекстные окна, сбои заданий или низкую загрузку. Оставайтесь на L40S, когда он уже соответствует вашим целям по задержке и качеству при более низкой стоимости за принятый результат.
Стоит ли использовать model API вместо аренды любой из этих GPU?
Используйте model API, когда вам не нужны собственные веса, прямой контроль CUDA, частное планирование GPU или ускорение рендеринга/медиа. Model API может быть более выгодным экономически, когда спрос на нагрузку нестабилен или загрузка GPU была бы низкой.
Проверенные источники
- Страница продукта NVIDIA RTX PRO 6000 Blackwell Server Edition
- Страница продукта NVIDIA L40S
- Страница архитектуры NVIDIA Blackwell
- Карта тем Flatkey Cloud GPU и исходник ключевого слова Cloud GPU с датой 2026-10-10
- Обзор продукта Flatkey и утверждённое позиционирование: один ключ, один баланс, официальные модели, журнал использования по модели оплаты за успешный вызов


