
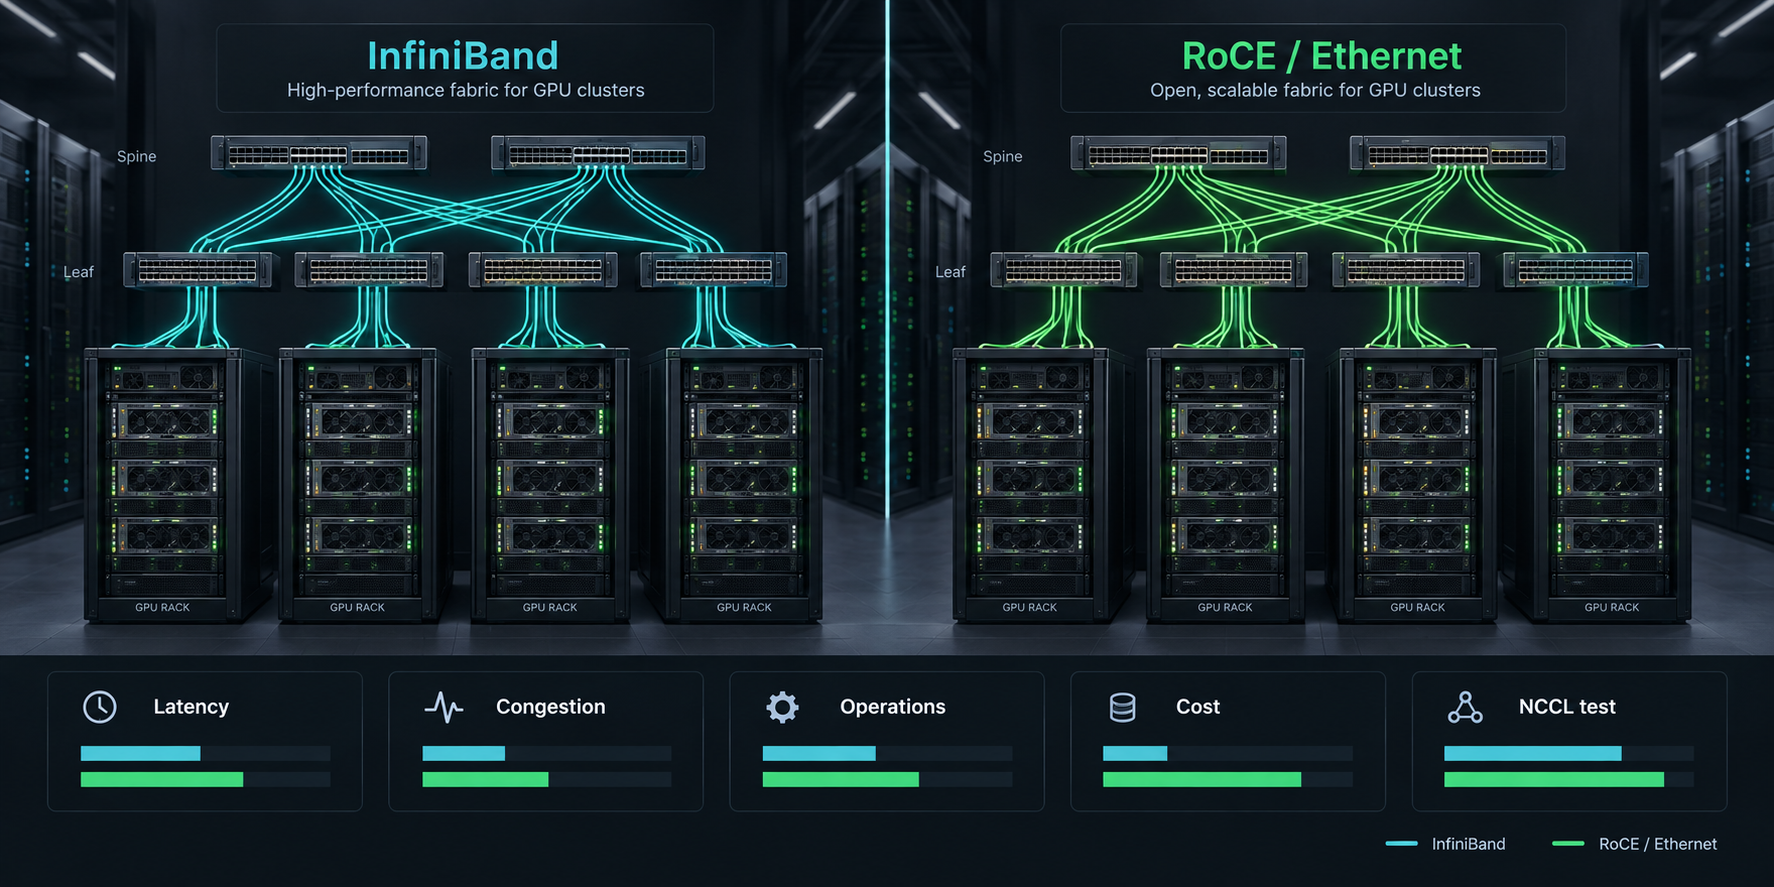
RoCE 対 InfiniBand の議論は、たいてい出発点を間違えています。比較すべきなのはプロトコル名ではなく、GPU クラスターが何に耐えなければならないかです。つまり、緊密に結合されたトレーニング、シャーディングされた推論、共有ストレージのトラフィック、混在テナント、調達制約、そして立ち上げ後にファブリックを調整する運用チームです。
マルチノード GPU クラスターでは、ワークロードがレイテンシーに敏感で、collective 通信が多く、専用の AI/HPC ファブリックを正当化できる規模なら、通常は InfiniBand がより安全な既定値です。すでに高速 Ethernet を運用していて、より広いベンダー選択肢を求め、導入前に実際の NCCL テストでロスレス Ethernet 設計を証明できるなら、通常は RoCE のほうがより良い出発点です。
難しいのは、どちらも動くし、どちらも失敗しうることです。適切に構築された RoCE v2 ファブリックは、本格的な AI クラスターを稼働させられます。一方で、運用のまずい InfiniBand ファブリックでも学習ウィンドウを逃すことがあります。このガイドでは、roce vs infiniband をレイテンシー、運用、コストの観点から比較し、プラットフォームチームが最も声の大きいベンダーのスライドではなく、ワークロードに合ったファブリックを選べるようにします。
RoCE vs InfiniBand の簡易回答
最初の意思決定フィルターとして、この表を使ってください。
| 状況 | 通常はまず採用するもの | 理由 |
|---|---|---|
| 頻繁な all-reduce トラフィックを伴う大規模分散学習 | InfiniBand | 低レイテンシー、高帯域幅の HPC および AI 通信向けに設計された専用のスイッチド・ファブリックだからです。 |
| GPU クラスターの見積もりに、検証済みの NVIDIA Quantum などの InfiniBand ファブリックがすでに含まれている | InfiniBand | リスクは設計から受け入れテストとベンダーの証明へ移ります。 |
| 企業ネットワークチームが、深い Ethernet 自動化、監視、調達上の優位性をすでに持っている | RoCE | RoCE は RDMA を Ethernet に載せますが、規律ある輻輳制御とロスレス動作が必要です。 |
| AI、ストレージ、通常のデータセンタートラフィックが 1 つの運用モデルに混在する | RoCE または分離した Ethernet と専用 AI ファブリック | RoCE は Ethernet 運用と整合しやすいですが、共有ファブリックは慎重に設計する必要があります。 |
| 小規模な推論基盤、バッチジョブ、またはノード間でスケールしないワークロード | どちらのファブリックも決定要因にすべきではない | GPU メモリ、利用率、キューイング、モデル/API の代替案のほうがインターコネクトより重要です。 |
| 調達で最大限のベンダー多様性と標準的なスイッチ調達が必要 | RoCE | Ethernet の調達はより幅広くできますが、InfiniBand クラスターはより垂直統合的です。 |
| チームに RDMA ファブリックの経験がなく、ベンチマークの時間もない | まず借りて、次に決める | NCCL、障害、可観測性のテストに合格するまで、マルチノード契約に署名しないでください。 |
実務的な答えはこうです。アプリケーションが、プロトコルレベルの調整リスクが最も少ない専用 AI/HPC ファブリックを必要とするなら InfiniBand を選びます。Ethernet の標準化、調達の柔軟性、既存運用の重要性が、追加のファブリック設計作業に見合うなら RoCE を選びます。
GPU クラスターにおける InfiniBand の意味
InfiniBand は、サーバーとストレージを相互接続するために使われる業界標準のスイッチド・ファブリックアーキテクチャです。GPU クラスターでは、低レイテンシー、高帯域幅、RDMA、GPU Direct RDMA、適応ルーティング、輻輳管理、ベンダー統合型の AI/HPC ツール群と結び付けられることが一般的です。
重要なのは、InfiniBand が速いということだけではありません。重要なのは、それがファブリックとして構築されている点です。サブネット管理、ファブリックレベルの挙動、仮想レーン、品質保証、ネットワーク内アクセラレーション、スイッチ/アダプター統合は、設計の境界に含まれます。これは、学習ジョブが数百、数千の GPU にまたがり、各 collective 操作がテールレイテンシーを増幅する場合に重要です。
クラウドの例は、このファブリックが今も多くの大規模 AI クラスターを支配している理由を示しています。Azure の ND H100 v5 のドキュメントでは、VM あたり 8 基の H100 GPU、GPU ごとの専用 400 Gbps NVIDIA Quantum-2 CX7 InfiniBand 接続、VM あたり 3.2 Tbps のインターコネクト帯域幅、GPU Direct RDMA 対応、NCCL 指向のスケールアウトクラスタリングが説明されています。これらの詳細は、単なる「高速ネットワーク」という表現ではありません。分散学習の挙動に影響するクラスター構成上の事実です。
購入者にとって、InfiniBand に関する問いは具体的であるべきです。
- どの InfiniBand 世代とスイッチプラットフォームが含まれていますか?
- ノードごとに NIC または host channel adapter は何枚接続されていますか?
- 各 GPU は専用のネットワークパスに割り当てられていますか、それともトラフィックは集約されていますか?
- GPUDirect RDMA は有効化され、テストされていますか?
- どの配置保証がノードを同じファブリックドメインに保ちますか?
- どのファブリック管理、テレメトリ、修復をプロバイダーが担いますか?
販売側が単に「InfiniBand 付き」と言うだけなら、その見積もりは不完全です。
GPU クラスターにおける RoCE の意味
RoCE は RDMA over Converged Ethernet を意味します。RoCE v2 はルーティング可能な Ethernet/IP ネットワーク上で RDMA を運ぶため、通常の TCP パスに伴う CPU とカーネルのオーバーヘッドの多くを回避しつつ、Ethernet スイッチングを利用できます。
それが魅力です。RoCE は、AI プラットフォームチームが Ethernet スイッチ、Ethernet の運用手法、より広い調達範囲を使って RDMA 対応の GPU クラスターを構築することを可能にします。すでに高速 Ethernet を大規模に運用している組織にとって、RoCE は変更管理、テレメトリ、配線、光トランシーバー、ベンダー管理への統合がしやすい場合があります。
トレードオフは、RoCE が負荷下で Ethernet ファブリックが良好に動作することに依存する点です。GPU の collective は同期的なバーストを生みます。チェックポイント作成やストレージトラフィックが学習トラフィックと衝突することがあります。輻輳はレイテンシースパイクに変わりえます。パケットロスは、通常のアプリケーショントラフィックよりも RDMA にとってはるかに高くつくことがあります。
そのため、RoCE のクラスター設計には通常、次のものが含まれます。
- Priority Flow Control、または別の検証済みのロスレス方式。
- 明示的輻輳通知(ECN)と輻輳制御のチューニング。
- スイッチとNIC全体でのData Center Bridging設定。
- キュー、サービスクラス、DSCP/優先度マッピングの規律。
- ドロップ、ポーズフレーム、ECNマーク、再送、バッファ圧力についての優先度別カウンタ。
- ファームウェア、スイッチOS、NICドライバー、MTU、ルーティングポリシーに対する厳格な変更管理。
RoCEは非常に優れていますが、「ただのEthernetだ」というのは誤った考え方です。GPUクラスターでは、RoCEはRDMAトラフィック向けに設計されたEthernetファブリックです。
レイテンシ:中央値だけでなく、テールの挙動を比較する
roce vs infiniband の判断では、平均レイテンシよりも、実際の集団負荷下でのテール挙動のほうが重要です。
分散学習では、最も遅い参加者を待つことがよくあります。レイテンシが高い少数のランクが、ステップ全体を遅らせることがあります。シャーディングされた推論では、p95およびp99のネットワーク遅延が、ユーザー向けレイテンシやバッチング効率の低下として表面化することがあります。ストレージ負荷の高い学習では、チェックポイントのトラフィックが、クリーンなマイクロベンチマークでは見えないバーストを生み出すことがあります。
次の4つのレベルで測定します:
| レイヤー | 測定対象 | 重要な理由 |
|---|---|---|
| リンクとファブリック | ポートエラー、ドロップ、ECNマーク、ポーズフレーム、輻輳イベント、ルート変更 | フレームワークを疑う前に、ファブリックの健全性問題を見つける。 |
| RDMAトランスポート | 再送、完了レイテンシ、キュー深度、NICカウンタ | 負荷時にRDMAが安定しているかを示す。 |
| NCCL集団通信 | all-reduce帯域幅、バス帯域幅、最小/平均/最大レイテンシ、反復ごとの時間 | AI学習の通信パターンに一致する。 |
| アプリケーション | ステップ時間、tokens/sec、リクエストレイテンシ、チェックポイント所要時間、障害復旧 | ファブリックが実際の作業に役立っているかを、財務・製品チームに示す。 |
InfiniBandは、多くのクラスター設計が集団通信中心のワークロードを最初から前提に構築・検証されているため、しばしば優位です。RoCEは、Ethernetファブリックが適切にチューニングされ、分離され、検証済みであれば、その差を縮めることができます。テストで重要なのは、RoCE v2が理論上RDMAを実行できるかどうかではありません。あなたが実際に実行するワークロードの最中に、この特定のスイッチ/NIC/ケーブル/ドライバー/トポロジーの組み合わせがp95とp99の挙動を維持できるかどうかです。
運用:InfiniBandは専門的、RoCEは統合的
運用は、roce vs infiniband comparison がそれほど自明ではなくなる部分です。
InfiniBandは、成熟したAI/HPC前提を備えた専用ファブリックをプラットフォームチームに提供します。これにより、チューニングの曖昧さを減らせることがあります。一方で、InfiniBand固有のスキル、ファブリック管理ツール、サブネットマネージャーの知識、サポート経路が必要になります。クラスターが専門プロバイダーやハイパースケーラーから借りるものであれば、その多くはプロバイダーのサービス境界の背後に隠れているかもしれません。クラスターを自社保有またはコロケーションしている場合、そのスキルギャップは現実的な問題になります。
RoCEはEthernet上で動作するため、多くの企業ネットワーク組織にとってより自然に適合します。調達、ケーブリング、スイッチ運用、監視、変更管理のパターンがすでに存在しているかもしれません。リスクは、通常のEthernet運用だけでは不十分だという点です。RDMAトラフィックには、一貫したエンドツーエンドの扱いが必要です。PFC、ECN、キューマッピング、MTU、ハッシュ、輻輳制御がずれると、通常のスイッチポリシー変更がファブリックを壊すことがあります。
次の運用モデルのチェックリストを使ってください:
| 運用上の問い | InfiniBandの要求に対する答え | RoCEの要求に対する答え |
|---|---|---|
| ファブリック設計の責任者は誰か? | AI/HPCネットワーキングの専門家またはプロバイダー | ネットワークチームとAIプラットフォームオーナー |
| トポロジーの検証者は誰か? | プロバイダーのファブリックレポート、サブネット/ファブリックツール、NCCLテスト | スイッチ/NIC設定の監査、テレメトリ、NCCLテスト |
| 最も頻繁に壊れるものは何か? | 配置の不一致、ファームウェア/ドライバーのずれ、リンク障害、サポート外のトポロジー前提 | ロスレス設定のずれ、輻輳設定ミス、共有トラフィックの干渉、キーマッピングの誤り |
| 何を監視すべきか? | リンク状態、ポートエラー、輻輳、ルート健全性、GPU/NICのアフィニティ、NCCL性能 | ドロップ、ポーズ/ECN挙動、PFCストーム、再送、バッファ圧力、NCCL性能 |
| どのスキルが希少か? | InfiniBandファブリックスペシャリスト | Ethernet運用とRDMA حساسなAIトラフィックの両方を理解するエンジニア |
すでに強力なEthernet自動化があり、InfiniBandのスキルがない場合、RoCEは運用面で魅力的かもしれません。AIファブリックをテスト済みのアプライアンスのような層としてプロバイダーに持たせたい場合は、InfiniBandのほうが提供リスクを下げられるかもしれません。
コスト:スイッチ価格だけでなく、ファブリックのリスクも含める
RoCEは、Ethernet機器が広く調達可能で再利用しやすいため、より安価だと語られることがよくあります。InfiniBandは、専用のAI/HPCファブリックであるため高価だと語られることがよくあります。これらの説明は真実であり得ますが、それでも誤った判断につながることがあります。
GPUクラスターでは、ファブリックのコストはスイッチ、NIC、光学部品、ケーブルの価格だけではありません。それは、完了した有用な作業のコストです。
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
次に正規化します:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
または:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE は、Ethernet の調達、再利用、運用によって総コストを下げつつ、ジョブ完了率を損なわない場合に有利です。InfiniBand は、より高いファブリックコストが、トレーニングの遅延、マルチノードジョブの失敗、そして数週間にわたるチューニングを回避できる場合に有利です。高価な GPU を遊ばせる安価なファブリックは、実際には安くありません。
roce networking vs infiniband のコスト判断は、次の 3 つの数値に結び付けてください:
- ネットワーク停止やジョブ失敗後の有効な GPU 利用率。
- 正確なノード数でのベンチマーク合格率。
- ファブリックを安定稼働させるために必要な運用工数。
これらの数値がなければ、コストモデルはまだ準備不足です。
ワークロード適合性: トレーニング、推論、ストレージ、混在クラスター
適切な roce vs infiniband comparison は、トラフィックパターンに依存します。
分散トレーニング
分散トレーニングは、InfiniBand が最も強い適用領域です。大規模な all-reduce と reduce-scatter、同期ステップ、スケールアウトジョブはジッターに弱いです。ジョブが多数のノードにまたがり、ビジネス上トレーニング期間を予定通りに完了することが重要なら、InfiniBand が低リスクな選択になることが多いです。
RoCE も依然として有効な選択肢になり得ます。特に、Ethernet/RDMA の実運用に強い組織ではそうです。ただし、実際に運用する予定のものと同じモデルファミリー、フレームワーク、精度、バッチサイズ、ノード数、チェックポイント方式で実証する必要があります。
シャーディングされた分散推論
推論はより混在的です。モデルが GPU やノードに分割されている場合、ネットワーク遅延が重要になります。フリートの大半が独立したレプリカであれば、GPU メモリ、バッチング、キャッシュ挙動、キューイング、オートスケーリングの方がファブリックより重要かもしれません。
多くの本番推論チームにとって、最初に問うべきことは InfiniBand か RoCE かではありません。ワークロードにそもそも GPU の直接制御が必要かどうかです。マネージドモデル API でレイテンシ、品質、プライバシー、コスト目標を満たせるなら、クラスター契約を結ぶ前にその経路を比較してください。
関連資料: Flatkey の GPU cloud vs model API、best GPU for LLM inference、vLLM deployment のガイドでは、提供側のコスト境界を扱っています。
ストレージ負荷の高いワークロード
大規模データセットを配置し、頻繁にチェックポイントを書き込み、またはモデル重みを再読み込みするトレーニングは、ストレージネットワークの問題になることがあります。高速な GPU ファブリックでも、遅いデータセット配置や、チェックポイント中に飽和する共有ファイルシステムは改善できません。
InfiniBand と RoCE のどちらでも、ベンチマークにストレージを含めてください:
- データセットの読み込み時間。
- チェックポイントの書き込みおよび復元時間。
- ローカル NVMe へのスピル挙動。
- オブジェクトストレージの経路と egress。
- 共有ファイルシステムの競合。
- ノード障害後の復旧時間。
マルチテナント GPU クラスター
マルチテナントクラスターには、ベンチマークラボよりも強い分離が必要です。ノイジーネイバー、バックグラウンドのストレージジョブ、ユーザーコンテナ、保守時間帯は、ファブリックの挙動を変える可能性があります。InfiniBand も RoCE も、Admission control、クォータ、テレメトリ、インシデント対応が必要です。RoCE は、RDMA トラフィックが通常の Ethernet トラフィックと運用境界を共有する場合、追加の注意が必要です。
どちらのファブリックでも使える受け入れテスト
ベンダーの infiniband vs roce comparison をそのまま証拠として受け入れないでください。購入またはレンタルする予定の正確なクラスター形状で受け入れテストを実施してください。
1. テスト用の部品表を固定する
記録する内容:
- GPU モデル、メモリ容量、1 ノードあたりの GPU 数。
- CPU、RAM、PCIe/SXM 構成、NUMA、ローカル NVMe。
- NIC/HCA モデル、速度、ファームウェア、ドライバ。
- スイッチモデル、スイッチ OS、ファブリック世代。
- 光学部品、ケーブル種別、リンク速度。
- MTU とキュー設定。
- 配置グループ、ラック、ゾーン、リージョン、ノード数。
- CUDA、NCCL、MPI、フレームワーク、コンテナイメージ、カーネルバージョン。
ベンチマーク後にこれらのいずれかが変わったら、テストを再実行してください。
2. すべてのノードで NCCL テストを実行する
NVIDIA の nccl-tests プロジェクトは、NCCL オペレーションの性能と正確性の両方を確認し、マルチノードの MPI 実行をサポートするため、実用的な基準となります。
受け入れテストの例:
# MPI サポート付きでビルドする。
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# 例: 8 ノード、1 ノードあたり 8 GPU、合計 64 ランク。
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
追跡する項目:
- アルゴリズム帯域幅とバス帯域幅。
- 最小、平均、最大レイテンシ。
- 有効化されている場合は、反復ごとの p95/p99。
- ランクの外れ値。
- 失敗した正当性チェック。
- 再実行間のばらつき。
- ノード再起動、ドライバ再起動、またはスイッチ保守イベント後の性能。
3. 実際のワークロードを再生する
マイクロベンチマークは必要ですが、十分ではありません。実際のトレーニングまたは推論ジョブを 1 つ再生してください:
- 同じモデルファミリーとシーケンス長。
- 同じフレームワークと分散戦略。
- 同じ精度、量子化、バッチサイズ。
- 同じチェックポイント間隔。
- 同じデータパス。
- 同じオートスケーリングまたはジョブスケジューラポリシー。
そのうえで、step time、tokens/sec、キュー遅延、チェックポイント時間、障害復旧、そして accepted output あたりのコストを比較してください。
4. 障害と輻輳を注入する
きれいな日だけ通るファブリックは、本番対応とは言えません。
テストする:
- ジョブから1ノードを除外する。
- 1本のリンクがダウンまたは劣化する。
- トレーニング中にストレージのチェックポイント書き込みがバーストする。
- トレーニングジョブ中にバックグラウンド推論負荷が発生する。
- スイッチ/NICのカウンターしきい値とアラート。
- ファブリック障害に対するプロバイダサポートの応答。
roce vs infiniband の勝者は、理論上のラインレートが高いファブリックではなく、これらのテスト後も有用な処理を予測可能に維持できるファブリックです。
InfiniBandサプライヤー向けの調達質問
契約前に次の点を確認してください。
- 含まれるInfiniBandの正確な世代、スイッチモデル、アダプタモデル、リンク速度は何ですか?
- GPU、ドライバ、フレームワークスタックに対してGPUDirect RDMAは有効化され、サポートされていますか?
- すべてのノードは、1つのファブリックドメインまたは配置グループ内にあることが保証されていますか?
- 同じGPU台数で、どのNCCL all-reduceの結果を提示できますか?
- サブネット管理、ファームウェア更新、輻輳調整、インシデント対応の責任者は誰ですか?
- SHARP、アダプティブルーティング、品質保証、またはインネットワーク機能は有効化され、サポートされていますか?
- 顧客が確認できるテレメトリは何ですか。ポートカウンター、輻輳イベント、HCAエラー、ルート変更、ジョブレベルのファブリックメトリクスはありますか?
- 見積もられたファブリックが合意済みベンチマークを通過できない場合、金銭的にはどうなりますか?
- トポロジーやオーバーサブスクリプションの前提を変更せずにクラスターを拡張できますか?
- どの保守ウィンドウ、予備部品、交換までの所要時間が適用されますか?
RoCEサプライヤー向けの調達質問
契約前に次の点を確認してください。
- ファブリックはRoCE v2ですか。また、必要なトポロジー全体でルーティング可能ですか?
- この正確なGPUクラスター構成に対して検証済みのスイッチおよびNICモデルはどれですか?
- 必要なPFC、ECN、DSCP、キュー、MTU、輻輳制御の設定は何ですか?
- RDMAトラフィックは通常のEthernetトラフィックから分離されていますか、それとも共有されていますか?
- NCCL負荷下でロスレス構成が健全であることを示すカウンターは何ですか?
- PFCストーム、ポーズフレームの蓄積、ECN設定ミス、バッファ圧迫はどのように検出しますか?
- スイッチ設定のドリフトとファームウェア互換性の責任者は誰ですか?
- 同じノード数とワークロードクラスで、どのNCCL結果がありますか?
- ネットワークチームは設定をコードから再現できますか?
- 問題がGPUドライバ、NICファームウェア、スイッチポリシー、アプリケーションフレームワークにまたがる場合、どのサポート境界が適用されますか?
意思決定マトリクス
このマトリクスは、ベンチマークの後に使ってください。前ではありません。
| 基準 | 次の場合はInfiniBandを優先... | 次の場合はRoCEを優先... |
|---|---|---|
| レイテンシ感度 | トレーニングのステップ時間が集団通信に支配される、またはp99のジッタが推論を損なう | 実運用負荷でp95/p99が安定していることがテストで示される |
| 規模 | クラスターが多数のノードにまたがり、予測可能な配置が必要 | クラスター規模が中程度、またはEthernetファブリックが同程度の規模で既に実証済み |
| 運用 | プロバイダまたはチームにInfiniBandファブリックの専門知識がある | ネットワークチームに強力なEthernet自動化とRDMA特有の実務がある |
| 調達 | 検証済みのAI/HPCファブリックを購入またはレンタルできる | より広範なスイッチ調達先やEthernet標準化が必要 |
| コスト | ジョブ失敗やチューニング遅延を避けることが、専用ファブリックのコストを正当化する | Ethernetの節約が、チューニング、テレメトリ、再試行のコストを差し引いても残る |
| 柔軟性 | クラスターがAI/HPCワークロード専用である | ファブリックがより広いデータセンターネットワーキングの慣行に合わせる必要がある |
| リスク | プロジェクト期限が厳しく、ファブリックの曖昧さが高コストである | ロスレスEthernetを検証・運用するための時間とスキルがチームにある |
マトリクスが引き分けになった場合は、両方をレンタルするかベンチマークしてください。マルチノードGPUネットワーキングは、プロトコル要約だけで判断するには高価すぎます。
そのまま使えるRoCE vs InfiniBandワークシート
この表を調達ドキュメントで使ってください。
| 項目 | InfiniBand विकल्प | RoCE विकल्प |
|---|---|---|
| GPUモデルとノード数 | ||
| ファブリック世代とリンク速度 | ||
| ノードあたりのNIC/HCA | ||
| スイッチモデルとポート数 | ||
| オーバーサブスクリプション比 | ||
| 配置保証 | ||
| GPUDirect RDMAサポート | ||
| NCCL all-reduceのバス帯域幅 | ||
| NCCL p95/p99または最大レイテンシ | ||
| トレーニングのステップ時間 | ||
| チェックポイントの書き込み/復元時間 | ||
| ファブリックのドロップ/輻輳カウンター | ||
| 運用責任者 | ||
| サポートSLA | ||
| 月額ファブリックコスト | ||
| アイドル/再試行の無駄の見積もり | ||
| 受理された出力あたりのコスト | ||
| 拡張パス | ||
| 出口リスク |
最も重要な行は、記載されたファブリック価格ではありません。ベンチマーク結果、運用責任者、アイドル/再試行の無駄、拡張パスです。
モデルAPIのほうが適切な答えである場合
roce vs infiniband を調べているチームの中には、実際にはネットワークファブリックを購入する準備ができていない場合があります。AI出力コストを下げたい、キュー遅延をなくしたい、または製品機能を出荷したいのです。
ワークロードがカスタム重み、GPUの直接スケジューリング、カスタムカーネル、厳密な配置、またはハードウェアレベルの分離を必要としない場合は、まずマネージドモデルAPIを比較してください。Flatkeyは、公式モデルとAIツール全体で1つのキー、1つの残高、1つの利用台帳をチームに提供し、製品がまだ変化している間はGPUクラスターを自前で運用するよりもシンプルな場合があります。
ハードウェア制御が必要な場合はファブリックのルートを使ってください。ビジネス指標がネットワーク所有ではなく、受け入れ可能な出力である場合は、モデル/APIのルートを使ってください。
関連するFlatkeyガイド:
- GPUクラスターのTCOでは、クラウドレンタル、コロケーション、オンプレミスの計算を扱います。
- GPUクラスターのレンタルでは、ベンダー評価とキャパシティ契約を扱います。
- GPUレンタル価格では、オンデマンド、スポット、予約、隠れたコストを扱います。
- サーバーレスGPU vs 専有GPUでは、コールドスタート、アイドル容量、制御について扱います。
公式ソースのチェックリスト
まず公式ページをソース確認に使い、その後、購入予定の実際のクラスターを検証してください。
| ソース | 確認すべきこと |
|---|---|
| InfiniBand Trade Association: About InfiniBand | InfiniBandが、サーバーおよびストレージ接続向けの業界標準のスイッチドファブリックであること。 |
| NVIDIA Quantum InfiniBand platform | InfiniBandスイッチ、アダプタ、ファブリック管理、SHARP、およびAI/HPCファブリックとしての位置づけ。 |
| NVIDIA Spectrum-X Ethernet | Ethernet/RoCE志向のAIネットワーキングの位置づけと、検証すべき輻輳管理の主張。 |
| Azure ND H100 v5 sizes | GPUごとに専用のInfiniBandとGPUDirect RDMAを使用するクラウドGPUクラスターの例。 |
| AWS Elastic Fabric Adapter | 選択されたインスタンス上で、OSバイパス、輻輳制御、Libfabric、NCCL、GPUDirect RDMAサポートを使うクラウド代替。 |
| Google Cloud GPUDirect documentation | GPUDirect対応のA3ファミリーインスタンス向けのクラウドGPUネットワーキング設定要件。 |
| NVIDIA nccl-tests | 対象クラスター形状に対する再現可能な集合通信ベンチマークと正しさテスト。 |
これらのページを受け入れテストの代わりに扱わないでください。これらは、真剣な購入者レビューのための最低限のソースリストとして扱ってください。
よくある質問
InfiniBandは常にRoCEより速いですか?
いいえ。InfiniBandは、目的特化型でレイテンシに敏感なAI/HPCファブリックに対して、通常はより低リスクな選択肢ですが、十分に設計されたRoCE v2ファブリックも良好に動作しえます。NCCLとアプリケーションテストを使って、実際のクラスターを比較してください。
RoCEはInfiniBandより安いですか?
Ethernetの調達、再利用、既存運用によって総コストが下がる場合、RoCEは安くなることがあります。損失のないEthernetのチューニング、輻輳インシデント、失敗したジョブ、またはアイドルGPUがその節約を打ち消すなら、安くはなりません。
RoCE v2とInfiniBandの違いは何ですか?
RoCE v2は、ルーティング可能なEthernet/IPネットワーク上でRDMAを運びます。InfiniBandは、一般にHPCおよびAIクラスターで使われる専用のスイッチドファブリックアーキテクチャです。運用上の違いは、RoCEがEthernetの設計柔軟性とチューニング負荷を継承するのに対し、InfiniBandはファブリックにより特化していることです。
分散学習にはどちらが良いですか?
大規模で密結合な分散学習では、InfiniBandがより安全なデフォルトであることが多いです。RoCEは、Ethernetファブリックが分離され、チューニングされ、監視され、同じ学習ワークロードで実証されている場合に、強力な選択肢になりえます。
推論にはどちらが良いですか?
推論アーキテクチャによります。シャーディングされたモデルやノード間サービングでは、ファブリックのレイテンシが重要です。独立したレプリカでは、GPUメモリ、バッチング、キャッシュヒット率、自動スケーリング、そして受け入れられた出力あたりのコストのほうが重要かもしれません。
選ぶ前に何をベンチマークすべきですか?
対象ノード数でNCCL all-reduceを実行し、実際のワークロードを再生し、ストレージ/チェックポイントのトラフィックを含め、障害や輻輳を注入し、ファブリックカウンタを記録してください。roce vs infiniband の判断は、これらの結果に従うべきです。
最終推奨
一般的なベンチマークだけで roce vs infiniband を選ばないでください。ワークロード、運用モデル、受け入れテストから選んでください。
クラスターが専用のAI/HPCファブリックであり、分散学習がクリティカルパスであり、学習ウィンドウを逃すことが高くつくなら、InfiniBandを選んでください。Ethernetの標準化、調達の柔軟性、既存運用が重要であり、チームが実際のGPUワークロード下で損失のないRDMA動作を実証できるなら、RoCEを選んでください。
アプリケーションが必要としているのがAI出力だけで、GPUファブリックの直接制御ではないなら、クラスターを借りるか買う前にFlatkeyのマネージドモデル/APIルートを比較してください。最も安いネットワークとは、運用しなくてよいネットワークです。


