
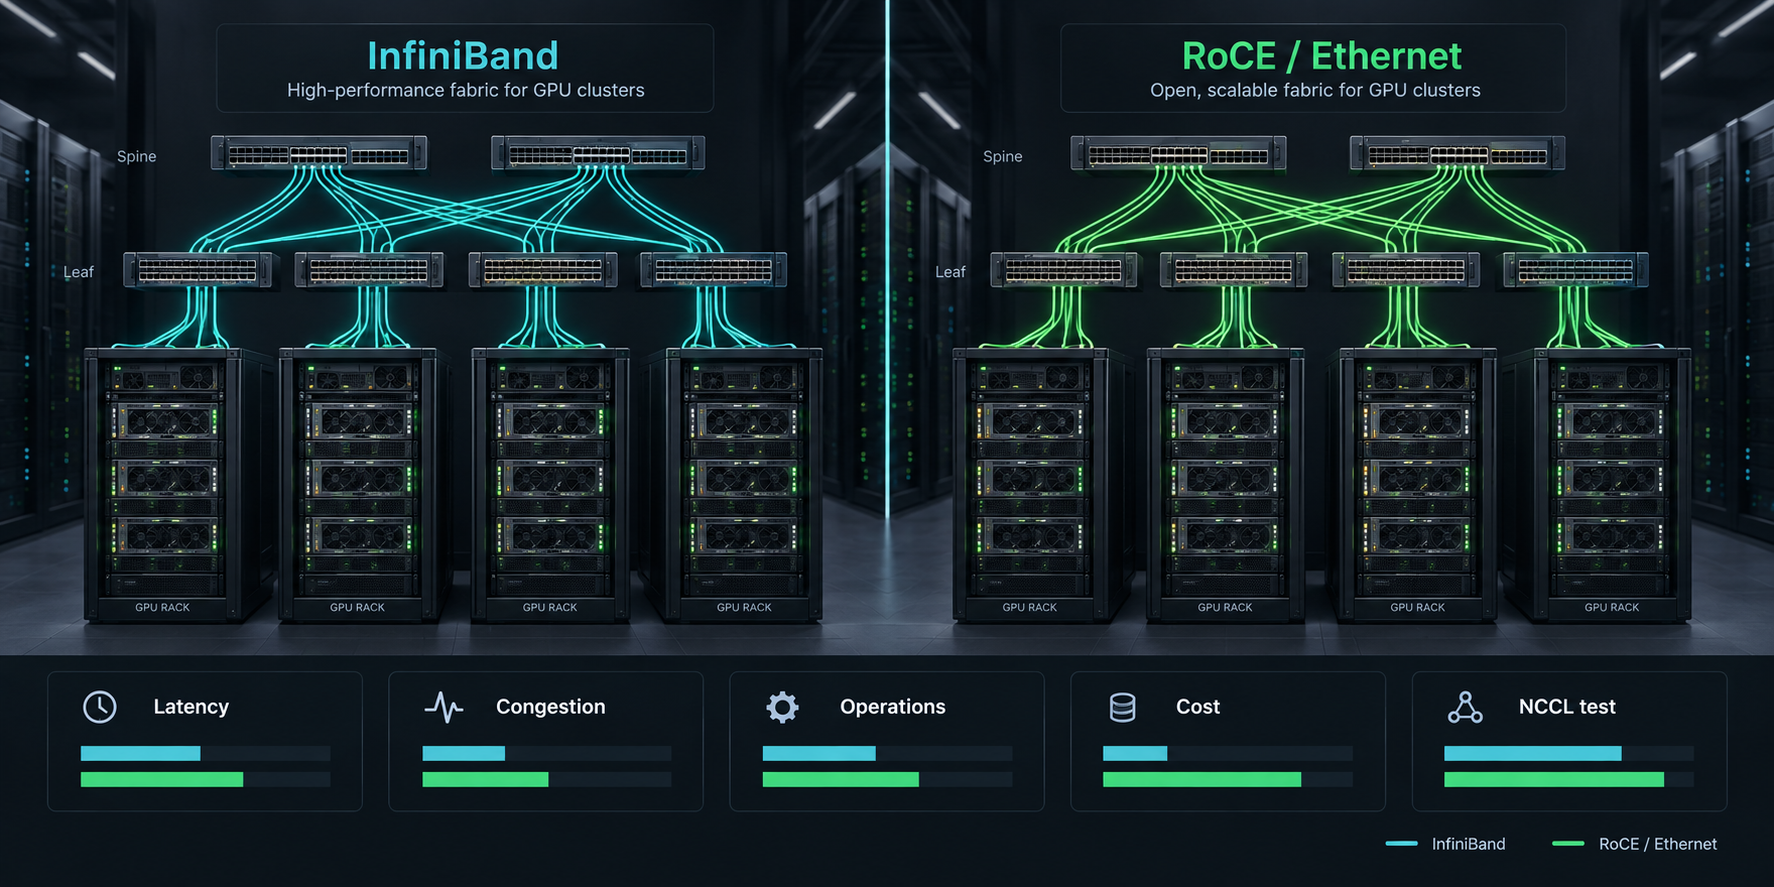
A maioria dos argumentos entre RoCE e InfiniBand começa no lugar errado. Eles comparam nomes de protocolos em vez de perguntar o que o cluster de GPU precisa suportar: treinamento fortemente acoplado, inferência fragmentada, tráfego de armazenamento compartilhado, locatários mistos, limites de aquisição e a equipe de operações que vai ajustar a malha após o lançamento.
Para clusters de GPU com vários nós, InfiniBand costuma ser o padrão inicial mais seguro quando a carga de trabalho é sensível à latência, intensiva em collectives e grande o suficiente para justificar uma malha de IA/HPC dedicada. RoCE costuma ser o melhor ponto de partida quando a equipe já opera Ethernet de alta velocidade, quer uma escolha mais ampla de fornecedores e consegue comprovar o design Ethernet sem perdas com testes reais de NCCL antes de se comprometer.
A parte difícil é que ambos podem funcionar, e ambos podem falhar. Uma malha RoCE v2 bem construída pode executar clusters sérios de IA. Uma malha InfiniBand mal operada ainda pode perder a janela de treinamento. Este guia compara roce vs infiniband por meio de latência, operações e custo, para que as equipes de plataforma escolham a malha que corresponde à carga de trabalho em vez do slide mais barulhento do fornecedor.
Resposta rápida: RoCE vs InfiniBand
Use esta tabela como filtro inicial de decisão.
| Situação | Normalmente comece com | Por quê |
|---|---|---|
| Treinamento distribuído em larga escala com tráfego frequente de all-reduce | InfiniBand | É uma malha comutadas criada para comunicação HPC e de IA de baixa latência e alta largura de banda. |
| A cotação do cluster de GPU já inclui uma malha NVIDIA Quantum validada ou uma malha InfiniBand semelhante | InfiniBand | O risco passa do projeto para os testes de aceitação e a comprovação do fornecedor. |
| A equipe de rede da empresa já tem automação, monitoramento e alavancagem de aquisição profundos em Ethernet | RoCE | RoCE mantém RDMA sobre Ethernet, mas exige controle disciplinado de congestionamento e comportamento sem perdas. |
| Tráfego misto de IA, armazenamento e data center comum em um único modelo operacional | RoCE ou Ethernet separada mais uma malha de IA dedicada | RoCE pode se alinhar às operações de Ethernet, mas as malhas compartilhadas devem ser projetadas com cuidado. |
| Frota pequena de inferência, jobs em lote ou cargas de trabalho que não escalam entre nós | Nenhuma das duas malhas deve orientar a decisão | Memória da GPU, utilização, filas e alternativas de modelo/API importam mais do que o interconector. |
| A aquisição precisa de máxima diversidade de fornecedores e fornecimento padronizado de switches | RoCE | O fornecimento Ethernet pode ser mais amplo, enquanto os clusters InfiniBand são mais verticalmente especializados. |
| A equipe não tem experiência com malha RDMA e não tem janela de benchmark | Alugue primeiro, depois decida | Não assine um contrato multi-nó até que os testes de NCCL, falhas e observabilidade passem. |
A resposta prática: escolha InfiniBand quando a aplicação precisa de uma malha de IA/HPC dedicada com o menor risco de ajuste no nível do protocolo. Escolha RoCE quando a padronização em Ethernet, a flexibilidade de aquisição ou as operações existentes forem importantes o suficiente para justificar o esforço extra de engenharia da malha.
O que InfiniBand significa em um cluster de GPU
InfiniBand é uma arquitetura de malha comutada padrão da indústria usada para interconectar servidores e armazenamento. Em clusters de GPU, ela é comumente associada a baixa latência, alta largura de banda, RDMA, GPU Direct RDMA, roteamento adaptativo, gerenciamento de congestionamento e ferramentas de IA/HPC integradas ao fornecedor.
O ponto importante não é apenas que InfiniBand é rápido. O ponto importante é que ele foi construído como uma malha. Gerenciamento de subnet, comportamento em nível de malha, virtual lanes, qualidade de serviço, aceleração dentro da rede e integração de switch/adaptador fazem parte do limite do projeto. Isso importa quando um job de treinamento se estende por centenas ou milhares de GPUs e toda operação coletiva amplifica a latência de cauda.
Exemplos em nuvem mostram por que essa malha ainda domina muitos grandes clusters de IA. A documentação do Azure ND H100 v5 descreve oito GPUs H100 por VM, conectividade dedicada NVIDIA Quantum-2 CX7 InfiniBand de 400 Gbps por GPU, 3,2 Tbps de largura de banda de interconexão por VM, suporte a GPU Direct RDMA e clusterização horizontal orientada ao NCCL. Esses detalhes não são linguagem genérica de "rede rápida"; são fatos sobre a forma do cluster que afetam o comportamento do treinamento distribuído.
Para um comprador, a questão do InfiniBand deve ser específica:
- Qual geração de InfiniBand e qual plataforma de switch estão incluídas?
- Quantas NICs ou adaptadores de canal de host estão conectados por nó?
- Cada GPU está mapeada para um caminho de rede dedicado ou o tráfego é agregado?
- O GPUDirect RDMA está habilitado e testado?
- Qual garantia de posicionamento mantém os nós no mesmo domínio de malha?
- Qual gerenciamento de malha, telemetria e correção o provedor assume?
Se o vendedor apenas disser "InfiniBand incluído", a proposta está incompleta.
O que RoCE significa em um cluster de GPU
RoCE significa RDMA over Converged Ethernet. RoCE v2 transporta RDMA sobre redes Ethernet/IP roteáveis, o que permite às equipes usar switching Ethernet enquanto ainda contornam grande parte da sobrecarga de CPU e kernel associada aos caminhos TCP comuns.
Esse é o atrativo. RoCE pode permitir que uma equipe de plataforma de IA construa clusters de GPU com capacidade RDMA usando switches Ethernet, práticas operacionais Ethernet e uma superfície de aquisição mais ampla. Para organizações que já operam Ethernet de alta velocidade em escala, RoCE pode ser mais fácil de integrar a controle de mudanças, telemetria, cabeamento, óptica e gestão de fornecedores.
A contrapartida é que RoCE depende de a malha Ethernet se comportar bem sob carga. Collectives de GPU criam rajadas sincronizadas. Checkpointing e tráfego de armazenamento podem colidir com o tráfego de treinamento. O congestionamento pode se transformar em picos de latência. A perda de pacotes pode ser muito mais cara para RDMA do que para o tráfego comum de aplicações.
É por isso que o projeto de cluster RoCE geralmente inclui:
- Controle de Fluxo com Prioridade ou outra estratégia lossless testada.
- Notificação Explícita de Congestionamento e ajuste de controle de congestionamento.
- Configuração de Data Center Bridging em switches e NICs.
- Disciplina de mapeamento de filas, classe de serviço e DSCP/prioridade.
- Contadores por prioridade para drops, quadros de pausa, marcações ECN, retransmissões e pressão de buffer.
- Controle de mudanças rigoroso para firmware, sistema operacional do switch, drivers de NIC, MTU e política de roteamento.
RoCE pode ser excelente, mas "é apenas Ethernet" é o modelo mental errado. Em um cluster de GPU, RoCE é um fabric Ethernet projetado para tráfego RDMA.
Latência: compare o comportamento da cauda, não apenas a mediana
Na decisão roce vs infiniband, a latência média é menos útil do que o comportamento da cauda sob carga coletiva real.
O treinamento distribuído frequentemente espera pelo participante mais lento. Um pequeno número de ranks com latência mais alta pode segurar todo o passo. Para inferência fragmentada, a latência de rede p95 e p99 pode aparecer como latência percebida pelo usuário ou menor eficiência de batching. Para treinamento intensivo em armazenamento, o tráfego de checkpoint pode criar picos invisíveis em um microbenchmark limpo.
Meça em quatro níveis:
| Camada | O que medir | Por que importa |
|---|---|---|
| Link e fabric | Erros de porta, drops, marcações ECN, quadros de pausa, eventos de congestionamento, mudanças de rota | Encontra problemas de integridade do fabric antes de culpar frameworks. |
| Transporte RDMA | Retransmissões, latência de conclusão, profundidade de fila, contadores da NIC | Mostra se o RDMA está estável sob pressão. |
| Coletivos NCCL | largura de banda de all-reduce, largura de banda do barramento, latência mínima/média/máxima, tempo por iteração | Corresponde aos padrões de comunicação do treinamento de IA. |
| Aplicação | tempo de passo, tokens/s, latência de requisição, duração do checkpoint, recuperação de falhas | Diz às equipes de finanças e produto se o fabric ajuda no trabalho útil. |
InfiniBand muitas vezes tem vantagem porque muitos designs de cluster são construídos e validados desde o início em torno de cargas de trabalho intensivas em coletivos. RoCE pode fechar a lacuna quando o fabric Ethernet é ajustado, isolado e comprovado. O teste não é se o RoCE v2 pode teoricamente fazer RDMA. O teste é se essa combinação exata de switch/NIC/cabeamento/driver/topologia mantém o comportamento p95 e p99 durante a carga de trabalho que você realmente vai executar.
Operações: InfiniBand é especializado, RoCE é integrado
Operações é onde a comparação roce vs infiniband se torna menos óbvia.
InfiniBand oferece às equipes de plataforma um fabric especializado com suposições maduras de IA/HPC. Isso pode reduzir a ambiguidade de ajuste. A desvantagem é que a equipe precisa de habilidades específicas de InfiniBand, ferramentas de gerenciamento de fabric, conhecimento de subnet manager e caminhos de suporte. Se o cluster for alugado de um provedor especializado ou hyperscaler, muito disso pode ficar oculto atrás da fronteira de serviço do provedor. Se o cluster for próprio ou em colocation, a lacuna de habilidades se torna real.
RoCE se encaixa de forma mais natural em muitas organizações de rede corporativa porque roda sobre Ethernet. Aquisição, cabeamento, operações de switch, monitoramento e padrões de gerenciamento de mudanças podem já existir. O risco é que operações Ethernet comuns não sejam suficientes. O tráfego RDMA precisa de tratamento consistente de ponta a ponta. Uma mudança rotineira de política no switch pode quebrar o fabric se PFC, ECN, mapeamento de filas, MTU, hashing ou controles de congestionamento se desviarem.
Use esta lista de verificação do modelo operacional:
| Pergunta operacional | Resposta de InfiniBand à demanda | Resposta de RoCE à demanda |
|---|---|---|
| Quem é o dono do design do fabric? | Especialista em rede de IA/HPC ou provedor | Equipe de rede mais o responsável pela plataforma de IA |
| Quem valida a topologia? | Relatório de fabric do provedor, ferramentas de subnet/fabric, testes NCCL | Auditoria de configuração de switch/NIC, telemetria, testes NCCL |
| O que quebra com mais frequência? | Desalinhamento de posicionamento, desvio de firmware/driver, links com falha, suposições de topologia sem suporte | Desvio de configuração lossless, má configuração de congestionamento, interferência de tráfego compartilhado, erros de mapeamento de filas |
| O que deve ser monitorado? | Estado do link, erros de porta, congestionamento, saúde de rota, afinidade GPU/NIC, desempenho NCCL | Drops, comportamento de pausa/ECN, tempestades de PFC, retransmissões, pressão de buffer, desempenho NCCL |
| Que habilidade é rara? | Especialistas em fabric InfiniBand | Engenheiros que entendem tanto operações Ethernet quanto tráfego de IA sensível a RDMA |
Se a sua equipe já tem forte automação Ethernet, mas não tem habilidades em InfiniBand, RoCE pode ser operacionalmente atraente. Se a sua equipe quer que o provedor assuma o fabric de IA como uma camada testada, semelhante a um appliance, InfiniBand pode reduzir o risco de entrega.
Custo: inclua o risco do fabric, não apenas o preço do switch
RoCE costuma ser apresentado como mais barato porque os equipamentos Ethernet podem ser obtidos e reutilizados amplamente. InfiniBand costuma ser apresentado como caro porque é um fabric especializado para IA/HPC. Essas afirmações podem ser verdadeiras e ainda assim levar a decisões ruins.
Para clusters de GPU, o custo do fabric não é apenas o preço de switch, NIC, ópticas e cabos. É o custo do trabalho útil concluído.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Então normalize:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
ou:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE pode vencer quando o fornecimento, a reutilização e as operações de Ethernet reduzem o custo total sem prejudicar a conclusão dos jobs. InfiniBand pode vencer quando um custo de fabric mais alto evita atrasos no treinamento, jobs multinó que falham e semanas de ajuste fino. Um fabric mais barato que deixa GPUs caras ociosas não é mais barato.
Vincule a decisão de custo de roce networking vs infiniband a três números:
- Utilização útil da GPU após stalls de rede e jobs falhados.
- Taxa de aceitação de benchmark no número exato de nós.
- Horas de operação necessárias para manter o fabric estável.
Se esses números estiverem ausentes, o modelo de custo não está pronto.
Adequação à carga de trabalho: treinamento, inferência, armazenamento e clusters mistos
A comparação correta de roce vs infiniband comparison depende do padrão de tráfego.
Treinamento distribuído
O treinamento distribuído é o caso mais forte para InfiniBand. Operações de all-reduce e reduce-scatter em grande escala, etapas sincronizadas e jobs de scale-out penalizam a variabilidade. Se o job se estende por muitos nós e o negócio se importa em concluir as janelas de treinamento no prazo, o InfiniBand costuma ser o caminho de menor risco.
RoCE ainda pode ser uma escolha válida, especialmente em organizações com forte prática de Ethernet/RDMA. Mas isso precisa ser comprovado com a mesma família de modelo, framework, precisão, tamanho de batch, contagem de nós e padrão de checkpoint que você pretende executar.
Inferência particionada e distribuída
A inferência é mais mista. Se um modelo é dividido entre GPUs ou nós, a latência de rede importa. Se a frota for composta principalmente por réplicas independentes, memória de GPU, batching, comportamento de cache, enfileiramento e autoscaling podem importar mais do que o fabric.
Para muitas equipes de inferência em produção, a melhor primeira pergunta não é InfiniBand vs RoCE. É se a carga de trabalho precisa de controle direto da GPU. Se uma API de modelo gerenciada puder atingir a meta de latência, qualidade, privacidade e custo, compare esse caminho antes de assinar um contrato de cluster.
Leitura relacionada: os guias da Flatkey sobre GPU cloud vs model API, melhor GPU para inferência de LLM e implantação do vLLM cobrem o limite de custo do lado de serving.
Cargas de trabalho intensivas em armazenamento
Execuções de treinamento que preparam grandes conjuntos de dados, gravam checkpoints frequentes ou recarregam pesos de modelo podem se tornar problemas de rede de armazenamento. Um fabric de GPU rápido não corrigirá o staging lento do conjunto de dados nem um sistema de arquivos compartilhado que satura durante checkpoints.
Para InfiniBand e RoCE, inclua armazenamento no benchmark:
- Tempo de carregamento do conjunto de dados.
- Tempo de gravação e restauração de checkpoint.
- Comportamento de spill em NVMe local.
- Caminho e egress do armazenamento de objetos.
- Contentionamento do sistema de arquivos compartilhado.
- Tempo de recuperação após falha de um nó.
Clusters de GPU multi-tenant
Clusters multi-tenant precisam de isolamento mais forte do que um laboratório de benchmark. Vizinhos barulhentos, jobs de armazenamento em segundo plano, containers de usuários e janelas de manutenção podem बदल a? Actually translate naturally: mudar o comportamento do fabric. InfiniBand e RoCE ambos precisam de controle de admissão, cotas, telemetria e resposta a incidentes. RoCE exige cuidado extra quando o tráfego RDMA compartilha limites operacionais com o tráfego Ethernet comum.
Teste de aceitação para qualquer fabric
Não aceite a infiniband vs roce comparison de um fornecedor como prova. Execute o teste de aceitação na exata forma de cluster que você vai comprar ou alugar.
1. Fixe a lista de materiais do teste
Registre:
- Modelo da GPU, tamanho de memória e GPUs por nó.
- CPU, RAM, layout PCIe/SXM, NUMA e NVMe local.
- Modelo da NIC/HCA, velocidade, firmware e driver.
- Modelo do switch, sistema operacional do switch e geração do fabric.
- Ópticos, tipo de cabo e velocidade do link.
- MTU e configuração de filas.
- Grupo de posicionamento, rack, zona, região e contagem de nós.
- CUDA, NCCL, MPI, framework, imagem de container e versão do kernel.
Se um desses itens mudar após o benchmark, execute o teste novamente.
2. Execute testes NCCL em todos os nós
O projeto nccl-tests da NVIDIA é a base prática porque verifica tanto o desempenho quanto a correção das operações NCCL e suporta execuções MPI multi-nó.
Exemplo de formato de aceitação:
# Build with MPI support.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Example: 8 nodes, 8 GPUs per node, 64 ranks total.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Acompanhe:
- Largura de banda algorítmica e largura de banda do barramento.
- Latência mínima, média e máxima.
- p95/p99 por iteração, se ativado.
- Outliers por rank.
- Falhas nas verificações de correção.
- Variação entre execuções repetidas.
- Desempenho após reinicialização de um nó, reinício do driver ou evento de manutenção do switch.
3. Reproduza a carga de trabalho real
Microbenchmarks são necessários, mas não suficientes. Reproduza um job real de treinamento ou inferência:
- Mesma família de modelo e comprimento de sequência.
- Mesmo framework e estratégia distribuída.
- Mesma precisão, quantização e tamanho de batch.
- Mesma cadência de checkpoint.
- Mesmo caminho de dados.
- Mesma política de autoscaling ou do scheduler de jobs.
Depois, compare tempo de etapa, tokens/s, atraso na fila, duração do checkpoint, recuperação de falhas e custo por saída aceita.
4. Injete falha e congestionamento
Um fabric que passa apenas em um dia limpo não está pronto para produção.
Teste:
- Um nó removido da tarefa.
- Um link indisponível ou degradado.
- Explosão de checkpoint de armazenamento durante o treinamento.
- Carga de inferência em segundo plano durante uma tarefa de treinamento.
- Limiares e alertas de contador de switch/NIC.
- Resposta do suporte do provedor para um incidente na malha.
O vencedor de roce vs infiniband é a malha que mantém o trabalho útil previsível após esses testes, não a malha com a melhor taxa de linha teórica.
Perguntas de aquisição para fornecedores de InfiniBand
Pergunte isto antes de assinar:
- Qual geração exata de InfiniBand, modelo de switch, modelo de adaptador e velocidade de link estão incluídos?
- O GPUDirect RDMA está habilitado e é suportado para o GPU, driver e stack de framework?
- Todos os nós são garantidos em um único domínio de malha ou grupo de posicionamento?
- Quais resultados de all-reduce do NCCL você pode fornecer para a mesma contagem de GPUs?
- Quem é responsável pelo gerenciamento de sub-rede, atualizações de firmware, ajuste de congestionamento e resposta a incidentes?
- SHARP, roteamento adaptativo, qualidade de serviço ou recursos em rede estão habilitados e suportados?
- Qual telemetria o cliente pode ver: contadores de porta, eventos de congestionamento, erros de HCA, mudanças de rota e métricas da malha em nível de tarefa?
- O que acontece financeiramente se a malha cotada não passar no benchmark acordado?
- O cluster pode expandir sem alterar a topologia ou as premissas de oversubscription?
- Quais janelas de manutenção, peças sobressalentes e prazos de substituição se aplicam?
Perguntas de aquisição para fornecedores de RoCE
Pergunte isto antes de assinar:
- A malha é RoCE v2 e é roteável pela topologia necessária?
- Quais modelos de switch e NIC são validados para este formato exato de cluster de GPU?
- Quais configurações de PFC, ECN, DSCP, fila, MTU e controle de congestionamento são necessárias?
- O tráfego RDMA é isolado do tráfego Ethernet comum ou compartilhado?
- Quais contadores comprovam que a configuração sem perdas está saudável sob carga do NCCL?
- Como são detectadas tempestades de PFC, acúmulo de frames de pausa, má configuração de ECN e pressão de buffer?
- Quem é responsável pela deriva de configuração do switch e pela compatibilidade de firmware?
- Que resultados de NCCL existem para a mesma contagem de nós e classe de workload?
- A equipe de rede pode reproduzir a configuração a partir de código?
- Que limite de suporte se aplica quando o problema abrange driver de GPU, firmware da NIC, política do switch e framework da aplicação?
Matriz de decisão
Use esta matriz depois do benchmark, não antes dele.
| Critério | Favoreça InfiniBand quando... | Favoreça RoCE quando... |
|---|---|---|
| Sensibilidade à latência | O tempo de etapa de treinamento é dominado por coletivas ou jitter p99 prejudica a inferência | Os testes mostram p95/p99 estáveis sob carga real |
| Escala | O cluster abrange muitos nós e precisa de posicionamento previsível | O cluster tem escala moderada ou a malha Ethernet já foi comprovada em escala semelhante |
| Operações | O provedor ou a equipe tem expertise em malha InfiniBand | A equipe de rede tem forte automação Ethernet e prática específica de RDMA |
| Aquisição | Você pode comprar ou alugar uma malha de IA/HPC validada | Você precisa de maior variedade de fornecedores de switch ou padronização Ethernet |
| Custo | Evitar tarefas falhadas e atraso de ajuste justifica o custo da malha especializada | As economias de Ethernet sobrevivem após custos de ajuste, telemetria e retries |
| Flexibilidade | O cluster é dedicado a workloads de IA/HPC | A malha precisa se alinhar a práticas mais amplas de rede de data center |
| Risco | O prazo do projeto é apertado e a ambiguidade da malha é cara | A equipe tem tempo e habilidade para validar e operar Ethernet sem perdas |
Se a matriz resultar em empate, alugue ou faça benchmark de ambos. Rede multi-nó de GPU é cara demais para decidir apenas com base em um resumo de protocolo.
Planilha copiável de RoCE vs InfiniBand
Use esta tabela no documento de aquisição.
| Campo | Opção InfiniBand | Opção RoCE |
|---|---|---|
| Modelo de GPU e contagem de nós | ||
| Geração da malha e velocidade do link | ||
| NIC/HCA por nó | ||
| Modelo de switch e contagem de portas | ||
| Razão de oversubscription | ||
| Garantia de posicionamento | ||
| Suporte a GPUDirect RDMA | ||
| Bandwidth do barramento de all-reduce do NCCL | ||
| Latência p95/p99 ou máxima do NCCL | ||
| Tempo de etapa de treinamento | ||
| Tempo de gravação/restauração de checkpoint | ||
| Contadores de drops/congestionamento da malha | ||
| Responsável pelas operações | ||
| SLA de suporte | ||
| Custo mensal da malha | ||
| Estimativa de desperdício por ociosidade/retry | ||
| Custo por saída aceita | ||
| Caminho de expansão | ||
| Risco de saída |
As linhas mais importantes não são o preço da malha listado. São o resultado do benchmark, o responsável pelas operações, o desperdício por ociosidade/retry e o caminho de expansão.
Quando uma API de modelo é a melhor resposta
Algumas equipes pesquisando roce vs infiniband ainda não estão realmente prontas para comprar uma malha de rede. Elas estão tentando reduzir o custo de saída de IA, eliminar atraso na fila ou lançar um recurso de produto.
Se a carga de trabalho não exigir pesos personalizados, agendamento direto de GPU, kernels personalizados, posicionamento rigoroso ou isolamento em nível de hardware, compare primeiro uma API de modelo gerenciada. A Flatkey dá às equipes uma chave, um saldo e um registro de uso para modelos oficiais e ferramentas de IA, o que pode ser mais simples do que operar um cluster de GPU enquanto o produto ainda está mudando.
Use a rota de fabric quando precisar de controle de hardware. Use uma rota de modelo/API quando a métrica de negócio for saídas aceitas, e não propriedade da rede.
Guias relacionados da Flatkey:
- TCO de cluster de GPU para a conta de aluguel em nuvem, colocation e on-premises.
- Aluguel de cluster de GPU para avaliação de provedores e contratos de capacidade.
- Preços de aluguel de GPU para custos sob demanda, spot, reservados e ocultos.
- GPU serverless vs GPU dedicada para cold starts, capacidade ociosa e controle.
Checklist de fontes oficiais
Use páginas oficiais como verificação de fonte e, em seguida, valide o cluster exato que você está comprando.
| Fonte | O que verificar |
|---|---|
| InfiniBand Trade Association: Sobre InfiniBand | InfiniBand como uma fabric comutada padrão da indústria para conectividade de servidores e armazenamento. |
| Plataforma NVIDIA Quantum InfiniBand | Posicionamento de switch, adaptador, gerenciamento de fabric, SHARP e fabric para IA/HPC da InfiniBand. |
| NVIDIA Spectrum-X Ethernet | Posicionamento de rede para IA orientado a Ethernet/RoCE e alegações de gerenciamento de congestionamento a validar. |
| Tamanhos Azure ND H100 v5 | Exemplo de clusters de GPU em nuvem usando InfiniBand dedicado por GPU e GPUDirect RDMA. |
| AWS Elastic Fabric Adapter | Alternativa em nuvem usando bypass do SO, controle de congestionamento, Libfabric, NCCL e suporte a GPUDirect RDMA em instâncias selecionadas. |
| Documentação GPUDirect do Google Cloud | Requisitos de configuração de rede de GPU em nuvem para instâncias da família A3 com GPUDirect habilitado. |
| NVIDIA nccl-tests | Testes de benchmark coletivo repetíveis e testes de correção para a forma exata do cluster. |
Não trate essas páginas como substituto para testes de aceitação. Trate-as como a lista mínima de fontes para uma revisão séria de comprador.
Perguntas frequentes
InfiniBand é sempre mais rápido que RoCE?
Não. InfiniBand geralmente é a escolha de menor risco para fabrics de IA/HPC sensíveis à latência e construídas para esse fim, mas uma fabric RoCE v2 bem projetada pode ter bom desempenho. Compare o cluster exato usando NCCL e testes da aplicação.
RoCE é mais barato que InfiniBand?
RoCE pode ser mais barato quando o sourcing Ethernet, a reutilização e as operações existentes reduzem o custo total. Não é mais barato se o ajuste de Ethernet sem perdas, incidentes de congestionamento, jobs com falha ou GPUs ociosas eliminarem a economia.
Qual é a diferença entre RoCE v2 e InfiniBand?
RoCE v2 transporta RDMA sobre redes Ethernet/IP roteáveis. InfiniBand é uma arquitetura dedicada de fabric comutada, comumente usada para clusters HPC e de IA. A diferença operacional é que o RoCE herda a flexibilidade de projeto e a necessidade de ajuste da Ethernet, enquanto o InfiniBand é mais especializado na fabric.
O que é melhor para treinamento distribuído?
Para treinamento distribuído grande e fortemente acoplado, InfiniBand costuma ser o padrão mais seguro. RoCE pode ser uma opção forte quando a fabric Ethernet é isolada, ajustada, monitorada e comprovada com a mesma carga de treinamento.
O que é melhor para inferência?
Depende da arquitetura de inferência. Modelos particionados e serving entre nós se importam com a latência da fabric. Réplicas independentes podem se importar mais com memória de GPU, batching, taxa de acerto de cache, autoscaling e custo por saída aceita.
O que devo medir antes de escolher?
Execute NCCL all-reduce no número de nós alvo, reproduza a carga de trabalho real, inclua tráfego de armazenamento/checkpoint, injete falhas ou congestionamento e registre os contadores da fabric. A decisão roce vs infiniband deve seguir esses resultados.
Recomendação final
Não escolha roce vs infiniband com base em um benchmark genérico. Escolha com base na carga de trabalho, no modelo operacional e no teste de aceitação.
Escolha InfiniBand quando o cluster for uma fabric dedicada de IA/HPC, o treinamento distribuído for o caminho crítico e perder janelas de treinamento for caro. Escolha RoCE quando a padronização em Ethernet, a flexibilidade de aquisição e as operações existentes forem importantes, e a equipe puder comprovar o comportamento RDMA sem perdas sob cargas reais de GPU.
Se a aplicação só precisar de saídas de IA, e não de controle direto da fabric de GPU, compare as rotas de modelo/API gerenciadas pela Flatkey antes de alugar ou comprar o cluster. A rede mais barata é aquela que você não precisa operar.


