
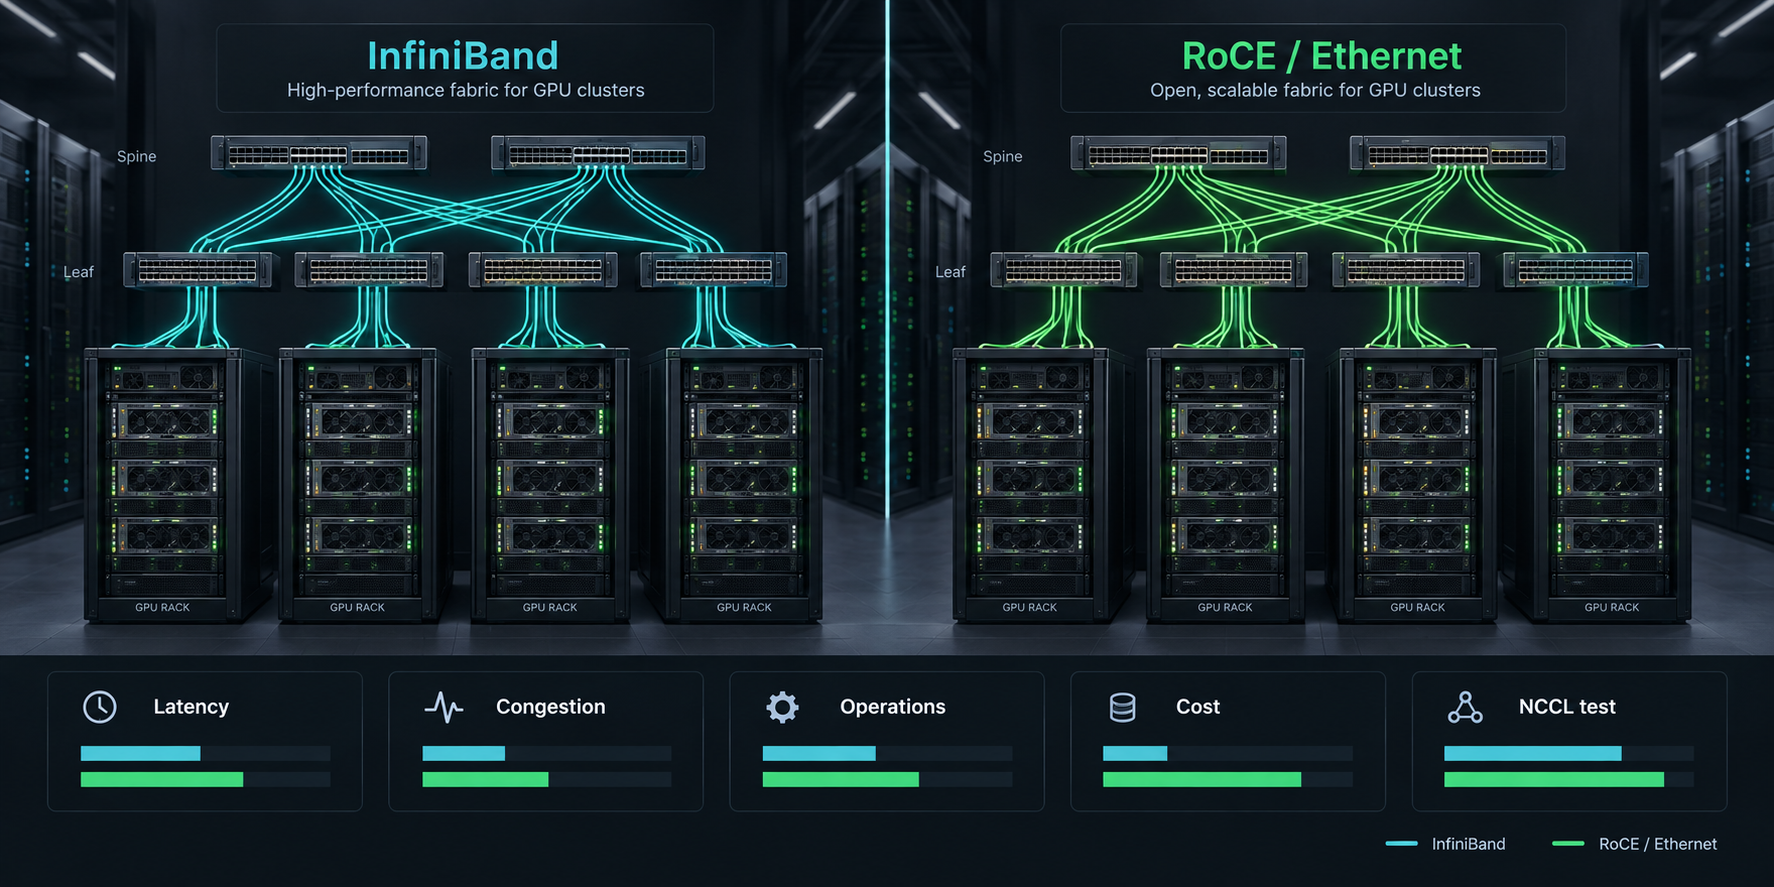
Большинство споров RoCE vs InfiniBand начинаются не с того места. Сравнивают названия протоколов вместо того, чтобы спросить, что именно должен выдержать GPU-кластер: тесно связанные обучающие задачи, шардированный инференс, общий поток к хранилищу, смешанных арендаторов, ограничения закупок и команду эксплуатации, которой предстоит настраивать фабрику после запуска.
Для многоузловых GPU-кластеров InfiniBand обычно является более безопасным выбором по умолчанию, когда нагрузка чувствительна к задержкам, активно использует коллективные операции и достаточно велика, чтобы оправдать специализированную AI/HPC-фабрику. RoCE обычно лучше подходит как отправная точка, когда команда уже эксплуатирует высокоскоростной Ethernet, хочет более широкий выбор вендоров и может доказать корректность безlossного Ethernet-дизайна реальными тестами NCCL до принятия решения.
Сложность в том, что оба варианта могут работать, и оба могут провалиться. Хорошо построенная фабрика RoCE v2 способна обслуживать серьезные AI-кластеры. Плохо эксплуатируемая фабрика InfiniBand все равно может не уложиться в окно обучения. Это руководство сравнивает roce vs infiniband по задержке, эксплуатации и стоимости, чтобы платформенные команды могли выбрать фабрику, которая соответствует нагрузке, а не самому громкому слайду вендора.
Краткий ответ: RoCE vs InfiniBand
Используйте эту таблицу как первичный фильтр для принятия решения.
| Ситуация | Обычно начинать с | Почему |
|---|---|---|
| Крупное распределенное обучение с частым трафиком all-reduce | InfiniBand | Это специализированная коммутируемая фабрика для HPC- и AI-коммуникаций с низкой задержкой и высокой пропускной способностью. |
| Коммерческое предложение на GPU-кластер уже включает проверенную NVIDIA Quantum или аналогичную InfiniBand-фабрику | InfiniBand | Риск смещается от проектирования к приемочным испытаниям и подтверждению со стороны провайдера. |
| У корпоративной сетевой команды уже есть глубокая автоматизация, мониторинг и закупочная гибкость в Ethernet | RoCE | RoCE сохраняет RDMA поверх Ethernet, но требует дисциплины в управлении перегрузками и безlossного поведения. |
| Смешанные AI-, storage- и обычные дата-центровые нагрузки в одной операционной модели | RoCE или отдельный Ethernet плюс выделенная AI-фабрика | RoCE может лучше соответствовать Ethernet-операциям, но общие фабрики нужно проектировать очень тщательно. |
| Небольшой парк для инференса, пакетные задачи или нагрузки, которые не масштабируются между узлами | Ни одна из фабрик не должна определять решение | Важнее GPU-память, утилизация, очереди и альтернативы модели/API, чем межсоединение. |
| Закупке требуется максимальное разнообразие вендоров и стандартные поставки коммутаторов | RoCE | Поставки Ethernet могут быть шире, тогда как кластеры InfiniBand более вертикально специализированы. |
| У команды нет опыта с RDMA-фабриками и нет окна для бенчмарков | Сначала арендуйте, потом решайте | Не подписывайте многонодовый контракт, пока не пройдут тесты NCCL, отказоустойчивости и наблюдаемости. |
Практический ответ: выбирайте InfiniBand, когда приложению нужна выделенная AI/HPC-фабрика с минимальным риском настройки на уровне протокола. Выбирайте RoCE, когда стандартизация Ethernet, гибкость закупок или существующие операционные процессы достаточно важны, чтобы оправдать дополнительную инженерную работу по фабрике.
Что означает InfiniBand в GPU-кластере
InfiniBand — это стандартная для отрасли коммутируемая фабричная архитектура, используемая для соединения серверов и хранилищ. В GPU-кластерах она обычно ассоциируется с низкой задержкой, высокой пропускной способностью, RDMA, GPU Direct RDMA, адаптивной маршрутизацией, управлением перегрузками и AI/HPC-инструментами, интегрированными вендором.
Важно не только то, что InfiniBand быстрый. Важно то, что он построен именно как фабрика. Управление подсетью, поведение на уровне фабрики, виртуальные линии, качество обслуживания, ускорение в сети и интеграция коммутатора/адаптера — все это часть границ проектирования. Это имеет значение, когда training job охватывает сотни или тысячи GPU, а каждая коллективная операция усиливает хвостовые задержки.
Примеры из облака показывают, почему эта фабрика по-прежнему доминирует во многих крупных AI-кластерах. В документации Azure для ND H100 v5 указаны восемь H100 GPU на ВМ, выделенное подключение NVIDIA Quantum-2 CX7 InfiniBand 400 Гбит/с на каждый GPU, 3,2 Тбит/с суммарной межсоединительной полосы пропускания на ВМ, поддержка GPU Direct RDMA и масштабирование кластера, ориентированное на NCCL. Эти детали — не просто общие слова про "быструю сеть"; это факты о конфигурации кластера, которые влияют на поведение распределенного обучения.
Для покупателя вопрос по InfiniBand должен быть конкретным:
- Поколение InfiniBand и платформа коммутаторов какого типа включены?
- Сколько NIC или host channel adapter подключено на узел?
- Привязан ли каждый GPU к выделенному сетевому пути или трафик агрегируется?
- Включен и протестирован ли GPUDirect RDMA?
- Какая гарантия размещения обеспечивает нахождение узлов в одном домене фабрики?
- Какими средствами управления фабрикой, телеметрии и устранения неполадок владеет провайдер?
Если продавец говорит только "InfiniBand included", предложение неполное.
Что означает RoCE в GPU-кластере
RoCE означает RDMA over Converged Ethernet. RoCE v2 передает RDMA по маршрутизируемым сетям Ethernet/IP, что позволяет командам использовать Ethernet-коммутацию, при этом в значительной степени обходя CPU и накладные расходы ядра, характерные для обычных TCP-путей.
В этом и состоит его привлекательность. RoCE может позволить команде AI-платформы строить GPU-кластеры с поддержкой RDMA на Ethernet-коммутаторах, с Ethernet-операционными практиками и более широким полем закупок. Для организаций, которые уже эксплуатируют высокоскоростной Ethernet в масштабе, RoCE может проще встроиться в процессы управления изменениями, телеметрию, кабельную инфраструктуру, оптику и работу с вендорами.
Компромисс в том, что RoCE зависит от того, насколько хорошо Ethernet-фабрика ведет себя под нагрузкой. Коллективные операции GPU создают синхронизированные всплески. Чекпойнтинг и трафик хранилища могут пересекаться с обучающим трафиком. Перегрузка может превращаться в скачки задержки. Для RDMA потеря пакетов может оказаться намного дороже, чем для обычного прикладного трафика.
Поэтому проектирование кластера RoCE обычно включает:
- Управление приоритетным потоком (Priority Flow Control) или другая протестированная стратегия без потерь.
- Явное уведомление о перегрузке (Explicit Congestion Notification) и настройка управления перегрузкой.
- Настройка Data Center Bridging на коммутаторах и NIC.
- Дисциплина в сопоставлении очередей, классов обслуживания и DSCP/приоритетов.
- Счетчики по приоритетам для потерь, pause-кадров, ECN-маркеров, ретрансмитов и давления на буферы.
- Строгий контроль изменений для прошивок, ОС коммутаторов, драйверов NIC, MTU и политики маршрутизации.
RoCE может быть отличным решением, но мысль, что «это всего лишь Ethernet», — неверная модель мышления. В GPU-кластере RoCE — это спроектированная Ethernet-ткань для RDMA-трафика.
Задержка: сравнивайте поведение хвостов, а не только медиану
При выборе между roce vs infiniband средняя задержка менее полезна, чем поведение хвостов под реальной коллективной нагрузкой.
Распределенное обучение часто ждет самого медленного участника. Небольшое число рангов с более высокой задержкой может замедлить весь шаг. Для распределенного инференса p95 и p99 сетевой задержки могут проявляться как видимая пользователю задержка или более низкая эффективность батчинга. Для обучения с интенсивной работой со storage трафик чекпоинтов может создавать всплески, которых не видно в чистом микробенчмарке.
Измеряйте на четырех уровнях:
| Уровень | Что измерять | Почему это важно |
|---|---|---|
| Линк и фабрика | Ошибки портов, потери, ECN-маркеры, pause-кадры, события перегрузки, изменения маршрута | Позволяет выявить проблемы с состоянием фабрики до того, как их начнут приписывать фреймворкам. |
| RDMA-транспорт | Ретранситы, задержка завершения, глубина очереди, счетчики NIC | Показывает, стабилен ли RDMA под нагрузкой. |
| Коллективы NCCL | полоса пропускания all-reduce, bus bandwidth, min/avg/max latency, время на итерацию | Соответствует шаблонам коммуникации при AI-обучении. |
| Приложение | время шага, токены/с, задержка запроса, длительность чекпоинта, восстановление после сбоев | Показывает финансовым и продуктовым командам, помогает ли фабрика выполнять полезную работу. |
У InfiniBand часто есть преимущество, потому что многие кластерные архитектуры изначально строятся и проверяются под коллективно-интенсивные нагрузки. RoCE может сократить разрыв, когда Ethernet-фабрика настроена, изолирована и подтверждена на практике. Проверка заключается не в том, может ли RoCE v2 теоретически выполнять RDMA. Проверка в том, выдерживает ли именно эта комбинация коммутатора/NIC/кабелей/драйверов/топологии поведение p95 и p99 на той нагрузке, которую вы действительно будете запускать.
Эксплуатация: InfiniBand специализирован, RoCE интегрирован
Эксплуатация — это та область, где roce vs infiniband comparison становится менее очевидным.
InfiniBand дает платформенным командам специализированную фабрику со зрелыми предположениями для AI/HPC. Это может уменьшить неопределенность в настройке. Обратная сторона в том, что команде нужны навыки, специфичные для InfiniBand, инструменты управления fabric, знание subnet manager и каналы поддержки. Если кластер арендуется у специализированного провайдера или гиперскейлера, многое из этого может быть скрыто за границей обслуживания провайдера. Если кластер находится в собственности или colocation, разрыв в навыках становится реальным.
RoCE более естественно вписывается во многие корпоративные сетевые организации, потому что он работает поверх Ethernet. Закупки, кабельная инфраструктура, эксплуатация коммутаторов, мониторинг и паттерны управления изменениями могут уже существовать. Риск в том, что обычной эксплуатации Ethernet недостаточно. RDMA-трафику требуется последовательная обработка end-to-end. Обычное изменение политики на коммутаторе может нарушить fabric, если PFC, ECN, сопоставление очередей, MTU, хеширование или управление перегрузкой отклонятся от нормы.
Используйте этот чек-лист операционной модели:
| Операционный вопрос | Ответ InfiniBand на требование | Ответ RoCE на требование |
|---|---|---|
| Кто владеет проектированием fabric? | Специалист по AI/HPC networking или провайдер | Сетевая команда плюс владелец AI-платформы |
| Кто проверяет топологию? | Отчет о fabric от провайдера, инструменты subnet/fabric, тесты NCCL | Аудит конфигурации коммутатора/NIC, телеметрия, тесты NCCL |
| Что ломается чаще всего? | Несоответствие размещения, дрейф прошивки/драйверов, отказавшие линki, неподдерживаемые допущения по топологии | Дрейф конфигурации без потерь, неверная настройка перегрузки, влияние общего трафика, ошибки сопоставления очередей |
| Что нужно мониторить? | Состояние линка, ошибки портов, перегрузки, здоровье маршрутов, совместимость GPU/NIC, производительность NCCL | Потери, поведение pause/ECN, PFC-storms, ретранситы, давление на буферы, производительность NCCL |
| Какого навыка не хватает? | Специалистов по fabric InfiniBand | Инженеров, которые понимают и операционную модель Ethernet, и AI-трафик, чувствительный к RDMA |
Если у вашей команды уже есть сильная автоматизация Ethernet, но нет навыков InfiniBand, RoCE может быть операционно более привлекательным. Если ваша команда хочет, чтобы провайдер взял на себя AI-fabric как протестированный уровень, похожий на appliance, InfiniBand может снизить риск поставки.
Стоимость: учитывайте риск fabric, а не только цену коммутатора
RoCE часто подается как более дешевый вариант, потому что Ethernet-оборудование можно широко закупать и переиспользовать. InfiniBand часто подается как дорогой, потому что это специализированная AI/HPC fabric. Эти утверждения могут быть верны и при этом приводить к плохим решениям.
Для GPU-кластеров стоимость fabric — это не только цена коммутаторов, NIC, оптики и кабелей. Это стоимость выполненной полезной работы.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Затем нормализуйте:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
или:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE может выиграть, когда закупка Ethernet, повторное использование и эксплуатация снижают общую стоимость без ущерба для завершения задач. InfiniBand может выиграть, когда более высокая стоимость fabric позволяет избежать задержек обучения, сбоев многонодовых задач и недель настройки. Более дешевая fabric, из-за которой дорогие GPU простаивают, не является более дешевой.
Привяжите решение по стоимости roce networking vs infiniband к трем числам:
- Полезная загрузка GPU после сетевых остановок и неудачных задач.
- Коэффициент приемки бенчмарка на точном количестве узлов.
- Часы работы, необходимые для поддержания стабильности fabric.
Если этих чисел нет, модель стоимости не готова.
Соответствие нагрузке: обучение, инференс, хранилище и смешанные кластеры
Правильное сравнение roce vs infiniband comparison зависит от характера трафика.
Распределенное обучение
Распределенное обучение — самый сильный сценарий для InfiniBand. Крупные операции all-reduce и reduce-scatter, синхронизированные шаги и scale-out задачи сильно страдают от джиттера. Если задача охватывает много узлов, а бизнесу важно завершать окна обучения по графику, InfiniBand часто оказывается менее рискованным путем.
RoCE по-прежнему может быть valid choice, особенно в организациях с сильной практикой Ethernet/RDMA. Но это нужно доказать на той же семейства модели, фреймворке, точности, размере батча, количестве узлов и схеме checkpoint, которые вы планируете запускать.
Шардированный и распределенный инференс
Инференс более смешанный. Если модель разделена между GPU или узлами, важна сетевая задержка. Если парк в основном состоит из независимых реплик, большее значение могут иметь память GPU, батчинг, поведение кэша, очередь и autoscaling, а не fabric.
Для многих production-команд по инференсу лучший первый вопрос — не InfiniBand vs RoCE. А нужен ли вообще workload с прямым управлением GPU. Если managed model API может уложиться в целевую задержку, качество, конфиденциальность и стоимость, сравните этот путь до подписания контракта на кластер.
Связанное чтение: руководства Flatkey по GPU cloud vs model API, best GPU for LLM inference и vLLM deployment охватывают границу затрат на стороне serving.
Нагрузки с интенсивным использованием хранилища
Обучающие запуски, которые подготавливают большие наборы данных, часто записывают checkpoint или перезагружают веса модели, могут превратиться в проблемы сетевого хранилища. Быстрый GPU fabric не исправит медленную подготовку датасета или shared filesystem, который насыщается во время checkpoint.
Для InfiniBand и RoCE включайте storage в бенчмарк:
- Время загрузки датасета.
- Время записи и восстановления checkpoint.
- Поведение локального NVMe spill.
- Путь к object storage и egress.
- Contention shared filesystem.
- Время восстановления после отказа узла.
Многопользовательские GPU-кластеры
Многопользовательским кластерам нужна более сильная изоляция, чем лаборатории бенчмарка. Шумные соседи, фоновые задачи хранения, пользовательские контейнеры и окна обслуживания могут изменить поведение fabric. И InfiniBand, и RoCE требуют контроля допуска, квот, телеметрии и реагирования на инциденты. RoCE требует дополнительной осторожности, когда RDMA-трафик разделяет операционные границы с обычным Ethernet-трафиком.
Тест приемки для любой fabric
Не принимайте сравнение infiniband vs roce comparison от вендора как доказательство. Проведите тест приемки на точной конфигурации кластера, который вы будете покупать или арендовать.
1. Зафиксируйте состав тестового оборудования
Запишите:
- Модель GPU, объем памяти и количество GPU на узел.
- CPU, RAM, конфигурацию PCIe/SXM, NUMA и локальный NVMe.
- Модель NIC/HCA, скорость, прошивку и драйвер.
- Модель switch, ОС switch и поколение fabric.
- Оптику, тип кабеля и скорость линии.
- Конфигурацию MTU и очередей.
- Placement group, стойку, зону, регион и количество узлов.
- CUDA, NCCL, MPI, фреймворк, образ контейнера и версию ядра.
Если что-то из этого меняется после бенчмарка, повторите тест.
2. Запустите NCCL-тесты на каждом узле
Проект NVIDIA nccl-tests — практическая базовая линия, потому что он проверяет и производительность, и корректность операций NCCL и поддерживает многонодовые MPI-запуски.
Пример формы приемки:
# Сборка с поддержкой MPI.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Пример: 8 узлов, 8 GPU на узел, всего 64 ранга.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Отслеживайте:
- Алгоритмическую пропускную способность и пропускную способность шины.
- Минимальную, среднюю и максимальную задержку.
- p95/p99 на каждую итерацию, если включено.
- Выбросы по рангу.
- Ошибки проверки корректности.
- Разброс между повторными запусками.
- Производительность после перезагрузки узла, перезапуска драйвера или события обслуживания switch.
3. Воспроизведите фактическую нагрузку
Микробенчмарки необходимы, но недостаточны. Воспроизведите одну реальную задачу обучения или инференса:
- Та же семейства модели и длина последовательности.
- Тот же фреймворк и стратегия распределения.
- Та же точность, квантизация и размер батча.
- Та же частота checkpoint.
- Тот же путь данных.
- Та же политика autoscaling или планировщика задач.
Затем сравните время шага, tokens/sec, задержку в очереди, длительность checkpoint, восстановление после сбоя и стоимость за принятый результат.
4. Индуцируйте отказ и перегрузку
Fabric, которая проходит тест только в идеальный день, не готова к production.
Проверьте:
- Один узел удалён из задания.
- Один линк недоступен или деградировал.
- Всплеск контрольной точки хранилища во время обучения.
- Фоновая нагрузка инференса во время обучения.
- Пороговые значения счётчиков коммутатора/NIC и оповещения.
- Ответ поддержки провайдера на инцидент в fabric.
Победитель в roce vs infiniband — это fabric, который делает полезную работу предсказуемой после этих тестов, а не fabric с лучшей теоретической пропускной способностью линии.
Вопросы для закупки у поставщиков InfiniBand
Задайте их до подписания:
- Какая именно версия InfiniBand, модель коммутатора, модель адаптера и скорость линка включены?
- Включён ли GPUDirect RDMA и поддерживается ли он для стека GPU, драйвера и фреймворка?
- Гарантируется ли, что все узлы находятся в одном домене fabric или группе размещения?
- Какие результаты NCCL all-reduce вы можете предоставить для того же количества GPU?
- Кто отвечает за управление subnet, обновления прошивок, настройку перегрузок и реагирование на инциденты?
- Включены ли и поддерживаются ли SHARP, адаптивная маршрутизация, качество обслуживания или встроенные в сеть функции?
- Какие метрики видит заказчик: счётчики портов, события перегрузки, ошибки HCA, изменения маршрутов и метрики fabric на уровне задания?
- Что будет в финансовом плане, если предложенный fabric не пройдёт согласованный бенчмарк?
- Можно ли масштабировать кластер без изменения топологии или предположений об оверсабскрипции?
- Какие применяются окна обслуживания, запасные части и сроки замены?
Вопросы для закупки у поставщиков RoCE
Задайте их до подписания:
- Является ли fabric RoCE v2 и маршрутизируется ли он по нужной топологии?
- Какие модели коммутаторов и NIC подтверждены для именно такой конфигурации GPU-кластера?
- Какие настройки PFC, ECN, DSCP, очередей, MTU и управления перегрузкой требуются?
- Изолирован ли трафик RDMA от обычного Ethernet-трафика или он общий?
- Какие счётчики подтверждают, что конфигурация без потерь здорова под нагрузкой NCCL?
- Как обнаруживаются PFC-штормы, накопление pause-кадров, неверная настройка ECN и давление на буферы?
- Кто отвечает за дрейф конфигурации коммутатора и совместимость прошивок?
- Какие результаты NCCL существуют для того же числа узлов и класса нагрузки?
- Может ли сетевая команда воспроизвести конфигурацию из кода?
- Какова граница поддержки, если проблема затрагивает драйвер GPU, прошивку NIC, политику коммутатора и прикладной фреймворк?
Матрица принятия решения
Используйте эту матрицу после бенчмарка, а не до него.
| Критерий | Предпочтителен InfiniBand, когда... | Предпочтителен RoCE, когда... |
|---|---|---|
| Чувствительность к задержке | Время шага обучения определяется collective-операциями или p99-джиттер мешает инференсу | Тесты показывают стабильные p95/p99 под реальной нагрузкой |
| Масштаб | Кластер охватывает много узлов и требует предсказуемого размещения | Кластер среднего масштаба или Ethernet fabric уже доказал работоспособность на сопоставимом масштабе |
| Эксплуатация | У провайдера или команды есть опыт с fabric InfiniBand | Сетевая команда имеет сильную автоматизацию Ethernet и практику, специфичную для RDMA |
| Закупка | Можно купить или арендовать валидированный AI/HPC fabric | Вам нужно более широкое разнообразие поставщиков коммутаторов или стандартизация Ethernet |
| Стоимость | Избежание сбоев заданий и задержек на настройку оправдывает стоимость специализированного fabric | Экономия на Ethernet сохраняется после учёта настройки, телеметрии и затрат на повторы |
| Гибкость | Кластер выделен под AI/HPC-нагрузки | Fabric должен соответствовать более широким практикам сетей дата-центра |
| Риск | Срок проекта сжат, а неопределённость в fabric дорого обходится | У команды есть время и навыки, чтобы валидировать и эксплуатировать lossless Ethernet |
Если по матрице получается ничья, арендуйте или протестируйте оба варианта. Сетевое взаимодействие GPU между несколькими узлами слишком дорого, чтобы решать вопрос только по краткому описанию протокола.
Заполняемая таблица RoCE vs InfiniBand
Используйте эту таблицу в документе закупки.
| Поле | Вариант InfiniBand | Вариант RoCE |
|---|---|---|
| Модель GPU и число узлов | ||
| Версия fabric и скорость линка | ||
| NIC/HCA на узел | ||
| Модель коммутатора и число портов | ||
| Коэффициент оверсабскрипции | ||
| Гарантия размещения | ||
| Поддержка GPUDirect RDMA | ||
| Полоса пропускания NCCL all-reduce | ||
| Задержка NCCL p95/p99 или максимальная | ||
| Время шага обучения | ||
| Время записи/восстановления контрольной точки | ||
| Счётчики потерь/перегрузки fabric | ||
| Ответственный за эксплуатацию | ||
| SLA поддержки | ||
| Ежемесячная стоимость fabric | ||
| Оценка потерь на простое/повторы | ||
| Стоимость одного принятого результата | ||
| Путь расширения | ||
| Риск выхода |
Самые важные строки — не указанная цена fabric. Это результат бенчмарка, ответственный за эксплуатацию, потери на простое/повторы и путь расширения.
Когда API модели — лучший ответ
Некоторые команды, исследующие roce vs infiniband, на самом деле ещё не готовы покупать сетевой fabric. Они пытаются снизить стоимость вывода AI, убрать задержку в очереди или выпустить функцию продукта.
Если рабочая нагрузка не требует пользовательских весов, прямого планирования GPU, пользовательских ядер, строгого размещения или изоляции на уровне оборудования, сначала сравните управляемый API модели. Flatkey дает командам один ключ, один баланс и один журнал использования по официальным моделям и ИИ-инструментам, что может быть проще, чем владеть GPU-кластером, пока продукт еще меняется.
Используйте вариант с fabric, когда нужен контроль над оборудованием. Используйте вариант с моделью/API, когда бизнес-метрика — это принятые результаты, а не владение сетью.
Связанные руководства Flatkey:
- TCO GPU-кластера для расчета аренды в облаке, колокейшна и on-premises.
- Аренда GPU-кластера для оценки провайдеров и контрактов на мощности.
- Цены на аренду GPU для on-demand, spot, reserved и скрытых затрат.
- Serverless GPU vs dedicated GPU для холодных стартов, простаивающих мощностей и контроля.
Чек-лист официальных источников
Используйте официальные страницы как проверку источников, затем верифицируйте именно тот кластер, который вы покупаете.
| Источник | Что проверить |
|---|---|
| InfiniBand Trade Association: About InfiniBand | InfiniBand как стандартную для отрасли коммутируемую fabric для подключения серверов и хранилищ. |
| Платформа NVIDIA Quantum InfiniBand | Позиционирование InfiniBand для переключателей, адаптеров, управления fabric, SHARP и AI/HPC fabric. |
| NVIDIA Spectrum-X Ethernet | Позиционирование сетей для AI на базе Ethernet/RoCE и заявления о управлении перегрузками, которые нужно проверить. |
| Размеры Azure ND H100 v5 | Пример облачных GPU-кластеров, использующих выделенный InfiniBand на каждую GPU и GPUDirect RDMA. |
| AWS Elastic Fabric Adapter | Облачная альтернатива с обходом ОС, управлением перегрузками, Libfabric, NCCL и поддержкой GPUDirect RDMA на выбранных инстансах. |
| Документация Google Cloud GPUDirect | Требования к настройке GPU-сети в облаке для инстансов семейства A3 с поддержкой GPUDirect. |
| NVIDIA nccl-tests | Воспроизводимые тесты коллективных операций и проверки корректности для точной формы кластера. |
Не рассматривайте эти страницы как замену приемочным тестам. Рассматривайте их как минимальный список источников для серьезной проверки перед покупкой.
Часто задаваемые вопросы
InfiniBand всегда быстрее, чем RoCE?
Нет. InfiniBand обычно является более безопасным выбором для специализированных, чувствительных к задержкам AI/HPC fabric, но хорошо спроектированная fabric RoCE v2 тоже может показывать высокую производительность. Сравнивайте конкретный кластер с помощью NCCL и прикладных тестов.
RoCE дешевле, чем InfiniBand?
RoCE может быть дешевле, когда закупка Ethernet, повторное использование и существующие операции снижают общую стоимость. Он не будет дешевле, если настройка lossless Ethernet, инциденты перегрузки, сбои заданий или простаивающие GPU съедят экономию.
В чем разница между RoCE v2 и InfiniBand?
RoCE v2 передает RDMA по маршрутизируемым сетям Ethernet/IP. InfiniBand — это выделенная архитектура коммутируемой fabric, обычно используемая для HPC и AI-кластеров. Операционная разница в том, что RoCE наследует гибкость проектирования Ethernet и необходимость тонкой настройки, тогда как InfiniBand более специализирован именно под fabric.
Что лучше для распределенного обучения?
Для крупного, тесно связанного распределенного обучения InfiniBand часто является более безопасным выбором по умолчанию. RoCE может быть сильным вариантом, когда Ethernet fabric изолирована, настроена, мониторится и подтверждена на той же обучающей нагрузке.
Что лучше для инференса?
Это зависит от архитектуры инференса. Для шардинговых моделей и кросс-нодового обслуживания важна задержка fabric. Для независимых реплик важнее память GPU, батчинг, hit rate кэша, autoscaling и стоимость за принятый результат.
Что следует протестировать перед выбором?
Запустите NCCL all-reduce на целевом числе узлов, воспроизведите реальную нагрузку, включите трафик хранилища/чекпоинтов, сымитируйте сбои или перегрузку и запишите счетчики fabric. Решение roce vs infiniband должно следовать из этих результатов.
Итоговая рекомендация
Не выбирайте roce vs infiniband по общему бенчмарку. Выбирайте на основе рабочей нагрузки, операционной модели и приемочного теста.
Выбирайте InfiniBand, когда кластер — это выделенная AI/HPC fabric, распределенное обучение является критическим путем, а пропущенные окна обучения дороги. Выбирайте RoCE, когда важны стандартизация Ethernet, гибкость закупок и существующие операции, и команда может доказать поведение lossless RDMA на реальных GPU-нагрузках.
Если приложению нужны только AI-результаты, а не прямой контроль fabric GPU, сравните управляемые маршруты Flatkey model/API прежде чем арендовать или покупать кластер. Самая дешевая сеть — та, которой вам не нужно управлять.


