
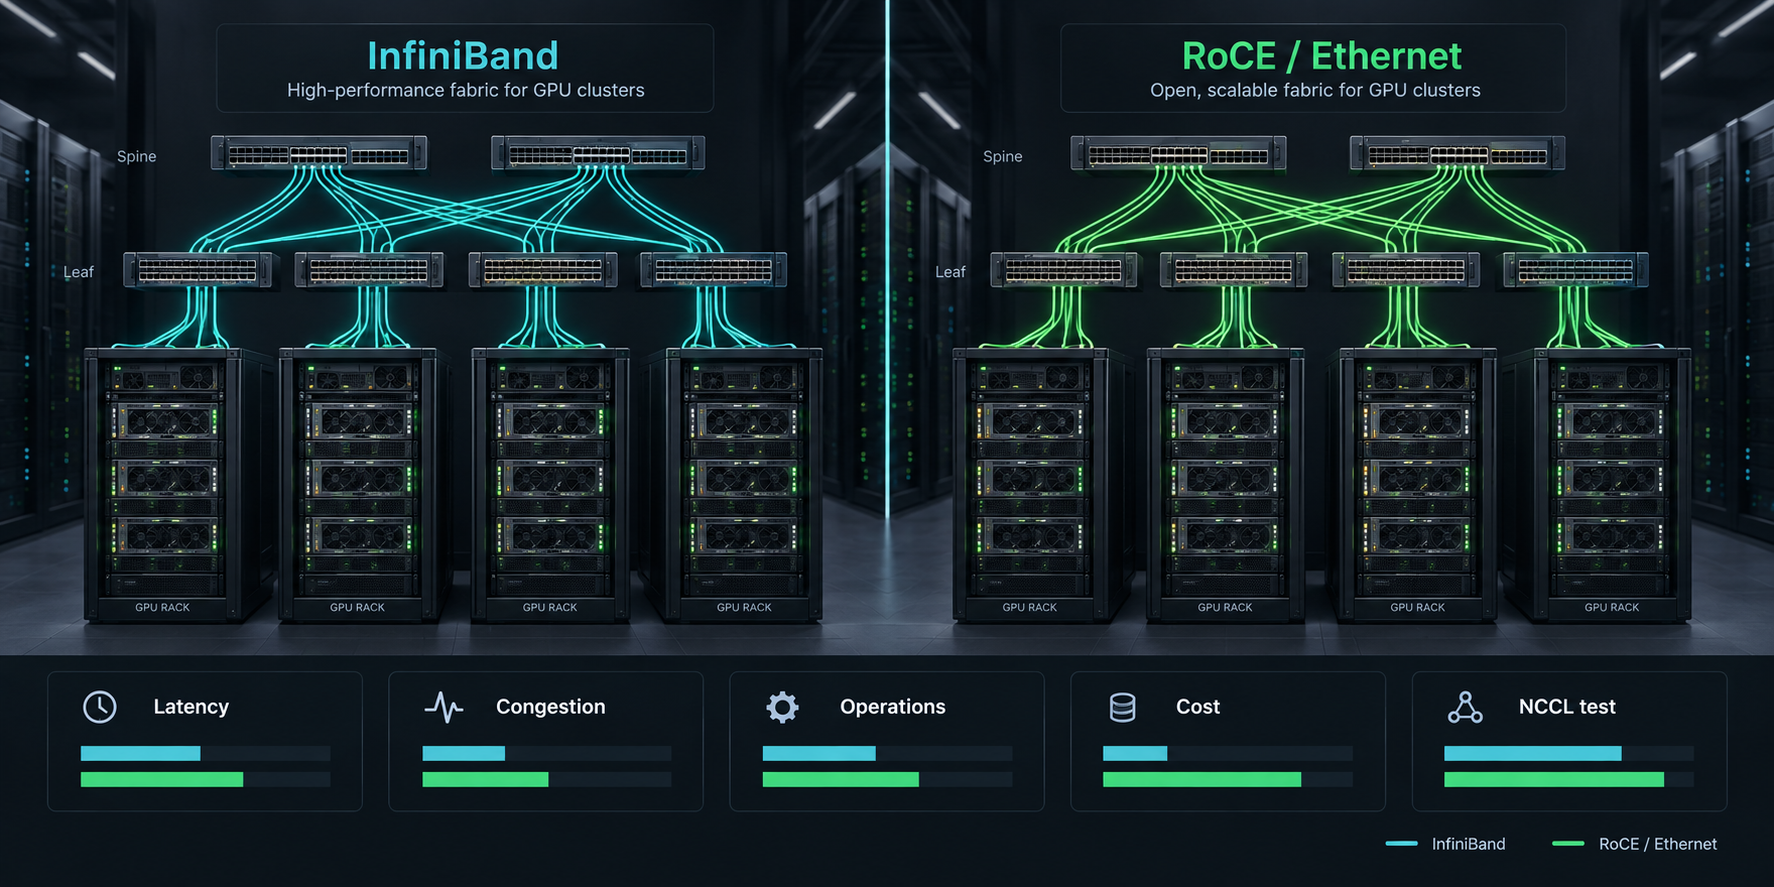
La mayoría de los debates sobre RoCE frente a InfiniBand empiezan en el lugar equivocado. Comparan nombres de protocolos en lugar de preguntarse qué tiene que soportar el clúster de GPU: entrenamiento estrechamente acoplado, inferencia fragmentada, tráfico de almacenamiento compartido, inquilinos mixtos, límites de aprovisionamiento y el equipo de operaciones que ajustará la red después del lanzamiento.
Para clústeres de GPU multinodo, InfiniBand suele ser la opción predeterminada más segura cuando la carga de trabajo es sensible a la latencia, intensiva en colectivas y lo bastante grande como para justificar una red de IA/HPC diseñada específicamente. RoCE suele ser un mejor punto de partida cuando el equipo ya opera Ethernet de alta velocidad, quiere una mayor variedad de proveedores y puede demostrar el diseño Ethernet sin pérdidas con pruebas reales de NCCL antes de comprometerse.
La parte difícil es que ambos pueden funcionar, y ambos pueden fallar. Una red RoCE v2 bien construida puede ejecutar clústeres de IA serios. Una red InfiniBand mal operada todavía puede no llegar a tiempo para la ventana de entrenamiento. Esta guía compara roce vs infiniband a través de la latencia, las operaciones y el coste para que los equipos de plataforma puedan elegir la red que encaje con la carga de trabajo en lugar de con la diapositiva más ruidosa del proveedor.
Respuesta rápida: RoCE vs InfiniBand
Use esta tabla como filtro de decisión inicial.
| Situación | Normalmente empezar con | Por qué |
|---|---|---|
| Entrenamiento distribuido a gran escala con tráfico all-reduce frecuente | InfiniBand | Es una red conmutada diseñada específicamente para comunicaciones HPC e IA de baja latencia y alto ancho de banda. |
| La oferta del clúster de GPU ya incluye una red NVIDIA Quantum validada o similar de InfiniBand | InfiniBand | El riesgo pasa del diseño a las pruebas de aceptación y a la validación del proveedor. |
| El equipo de red de la empresa ya cuenta con una profunda automatización Ethernet, monitorización y capacidad de compra | RoCE | RoCE mantiene RDMA sobre Ethernet, pero requiere un control de congestión disciplinado y comportamiento sin pérdidas. |
| Tráfico mixto de IA, almacenamiento y centro de datos convencional en un solo modelo operativo | RoCE o Ethernet separada más red de IA dedicada | RoCE puede alinearse con las operaciones de Ethernet, pero las redes compartidas deben diseñarse con cuidado. |
| Pequeña flota de inferencia, trabajos por lotes o cargas que no escalan entre nodos | Ninguna de las dos redes debería impulsar la decisión | La memoria de GPU, la utilización, la cola y las alternativas de modelo/API importan más que la interconexión. |
| El aprovisionamiento necesita la máxima diversidad de proveedores y un suministro estándar de switches | RoCE | El abastecimiento Ethernet puede ser más amplio, mientras que los clústeres InfiniBand están más especializados verticalmente. |
| El equipo no tiene experiencia en redes RDMA ni ventana de evaluación | Primero alquilar, luego decidir | No firme un contrato multinodo hasta que pasen las pruebas de NCCL, fallos y observabilidad. |
La respuesta práctica: elija InfiniBand cuando la aplicación necesite una red de IA/HPC dedicada con el menor riesgo de ajuste a nivel de protocolo. Elija RoCE cuando la estandarización Ethernet, la flexibilidad de aprovisionamiento o las operaciones existentes sean lo bastante importantes como para justificar la ingeniería adicional de la red.
Qué significa InfiniBand en un clúster de GPU
InfiniBand es una arquitectura de red conmutada estándar del sector utilizada para interconectar servidores y almacenamiento. En clústeres de GPU, suele asociarse con baja latencia, alto ancho de banda, RDMA, GPU Direct RDMA, enrutamiento adaptativo, gestión de congestión y herramientas de IA/HPC integradas por el proveedor.
El punto importante no es solo que InfiniBand sea rápida. El punto importante es que está diseñada como una red. La gestión de subredes, el comportamiento a nivel de red, los carriles virtuales, la calidad de servicio, la aceleración en la red y la integración de switches/adaptadores forman parte del límite de diseño. Eso importa cuando una tarea de entrenamiento abarca cientos o miles de GPU y cada operación colectiva amplifica la latencia de cola.
Los ejemplos en la nube muestran por qué esta red sigue dominando muchos clústeres de IA de gran tamaño. La documentación de ND H100 v5 de Azure describe ocho GPU H100 por VM, conectividad InfiniBand NVIDIA Quantum-2 CX7 dedicada de 400 Gbps por GPU, 3,2 Tbps de ancho de banda de interconexión por VM, compatibilidad con GPU Direct RDMA y escalado de clúster orientado a NCCL. Esos detalles no son lenguaje genérico de "red rápida"; son hechos sobre la forma del clúster que afectan al comportamiento del entrenamiento distribuido.
Para un comprador, la pregunta sobre InfiniBand debe ser específica:
- ¿Qué generación de InfiniBand y qué plataforma de switches se incluyen?
- ¿Cuántas NIC o adaptadores de canal de host están conectados por nodo?
- ¿Cada GPU se asigna a una ruta de red dedicada o el tráfico se agrega?
- ¿GPU Direct RDMA está habilitado y probado?
- ¿Qué garantía de ubicación mantiene los nodos dentro del mismo dominio de red?
- ¿Qué gestión de red, telemetría y remediación asume el proveedor?
Si el vendedor solo dice "InfiniBand incluida", la oferta está incompleta.
Qué significa RoCE en un clúster de GPU
RoCE significa RDMA over Converged Ethernet. RoCE v2 transporta RDMA sobre redes Ethernet/IP encaminables, lo que permite a los equipos usar conmutación Ethernet y al mismo tiempo evitar gran parte de la sobrecarga de CPU y kernel asociada a las rutas TCP ordinarias.
Esa es la ventaja. RoCE puede permitir que un equipo de plataforma de IA construya clústeres de GPU con capacidad RDMA usando switches Ethernet, prácticas operativas Ethernet y una superficie de aprovisionamiento más amplia. Para organizaciones que ya operan Ethernet de alta velocidad a escala, RoCE puede ser más fácil de integrar en el control de cambios, la telemetría, el cableado, la óptica y la gestión de proveedores.
La contrapartida es que RoCE depende de que la red Ethernet se comporte bien bajo carga. Las colectivas de GPU generan ráfagas sincronizadas. El checkpointing y el tráfico de almacenamiento pueden chocar con el tráfico de entrenamiento. La congestión puede convertirse en picos de latencia. La pérdida de paquetes puede ser mucho más costosa para RDMA que para el tráfico de aplicaciones ordinario.
Por eso, el diseño de clúster RoCE suele incluir:
- Control de flujo de prioridad u otra estrategia sin pérdidas probada.
- Notificación explícita de congestión y ajuste del control de congestión.
- Configuración de Data Center Bridging en switches y NIC.
- Disciplina en el mapeo de colas, clase de servicio y DSCP/prioridad.
- Contadores por prioridad de pérdidas, tramas de pausa, marcas ECN, retransmisiones y presión de buffer.
- Control estricto de cambios para firmware, sistema operativo del switch, controladores NIC, MTU y política de enrutamiento.
RoCE puede ser excelente, pero "es solo Ethernet" es el modelo mental equivocado. En un clúster de GPU, RoCE es una infraestructura Ethernet diseñada para tráfico RDMA.
Latencia: compare el comportamiento de la cola, no solo la mediana
En la decisión roce vs infiniband, la latencia media es menos útil que el comportamiento de la cola bajo carga colectiva real.
El entrenamiento distribuido a menudo espera al participante más lento. Un pequeño número de ranks con mayor latencia puede frenar todo el paso. En la inferencia fragmentada, la latencia de red p95 y p99 puede aparecer como latencia visible para el usuario o menor eficiencia de lotes. En el entrenamiento con mucho almacenamiento, el tráfico de checkpoints puede crear ráfagas invisibles en un microbenchmark limpio.
Mida en cuatro niveles:
| Capa | Qué medir | Por qué importa |
|---|---|---|
| Enlace e infraestructura | Errores de puerto, pérdidas, marcas ECN, tramas de pausa, eventos de congestión, cambios de ruta | Detecta problemas de salud de la infraestructura antes de culpar a los frameworks. |
| Transporte RDMA | Retransmisiones, latencia de finalización, profundidad de cola, contadores NIC | Muestra si RDMA es estable bajo presión. |
| Colectivas NCCL | ancho de banda all-reduce, ancho de banda del bus, latencia mín/med/max, tiempo por iteración | Se ajusta a los patrones de comunicación del entrenamiento de IA. |
| Aplicación | tiempo de paso, tokens/seg, latencia de solicitud, duración del checkpoint, recuperación ante fallos | Dice a los equipos de finanzas y producto si la infraestructura ayuda al trabajo útil. |
InfiniBand suele tener ventaja porque muchos diseños de clúster se construyen y validan desde el principio alrededor de cargas de trabajo intensivas en colectivas. RoCE puede cerrar la brecha cuando la infraestructura Ethernet está ajustada, aislada y validada. La prueba no es si RoCE v2 puede, en teoría, hacer RDMA. La prueba es si esta combinación exacta de switch/NIC/cableado/controlador/topología mantiene el comportamiento p95 y p99 durante la carga de trabajo que realmente ejecutará.
Operaciones: InfiniBand está especializado, RoCE está integrado
Las operaciones son donde la comparación roce vs infiniband se vuelve menos obvia.
InfiniBand ofrece a los equipos de plataforma una infraestructura especializada con supuestos maduros para IA/HPC. Eso puede reducir la ambigüedad de ajuste. La desventaja es que el equipo necesita habilidades específicas de InfiniBand, herramientas de gestión de la infraestructura, conocimiento del gestor de subredes y vías de soporte. Si el clúster se alquila a un proveedor especializado o a un hyperscaler, gran parte de eso puede quedar oculta tras el límite de servicio del proveedor. Si el clúster es propio o está en colocation, la brecha de habilidades se vuelve real.
RoCE encaja de forma más natural en muchas organizaciones de red empresariales porque funciona sobre Ethernet. La adquisición, el cableado, las operaciones de switches, la supervisión y los patrones de gestión de cambios pueden ya existir. El riesgo es que las operaciones Ethernet normales no sean suficientes. El tráfico RDMA necesita un tratamiento coherente de extremo a extremo. Un cambio rutinario de política en el switch puede romper la infraestructura si PFC, ECN, el mapeo de colas, la MTU, el hashing o los controles de congestión se desvían.
Use esta lista de verificación del modelo operativo:
| Pregunta operativa | Respuesta esperada de InfiniBand | Respuesta esperada de RoCE |
|---|---|---|
| ¿Quién es dueño del diseño de la infraestructura? | Especialista de redes AI/HPC o proveedor | Equipo de red más propietario de la plataforma de IA |
| ¿Quién valida la topología? | Informe de infraestructura del proveedor, herramientas de subnet/fabric, pruebas NCCL | Auditoría de configuración de switch/NIC, telemetría, pruebas NCCL |
| ¿Qué falla con más frecuencia? | Desajuste de ubicación, deriva de firmware/controlador, enlaces fallidos, supuestos de topología no compatibles | Deriva de la configuración sin pérdidas, mala configuración de congestión, interferencia del tráfico compartido, errores de mapeo de colas |
| ¿Qué debe supervisarse? | Estado del enlace, errores de puerto, congestión, salud de rutas, afinidad GPU/NIC, rendimiento NCCL | Pérdidas, comportamiento de pausa/ECN, tormentas PFC, retransmisiones, presión de buffer, rendimiento NCCL |
| ¿Qué habilidad escasea? | Especialistas en infraestructura InfiniBand | Ingenieros que entienden tanto las operaciones Ethernet como el tráfico de IA sensible a RDMA |
Si su equipo ya tiene una sólida automatización Ethernet pero no tiene habilidades en InfiniBand, RoCE puede resultar atractivo operativamente. Si su equipo quiere que el proveedor se encargue de la infraestructura de IA como una capa probada tipo appliance, InfiniBand puede reducir el riesgo de entrega.
Coste: incluya el riesgo de la infraestructura, no solo el precio del switch
RoCE a menudo se presenta como más barato porque el equipamiento Ethernet puede obtenerse ampliamente y reutilizarse. InfiniBand a menudo se presenta como caro porque es una infraestructura especializada para IA/HPC. Esas afirmaciones pueden ser ciertas y aun así llevar a malas decisiones.
Para clústeres de GPU, el coste de la infraestructura no es solo el precio del switch, la NIC, los ópticos y el cable. Es el coste del trabajo útil completado.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Luego normalice:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
o:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE puede ganar cuando el aprovisionamiento Ethernet, la reutilización y las operaciones reducen el coste total sin perjudicar la finalización de los trabajos. InfiniBand puede ganar cuando un mayor coste de la red evita retrasos en el entrenamiento, trabajos multinodo fallidos y semanas de ajuste. Una red más barata que deja GPUs caras ociosas no es más barata.
Vincula la decisión de coste de roce networking vs infiniband a tres números:
- Utilización útil de la GPU tras las paradas de red y los trabajos fallidos.
- Tasa de aceptación de los benchmarks en el número exacto de nodos.
- Horas de operaciones necesarias para mantener estable la red.
Si esos números faltan, el modelo de costes no está listo.
Ajuste de carga de trabajo: entrenamiento, inferencia, almacenamiento y clústeres mixtos
La comparación correcta de roce vs infiniband comparison depende del patrón de tráfico.
Entrenamiento distribuido
El entrenamiento distribuido es el caso más fuerte para InfiniBand. Las grandes operaciones all-reduce y reduce-scatter, los pasos sincronizados y los trabajos de escalado horizontal penalizan la variabilidad. Si el trabajo abarca muchos nodos y al negocio le importa completar las ventanas de entrenamiento a tiempo, InfiniBand suele ser la ruta de menor riesgo.
RoCE aún puede ser una opción válida, especialmente en organizaciones con una sólida práctica Ethernet/RDMA. Pero debe demostrarse con la misma familia de modelo, framework, precisión, tamaño de lote, número de nodos y patrón de checkpoint que planeas ejecutar.
Inferencia fragmentada y distribuida
La inferencia es más mixta. Si un modelo se divide entre varias GPUs o nodos, la latencia de red importa. Si la flota es en su mayoría réplicas independientes, la memoria de la GPU, el batching, el comportamiento de la caché, la cola y el autoscaling pueden importar más que la red.
Para muchos equipos de inferencia en producción, la mejor primera pregunta no es InfiniBand vs RoCE. Es si la carga de trabajo necesita control directo de la GPU en absoluto. Si una API de modelo gestionada puede cumplir el objetivo de latencia, calidad, privacidad y coste, compara esa vía antes de firmar un contrato de clúster.
Lectura relacionada: las guías de Flatkey sobre GPU cloud vs model API, la mejor GPU para inferencia LLM y despliegue de vLLM cubren el límite de costes del lado de serving.
Cargas de trabajo intensivas en almacenamiento
Los entrenamientos que preparan grandes conjuntos de datos, escriben checkpoints frecuentes o recargan pesos del modelo pueden convertirse en problemas de red de almacenamiento. Una red de GPU rápida no solucionará una preparación lenta del conjunto de datos ni un sistema de archivos compartido que se satura durante los checkpoints.
Tanto para InfiniBand como para RoCE, incluye el almacenamiento en el benchmark:
- Tiempo de carga del conjunto de datos.
- Tiempo de escritura y restauración del checkpoint.
- Comportamiento de spill local en NVMe.
- Ruta de almacenamiento de objetos y egress.
- Contención del sistema de archivos compartido.
- Tiempo de recuperación tras un fallo de nodo.
Clústeres de GPU multiarrendatario
Los clústeres multiarrendatario necesitan una aislamiento más fuerte que un laboratorio de benchmarking. Vecinos ruidosos, trabajos de almacenamiento en segundo plano, contenedores de usuarios y ventanas de mantenimiento pueden cambiar el comportamiento de la red. Tanto InfiniBand como RoCE necesitan control de admisión, cuotas, telemetría y respuesta a incidentes. RoCE necesita un cuidado extra cuando el tráfico RDMA comparte límites operativos con el tráfico Ethernet ordinario.
Prueba de aceptación para cualquiera de las dos redes
No aceptes la infiniband vs roce comparison de un proveedor como prueba. Ejecuta la prueba de aceptación en la forma exacta del clúster que vas a comprar o alquilar.
1. Bloquea la lista de materiales de prueba
Registra:
- Modelo de GPU, tamaño de memoria y GPUs por nodo.
- CPU, RAM, distribución PCIe/SXM, NUMA y NVMe local.
- Modelo de NIC/HCA, velocidad, firmware y driver.
- Modelo de switch, sistema operativo del switch y generación de la red.
- Óptica, tipo de cable y velocidad de enlace.
- MTU y configuración de colas.
- Grupo de ubicación, rack, zona, región y número de nodos.
- CUDA, NCCL, MPI, framework, imagen de contenedor y versión del kernel.
Si una de esas cosas cambia después del benchmark, repite la prueba.
2. Ejecuta pruebas NCCL en todos los nodos
El proyecto nccl-tests de NVIDIA es la referencia práctica porque comprueba tanto el rendimiento como la corrección de las operaciones NCCL y admite ejecuciones MPI multinodo.
Forma de aceptación de ejemplo:
# Build with MPI support.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Example: 8 nodes, 8 GPUs per node, 64 ranks total.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Haz seguimiento de:
- Ancho de banda algorítmico y ancho de banda del bus.
- Latencia mínima, media y máxima.
- p95/p99 por iteración, si está habilitado.
- Valores atípicos por rank.
- Comprobaciones de corrección fallidas.
- Variación entre ejecuciones repetidas.
- Rendimiento tras un reinicio de nodo, reinicio del driver o un evento de mantenimiento del switch.
3. Reproduce la carga de trabajo real
Los microbenchmarks son necesarios, pero no suficientes. Reproduce un trabajo real de entrenamiento o inferencia:
- La misma familia de modelo y longitud de secuencia.
- El mismo framework y estrategia distribuida.
- La misma precisión, cuantización y tamaño de lote.
- La misma cadencia de checkpoints.
- La misma ruta de datos.
- La misma política de autoscaling o del programador de trabajos.
Luego compara el tiempo por paso, tokens/seg, retraso en cola, duración del checkpoint, recuperación ante fallos y coste por salida aceptada.
4. Inyecta fallos y congestión
Una red que solo pasa en un día limpio no está lista para producción.
Prueba:
- Un nodo eliminado del trabajo.
- Un enlace caído o degradado.
- Ráfaga de checkpoint de almacenamiento durante el entrenamiento.
- Carga de inferencia en segundo plano durante un trabajo de entrenamiento.
- Umbrales y alertas de contadores del switch/NIC.
- Respuesta del soporte del proveedor ante un incidente de la red.
El ganador de roce vs infiniband es la red que mantiene predecible el trabajo útil después de estas pruebas, no la red con la mejor tasa de línea teórica.
Preguntas de compra para proveedores de InfiniBand
Pregunte esto antes de firmar:
- ¿Qué generación exacta de InfiniBand, modelo de switch, modelo de adaptador y velocidad de enlace están incluidos?
- ¿GPUDirect RDMA está habilitado y es compatible con la GPU, el controlador y la pila del framework?
- ¿Está garantizado que todos los nodos estén en un único dominio de red o grupo de colocación?
- ¿Qué resultados de all-reduce de NCCL pueden proporcionar para la misma cantidad de GPU?
- ¿Quién es responsable de la gestión de subred, las actualizaciones de firmware, el ajuste de congestión y la respuesta a incidentes?
- ¿Están habilitados y admitidos SHARP, el enrutamiento adaptativo, la calidad de servicio o las funciones dentro de la red?
- ¿Qué telemetría puede ver el cliente: contadores de puertos, eventos de congestión, errores de HCA, cambios de ruta y métricas de la red a nivel de trabajo?
- ¿Qué ocurre financieramente si la red cotizada no puede superar el benchmark acordado?
- ¿Puede el clúster ampliarse sin cambiar la topología ni los supuestos de sobre suscripción?
- ¿Qué ventanas de mantenimiento, piezas de repuesto y plazos de sustitución aplican?
Preguntas de compra para proveedores de RoCE
Pregunte esto antes de firmar:
- ¿La red es RoCE v2 y es enrutable a través de la topología necesaria?
- ¿Qué modelos de switch y NIC están validados para esta forma exacta de clúster de GPU?
- ¿Qué ajustes de PFC, ECN, DSCP, colas, MTU y control de congestión se requieren?
- ¿El tráfico RDMA está aislado del tráfico Ethernet ordinario o se comparte?
- ¿Qué contadores demuestran que la configuración sin pérdidas está sana bajo carga de NCCL?
- ¿Cómo se detectan las tormentas de PFC, la acumulación de tramas de pausa, la mala configuración de ECN y la presión de búfer?
- ¿Quién es responsable de la deriva de configuración del switch y de la compatibilidad del firmware?
- ¿Qué resultados de NCCL existen para el mismo número de nodos y clase de carga de trabajo?
- ¿Puede el equipo de red reproducir la configuración desde código?
- ¿Qué límite de soporte aplica cuando el problema abarca el controlador de la GPU, el firmware de la NIC, la política del switch y el framework de la aplicación?
Matriz de decisión
Use esta matriz después del benchmark, no antes.
| Criterio | Favorezca InfiniBand cuando... | Favorezca RoCE cuando... |
|---|---|---|
| Sensibilidad a la latencia | El tiempo por paso de entrenamiento está dominado por colectivos o el jitter p99 perjudica la inferencia | Las pruebas muestran p95/p99 estables bajo carga real |
| Escala | El clúster abarca muchos nodos y necesita una colocación predecible | El clúster es de escala media o la red Ethernet ya ha sido probada a una escala similar |
| Operaciones | El proveedor o el equipo tiene experiencia en redes InfiniBand | El equipo de red tiene una sólida automatización Ethernet y práctica específica en RDMA |
| Adquisición | Puede comprar o alquilar una red validada de IA/HPC | Necesita una mayor variedad de proveedores de switches o estandarización Ethernet |
| Coste | Evitar trabajos fallidos y tiempo de ajuste justifica el coste de una red especializada | El ahorro de Ethernet se mantiene después de los costes de ajuste, telemetría y reintentos |
| Flexibilidad | El clúster está dedicado a cargas de trabajo de IA/HPC | La red debe alinearse con prácticas más amplias de redes de centros de datos |
| Riesgo | El plazo del proyecto es ajustado y la ambigüedad de la red es costosa | El equipo tiene tiempo y capacidad para validar y operar Ethernet sin pérdidas |
Si la matriz produce un empate, alquile o pruebe ambos. La red multi-nodo para GPU es demasiado cara para decidirla solo a partir de un resumen de protocolo.
Hoja de trabajo copiable de RoCE vs InfiniBand
Use esta tabla en el documento de adquisición.
| Campo | Opción InfiniBand | Opción RoCE |
|---|---|---|
| Modelo de GPU y número de nodos | ||
| Generación de la red y velocidad de enlace | ||
| NIC/HCA por nodo | ||
| Modelo de switch y número de puertos | ||
| Relación de sobre suscripción | ||
| Garantía de colocación | ||
| Compatibilidad con GPUDirect RDMA | ||
| Ancho de banda del bus de all-reduce de NCCL | ||
| Latencia p95/p99 o máxima de NCCL | ||
| Tiempo por paso de entrenamiento | ||
| Tiempo de escritura/restauración del checkpoint | ||
| Contadores de caídas/congestión de la red | ||
| Responsable de operaciones | ||
| SLA de soporte | ||
| Coste mensual de la red | ||
| Estimación de desperdicio por inactividad/reintentos | ||
| Coste por salida aceptada | ||
| Ruta de expansión | ||
| Riesgo de salida |
Las filas más importantes no son el precio de la red listado. Son el resultado del benchmark, el responsable de operaciones, el desperdicio por inactividad/reintentos y la ruta de expansión.
Cuándo una API de modelo es la mejor respuesta
Algunos equipos que investigan roce vs infiniband en realidad no están listos para comprar una red. Están tratando de reducir el coste de salida de IA, eliminar el retraso en la cola o lanzar una funcionalidad de producto.
Si la carga de trabajo no requiere pesos personalizados, programación directa de GPU, kernels personalizados, colocación estricta o aislamiento a nivel de hardware, compare primero una API de modelo gestionado. Flatkey ofrece a los equipos una clave, un saldo y un libro de uso únicos en modelos oficiales y herramientas de IA, lo que puede ser más sencillo que administrar un clúster de GPU mientras el producto sigue cambiando.
Use la ruta de la infraestructura cuando necesite control del hardware. Use una ruta de modelo/API cuando la métrica de negocio sean resultados aceptados, no la propiedad de la red.
Guías relacionadas de Flatkey:
- TCO de clúster de GPU para cálculos de alquiler en la nube, colocation y on-premises.
- Alquiler de clúster de GPU para evaluación de proveedores y contratos de capacidad.
- Precios de alquiler de GPU para costes bajo demanda, spot, reservados y ocultos.
- GPU serverless vs GPU dedicada para arranques en frío, capacidad ociosa y control.
Lista de verificación de fuentes oficiales
Use las páginas oficiales como comprobaciones de fuente y luego valide el clúster exacto que va a comprar.
| Fuente | Qué verificar |
|---|---|
| InfiniBand Trade Association: Acerca de InfiniBand | InfiniBand como una infraestructura conmutada estándar del sector para conectividad de servidores y almacenamiento. |
| Plataforma NVIDIA Quantum InfiniBand | Posicionamiento de InfiniBand para conmutador, adaptador, gestión de la infraestructura, SHARP e infraestructura de IA/HPC. |
| NVIDIA Spectrum-X Ethernet | Posicionamiento de red de IA orientado a Ethernet/RoCE y afirmaciones de gestión de congestión que deben validarse. |
| Tamaños Azure ND H100 v5 | Ejemplo de clústeres de GPU en la nube que usan InfiniBand dedicado por GPU y GPUDirect RDMA. |
| Elastic Fabric Adapter de AWS | Alternativa en la nube que usa bypass del sistema operativo, control de congestión, Libfabric, NCCL y compatibilidad con GPUDirect RDMA en instancias seleccionadas. |
| Documentación de GPUDirect de Google Cloud | Requisitos de configuración de red de GPU en la nube para instancias de la familia A3 con GPUDirect habilitado. |
| NVIDIA nccl-tests | Pruebas de rendimiento colectivo y de corrección repetibles para la forma exacta del clúster. |
No trate estas páginas como sustituto de las pruebas de aceptación. Trátelas como la lista mínima de fuentes para una revisión seria por parte del comprador.
Preguntas frecuentes
¿InfiniBand es siempre más rápido que RoCE?
No. InfiniBand suele ser la opción de menor riesgo para infraestructuras de IA/HPC diseñadas específicamente y sensibles a la latencia, pero una infraestructura RoCE v2 bien diseñada puede rendir bien. Compare el clúster exacto usando NCCL y pruebas de la aplicación.
¿RoCE es más barato que InfiniBand?
RoCE puede ser más barato cuando el aprovisionamiento de Ethernet, la reutilización y las operaciones existentes reducen el coste total. No es más barato si el ajuste de Ethernet sin pérdidas, los incidentes de congestión, los trabajos fallidos o las GPU ociosas eliminan el ahorro.
¿Cuál es la diferencia entre RoCE v2 e InfiniBand?
RoCE v2 transporta RDMA sobre redes Ethernet/IP enrutable. InfiniBand es una arquitectura de infraestructura conmutada dedicada, usada comúnmente para clústeres de HPC e IA. La diferencia operativa es que RoCE hereda la flexibilidad de diseño y la carga de ajuste de Ethernet, mientras que InfiniBand está más especializado en torno a la infraestructura.
¿Cuál es mejor para el entrenamiento distribuido?
Para entrenamiento distribuido grande y estrechamente acoplado, InfiniBand suele ser la opción predeterminada más segura. RoCE puede ser una opción sólida cuando la infraestructura Ethernet está aislada, ajustada, monitorizada y probada con la misma carga de trabajo de entrenamiento.
¿Cuál es mejor para inferencia?
Depende de la arquitectura de inferencia. Los modelos fragmentados y la atención desde varios nodos dependen de la latencia de la infraestructura. Las réplicas independientes pueden depender más de la memoria de GPU, el batching, la tasa de aciertos de caché, el autoscaling y el coste por resultado aceptado.
¿Qué debo comparar antes de elegir?
Ejecute all-reduce de NCCL en el número objetivo de nodos, reproduzca la carga de trabajo real, incluya tráfico de almacenamiento/checkpoint, inyecte fallos o congestión y registre los contadores de la infraestructura. La decisión de roce vs infiniband debe seguir esos resultados.
Recomendación final
No elija roce vs infiniband a partir de un benchmark genérico. Elija según la carga de trabajo, el modelo operativo y la prueba de aceptación.
Elija InfiniBand cuando el clúster sea una infraestructura dedicada de IA/HPC, el entrenamiento distribuido sea el camino crítico y perder ventanas de entrenamiento sea costoso. Elija RoCE cuando la estandarización de Ethernet, la flexibilidad de compras y las operaciones existentes importen, y el equipo pueda demostrar un comportamiento RDMA sin pérdidas bajo cargas reales de trabajo de GPU.
Si la aplicación solo necesita resultados de IA, no control directo de la infraestructura de GPU, compare antes las rutas de modelo/API gestionadas por Flatkey de alquilar o comprar el clúster. La red más barata es la que no tiene que operar.


