
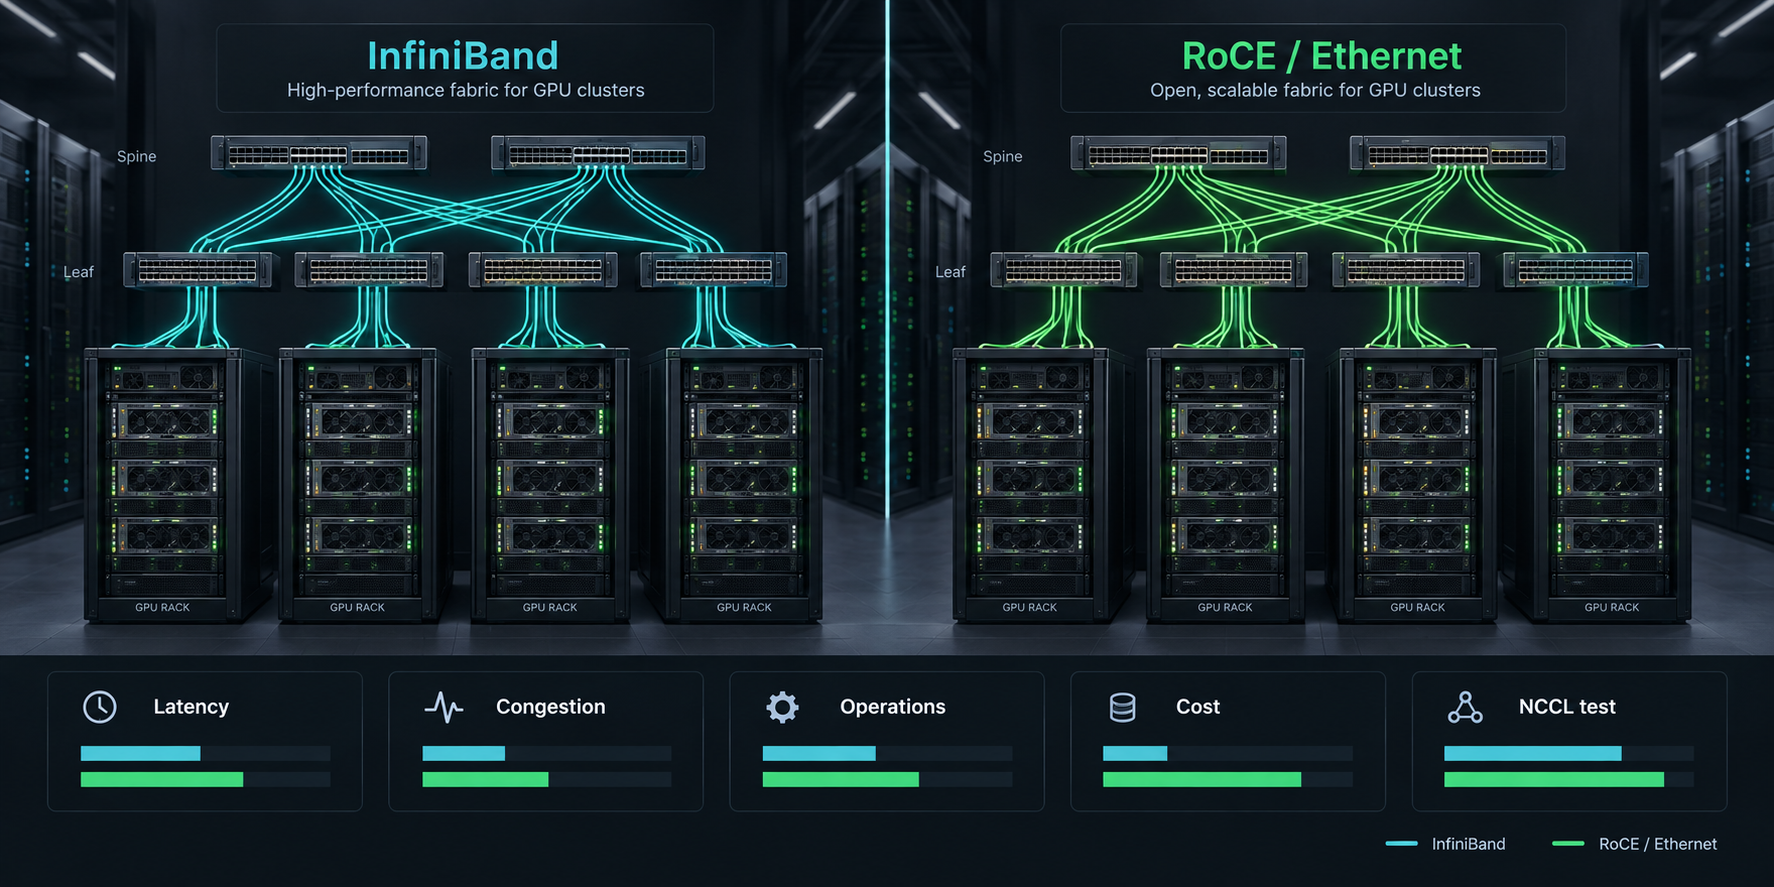
Hầu hết các tranh luận RoCE vs InfiniBand đều bắt đầu ở chỗ sai. Chúng so sánh tên giao thức thay vì hỏi cụm GPU phải chịu đựng điều gì: huấn luyện liên kết chặt, suy luận phân mảnh, lưu lượng lưu trữ dùng chung, đa tenant, giới hạn mua sắm, và đội vận hành sẽ tinh chỉnh fabric sau khi triển khai.
Với các cụm GPU đa nút, InfiniBand thường là mặc định an toàn hơn khi khối lượng công việc nhạy cảm với độ trễ, nặng về collective, và đủ lớn để biện minh cho một fabric AI/HPC chuyên dụng. RoCE thường là điểm khởi đầu tốt hơn khi đội ngũ đã vận hành Ethernet tốc độ cao, muốn lựa chọn nhà cung cấp rộng hơn, và có thể chứng minh thiết kế Ethernet lossless bằng các bài kiểm tra NCCL thực tế trước khi cam kết.
Điều khó là cả hai đều có thể hoạt động, và cả hai đều có thể thất bại. Một fabric RoCE v2 được xây dựng tốt có thể chạy các cụm AI nghiêm túc. Một fabric InfiniBand được vận hành kém vẫn có thể bỏ lỡ cửa sổ huấn luyện. Hướng dẫn này so sánh roce vs infiniband qua độ trễ, vận hành và chi phí để các đội nền tảng có thể chọn fabric phù hợp với khối lượng công việc thay vì theo slide của nhà cung cấp ồn ào nhất.
RoCE vs InfiniBand: câu trả lời nhanh
Dùng bảng này như bộ lọc quyết định bước đầu.
| Tình huống | Thường bắt đầu với | Vì sao |
|---|---|---|
| Huấn luyện phân tán quy mô lớn với lưu lượng all-reduce thường xuyên | InfiniBand | Đây là một fabric chuyển mạch được thiết kế chuyên cho giao tiếp HPC và AI độ trễ thấp, băng thông cao. |
| Báo giá cụm GPU đã bao gồm fabric NVIDIA Quantum đã được xác thực hoặc InfiniBand tương tự | InfiniBand | Rủi ro chuyển từ thiết kế sang kiểm thử nghiệm thu và bằng chứng từ nhà cung cấp. |
| Đội mạng doanh nghiệp đã có tự động hóa, giám sát và lợi thế mua sắm Ethernet sâu | RoCE | RoCE giữ RDMA trên Ethernet, nhưng cần kiểm soát tắc nghẽn kỷ luật và hành vi lossless. |
| Lưu lượng AI, lưu trữ và dữ liệu trung tâm dữ liệu thông thường trộn lẫn trên một mô hình vận hành | RoCE hoặc Ethernet tách biệt cộng với fabric AI chuyên dụng | RoCE có thể phù hợp với vận hành Ethernet, nhưng các fabric dùng chung phải được thiết kế cẩn thận. |
| Cụm suy luận nhỏ, tác vụ batch, hoặc khối lượng công việc không mở rộng qua nhiều nút | Không fabric nào nên chi phối quyết định | Bộ nhớ GPU, mức sử dụng, xếp hàng và các lựa chọn mô hình/API quan trọng hơn interconnect. |
| Mua sắm cần đa dạng nhà cung cấp tối đa và nguồn switch theo chuẩn | RoCE | Nguồn cung Ethernet có thể rộng hơn, trong khi các cụm InfiniBand chuyên biệt theo chiều dọc hơn. |
| Đội chưa có kinh nghiệm với fabric RDMA và không có cửa sổ benchmark | Thuê trước, rồi quyết định | Đừng ký hợp đồng đa nút cho đến khi các bài kiểm tra NCCL, lỗi và khả năng quan sát đều đạt. |
Câu trả lời thực tế: chọn InfiniBand khi ứng dụng cần một fabric AI/HPC chuyên dụng với rủi ro tinh chỉnh ở mức giao thức thấp nhất. Chọn RoCE khi tiêu chuẩn hóa Ethernet, tính linh hoạt mua sắm, hoặc vận hành hiện có đủ quan trọng để biện minh cho phần engineering bổ sung của fabric.
InfiniBand có nghĩa là gì trong một cụm GPU
InfiniBand là một kiến trúc fabric chuyển mạch theo tiêu chuẩn ngành, dùng để kết nối máy chủ và lưu trữ. Trong các cụm GPU, nó thường gắn với độ trễ thấp, băng thông cao, RDMA, GPU Direct RDMA, định tuyến thích ứng, quản lý tắc nghẽn và công cụ AI/HPC tích hợp với nhà cung cấp.
Điểm quan trọng không chỉ là InfiniBand nhanh. Điểm quan trọng là nó được xây dựng như một fabric. Quản lý subnet, hành vi ở cấp fabric, virtual lane, chất lượng dịch vụ, tăng tốc trong mạng, và tích hợp switch/adapter đều là một phần của ranh giới thiết kế. Điều đó quan trọng khi một job huấn luyện trải dài hàng trăm hoặc hàng nghìn GPU và mọi phép collective đều khuếch đại độ trễ đuôi.
Các ví dụ trên cloud cho thấy vì sao fabric này vẫn chiếm ưu thế trong nhiều cụm AI lớn. Tài liệu về ND H100 v5 của Azure mô tả tám GPU H100 cho mỗi VM, kết nối NVIDIA Quantum-2 CX7 InfiniBand 400 Gbps riêng cho mỗi GPU, 3,2 Tbps băng thông interconnect mỗi VM, hỗ trợ GPU Direct RDMA và clustering mở rộng theo hướng NCCL. Những chi tiết đó không phải là ngôn ngữ "mạng nhanh" chung chung; chúng là các факт về hình dạng cụm ảnh hưởng đến hành vi huấn luyện phân tán.
Đối với bên mua, câu hỏi về InfiniBand nên cụ thể:
- Thế hệ InfiniBand và nền tảng switch nào được bao gồm?
- Có bao nhiêu NIC hoặc host channel adapter được gắn trên mỗi nút?
- Mỗi GPU có được ánh xạ tới một đường mạng riêng hay lưu lượng được gộp lại?
- GPUDirect RDMA có được bật và kiểm thử không?
- Bảo đảm vị trí nào giữ các nút trong cùng một miền fabric?
- Nhà cung cấp chịu trách nhiệm quản lý fabric, telemetry và khắc phục sự cố nào?
Nếu người bán chỉ nói "đã bao gồm InfiniBand," thì báo giá đó chưa đầy đủ.
RoCE có nghĩa là gì trong một cụm GPU
RoCE nghĩa là RDMA over Converged Ethernet. RoCE v2 truyền RDMA qua các mạng Ethernet/IP có thể định tuyến, cho phép các đội sử dụng switching Ethernet trong khi vẫn bỏ qua phần lớn overhead của CPU và kernel liên quan đến các đường TCP thông thường.
Đó là sức hấp dẫn của nó. RoCE có thể cho phép đội nền tảng AI xây dựng các cụm GPU có khả năng RDMA với switch Ethernet, thực hành vận hành Ethernet, và một phạm vi mua sắm rộng hơn. Với các tổ chức đã vận hành Ethernet tốc độ cao ở quy mô lớn, RoCE có thể dễ tích hợp hơn vào kiểm soát thay đổi, telemetry, cáp, quang và quản lý nhà cung cấp.
Đổi lại, RoCE phụ thuộc vào fabric Ethernet hoạt động tốt dưới tải. Các collective của GPU tạo ra các đợt bùng phát đồng bộ. Sao lưu checkpoint và lưu lượng lưu trữ có thể va chạm với lưu lượng huấn luyện. Tắc nghẽn có thể biến thành các đột biến độ trễ. Mất gói có thể đắt hơn nhiều đối với RDMA so với lưu lượng ứng dụng thông thường.
Đó là lý do thiết kế cụm RoCE thường bao gồm:
- Kiểm soát lưu lượng ưu tiên hoặc một chiến lược lossless đã được kiểm thử khác.
- Thông báo tắc nghẽn rõ ràng và tinh chỉnh kiểm soát tắc nghẽn.
- Cấu hình Data Center Bridging trên các switch và NIC.
- Kỷ luật ánh xạ hàng đợi, lớp dịch vụ và DSCP/priority.
- Bộ đếm theo từng mức ưu tiên cho drop, pause frame, dấu ECN, retransmit và áp lực bộ đệm.
- Kiểm soát thay đổi chặt chẽ đối với firmware, hệ điều hành switch, driver NIC, MTU và chính sách định tuyến.
RoCE có thể rất tốt, nhưng tư duy “nó chỉ là Ethernet” là sai. Trong một cụm GPU, RoCE là một fabric Ethernet được thiết kế chuyên biệt cho lưu lượng RDMA.
Độ trễ: so sánh hành vi đuôi, không chỉ trung vị
Trong quyết định roce vs infiniband, độ trễ trung bình ít hữu ích hơn hành vi đuôi dưới tải tập thể thực tế.
Huấn luyện phân tán thường phải chờ nút chậm nhất. Chỉ một số ít rank có độ trễ cao hơn cũng có thể kìm hãm toàn bộ bước. Với suy luận sharded, độ trễ mạng p95 và p99 có thể xuất hiện dưới dạng độ trễ mà người dùng cảm nhận được hoặc hiệu suất batching thấp hơn. Với huấn luyện nặng về lưu trữ, lưu lượng checkpoint có thể tạo ra các đợt bùng phát mà một microbenchmark sạch sẽ không thấy được.
Đo ở bốn cấp độ:
| Lớp | Cần đo gì | Vì sao quan trọng |
|---|---|---|
| Liên kết và fabric | Lỗi cổng, drop, dấu ECN, pause frame, sự kiện tắc nghẽn, thay đổi tuyến | Phát hiện vấn đề sức khỏe fabric trước khi đổ lỗi cho framework. |
| Vận chuyển RDMA | Retransmit, độ trễ hoàn tất, độ sâu hàng đợi, bộ đếm NIC | Cho thấy RDMA có ổn định dưới áp lực hay không. |
| Các collective của NCCL | băng thông all-reduce, băng thông bus, độ trễ min/avg/max, thời gian từng vòng lặp | Khớp với các mẫu giao tiếp trong huấn luyện AI. |
| Ứng dụng | thời gian bước, tokens/giây, độ trễ yêu cầu, thời lượng checkpoint, khôi phục khi lỗi | Cho biết với tài chính và các nhóm sản phẩm rằng fabric có giúp công việc hữu ích hay không. |
InfiniBand thường có lợi thế vì nhiều thiết kế cụm đã được xây dựng và xác thực ngay từ đầu quanh các workload nặng về collective. RoCE có thể thu hẹp khoảng cách khi fabric Ethernet được tinh chỉnh, cô lập và chứng minh. Bài kiểm tra không phải là RoCE v2 có thể làm RDMA trên lý thuyết hay không. Bài kiểm tra là tổ hợp switch/NIC/cáp/driver/topology cụ thể này có giữ được hành vi p95 và p99 trong đúng workload mà bạn sẽ thực sự chạy hay không.
Vận hành: InfiniBand là chuyên biệt, RoCE được tích hợp
Vận hành là nơi so sánh roce vs infiniband trở nên kém rõ ràng hơn.
InfiniBand cung cấp cho các nhóm nền tảng một fabric chuyên biệt với các giả định AI/HPC trưởng thành. Điều đó có thể giảm sự mơ hồ trong tinh chỉnh. Mặt trái là đội ngũ cần kỹ năng đặc thù InfiniBand, công cụ quản lý fabric, kiến thức subnet manager và các đường hỗ trợ phù hợp. Nếu cụm được thuê từ một nhà cung cấp chuyên biệt hoặc hyperscaler, phần lớn điều này có thể bị ẩn sau ranh giới dịch vụ của nhà cung cấp. Nếu cụm thuộc sở hữu hoặc colocated, khoảng cách kỹ năng sẽ trở nên rất thực tế.
RoCE phù hợp tự nhiên hơn với nhiều tổ chức mạng doanh nghiệp vì nó chạy trên Ethernet. Mua sắm, đi cáp, vận hành switch, giám sát và các mẫu quản lý thay đổi có thể đã tồn tại sẵn. Rủi ro là vận hành Ethernet thông thường là chưa đủ. Lưu lượng RDMA cần được xử lý nhất quán từ đầu đến cuối. Một thay đổi chính sách switch thường lệ có thể làm hỏng fabric nếu PFC, ECN, ánh xạ hàng đợi, MTU, hashing hoặc điều khiển tắc nghẽn bị lệch.
Hãy dùng danh sách kiểm tra mô hình vận hành này:
| Câu hỏi vận hành | InfiniBand yêu cầu | RoCE yêu cầu |
|---|---|---|
| Ai sở hữu thiết kế fabric? | Chuyên gia mạng AI/HPC hoặc nhà cung cấp | Nhóm mạng cộng với chủ sở hữu nền tảng AI |
| Ai xác thực topology? | Báo cáo fabric của nhà cung cấp, công cụ subnet/fabric, kiểm thử NCCL | Kiểm tra cấu hình switch/NIC, telemetry, kiểm thử NCCL |
| Điều gì thường hỏng nhất? | Lệch vị trí, lệch firmware/driver, lỗi link, giả định topology không được hỗ trợ | Lệch cấu hình lossless, cấu hình tắc nghẽn sai, can nhiễu từ lưu lượng chia sẻ, lỗi ánh xạ hàng đợi |
| Cần giám sát gì? | Trạng thái link, lỗi cổng, tắc nghẽn, sức khỏe tuyến, affinity GPU/NIC, hiệu năng NCCL | Drop, hành vi pause/ECN, PFC storm, retransmit, áp lực bộ đệm, hiệu năng NCCL |
| Kỹ năng nào khan hiếm? | Chuyên gia fabric InfiniBand | Kỹ sư hiểu cả vận hành Ethernet và lưu lượng AI nhạy với RDMA |
Nếu đội ngũ của bạn đã có tự động hóa Ethernet mạnh nhưng không có kỹ năng InfiniBand, RoCE có thể hấp dẫn về mặt vận hành. Nếu đội ngũ của bạn muốn nhà cung cấp sở hữu fabric AI như một lớp kiểu appliance đã được kiểm thử, InfiniBand có thể giảm rủi ro bàn giao.
Chi phí: bao gồm rủi ro fabric, không chỉ giá switch
RoCE thường được coi là rẻ hơn vì thiết bị Ethernet có thể được tìm nguồn rộng rãi và tái sử dụng. InfiniBand thường được coi là đắt hơn vì nó là fabric AI/HPC chuyên biệt. Những nhận định đó có thể đúng mà vẫn dẫn đến quyết định tồi.
Với cụm GPU, chi phí fabric không chỉ là giá switch, NIC, optics và cáp. Nó là chi phí của công việc hữu ích được hoàn thành.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Sau đó chuẩn hóa:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
hoặc:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE có thể thắng khi nguồn cung Ethernet, tái sử dụng và vận hành làm giảm tổng chi phí mà không ảnh hưởng đến việc hoàn thành tác vụ. InfiniBand có thể thắng khi chi phí fabric cao hơn giúp tránh chậm trễ huấn luyện, các job đa nút thất bại và hàng tuần tinh chỉnh. Một fabric rẻ hơn nhưng để các GPU đắt tiền nhàn rỗi thì không hề rẻ.
Hãy gắn quyết định chi phí roce networking vs infiniband với ba con số:
- Mức sử dụng GPU hữu ích sau khi mạng bị nghẽn và job thất bại.
- Tỷ lệ chấp nhận benchmark trên đúng số lượng node.
- Số giờ vận hành cần thiết để giữ fabric ổn định.
Nếu thiếu các con số đó, mô hình chi phí vẫn chưa sẵn sàng.
Độ phù hợp với workload: huấn luyện, suy luận, lưu trữ và cụm hỗn hợp
So sánh roce vs infiniband phù hợp phụ thuộc vào kiểu lưu lượng.
Huấn luyện phân tán
Huấn luyện phân tán là trường hợp mạnh nhất của InfiniBand. Các thao tác all-reduce và reduce-scatter lớn, các bước đồng bộ và các job mở rộng theo cụm sẽ bị ảnh hưởng nặng bởi jitter. Nếu job trải dài trên nhiều node và doanh nghiệp quan tâm đến việc hoàn thành các cửa sổ huấn luyện đúng lịch, InfiniBand thường là con đường ít rủi ro hơn.
RoCE vẫn có thể là lựa chọn hợp lệ, đặc biệt trong các tổ chức có thực hành Ethernet/RDMA mạnh. Nhưng nó phải được chứng minh bằng cùng họ mô hình, framework, độ chính xác, kích thước batch, số lượng node và kiểu checkpoint mà bạn dự định chạy.
Suy luận phân mảnh và phân tán
Suy luận thì đa dạng hơn. Nếu một mô hình được chia trên nhiều GPU hoặc node, độ trễ mạng rất quan trọng. Nếu đội ngũ chủ yếu chạy các bản sao độc lập, bộ nhớ GPU, batching, hành vi cache, xếp hàng và autoscaling có thể quan trọng hơn fabric.
Đối với nhiều đội suy luận production, câu hỏi đầu tiên tốt hơn không phải là InfiniBand hay RoCE. Mà là workload có thực sự cần điều khiển GPU trực tiếp hay không. Nếu một API mô hình được quản lý có thể đạt mục tiêu về độ trễ, chất lượng, quyền riêng tư và chi phí, hãy so sánh hướng đó trước khi ký hợp đồng cụm.
Bài đọc liên quan: các hướng dẫn của Flatkey về GPU cloud vs model API, GPU tốt nhất cho suy luận LLM, và triển khai vLLM bao quát ranh giới chi phí phía serving.
Workload nặng về lưu trữ
Các lần huấn luyện phải nạp bộ dữ liệu lớn, ghi checkpoint thường xuyên hoặc tải lại trọng số mô hình có thể trở thành vấn đề mạng lưu trữ. Một fabric GPU nhanh sẽ không khắc phục được việc staging dataset chậm hoặc một hệ thống tệp dùng chung bị bão hòa trong lúc checkpoint.
Với cả InfiniBand và RoCE, hãy đưa lưu trữ vào benchmark:
- Thời gian tải dataset.
- Thời gian ghi và khôi phục checkpoint.
- Hành vi spill ra NVMe cục bộ.
- Đường đi và egress của object storage.
- Tranh chấp trên hệ thống tệp dùng chung.
- Thời gian khôi phục sau khi một node bị lỗi.
Cụm GPU nhiều tenant
Cụm đa tenant cần khả năng cô lập mạnh hơn một phòng lab benchmark. Hàng xóm ồn ào, các job lưu trữ nền, container người dùng và cửa sổ bảo trì đều có thể làm thay đổi hành vi fabric. Cả InfiniBand và RoCE đều cần kiểm soát truy cập, hạn mức, telemetry và phản ứng sự cố. RoCE cần chú ý thêm khi lưu lượng RDMA dùng chung ranh giới vận hành với lưu lượng Ethernet thông thường.
Bài kiểm tra chấp nhận cho bất kỳ fabric nào
Đừng xem infiniband vs roce comparison của nhà cung cấp như bằng chứng. Hãy chạy bài kiểm tra chấp nhận trên đúng hình dạng cụm mà bạn sẽ mua hoặc thuê.
1. Khóa danh mục vật tư kiểm thử
Ghi lại:
- Mẫu GPU, dung lượng bộ nhớ và số GPU trên mỗi node.
- CPU, RAM, bố cục PCIe/SXM, NUMA và NVMe cục bộ.
- Mẫu NIC/HCA, tốc độ, firmware và driver.
- Mẫu switch, hệ điều hành switch và thế hệ fabric.
- Optics, loại cáp và tốc độ liên kết.
- MTU và cấu hình hàng đợi.
- Placement group, rack, zone, region và số lượng node.
- CUDA, NCCL, MPI, framework, image container và phiên bản kernel.
Nếu một trong những thứ đó thay đổi sau benchmark, hãy chạy lại bài kiểm tra.
2. Chạy các bài kiểm tra NCCL trên mọi node
Dự án nccl-tests của NVIDIA là baseline thực tế vì nó kiểm tra cả hiệu năng lẫn độ đúng đắn của các thao tác NCCL và hỗ trợ các lần chạy MPI đa node.
Cấu hình chấp nhận mẫu:
# Build with MPI support.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Example: 8 nodes, 8 GPUs per node, 64 ranks total.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Theo dõi:
- Băng thông thuật toán và băng thông bus.
- Độ trễ tối thiểu, trung bình và tối đa.
- p95/p99 theo từng vòng lặp nếu được bật.
- Điểm ngoại lệ của từng rank.
- Các kiểm tra đúng đắn thất bại.
- Biến thiên qua các lần chạy lặp lại.
- Hiệu năng sau khi một node khởi động lại, driver restart hoặc sự kiện bảo trì switch.
3. Phát lại workload thực tế
Microbenchmark là cần thiết, nhưng chưa đủ. Hãy phát lại một job huấn luyện hoặc suy luận thực:
- Cùng họ mô hình và độ dài sequence.
- Cùng framework và chiến lược phân tán.
- Cùng độ chính xác, lượng tử hóa và kích thước batch.
- Cùng nhịp checkpoint.
- Cùng đường dữ liệu.
- Cùng chính sách autoscaling hoặc scheduler của job.
Sau đó so sánh thời gian bước, tokens/sec, độ trễ hàng đợi, thời lượng checkpoint, khôi phục sau lỗi và chi phí trên mỗi output được chấp nhận.
4. Tiêm lỗi và tắc nghẽn
Một fabric chỉ vượt qua trong ngày đẹp trời thì chưa sẵn sàng cho production.
Kiểm tra:
- Một node bị xóa khỏi job.
- Một liên kết bị ngắt hoặc suy giảm.
- Bùng nổ checkpoint lưu trữ trong quá trình huấn luyện.
- Tải suy luận nền trong lúc một job huấn luyện đang chạy.
- Các ngưỡng bộ đếm của switch/NIC và cảnh báo.
- Phản hồi hỗ trợ từ nhà cung cấp cho một sự cố fabric.
“Người thắng” của roce vs infiniband là fabric giữ cho công việc hữu ích luôn có thể dự đoán sau các bài kiểm tra này, chứ không phải fabric có tốc độ đường truyền lý thuyết tốt hơn.
Câu hỏi mua sắm dành cho nhà cung cấp InfiniBand
Ask these before signing:
- Thế hệ InfiniBand chính xác nào, model switch nào, model adapter nào và tốc độ liên kết nào được bao gồm?
- GPUDirect RDMA có được bật và hỗ trợ cho GPU, driver và bộ khung phần mềm hay không?
- Tất cả các node có được đảm bảo nằm trong cùng một fabric domain hoặc placement group không?
- Bạn có thể cung cấp kết quả NCCL all-reduce nào cho cùng số lượng GPU?
- Ai chịu trách nhiệm quản lý subnet, cập nhật firmware, tinh chỉnh tắc nghẽn và phản hồi sự cố?
- SHARP, định tuyến thích ứng, chất lượng dịch vụ hoặc các tính năng trong mạng có được bật và hỗ trợ không?
- Khách hàng có thể xem những telemetry nào: bộ đếm port, sự kiện tắc nghẽn, lỗi HCA, thay đổi tuyến đường và chỉ số fabric ở cấp job?
- Về mặt tài chính sẽ ra sao nếu fabric được báo giá không thể vượt qua benchmark đã thống nhất?
- Cụm có thể mở rộng mà không thay đổi topology hoặc giả định oversubscription không?
- Các cửa sổ bảo trì, linh kiện dự phòng và thời gian thay thế nào được áp dụng?
Câu hỏi mua sắm dành cho nhà cung cấp RoCE
Ask these before signing:
- Fabric có phải là RoCE v2 không, và có thể định tuyến qua topology cần thiết không?
- Mẫu switch và NIC nào được xác nhận cho đúng hình dạng cụm GPU này?
- Các thiết lập PFC, ECN, DSCP, queue, MTU và kiểm soát tắc nghẽn nào là bắt buộc?
- Lưu lượng RDMA có được tách khỏi lưu lượng Ethernet thông thường hay dùng chung?
- Những bộ đếm nào chứng minh cấu hình lossless đang hoạt động tốt dưới tải NCCL?
- Làm thế nào để phát hiện bão PFC, tích tụ pause-frame, cấu hình ECN sai và áp lực buffer?
- Ai chịu trách nhiệm cho độ lệch cấu hình switch và tính tương thích firmware?
- Tồn tại kết quả NCCL nào cho cùng số lượng node và cùng loại workload?
- Đội mạng có thể tái tạo cấu hình từ mã nguồn không?
- Áp dụng ranh giới hỗ trợ nào khi sự cố liên quan đến driver GPU, firmware NIC, chính sách switch và bộ khung ứng dụng?
Ma trận quyết định
Hãy dùng ma trận này sau benchmark, không phải trước nó.
| Criterion | Favor InfiniBand when... | Favor RoCE when... |
|---|---|---|
| Latency sensitivity | Thời gian bước huấn luyện bị chi phối bởi collective hoặc độ rung p99 làm hại suy luận | Kiểm tra cho thấy p95/p99 ổn định dưới tải thực |
| Scale | Cụm trải rộng trên nhiều node và cần bố trí có thể dự đoán | Cụm ở quy mô vừa hoặc fabric Ethernet đã được chứng minh ở quy mô tương tự |
| Operations | Nhà cung cấp hoặc đội ngũ có chuyên môn về fabric InfiniBand | Đội mạng có tự động hóa Ethernet mạnh và thực hành chuyên biệt cho RDMA |
| Procurement | Bạn có thể mua hoặc thuê một fabric AI/HPC đã được xác nhận | Bạn cần nguồn cung switch rộng hơn hoặc chuẩn hóa Ethernet |
| Cost | Tránh job thất bại và độ trễ tinh chỉnh biện minh cho chi phí fabric chuyên dụng | Tiết kiệm Ethernet vẫn còn sau khi tính chi phí tinh chỉnh, telemetry và retry |
| Flexibility | Cụm chuyên cho workload AI/HPC | Fabric phải phù hợp với các thực hành mạng trung tâm dữ liệu rộng hơn |
| Risk | Hạn chót dự án gấp và sự mơ hồ về fabric rất tốn kém | Đội có thời gian và kỹ năng để xác thực và vận hành Ethernet lossless |
Nếu ma trận cho kết quả hòa, hãy thuê hoặc benchmark cả hai. Mạng GPU nhiều node quá đắt để quyết định chỉ từ một bản tóm tắt giao thức.
Bảng tính RoCE vs InfiniBand có thể sao chép
Hãy dùng bảng này trong tài liệu mua sắm.
| Field | InfiniBand option | RoCE option |
|---|---|---|
| GPU model and node count | ||
| Fabric generation and link speed | ||
| NIC/HCA per node | ||
| Switch model and port count | ||
| Oversubscription ratio | ||
| Placement guarantee | ||
| GPUDirect RDMA support | ||
| NCCL all-reduce bus bandwidth | ||
| NCCL p95/p99 or max latency | ||
| Training step time | ||
| Checkpoint write/restore time | ||
| Fabric drops/congestion counters | ||
| Operations owner | ||
| Support SLA | ||
| Monthly fabric cost | ||
| Idle/retry waste estimate | ||
| Cost per accepted output | ||
| Expansion path | ||
| Exit risk |
Các hàng quan trọng nhất không phải là giá fabric được liệt kê. Chúng là kết quả benchmark, chủ sở hữu vận hành, lãng phí do nhàn rỗi/retry, và lộ trình mở rộng.
Khi API mô hình là câu trả lời tốt hơn
Một số đội đang nghiên cứu roce vs infiniband thực ra chưa sẵn sàng mua một fabric mạng. Họ đang cố giảm chi phí đầu ra AI, loại bỏ độ trễ hàng đợi, hoặc triển khai một tính năng sản phẩm.
Nếu khối lượng công việc không yêu cầu trọng số tùy chỉnh, lập lịch GPU trực tiếp, kernel tùy chỉnh, vị trí triển khai nghiêm ngặt hoặc cách ly ở cấp phần cứng, hãy so sánh trước một API mô hình được quản lý. Flatkey cung cấp cho các đội một khóa, một số dư và một sổ theo dõi sử dụng trên các mô hình chính thức và công cụ AI, điều này có thể đơn giản hơn so với việc tự sở hữu một cụm GPU khi sản phẩm vẫn đang thay đổi.
Hãy dùng hướng fabric khi bạn cần kiểm soát phần cứng. Hãy dùng hướng mô hình/API khi chỉ số kinh doanh là đầu ra được chấp nhận, chứ không phải quyền sở hữu mạng.
Các hướng dẫn liên quan của Flatkey:
- TCO của cụm GPU cho bài toán thuê cloud, colocations và on-premises.
- Thuê cụm GPU cho việc đánh giá nhà cung cấp và hợp đồng dung lượng.
- Giá thuê GPU cho chi phí theo nhu cầu, spot, reserved và các chi phí ẩn.
- GPU serverless vs GPU dedicated cho khởi động nguội, năng lực nhàn rỗi và khả năng kiểm soát.
Danh sách kiểm tra nguồn chính thức
Hãy dùng các trang chính thức làm nguồn kiểm tra, rồi xác thực cụm chính xác mà bạn đang mua.
| Nguồn | Cần xác minh gì |
|---|---|
| InfiniBand Trade Association: About InfiniBand | InfiniBand là một fabric chuyển mạch theo tiêu chuẩn ngành cho kết nối máy chủ và lưu trữ. |
| Nền tảng NVIDIA Quantum InfiniBand | Vị trí của InfiniBand về switch, adapter, quản lý fabric, SHARP và fabric AI/HPC. |
| NVIDIA Spectrum-X Ethernet | Vị trí mạng AI theo hướng Ethernet/RoCE và các tuyên bố về quản lý tắc nghẽn cần xác minh. |
| Kích thước Azure ND H100 v5 | Ví dụ về các cụm GPU cloud dùng InfiniBand dành riêng cho từng GPU và GPUDirect RDMA. |
| AWS Elastic Fabric Adapter | Giải pháp thay thế trên cloud dùng OS-bypass, kiểm soát tắc nghẽn, Libfabric, NCCL và hỗ trợ GPUDirect RDMA trên các phiên bản được chọn. |
| Tài liệu Google Cloud GPUDirect | Các yêu cầu thiết lập mạng GPU cloud cho các phiên bản dòng A3 có bật GPUDirect. |
| NVIDIA nccl-tests | Benchmark collective và kiểm thử tính đúng đắn lặp lại được cho đúng hình dạng cụm. |
Đừng coi các trang này là thay thế cho bài kiểm thử nghiệm thu. Hãy coi chúng là danh sách nguồn tối thiểu cho một đợt đánh giá mua sắm nghiêm túc.
Các câu hỏi thường gặp
InfiniBand có luôn nhanh hơn RoCE không?
Không. InfiniBand thường là lựa chọn ít rủi ro hơn cho các fabric AI/HPC chuyên dụng, nhạy độ trễ, nhưng một fabric RoCE v2 được thiết kế tốt cũng có thể hoạt động rất tốt. Hãy so sánh cụm chính xác bằng NCCL và các bài kiểm thử ứng dụng.
RoCE có rẻ hơn InfiniBand không?
RoCE có thể rẻ hơn khi nguồn cung Ethernet, tái sử dụng và vận hành sẵn có làm giảm tổng chi phí. Nó không rẻ hơn nếu việc tinh chỉnh Ethernet không mất gói, các sự cố tắc nghẽn, job thất bại hoặc GPU nhàn rỗi xóa mất phần tiết kiệm đó.
Sự khác nhau giữa RoCE v2 và InfiniBand là gì?
RoCE v2 truyền RDMA qua các mạng Ethernet/IP có thể định tuyến. InfiniBand là một kiến trúc fabric chuyển mạch chuyên dụng, thường được dùng cho các cụm HPC và AI. Khác biệt vận hành là RoCE thừa hưởng sự linh hoạt trong thiết kế và gánh nặng tinh chỉnh của Ethernet, còn InfiniBand chuyên biệt hơn quanh fabric.
Cái nào tốt hơn cho huấn luyện phân tán?
Đối với huấn luyện phân tán quy mô lớn, liên kết chặt, InfiniBand thường là lựa chọn mặc định an toàn hơn. RoCE có thể là một lựa chọn mạnh khi fabric Ethernet được tách biệt, tinh chỉnh, giám sát và đã được chứng minh với cùng khối lượng công việc huấn luyện.
Cái nào tốt hơn cho suy luận?
Tùy vào kiến trúc suy luận. Các mô hình phân mảnh và phục vụ xuyên nút quan tâm đến độ trễ của fabric. Các bản sao độc lập có thể quan tâm nhiều hơn đến bộ nhớ GPU, batching, tỷ lệ cache hit, autoscaling và chi phí trên mỗi đầu ra được chấp nhận.
Tôi nên benchmark gì trước khi chọn?
Chạy NCCL all-reduce trên số node mục tiêu, phát lại khối lượng công việc thực tế, bao gồm lưu lượng lưu trữ/checkpoint, tạo lỗi hoặc tắc nghẽn, và ghi lại các bộ đếm của fabric. Quyết định roce vs infiniband nên dựa trên các kết quả đó.
Khuyến nghị cuối cùng
Đừng chọn roce vs infiniband từ một benchmark chung chung. Hãy chọn dựa trên khối lượng công việc, mô hình vận hành và bài kiểm thử nghiệm thu.
Chọn InfiniBand khi cụm là một fabric AI/HPC chuyên dụng, huấn luyện phân tán là đường đi quan trọng nhất, và việc lỡ cửa sổ huấn luyện là rất tốn kém. Chọn RoCE khi tiêu chuẩn hóa Ethernet, sự linh hoạt trong mua sắm và vận hành hiện có là quan trọng, và đội ngũ có thể chứng minh hành vi RDMA không mất gói dưới các khối lượng công việc GPU thực tế.
Nếu ứng dụng chỉ cần đầu ra AI, chứ không cần kiểm soát fabric GPU trực tiếp, hãy so sánh các hướng model/API được Flatkey quản lý trước khi thuê hoặc mua cụm. Mạng rẻ nhất là mạng bạn không phải vận hành.


