
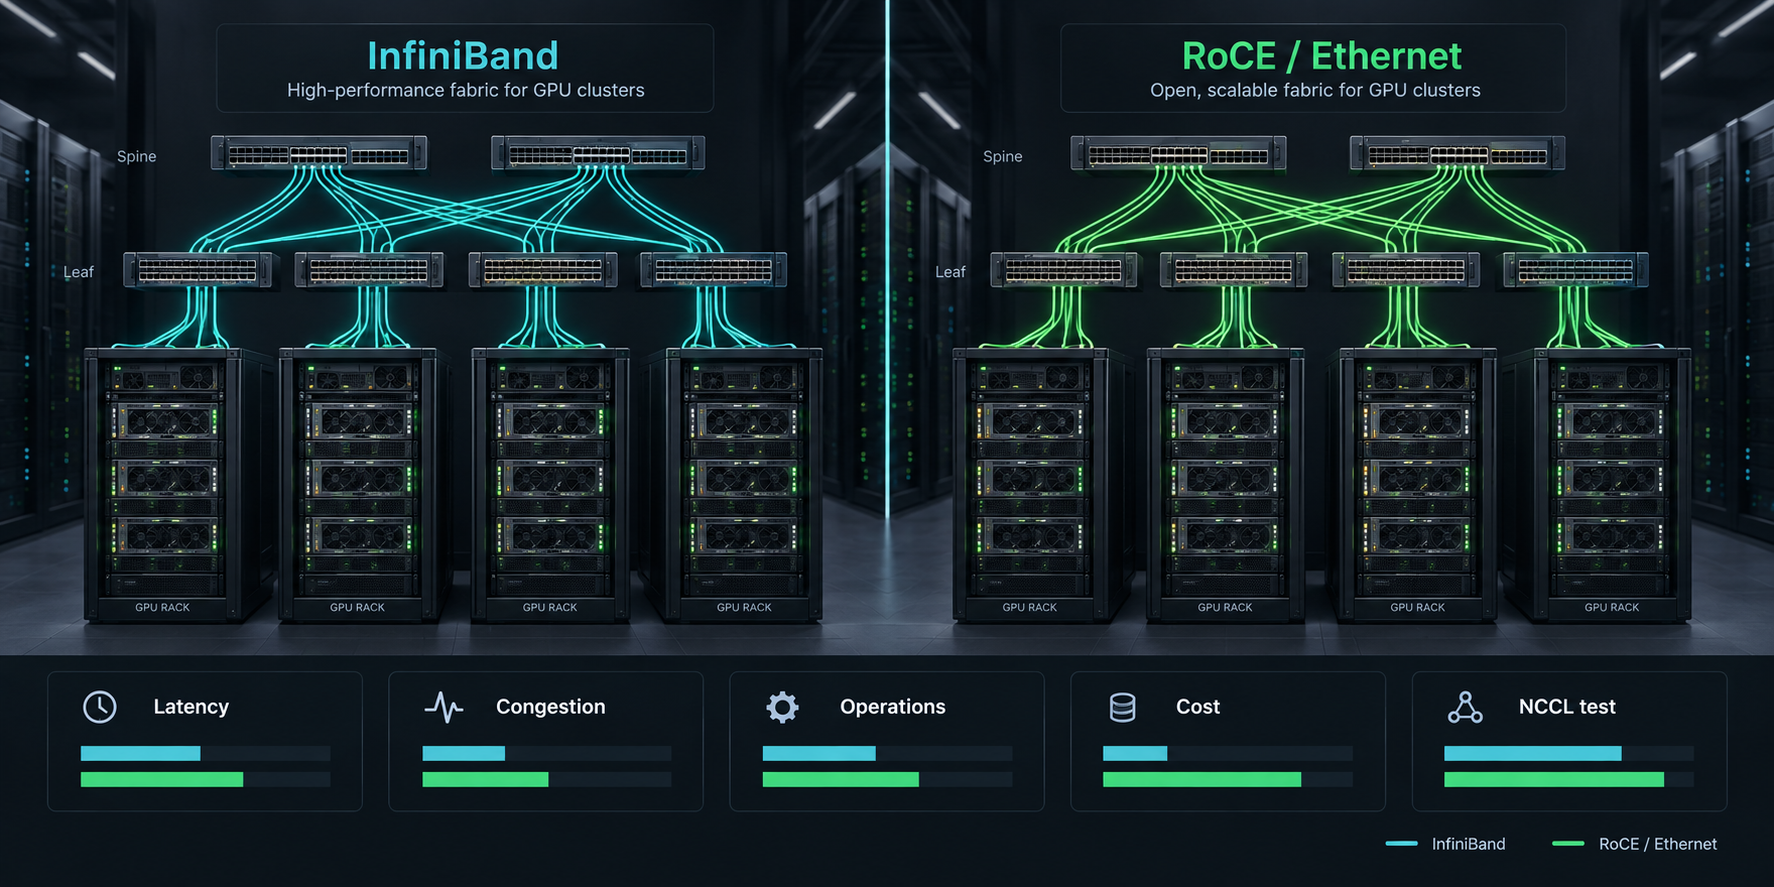
Sebagian besar perdebatan RoCE vs InfiniBand dimulai dari tempat yang salah. Mereka membandingkan nama protokol alih-alih menanyakan apa yang harus ditahan oleh klaster GPU: training yang saling terikat erat, inference ter-shard, traffic storage bersama, multi-tenant campuran, batasan pengadaan, dan tim operasi yang akan men-tune fabric setelah peluncuran.
Untuk klaster GPU multi-node, InfiniBand biasanya menjadi default yang lebih aman ketika workload sensitif terhadap latensi, heavy pada collective, dan cukup besar untuk membenarkan fabric AI/HPC yang dibuat khusus. RoCE biasanya menjadi titik awal yang lebih baik ketika tim sudah mengoperasikan Ethernet berkecepatan tinggi, menginginkan pilihan vendor yang lebih luas, dan dapat membuktikan desain Ethernet lossless dengan pengujian NCCL yang nyata sebelum berkomitmen.
Bagian yang sulit adalah bahwa keduanya bisa bekerja, dan keduanya bisa gagal. Fabric RoCE v2 yang dibangun dengan baik dapat menjalankan klaster AI yang serius. Fabric InfiniBand yang dioperasikan dengan buruk tetap bisa melewatkan jendela training. Panduan ini membandingkan roce vs infiniband melalui latensi, operasional, dan biaya sehingga tim platform dapat memilih fabric yang sesuai dengan workload, bukan slide vendor yang paling berisik.
Jawaban singkat RoCE vs InfiniBand
Gunakan tabel ini sebagai filter keputusan awal.
| Situasi | Biasanya mulai dengan | Mengapa |
|---|---|---|
| Training terdistribusi skala besar dengan traffic all-reduce yang sering | InfiniBand | Ini adalah fabric switching yang dibuat khusus untuk komunikasi HPC dan AI berlatensi rendah serta bandwidth tinggi. |
| Penawaran klaster GPU sudah mencakup fabric NVIDIA Quantum atau InfiniBand serupa yang tervalidasi | InfiniBand | Risiko bergeser dari desain ke pengujian penerimaan dan pembuktian dari penyedia. |
| Tim jaringan enterprise sudah memiliki otomasi Ethernet, monitoring, dan daya tawar pengadaan yang mendalam | RoCE | RoCE mempertahankan RDMA di Ethernet, tetapi memerlukan kontrol kemacetan yang disiplin dan perilaku lossless. |
| Traffic AI, storage, dan data center biasa bercampur pada satu model operasional | RoCE atau Ethernet terpisah plus fabric AI khusus | RoCE dapat selaras dengan operasi Ethernet, tetapi fabric bersama harus dirancang dengan hati-hati. |
| Fleet inferensi kecil, job batch, atau workload yang tidak diskalakan lintas node | Seharusnya tidak ada fabric yang mendorong keputusan | Memori GPU, utilisasi, antrean, dan alternatif model/API lebih penting daripada interkoneksi. |
| Pengadaan membutuhkan keberagaman vendor maksimum dan sumber switch standar | RoCE | Sumber Ethernet bisa lebih luas, sementara klaster InfiniBand lebih terspesialisasi secara vertikal. |
| Tim tidak memiliki pengalaman fabric RDMA dan tidak ada jendela benchmark | Sewa dulu, lalu putuskan | Jangan menandatangani kontrak multi-node sampai pengujian NCCL, kegagalan, dan observabilitas lulus. |
Jawaban praktisnya: pilih InfiniBand ketika aplikasi membutuhkan fabric AI/HPC khusus dengan risiko tuning di level protokol yang paling kecil. Pilih RoCE ketika standardisasi Ethernet, fleksibilitas pengadaan, atau operasi yang sudah ada cukup penting untuk membenarkan engineering fabric tambahan.
Apa arti InfiniBand dalam klaster GPU
InfiniBand adalah arsitektur fabric switching standar industri yang digunakan untuk menghubungkan server dan storage. Dalam klaster GPU, ini umumnya dikaitkan dengan latensi rendah, bandwidth tinggi, RDMA, GPU Direct RDMA, adaptive routing, manajemen kemacetan, dan tooling AI/HPC terintegrasi vendor.
Poin pentingnya bukan hanya bahwa InfiniBand itu cepat. Poin pentingnya adalah bahwa ia dibangun sebagai sebuah fabric. Manajemen subnet, perilaku di tingkat fabric, virtual lane, quality of service, akselerasi in-network, dan integrasi switch/adapter merupakan bagian dari batas desain. Itu penting ketika sebuah job training mencakup ratusan atau ribuan GPU dan setiap operasi collective memperbesar tail latency.
Contoh cloud menunjukkan mengapa fabric ini masih mendominasi banyak klaster AI besar. Dokumentasi Azure ND H100 v5 menjelaskan delapan GPU H100 per VM, konektivitas NVIDIA Quantum-2 CX7 InfiniBand khusus 400 Gbps per GPU, bandwidth interconnect 3,2 Tbps per VM, dukungan GPU Direct RDMA, dan scale-out clustering berorientasi NCCL. Detail-detail itu bukan bahasa generik "jaringan cepat"; itu adalah fakta bentuk klaster yang memengaruhi perilaku training terdistribusi.
Bagi pembeli, pertanyaan InfiniBand harus spesifik:
- Generasi InfiniBand dan platform switch mana yang disertakan?
- Berapa banyak NIC atau host channel adapter yang terpasang per node?
- Apakah setiap GPU dipetakan ke jalur jaringan khusus atau traffic diagregasi?
- Apakah GPUDirect RDMA diaktifkan dan diuji?
- Jaminan penempatan apa yang memastikan node berada dalam domain fabric yang sama?
- Manajemen fabric, telemetry, dan remediasi apa yang menjadi tanggung jawab penyedia?
Jika penjual hanya mengatakan "InfiniBand included", penawarannya tidak lengkap.
Apa arti RoCE dalam klaster GPU
RoCE berarti RDMA over Converged Ethernet. RoCE v2 membawa RDMA melalui jaringan Ethernet/IP yang dapat dirutekan, yang memungkinkan tim menggunakan switching Ethernet sambil tetap melewati sebagian besar overhead CPU dan kernel yang terkait dengan jalur TCP biasa.
Itulah daya tariknya. RoCE dapat memungkinkan tim platform AI membangun klaster GPU yang mendukung RDMA dengan switch Ethernet, praktik operasional Ethernet, dan permukaan pengadaan yang lebih luas. Bagi organisasi yang sudah menjalankan Ethernet berkecepatan tinggi dalam skala besar, RoCE bisa lebih mudah diintegrasikan ke kontrol perubahan, telemetry, kabel, optik, dan manajemen vendor.
Trade-off-nya adalah RoCE bergantung pada fabric Ethernet yang berperilaku baik saat beban tinggi. Collective GPU menciptakan burst yang tersinkronisasi. Checkpointing dan traffic storage dapat berbenturan dengan traffic training. Kemacetan dapat berubah menjadi lonjakan latensi. Kehilangan paket bisa jauh lebih mahal bagi RDMA dibandingkan traffic aplikasi biasa.
Itulah mengapa desain klaster RoCE biasanya mencakup:
- Pengendalian Aliran Prioritas atau strategi lossless lain yang telah diuji.
- Notifikasi Kemacetan Eksplisit dan penyesuaian pengendalian kemacetan.
- Konfigurasi Data Center Bridging di seluruh switch dan NIC.
- Disiplin pemetaan antrean, kelas layanan, dan DSCP/prioritas.
- Penghitung per-prioritas untuk drop, frame pause, penanda ECN, retransmisi, dan tekanan buffer.
- Kontrol perubahan yang ketat untuk firmware, OS switch, driver NIC, MTU, dan kebijakan routing.
RoCE bisa sangat baik, tetapi menganggapnya sebagai "hanya Ethernet" adalah model mental yang keliru. Dalam klaster GPU, RoCE adalah fabric Ethernet yang direkayasa untuk lalu lintas RDMA.
Latensi: bandingkan perilaku ekor, bukan hanya median
Dalam keputusan roce vs infiniband, latensi rata-rata kurang berguna dibandingkan perilaku ekor di bawah beban kolektif nyata.
Pelatihan terdistribusi sering menunggu peserta yang paling lambat. Sejumlah kecil rank dengan latensi lebih tinggi dapat menahan seluruh langkah. Untuk inferensi ter-shard, penundaan jaringan p95 dan p99 dapat muncul sebagai latensi yang terlihat oleh pengguna atau efisiensi batching yang lebih rendah. Untuk pelatihan yang berat pada storage, lalu lintas checkpoint dapat menciptakan lonjakan yang tidak terlihat dalam microbenchmark yang bersih.
Ukur pada empat tingkat:
| Lapisan | Apa yang diukur | Mengapa penting |
|---|---|---|
| Link dan fabric | Error port, drop, penanda ECN, frame pause, kejadian kemacetan, perubahan rute | Menemukan masalah kesehatan fabric sebelum menyalahkan framework. |
| Transport RDMA | Retransmisi, latensi penyelesaian, kedalaman antrean, penghitung NIC | Menunjukkan apakah RDMA stabil di bawah tekanan. |
| Collective NCCL | bandwidth all-reduce, bandwidth bus, latensi min/rata-rata/maks, waktu per iterasi | Cocok dengan pola komunikasi pelatihan AI. |
| Aplikasi | waktu langkah, token/detik, latensi permintaan, durasi checkpoint, pemulihan kegagalan | Memberi tahu tim keuangan dan produk apakah fabric membantu pekerjaan yang berguna. |
InfiniBand sering memiliki keunggulan karena banyak desain klaster dibangun dan divalidasi sejak awal di sekitar beban kerja yang berat pada kolektif. RoCE dapat menutup kesenjangan ketika fabric Ethernet disetel, diisolasi, dan dibuktikan. Ujiannya bukan apakah RoCE v2 secara teoretis bisa melakukan RDMA. Ujiannya adalah apakah kombinasi switch/NIC/kabel/driver/topologi yang tepat ini mempertahankan perilaku p95 dan p99 selama beban kerja yang benar-benar akan Anda jalankan.
Operasional: InfiniBand terspesialisasi, RoCE terintegrasi
Operasional adalah tempat perbandingan roce vs infiniband menjadi kurang jelas.
InfiniBand memberi tim platform fabric terspesialisasi dengan asumsi AI/HPC yang matang. Itu dapat mengurangi ambiguitas penyetelan. Kekurangannya adalah tim memerlukan keahlian khusus InfiniBand, alat manajemen fabric, pengetahuan subnet manager, dan jalur dukungan. Jika klaster disewa dari penyedia spesialis atau hyperscaler, banyak hal itu mungkin tersembunyi di balik batas layanan penyedia. Jika klaster dimiliki sendiri atau di-colocation, kesenjangan keahlian menjadi nyata.
RoCE lebih alami masuk ke banyak organisasi jaringan enterprise karena berjalan di atas Ethernet. Pengadaan, penarikan kabel, operasi switch, pemantauan, dan pola manajemen perubahan mungkin sudah ada. Risikonya adalah operasi Ethernet biasa tidak cukup. Lalu lintas RDMA membutuhkan perlakuan end-to-end yang konsisten. Perubahan kebijakan switch rutin dapat merusak fabric jika PFC, ECN, pemetaan antrean, MTU, hashing, atau kontrol kemacetan bergeser.
Gunakan daftar periksa model operasi ini:
| Pertanyaan operasional | Jawaban permintaan InfiniBand | Jawaban permintaan RoCE |
|---|---|---|
| Siapa yang memiliki desain fabric? | Spesialis jaringan AI/HPC atau penyedia | Tim jaringan plus pemilik platform AI |
| Siapa yang memvalidasi topologi? | Laporan fabric penyedia, alat subnet/fabric, pengujian NCCL | Audit konfigurasi switch/NIC, telemetri, pengujian NCCL |
| Apa yang paling sering rusak? | Ketidaksesuaian penempatan, drift firmware/driver, link gagal, asumsi topologi yang tidak didukung | Drift konfigurasi lossless, salah konfigurasi kemacetan, interferensi lalu lintas bersama, kesalahan pemetaan antrean |
| Apa yang harus dipantau? | Status link, error port, kemacetan, kesehatan rute, afinitas GPU/NIC, kinerja NCCL | Drop, perilaku pause/ECN, PFC storm, retransmisi, tekanan buffer, kinerja NCCL |
| Keterampilan apa yang langka? | Spesialis fabric InfiniBand | Engineer yang memahami operasi Ethernet sekaligus lalu lintas AI yang sensitif terhadap RDMA |
Jika tim Anda sudah memiliki automasi Ethernet yang kuat tetapi tidak memiliki keterampilan InfiniBand, RoCE mungkin menarik secara operasional. Jika tim Anda ingin penyedia memiliki fabric AI sebagai lapisan seperti appliance yang telah diuji, InfiniBand dapat menurunkan risiko pengiriman.
Biaya: sertakan risiko fabric, bukan hanya harga switch
RoCE sering digambarkan lebih murah karena peralatan Ethernet dapat diperoleh luas dan digunakan kembali. InfiniBand sering digambarkan mahal karena merupakan fabric AI/HPC terspesialisasi. Pernyataan itu bisa benar dan tetap mengarah pada keputusan yang buruk.
Untuk klaster GPU, biaya fabric bukan hanya harga switch, NIC, optic, dan kabel. Itu adalah biaya pekerjaan yang berguna yang diselesaikan.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Lalu normalisasikan:
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
atau:
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE dapat menang ketika sumber Ethernet, reuse, dan operasional menurunkan total biaya tanpa mengganggu penyelesaian pekerjaan. InfiniBand dapat menang ketika biaya fabric yang lebih tinggi menghindari penundaan pelatihan, kegagalan job multi-node, dan berjam-jam tuning. Fabric yang lebih murah tetapi membuat GPU mahal menganggur tidaklah lebih murah.
Hubungkan keputusan biaya roce networking vs infiniband ke tiga angka:
- Pemanfaatan GPU yang berguna setelah hambatan jaringan dan job gagal.
- Tingkat penerimaan benchmark di seluruh jumlah node yang tepat.
- Jam operasional yang diperlukan untuk menjaga fabric tetap stabil.
Jika angka-angka itu belum ada, model biaya belum siap.
Kecocokan workload: pelatihan, inferensi, storage, dan klaster campuran
Perbandingan roce vs infiniband comparison yang tepat bergantung pada pola traffic.
Pelatihan terdistribusi
Pelatihan terdistribusi adalah kasus terkuat untuk InfiniBand. Operasi all-reduce dan reduce-scatter yang besar, langkah-langkah yang tersinkronisasi, dan job scale-out akan dihukum oleh jitter. Jika job mencakup banyak node dan bisnis peduli agar jendela pelatihan selesai tepat waktu, InfiniBand sering kali menjadi jalur berisiko lebih rendah.
RoCE masih bisa menjadi pilihan yang valid, terutama di organisasi dengan praktik Ethernet/RDMA yang kuat. Tetapi hal itu harus dibuktikan dengan model family, framework, presisi, ukuran batch, jumlah node, dan pola checkpoint yang sama seperti yang akan Anda jalankan.
Inferensi yang di-shard dan terdistribusi
Inferensi lebih campuran. Jika sebuah model dipecah di beberapa GPU atau node, latensi jaringan menjadi penting. Jika armadanya mostly replica independen, memori GPU, batching, perilaku cache, queueing, dan autoscaling mungkin lebih penting daripada fabric.
Bagi banyak tim inferensi produksi, pertanyaan pertama yang lebih baik bukan InfiniBand vs RoCE. Melainkan apakah workload tersebut benar-benar membutuhkan kontrol GPU langsung. Jika managed model API dapat memenuhi target latensi, kualitas, privasi, dan biaya, bandingkan jalur itu sebelum menandatangani kontrak klaster.
Bacaan terkait: panduan Flatkey tentang GPU cloud vs model API, GPU terbaik untuk inferensi LLM, dan deployment vLLM membahas batas biaya di sisi serving.
Workload intensif storage
Run pelatihan yang men-staging dataset besar, menulis checkpoint secara sering, atau memuat ulang bobot model dapat menjadi masalah jaringan storage. Fabric GPU yang cepat tidak akan memperbaiki staging dataset yang lambat atau filesystem bersama yang jenuh saat checkpoint.
Untuk InfiniBand dan RoCE, sertakan storage dalam benchmark:
- Waktu muat dataset.
- Waktu tulis dan pemulihan checkpoint.
- Perilaku spill ke NVMe lokal.
- Jalur object storage dan egress.
- Kontensi filesystem bersama.
- Waktu pemulihan setelah kegagalan node.
Klaster GPU multi-tenant
Klaster multi-tenant membutuhkan isolasi yang lebih kuat daripada laboratorium benchmark. Tetangga yang bising, job storage latar belakang, container pengguna, dan jendela maintenance dapat mengubah perilaku fabric. InfiniBand dan RoCE sama-sama memerlukan admission control, kuota, telemetry, dan respons insiden. RoCE membutuhkan perhatian ekstra ketika traffic RDMA berbagi batas operasional dengan traffic Ethernet biasa.
Uji penerimaan untuk kedua fabric
Jangan menerima infiniband vs roce comparison dari vendor sebagai bukti. Jalankan uji penerimaan pada bentuk klaster yang persis akan Anda beli atau sewa.
1. Kunci bill of materials pengujian
Catat:
- Model GPU, ukuran memori, dan jumlah GPU per node.
- CPU, RAM, tata letak PCIe/SXM, NUMA, dan NVMe lokal.
- Model NIC/HCA, kecepatan, firmware, dan driver.
- Model switch, OS switch, dan generasi fabric.
- Optik, jenis kabel, dan kecepatan link.
- MTU dan konfigurasi queue.
- Placement group, rack, zona, region, dan jumlah node.
- CUDA, NCCL, MPI, framework, image container, dan versi kernel.
Jika salah satu dari itu berubah setelah benchmark, jalankan ulang pengujian.
2. Jalankan tes NCCL di setiap node
Proyek nccl-tests dari NVIDIA adalah baseline yang praktis karena memeriksa performa dan kebenaran operasi NCCL serta mendukung run MPI multi-node.
Bentuk penerimaan contoh:
# Build with MPI support.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Example: 8 nodes, 8 GPUs per node, 64 ranks total.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Lacak:
- Bandwidth algoritmik dan bandwidth bus.
- Latency minimum, rata-rata, dan maksimum.
- p95/p99 per iterasi jika diaktifkan.
- Outlier per rank.
- Pemeriksaan kebenaran yang gagal.
- Variasi di berbagai run berulang.
- Performa setelah reboot node, restart driver, atau event maintenance switch.
3. Putar ulang workload aktual
Microbenchmark diperlukan, tetapi tidak cukup. Putar ulang satu job pelatihan atau inferensi nyata:
- Model family dan sequence length yang sama.
- Framework dan strategi terdistribusi yang sama.
- Presisi, quantization, dan ukuran batch yang sama.
- Cadence checkpoint yang sama.
- Jalur data yang sama.
- Kebijakan autoscaling atau job scheduler yang sama.
Kemudian bandingkan waktu step, token/detik, delay antrian, durasi checkpoint, pemulihan kegagalan, dan biaya per output yang diterima.
4. Suntikkan kegagalan dan kongesti
Fabric yang lolos hanya pada hari yang bersih bukan siap produksi.
Uji:
- Satu node dihapus dari job.
- Satu link down atau mengalami degradasi.
- Lonjakan checkpoint storage selama training.
- Beban inference latar belakang selama job training.
- Ambang batas counter switch/NIC dan alert.
- Respons dukungan penyedia untuk insiden fabric.
Pemenang dari roce vs infiniband adalah fabric yang menjaga pekerjaan berguna tetap dapat diprediksi setelah pengujian ini, bukan fabric dengan line rate teoretis yang lebih baik.
Pertanyaan pengadaan untuk pemasok InfiniBand
Tanyakan ini sebelum menandatangani:
- Generasi InfiniBand, model switch, model adapter, dan kecepatan link apa yang tepat disertakan?
- Apakah GPUDirect RDMA diaktifkan dan didukung untuk stack GPU, driver, dan framework?
- Apakah semua node dijamin berada dalam satu domain fabric atau placement group?
- Hasil all-reduce NCCL apa yang dapat Anda berikan untuk jumlah GPU yang sama?
- Siapa yang bertanggung jawab atas manajemen subnet, pembaruan firmware, tuning congestion, dan respons insiden?
- Apakah SHARP, adaptive routing, quality of service, atau fitur in-network diaktifkan dan didukung?
- Telemetry apa yang dapat dilihat pelanggan: counter port, event congestion, error HCA, perubahan rute, dan metrik fabric tingkat job?
- Apa konsekuensi finansial jika fabric yang ditawarkan tidak dapat melewati benchmark yang disepakati?
- Apakah klaster dapat diperluas tanpa mengubah topologi atau asumsi oversubscription?
- Jendela pemeliharaan, suku cadang, dan timeline penggantian apa yang berlaku?
Pertanyaan pengadaan untuk pemasok RoCE
Tanyakan ini sebelum menandatangani:
- Apakah fabric menggunakan RoCE v2, dan apakah dapat dirutekan di seluruh topologi yang dibutuhkan?
- Model switch dan NIC mana yang divalidasi untuk bentuk klaster GPU yang persis ini?
- Pengaturan PFC, ECN, DSCP, queue, MTU, dan congestion-control apa yang diperlukan?
- Apakah traffic RDMA diisolasi dari traffic Ethernet biasa atau dibagikan?
- Counter apa yang membuktikan konfigurasi lossless tetap sehat di bawah beban NCCL?
- Bagaimana PFC storm, penumpukan pause-frame, salah konfigurasi ECN, dan tekanan buffer dideteksi?
- Siapa yang bertanggung jawab atas drift konfigurasi switch dan kompatibilitas firmware?
- Hasil NCCL apa yang tersedia untuk jumlah node dan kelas workload yang sama?
- Apakah tim jaringan dapat mereproduksi konfigurasi dari kode?
- Batas dukungan apa yang berlaku ketika masalah melintasi driver GPU, firmware NIC, kebijakan switch, dan framework aplikasi?
Matriks keputusan
Gunakan matriks ini setelah benchmark, bukan sebelumnya.
| Kriteria | Pilih InfiniBand ketika... | Pilih RoCE ketika... |
|---|---|---|
| Sensitivitas latensi | Waktu langkah training didominasi oleh collective atau jitter p99 mengganggu inference | Pengujian menunjukkan p95/p99 yang stabil di bawah beban nyata |
| Skala | Klaster mencakup banyak node dan membutuhkan placement yang dapat diprediksi | Klaster berskala sedang atau fabric Ethernet sudah terbukti pada skala serupa |
| Operasional | Penyedia atau tim memiliki keahlian fabric InfiniBand | Tim jaringan memiliki automasi Ethernet yang kuat dan praktik khusus RDMA |
| Pengadaan | Anda dapat membeli atau menyewa fabric AI/HPC yang tervalidasi | Anda membutuhkan sumber switch yang lebih luas atau standardisasi Ethernet |
| Biaya | Menghindari job gagal dan penundaan tuning membenarkan biaya fabric khusus | Penghematan Ethernet tetap bertahan setelah biaya tuning, telemetry, dan retry |
| Fleksibilitas | Klaster didedikasikan untuk workload AI/HPC | Fabric harus selaras dengan praktik jaringan data center yang lebih luas |
| Risiko | Tenggat proyek ketat dan ambiguitas fabric mahal | Tim memiliki waktu dan keahlian untuk memvalidasi dan mengoperasikan lossless Ethernet |
Jika matriks menghasilkan seri, sewa atau benchmark keduanya. Networking GPU multi-node terlalu mahal untuk diputuskan hanya dari ringkasan protokol.
Worksheet RoCE vs InfiniBand yang dapat disalin
Gunakan tabel ini di dokumen pengadaan.
| Field | Opsi InfiniBand | Opsi RoCE |
|---|---|---|
| Model GPU dan jumlah node | ||
| Generasi fabric dan kecepatan link | ||
| NIC/HCA per node | ||
| Model switch dan jumlah port | ||
| Rasio oversubscription | ||
| Jaminan placement | ||
| Dukungan GPUDirect RDMA | ||
| Bandwidth bus all-reduce NCCL | ||
| Latensi p95/p99 atau maksimum NCCL | ||
| Waktu langkah training | ||
| Waktu tulis/pulihkan checkpoint | ||
| Counter drop/congestion fabric | ||
| Owner operasional | ||
| SLA dukungan | ||
| Biaya fabric bulanan | ||
| Estimasi pemborosan idle/retry | ||
| Biaya per output yang diterima | ||
| Jalur ekspansi | ||
| Risiko keluar |
Baris yang paling penting bukan harga fabric yang tercantum. Melainkan hasil benchmark, owner operasional, pemborosan idle/retry, dan jalur ekspansi.
Kapan API model adalah jawaban yang lebih baik
Beberapa tim yang meneliti roce vs infiniband sebenarnya belum siap membeli network fabric. Mereka mencoba menurunkan biaya output AI, menghilangkan antrean delay, atau meluncurkan fitur produk.
Jika beban kerja tidak memerlukan bobot kustom, penjadwalan GPU langsung, kernel kustom, penempatan yang ketat, atau isolasi di tingkat hardware, bandingkan dulu API model terkelola. Flatkey memberi tim satu kunci, satu saldo, dan satu buku besar penggunaan di seluruh model resmi dan alat AI, yang bisa lebih sederhana daripada memiliki klaster GPU sendiri saat produk masih terus berubah.
Gunakan jalur fabric ketika Anda membutuhkan kontrol hardware. Gunakan jalur model/API ketika metrik bisnisnya adalah output yang diterima, bukan kepemilikan jaringan.
Panduan Flatkey terkait:
- TCO klaster GPU untuk perhitungan sewa cloud, colocation, dan on-premises.
- Sewa klaster GPU untuk evaluasi penyedia dan kontrak kapasitas.
- Harga sewa GPU untuk biaya on-demand, spot, reserved, dan biaya tersembunyi.
- GPU serverless vs GPU dedicated untuk cold start, kapasitas menganggur, dan kontrol.
Daftar periksa sumber resmi
Gunakan halaman resmi sebagai pemeriksaan sumber, lalu validasi klaster spesifik yang Anda beli.
| Sumber | Apa yang perlu diverifikasi |
|---|---|
| InfiniBand Trade Association: Tentang InfiniBand | InfiniBand sebagai fabric switching standar industri untuk konektivitas server dan storage. |
| Platform NVIDIA Quantum InfiniBand | Penempatan switch InfiniBand, adapter, manajemen fabric, SHARP, dan fabric AI/HPC. |
| NVIDIA Spectrum-X Ethernet | Penempatan networking AI yang berorientasi Ethernet/RoCE dan klaim manajemen kemacetan yang perlu divalidasi. |
| Ukuran Azure ND H100 v5 | Contoh klaster GPU cloud yang menggunakan InfiniBand per-GPU khusus dan GPUDirect RDMA. |
| AWS Elastic Fabric Adapter | Alternatif cloud yang menggunakan OS-bypass, kontrol kemacetan, Libfabric, NCCL, dan dukungan GPUDirect RDMA pada instance tertentu. |
| Dokumentasi GPUDirect Google Cloud | Persyaratan pengaturan networking GPU cloud untuk instance keluarga A3 yang mendukung GPUDirect. |
| NVIDIA nccl-tests | Benchmark kolektif yang dapat diulang dan tes kebenaran untuk bentuk klaster yang spesifik. |
Jangan menganggap halaman-halaman ini sebagai pengganti tes penerimaan. Anggap ini sebagai daftar sumber minimum untuk tinjauan pembeli yang serius.
Pertanyaan yang sering diajukan
Apakah InfiniBand selalu lebih cepat daripada RoCE?
Tidak. InfiniBand biasanya merupakan pilihan dengan risiko lebih rendah untuk fabric AI/HPC yang dibangun khusus dan sensitif terhadap latensi, tetapi fabric RoCE v2 yang dirancang dengan baik juga bisa berkinerja baik. Bandingkan klaster yang spesifik menggunakan NCCL dan tes aplikasi.
Apakah RoCE lebih murah daripada InfiniBand?
RoCE bisa lebih murah ketika sumber Ethernet, penggunaan ulang, dan operasi yang sudah ada menurunkan total biaya. RoCE tidak lebih murah jika penyesuaian Ethernet lossless, insiden kemacetan, job gagal, atau GPU menganggur menghapus penghematan tersebut.
Apa perbedaan antara RoCE v2 vs InfiniBand?
RoCE v2 membawa RDMA melalui jaringan Ethernet/IP yang dapat dirutekan. InfiniBand adalah arsitektur fabric switching khusus yang umum digunakan untuk klaster HPC dan AI. Perbedaan operasionalnya adalah RoCE mewarisi fleksibilitas desain dan beban penyesuaian Ethernet, sementara InfiniBand lebih terspesialisasi pada fabric itu sendiri.
Mana yang lebih baik untuk distributed training?
Untuk distributed training besar yang sangat saling bergantung, InfiniBand sering menjadi default yang lebih aman. RoCE bisa menjadi opsi yang kuat ketika fabric Ethernet terisolasi, disetel, dipantau, dan terbukti dengan workload training yang sama.
Mana yang lebih baik untuk inference?
Tergantung arsitektur inference. Model yang dipecah dan serving lintas node peduli pada latensi fabric. Replika independen mungkin lebih peduli pada memori GPU, batching, tingkat cache hit, autoscaling, dan biaya per output yang diterima.
Apa yang harus saya benchmark sebelum memilih?
Jalankan NCCL all-reduce di seluruh jumlah node target, putar ulang workload nyata, sertakan traffic storage/checkpoint, injeksikan kegagalan atau kemacetan, dan catat counter fabric. Keputusan roce vs infiniband harus mengikuti hasil tersebut.
Rekomendasi akhir
Jangan memilih roce vs infiniband dari benchmark generik. Pilih dari workload, model operasional, dan tes penerimaan.
Pilih InfiniBand ketika klaster merupakan fabric AI/HPC khusus, distributed training adalah jalur kritis, dan jendela training yang terlewat sangat mahal. Pilih RoCE ketika standardisasi Ethernet, fleksibilitas pengadaan, dan operasi yang sudah ada penting, dan tim dapat membuktikan perilaku RDMA lossless pada workload GPU yang nyata.
Jika aplikasi hanya membutuhkan output AI, bukan kontrol langsung atas fabric GPU, bandingkan jalur model/API terkelola Flatkey sebelum menyewa atau membeli klaster. Jaringan termurah adalah jaringan yang tidak perlu Anda operasikan.


