
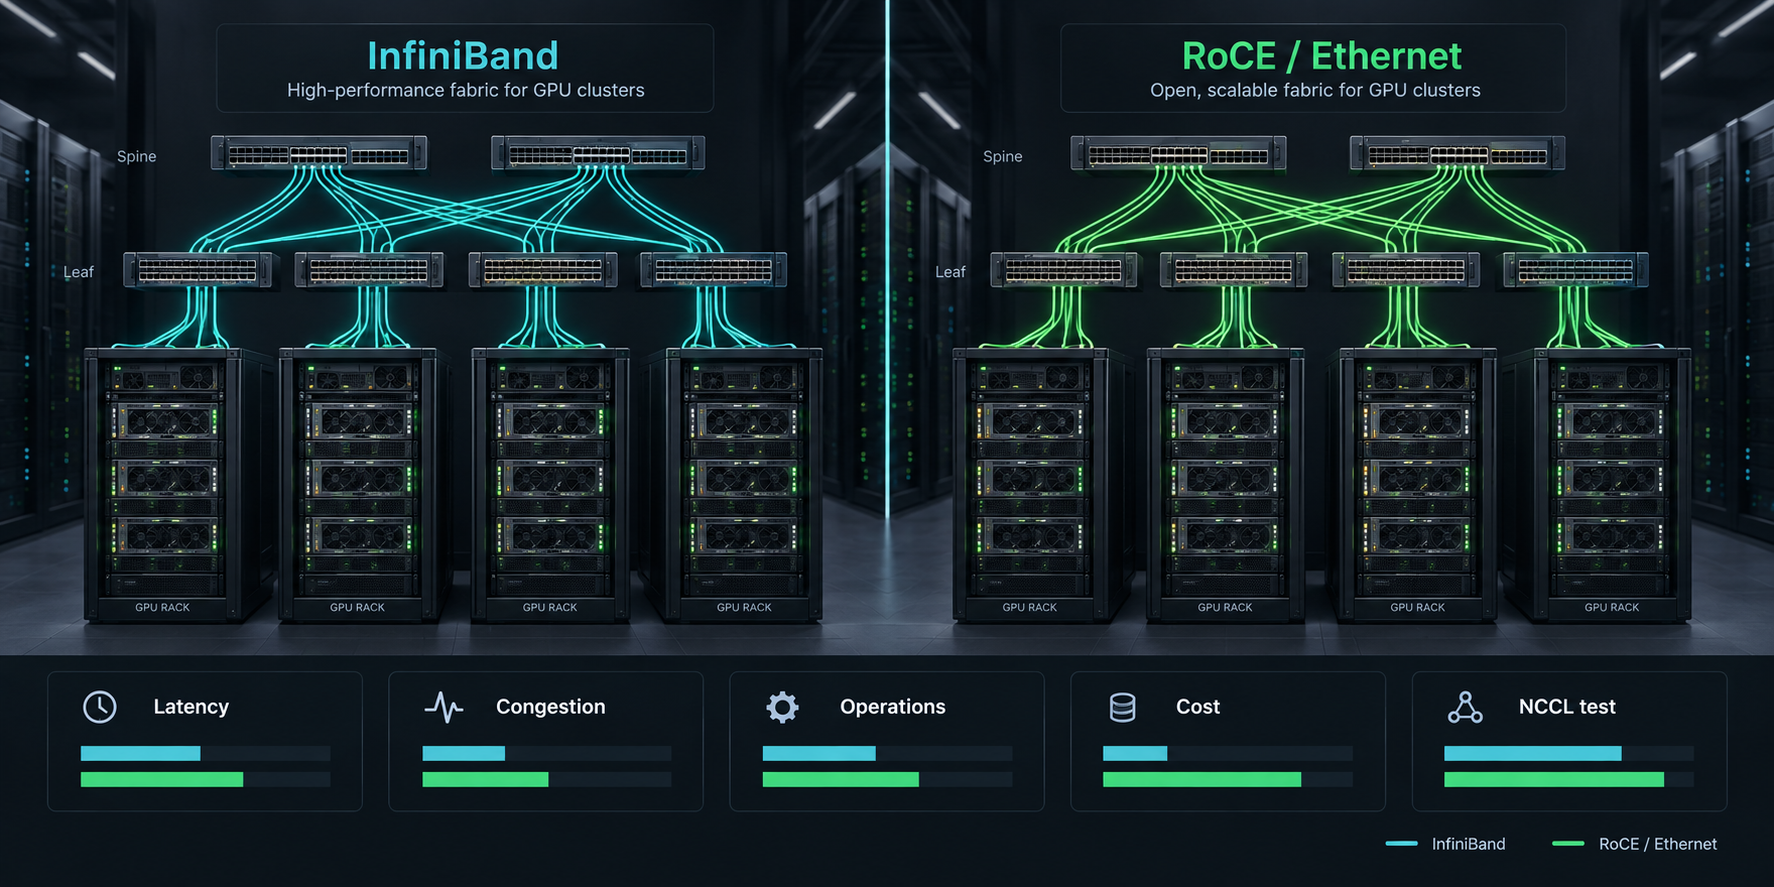
La plupart des débats RoCE contre InfiniBand partent du mauvais point de départ. Ils comparent des noms de protocoles au lieu de demander ce que le cluster GPU doit supporter : un entraînement étroitement couplé, une inférence sharded, du trafic de stockage partagé, des locataires mixtes, des limites d’approvisionnement et l’équipe d’exploitation qui devra régler le fabric après le lancement.
Pour les clusters GPU multi-nœuds, InfiniBand est généralement le choix par défaut le plus sûr lorsque la charge de travail est sensible à la latence, riche en collectives et suffisamment grande pour justifier un fabric IA/HPC conçu à cet effet. RoCE est généralement un meilleur point de départ lorsque l’équipe exploite déjà un Ethernet haute vitesse, veut un choix de fournisseurs plus large et peut démontrer la conception Ethernet sans perte avec de véritables tests NCCL avant de s’engager.
La difficulté, c’est que les deux peuvent fonctionner, et les deux peuvent échouer. Un fabric RoCE v2 bien construit peut faire tourner de sérieux clusters IA. Un fabric InfiniBand mal exploité peut malgré tout manquer la fenêtre d’entraînement. Ce guide compare roce vs infiniband sous l’angle de la latence, de l’exploitation et du coût afin que les équipes plateforme puissent choisir le fabric qui correspond à la charge de travail plutôt qu’à la diapositive la plus bruyante du fournisseur.
Réponse rapide : RoCE vs InfiniBand
Utilisez ce tableau comme filtre de décision initial.
| Situation | Commencer généralement avec | Pourquoi |
|---|---|---|
| Entraînement distribué à grande échelle avec trafic all-reduce fréquent | InfiniBand | C’est un fabric commuté conçu spécifiquement pour une communication HPC et IA à faible latence et à large bande passante. |
| Le devis du cluster GPU inclut déjà un fabric NVIDIA Quantum ou InfiniBand similaire validé | InfiniBand | Le risque passe de la conception aux tests d’acceptation et à la preuve du fournisseur. |
| L’équipe réseau d’entreprise dispose déjà d’une forte automatisation Ethernet, d’un monitoring et d’un levier d’achat | RoCE | RoCE conserve le RDMA sur Ethernet, mais il nécessite un contrôle de congestion discipliné et un comportement sans perte. |
| Trafic IA, stockage et centre de données classique mélangé sur un seul modèle d’exploitation | RoCE ou Ethernet séparé plus fabric IA dédié | RoCE peut s’aligner sur les opérations Ethernet, mais les fabrics partagés doivent être conçus avec soin. |
| Petit parc d’inférence, jobs batch ou charges de travail qui ne s’échelonnent pas sur plusieurs nœuds | Aucun des deux fabrics ne devrait guider la décision | La mémoire GPU, l’utilisation, la mise en file d’attente et les alternatives de modèle/API comptent davantage que l’interconnexion. |
| Les achats exigent une diversité maximale des fournisseurs et un approvisionnement standard des commutateurs | RoCE | L’approvisionnement Ethernet peut être plus large, tandis que les clusters InfiniBand sont plus spécialisés verticalement. |
| L’équipe n’a aucune expérience du fabric RDMA et aucune fenêtre de benchmark | Louez d’abord, puis décidez | Ne signez pas de contrat multi-nœuds tant que les tests NCCL, de défaillance et d’observabilité ne passent pas. |
La réponse pratique : choisissez InfiniBand lorsque l’application a besoin d’un fabric IA/HPC dédié avec le moins de risque de réglage au niveau du protocole. Choisissez RoCE lorsque la standardisation Ethernet, la flexibilité d’achat ou les opérations existantes justifient l’effort supplémentaire d’ingénierie du fabric.
Ce que signifie InfiniBand dans un cluster GPU
InfiniBand est une architecture de fabric commuté standard de l’industrie utilisée pour interconnecter des serveurs et du stockage. Dans les clusters GPU, elle est couramment associée à une faible latence, une bande passante élevée, RDMA, GPU Direct RDMA, le routage adaptatif, la gestion de la congestion et des outils IA/HPC intégrés au fournisseur.
Le point important n’est pas seulement qu’InfiniBand est rapide. Le point important est qu’il est conçu comme un fabric. La gestion du sous-réseau, le comportement au niveau du fabric, les voies virtuelles, la qualité de service, l’accélération dans le réseau et l’intégration commutateur/adaptateur font partie de la frontière de conception. Cela compte lorsqu’un job d’entraînement s’étend sur des centaines ou des milliers de GPU et que chaque opération collective amplifie la latence de queue.
Des exemples cloud montrent pourquoi ce fabric domine encore de nombreux grands clusters IA. La documentation Azure ND H100 v5 décrit huit GPU H100 par VM, une connectivité InfiniBand NVIDIA Quantum-2 CX7 dédiée à 400 Gbps par GPU, 3,2 Tbps de bande passante d’interconnexion par VM, la prise en charge de GPU Direct RDMA et un clustering scale-out orienté NCCL. Ces détails ne relèvent pas d’un langage générique de « réseau rapide » ; ce sont des faits sur la forme du cluster qui influencent le comportement de l’entraînement distribué.
Pour un acheteur, la question InfiniBand doit être spécifique :
- Quelle génération InfiniBand et quelle plateforme de commutation sont incluses ?
- Combien de NIC ou d’adaptateurs de canal hôte sont attachés par nœud ?
- Chaque GPU est-il mappé à un chemin réseau dédié ou le trafic est-il agrégé ?
- GPUDirect RDMA est-il activé et testé ?
- Quelle garantie de placement maintient les nœuds dans le même domaine de fabric ?
- Quelle gestion du fabric, quelle télémétrie et quelle remédiation le fournisseur prend-il en charge ?
Si le vendeur dit seulement « InfiniBand inclus », le devis est incomplet.
Ce que signifie RoCE dans un cluster GPU
RoCE signifie RDMA over Converged Ethernet. RoCE v2 transporte RDMA sur des réseaux Ethernet/IP routables, ce qui permet aux équipes d’utiliser la commutation Ethernet tout en contournant une grande partie du surcoût CPU et noyau associé aux chemins TCP ordinaires.
C’est là tout son attrait. RoCE peut permettre à une équipe de plateforme IA de construire des clusters GPU capables de RDMA avec des commutateurs Ethernet, des pratiques d’exploitation Ethernet et une surface d’approvisionnement plus large. Pour les organisations qui exploitent déjà l’Ethernet haute vitesse à grande échelle, RoCE peut être plus facile à intégrer dans le contrôle des changements, la télémétrie, le câblage, les optiques et la gestion des fournisseurs.
Le compromis est que RoCE dépend du bon comportement du fabric Ethernet sous charge. Les collectives GPU créent des rafales synchronisées. Le checkpointing et le trafic de stockage peuvent entrer en collision avec le trafic d’entraînement. La congestion peut se transformer en pics de latence. La perte de paquets peut être beaucoup plus coûteuse pour RDMA que pour du trafic applicatif ordinaire.
C’est pourquoi la conception d’un cluster RoCE inclut généralement :
- Contrôle de flux prioritaire ou une autre stratégie sans perte testée.
- Notification explicite de congestion et réglage du contrôle de congestion.
- Configuration du Data Center Bridging sur les commutateurs et les NIC.
- Discipline de mappage des files d’attente, de la classe de service et du DSCP/de la priorité.
- Compteurs par priorité pour les pertes, les trames de pause, les marquages ECN, les retransmissions et la pression des tampons.
- Contrôle strict des changements pour le firmware, le système d’exploitation du commutateur, les pilotes NIC, le MTU et la politique de routage.
RoCE peut être excellent, mais « ce n’est que de l’Ethernet » est le mauvais modèle mental. Dans un cluster GPU, RoCE est un fabric Ethernet conçu pour le trafic RDMA.
Latence : comparez le comportement en queue de distribution, pas seulement la médiane
Dans la décision roce vs infiniband, la latence moyenne est moins utile que le comportement en queue sous une charge collective réelle.
L’entraînement distribué attend souvent le participant le plus lent. Un petit nombre de rangs avec une latence plus élevée peut retarder toute l’étape. Pour l’inférence sharded, la latence réseau p95 et p99 peut se traduire par une latence visible pour l’utilisateur ou une moindre efficacité du batching. Pour un entraînement intensif en stockage, le trafic de checkpoint peut créer des pics invisibles dans un microbenchmark propre.
Mesurez à quatre niveaux :
| Couche | Quoi mesurer | Pourquoi c’est important |
|---|---|---|
| Lien et fabric | Erreurs de port, pertes, marquages ECN, trames de pause, événements de congestion, changements de route | Détecte les problèmes de santé du fabric avant de blâmer les frameworks. |
| Transport RDMA | Retransmissions, latence de complétion, profondeur de file d’attente, compteurs NIC | Montre si le RDMA est stable sous pression. |
| Collectifs NCCL | bande passante all-reduce, bande passante bus, latence min/moy/max, timing par itération | Correspond aux schémas de communication de l’entraînement IA. |
| Application | temps d’étape, tokens/s, latence des requêtes, durée des checkpoints, reprise après échec | Indique aux équipes finance et produit si le fabric aide réellement le travail utile. |
InfiniBand a souvent un avantage parce que de nombreuses architectures de cluster sont conçues et validées dès le départ autour de charges de travail fortement collectives. RoCE peut combler l’écart lorsque le fabric Ethernet est réglé, isolé et éprouvé. Le test n’est pas de savoir si RoCE v2 peut théoriquement faire du RDMA. Le test est de savoir si cette combinaison exacte de commutateur/NIC/câblage/pilote/topologie maintient un comportement p95 et p99 pendant la charge de travail que vous allez réellement exécuter.
Exploitation : InfiniBand est spécialisé, RoCE est intégré
L’exploitation est l’endroit où la comparaison roce vs infiniband devient moins évidente.
InfiniBand fournit aux équipes plateforme un fabric spécialisé avec des hypothèses IA/HPC matures. Cela peut réduire l’ambiguïté de réglage. L’inconvénient est que l’équipe a besoin de compétences spécifiques à InfiniBand, d’outils de gestion du fabric, de connaissances du gestionnaire de sous-réseau et de chaînes de support. Si le cluster est loué auprès d’un fournisseur spécialisé ou d’un hyperscaler, une grande partie de cela peut être masquée derrière le périmètre de service du fournisseur. Si le cluster est détenu ou colocalisé, l’écart de compétences devient réel.
RoCE s’intègre plus naturellement dans de nombreuses organisations réseau d’entreprise parce qu’il fonctionne sur Ethernet. L’approvisionnement, le câblage, l’exploitation des commutateurs, la supervision et les schémas de gestion des changements peuvent déjà exister. Le risque est que les opérations Ethernet ordinaires ne suffisent pas. Le trafic RDMA nécessite un traitement cohérent de bout en bout. Un changement de politique de commutateur de routine peut casser le fabric si PFC, ECN, le mappage des files, le MTU, le hachage ou les contrôles de congestion dérivent.
Utilisez cette liste de contrôle du modèle d’exploitation :
| Question d’exploitation | Réponse attendue pour InfiniBand | Réponse attendue pour RoCE |
|---|---|---|
| Qui possède la conception du fabric ? | Spécialiste réseau IA/HPC ou fournisseur | Équipe réseau plus propriétaire de la plateforme IA |
| Qui valide la topologie ? | Rapport de fabric du fournisseur, outils de sous-réseau/fabric, tests NCCL | Audit de configuration des commutateurs/NIC, télémétrie, tests NCCL |
| Qu’est-ce qui casse le plus souvent ? | Inadéquation de placement, dérive firmware/pilote, liaisons défaillantes, hypothèses de topologie non prises en charge | Dérive de la configuration sans perte, mauvaise configuration de la congestion, interférences du trafic partagé, erreurs de mappage des files |
| Que faut-il surveiller ? | État des liens, erreurs de port, congestion, santé des routes, affinité GPU/NIC, performances NCCL | Pertes, comportement pause/ECN, tempêtes PFC, retransmissions, pression des tampons, performances NCCL |
| Quelle compétence est rare ? | Spécialistes du fabric InfiniBand | Ingénieurs qui comprennent à la fois l’exploitation Ethernet et le trafic IA sensible au RDMA |
Si votre équipe dispose déjà d’une forte automatisation Ethernet mais d’aucune compétence InfiniBand, RoCE peut être intéressant sur le plan opérationnel. Si votre équipe souhaite que le fournisseur prenne en charge le fabric IA comme une couche testée de type appliance, InfiniBand peut réduire le risque de livraison.
Coût : incluez le risque du fabric, pas seulement le prix des commutateurs
RoCE est souvent présenté comme moins cher parce que l’équipement Ethernet peut être largement sourcé et réutilisé. InfiniBand est souvent présenté comme coûteux parce qu’il s’agit d’un fabric IA/HPC spécialisé. Ces affirmations peuvent être vraies et conduire malgré tout à de mauvaises décisions.
Pour les clusters GPU, le coût du fabric ne se limite pas au prix du commutateur, de la NIC, des optiques et des câbles. C’est le coût du travail utile accompli.
fabric_adjusted_gpu_cluster_cost =
  compute_capacity
  + network_adapters
  + switches
  + optics_and_cables
  + rack_power_and_space
  + storage_and_data_path
  + fabric_operations
  + failed_job_and_retry_waste
  + queue_delay_and_idle_gpu_time
  + support_and_escalation
Puis normalisez :
cost_per_accepted_training_run =
  fabric_adjusted_gpu_cluster_cost
  / accepted_training_runs_completed_on_time
ou :
cost_per_accepted_output =
  fabric_adjusted_gpu_cluster_cost
  / accepted_inference_outputs_after_retries
RoCE peut l’emporter lorsque l’approvisionnement Ethernet, la réutilisation et l’exploitation réduisent le coût total sans nuire à l’achèvement des tâches. InfiniBand peut l’emporter lorsque le coût plus élevé du réseau évite les retards d’entraînement, les jobs multinœuds échoués et des semaines de réglage. Un réseau moins cher qui laisse des GPU coûteux inactifs n’est pas moins cher.
Rattachez la décision de coût entre roce networking vs infiniband à trois chiffres :
- Utilisation utile des GPU après les blocages réseau et les jobs échoués.
- Taux d’acceptation des benchmarks sur le nombre exact de nœuds.
- Heures d’exploitation nécessaires pour maintenir la stabilité du réseau.
Si ces chiffres manquent, le modèle de coût n’est pas prêt.
Adéquation à la charge de travail : entraînement, inférence, stockage et clusters mixtes
La bonne roce vs infiniband comparison dépend du profil de trafic.
Entraînement distribué
L’entraînement distribué est le cas le plus favorable à InfiniBand. Les grandes opérations all-reduce et reduce-scatter, les étapes synchronisées et les jobs à grande échelle sanctionnent la gigue. Si le job s’étend sur de nombreux nœuds et que l’entreprise tient à terminer les fenêtres d’entraînement dans les délais, InfiniBand est souvent la voie la moins risquée.
RoCE peut néanmoins rester un choix valide, surtout dans les organisations disposant d’une solide pratique Ethernet/RDMA. Mais il doit être démontré avec la même famille de modèles, le même framework, la même précision, la même taille de batch, le même nombre de nœuds et le même schéma de checkpoint que ceux que vous prévoyez d’exécuter.
Inférence distribuée et shardée
L’inférence est plus nuancée. Si un modèle est réparti sur plusieurs GPU ou nœuds, la latence réseau compte. Si le parc est surtout composé de réplicas indépendants, la mémoire GPU, le batching, le comportement du cache, la mise en file d’attente et l’autoscaling peuvent compter davantage que le réseau.
Pour de nombreuses équipes d’inférence en production, la meilleure première question n’est pas InfiniBand contre RoCE. C’est de savoir si la charge de travail a besoin d’un contrôle direct des GPU. Si une API de modèle gérée peut atteindre l’objectif de latence, de qualité, de confidentialité et de coût, comparez cette voie avant de signer un contrat de cluster.
Lecture connexe : les guides de Flatkey sur GPU cloud vs model API, best GPU for LLM inference et vLLM deployment couvrent la frontière de coût côté service.
Charges de travail intensives en stockage
Les entraînements qui mettent en place de grands jeux de données, écrivent des checkpoints fréquents ou rechargent les poids du modèle peuvent devenir des problèmes de réseau de stockage. Un réseau GPU rapide ne corrigera pas une mise en place de jeu de données lente ni un système de fichiers partagé qui sature pendant les checkpoints.
Pour InfiniBand comme pour RoCE, incluez le stockage dans le benchmark :
- Temps de chargement du jeu de données.
- Temps d’écriture et de restauration du checkpoint.
- Comportement du débordement local NVMe.
- Chemin du stockage objet et egress.
- Contention du système de fichiers partagé.
- Temps de récupération après une panne de nœud.
Clusters GPU multi-tenant
Les clusters multi-tenant ont besoin d’une isolation plus forte qu’un laboratoire de benchmark. Les voisins bruyants, les jobs de stockage en arrière-plan, les conteneurs utilisateurs et les fenêtres de maintenance peuvent modifier le comportement du réseau. InfiniBand et RoCE ont tous deux besoin de contrôle d’admission, de quotas, de télémétrie et de réponse aux incidents. RoCE exige une attention supplémentaire lorsque le trafic RDMA partage les mêmes limites opérationnelles que le trafic Ethernet ordinaire.
Test d’acceptation pour l’un ou l’autre réseau
N’acceptez pas la infiniband vs roce comparison d’un fournisseur comme preuve. Exécutez le test d’acceptation sur la forme exacte du cluster que vous allez acheter ou louer.
1. Verrouillez la nomenclature du test
Enregistrez :
- Modèle de GPU, taille de mémoire et nombre de GPU par nœud.
- CPU, RAM, disposition PCIe/SXM, NUMA et NVMe local.
- Modèle de NIC/HCA, vitesse, firmware et pilote.
- Modèle de switch, OS du switch et génération du réseau.
- Optiques, type de câble et vitesse de lien.
- Configuration MTU et files d’attente.
- Groupe de placement, rack, zone, région et nombre de nœuds.
- CUDA, NCCL, MPI, framework, image conteneur et version du kernel.
Si l’un de ces éléments change après le benchmark, relancez le test.
2. Exécutez les tests NCCL sur chaque nœud
Le projet nccl-tests de NVIDIA est la base pratique, car il vérifie à la fois les performances et la correction des opérations NCCL et prend en charge les exécutions MPI multinœuds.
Exemple de forme d’acceptation :
# Build with MPI support.
make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr

# Example: 8 nodes, 8 GPUs per node, 64 ranks total.
mpirun -np 64 -N 8 ./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1 \
  -n 50 -w 10 -a 2 -S 1 -J all-reduce-64gpu.json
Suivez :
- Bande passante algorithmique et bande passante bus.
- Latence minimale, moyenne et maximale.
- p95/p99 par itération si activé.
- Valeurs aberrantes par rang.
- Échecs de vérification de correction.
- Variations entre exécutions répétées.
- Performances après un redémarrage de nœud, un redémarrage du pilote ou un événement de maintenance du switch.
3. Rejouez la charge de travail réelle
Les microbenchmarks sont nécessaires, mais pas suffisants. Rejouez un vrai job d’entraînement ou d’inférence :
- Même famille de modèles et même longueur de séquence.
- Même framework et même stratégie distribuée.
- Même précision, quantification et taille de batch.
- Même cadence de checkpoint.
- Même chemin des données.
- Même politique d’autoscaling ou de planification des jobs.
Comparez ensuite le temps de step, les tokens/sec, le délai de file d’attente, la durée des checkpoints, la récupération après panne et le coût par sortie acceptée.
4. Injectez des pannes et de la congestion
Un réseau qui ne réussit que par beau temps n’est pas prêt pour la production.
Testez :
- Un nœud retiré du job.
- Un lien en panne ou dégradé.
- Burst de point de contrôle du stockage pendant l’entraînement.
- Charge d’inférence en arrière-plan pendant un job d’entraînement.
- Seuils de compteurs de switch/NIC et alertes.
- Réponse du support du fournisseur pour un incident du fabric.
Le gagnant de roce vs infiniband est le fabric qui maintient le travail utile prévisible après ces tests, et non celui qui affiche le meilleur débit théorique sur la ligne.
Questions d’achat pour les fournisseurs InfiniBand
Posez ces questions avant de signer :
- Quelle génération exacte d’InfiniBand, quel modèle de switch, quel modèle d’adaptateur et quelle vitesse de lien sont inclus ?
- GPUDirect RDMA est-il activé et pris en charge pour la pile GPU, pilote et framework ?
- Tous les nœuds sont-ils garantis dans un seul domaine de fabric ou groupe de placement ?
- Quels résultats NCCL all-reduce pouvez-vous fournir pour le même nombre de GPU ?
- Qui est responsable de la gestion du sous-réseau, des mises à jour du firmware, du réglage de la congestion et de la réponse aux incidents ?
- SHARP, le routage adaptatif, la qualité de service ou les fonctionnalités in-network sont-ils activés et pris en charge ?
- Quelle télémétrie le client peut-il voir : compteurs de ports, événements de congestion, erreurs HCA, changements de route et métriques du fabric au niveau du job ?
- Que se passe-t-il financièrement si le fabric proposé ne peut pas passer le benchmark convenu ?
- Le cluster peut-il s’étendre sans modifier la topologie ni les hypothèses de surabonnement ?
- Quelles fenêtres de maintenance, pièces de rechange et délais de remplacement s’appliquent ?
Questions d’achat pour les fournisseurs RoCE
Posez ces questions avant de signer :
- Le fabric est-il en RoCE v2, et est-il routable sur la topologie requise ?
- Quels modèles de switch et de NIC sont validés pour cette forme exacte de cluster GPU ?
- Quels paramètres PFC, ECN, DSCP, file d’attente, MTU et contrôle de congestion sont requis ?
- Le trafic RDMA est-il isolé du trafic Ethernet ordinaire ou partagé ?
- Quels compteurs prouvent que la configuration sans perte est saine sous charge NCCL ?
- Comment les tempêtes PFC, l’accumulation de trames de pause, une mauvaise configuration ECN et la pression sur les tampons sont-ils détectés ?
- Qui est responsable des dérives de configuration des switchs et de la compatibilité du firmware ?
- Quels résultats NCCL existent pour le même nombre de nœuds et la même classe de charge de travail ?
- L’équipe réseau peut-elle reproduire la configuration à partir du code ?
- Quelle frontière de support s’applique lorsque le problème traverse le pilote GPU, le firmware NIC, la politique du switch et le framework applicatif ?
Matrice de décision
Utilisez cette matrice après le benchmark, pas avant.
| Critère | Favoriser InfiniBand quand... | Favoriser RoCE quand... |
|---|---|---|
| Sensibilité à la latence | Le temps d’étape d’entraînement est dominé par les collectives ou le jitter p99 nuit à l’inférence | Les tests montrent une p95/p99 stable sous charge réelle |
| Échelle | Le cluster s’étend sur de nombreux nœuds et nécessite un placement prévisible | Le cluster est de taille moyenne ou le fabric Ethernet a déjà fait ses preuves à une échelle similaire |
| Exploitation | Le fournisseur ou l’équipe dispose d’une expertise en fabric InfiniBand | L’équipe réseau a une forte automatisation Ethernet et une pratique spécifique RDMA |
| Achat | Vous pouvez acheter ou louer un fabric IA/HPC validé | Vous avez besoin d’une source de switchs plus large ou d’une standardisation Ethernet |
| Coût | Éviter les jobs échoués et le délai de réglage justifie le coût d’un fabric spécialisé | Les économies Ethernet subsistent après les coûts de réglage, de télémétrie et de reprise |
| Flexibilité | Le cluster est dédié aux charges de travail IA/HPC | Le fabric doit s’aligner sur des pratiques plus larges de réseau de centre de données |
| Risque | Le délai du projet est serré et l’ambiguïté du fabric coûte cher | L’équipe a le temps et les compétences pour valider et exploiter un Ethernet sans perte |
Si la matrice aboutit à une égalité, louez ou benchmarkez les deux. Le réseau GPU multi-nœuds est trop coûteux pour être décidé à partir d’un simple résumé de protocole.
Feuille de calcul RoCE vs InfiniBand à copier
Utilisez ce tableau dans le document d’achat.
| Champ | Option InfiniBand | Option RoCE |
|---|---|---|
| Modèle GPU et nombre de nœuds | ||
| Génération du fabric et vitesse de lien | ||
| NIC/HCA par nœud | ||
| Modèle de switch et nombre de ports | ||
| Taux de surabonnement | ||
| Garantie de placement | ||
| Prise en charge de GPUDirect RDMA | ||
| Bande passante du bus NCCL all-reduce | ||
| Latence NCCL p95/p99 ou maximale | ||
| Temps d’étape d’entraînement | ||
| Temps d’écriture/restauration du checkpoint | ||
| Compteurs de pertes/congestion du fabric | ||
| Responsable des opérations | ||
| SLA de support | ||
| Coût mensuel du fabric | ||
| Estimation du gaspillage lié à l’inactivité/aux reprises | ||
| Coût par sortie acceptée | ||
| Chemin d’extension | ||
| Risque de sortie |
Les lignes les plus importantes ne sont pas le prix du fabric सूची. Ce sont le résultat du benchmark, le responsable des opérations, le gaspillage lié à l’inactivité/aux reprises et le chemin d’extension.
Quand une API de modèle est la meilleure réponse
Certaines équipes qui étudient roce vs infiniband ne sont pas encore prêtes à acheter un fabric réseau. Elles cherchent à réduire le coût de sortie IA, à supprimer le délai de file d’attente ou à livrer une fonctionnalité produit.
Si la charge de travail ne nécessite pas de poids personnalisés, d’ordonnancement direct des GPU, de kernels personnalisés, de placement strict ou d’isolation au niveau matériel, comparez d’abord une API de modèle gérée. Flatkey offre aux équipes une seule clé, un seul solde et un seul registre d’utilisation sur les modèles officiels et les outils d’IA, ce qui peut être plus simple que de gérer un cluster GPU tant que le produit évolue encore.
Utilisez la voie du fabric lorsque vous avez besoin d’un contrôle matériel. Utilisez la voie modèle/API lorsque la métrique métier est le fait d’obtenir des sorties acceptées, et non la propriété du réseau.
Guides Flatkey associés :
- TCO du cluster GPU pour les calculs de location cloud, colocation et sur site.
- Location de cluster GPU pour l’évaluation des fournisseurs et les contrats de capacité.
- Prix de location des GPU pour les coûts à la demande, spot, réservés et cachés.
- GPU serverless vs GPU dédié pour les cold starts, la capacité inutilisée et le contrôle.
Liste de contrôle des sources officielles
Utilisez les pages officielles comme vérifications des sources, puis validez le cluster exact que vous achetez.
| Source | À vérifier |
|---|---|
| InfiniBand Trade Association : À propos d’InfiniBand | InfiniBand comme fabric commuté standard de l’industrie pour la connectivité des serveurs et du stockage. |
| Plateforme NVIDIA Quantum InfiniBand | Positionnement du switch InfiniBand, de l’adaptateur, de la gestion du fabric, de SHARP et du fabric IA/HPC. |
| NVIDIA Spectrum-X Ethernet | Positionnement du réseau IA orienté Ethernet/RoCE et affirmations de gestion de la congestion à valider. |
| Tailles Azure ND H100 v5 | Exemple de clusters GPU cloud utilisant InfiniBand dédié par GPU et GPUDirect RDMA. |
| AWS Elastic Fabric Adapter | Alternative cloud utilisant l’OS-bypass, le contrôle de congestion, Libfabric, NCCL et la prise en charge de GPUDirect RDMA sur certaines instances. |
| Documentation Google Cloud GPUDirect | Exigences de configuration du réseau GPU cloud pour les instances de la famille A3 compatibles GPUDirect. |
| NVIDIA nccl-tests | Tests de collectives et de correction reproductibles pour la forme exacte du cluster. |
Ne considérez pas ces pages comme un substitut aux tests d’acceptation. Considérez-les comme la liste minimale de sources pour une revue sérieuse par l’acheteur.
Foire aux questions
InfiniBand est-il toujours plus rapide que RoCE ?
Non. InfiniBand est généralement le choix le moins risqué pour des fabrics IA/HPC conçus à cet effet et sensibles à la latence, mais un fabric RoCE v2 bien conçu peut offrir de bonnes performances. Comparez le cluster exact à l’aide de NCCL et de tests applicatifs.
RoCE est-il moins cher qu’InfiniBand ?
RoCE peut être moins cher lorsque l’approvisionnement Ethernet, la réutilisation et les opérations existantes réduisent le coût total. Il ne l’est pas si le réglage d’un Ethernet sans perte, les incidents de congestion, les jobs échoués ou les GPU inactifs annulent les économies.
Quelle est la différence entre RoCE v2 et InfiniBand ?
RoCE v2 transporte RDMA sur des réseaux Ethernet/IP routables. InfiniBand est une architecture de fabric commuté dédiée, couramment utilisée pour les clusters HPC et IA. La différence opérationnelle est que RoCE hérite de la flexibilité de conception et de la charge de réglage d’Ethernet, tandis qu’InfiniBand est plus spécialisé autour du fabric.
Lequel est meilleur pour l’entraînement distribué ?
Pour un entraînement distribué à grande échelle et fortement couplé, InfiniBand est souvent le choix par défaut le plus sûr. RoCE peut être une bonne option lorsque le fabric Ethernet est isolé, ajusté, surveillé et validé avec la même charge de travail d’entraînement.
Lequel est meilleur pour l’inférence ?
Cela dépend de l’architecture d’inférence. Les modèles fragmentés et les services multi-nœuds se soucient de la latence du fabric. Les répliques indépendantes peuvent accorder plus d’importance à la mémoire GPU, au batching, au taux de cache hit, à l’autoscaling et au coût par sortie acceptée.
Que dois-je benchmarker avant de choisir ?
Exécutez un all-reduce NCCL sur le nombre de nœuds cible, rejouez la charge de travail réelle, incluez le trafic de stockage/checkpoint, injectez des pannes ou de la congestion, et enregistrez les compteurs du fabric. La décision roce vs infiniband doit découler de ces résultats.
Recommandation finale
Ne choisissez pas roce vs infiniband à partir d’un benchmark générique. Choisissez en fonction de la charge de travail, du modèle d’exploitation et du test d’acceptation.
Choisissez InfiniBand lorsque le cluster est un fabric IA/HPC dédié, que l’entraînement distribué est le chemin critique et que manquer des fenêtres d’entraînement coûte cher. Choisissez RoCE lorsque la standardisation Ethernet, la flexibilité d’approvisionnement et les opérations existantes comptent, et que l’équipe peut démontrer un comportement RDMA sans perte sous des charges GPU réelles.
Si l’application n’a besoin que de sorties IA, et non d’un contrôle direct du fabric GPU, comparez les routes modèle/API gérées par Flatkey avant de louer ou d’acheter le cluster. Le réseau le moins cher est celui que vous n’avez pas à exploiter.


