
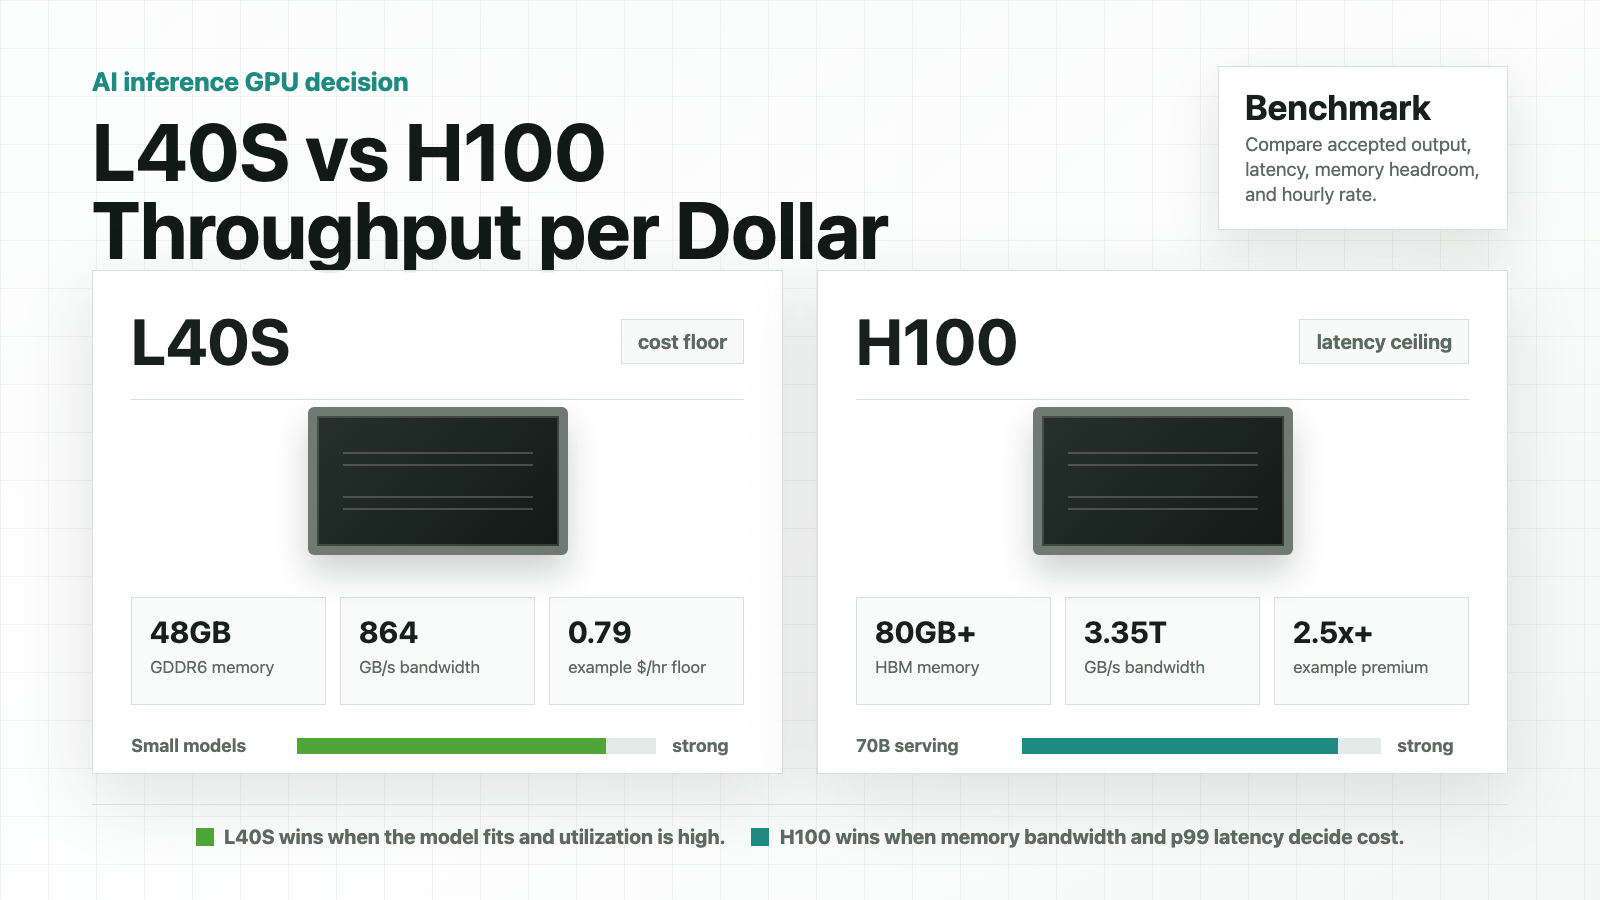
NVIDIA L40S vs H100 pour l’inférence IA : débit par dollar
La réponse courte pour L40S vs H100 n’est pas « H100 est plus rapide, donc achetez H100. » H100 est l’accélérateur IA le plus puissant. L40S est souvent le meilleur candidat en termes de débit par dollar lorsque le modèle tient dans 48 Go, que les objectifs de latence sont modérés et que le devis du fournisseur est nettement plus bas.
Pour les équipes d’inférence IA, la question utile est :
Est-ce que H100 fournit suffisamment de sorties acceptées par heure pour compenser son surcoût par rapport à L40S pour ce modèle précis, ce mélange de prompts, cette pile de service et ce SLA ?
Cette comparaison NVIDIA L40S vs H100 se concentre sur l’économie de l’inférence : adéquation mémoire, préremplissage, décodage, batching, latence, utilisation et tarification cloud des GPU. Les prix évoluent souvent ; considérez donc les lignes de prix publiques ci-dessous comme des exemples vérifiés le 12 octobre 2026, puis recalculez la même feuille de calcul avec les devis actuels de votre fournisseur.
L40S vs H100 : tableau de décision rapide
| Charge d’inférence | Commencer généralement avec | Pourquoi |
|---|---|---|
| Chat 7B à 13B, copilotes internes, RAG léger | L40S | Un coût horaire plus faible peut surpasser H100 lorsque la latence est acceptable et que le modèle tient avec une marge pour le cache KV. |
| Modèles de classe 30B avec contexte modéré | Benchmark des deux | L40S peut l’emporter sur le coût ; H100 peut l’emporter lorsque la latence de queue ou la bande passante mémoire domine. |
| Service de classe 70B avec latence stricte | H100, H100 NVL, H200 ou multi-GPU | H100 offre une bande passante HBM bien plus élevée, davantage de mémoire sur les configurations SXM/NVL courantes, des options NVLink et une prise en charge plus robuste du service de production. |
| Inférence par lots avec SLA assoupli | L40S d’abord | Les charges tolérant les files d’attente peuvent utiliser une capacité moins coûteuse si l’utilisation reste élevée. |
| RAG à long contexte | H100 d’abord | Le préremplissage et la pression sur le cache KV récompensent généralement la bande passante HBM et une mémoire plus importante. |
| Infrastructure multi-locataire | H100 si MIG est important | NVIDIA indique la prise en charge de MIG sur H100 ; NVIDIA n’indique aucune prise en charge de MIG sur L40S. |
| Charges multimodales avec rendu, image/vidéo ou graphisme | L40S peut être attrayant | L40S est positionné par NVIDIA comme un GPU universel pour l’IA, le graphisme, le rendu et l’accélération média. |
| API LLM orientée client à forte concurrence | H100 d’abord | La latence de queue, la marge de batching et l’optimisation logicielle justifient souvent la prime. |
La règle pratique : choisissez L40S lorsque le plancher de coût compte et que la charge de travail s’adapte proprement. Choisissez H100 lorsque la latence, la bande passante, la concurrence, la simplicité de sharding ou la topologie multi-GPU affectent le revenu ou la fiabilité.
Principales différences de spécifications
NVIDIA positionne L40S comme un GPU de centre de données Ada Lovelace pour l’IA générative, l’inférence et l’entraînement des LLM, le graphisme 3D, le rendu et la vidéo. NVIDIA indique que L40S dispose de 48 Go de mémoire GDDR6 ECC, d’une bande passante mémoire de 864 Go/s, de PCIe Gen4 x16, d’une puissance maximale de 350 W, de Tensor Cores de quatrième génération, de la prise en charge FP8, de l’absence de MIG et de l’absence de prise en charge NVLink. NVIDIA positionne H100 comme un GPU de centre de données Hopper pour l’IA à grande échelle et le HPC, avec un Transformer Engine dédié, NVLink de quatrième génération, MIG et de la mémoire HBM. Les spécifications produit H100 de NVIDIA indiquent que H100 SXM dispose de 80 Go de mémoire, de 3,35 To/s de bande passante, jusqu’à 7 instances MIG, 900 Go/s NVLink et jusqu’à 700 W de TDP configurable ; H100 NVL est indiqué avec 94 Go par GPU, 3,9 To/s de bande passante et 600 Go/s NVLink. Sources : NVIDIA L40S et NVIDIA H100.
| Zone | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Implication pour l’acheteur |
|---|---|---|---|
| Architecture | Ada Lovelace | Hopper | H100 est la génération phare d’accélérateur IA/HPC ; L40S est un GPU de centre de données universel. |
| Mémoire | 48 Go GDDR6 ECC | 80 Go HBM sur H100 SXM ; 94 Go HBM sur H100 NVL | H100 offre plus d’espace pour des modèles plus grands, un contexte plus long et une concurrence plus élevée. |
| Bande passante mémoire | 864 Go/s | 3,35 To/s sur H100 SXM ; 3,9 To/s sur H100 NVL | H100 a un avantage important pour le préremplissage, le décodage et le mouvement du cache KV limités par la bande passante. |
| Pic Tensor Core FP8 avec sparsité | 1 466 TFLOPS | 3 958 TFLOPS sur H100 SXM ; 3 341 TFLOPS sur H100 NVL | H100 a un plafond bien plus élevé lorsque la pile de service et la politique de précision peuvent utiliser FP8. |
| Interconnexion | PCIe Gen4 x16 ; pas de NVLink | PCIe Gen5 plus NVLink sur les configurations SXM/NVL | H100 est plus fort pour le scale-up et l’inférence multi-GPU. |
| MIG | Non | Jusqu’à 7 instances MIG | H100 est meilleur lorsque vous avez besoin de partitionnement matériel pour l’utilisation ou l’isolation. |
| Puissance maximale | 350 W | Jusqu’à 700 W sur SXM ; 350-400 W sur NVL | L40S peut être plus facile à intégrer dans des serveurs à plus faible consommation ; H100 peut accomplir davantage de travail par GPU. |
Ces spécifications expliquent pourquoi un benchmark L40S vs H100 générique peut induire en erreur lors des achats. H100 a le plafond technique. L40S peut malgré tout l’emporter lorsque H100 coûte plusieurs fois plus cher et que l’application n’utilise pas tout ce plafond.
Formule de débit par dollar
Pour l’inférence, comparez la sortie acceptée, pas les FLOPS théoriques bruts :
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
Ensuite, incluez les coûts cachés :
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
La règle du seuil de rentabilité est simple :
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
Si l’H100 coûte 3x plus cher que le L40S, l’H100 doit fournir plus de 3x de sorties acceptées par heure pour l’emporter sur le débit par dollar, avant même de tenir compte de la valeur métier d’une latence plus faible. Si l’H100 coûte 1,8x plus cher, la barre est plus basse. Si le L40S provoque des reprises OOM, une faible taille de batch ou des p99 manquées, le tarif horaire le moins cher n’est pas le service le moins cher.
Pour une feuille de calcul plus large sur les coûts cachés, consultez le guide de Flatkey sur les prix de location des GPU.
Exemples de prix publics vérifiés le 12 octobre 2026
Les prix publics des GPU ne sont pas des grilles tarifaires permanentes. Ils varient selon le fournisseur, la région, la disponibilité, le niveau de sécurité, la réservation, l’unité de facturation et le fait que la capacité soit marketplace, dédiée, à la demande ou engagée.
| Page du fournisseur | Exemple L40S | Exemple H100 | Ce que cela montre |
|---|---|---|---|
| Tarifs RunPod | L40S : Community Cloud 0,79 $/h, Secure Cloud 1,09 $/h | H100 PCIe : Community Cloud 1,99 $/h, Secure Cloud 2,89 $/h ; H100 SXM : Community Cloud 2,69 $/h, Secure Cloud 3,49 $/h ; H100 NVL : Community Cloud 2,59 $/h, Secure Cloud 3,19 $/h | Les lignes de cotation directe peuvent faire en sorte que l’H100 coûte environ 2,5x à 3,4x le tarif horaire du L40S avant les coûts cachés. |
| Tarifs Lambda | Aucune ligne L40S directe trouvée dans le HTML de tarification public vérifié pour cet article | Les lignes H100 sont exposées dans les configurations en libre-service et en cluster, y compris des exemples H100 SXM et H100 PCIe | La couverture des fournisseurs diffère ; n’assumez pas que chaque GPU de la liste restreinte est disponible chez chaque vendeur. |
Avec les exemples RunPod Community Cloud, le seuil de rentabilité ressemble à ceci :
| Comparaison | Prix H100 | Prix L40S | Prime de prix H100 | Signification du seuil de rentabilité |
|---|---|---|---|---|
| H100 PCIe vs L40S | 1,99 $/h | 0,79 $/h | 2,52x | L’H100 PCIe doit fournir plus de 2,52x de sorties acceptées par heure pour l’emporter sur le simple loyer GPU. |
| H100 SXM vs L40S | 2,69 $/h | 0,79 $/h | 3,41x | L’H100 SXM a besoin d’un gain de débit important ou d’une raison liée à la latence / au business pour justifier la prime. |
| H100 NVL vs L40S | 2,59 $/h | 0,79 $/h | 3,28x | L’H100 NVL a besoin que son avantage en mémoire / interconnexion soit pertinent pour la charge de travail. |
| H100 SXM sécurisé vs L40S sécurisé | 3,49 $/h | 1,09 $/h | 3,20x | La capacité sécurisée modifie le tarif absolu, mais l’idée du seuil de rentabilité reste la même. |
N’utilisez pas ces lignes comme une vérité universelle. Utilisez-les pour comprendre les calculs : une décision sur les performances d’inférence NVIDIA L40S vs H100 change lorsque le devis change.
Où le L40S gagne
Le L40S mérite généralement la première place dans les benchmarks lorsque la charge de travail est sensible au coût et techniquement contenue :
- Le modèle est un 7B, 8B, 13B, ou un parcours quantifié de classe 30B qui tient dans 48 Go avec une marge pour le cache KV.
- Le trafic est orienté batch, asynchrone, interne, ou tolère une latence p95 plus élevée.
- Vous pouvez maintenir le L40S utilisé avec des files d’attente au lieu de surdimensionner pour une réponse instantanée.
- Vous avez besoin d’un GPU universel qui peut aussi gérer le rendu, les médias, la génération d’images ou des charges créatives mixtes.
- Votre devis fournisseur fait que l’H100 est 2,5x à 4x plus cher.
- Votre framework de service affiche une latence p95/p99 acceptable sur des prompts réalistes.
Le L40S est également attractif pour les équipes qui construisent leurs premiers produits d’inférence. Si le choix du modèle, la forme du prompt et le trafic changent encore, un GPU moins coûteux peut rendre l’expérimentation moins chère pendant que vous collectez de vraies données de demande.
Où l’H100 gagne
L’H100 mérite généralement la première place dans les benchmarks lorsque la latence, la concurrence, la bande passante mémoire ou le service de grands modèles déterminent la facture :
- Le RAG à long contexte sollicite le prefill et le mouvement du cache KV.
- La latence p95 ou p99 affecte la conversion, la rétention ou la charge du support.
- Le modèle est suffisamment grand pour que 48 Go sur le L40S imposent une quantification agressive, de petites tailles de batch ou du parallélisme tensoriel.
- Vous avez besoin de MIG pour l’isolation multi-tenant ou une utilisation plus élevée.
- Vous avez besoin de NVLink, NVSwitch ou d’une mise à l’échelle de type H100 NVL pour l’inférence de classe 70B.
- Votre pile peut exploiter FP8 ou des kernels optimisés Hopper sans régression de qualité.
- La réduction du nombre de GPU compense la prime horaire.
L’H100 ne concerne pas seulement la vitesse de pointe. Il peut aussi simplifier la production lorsqu’un seul H100 remplace plusieurs GPU de gamme inférieure, évite le découpage du modèle ou maintient la latence de queue dans le SLA.
Les détails de charge de travail qui changent le gagnant
L’erreur de comparaison de performances NVIDIA L40S vs H100 la plus courante consiste à tester une seule longueur de prompt et un seul niveau de concurrence. Le service de LLM présente des goulots d’étranglement différents :
| Dimension de la charge de travail | Pourquoi c’est important |
|---|---|
| Taille du modèle | Un modèle 7B et un modèle 70B ne sollicitent pas la mémoire, la bande passante ou l’interconnexion de la même manière. |
| Précision et quantification | FP8, FP16, BF16, INT8, AWQ, GPTQ et d’autres approches modifient à la fois la qualité et le débit. |
| Longueur du contexte | Les longues requêtes déplacent le coût vers le préremplissage et la pression sur le cache KV. |
| Longueur de sortie | Les réponses longues déplacent le coût vers le débit de décodage et l’ordonnancement. |
| Concurrence | Un GPU qui gagne à une taille de lot de 1 peut perdre sous un trafic réel. |
| Taux d’acceptation | Les sorties échouées, expirées ou de faible qualité ne comptent pas comme un débit productif. |
| Framework de service | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM et les serveurs personnalisés ont des voies d’optimisation différentes. |
| Forme du fournisseur | Le CPU, la RAM, le NVMe local, le réseau, le démarrage de l’image et le risque de voisin bruyant peuvent dominer une offre de GPU bon marché. |
Si vous choisissez en même temps une pile de service, le guide Flatkey sur vLLM vs SGLang propose un cadre distinct pour mesurer le débit, la latence, la prise en charge des modèles et l’exploitation.
Plan de benchmark pour l’inférence L40S vs H100
Exécutez la même relecture sur L40S et H100. Conservez des critères d’acceptation fixes.
| Étape | Ce qu’il faut mesurer | Pourquoi |
|---|---|---|
| 1. Geler la charge de travail | ID du modèle, quantification, distribution du contexte, plafond de sortie, contrôles de qualité | Empêche les faux résultats comparables. |
| 2. Geler la pile de service | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, pilote, image de conteneur | Les changements logiciels peuvent masquer les effets matériels. |
| 3. Exécuter une échelle de concurrence | 1, 4, 8, 16, 32, 64, ou votre schéma de trafic réel | Montre à quel moment chaque GPU sature. |
| 4. Séparer préremplissage et décodage | Temps jusqu’au premier jeton, jetons de requête/sec, jetons de sortie/sec | Révèle si la bande passante ou le décodage est le goulot d’étranglement. |
| 5. Suivre la latence de queue | p50, p95, p99, attente en file, taux de timeout | Les décisions d’achat doivent protéger l’expérience utilisateur. |
| 6. Suivre l’utilisation | Utilisation du GPU, mémoire utilisée, pression sur la bande passante HBM/GDDR, attente CPU, attente stockage | Confirme que le GPU est le véritable goulot d’étranglement. |
| 7. Compter les échecs | OOM, expulsions, mauvais hôtes, démarrages à froid, tempêtes de retry | Le travail échoué doit entrer dans le coût par sortie acceptée. |
| 8. Calculer le coût accepté | Coût par 1M de jetons de sortie acceptés, par réponse acceptée ou par tâche terminée | Les achats ont besoin d’un coût normalisé, pas de captures d’écran de benchmarks. |
Relecture minimale :
100 invites courtes
100 invites moyennes
100 invites à contexte long
même modèle
même politique de précision ou de quantification
même nombre maximal de jetons de sortie
même version du serveur
même échelle de concurrence
mêmes contrôles de qualité et d’acceptation
Tableau de décision :
| Métrique | Résultat L40S | Résultat H100 |
|---|---|---|
| Prix horaire du GPU | ||
| Coût horaire effectif | ||
| Réponses acceptées/heure | ||
| Jetons de sortie acceptés/heure | ||
| Coût par 1M de jetons de sortie acceptés | ||
| Temps jusqu’au premier jeton p95 | ||
| Latence de bout en bout p95/p99 | ||
| Taux d’OOM ou de retry | ||
| Utilisation moyenne du GPU | ||
| Notes opérationnelles |
C’est l’atout de valeur pour un vrai benchmark L40S vs H100 : le gagnant est le GPU avec le coût accepté le plus faible au niveau de latence et de fiabilité exigé par votre produit.
Liste de contrôle pour l’approvisionnement
Avant de louer ou d’acheter l’un de ces GPU, demandez :
- Référence SKU exacte : L40S, H100 PCIe, H100 SXM, H100 NVL, taille mémoire et format.
- Configuration du nœud : nombre de GPU, CPU, RAM, NVMe local, réseau, et savoir si les GPU partagent une interconnexion puissante.
- Unité de facturation : par seconde, minute, heure, mois ou engagement.
- Mode de capacité : place de marché, cloud sécurisé, dédié, réservé, spot ou cluster.
- Politique d’interruption et de remplacement.
- Région, conformité, tenancy et exigences de traitement des données.
- Prix du stockage et des snapshots.
- Politique de sortie et de bande passante.
- Prise en charge du pilote, de CUDA, du conteneur et du framework de service.
- Observabilité : utilisation, mémoire, file d’attente, p95/p99, OOM, retries et coût par route.
- SLA de support et processus d’escalade.
Pour une liste de contrôle plus large au niveau du cluster, consultez le guide Flatkey sur la location de clusters GPU.
Quand une API de modèle surpasse l’un ou l’autre GPU
La bonne réponse à L40S vs H100 peut aussi être « ni l’un ni l’autre ». Louer des GPU a du sens lorsque vous avez des poids propriétaires, une utilisation soutenue, un contrôle strict de la latence, des kernels personnalisés, des exigences de localisation des données ou une équipe prête à exploiter une infrastructure d’inférence.
Utilisez une API de modèle ou un routeur lorsque :
- Le trafic est intermittent.
- Le choix du modèle change souvent.
- Vous avez besoin d’une solution de secours entre fournisseurs.
- Vous n’avez pas besoin d’héberger des poids personnalisés.
- Le temps GPU inutilisé dépasserait toute prime d’API.
- La finance a besoin d’enregistrements d’utilisation au niveau des requêtes, de budgets par sous-clé, de factures et d’une attribution des coûts.
Flatkey convient à ce côté de la décision : une clé, un solde, une facture, des points de terminaison de modèles officiels et des enregistrements d’utilisation au niveau des requêtes sur plusieurs routes de modèles. Comparez le coût par jeton accepté d’un L40S ou d’un H100 dédiés à celui des routes de modèles gérées avant de vous engager sur une capacité GPU à long terme.
Pour des travaux de coût connexes, consultez les guides de Flatkey sur le meilleur GPU pour l’inférence LLM, H100 vs A100, H200 vs H100, comparaison des tarifs des modèles d’IA, et gestion des dépenses d’API IA.
Recommandation finale
Pour la plupart des développeurs indépendants et des petites équipes IA qui comparent L40S vs H100, commencez par cette règle :
- Choisissez L40S lorsque le modèle convient, que la latence est modérée, que le trafic peut être mis en file d’attente, et que le H100 coûte plus de 2 à 3 fois le tarif horaire.
- Choisissez H100 lorsque la bande passante mémoire, une mémoire plus grande, NVLink, MIG, une forte concurrence, un long contexte ou la latence p95/p99 détermine le résultat du produit.
- Benchmarkez les deux lorsque la charge de travail est de classe 30B, à contexte mixte, ou proche de la limite de mémoire de 48 Go.
- Comparez les deux à une API de modèle gérée lorsque l’utilisation est incertaine ou que le choix du modèle change fréquemment.
La décision la plus solide en matière de performance NVIDIA L40S vs H100 n’est pas un vainqueur générique de benchmark. C’est le GPU qui produit le coût le plus faible par sortie acceptée tout en respectant vos objectifs de latence et de fiabilité.
FAQ L40S vs H100
Le H100 est-il plus rapide que le L40S pour l’inférence IA ?
Oui, le H100 a un plafond technique bien plus élevé pour l’inférence IA, en particulier lorsque la bande passante mémoire, le débit FP8, une mémoire plus grande, NVLink et un service optimisé pour Hopper sont importants. Le L40S peut néanmoins l’emporter en débit par dollar lorsque la charge de travail convient et que la prime horaire du H100 est trop élevée.
Le L40S est-il adapté à l’inférence LLM ?
Oui. NVIDIA positionne le L40S pour l’IA générative et l’inférence/l’entraînement LLM, et indique 48 Go de mémoire GDDR6 ECC ainsi que des Tensor Cores de quatrième génération avec prise en charge FP8. Il est particulièrement performant pour les modèles petits et de taille moyenne, l’inférence par lots, les charges IA/graphique mixtes et le service sensible aux coûts.
Dois-je utiliser le L40S ou le H100 pour des modèles 70B ?
Commencez avec un H100, un H100 NVL, un H200 ou une configuration multi-GPU pour l’inférence de production de classe 70B, surtout avec un long contexte ou des objectifs de latence stricts. Le L40S peut fonctionner pour des expérimentations contraintes ou quantifiées, mais 48 Go de mémoire peuvent limiter la concurrence et la marge du cache KV.
Quelle est la meilleure métrique pour L40S vs H100 ?
Utilisez le coût par sortie acceptée à la latence cible. Suivez les jetons de sortie acceptés par heure, les réponses acceptées par heure, la latence p95/p99, le taux de nouvelle tentative, le taux d’OOM, l’utilisation et le coût horaire effectif.
Un benchmark L40S vs H100 suffit-il pour acheter de la capacité ?
Seulement si le benchmark reproduit votre mélange réel de prompts, les longueurs de contexte, les longueurs de sortie, la concurrence, les contrôles de qualité et l’environnement du fournisseur. Un résultat générique en jetons/s est utile, mais il ne constitue pas à lui seul une décision d’achat.


