
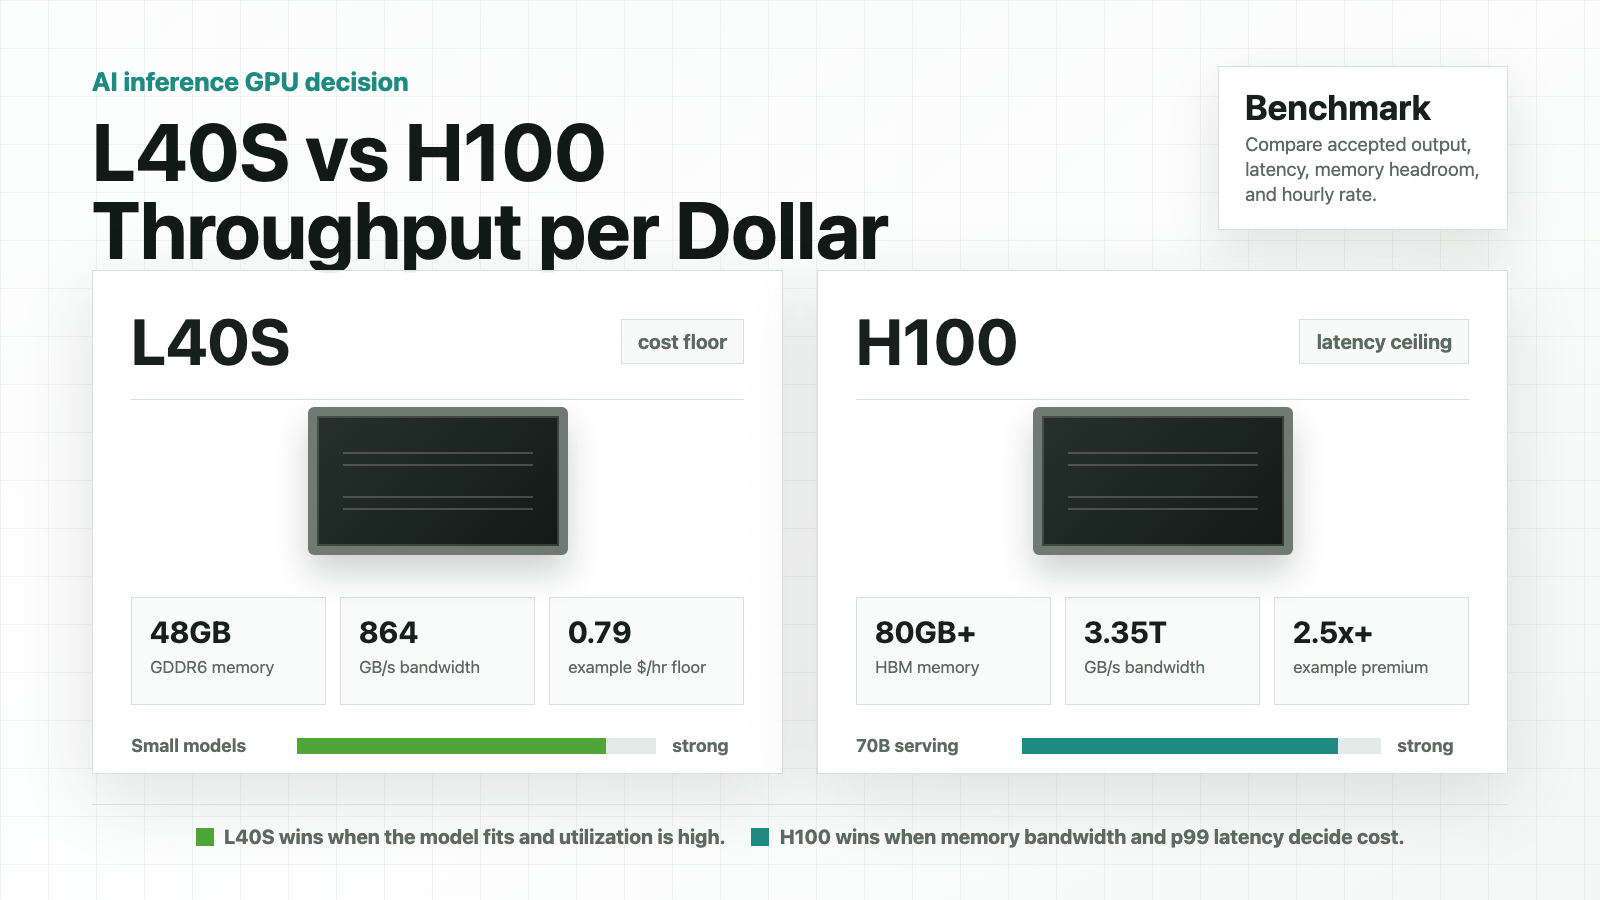
NVIDIA L40S vs H100 para Inferência de IA: Throughput por Dólar
A resposta curta para L40S vs H100 não é “H100 é mais rápido, então compre H100.” A H100 é o acelerador de IA mais শক্তo. A L40S costuma ser a melhor candidata em throughput por dólar quando o modelo cabe em 48 GB, os objetivos de latência são moderados e a cotação do provedor é muito mais baixa.
Para equipes de inferência de IA, a pergunta útil é:
A H100 entrega saída aceita suficiente por hora para compensar seu prêmio de preço sobre a L40S para este modelo exato, mix de prompts, stack de serving e SLA?
Esta comparação NVIDIA L40S vs H100 foca na economia da inferência: adequação de memória, prefill, decode, batching, latência, utilização e preços de GPU na nuvem. Os preços mudam com frequência, então trate as linhas públicas de preço abaixo como exemplos verificados em 12 de outubro de 2026 e, depois, refaça a mesma planilha com as cotações atuais do seu provedor.
L40S vs H100: tabela rápida de decisão
| Carga de trabalho de inferência | Normalmente comece com | Por quê |
|---|---|---|
| Chat 7B a 13B, copilots internos, RAG leve | L40S | Um custo horário menor pode superar a H100 quando a latência é aceitável e o modelo cabe com folga para o cache KV. |
| Modelos na classe de 30B com contexto moderado | Teste ambos | A L40S pode vencer em custo; a H100 pode vencer quando a latência na cauda ou a largura de banda de memória domina. |
| Serving de modelos na classe de 70B com latência rigorosa | H100, H100 NVL, H200 ou multi-GPU | A H100 tem largura de banda HBM muito maior, mais memória em configurações SXM/NVL comuns, opções NVLink e suporte mais forte para serving em produção. |
| Inferência em lote com SLA relaxado | L40S primeiro | Cargas de trabalho amigáveis a fila podem usar capacidade mais barata se a utilização permanecer alta. |
| RAG de contexto longo | H100 primeiro | Prefill e pressão de KV cache normalmente favorecem largura de banda HBM e mais memória. |
| Infraestrutura multi-tenant | H100 se MIG for importante | A NVIDIA lista suporte a MIG na H100; a NVIDIA não lista suporte a MIG na L40S. |
| Cargas multimodais com renderização, imagem/vídeo ou gráficos | A L40S pode ser आकर्षiva | A L40S é posicionada pela NVIDIA como uma GPU universal para IA, gráficos, renderização e aceleração de mídia. |
| API de LLM voltada ao cliente com alta concorrência | H100 primeiro | Latência na cauda, folga para batching e otimização de software muitas vezes justificam o prêmio. |
A regra prática: escolha a L40S quando o custo mínimo importa e a carga de trabalho se encaixa de forma limpa. Escolha a H100 quando latência, largura de banda, concorrência, simplicidade de sharding ou topologia multi-GPU afetam receita ou confiabilidade.
Principais diferenças de especificação
A NVIDIA posiciona a L40S como uma GPU de data center Ada Lovelace para IA generativa, inferência e treinamento de LLM, gráficos 3D, renderização e vídeo. A NVIDIA lista a L40S com 48 GB de memória GDDR6 ECC, 864 GB/s de largura de banda de memória, PCIe Gen4 x16, 350W de potência máxima, Tensor Cores de quarta geração, suporte a FP8, sem MIG e sem suporte a NVLink. A NVIDIA posiciona a H100 como uma GPU de data center Hopper para IA em larga escala e HPC, com Transformer Engine dedicado, NVLink de quarta geração, MIG e memória HBM. As especificações do produto H100 da NVIDIA listam a H100 SXM com 80 GB de memória, 3,35 TB/s de largura de banda, até 7 instâncias MIG, 900 GB/s de NVLink e até 700W de TDP configurável; a H100 NVL é listada com 94 GB por GPU, 3,9 TB/s de largura de banda e 600 GB/s de NVLink. Fontes: NVIDIA L40S e NVIDIA H100.
| Área | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Implicação para o comprador |
|---|---|---|---|
| Arquitetura | Ada Lovelace | Hopper | A H100 é a geração carro-chefe de aceleradores de IA/HPC; a L40S é uma GPU universal de data center. |
| Memória | 48 GB GDDR6 ECC | 80 GB HBM na H100 SXM; 94 GB HBM na H100 NVL | A H100 tem mais espaço para modelos maiores, contexto mais longo e maior concorrência. |
| Largura de banda de memória | 864 GB/s | 3,35 TB/s na H100 SXM; 3,9 TB/s na H100 NVL | A H100 tem uma grande vantagem para prefill, decode e movimentação de KV cache limitados por largura de banda. |
| Pico de Tensor Core FP8 com esparsidade | 1.466 TFLOPS | 3.958 TFLOPS na H100 SXM; 3.341 TFLOPS na H100 NVL | A H100 tem um teto muito mais alto quando a stack de serving e a política de precisão podem usar FP8. |
| Interconexão | PCIe Gen4 x16; sem NVLink | PCIe Gen5 mais NVLink nas configurações SXM/NVL | A H100 é mais forte para scale-up e inferência multi-GPU. |
| MIG | Não | Até 7 instâncias MIG | A H100 é melhor quando você precisa de particionamento por hardware para utilização ou isolamento. |
| Potência máxima | 350W | Até 700W na SXM; 350-400W na NVL | A L40S pode ser mais fácil de acomodar em servidores de menor potência; a H100 pode concluir mais trabalho por GPU. |
Essas especificações explicam por que um benchmark L40S vs H100 genérico pode induzir à compra errada. A H100 tem o teto técnico. A L40S ainda pode vencer quando a H100 custa várias vezes mais e a aplicação não usa o teto completo.
Fórmula de throughput por dólar
Para inferência, compare a saída aceita, não o FLOPS teórico bruto:
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
Então inclua o custo oculto:
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
A regra do ponto de equilíbrio é simples:
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
Se o H100 custa 3x mais que o L40S, o H100 precisa entregar mais de 3x de saída aceita por hora para vencer em throughput por dólar, antes de contar o valor de negócio de uma latência menor. Se o H100 custa 1,8x mais, a barreira é menor. Se o L40S causa retries por OOM, tamanho de lote baixo ou latência p99 perdida, o preço horário mais barato não é o serviço mais barato.
Para uma planilha mais ampla de custos ocultos, veja o guia da Flatkey sobre preços de aluguel de GPU.
Exemplos de preços públicos verificados em 12 de outubro de 2026
Os preços públicos de GPU não são tabelas de tarifas permanentes. Eles variam por provedor, região, disponibilidade, nível de segurança, reserva, unidade de cobrança e se a capacidade é marketplace, dedicada, sob demanda ou comprometida.
| Página do provedor | Exemplo de L40S | Exemplo de H100 | O que isso mostra |
|---|---|---|---|
| Preços da RunPod | L40S: Community Cloud US$ 0,79/h, Secure Cloud US$ 1,09/h | H100 PCIe: Community Cloud US$ 1,99/h, Secure Cloud US$ 2,89/h; H100 SXM: Community Cloud US$ 2,69/h, Secure Cloud US$ 3,49/h; H100 NVL: Community Cloud US$ 2,59/h, Secure Cloud US$ 3,19/h | Linhas de cotação direta podem fazer o H100 custar de cerca de 2,5x a 3,4x a taxa horária do L40S antes dos custos ocultos. |
| Preços da Lambda | Nenhuma linha direta de L40S foi encontrada no HTML de preços públicos verificado para este artigo | Linhas de H100 estão expostas em configurações self-serve e de cluster, incluindo exemplos de H100 SXM e H100 PCIe | A cobertura do provedor difere; não assuma que toda seleção curta de GPU está disponível de todo fornecedor. |
Com os exemplos do RunPod Community Cloud, o speedup de ponto de equilíbrio fica assim:
| Comparação | Preço do H100 | Preço do L40S | Prêmio de preço do H100 | Significado do ponto de equilíbrio |
|---|---|---|---|---|
| H100 PCIe vs L40S | US$ 1,99/h | US$ 0,79/h | 2,52x | O H100 PCIe precisa de mais de 2,52x de saída aceita por hora para vencer apenas no aluguel bruto da GPU. |
| H100 SXM vs L40S | US$ 2,69/h | US$ 0,79/h | 3,41x | O H100 SXM precisa de um grande ganho de throughput ou de um motivo de latência/negócio para justificar o prêmio. |
| H100 NVL vs L40S | US$ 2,59/h | US$ 0,79/h | 3,28x | O H100 NVL precisa que sua vantagem de memória/interconexão faça diferença na carga de trabalho. |
| H100 SXM Secure vs L40S Secure | US$ 3,49/h | US$ 1,09/h | 3,20x | A capacidade segura altera a taxa absoluta, mas a ideia de ponto de equilíbrio continua a mesma. |
Não use essas linhas como verdade universal. Use-as para entender a matemática: uma decisão de desempenho de inferência NVIDIA L40S vs H100 muda quando a cotação muda.
Onde o L40S vence
O L40S geralmente merece a primeira posição no benchmark quando a carga de trabalho é sensível a custo e tecnicamente contida:
- O modelo é 7B, 8B, 13B ou uma rota quantizada da classe 30B que cabe em 48 GB com folga para o KV-cache.
- O tráfego é orientado a lote, assíncrono, interno ou tolerante a latência p95 mais alta.
- Você consegue manter o L40S utilizado com filas em vez de superprovisionar para resposta instantânea.
- Você precisa de uma GPU universal que também possa lidar com renderização, mídia, geração de imagens ou cargas criativas mistas.
- Sua cotação do provedor torna o H100 de 2,5x a 4x mais caro.
- Seu framework de serving mostra latência p95/p99 aceitável em prompts realistas.
O L40S também é atraente para equipes que estão construindo produtos iniciais de inferência. Se a escolha do modelo, a forma do prompt e o tráfego ainda estão mudando, uma GPU de menor custo pode tornar a experimentação mais barata enquanto você coleta dados reais de demanda.
Onde o H100 vence
O H100 geralmente merece a primeira posição no benchmark quando latência, concorrência, largura de banda de memória ou serving de grandes modelos determina a conta:
- RAG de contexto longo estressa o prefill e o movimento do KV-cache.
- Latência p95 ou p99 afeta conversão, retenção ou carga de suporte.
- O modelo é grande o suficiente para que 48 GB no L40S forcem quantização agressiva, tamanhos de lote pequenos ou paralelismo de tensor.
- Você precisa de MIG para isolamento multi-tenant ou maior utilização.
- Você precisa de NVLink, NVSwitch ou escalabilidade no estilo H100 NVL para inferência da classe 70B.
- Sua stack consegue aproveitar FP8 ou kernels otimizados para Hopper sem regressão de qualidade.
- A redução na quantidade de GPUs compensa o prêmio por hora.
O H100 não é apenas sobre velocidade de pico. Ele também pode simplificar a produção quando um H100 substitui várias GPUs de menor porte, evita particionamento do modelo ou mantém a latência de cauda dentro do SLA.
Os detalhes da carga de trabalho que mudam o vencedor
O erro mais comum na comparação de desempenho NVIDIA L40S vs H100 é testar um comprimento de prompt e um nível de concorrência. O serving de LLM tem gargalos diferentes:
| Dimensão da carga de trabalho | Por que isso importa |
|---|---|
| Tamanho do modelo | Um modelo de 7B e um modelo de 70B não exigem memória, largura de banda ou interconexão da mesma forma. |
| Precisão e quantização | FP8, FP16, BF16, INT8, AWQ, GPTQ e outros caminhos alteram tanto a qualidade quanto a taxa de processamento. |
| Comprimento do contexto | Prompts longos deslocam o custo para o prefill e a pressão sobre o KV-cache. |
| Comprimento da saída | Respostas longas deslocam o custo para a taxa de processamento do decode e o agendamento. |
| Concorrência | Uma GPU que vence em batch size 1 pode perder sob tráfego real. |
| Taxa de aceitação | Saídas com falha, com timeout ou de baixa qualidade não contam como throughput produtivo. |
| Framework de serving | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM e servidores personalizados têm caminhos de otimização diferentes. |
| Forma do provedor | CPU, RAM, NVMe local, rede, inicialização da imagem e risco de vizinho barulhento podem dominar uma listagem barata de GPU. |
Se você estiver escolhendo uma stack de serving ao mesmo tempo, o guia da Flatkey sobre vLLM vs SGLang oferece um framework separado para medir throughput, latência, suporte a modelos e operações.
Plano de benchmark para inferência em L40S vs H100
Execute a mesma reprodução no L40S e no H100. Mantenha os critérios de aceitação fixos.
| Etapa | O que medir | Por que |
|---|---|---|
| 1. Congele a carga de trabalho | ID do modelo, quantização, distribuição de contexto, limite de saída, verificações de qualidade | Evita resultados falsos de comparação direta. |
| 2. Congele a stack de serving | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, driver, imagem de contêiner | Alterações de software podem mascarar efeitos de hardware. |
| 3. Execute uma escada de concorrência | 1, 4, 8, 16, 32, 64, ou seu padrão real de tráfego | Mostra quando cada GPU satura. |
| 4. Separe prefill e decode | Tempo até o primeiro token, tokens de prompt/seg, tokens de saída/seg | Revela se a largura de banda ou o decode é o gargalo. |
| 5. Acompanhe a latência de cauda | p50, p95, p99, tempo de espera na fila, taxa de timeout | As decisões de compra devem proteger a experiência do usuário. |
| 6. Acompanhe a utilização | Utilização da GPU, memória usada, pressão de largura de banda HBM/GDDR, espera da CPU, espera de armazenamento | Confirma que a GPU é o verdadeiro gargalo. |
| 7. Conte falhas | OOM, evictions, hosts ruins, cold starts, storms de retry | Trabalho com falha pertence ao custo por saída aceita. |
| 8. Calcule o custo aceito | Custo por 1M tokens de saída aceitos, por resposta aceita ou por tarefa concluída | Compras precisam de custo normalizado, não de capturas de tela de benchmark. |
Reprodução mínima:
100 prompts curtos
100 prompts médios
100 prompts de contexto longo
mesmo modelo
mesma política de precisão ou quantização
mesmo número máximo de tokens de saída
mesma versão do servidor
mesma escada de concorrência
mesmas verificações de qualidade e aceitação
Tabela de decisão:
| Métrica | Resultado do L40S | Resultado do H100 |
|---|---|---|
| Preço horário da GPU | ||
| Custo horário efetivo | ||
| Respostas aceitas/hora | ||
| Tokens de saída aceitos/hora | ||
| Custo por 1M tokens de saída aceitos | ||
| Tempo até o primeiro token p95 | ||
| Latência ponta a ponta p95/p99 | ||
| Taxa de OOM ou retry | ||
| Utilização média da GPU | ||
| Notas operacionais |
Este é o ativo de valor para um benchmark L40S vs H100 real: o vencedor é a GPU com o menor custo aceito no nível de latência e confiabilidade que seu produto exige.
Checklist de aquisição
Antes de alugar ou comprar qualquer uma das GPUs, peça:
- SKU exato: L40S, H100 PCIe, H100 SXM, H100 NVL, tamanho de memória e formato.
- Formato do nó: quantidade de GPUs, CPU, RAM, NVMe local, rede e se as GPUs compartilham uma interconexão forte.
- Unidade de cobrança: por segundo, minuto, hora, mês ou contrato comprometido.
- Modo de capacidade: marketplace, cloud segura, dedicado, reservado, spot ou cluster.
- Política de interrupção e substituição.
- Região, conformidade, tenancy e requisitos de tratamento de dados.
- Preços de armazenamento e snapshot.
- Política de egress e largura de banda.
- Suporte para driver, CUDA, contêiner e framework de serving.
- Observabilidade: utilização, memória, enfileiramento, p95/p99, OOMs, retries e custo por rota.
- SLA de suporte e caminho de escalonamento.
Para um checklist mais amplo em nível de cluster, veja o guia da Flatkey sobre aluguel de cluster GPU.
Quando uma API de modelo supera qualquer uma das GPUs
A resposta certa para L40S vs H100 também pode ser "nenhuma das duas". Alugar GPUs faz sentido quando você tem pesos proprietários, utilização sustentada, controle rigoroso de latência, kernels personalizados, requisitos de localidade de dados ou uma equipe pronta para operar infraestrutura de inferência.
Use uma API de modelo ou um roteador quando:
- O tráfego é irregular.
- A escolha do modelo muda com frequência.
- Você precisa de fallback entre provedores.
- Você não precisa hospedar pesos personalizados.
- O tempo ocioso da GPU excederia qualquer prêmio da API.
- O financeiro precisa de registros de uso no nível da requisição, orçamentos por subchave, faturas e atribuição de custos.
A Flatkey se encaixa nesse lado da decisão: uma chave, um saldo, uma fatura, endpoints oficiais de modelos e registros de uso no nível da requisição em rotas de modelos. Compare o custo dedicado do L40S ou H100 por token aceito contra rotas de modelos gerenciadas antes de se comprometer com capacidade de GPU de longo prazo.
Para trabalhos relacionados de custo, consulte os guias da Flatkey para o melhor GPU para inferência de LLM, H100 vs A100, H200 vs H100, comparação de preços de modelos de IA e gestão de gastos com API de IA.
Recomendação final
Para a maioria dos desenvolvedores independentes e pequenas equipes de IA que comparam L40S vs H100, comece com esta regra:
- Escolha L40S quando o modelo couber, a latência for moderada, o tráfego puder enfileirar e o H100 custar mais de 2x a 3x o preço por hora.
- Escolha H100 quando largura de banda de memória, memória maior, NVLink, MIG, alta concorrência, contexto longo ou latência p95/p99 determinarem o resultado do produto.
- Faça benchmark de ambos quando a carga de trabalho for da classe 30B, de contexto misto ou próxima do limite de memória de 48 GB.
- Compare ambos com uma API de modelo gerenciada quando a utilização for incerta ou a escolha do modelo mudar com frequência.
A decisão mais forte de desempenho do NVIDIA L40S vs H100 não é um vencedor genérico de benchmark. É a GPU que produz o menor custo por saída aceita ao atender ao seu alvo de latência e confiabilidade.
FAQ L40S vs H100
O H100 é mais rápido que o L40S para inferência de IA?
Sim, o H100 tem um teto técnico muito mais alto para inferência de IA, especialmente quando largura de banda de memória, throughput FP8, memória maior, NVLink e serving otimizado para Hopper são importantes. O L40S ainda pode vencer em throughput por dólar quando a carga de trabalho se encaixa e o prêmio por hora do H100 é alto demais.
O L40S é bom para inferência de LLM?
Sim. A NVIDIA posiciona o L40S para IA generativa e inferência/treinamento de LLM, e lista 48 GB de memória GDDR6 ECC além de Tensor Cores de quarta geração com suporte a FP8. Ele é mais forte para modelos menores e de médio porte, inferência em lote, cargas de trabalho mistas de IA/gráficos e serving sensível a custos.
Devo usar L40S ou H100 para modelos de 70B?
Comece com H100, H100 NVL, H200 ou uma configuração multi-GPU para inferência de produção na classe 70B, especialmente com contexto longo ou metas rígidas de latência. O L40S pode funcionar para experimentos restritos ou quantizados, mas 48 GB de memória podem limitar a concorrência e a margem do KV-cache.
Qual é a melhor métrica para L40S vs H100?
Use custo por saída aceita na latência-alvo. Acompanhe tokens de saída aceitos por hora, respostas aceitas por hora, latência p95/p99, taxa de retentativa, taxa de OOM, utilização e custo horário efetivo.
Um benchmark de L40S vs H100 é suficiente para comprar capacidade?
Só se o benchmark reproduzir sua mistura real de prompts, comprimentos de contexto, comprimentos de saída, concorrência, verificações de qualidade e ambiente do provedor. Um resultado genérico de tokens/s é útil, mas não é, por si só, uma decisão de compra.


