
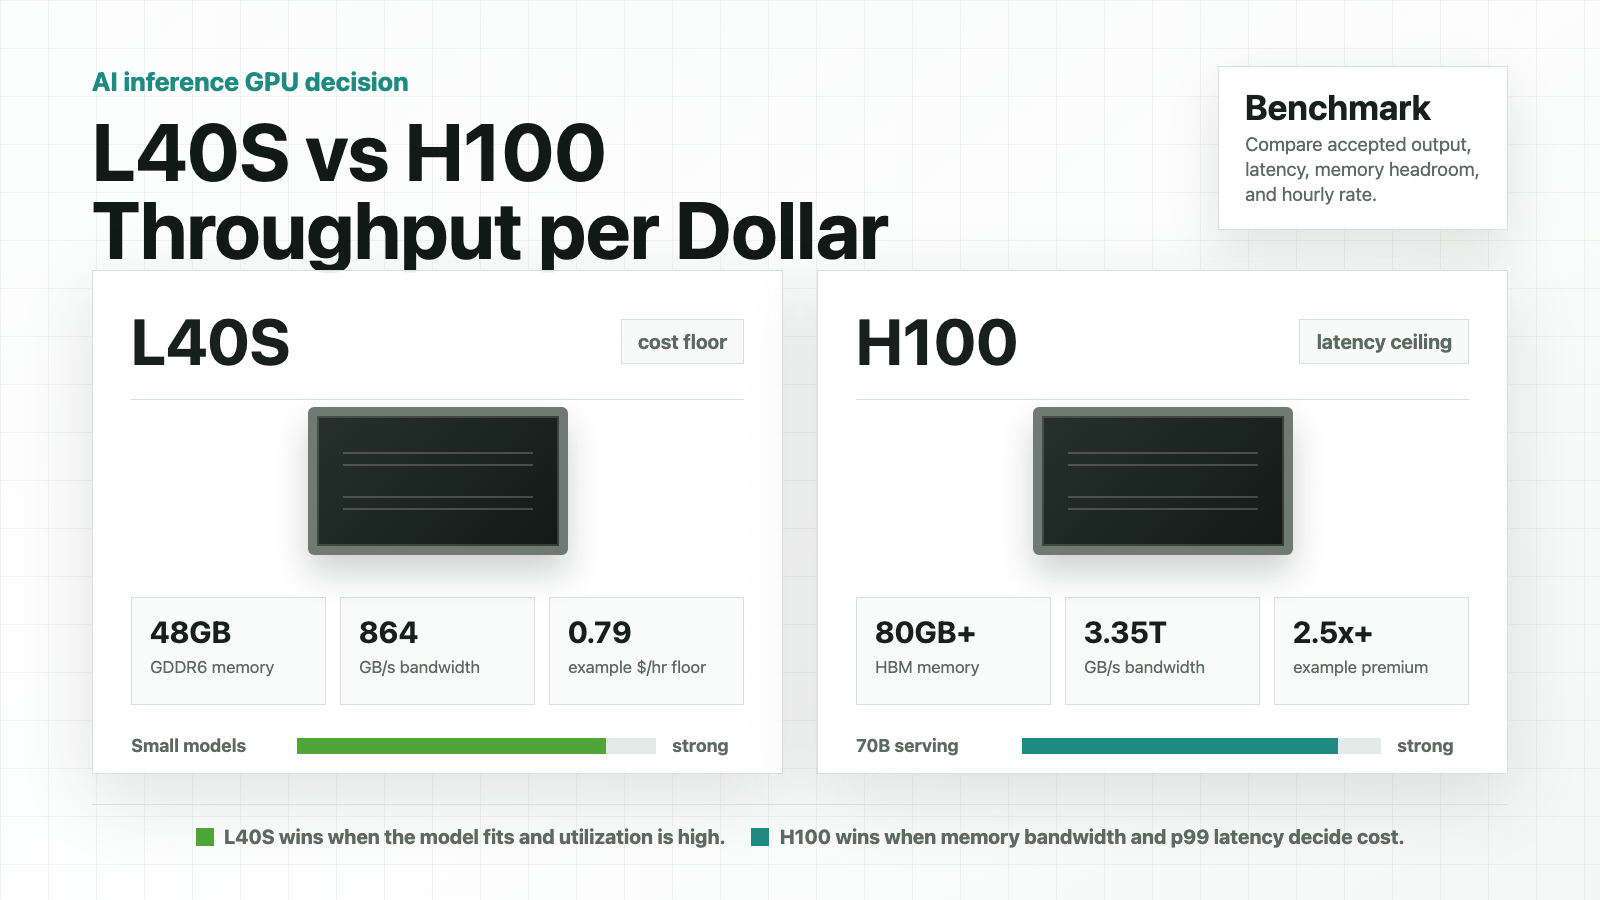
NVIDIA L40S vs H100 cho AI Inference: Thông lượng trên mỗi đô la
Câu trả lời ngắn cho L40S vs H100 không phải là "H100 nhanh hơn, nên mua H100." H100 là bộ tăng tốc AI mạnh hơn. L40S thường là lựa chọn tốt hơn về thông lượng trên mỗi đô la khi mô hình vừa trong 48 GB, mục tiêu độ trễ ở mức vừa phải, và báo giá của nhà cung cấp thấp hơn đáng kể.
Đối với các nhóm AI inference, câu hỏi hữu ích là:
H100 có tạo ra đủ đầu ra được chấp nhận mỗi giờ để bù cho mức chênh giá so với L40S cho đúng mô hình này, phối hợp prompt này, serving stack này, và SLA này không?
Phần so sánh NVIDIA L40S vs H100 này tập trung vào kinh tế inference: mức phù hợp bộ nhớ, prefill, decode, batching, độ trễ, mức sử dụng, và giá GPU trên cloud. Giá thay đổi thường xuyên, vì vậy hãy xem các hàng giá công khai bên dưới như ví dụ được kiểm tra vào ngày 12 tháng 10, 2026, rồi chạy lại cùng bảng tính đó với báo giá hiện tại của nhà cung cấp.
L40S vs H100: bảng quyết định nhanh
| Inference workload | Thường bắt đầu với | Tại sao |
|---|---|---|
| chat 7B đến 13B, copilots nội bộ, RAG nhẹ | L40S | Chi phí theo giờ thấp hơn có thể vượt H100 khi độ trễ chấp nhận được và mô hình vừa với phần dư cho KV cache. |
| mô hình cỡ 30B với ngữ cảnh vừa phải | Benchmark cả hai | L40S có thể thắng về chi phí; H100 có thể thắng khi tail latency hoặc băng thông bộ nhớ chi phối. |
| phục vụ cỡ 70B với độ trễ nghiêm ngặt | H100, H100 NVL, H200, hoặc multi-GPU | H100 có băng thông HBM cao hơn nhiều, bộ nhớ lớn hơn trên các cấu hình SXM/NVL phổ biến, tùy chọn NVLink, và hỗ trợ phục vụ production mạnh hơn. |
| batch inference với SLA thoải mái hơn | L40S trước | Khối lượng công việc thân thiện với hàng đợi có thể dùng năng lực rẻ hơn nếu mức sử dụng duy trì cao. |
| long-context RAG | H100 trước | Prefill và áp lực KV-cache thường được hưởng lợi từ băng thông HBM và bộ nhớ lớn hơn. |
| hạ tầng multi-tenant | H100 nếu MIG quan trọng | NVIDIA liệt kê hỗ trợ MIG trên H100; NVIDIA không liệt kê hỗ trợ MIG trên L40S. |
| workload đa phương thức với rendering, image/video, hoặc graphics | L40S có thể hấp dẫn | NVIDIA định vị L40S là GPU đa dụng cho AI, graphics, rendering, và tăng tốc media. |
| LLM API hướng tới khách hàng với độ đồng thời cao | H100 trước | Tail latency, dư địa batching, và tối ưu hóa phần mềm thường đủ để biện minh cho mức giá cao hơn. |
Quy tắc thực tế: chọn L40S khi mức sàn chi phí là quan trọng và workload vừa khớp gọn. Chọn H100 khi độ trễ, băng thông, đồng thời, sự đơn giản của sharding, hoặc topology multi-GPU ảnh hưởng đến doanh thu hay độ tin cậy.
Các khác biệt chính về thông số
NVIDIA định vị L40S là GPU data center Ada Lovelace cho generative AI, suy luận và huấn luyện LLM, đồ họa 3D, rendering, và video. NVIDIA liệt kê L40S với 48 GB bộ nhớ GDDR6 ECC, băng thông bộ nhớ 864 GB/s, PCIe Gen4 x16, công suất tối đa 350W, Tensor Cores thế hệ thứ tư, hỗ trợ FP8, không có MIG, và không hỗ trợ NVLink. NVIDIA định vị H100 là GPU data center Hopper cho AI quy mô lớn và HPC, với Transformer Engine chuyên dụng, NVLink thế hệ thứ tư, MIG, và bộ nhớ HBM. Thông số sản phẩm H100 của NVIDIA liệt kê H100 SXM với bộ nhớ 80 GB, băng thông 3,35 TB/s, tối đa 7 phiên bản MIG, NVLink 900 GB/s, và TDP cấu hình tối đa 700W; H100 NVL được liệt kê với 94 GB mỗi GPU, băng thông 3,9 TB/s, và NVLink 600 GB/s. Nguồn: NVIDIA L40S và NVIDIA H100.
| Hạng mục | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Hàm ý cho người mua |
|---|---|---|---|
| Kiến trúc | Ada Lovelace | Hopper | H100 là thế hệ accelerator AI/HPC hàng đầu; L40S là GPU data center đa dụng. |
| Bộ nhớ | 48 GB GDDR6 ECC | 80 GB HBM trên H100 SXM; 94 GB HBM trên H100 NVL | H100 có nhiều chỗ hơn cho mô hình lớn hơn, ngữ cảnh dài hơn, và độ đồng thời cao hơn. |
| Băng thông bộ nhớ | 864 GB/s | 3,35 TB/s trên H100 SXM; 3,9 TB/s trên H100 NVL | H100 có lợi thế lớn cho prefill, decode, và di chuyển KV-cache bị giới hạn bởi băng thông. |
| Đỉnh Tensor Core FP8 với sparsity | 1.466 TFLOPS | 3.958 TFLOPS trên H100 SXM; 3.341 TFLOPS trên H100 NVL | H100 có trần hiệu năng cao hơn nhiều khi serving stack và chính sách độ chính xác có thể dùng FP8. |
| Kết nối liên GPU | PCIe Gen4 x16; không có NVLink | PCIe Gen5 cộng NVLink trên cấu hình SXM/NVL | H100 mạnh hơn cho scale-up và inference multi-GPU. |
| MIG | Không | Tối đa 7 phiên bản MIG | H100 tốt hơn khi bạn cần phân vùng phần cứng cho mức sử dụng hoặc cô lập. |
| Công suất tối đa | 350W | Tối đa 700W trên SXM; 350-400W trên NVL | L40S có thể dễ bố trí hơn trong các server công suất thấp; H100 có thể hoàn thành nhiều việc hơn trên mỗi GPU. |
Các thông số này giải thích vì sao một L40S vs H100 benchmark chung chung có thể gây hiểu lầm cho việc mua sắm. H100 có trần kỹ thuật cao hơn. L40S vẫn có thể thắng khi H100 bị định giá cao hơn nhiều lần và ứng dụng không tận dụng hết trần đó.
Công thức thông lượng trên mỗi đô la
Đối với inference, hãy so sánh đầu ra được chấp nhận, không phải FLOPS lý thuyết thô:
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
Sau đó bao gồm chi phí ẩn:
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
Quy tắc hòa vốn rất đơn giản:
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
Nếu H100 đắt gấp 3 lần L40S, H100 phải tạo ra nhiều hơn 3 lần output được chấp nhận mỗi giờ thì mới thắng về thông lượng trên mỗi đô la, trước khi tính đến giá trị kinh doanh từ độ trễ thấp hơn. Nếu H100 đắt gấp 1,8 lần, ngưỡng này thấp hơn. Nếu L40S gây ra retry do OOM, batch size nhỏ, hoặc bỏ lỡ độ trễ p99, thì giá theo giờ rẻ hơn chưa chắc đã là dịch vụ rẻ hơn.
Để xem một bảng tính chi phí ẩn rộng hơn, hãy xem hướng dẫn của Flatkey về giá thuê GPU.
Ví dụ giá công khai được kiểm tra vào ngày 12 tháng 10 năm 2026
Giá GPU công khai không phải là bảng giá cố định. Chúng thay đổi theo nhà cung cấp, khu vực, tình trạng sẵn có, cấp bảo mật, đặt trước, đơn vị tính cước và việc dung lượng là marketplace, dedicated, on-demand hay committed.
| Trang nhà cung cấp | Ví dụ L40S | Ví dụ H100 | Điều này cho thấy |
|---|---|---|---|
| Bảng giá RunPod | L40S: Community Cloud $0.79/hr, Secure Cloud $1.09/hr | H100 PCIe: Community Cloud $1.99/hr, Secure Cloud $2.89/hr; H100 SXM: Community Cloud $2.69/hr, Secure Cloud $3.49/hr; H100 NVL: Community Cloud $2.59/hr, Secure Cloud $3.19/hr | Các dòng báo giá trực tiếp có thể khiến H100 đắt hơn L40S khoảng 2,5x đến 3,4x theo giá theo giờ trước khi tính chi phí ẩn. |
| Bảng giá Lambda | Không tìm thấy dòng L40S trực tiếp trong HTML bảng giá công khai được kiểm tra cho bài viết này | Các dòng H100 được hiển thị trên các cấu hình tự phục vụ và cluster, bao gồm các ví dụ H100 SXM và H100 PCIe | Phạm vi hỗ trợ của từng nhà cung cấp khác nhau; đừng giả định mọi GPU trong danh sách rút gọn đều có ở mọi vendor. |
Với các ví dụ RunPod Community Cloud, ngưỡng hòa vốn trông như sau:
| So sánh | Giá H100 | Giá L40S | Phần trăm chênh lệch giá H100 | Ý nghĩa hòa vốn |
|---|---|---|---|---|
| H100 PCIe so với L40S | $1.99/hr | $0.79/hr | 2.52x | H100 PCIe cần nhiều hơn 2,52x output được chấp nhận mỗi giờ để thắng về chi phí thuê GPU thô. |
| H100 SXM so với L40S | $2.69/hr | $0.79/hr | 3.41x | H100 SXM cần mức tăng thông lượng lớn hoặc lý do về độ trễ/kinh doanh để biện minh cho mức giá cao hơn. |
| H100 NVL so với L40S | $2.59/hr | $0.79/hr | 3.28x | H100 NVL cần lợi thế về bộ nhớ/liên kết nội bộ để tạo khác biệt trong workload. |
| Secure H100 SXM so với Secure L40S | $3.49/hr | $1.09/hr | 3.20x | Năng lực bảo mật làm thay đổi mức giá tuyệt đối, nhưng ý tưởng hòa vốn vẫn như cũ. |
Đừng coi các dòng này là chân lý phổ quát. Hãy dùng chúng để hiểu phép tính: quyết định về hiệu năng suy luận NVIDIA L40S so với H100 sẽ thay đổi khi báo giá thay đổi.
Trường hợp L40S thắng
L40S thường xứng đáng là lựa chọn benchmark đầu tiên khi workload nhạy về chi phí và được kiểm soát tốt về mặt kỹ thuật:
- Mô hình là 7B, 8B, 13B, hoặc một luồng 30B đã lượng tử hóa phù hợp với 48 GB cùng dung lượng dự phòng cho KV-cache.
- Lưu lượng mang tính batch, bất đồng bộ, nội bộ, hoặc chấp nhận độ trễ p95 cao hơn.
- Bạn có thể giữ cho L40S được sử dụng hiệu quả bằng hàng đợi thay vì overprovision để phản hồi tức thì.
- Bạn cần một GPU đa dụng cũng có thể xử lý rendering, media, tạo ảnh, hoặc các workload sáng tạo pha trộn.
- Báo giá từ nhà cung cấp của bạn khiến H100 đắt hơn từ 2,5x đến 4x.
- Khung phục vụ của bạn cho thấy độ trễ p95/p99 chấp nhận được trên các prompt thực tế.
L40S cũng hấp dẫn với các đội đang xây dựng sản phẩm suy luận ở giai đoạn đầu. Nếu lựa chọn mô hình, hình dạng prompt và lưu lượng vẫn còn thay đổi, một GPU chi phí thấp hơn có thể giúp việc thử nghiệm rẻ hơn trong khi bạn thu thập dữ liệu nhu cầu thực tế.
Trường hợp H100 thắng
H100 thường xứng đáng là lựa chọn benchmark đầu tiên khi độ trễ, concurrency, băng thông bộ nhớ, hoặc phục vụ mô hình lớn là yếu tố quyết định chi phí:
- RAG với ngữ cảnh dài gây áp lực lên prefill và di chuyển KV-cache.
- Độ trễ p95 hoặc p99 ảnh hưởng đến chuyển đổi, giữ chân, hoặc khối lượng hỗ trợ.
- Mô hình đủ lớn khiến 48 GB trên L40S buộc phải lượng tử hóa mạnh, batch size nhỏ, hoặc tensor parallelism.
- Bạn cần MIG cho cô lập đa tenant hoặc mức sử dụng cao hơn.
- Bạn cần NVLink, NVSwitch, hoặc khả năng mở rộng kiểu H100 NVL cho suy luận lớp 70B.
- Stack của bạn có thể tận dụng FP8 hoặc các kernel tối ưu cho Hopper mà không làm giảm chất lượng.
- Giảm số lượng GPU bù lại mức phí theo giờ cao hơn.
H100 không chỉ là về tốc độ đỉnh. Nó cũng có thể đơn giản hóa production khi một H100 thay thế nhiều GPU cấp thấp hơn, tránh phải shard mô hình, hoặc giữ độ trễ đuôi trong SLA.
Các chi tiết workload làm thay đổi bên thắng cuộc
Sai lầm phổ biến nhất khi so sánh NVIDIA L40S với H100 về hiệu năng là chỉ test một độ dài prompt và một mức concurrency. Phục vụ LLM có nhiều nút thắt khác nhau:
| Kích thước khối lượng công việc | Vì sao điều này quan trọng |
|---|---|
| Kích thước mô hình | Một mô hình 7B và một mô hình 70B không gây áp lực lên bộ nhớ, băng thông hay interconnect theo cùng một cách. |
| Độ chính xác và lượng tử hóa | FP8, FP16, BF16, INT8, AWQ, GPTQ và các đường đi khác làm thay đổi cả chất lượng lẫn thông lượng. |
| Độ dài ngữ cảnh | Các prompt dài chuyển chi phí sang prefill và áp lực lên KV-cache. |
| Độ dài đầu ra | Các câu trả lời dài chuyển chi phí sang thông lượng decode và lập lịch. |
| Đồng thời | Một GPU thắng ở batch size 1 có thể thua dưới lưu lượng thực tế. |
| Tỷ lệ chấp nhận | Các đầu ra thất bại, quá thời gian hoặc chất lượng thấp không được tính là thông lượng hữu ích. |
| Khung phục vụ | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM và các server tùy chỉnh có những đường tối ưu hóa khác nhau. |
| Hình dạng nhà cung cấp | CPU, RAM, NVMe cục bộ, mạng, thời gian khởi động image và rủi ro hàng xóm ồn ào có thể lấn át một danh sách GPU rẻ. |
Nếu bạn đang chọn một stack phục vụ cùng lúc, hướng dẫn vLLM vs SGLang của Flatkey cung cấp một khung riêng để đo thông lượng, độ trễ, hỗ trợ mô hình và vận hành.
Kế hoạch benchmark cho suy luận L40S vs H100
Chạy cùng một bản replay trên L40S và H100. Giữ nguyên các tiêu chí chấp nhận.
| Bước | Đo cái gì | Vì sao |
|---|---|---|
| 1. Cố định khối lượng công việc | ID mô hình, lượng tử hóa, phân phối ngữ cảnh, giới hạn đầu ra, kiểm tra chất lượng | Ngăn kết quả giả kiểu so sánh táo với táo. |
| 2. Cố định stack phục vụ | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, driver, image container | Các thay đổi phần mềm có thể che khuất tác động phần cứng. |
| 3. Chạy một thang đồng thời | 1, 4, 8, 16, 32, 64, hoặc mẫu lưu lượng thực tế của bạn | Cho thấy mỗi GPU bão hòa khi nào. |
| 4. Tách prefill và decode | Thời gian tới token đầu tiên, prompt tokens/sec, output tokens/sec | Cho thấy nút thắt là băng thông hay decode. |
| 5. Theo dõi độ trễ đuôi | p50, p95, p99, thời gian chờ hàng đợi, tỷ lệ timeout | Quyết định mua hàng nên bảo vệ trải nghiệm người dùng. |
| 6. Theo dõi mức sử dụng | Mức sử dụng GPU, bộ nhớ đã dùng, áp lực băng thông HBM/GDDR, CPU chờ, lưu trữ chờ | Xác nhận GPU là nút thắt thực sự. |
| 7. Đếm lỗi | OOM, eviction, host lỗi, cold start, retry storm | Công việc thất bại phải được tính trong chi phí trên mỗi đầu ra được chấp nhận. |
| 8. Tính chi phí đã chấp nhận | Chi phí trên mỗi 1M token đầu ra được chấp nhận, mỗi phản hồi được chấp nhận, hoặc mỗi job hoàn tất | Mua sắm cần chi phí đã chuẩn hóa, không phải ảnh chụp màn hình benchmark. |
Bản replay tối thiểu:
100 prompt ngắn
100 prompt trung bình
100 prompt ngữ cảnh dài
cùng mô hình
cùng chính sách độ chính xác hoặc lượng tử hóa
cùng số token đầu ra tối đa
cùng phiên bản server
cùng thang đồng thời
cùng kiểm tra chất lượng và chấp nhận
Bảng quyết định:
| Chỉ số | Kết quả L40S | Kết quả H100 |
|---|---|---|
| Giá GPU theo giờ | ||
| Chi phí hiệu dụng theo giờ | ||
| Phản hồi được chấp nhận/giờ | ||
| Token đầu ra được chấp nhận/giờ | ||
| Chi phí trên mỗi 1M token đầu ra được chấp nhận | ||
| Thời gian tới token đầu tiên p95 | ||
| Độ trễ đầu-cuối p95/p99 | ||
| Tỷ lệ OOM hoặc retry | ||
| Mức sử dụng GPU trung bình | ||
| Ghi chú vận hành |
Đây là tài sản giá trị cho một benchmark L40S vs H100 thực sự: bên thắng là GPU có chi phí được chấp nhận thấp hơn ở mức độ độ trễ và độ tin cậy mà sản phẩm của bạn yêu cầu.
Danh sách kiểm tra mua sắm
Trước khi thuê hoặc mua bất kỳ GPU nào, hãy yêu cầu:
- SKU chính xác: L40S, H100 PCIe, H100 SXM, H100 NVL, dung lượng bộ nhớ và form factor.
- Dạng node: số lượng GPU, CPU, RAM, NVMe cục bộ, mạng, và liệu các GPU có chia sẻ interconnect mạnh hay không.
- Đơn vị tính phí: theo giây, phút, giờ, tháng hoặc theo kỳ cam kết.
- Chế độ dung lượng: marketplace, cloud an toàn, dedicated, reserved, spot hoặc cluster.
- Chính sách gián đoạn và thay thế.
- Khu vực, tuân thủ, tenancy và yêu cầu xử lý dữ liệu.
- Giá lưu trữ và snapshot.
- Chính sách egress và băng thông.
- Hỗ trợ driver, CUDA, container và khung phục vụ.
- Quan sát được: mức sử dụng, bộ nhớ, xếp hàng, p95/p99, OOM, retry và chi phí theo từng route.
- SLA hỗ trợ và đường leo thang.
Để có danh sách kiểm tra ở cấp cluster rộng hơn, xem hướng dẫn thuê GPU cluster của Flatkey.
Khi API mô hình tốt hơn cả hai GPU
Câu trả lời đúng cho L40S vs H100 cũng có thể là "không cái nào." Thuê GPU hợp lý khi bạn có trọng số độc quyền, mức sử dụng duy trì cao, kiểm soát độ trễ nghiêm ngặt, kernel tùy chỉnh, yêu cầu dữ liệu cục bộ, hoặc một đội sẵn sàng vận hành hạ tầng suy luận.
Hãy dùng API mô hình hoặc router khi:
- Lưu lượng truy cập có tính bùng nổ.
- Lựa chọn mô hình thay đổi thường xuyên.
- Bạn cần cơ chế dự phòng giữa các nhà cung cấp.
- Bạn không cần tự lưu trữ trọng số tùy chỉnh.
- Thời gian GPU nhàn rỗi sẽ vượt quá bất kỳ khoản phí premium nào của API.
- Bộ phận tài chính cần hồ sơ sử dụng ở cấp độ request, ngân sách theo sub-key, hóa đơn và phân bổ chi phí.
Flatkey phù hợp với phía quyết định đó: một key, một số dư, một hóa đơn, các endpoint mô hình chính thức, và hồ sơ sử dụng ở cấp độ request trên nhiều tuyến mô hình. Hãy so sánh chi phí trên mỗi token được chấp nhận của L40S hoặc H100 chuyên dụng với các tuyến mô hình được quản lý trước khi cam kết năng lực GPU dài hạn.
Đối với các công việc chi phí liên quan, xem hướng dẫn của Flatkey về GPU tốt nhất cho suy luận LLM, H100 so với A100, H200 so với H100, so sánh giá mô hình AI, và quản lý chi tiêu AI API.
Kết luận cuối cùng
Đối với hầu hết các nhà phát triển độc lập và các nhóm AI nhỏ đang so sánh L40S vs H100, hãy bắt đầu với quy tắc này:
- Chọn L40S khi mô hình phù hợp, độ trễ ở mức vừa phải, lưu lượng có thể xếp hàng, và H100 đắt hơn từ 2x đến 3x theo giá theo giờ.
- Chọn H100 khi băng thông bộ nhớ, bộ nhớ lớn hơn, NVLink, MIG, độ đồng thời cao, ngữ cảnh dài, hoặc độ trễ p95/p99 quyết định kết quả sản phẩm.
- Benchmark cả hai khi khối lượng công việc thuộc nhóm 30B, có ngữ cảnh hỗn hợp, hoặc gần ngưỡng bộ nhớ 48 GB.
- So sánh cả hai với một API mô hình được quản lý khi mức sử dụng không chắc chắn hoặc lựa chọn mô hình thay đổi thường xuyên.
Quyết định hiệu năng NVIDIA L40S vs H100 mạnh nhất không phải là một người thắng chung cuộc trong benchmark tổng quát. Đó là GPU tạo ra chi phí thấp nhất trên mỗi đầu ra được chấp nhận trong khi vẫn đáp ứng mục tiêu về độ trễ và độ tin cậy của bạn.
Câu hỏi thường gặp về L40S vs H100
H100 có nhanh hơn L40S cho suy luận AI không?
Có, H100 có trần hiệu năng kỹ thuật cao hơn nhiều cho suy luận AI, đặc biệt khi băng thông bộ nhớ, thông lượng FP8, bộ nhớ lớn hơn, NVLink, và serving tối ưu cho Hopper là quan trọng. L40S vẫn có thể thắng về thông lượng trên mỗi đô la khi khối lượng công việc phù hợp và phí premium theo giờ của H100 quá cao.
L40S có tốt cho suy luận LLM không?
Có. NVIDIA định vị L40S cho AI tạo sinh và suy luận/huấn luyện LLM, và liệt kê bộ nhớ GDDR6 ECC 48 GB cùng Tensor Cores thế hệ thứ tư với hỗ trợ FP8. Nó mạnh nhất cho các mô hình nhỏ và tầm trung, suy luận theo lô, khối lượng công việc AI/đồ họa kết hợp, và phục vụ nhạy cảm về chi phí.
Tôi nên dùng L40S hay H100 cho mô hình 70B?
Hãy bắt đầu với H100, H100 NVL, H200, hoặc cấu hình nhiều GPU cho suy luận production thuộc lớp 70B, đặc biệt với ngữ cảnh dài hoặc mục tiêu độ trễ nghiêm ngặt. L40S có thể hoạt động cho các thử nghiệm bị giới hạn hoặc đã lượng tử hóa, nhưng bộ nhớ 48 GB có thể hạn chế độ đồng thời và khoảng trống KV-cache.
Chỉ số tốt nhất để so sánh L40S với H100 là gì?
Hãy dùng chi phí trên mỗi đầu ra được chấp nhận tại độ trễ mục tiêu. Theo dõi số token đầu ra được chấp nhận mỗi giờ, số phản hồi được chấp nhận mỗi giờ, độ trễ p95/p99, tỷ lệ retry, tỷ lệ OOM, mức sử dụng, và chi phí hiệu dụng theo giờ.
Benchmark L40S vs H100 đã đủ để mua năng lực chưa?
Chỉ khi benchmark mô phỏng đúng hỗn hợp prompt thực tế, độ dài ngữ cảnh, độ dài đầu ra, độ đồng thời, các kiểm tra chất lượng, và môi trường nhà cung cấp của bạn. Kết quả tokens/sec tổng quát là hữu ích, nhưng tự nó chưa phải là quyết định mua hàng.


