
NVIDIA L40S vs H100 для AI-инференса: пропускная способность на доллар
Короткий ответ на вопрос L40S vs H100 — это не «H100 быстрее, значит покупайте H100». H100 — более мощный AI-ускоритель. L40S часто оказывается лучшим вариантом по пропускной способности на доллар, когда модель помещается в 48 ГБ, требования к задержке умеренные, а предложение провайдера существенно ниже.
Для команд, занимающихся AI-инференсом, полезный вопрос звучит так:
Дает ли H100 достаточно принятого output в час, чтобы компенсировать свою более высокую цену по сравнению с L40S для именно этой модели, смеси промптов, стека сервинга и SLA?
Это сравнение NVIDIA L40S vs H100 фокусируется на экономике инференса: соответствие объема памяти, prefill, decode, batching, latency, utilization и cloud GPU pricing. Цены меняются часто, поэтому рассматривайте публичные строки цен ниже как примеры, проверенные 12 октября 2026 года, а затем пересчитайте ту же таблицу на основе актуальных котировок вашего провайдера.
L40S vs H100: краткая таблица принятия решения
| Нагрузка инференса | Обычно начинать с | Почему |
|---|---|---|
| чат 7B–13B, внутренние copilots, lightweight RAG | L40S | Более низкая почасовая стоимость может обойти H100, когда latency приемлема, а модель помещается с запасом для KV cache. |
| модели класса 30B со средним контекстом | Benchmark both | L40S может выиграть по стоимости; H100 может выиграть, когда доминирует хвостовая задержка или пропускная способность памяти. |
| обслуживание моделей класса 70B со строгой latency | H100, H100 NVL, H200 или multi-GPU | У H100 значительно выше пропускная способность HBM, больше памяти в распространенных конфигурациях SXM/NVL, есть варианты NVLink и более сильная поддержка production serving. |
| batch inference с мягким SLA | сначала L40S | Нагрузки, дружелюбные к очереди, могут использовать более дешевую емкость, если utilization остается высокой. |
| Long-context RAG | сначала H100 | Prefill и давление на KV-cache обычно вознаграждают высокую пропускную способность HBM и больший объем памяти. |
| multi-tenant infrastructure | H100, если важен MIG | NVIDIA указывает поддержку MIG на H100; NVIDIA не указывает поддержку MIG на L40S. |
| multimodal workloads с rendering, image/video или graphics | L40S может быть привлекательным | NVIDIA позиционирует L40S как универсальный GPU для AI, graphics, rendering и media acceleration. |
| LLM API для клиентов с высокой concurrency | сначала H100 | Хвостовая задержка, запас для batching и оптимизация ПО часто оправдывают премию. |
Практическое правило: выбирайте L40S, когда важен нижний предел стоимости и workload хорошо помещается. Выбирайте H100, когда latency, bandwidth, concurrency, простота sharding или multi-GPU topology влияют на выручку или надежность.
Ключевые различия спецификаций
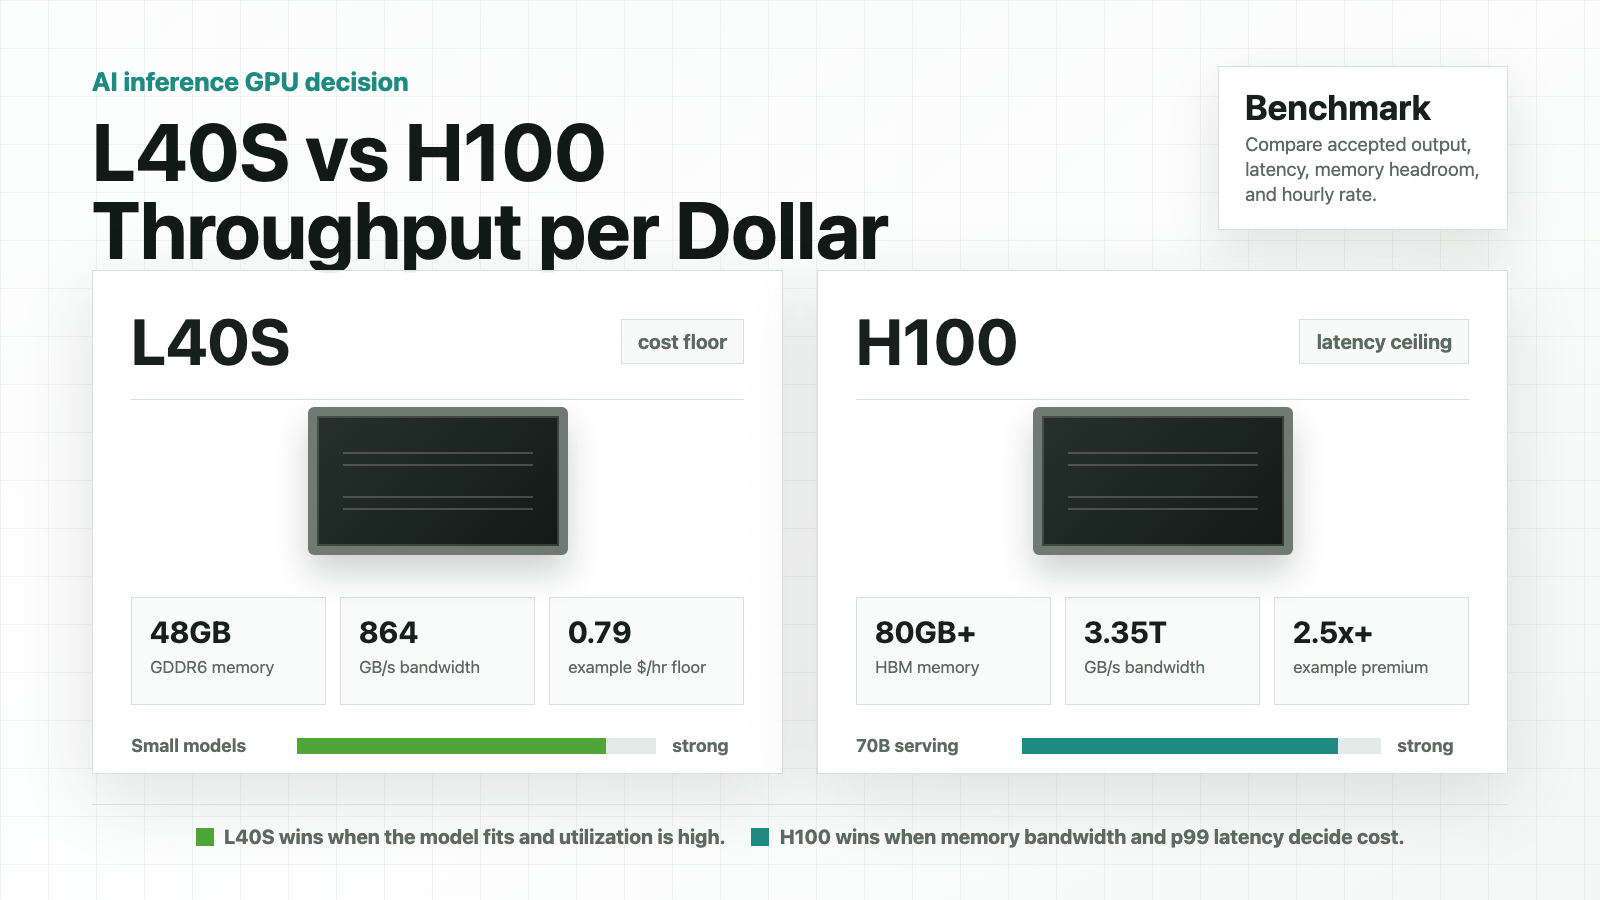
NVIDIA позиционирует L40S как data center GPU на архитектуре Ada Lovelace для генеративного AI, inference и training LLM, 3D graphics, rendering и video. NVIDIA указывает для L40S 48 ГБ памяти GDDR6 ECC, пропускную способность памяти 864 ГБ/с, PCIe Gen4 x16, максимальную мощность 350 Вт, Tensor Cores четвертого поколения, поддержку FP8, отсутствие MIG и отсутствие поддержки NVLink. NVIDIA позиционирует H100 как data center GPU на архитектуре Hopper для крупномасштабного AI и HPC, с выделенным Transformer Engine, NVLink четвертого поколения, MIG и памятью HBM. В спецификациях продукта H100 от NVIDIA указано, что H100 SXM имеет 80 ГБ памяти, пропускную способность 3,35 ТБ/с, до 7 экземпляров MIG, 900 ГБ/с NVLink и настраиваемый TDP до 700 Вт; H100 NVL указан с 94 ГБ на GPU, пропускной способностью 3,9 ТБ/с и 600 ГБ/с NVLink. Источники: NVIDIA L40S и NVIDIA H100.
| Область | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Вывод для покупателя |
|---|---|---|---|
| Architecture | Ada Lovelace | Hopper | H100 — флагманское поколение AI/HPC-ускорителей; L40S — универсальный data center GPU. |
| Memory | 48 GB GDDR6 ECC | 80 GB HBM on H100 SXM; 94 GB HBM on H100 NVL | У H100 больше пространства для более крупных моделей, более длинного контекста и более высокой concurrency. |
| Memory bandwidth | 864 GB/s | 3.35 TB/s on H100 SXM; 3.9 TB/s on H100 NVL | У H100 большое преимущество для bandwidth-bound prefill, decode и перемещения KV-cache. |
| FP8 Tensor Core peak with sparsity | 1,466 TFLOPS | 3,958 TFLOPS on H100 SXM; 3,341 TFLOPS on H100 NVL | У H100 значительно более высокий потолок, когда serving stack и политика точности могут использовать FP8. |
| Interconnect | PCIe Gen4 x16; no NVLink | PCIe Gen5 plus NVLink on SXM/NVL configurations | H100 сильнее для scale-up и multi-GPU inference. |
| MIG | No | Up to 7 MIG instances | H100 лучше, когда требуется аппаратное разделение для utilization или изоляции. |
| Max power | 350W | Up to 700W on SXM; 350-400W on NVL | L40S может быть проще разместить в серверах с меньшим энергопотреблением; H100 может выполнять больше работы на GPU. |
Эти спецификации объясняют, почему общий L40S vs H100 benchmark может ввести в заблуждение при закупке. У H100 технический потолок выше. L40S все равно может выиграть, когда H100 стоит в несколько раз дороже, а приложение не использует весь этот потолок.
Формула пропускной способности на доллар
Для инференса сравнивайте accepted output, а не сырые теоретические FLOPS:
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
Затем учтите скрытые затраты:
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
Правило точки безубыточности простое:
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
Если H100 стоит в 3 раза дороже L40S, H100 должен выдавать более чем в 3 раза больше принятого вывода в час, чтобы выиграть по пропускной способности на доллар, прежде чем учитывать бизнес-ценность от меньшей задержки. Если H100 стоит в 1,8 раза дороже, планка ниже. Если L40S вызывает OOM-повторы, низкий размер батча или пропущенную p99-задержку, более низкая почасовая цена не означает более дешевый сервис.
Для более широкой таблицы скрытых затрат см. руководство Flatkey по ценам аренды GPU.
Примеры публичных цен, проверенные 12 октября 2026 года
Публичные цены на GPU — не постоянные прайс-листы. Они зависят от провайдера, региона, доступности, уровня безопасности, резервирования, единицы биллинга и от того, является ли мощность маркетплейсной, выделенной, on-demand или по обязательству.
| Страница провайдера | Пример L40S | Пример H100 | Что это показывает |
|---|---|---|---|
| Цены RunPod | L40S: Community Cloud $0.79/ч, Secure Cloud $1.09/ч | H100 PCIe: Community Cloud $1.99/ч, Secure Cloud $2.89/ч; H100 SXM: Community Cloud $2.69/ч, Secure Cloud $3.49/ч; H100 NVL: Community Cloud $2.59/ч, Secure Cloud $3.19/ч | Строки с прямыми ценами могут делать H100 примерно в 2,5–3,4 раза дороже по почасовой ставке L40S еще до учета скрытых затрат. |
| Цены Lambda | В проверенном для этой статьи HTML с публичными ценами не найдено прямой строки L40S | Строки H100 представлены в self-serve и кластерных конфигурациях, включая примеры H100 SXM и H100 PCIe | Покрытие у провайдеров различается; не следует предполагать, что каждый GPU из короткого списка доступен у каждого вендора. |
На примерах RunPod Community Cloud точка безубыточности по ускорению выглядит так:
| Сравнение | Цена H100 | Цена L40S | Премия к цене H100 | Что означает точка безубыточности |
|---|---|---|---|---|
| H100 PCIe против L40S | $1.99/ч | $0.79/ч | 2.52x | H100 PCIe нужен более чем 2.52x больший принятый output в час, чтобы выиграть на чистой аренде GPU. |
| H100 SXM против L40S | $2.69/ч | $0.79/ч | 3.41x | H100 SXM нужен большой прирост пропускной способности или причина на уровне задержки/бизнеса, чтобы оправдать премию. |
| H100 NVL против L40S | $2.59/ч | $0.79/ч | 3.28x | H100 NVL нужна его память/интерконнект-преимущество, чтобы оно имело значение для workload. |
| Secure H100 SXM против Secure L40S | $3.49/ч | $1.09/ч | 3.20x | Защищенная мощность меняет абсолютную ставку, но идея точки безубыточности остается той же. |
Не используйте эти строки как универсальную истину. Используйте их, чтобы понять математику: решение по производительности инференса NVIDIA L40S vs H100 меняется, когда меняется предложение.
Где выигрывает L40S
L40S обычно заслуживает первого места в бенчмарке, когда workload чувствителен к стоимости и технически ограничен:
- Модель — 7B, 8B, 13B или квантованный маршрут класса 30B, который помещается в 48 GB с запасом для KV-cache.
- Трафик ориентирован на батчи, асинхронный, внутренний или терпим к более высокой p95-задержке.
- Вы можете поддерживать загрузку L40S очередями вместо избыточного резервирования ради мгновенного ответа.
- Вам нужен универсальный GPU, который также может выполнять рендеринг, работу с медиа, генерацию изображений или смешанные креативные задачи.
- Предложение вашего провайдера делает H100 в 2.5x–4x дороже.
- Ваш serving framework показывает приемлемую p95/p99 задержку на реалистичных промптах.
L40S также привлекателен для команд, строящих ранние inference-продукты. Если выбор модели, форма промптов и трафик все еще меняются, более дешевый GPU может удешевить эксперименты, пока вы собираете реальные данные спроса.
Где выигрывает H100
H100 обычно заслуживает первого места в бенчмарке, когда задержка, concurrency, пропускная способность памяти или обслуживание больших моделей определяют счет:
- RAG с длинным контекстом нагружает prefill и движение KV-cache.
- p95 или p99-задержка влияет на конверсию, удержание или нагрузку на поддержку.
- Модель достаточно большая, и 48 GB на L40S вынуждают к агрессивной квантизации, малому размеру батчей или tensor parallelism.
- Вам нужен MIG для изоляции multi-tenant или более высокой утилизации.
- Вам нужен NVLink, NVSwitch или масштабирование в стиле H100 NVL для инференса класса 70B.
- Ваш стек может использовать FP8 или оптимизированные для Hopper kernels без деградации качества.
- Снижение числа GPU компенсирует почасовую премию.
H100 — это не только про пиковой speed. Он также может упростить production, когда один H100 заменяет несколько менее мощных GPU, избегает model sharding или удерживает tail latency внутри SLA.
Детали workload, которые меняют победителя
Самая частая ошибка в сравнении производительности NVIDIA L40S vs H100 — тестировать одну длину промпта и один уровень concurrency. Обслуживание LLM имеет разные узкие места:
| Измерение рабочей нагрузки | Почему это важно |
|---|---|
| Размер модели | Модель 7B и модель 70B по-разному нагружают память, пропускную способность и interconnect. |
| Точность и квантизация | FP8, FP16, BF16, INT8, AWQ, GPTQ и другие подходы меняют и качество, и пропускную способность. |
| Длина контекста | Длинные промпты смещают затраты в сторону prefill и давления на KV-cache. |
| Длина вывода | Длинные ответы смещают затраты в сторону throughput на decode и планирования. |
| Конкурентность | GPU, который выигрывает при batch size 1, может проигрывать при реальном трафике. |
| Коэффициент принятия | Неудачные, завершившиеся по тайм-ауту или низкокачественные ответы не считаются продуктивной пропускной способностью. |
| Фреймворк обслуживания | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM и пользовательские серверы имеют разные пути оптимизации. |
| Профиль провайдера | CPU, RAM, локальный NVMe, сеть, запуск образа и риск «шумного соседа» могут доминировать над дешевым предложением GPU. |
Если вы одновременно выбираете стек обслуживания, руководство Flatkey vLLM vs SGLang предлагает отдельную методику для измерения throughput, latency, поддержки моделей и эксплуатации.
План бенчмарка для инференса на L40S vs H100
Запустите одинаковый replay на L40S и H100. Зафиксируйте критерии принятия.
| Шаг | Что измерять | Почему |
|---|---|---|
| 1. Зафиксируйте рабочую нагрузку | ID модели, квантизация, распределение контекста, ограничение вывода, проверки качества | Предотвращает ложные сравнения «яблоки к яблокам». |
| 2. Зафиксируйте стек обслуживания | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, драйвер, контейнерный образ | Изменения в ПО могут скрывать эффекты оборудования. |
| 3. Запустите лестницу конкуренции | 1, 4, 8, 16, 32, 64 или ваш реальный профиль трафика | Показывает, когда каждая GPU достигает насыщения. |
| 4. Разделите prefill и decode | Время до первого токена, токены промпта/с, токены вывода/с | Показывает, что является узким местом: пропускная способность или decode. |
| 5. Отслеживайте хвостовую задержку | p50, p95, p99, ожидание в очереди, доля тайм-аутов | Решения покупателя должны защищать пользовательский опыт. |
| 6. Отслеживайте утилизацию | Утилизация GPU, использованная память, давление на пропускную способность HBM/GDDR, ожидание CPU, ожидание хранилища | Подтверждает, что узким местом является именно GPU. |
| 7. Подсчитайте сбои | OOM, вытеснения, плохие хосты, холодные старты, штормы повторных попыток | Неудачная работа должна учитываться в стоимости на принятый вывод. |
| 8. Рассчитайте стоимость принятых результатов | Стоимость за 1M принятых токенов вывода, за принятый ответ или за завершённую задачу | Закупкам нужна нормализованная стоимость, а не скриншоты бенчмарков. |
Минимальный replay:
100 short prompts
100 medium prompts
100 long-context prompts
same model
same precision or quantization policy
same max output tokens
same server version
same concurrency ladder
same quality and acceptance checks
Таблица принятия решения:
| Метрика | Результат L40S | Результат H100 |
|---|---|---|
| Почасовая цена GPU | ||
| Эффективная почасовая стоимость | ||
| Принятых ответов/час | ||
| Принятых токенов вывода/час | ||
| Стоимость за 1M принятых токенов вывода | ||
| Время до первого токена p95 | ||
| Сквозная задержка p95/p99 | ||
| Частота OOM или повторных попыток | ||
| Средняя утилизация GPU | ||
| Операционные заметки |
Это ключевая ценность для реального бенчмарка L40S vs H100: победитель — это GPU с более низкой стоимостью на принятый результат при уровне задержки и надёжности, который требуется вашему продукту.
Чек-лист для закупки
Прежде чем арендовать или покупать любую из этих GPU, запросите:
- Точный SKU: L40S, H100 PCIe, H100 SXM, H100 NVL, размер памяти и форм-фактор.
- Конфигурацию узла: число GPU, CPU, RAM, локальный NVMe, сеть и есть ли у GPU мощный interconnect.
- Единицу тарификации: за секунду, минуту, час, месяц или по контракту.
- Режим доступности: marketplace, secure cloud, dedicated, reserved, spot или cluster.
- Политику прерывания и замены.
- Требования к региону, соответствию, tenancy и обработке данных.
- Цены на хранение и snapshots.
- Политику egress и bandwidth.
- Поддержку драйвера, CUDA, контейнера и фреймворка обслуживания.
- Наблюдаемость: утилизация, память, очереди, p95/p99, OOM, повторные попытки и стоимость по маршруту.
- SLA поддержки и путь эскалации.
Для более широкого чек-листа на уровне кластера см. руководство Flatkey по аренде GPU-кластера.
Когда API модели лучше любой из GPU
Правильный ответ на вопрос L40S vs H100 может быть и таким: «ни то, ни другое». Аренда GPU имеет смысл, когда у вас есть собственные веса, стабильная загрузка, строгий контроль задержки, пользовательские ядра, требования к локальности данных или команда, готовая эксплуатировать инфраструктуру инференса.
Используйте API модели или router, когда:
- Трафик носит всплесковый характер.
- Выбор модели часто меняется.
- Вам нужен fallback между провайдерами.
- Вам не нужно размещать собственные веса.
- Простой GPU-ресурс превысил бы любую API-премию.
- Финансам нужны записи использования на уровне запросов, бюджеты на уровне под-ключей, счета и атрибуция затрат.
Flatkey подходит для этой стороны решения: один ключ, один баланс, один счет, официальные endpoints моделей и записи использования на уровне запросов across model routes. Сравните стоимость выделенных L40S или H100 на один принятый токен с управляемыми маршрутами моделей, прежде чем брать на себя долгосрочную GPU-мощность.
По связанным вопросам затрат см. руководства Flatkey по лучшему GPU для LLM-инференса, H100 vs A100, H200 vs H100, сравнению цен на AI-модели и управлению расходами на AI API.
Итоговая рекомендация
Для большинства независимых разработчиков и небольших AI-команд, сравнивающих L40S vs H100, начните с такого правила:
- Выбирайте L40S, когда модель подходит, задержка умеренная, трафик можно ставить в очередь, а H100 стоит более чем в 2–3 раза дороже в час.
- Выбирайте H100, когда на итог продукта влияют пропускная способность памяти, больший объем памяти, NVLink, MIG, высокая конкуррентность, длинный контекст или задержка p95/p99.
- Проводите бенчмарк обеих систем, когда рабочая нагрузка относится к классу 30B, имеет смешанный контекст или находится близко к границе памяти 48 GB.
- Сравнивайте обе системы с управляемым API модели, когда загрузка неочевидна или выбор модели часто меняется.
Самое сильное решение в вопросе производительности NVIDIA L40S vs H100 — это не абстрактный победитель бенчмарка. Это тот GPU, который дает самую низкую стоимость на один принятый результат при соблюдении ваших целевых показателей задержки и надежности.
FAQ по L40S vs H100
H100 быстрее L40S для AI-инференса?
Да, у H100 значительно более высокий технический потолок для AI-инференса, особенно когда важны пропускная способность памяти, FP8 throughput, больший объем памяти, NVLink и обслуживание, оптимизированное под Hopper. L40S все еще может выигрывать по пропускной способности на доллар, если нагрузка подходит, а часовая премия H100 слишком высока.
Подходит ли L40S для LLM-инференса?
Да. NVIDIA позиционирует L40S для generative AI и инференса/обучения LLM, и указывает 48 GB памяти GDDR6 ECC плюс тензорные ядра четвертого поколения с поддержкой FP8. Он особенно силен для небольших и средних моделей, пакетного инференса, смешанных AI/графических нагрузок и чувствительного к стоимости обслуживания.
Стоит ли использовать L40S или H100 для моделей 70B?
Начинайте с H100, H100 NVL, H200 или многo-GPU-конфигурации для production-инференса класса 70B, особенно при длинном контексте или строгих целевых задержках. L40S может подойти для ограниченных или квантизованных экспериментов, но память 48 GB может ограничивать конкуррентность и запас для KV-cache.
Какая метрика лучшая для L40S vs H100?
Используйте стоимость на один принятый результат при целевой задержке. Отслеживайте принятые токены ответа в час, принятые ответы в час, задержку p95/p99, частоту повторных попыток, частоту OOM, загрузку и эффективную почасовую стоимость.
Достаточно ли бенчмарка L40S vs H100, чтобы покупать мощность?
Только если бенчмарк воспроизводит ваш реальный микс запросов, длины контекста, длины ответов, конкуррентность, проверки качества и среду провайдера. Общий результат tokens/sec полезен, но сам по себе не является решением о покупке.


