
NVIDIA L40S vs H100 untuk AI Inference: Throughput per Dolar
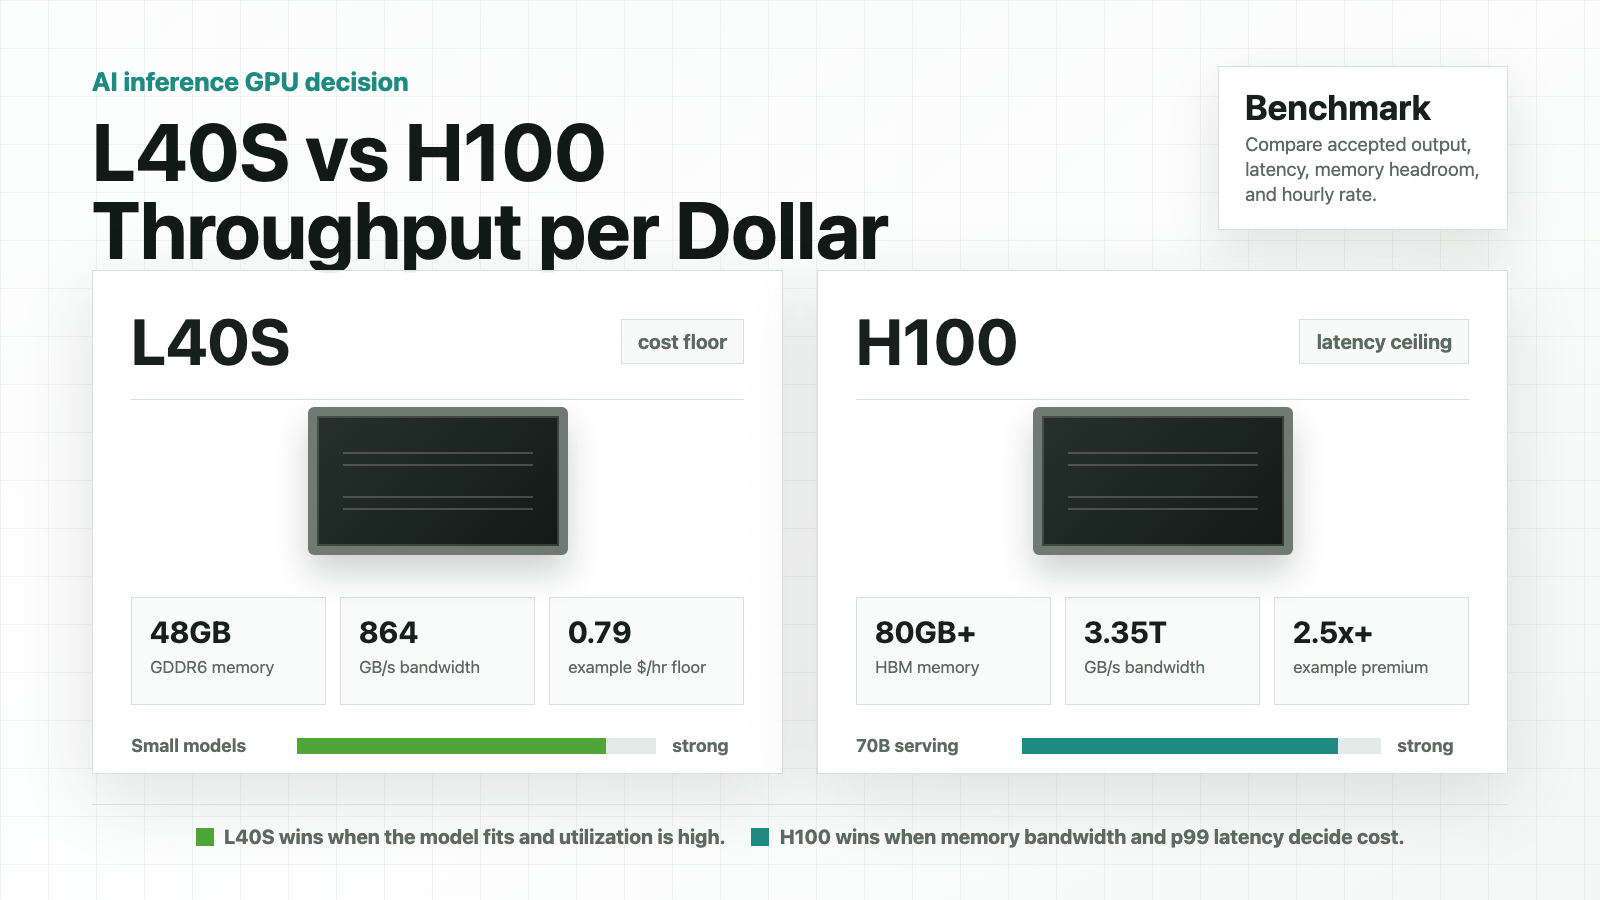
Jawaban singkat untuk L40S vs H100 bukanlah "H100 lebih cepat, jadi beli H100." H100 adalah akselerator AI yang lebih kuat. L40S sering kali menjadi kandidat throughput-per-dolar yang lebih baik ketika model muat dalam 48 GB, target latensi moderat, dan penawaran provider jauh lebih rendah.
Untuk tim AI inference, pertanyaan yang berguna adalah:
Apakah H100 memberikan output yang diterima per jam cukup besar untuk mengimbangi premium harganya dibanding L40S untuk model, campuran prompt, stack serving, dan SLA yang spesifik ini?
Perbandingan NVIDIA L40S vs H100 ini berfokus pada ekonomi inference: kecocokan memori, prefill, decode, batching, latensi, utilisasi, dan harga GPU cloud. Harga sering berubah, jadi perlakukan baris harga publik di bawah ini sebagai contoh yang dicek pada 12 Oktober 2026, lalu jalankan kembali worksheet yang sama terhadap penawaran provider Anda saat ini.
L40S vs H100: tabel keputusan cepat
| Inference workload | Biasanya mulai dengan | Mengapa |
|---|---|---|
| Chat 7B hingga 13B, copilot internal, RAG ringan | L40S | Biaya per jam yang lebih rendah dapat mengalahkan H100 ketika latensi dapat diterima dan model muat dengan ruang headroom untuk KV cache. |
| Model kelas 30B dengan konteks moderat | Benchmark keduanya | L40S bisa unggul dalam biaya; H100 bisa unggul ketika tail latency atau bandwidth memori menjadi faktor dominan. |
| Serving kelas 70B dengan latensi ketat | H100, H100 NVL, H200, atau multi-GPU | H100 memiliki bandwidth HBM yang jauh lebih tinggi, memori lebih besar pada konfigurasi SXM/NVL yang umum, opsi NVLink, dan dukungan serving produksi yang lebih kuat. |
| Batch inference dengan SLA yang lebih longgar | L40S dulu | Workload yang ramah antrean dapat menggunakan kapasitas yang lebih murah jika utilisasi tetap tinggi. |
| RAG dengan konteks panjang | H100 dulu | Prefill dan tekanan KV-cache biasanya lebih diuntungkan oleh bandwidth HBM dan memori yang lebih besar. |
| Infrastruktur multi-tenant | H100 jika MIG penting | NVIDIA mencantumkan dukungan MIG pada H100; NVIDIA tidak mencantumkan dukungan MIG pada L40S. |
| Workload multimodal dengan rendering, image/video, atau grafik | L40S bisa menarik | L40S diposisikan NVIDIA sebagai GPU universal untuk AI, grafis, rendering, dan akselerasi media. |
| API LLM customer-facing dengan concurrency tinggi | H100 dulu | Tail latency, headroom batching, dan optimisasi software sering kali membenarkan premium tersebut. |
Aturan praktisnya: pilih L40S ketika batas biaya penting dan workload pas dengan rapi. Pilih H100 ketika latensi, bandwidth, concurrency, kesederhanaan sharding, atau topologi multi-GPU memengaruhi pendapatan atau keandalan.
Perbedaan spesifikasi inti
NVIDIA memposisikan L40S sebagai GPU data center Ada Lovelace untuk generative AI, inference dan training LLM, grafis 3D, rendering, dan video. NVIDIA mencantumkan L40S dengan memori 48 GB GDDR6 ECC, bandwidth memori 864 GB/s, PCIe Gen4 x16, daya maksimum 350W, Tensor Cores generasi keempat, dukungan FP8, tanpa MIG, dan tanpa dukungan NVLink. NVIDIA memposisikan H100 sebagai GPU data center Hopper untuk AI skala besar dan HPC, dengan Transformer Engine khusus, NVLink generasi keempat, MIG, dan memori HBM. Spesifikasi produk H100 NVIDIA mencantumkan H100 SXM dengan memori 80 GB, bandwidth 3,35 TB/s, hingga 7 instance MIG, NVLink 900 GB/s, dan TDP yang dapat dikonfigurasi hingga 700W; H100 NVL dicantumkan dengan 94 GB per GPU, bandwidth 3,9 TB/s, dan NVLink 600 GB/s. Sumber: NVIDIA L40S dan NVIDIA H100.
| Area | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Implikasi bagi pembeli |
|---|---|---|---|
| Arsitektur | Ada Lovelace | Hopper | H100 adalah generasi akselerator AI/HPC andalan; L40S adalah GPU data center universal. |
| Memori | 48 GB GDDR6 ECC | 80 GB HBM pada H100 SXM; 94 GB HBM pada H100 NVL | H100 memiliki ruang lebih besar untuk model yang lebih besar, konteks lebih panjang, dan concurrency yang lebih tinggi. |
| Bandwidth memori | 864 GB/s | 3,35 TB/s pada H100 SXM; 3,9 TB/s pada H100 NVL | H100 memiliki keunggulan besar untuk prefill, decode, dan pergerakan KV-cache yang terikat bandwidth. |
| Puncak FP8 Tensor Core dengan sparsity | 1.466 TFLOPS | 3.958 TFLOPS pada H100 SXM; 3.341 TFLOPS pada H100 NVL | H100 memiliki plafon yang jauh lebih tinggi ketika stack serving dan kebijakan akurasi dapat menggunakan FP8. |
| Interconnect | PCIe Gen4 x16; tanpa NVLink | PCIe Gen5 plus NVLink pada konfigurasi SXM/NVL | H100 lebih kuat untuk scale-up dan inference multi-GPU. |
| MIG | Tidak | Hingga 7 instance MIG | H100 lebih baik ketika Anda memerlukan partisi perangkat keras untuk utilisasi atau isolasi. |
| Daya maksimum | 350W | Hingga 700W pada SXM; 350-400W pada NVL | L40S mungkin lebih mudah ditempatkan di server dengan daya lebih rendah; H100 dapat menyelesaikan lebih banyak pekerjaan per GPU. |
Spesifikasi ini menjelaskan mengapa benchmark L40S vs H100 yang generik dapat menyesatkan pengadaan. H100 memiliki plafon teknis yang lebih tinggi. L40S tetap bisa menang ketika H100 dihargai beberapa kali lebih mahal dan aplikasi tidak memanfaatkan plafon penuh tersebut.
Rumus throughput per dolar
Untuk inference, bandingkan output yang diterima, bukan FLOPS teoretis mentah:
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
Lalu sertakan biaya tersembunyi:
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
Aturan titik impasnya sederhana:
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
Jika H100 berbiaya 3x lebih mahal daripada L40S, H100 harus menghasilkan output yang diterima lebih dari 3x per jam agar unggul dalam throughput per dolar, sebelum memperhitungkan nilai bisnis dari latensi yang lebih rendah. Jika H100 berbiaya 1.8x lebih mahal, ambangnya lebih rendah. Jika L40S menyebabkan retry OOM, batch size kecil, atau p99 latency yang terlewat, harga per jam yang lebih murah bukan berarti layanan yang lebih murah.
Untuk worksheet biaya tersembunyi yang lebih luas, lihat panduan Flatkey tentang harga sewa GPU.
Contoh harga publik yang diperiksa 12 Oktober 2026
Harga GPU publik bukan daftar tarif permanen. Harganya bervariasi לפי provider, region, ketersediaan, tingkat keamanan, reservasi, unit penagihan, dan apakah kapasitasnya marketplace, dedicated, on-demand, atau committed.
| Halaman provider | Contoh L40S | Contoh H100 | Yang ditunjukkan |
|---|---|---|---|
| Harga RunPod | L40S: Community Cloud $0.79/jam, Secure Cloud $1.09/jam | H100 PCIe: Community Cloud $1.99/jam, Secure Cloud $2.89/jam; H100 SXM: Community Cloud $2.69/jam, Secure Cloud $3.49/jam; H100 NVL: Community Cloud $2.59/jam, Secure Cloud $3.19/jam | Kutipan baris langsung dapat membuat H100 sekitar 2.5x hingga 3.4x tarif per jam L40S sebelum biaya tersembunyi. |
| Harga Lambda | Tidak ditemukan baris L40S langsung dalam HTML harga publik yang diperiksa untuk artikel ini | Baris H100 tersedia di konfigurasi self-serve dan cluster, termasuk contoh H100 SXM dan H100 PCIe | Cakupan provider berbeda; jangan berasumsi setiap GPU shortlist tersedia dari setiap vendor. |
Dengan contoh RunPod Community Cloud, speedup titik impasnya terlihat seperti ini:
| Perbandingan | Harga H100 | Harga L40S | Premium harga H100 | Arti titik impas |
|---|---|---|---|---|
| H100 PCIe vs L40S | $1.99/jam | $0.79/jam | 2.52x | H100 PCIe perlu lebih dari 2.52x output yang diterima per jam untuk menang pada sewa GPU mentah. |
| H100 SXM vs L40S | $2.69/jam | $0.79/jam | 3.41x | H100 SXM memerlukan peningkatan throughput yang besar atau alasan latensi/bisnis untuk membenarkan premi tersebut. |
| H100 NVL vs L40S | $2.59/jam | $0.79/jam | 3.28x | H100 NVL memerlukan keunggulan memori/interconnect agar relevan dalam workload. |
| Secure H100 SXM vs Secure L40S | $3.49/jam | $1.09/jam | 3.20x | Kapasitas secure mengubah tarif absolut, tetapi konsep titik impasnya tetap sama. |
Jangan gunakan baris-baris ini sebagai kebenaran universal. Gunakan untuk memahami matematikanya: keputusan kinerja inferensi NVIDIA L40S vs H100 berubah ketika penawaran berubah.
Di mana L40S unggul
L40S biasanya layak mendapat slot benchmark pertama saat workload sensitif terhadap biaya dan secara teknis terkontrol:
- Modelnya 7B, 8B, 13B, atau jalur kelas 30B yang di-quantize dan muat dalam 48 GB dengan headroom KV-cache.
- Lalu lintas bersifat batch-oriented, asinkron, internal, atau toleran terhadap latensi p95 yang lebih tinggi.
- Anda dapat menjaga utilisasi L40S dengan queue alih-alih overprovisioning untuk respons instan.
- Anda memerlukan GPU serbaguna yang juga dapat menangani rendering, media, image generation, atau workload kreatif campuran.
- Kutipan provider Anda membuat H100 2.5x hingga 4x lebih mahal.
- Framework serving Anda menunjukkan latensi p95/p99 yang dapat diterima pada prompt yang realistis.
L40S juga menarik untuk tim yang membangun produk inferensi awal. Jika pilihan model, bentuk prompt, dan traffic masih berubah, GPU berbiaya lebih rendah dapat membuat eksperimen lebih murah sambil Anda mengumpulkan data permintaan nyata.
Di mana H100 unggul
H100 biasanya layak mendapat slot benchmark pertama saat latensi, concurrency, bandwidth memori, atau serving model besar mendorong tagihan:
- RAG dengan konteks panjang memberi tekanan pada prefill dan pergerakan KV-cache.
- Latensi p95 atau p99 memengaruhi konversi, retensi, atau beban dukungan.
- Model cukup besar sehingga 48 GB pada L40S memaksa quantization agresif, batch size kecil, atau tensor parallelism.
- Anda memerlukan MIG untuk isolasi multi-tenant atau utilisasi yang lebih tinggi.
- Anda memerlukan NVLink, NVSwitch, atau scaling bergaya H100 NVL untuk inferensi kelas 70B.
- Stack Anda dapat memanfaatkan FP8 atau kernel yang dioptimalkan Hopper tanpa regresi kualitas.
- Pengurangan jumlah GPU mengimbangi premium per jam.
H100 bukan hanya soal kecepatan puncak. H100 juga dapat menyederhanakan produksi ketika satu H100 menggantikan beberapa GPU kelas bawah, menghindari sharding model, atau menjaga tail latency tetap dalam SLA.
Detail workload yang mengubah pemenang
Kesalahan perbandingan kinerja NVIDIA L40S vs H100 yang paling umum adalah menguji satu panjang prompt dan satu level concurrency. Serving LLM memiliki bottleneck yang berbeda:
| Dimensi beban kerja | Mengapa ini penting |
|---|---|
| Ukuran model | Model 7B dan model 70B tidak membebani memori, bandwidth, atau interconnect dengan cara yang sama. |
| Presisi dan kuantisasi | FP8, FP16, BF16, INT8, AWQ, GPTQ, dan jalur lainnya mengubah kualitas sekaligus throughput. |
| Panjang konteks | Prompt yang panjang menggeser biaya ke prefill dan tekanan KV-cache. |
| Panjang output | Jawaban yang panjang menggeser biaya ke throughput decode dan penjadwalan. |
| Konkurensi | GPU yang unggul pada batch size 1 bisa kalah pada trafik nyata. |
| Tingkat penerimaan | Output yang gagal, timeout, atau berkualitas rendah tidak dihitung sebagai throughput produktif. |
| Framework serving | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM, dan server kustom memiliki jalur optimasi yang berbeda. |
| Bentuk penyedia | CPU, RAM, NVMe lokal, jaringan, startup image, dan risiko noisy neighbor dapat mendominasi listing GPU yang murah. |
Jika Anda juga sedang memilih stack serving, panduan Flatkey vLLM vs SGLang menyediakan kerangka terpisah untuk mengukur throughput, latensi, dukungan model, dan operasional.
Rencana benchmark untuk inference L40S vs H100
Jalankan replay yang sama pada L40S dan H100. Pertahankan kriteria penerimaan tetap.
| Langkah | Apa yang diukur | Mengapa |
|---|---|---|
| 1. Bekukan workload | ID model, kuantisasi, distribusi konteks, batas output, pemeriksaan kualitas | Mencegah hasil semu yang terlihat apple-to-apple. |
| 2. Bekukan stack serving | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, driver, image container | Perubahan perangkat lunak dapat menyamarkan efek perangkat keras. |
| 3. Jalankan tangga konkurensi | 1, 4, 8, 16, 32, 64, atau pola trafik nyata Anda | Menunjukkan kapan masing-masing GPU mencapai saturasi. |
| 4. Pisahkan prefill dan decode | Waktu ke token pertama, token prompt/dtk, token output/dtk | Mengungkap apakah bandwidth atau decode yang menjadi bottleneck. |
| 5. Lacak latensi ekor | p50, p95, p99, waktu tunggu antrean, tingkat timeout | Keputusan pembelian harus melindungi pengalaman pengguna. |
| 6. Lacak utilisasi | Utilisasi GPU, memori terpakai, tekanan bandwidth HBM/GDDR, CPU wait, storage wait | Memastikan GPU adalah bottleneck yang sebenarnya. |
| 7. Hitung kegagalan | OOM, eviksi, host buruk, cold start, lonjakan retry | Pekerjaan yang gagal termasuk dalam biaya per output yang diterima. |
| 8. Hitung biaya yang diterima | Biaya per 1M token output yang diterima, per respons yang diterima, atau per job yang selesai | Pengadaan membutuhkan biaya yang dinormalisasi, bukan tangkapan layar benchmark. |
Replay minimum:
100 short prompts
100 medium prompts
100 long-context prompts
same model
same precision or quantization policy
same max output tokens
same server version
same concurrency ladder
same quality and acceptance checks
Tabel keputusan:
| Metrik | Hasil L40S | Hasil H100 |
|---|---|---|
| Harga per jam GPU | ||
| Biaya efektif per jam | ||
| Respons yang diterima/jam | ||
| Token output yang diterima/jam | ||
| Biaya per 1M token output yang diterima | ||
| Waktu ke token pertama p95 | ||
| Latensi end-to-end p95/p99 | ||
| Tingkat OOM atau retry | ||
| Rata-rata utilisasi GPU | ||
| Catatan operasional |
Inilah aset nilai untuk benchmark L40S vs H100 yang nyata: pemenangnya adalah GPU dengan biaya yang diterima lebih rendah pada tingkat latensi dan keandalan yang dibutuhkan produk Anda.
Daftar periksa pengadaan
Sebelum menyewa atau membeli salah satu GPU, mintalah:
- SKU yang tepat: L40S, H100 PCIe, H100 SXM, H100 NVL, ukuran memori, dan faktor bentuk.
- Bentuk node: jumlah GPU, CPU, RAM, NVMe lokal, jaringan, dan apakah GPU berbagi interconnect yang kuat.
- Unit penagihan: per detik, menit, jam, bulan, atau masa komitmen.
- Mode kapasitas: marketplace, cloud aman, dedicated, reserved, spot, atau cluster.
- Kebijakan gangguan dan penggantian.
- Persyaratan region, kepatuhan, tenancy, dan penanganan data.
- Harga storage dan snapshot.
- Kebijakan egress dan bandwidth.
- Dukungan driver, CUDA, container, dan framework serving.
- Observabilitas: utilisasi, memori, antrean, p95/p99, OOM, retry, dan biaya per route.
- SLA dukungan dan jalur eskalasi.
Untuk daftar periksa yang lebih luas di level cluster, lihat panduan penyewaan cluster GPU Flatkey GPU cluster rental guide.
Kapan model API lebih baik daripada salah satu GPU
Jawaban yang tepat untuk L40S vs H100 juga bisa jadi "keduanya tidak." Menyewa GPU masuk akal ketika Anda memiliki bobot proprietary, utilisasi berkelanjutan, kontrol latensi yang ketat, kernel kustom, persyaratan data locality, atau tim yang siap mengoperasikan infrastruktur inference.
Gunakan model API atau router ketika:
- Lalu lintas bersifat bursty.
- Pilihan model sering berubah.
- Anda memerlukan fallback lintas penyedia.
- Anda tidak perlu meng-host bobot kustom.
- Waktu idle GPU akan melebihi premi API apa pun.
- Keuangan membutuhkan catatan penggunaan di level permintaan, anggaran sub-key, invoice, dan atribusi biaya.
Flatkey cocok untuk sisi keputusan tersebut: satu key, satu saldo, satu invoice, endpoint model resmi, dan catatan penggunaan di level permintaan di seluruh route model. Bandingkan biaya per token yang diterima untuk L40S atau H100 khusus terhadap route model terkelola sebelum berkomitmen pada kapasitas GPU jangka panjang.
Untuk pekerjaan biaya terkait, lihat panduan Flatkey tentang GPU terbaik untuk inferensi LLM, H100 vs A100, H200 vs H100, perbandingan harga model AI, dan pengelolaan pengeluaran AI API.
Rekomendasi akhir
Untuk sebagian besar developer independen dan tim AI kecil yang membandingkan L40S vs H100, mulailah dengan aturan ini:
- Pilih L40S ketika model cocok, latensi moderat, lalu lintas bisa mengantre, dan harga per jam H100 lebih dari 2x hingga 3x lebih tinggi.
- Pilih H100 ketika bandwidth memori, memori yang lebih besar, NVLink, MIG, konkurensi tinggi, konteks panjang, atau latensi p95/p99 menentukan hasil produk.
- Benchmark keduanya ketika beban kerja berada di kelas 30B, konteks campuran, atau dekat batas memori 48 GB.
- Bandingkan keduanya dengan API model terkelola ketika utilisasi tidak pasti atau pilihan model sering berubah.
Keputusan kinerja NVIDIA L40S vs H100 yang paling kuat bukanlah pemenang benchmark generik. Itu adalah GPU yang menghasilkan biaya terendah per output yang diterima sambil memenuhi target latensi dan reliabilitas Anda.
FAQ L40S vs H100
Apakah H100 lebih cepat daripada L40S untuk AI inference?
Ya, H100 memiliki batas teknis yang jauh lebih tinggi untuk AI inference, terutama ketika bandwidth memori, throughput FP8, memori yang lebih besar, NVLink, dan serving yang dioptimalkan untuk Hopper berperan. L40S masih bisa unggul dalam throughput per dolar ketika beban kerja cocok dan premi per jam H100 terlalu tinggi.
Apakah L40S bagus untuk inferensi LLM?
Ya. NVIDIA memposisikan L40S untuk AI generatif dan inferensi/pelatihan LLM, serta mencantumkan memori GDDR6 ECC 48 GB plus Tensor Cores generasi keempat dengan dukungan FP8. Ini paling kuat untuk model kecil dan menengah, inferensi batch, beban kerja campuran AI/grafis, dan serving yang sensitif terhadap biaya.
Haruskah saya menggunakan L40S atau H100 untuk model 70B?
Mulailah dengan H100, H100 NVL, H200, atau konfigurasi multi-GPU untuk inferensi produksi kelas 70B, terutama dengan konteks panjang atau target latensi yang ketat. L40S mungkin bekerja untuk eksperimen yang dibatasi atau dikuantisasi, tetapi memori 48 GB dapat membatasi konkurensi dan ruang kepala KV-cache.
Apa metrik terbaik untuk L40S vs H100?
Gunakan biaya per output yang diterima pada latensi target. Lacak token output yang diterima per jam, respons yang diterima per jam, latensi p95/p99, tingkat retry, tingkat OOM, utilisasi, dan biaya efektif per jam.
Apakah benchmark L40S vs H100 cukup untuk membeli kapasitas?
Hanya jika benchmark tersebut memutar ulang campuran prompt, panjang konteks, panjang output, konkurensi, pemeriksaan kualitas, dan lingkungan penyedia Anda yang sebenarnya. Hasil token/detik generik berguna, tetapi itu bukan keputusan pembelian dengan sendirinya.


