
NVIDIA L40S vs H100 para inferencia de IA: rendimiento por dólar
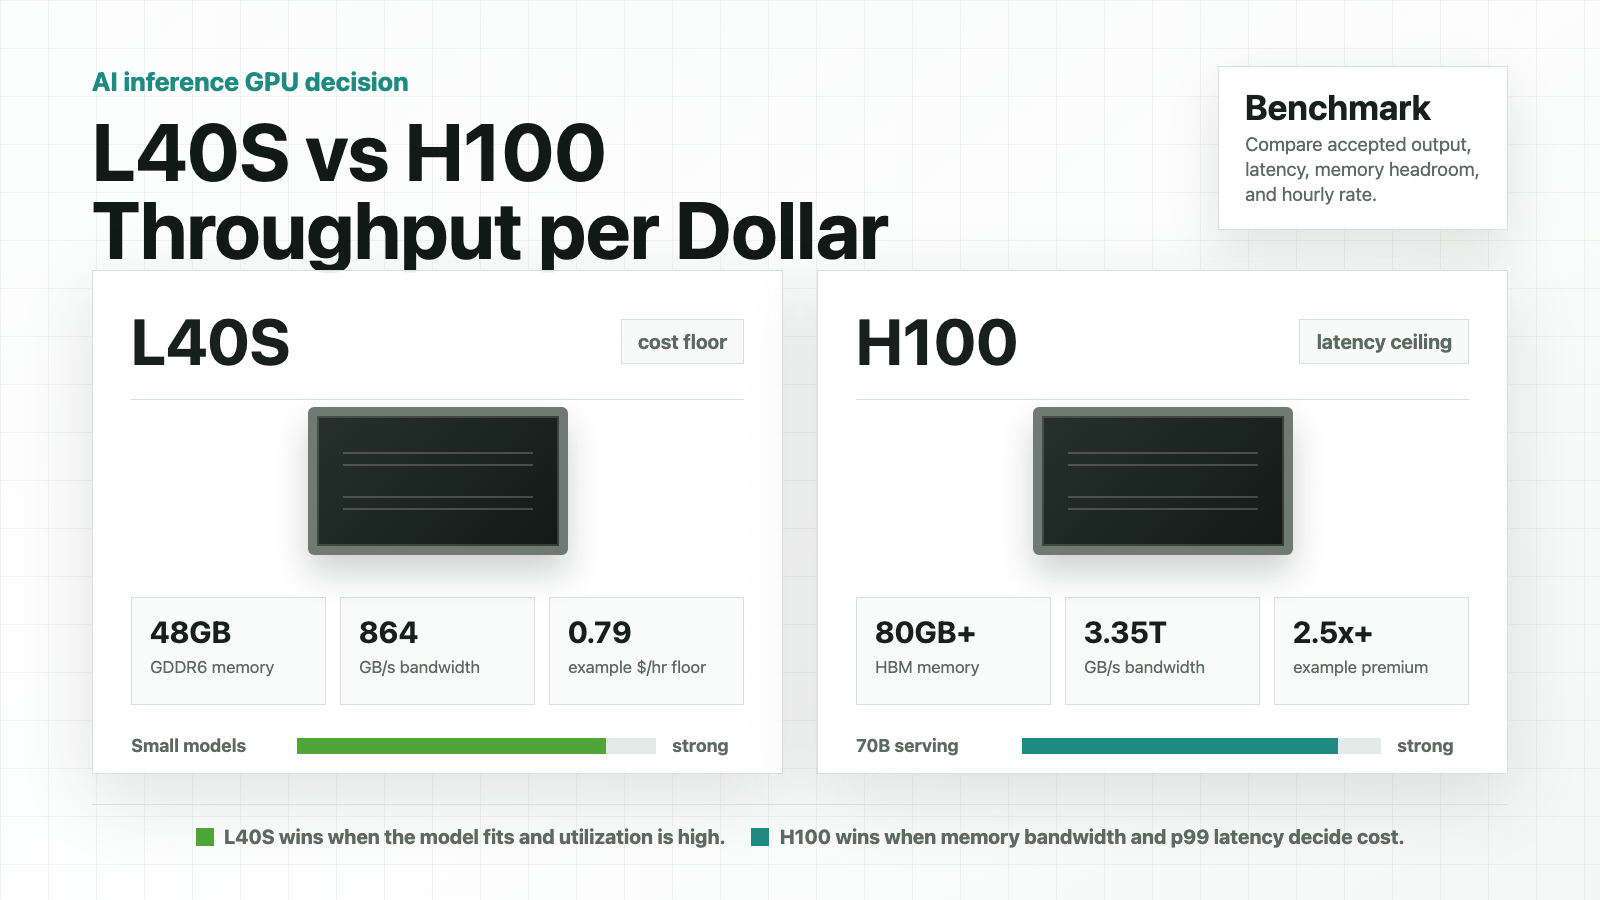
La respuesta breve para L40S vs H100 no es "H100 es más rápida, así que compra H100." H100 es el acelerador de IA más potente. L40S suele ser la mejor candidata en rendimiento por dólar cuando el modelo cabe en 48 GB, los objetivos de latencia son moderados y la cotización del proveedor es mucho más baja.
Para los equipos de inferencia de IA, la pregunta útil es:
¿Ofrece H100 suficiente salida aceptada por hora para compensar su prima de precio frente a L40S para este modelo exacto, mezcla de prompts, stack de servicio y SLA?
Esta comparación NVIDIA L40S vs H100 se centra en la economía de la inferencia: ajuste de memoria, prefill, decode, batching, latencia, utilización y precios de GPU en la nube. Los precios cambian con frecuencia, así que trate las filas de precios públicos de abajo como ejemplos verificados el 12 de octubre de 2026, y luego vuelva a ejecutar la misma hoja de cálculo con las cotizaciones actuales de su proveedor.
L40S vs H100: tabla rápida de decisión
| Inference workload | Usually start with | Why |
|---|---|---|
| 7B to 13B chat, internal copilots, lightweight RAG | L40S | Lower hourly cost can beat H100 when latency is acceptable and the model fits with KV cache headroom. |
| 30B-class models with moderate context | Benchmark both | L40S can win on cost; H100 can win when tail latency or memory bandwidth dominates. |
| 70B-class serving with strict latency | H100, H100 NVL, H200, or multi-GPU | H100 has much higher HBM bandwidth, larger memory on common SXM/NVL configurations, NVLink options, and stronger production serving support. |
| Batch inference with relaxed SLA | L40S first | Queue-friendly workloads can use cheaper capacity if utilization stays high. |
| Long-context RAG | H100 first | Prefill and KV-cache pressure usually reward HBM bandwidth and more memory. |
| Multi-tenant infrastructure | H100 if MIG matters | NVIDIA lists MIG support on H100; NVIDIA lists no MIG support on L40S. |
| Multimodal workloads with rendering, image/video, or graphics | L40S can be attractive | L40S is positioned by NVIDIA as a universal GPU for AI, graphics, rendering, and media acceleration. |
| High-concurrency customer-facing LLM API | H100 first | Tail latency, batching headroom, and software optimization often justify the premium. |
The practical rule: choose L40S when the cost floor matters and the workload fits cleanly. Choose H100 when latency, bandwidth, concurrency, sharding simplicity, or multi-GPU topology affects revenue or reliability.
Diferencias clave de especificaciones
NVIDIA posiciona L40S como una GPU de centro de datos Ada Lovelace para IA generativa, inferencia y entrenamiento de LLM, gráficos 3D, renderizado y vídeo. NVIDIA lista L40S con 48 GB de memoria GDDR6 ECC, 864 GB/s de ancho de banda de memoria, PCIe Gen4 x16, 350W de potencia máxima, Tensor Cores de cuarta generación, compatibilidad con FP8, sin MIG y sin compatibilidad con NVLink. NVIDIA posiciona H100 como una GPU de centro de datos Hopper para IA a gran escala y HPC, con un Transformer Engine dedicado, NVLink de cuarta generación, MIG y memoria HBM. Las especificaciones de producto de H100 de NVIDIA indican H100 SXM con 80 GB de memoria, 3.35 TB/s de ancho de banda, hasta 7 instancias MIG, 900 GB/s de NVLink y hasta 700W de TDP configurable; H100 NVL se indica con 94 GB por GPU, 3.9 TB/s de ancho de banda y 600 GB/s de NVLink. Fuentes: NVIDIA L40S y NVIDIA H100.
| Area | NVIDIA L40S | NVIDIA H100 SXM / H100 NVL | Buyer implication |
|---|---|---|---|
| Architecture | Ada Lovelace | Hopper | H100 is the flagship AI/HPC accelerator generation; L40S is a universal data center GPU. |
| Memory | 48 GB GDDR6 ECC | 80 GB HBM on H100 SXM; 94 GB HBM on H100 NVL | H100 has more room for larger models, longer context, and higher concurrency. |
| Memory bandwidth | 864 GB/s | 3.35 TB/s on H100 SXM; 3.9 TB/s on H100 NVL | H100 has a large advantage for bandwidth-bound prefill, decode, and KV-cache movement. |
| FP8 Tensor Core peak with sparsity | 1,466 TFLOPS | 3,958 TFLOPS on H100 SXM; 3,341 TFLOPS on H100 NVL | H100 has a much higher ceiling when the serving stack and accuracy policy can use FP8. |
| Interconnect | PCIe Gen4 x16; no NVLink | PCIe Gen5 plus NVLink on SXM/NVL configurations | H100 is stronger for scale-up and multi-GPU inference. |
| MIG | No | Up to 7 MIG instances | H100 is better when you need hardware partitioning for utilization or isolation. |
| Max power | 350W | Up to 700W on SXM; 350-400W on NVL | L40S may be easier to place in lower-power servers; H100 can finish more work per GPU. |
Estas especificaciones explican por qué un benchmark de L40S vs H100 genérico puede confundir una decisión de compra. H100 tiene el techo técnico. L40S aún puede ganar cuando H100 cuesta varias veces más y la aplicación no aprovecha todo ese techo.
Fórmula de rendimiento por dólar
Para inferencia, compara la salida aceptada, no los FLOPS teóricos brutos:
accepted_output_per_dollar =
  accepted output tokens or accepted responses per hour
  / effective hourly cost
Luego incluya el costo oculto:
effective_hourly_cost =
  GPU hourly rate
  + storage and snapshot cost
  + network and egress cost
  + idle capacity cost
  + retry and failed request cost
  + orchestration or managed-service overhead
La regla de punto de equilibrio es simple:
H100 required speedup over L40S =
  H100 effective hourly cost / L40S effective hourly cost
Si H100 cuesta 3 veces más que L40S, H100 debe ofrecer más de 3 veces la salida aceptada por hora para ganar en rendimiento por dólar antes de contar el valor de negocio de una menor latencia. Si H100 cuesta 1.8 veces más, el listón es más bajo. Si L40S provoca reintentos por OOM, un tamaño de lote bajo o incumplimiento de la latencia p99, el precio horario más barato no es el servicio más barato.
Para una hoja de cálculo más amplia de costos ocultos, consulte la guía de Flatkey sobre precios de alquiler de GPU.
Ejemplos de precios públicos verificados el 12 de octubre de 2026
Los precios públicos de GPU no son tarifas permanentes. Varían según el proveedor, la región, la disponibilidad, el nivel de seguridad, la reserva, la unidad de facturación y si la capacidad es de marketplace, dedicada, bajo demanda o comprometida.
| Proveedor página | Ejemplo L40S | Ejemplo H100 | Lo que muestra |
|---|---|---|---|
| Precios de RunPod | L40S: Community Cloud $0.79/h, Secure Cloud $1.09/h | H100 PCIe: Community Cloud $1.99/h, Secure Cloud $2.89/h; H100 SXM: Community Cloud $2.69/h, Secure Cloud $3.49/h; H100 NVL: Community Cloud $2.59/h, Secure Cloud $3.19/h | Las filas de cotización directa pueden hacer que H100 cueste aproximadamente entre 2.5x y 3.4x la tarifa horaria de L40S antes de los costos ocultos. |
| Precios de Lambda | No se encontró una fila directa de L40S en el HTML público de precios revisado para este artículo | Las filas de H100 están expuestas en configuraciones de autoservicio y de clúster, incluidos ejemplos de H100 SXM y H100 PCIe | La cobertura del proveedor difiere; no asuma que todos los GPU de la lista corta están disponibles en todos los vendedores. |
Con los ejemplos de RunPod Community Cloud, el punto de equilibrio del aumento de velocidad se ve así:
| Comparación | Precio H100 | Precio L40S | Prima de precio de H100 | Significado del punto de equilibrio |
|---|---|---|---|---|
| H100 PCIe vs L40S | $1.99/h | $0.79/h | 2.52x | H100 PCIe necesita más de 2.52x la salida aceptada por hora para ganar en alquiler bruto de GPU. |
| H100 SXM vs L40S | $2.69/h | $0.79/h | 3.41x | H100 SXM necesita una gran ganancia de rendimiento o una razón de latencia/negocio para justificar la prima. |
| H100 NVL vs L40S | $2.59/h | $0.79/h | 3.28x | H100 NVL necesita que su ventaja de memoria/interconexión importe en la carga de trabajo. |
| Secure H100 SXM vs Secure L40S | $3.49/h | $1.09/h | 3.20x | La capacidad segura cambia la tarifa absoluta, pero la idea del punto de equilibrio sigue siendo la misma. |
No use estas filas como verdad universal. Úselas para entender las matemáticas: una decisión de rendimiento de inferencia NVIDIA L40S vs H100 cambia cuando cambia la cotización.
Dónde gana L40S
Por lo general, L40S merece el primer lugar en las pruebas de referencia cuando la carga de trabajo es sensible al costo y está contenida técnicamente:
- El modelo es de 7B, 8B, 13B o una ruta cuantizada de clase 30B que cabe en 48 GB con margen para KV-cache.
- El tráfico es por lotes, asíncrono, interno o tolerante a una latencia p95 más alta.
- Puede mantener L40S utilizado con colas en lugar de sobredimensionarlo para una respuesta instantánea.
- Necesita una GPU universal que también pueda manejar renderizado, medios, generación de imágenes o cargas creativas mixtas.
- La cotización de su proveedor hace que H100 sea entre 2.5x y 4x más caro.
- Su marco de serving muestra una latencia p95/p99 aceptable en prompts realistas.
L40S también resulta atractivo para equipos que construyen productos de inferencia tempranos. Si la elección del modelo, la forma del prompt y el tráfico aún están cambiando, una GPU de menor costo puede hacer que la experimentación sea más barata mientras recopila datos reales de demanda.
Dónde gana H100
Por lo general, H100 merece el primer lugar en las pruebas de referencia cuando la latencia, la concurrencia, el ancho de banda de memoria o el serving de modelos grandes impulsan la factura:
- RAG de contexto largo pone a prueba el prefill y el movimiento de KV-cache.
- La latencia p95 o p99 afecta la conversión, la retención o la carga de soporte.
- El modelo es lo suficientemente grande como para que 48 GB en L40S obliguen a una cuantización agresiva, tamaños de lote pequeños o paralelismo de tensores.
- Necesita MIG para aislamiento multiinquilino o mayor utilización.
- Necesita NVLink, NVSwitch o escalado al estilo H100 NVL para inferencia de clase 70B.
- Su stack puede aprovechar FP8 o kernels optimizados para Hopper sin degradación de calidad.
- La reducción en la cantidad de GPU compensa la prima horaria.
H100 no trata solo de la velocidad máxima. También puede simplificar la producción cuando un H100 reemplaza varias GPUs de gama baja, evita el fraccionamiento del modelo o mantiene la latencia de cola dentro del SLA.
Los detalles de la carga de trabajo que cambian al ganador
El error más común en la comparación de rendimiento NVIDIA L40S vs H100 es probar una sola longitud de prompt y un solo nivel de concurrencia. El serving de LLM tiene diferentes cuellos de botella:
| Dimensión de la carga de trabajo | Por qué importa |
|---|---|
| Tamaño del modelo | Un modelo de 7B y un modelo de 70B no ejercen la memoria, el ancho de banda ni la interconexión de la misma manera. |
| Precisión y cuantización | FP8, FP16, BF16, INT8, AWQ, GPTQ y otras rutas cambian tanto la calidad como el rendimiento. |
| Longitud del contexto | Los prompts largos desplazan el costo hacia el prefill y la presión sobre la KV-cache. |
| Longitud de la salida | Las respuestas largas desplazan el costo hacia el rendimiento de decodificación y la programación. |
| Concurrencia | Una GPU que gana con tamaño de lote 1 puede perder bajo tráfico real. |
| Tasa de aceptación | Las salidas fallidas, por tiempo de espera agotado o de baja calidad no cuentan como rendimiento productivo. |
| Framework de serving | vLLM, SGLang, TensorRT-LLM, NVIDIA NIM y los servidores personalizados tienen distintas rutas de optimización. |
| Forma del proveedor | CPU, RAM, NVMe local, red, tiempo de inicio de la imagen y riesgo de vecinos ruidosos pueden dominar un listado de GPU barata. |
Si estás eligiendo una pila de serving al mismo tiempo, la guía de Flatkey sobre vLLM vs SGLang ofrece un marco independiente para medir rendimiento, latencia, compatibilidad con modelos y operaciones.
Plan de benchmark para inferencia con L40S vs H100
Ejecuta la misma reproducción en L40S y H100. Mantén fijos los criterios de aceptación.
| Paso | Qué medir | Por qué |
|---|---|---|
| 1. Congelar la carga de trabajo | ID del modelo, cuantización, distribución de contexto, límite de salida, verificaciones de calidad | Evita resultados falsos de comparación entre iguales. |
| 2. Congelar la pila de serving | vLLM, SGLang, TensorRT-LLM, NIM, CUDA, controlador, imagen del contenedor | Los cambios de software pueden ocultar los efectos del hardware. |
| 3. Ejecutar una escalera de concurrencia | 1, 4, 8, 16, 32, 64, o tu patrón real de tráfico | Muestra cuándo se satura cada GPU. |
| 4. Separar prefill y decode | Tiempo hasta el primer token, tokens de prompt por segundo, tokens de salida por segundo | Revela si el cuello de botella es el ancho de banda o la decodificación. |
| 5. Rastrear la latencia de cola | p50, p95, p99, tiempo de espera en cola, tasa de timeout | Las decisiones de compra deben proteger la experiencia del usuario. |
| 6. Rastrear la utilización | Utilización de GPU, memoria usada, presión de ancho de banda HBM/GDDR, espera de CPU, espera de almacenamiento | Confirma que la GPU es realmente el cuello de botella. |
| 7. Contar fallos | OOM, expulsiones, hosts defectuosos, arranques en frío, tormentas de reintentos | El trabajo fallido pertenece al costo por salida aceptada. |
| 8. Calcular el costo aceptado | Costo por 1M de tokens de salida aceptados, por respuesta aceptada o por trabajo completado | Las compras necesitan costo normalizado, no capturas de pantalla de benchmarks. |
Reproducción mínima:
100 short prompts
100 medium prompts
100 long-context prompts
same model
same precision or quantization policy
same max output tokens
same server version
same concurrency ladder
same quality and acceptance checks
Tabla de decisión:
| Métrica | Resultado de L40S | Resultado de H100 |
|---|---|---|
| Precio horario de la GPU | ||
| Costo horario efectivo | ||
| Respuestas aceptadas/hora | ||
| Tokens de salida aceptados/hora | ||
| Costo por 1M de tokens de salida aceptados | ||
| Tiempo hasta el primer token p95 | ||
| Latencia de extremo a extremo p95/p99 | ||
| Tasa de OOM o reintento | ||
| Utilización media de la GPU | ||
| Notas operativas |
Este es el activo de valor para un benchmark L40S vs H100 real: el ganador es la GPU con el menor costo aceptado al nivel de latencia y confiabilidad que requiere tu producto.
Lista de verificación de compras
Antes de alquilar o comprar cualquiera de las dos GPU, pide:
- SKU exacto: L40S, H100 PCIe, H100 SXM, H100 NVL, tamaño de memoria y factor de forma.
- Forma del nodo: cantidad de GPU, CPU, RAM, NVMe local, red y si las GPU comparten una interconexión potente.
- Unidad de facturación: por segundo, minuto, hora, mes o plazo comprometido.
- Modo de capacidad: marketplace, nube segura, dedicado, reservado, spot o clúster.
- Política de interrupción y reemplazo.
- Requisitos de región, cumplimiento, tenencia y manejo de datos.
- Precios de almacenamiento y snapshots.
- Política de salida de datos y ancho de banda.
- Compatibilidad con controlador, CUDA, contenedor y framework de serving.
- Observabilidad: utilización, memoria, encolamiento, p95/p99, OOM, reintentos y costo por ruta.
- SLA de soporte y ruta de escalamiento.
Para una lista de verificación más amplia a nivel de clúster, consulta la guía de Flatkey sobre alquiler de clústeres GPU.
Cuando una API de modelo supera a cualquiera de las dos GPU
La respuesta correcta a L40S vs H100 también puede ser "ninguna de las dos". Alquilar GPU tiene sentido cuando tienes pesos propietarios, utilización sostenida, control estricto de latencia, kernels personalizados, requisitos de localización de datos o un equipo listo para operar infraestructura de inferencia.
Usa una API de modelo o un router cuando:
- El tráfico es intermitente.
- La elección del modelo cambia con frecuencia.
- Necesitas respaldo entre proveedores.
- No necesitas alojar pesos personalizados.
- El tiempo de inactividad de la GPU superaría cualquier prima de la API.
- Finanzas necesita registros de uso a nivel de solicitud, presupuestos por subclave, facturas y atribución de costos.
Flatkey encaja en ese lado de la decisión: una clave, un saldo, una factura, endpoints oficiales de modelos y registros de uso a nivel de solicitud a través de rutas de modelo. Compara el costo por token aceptado de una L40S o H100 dedicada frente a rutas de modelo administradas antes de comprometerte con capacidad de GPU a largo plazo.
Para trabajos relacionados con costos, consulta las guías de Flatkey sobre la mejor GPU para inferencia de LLM, H100 vs A100, H200 vs H100, comparación de precios de modelos de IA y gestión del gasto en API de IA.
Recomendación final
Para la mayoría de desarrolladores independientes y pequeños equipos de IA que comparan L40S vs H100, empieza con esta regla:
- Elige L40S cuando el modelo encaje, la latencia sea moderada, el tráfico pueda hacer cola y la H100 cueste más de 2x a 3x por hora.
- Elige H100 cuando el ancho de banda de memoria, una memoria más grande, NVLink, MIG, alta concurrencia, contexto largo o la latencia p95/p99 determinen el resultado del producto.
- Haz pruebas comparativas de ambas cuando la carga sea de clase 30B, de contexto mixto o esté cerca del límite de memoria de 48 GB.
- Compara ambas con una API de modelo administrada cuando la utilización sea incierta o la elección del modelo cambie con frecuencia.
La decisión más sólida de rendimiento NVIDIA L40S vs H100 no es una ganadora genérica del benchmark. Es la GPU que produce el menor costo por salida aceptada mientras cumple tu objetivo de latencia y fiabilidad.
FAQ de L40S vs H100
¿Es la H100 más rápida que la L40S para inferencia de IA?
Sí, la H100 tiene un techo técnico mucho más alto para la inferencia de IA, especialmente cuando importan el ancho de banda de memoria, el rendimiento FP8, una memoria más grande, NVLink y el serving optimizado para Hopper. La L40S aún puede ganar en rendimiento por dólar cuando la carga encaja y la prima por hora de la H100 es demasiado alta.
¿La L40S es buena para inferencia de LLM?
Sí. NVIDIA posiciona la L40S para IA generativa e inferencia/entrenamiento de LLM, y enumera 48 GB de memoria GDDR6 ECC además de Tensor Cores de cuarta generación con soporte FP8. Es especialmente fuerte para modelos pequeños y medianos, inferencia por lotes, cargas mixtas de IA/gráficos y serving sensible al costo.
¿Debería usar L40S o H100 para modelos de 70B?
Empieza con H100, H100 NVL, H200 o una configuración multinodo/GPU para inferencia de producción de clase 70B, especialmente con contexto largo o objetivos estrictos de latencia. La L40S puede funcionar para experimentos limitados o cuantizados, pero la memoria de 48 GB puede limitar la concurrencia y el margen del KV-cache.
¿Cuál es la mejor métrica para L40S vs H100?
Usa el costo por salida aceptada al objetivo de latencia. Seguimiento de tokens de salida aceptados por hora, respuestas aceptadas por hora, latencia p95/p99, tasa de reintento, tasa de OOM, utilización y costo horario efectivo.
¿Un benchmark de L40S vs H100 es suficiente para comprar capacidad?
Solo si el benchmark reproduce tu mezcla real de prompts, longitudes de contexto, longitudes de salida, concurrencia, verificaciones de calidad y entorno del proveedor. Un resultado genérico de tokens/segundo es útil, pero no es una decisión de compra por sí solo.


