
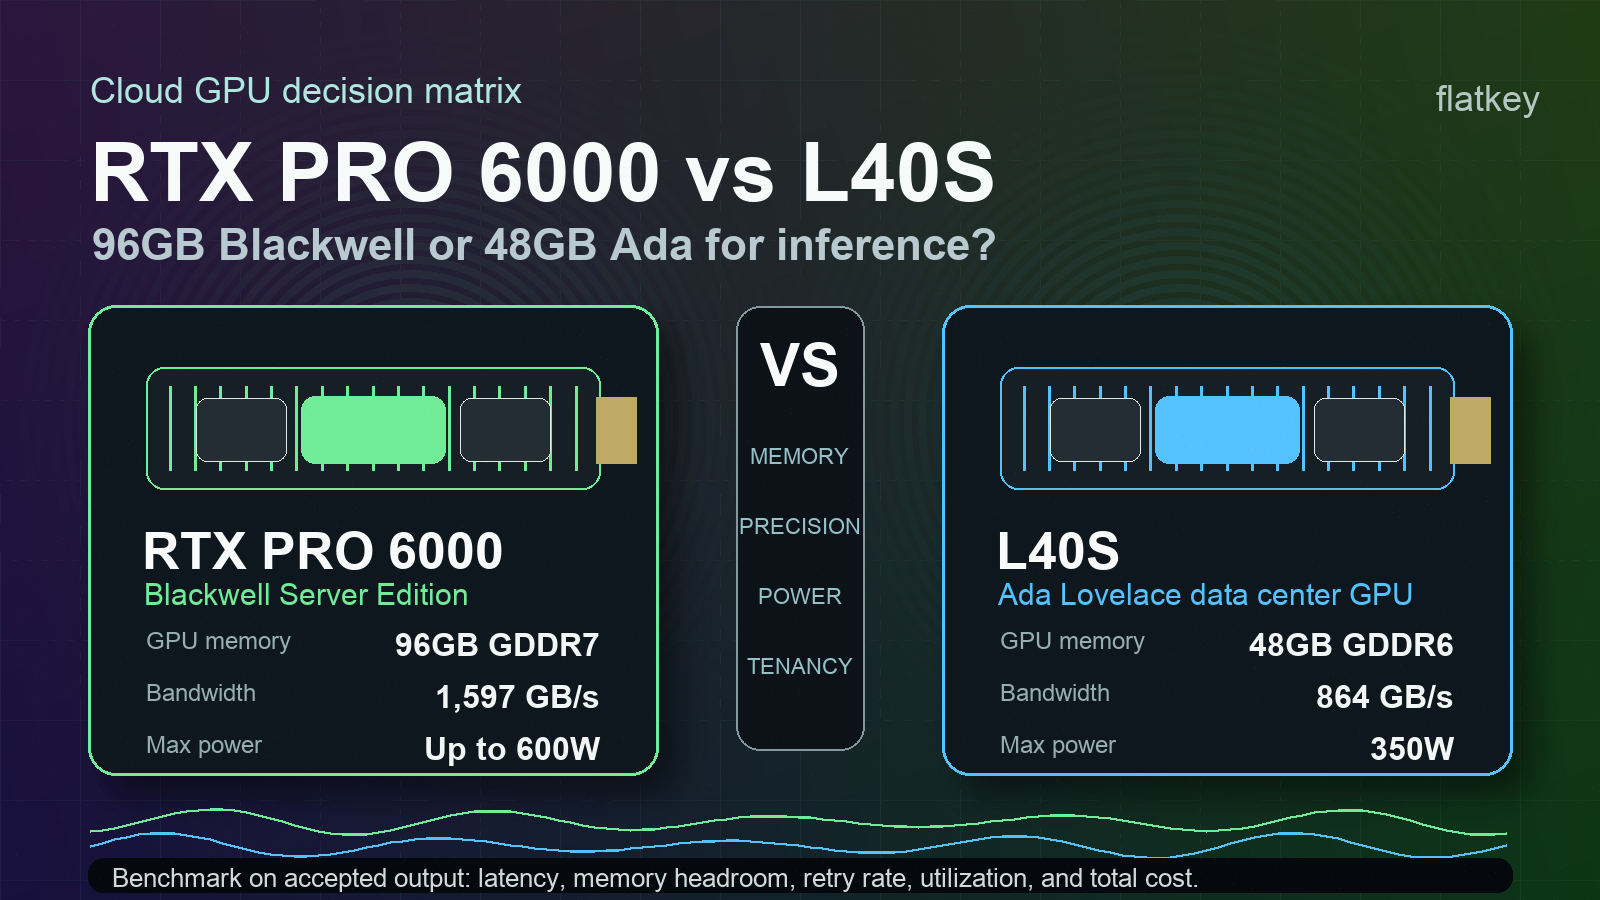
RTX PRO 6000 vs L40S: 96GB Blackwell atau GPU Inferensi Ada?
Jawaban singkat untuk l40s vs rtx pro 6000: pilih NVIDIA RTX PRO 6000 Blackwell Server Edition ketika 96GB memori GPU, dukungan Blackwell FP4, PCIe Gen 5, partisi MIG, dan mesin media yang lebih baru dapat mengubah desain serving Anda. Pilih NVIDIA L40S ketika workload Anda sudah muat dalam 48GB, stack Anda sudah matang di GPU Ada, dan selisih harga atau ketersediaannya cukup besar untuk mengalahkan kartu yang lebih baru.
Ini bukan keputusan yang bersih seperti "GPU baru selalu menang". Perbandingan rtx pro 6000 vs l40s sebenarnya tentang kecocokan memori, dukungan presisi, kematangan perangkat lunak, anggaran daya, dan biaya output yang diterima. Jika RTX PRO 6000 memungkinkan Anda memakai lebih sedikit shard, window konteks yang lebih besar, batch yang lebih besar, atau retry out-of-memory yang lebih sedikit, GPU ini bisa menjadi GPU inferensi yang lebih kuat. Jika kapasitas L40S lebih murah, lebih mudah dipesan, dan sudah memenuhi target latensi Anda, kartu Ada yang lebih lama masih bisa menjadi pilihan yang pragmatis.
Diperiksa pada 13 Oktober 2026.
L40S vs RTX PRO 6000: perbedaan praktisnya
Gunakan tabel ini sebagai penyaringan pengadaan pertama sebelum Anda meminta benchmark dari penyedia.
| Poin keputusan | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| Generasi GPU | Blackwell | Ada Lovelace |
| Alasan utama pembeli | Memori lebih besar, Tensor Core lebih baru, jalur FP4, PCIe Gen 5, partisi workload | GPU data center 48GB yang matang untuk inferensi, rendering, grafis, dan video |
| Memori GPU | 96GB GDDR7 dengan ECC | 48GB GDDR6 dengan ECC |
| Bandwidth memori | 1.597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Sorotan presisi Tensor | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1.466 TFLOPS dengan sparsity, FP16/BF16 362,05 / 733 TFLOPS dengan sparsity |
| Daya maksimum | Hingga 600W yang dapat dikonfigurasi | 350W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | Hingga empat instance terisolasi pada RTX PRO 6000 | Tidak ada dukungan MIG yang tercantum untuk L40S |
| Uji pertama terbaik | Inferensi LLM konteks panjang, model multimodal yang lebih besar, berbagi GPU multi-tenant, serving yang dioptimalkan FP4/Blackwell | LLM yang ramah 48GB, pembuatan gambar gaya Stable Diffusion, rendering, video, fleet Ada yang matang |
Sumber: halaman produk NVIDIA RTX PRO 6000 Blackwell Server Edition, halaman produk NVIDIA L40S, dan halaman arsitektur Blackwell NVIDIA.
Rekomendasi cepat
Mulailah benchmark l40s vs rtx pro 6000 dari memori, bukan TFLOPS puncak.
- Pilih RTX PRO 6000 Blackwell Server Edition ketika model Anda dibatasi memori pada L40S, ketika panjang konteks atau tekanan KV cache mendorong jumlah GPU, ketika Anda ingin menguji jalur inferensi FP4/Blackwell, atau ketika potongan GPU terisolasi penting untuk cluster enterprise bersama.
- Pilih L40S ketika model, ukuran batch, dan window konteks Anda muat dengan nyaman dalam 48GB, ketika stack produksi Anda sudah disetel untuk Ada, atau ketika perbedaan harga penyedia cukup besar sehingga GPU yang lebih lama menang dalam biaya output yang diterima.
- Gunakan baseline API model ketika Anda tidak memerlukan bobot kustom, kontrol CUDA, penjadwalan GPU privat, atau akselerasi media/rendering langsung. Perangkat keras harus mengalahkan biaya dan kesederhanaan operasional panggilan model terkelola setelah antrean, retry, waktu idle, dan overhead engineering.
Poin terakhir itu adalah alasan mengapa keputusan nvidia rtx pro 6000 vs l40s tidak boleh berhenti pada lembar spesifikasi. Kartu yang lebih cepat tetap bisa menjadi pembelian yang salah jika utilisasinya rendah atau tim tidak perlu memiliki operasi GPU.
Mengapa RTX PRO 6000 mengubah percakapan tentang inferensi
RTX PRO 6000 Blackwell Server Edition menggandakan kapasitas memori yang tercantum dibanding L40S: 96GB GDDR7 alih-alih 48GB GDDR6. Kartu ini juga meningkatkan bandwidth memori yang tercantum dari 864 GB/s pada L40S menjadi 1.597 GB/s.
Untuk tim inferensi, memori bukan hanya "ukuran model." Memori juga mencakup KV cache, ruang untuk batching, buffer runtime, adapter, input multimodal, margin aman untuk prompt panjang, dan overhead tenancy. Dalam layanan nyata, kartu yang menghindari error out-of-memory atau mengurangi sharding tensor-parallel dapat mengalahkan kartu yang lebih murah dengan biaya per jam yang tercantum lebih rendah.
RTX PRO 6000 sangat layak diuji ketika:
- Anda melayani trafik LLM konteks panjang dan KV cache mendominasi perencanaan memori.
- Anda ingin menguji model kuantisasi kelas 70B atau lebih besar dengan lebih sedikit shard.
- Anda menjalankan beban kerja multimodal campuran di mana komponen image, video, embedding, reranking, dan LLM bersaing untuk memori.
- Anda perlu mempartisi GPU fisik untuk beberapa pengguna atau workload; NVIDIA mencantumkan hingga empat instance MIG terisolasi untuk RTX PRO 6000.
- Anda sedang mengevaluasi jalur serving spesifik Blackwell seperti FP4/NVFP4, TensorRT-LLM, vLLM, atau peningkatan SGLang.
Trade-off dayanya nyata. NVIDIA mencantumkan RTX PRO 6000 hingga 600W yang dapat dikonfigurasi, sementara L40S adalah 350W. Jika penyedia Anda menetapkan harga berdasarkan server yang dikomit, envelope daya, kepadatan rak, atau kapasitas reservasi, plafon yang lebih tinggi itu harus masuk dalam model biaya rtx 6000 pro vs l40s. Jangan bandingkan harga GPU per jam tanpa menanyakan apa saja yang termasuk: daya, pendinginan, konfigurasi host, dukungan, dan tenancy.
Mengapa L40S masih berguna
L40S tetap menjadi GPU praktis yang kuat karena merupakan kartu data center Ada yang matang dengan memori ECC 48GB, bandwidth memori 864 GB/s, daya maksimum 350W, dan familiaritas produksi yang luas. NVIDIA memposisikan L40S untuk AI generatif, pelatihan dan inferensi LLM, grafis, rendering, Omniverse, dan beban kerja video.
Kematangan itu penting dalam pengadaan cloud. Kartu yang sedikit lebih lama bisa menang ketika:
- Kapasitas tersedia sekarang di region yang Anda butuhkan secara tepat.
- Image provider, driver, container, dan monitoring sudah stabil.
- Beban kerja muat di dalam 48GB tanpa sharding agresif.
- Hambatan Anda adalah waktu antre, loading data, preprocessing CPU, atau penjadwalan software, bukan puncak Tensor Core mentah.
- Anda menjalankan pekerjaan pembuatan gambar, rendering, video, atau komputasi visual yang sudah memiliki hasil benchmark baik di Ada.
Pertanyaan nvidia l40s vs rtx pro 6000 sering kali bergantung pada apakah tambahan 48GB pada RTX PRO 6000 mengubah bentuk deployment. Jika tidak, L40S bisa menjadi opsi sewa atau kapasitas cadangan yang berisiko lebih rendah, terutama untuk tim dengan script dan baseline yang sudah ada.
Matriks keputusan per beban kerja
Gunakan matriks ini sebelum Anda meminta penawaran ke provider.
| Beban kerja | Pilih RTX PRO 6000 jika... | Pilih L40S jika... | Apa yang diukur |
|---|---|---|---|
| Inferensi LLM konteks panjang | 48GB membatasi panjang konteks, ukuran batch, atau headroom KV cache | 48GB memenuhi target p95 konteks dan concurrency | Waktu ke token pertama, token/detik, latensi p95, tingkat OOM, respons yang diterima/jam |
| Penyajian model kelas 70B terkuantisasi | 96GB mengurangi sharding, retry, atau kompleksitas penempatan | Model terkuantisasi Anda dan KV cache muat di L40S pada concurrency target | Jumlah GPU per replika, delay antrean, skor kualitas, tingkat retry |
| Inferensi multi-tenant | Isolasi MIG dan memori 96GB meningkatkan utilisasi | Tenancy ditangani di level node atau scheduler | Utilisasi per tenant, insiden noisy-neighbor, job yang gagal |
| Stable Diffusion dan pembuatan gambar | Model lebih besar, batch, atau tahap mixed media membutuhkan lebih banyak memori | Pipeline yang sudah ada sudah memenuhi target throughput dan kualitas | Gambar yang diterima/jam, headroom VRAM, biaya per gambar yang diterima |
| Rendering dan grafis 3D | Fitur RT/media Blackwell meningkatkan renderer atau pipeline yang spesifik | Performa Ada L40S sudah divalidasi untuk renderer | Waktu frame/render, render gagal, throughput encode/decode media |
| Pembaruan enterprise | Anda menginginkan platform era Blackwell untuk 24 bulan ke depan | Anda membutuhkan kapasitas tambahan dengan operasi yang sudah dikenal | Lantai utilisasi, upaya migrasi, SLA dukungan, ketersediaan kapasitas |
Ini adalah cara yang berguna untuk membingkai l40s vs rtx 6000 pro: bukan produk mana yang memiliki angka lebih besar di halaman spesifikasi, melainkan GPU mana yang mengubah jumlah output yang diterima yang dapat Anda kirim per dolar.
Benchmark output yang diterima, bukan spesifikasi puncak
Benchmark l40s vs rtx pro 6000 yang serius harus menjalankan ulang beban kerja Anda, bukan mengandalkan puncak umum. Ukur output yang diterima pengguna atau pelanggan Anda.
Untuk inferensi LLM, kumpulkan:
| Metrik | Mengapa penting |
|---|---|
| Waktu ke token pertama | Mengukur latensi pengguna interaktif |
| Latensi antar-token | Menunjukkan perilaku decode pada concurrency nyata |
| Concurrency stabil | Menunjukkan apakah 48GB atau 96GB mengubah batching |
| Tangga panjang konteks | Menemukan kapan tekanan KV cache muncul |
| Tingkat OOM dan retry | Mengubah kecocokan memori menjadi biaya nyata |
| Respons yang diterima per jam | Menormalkan filter kualitas, kegagalan, dan retry |
| Biaya per 1 juta token output yang diterima | Memungkinkan RTX PRO 6000, L40S, dan API model berbagi satu metrik |
| Jam engineering per bulan | Mengukur tenaga kerja driver, kernel, antrean, insiden, dan benchmark |
Untuk beban kerja gambar, video, rendering, atau multimodal, gantikan token yang diterima dengan gambar yang diterima, klip yang diterima, frame yang dirender, atau job yang selesai. Logikanya sama. Kartu yang terlihat lebih cepat pada benchmark vendor bisa kalah jika kartu tersebut meningkatkan kontensi antrean, membuat lebih banyak job gagal, atau memerlukan migrasi software yang tidak dapat dipelihara tim Anda.
Pertanyaan ke provider sebelum menyewa RTX PRO 6000 atau L40S
Ajukan pertanyaan-pertanyaan ini sebelum berkomitmen pada salah satu GPU:
- Apakah kapasitas RTX PRO 6000 secara spesifik adalah Blackwell Server Edition, dan apakah itu dual-slot berpendingin udara atau single-slot berpendingin cairan?
- Apakah kapasitas L40S bersifat dedicated, fractional, containerized, atau bagian dari managed job service?
- Versi driver, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch, dan container apa yang didukung?
- Apakah provider mengekspos MIG di RTX PRO 6000, dan bagaimana instance ditagih?
- Apakah run benchmark ditagih dengan tarif on-demand, tarif reserved, atau termasuk dalam jendela evaluasi?
- Apa region, fabric jaringan, host CPU, kelas storage, dan kapasitas NVMe lokalnya?
- Apakah job yang gagal, waktu idle, waktu antre, snapshot, dan egress ditagih terpisah?
- SLA dukungan dan jalur penggantian apa yang berlaku ketika host GPU tidak sehat?
- Bisakah Anda mengekspor utilisasi GPU per job, penggunaan memori, delay antrean, tingkat retry, dan biaya?
- Apa jalur fallback jika ketersediaan, driver, atau kernel Blackwell tertinggal dari jadwal peluncuran Anda?
Padukan jawaban tersebut dengan panduan harga sewa GPU Flatkey, worksheet TCO klaster GPU, dan GPU cloud vs API model. Jika Anda masih menentukan kelas GPU, baca panduan GPU terbaik untuk inferensi LLM yang lebih luas sebelum mengerucut ke nvidia l40s vs rtx pro 6000.
Di mana Flatkey cocok
Flatkey tidak menggantikan RTX PRO 6000 atau L40S ketika Anda membutuhkan kontrol GPU langsung. Jika Anda menjalankan bobot privat, kernel kustom, locality data yang ketat, pipeline rendering khusus, atau riset di level hardware, Anda tetap memerlukan kapasitas GPU cloud atau infrastruktur milik sendiri.
Flatkey adalah baseline yang harus dikalahkan ketika tim Anda terutama membutuhkan output model yang andal. Dengan satu kunci dan satu saldo di seluruh model resmi dan alat AI, tim dapat merutekan beban kerja API, melacak penggunaan, membandingkan biaya model, dan menghindari akun penyedia yang terpencar. Itu memberi keuangan dan engineering kelompok kontrol yang rapi sebelum berkomitmen pada kapasitas GPU tetap.
Dalam praktiknya, jalankan tiga jalur:
| Jalur | Kapan unggul |
|---|---|
| RTX PRO 6000 | Memori yang lebih besar atau fitur Blackwell mengurangi jumlah GPU, kegagalan, atau latensi cukup banyak untuk menutupi biaya yang lebih tinggi |
| L40S | 48GB sudah cukup dan kapasitas Ada yang matang memiliki harga output-terima terbaik |
| API model terkelola melalui Flatkey | Kontrol GPU langsung tidak diperlukan dan kesederhanaan operasional mengalahkan kepemilikan infrastruktur |
Pemenang yang tepat adalah jalur dengan biaya per output yang diterima terendah pada target kualitas dan latensi Anda.
Rekomendasi akhir
Untuk l40s vs rtx pro 6000, jadikan RTX PRO 6000 tolok ukur pertama Anda ketika ruang memori, dukungan FP4/Blackwell, PCIe Gen 5, atau partisi MIG dapat mengubah arsitektur serving. Jadikan L40S tolok ukur pertama Anda ketika beban kerja sudah muat di dalam 48GB dan kapasitas Ada yang matang lebih murah atau lebih mudah dipesan.
Kemudian bandingkan keduanya dengan baseline model/API. Jika Flatkey atau rute API terkelola lainnya memenuhi persyaratan kualitas, latensi, privasi, dan biaya, sewa GPU harus dapat membenarkan tambahan pekerjaan operasionalnya. Jika tidak bisa, jalur hardware layak dipilih, dan keputusan akhir menjadi replay beban kerja: rtx pro 6000 vs l40s berdasarkan output yang diterima, bukan puncak marketing.
Pertanyaan yang sering diajukan
Apakah RTX PRO 6000 Blackwell lebih cepat daripada L40S?
Pada spesifikasi publik NVIDIA, RTX PRO 6000 Blackwell Server Edition memiliki performa FP32 yang tercantum lebih tinggi, memori lebih besar, bandwidth memori lebih besar, Tensor Cores yang lebih baru, dan dukungan FP4. Itu tidak berarti lebih murah untuk setiap beban kerja. Benchmark tumpukan serving Anda yang spesifik dan biaya output yang diterima.
Apakah L40S masih bagus untuk inferensi LLM?
Ya, ketika model, ukuran context window, dan target concurrency muat di dalam 48GB. L40S masih bisa praktis untuk inferensi LLM, pembuatan gambar, rendering, video, dan beban kerja komputasi visual campuran, terutama ketika kapasitas penyedia sudah matang.
Apa perbedaan terbesar NVIDIA RTX PRO 6000 vs L40S?
Perbedaan praktis terbesar adalah memori. RTX PRO 6000 Blackwell Server Edition mencantumkan 96GB GDDR7 dan bandwidth memori 1.597 GB/s; L40S mencantumkan 48GB GDDR6 dan bandwidth memori 864 GB/s. RTX PRO 6000 juga menambahkan jalur Blackwell FP4 dan dukungan MIG.
Haruskah saya upgrade dari L40S ke RTX PRO 6000?
Upgrade ketika batas memori L40S menyebabkan shard tambahan, batch yang lebih kecil, context window yang lebih pendek, job gagal, atau utilisasi rendah. Tetap di L40S ketika sudah memenuhi target latensi dan kualitas Anda dengan biaya output yang diterima lebih rendah.
Haruskah saya menggunakan API model alih-alih menyewa salah satu GPU ini?
Gunakan API model ketika Anda tidak memerlukan bobot kustom, kontrol CUDA langsung, penjadwalan GPU privat, atau akselerasi rendering/media. API model bisa menjadi jalur ekonomi yang lebih baik ketika permintaan beban kerja volatil atau utilisasi GPU akan rendah.
Sumber yang diperiksa
- Halaman produk NVIDIA RTX PRO 6000 Blackwell Server Edition
- Halaman produk NVIDIA L40S
- Halaman arsitektur NVIDIA Blackwell
- Peta topik GPU Cloud Flatkey dan sumber keyword Cloud GPU bertanggal 2026-10-10
- Gambaran produk Flatkey dan positioning yang disetujui: satu kunci, satu saldo, model resmi, buku besar penggunaan bayar-per-panggilan-berhasil


