
RTX PRO 6000 vs L40S: GPU suy luận Blackwell 96GB hay Ada?
Câu trả lời ngắn cho l40s vs rtx pro 6000: hãy chọn NVIDIA RTX PRO 6000 Blackwell Server Edition khi 96GB bộ nhớ GPU, hỗ trợ Blackwell FP4, PCIe Gen 5, phân vùng MIG và các bộ máy media mới hơn có thể thay đổi thiết kế triển khai của bạn. Hãy chọn NVIDIA L40S khi workload của bạn đã vừa trong 48GB, stack của bạn đã trưởng thành trên GPU Ada, và chênh lệch về giá hoặc khả dụng đủ lớn để vượt qua card mới hơn.
Đây không phải là quyết định kiểu “GPU mới luôn thắng” một cách rõ ràng. So sánh rtx pro 6000 vs l40s thực chất là về độ vừa của bộ nhớ, hỗ trợ độ chính xác, độ trưởng thành của phần mềm, ngân sách điện năng và chi phí trên mỗi đầu ra được chấp nhận. Nếu RTX PRO 6000 cho phép bạn dùng ít shard hơn, context window lớn hơn, batch lớn hơn hoặc ít lần retry do out-of-memory hơn, nó có thể là GPU suy luận mạnh hơn. Nếu năng lực của L40S rẻ hơn, dễ đặt trước hơn và đã đáp ứng mục tiêu độ trễ của bạn, card Ada cũ hơn vẫn có thể là lựa chọn thực dụng.
Đã kiểm tra vào ngày 13 tháng 10 năm 2026.
L40S vs RTX PRO 6000: khác biệt thực tế
Hãy dùng bảng này như bước sàng lọc mua sắm đầu tiên trước khi bạn yêu cầu benchmark từ nhà cung cấp.
| Điểm quyết định | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| Thế hệ GPU | Blackwell | Ada Lovelace |
| Lý do mua chính | Nhiều bộ nhớ hơn, Tensor Core mới hơn, đường dẫn FP4, PCIe Gen 5, phân vùng workload | GPU trung tâm dữ liệu 48GB trưởng thành cho suy luận, rendering, đồ họa và video |
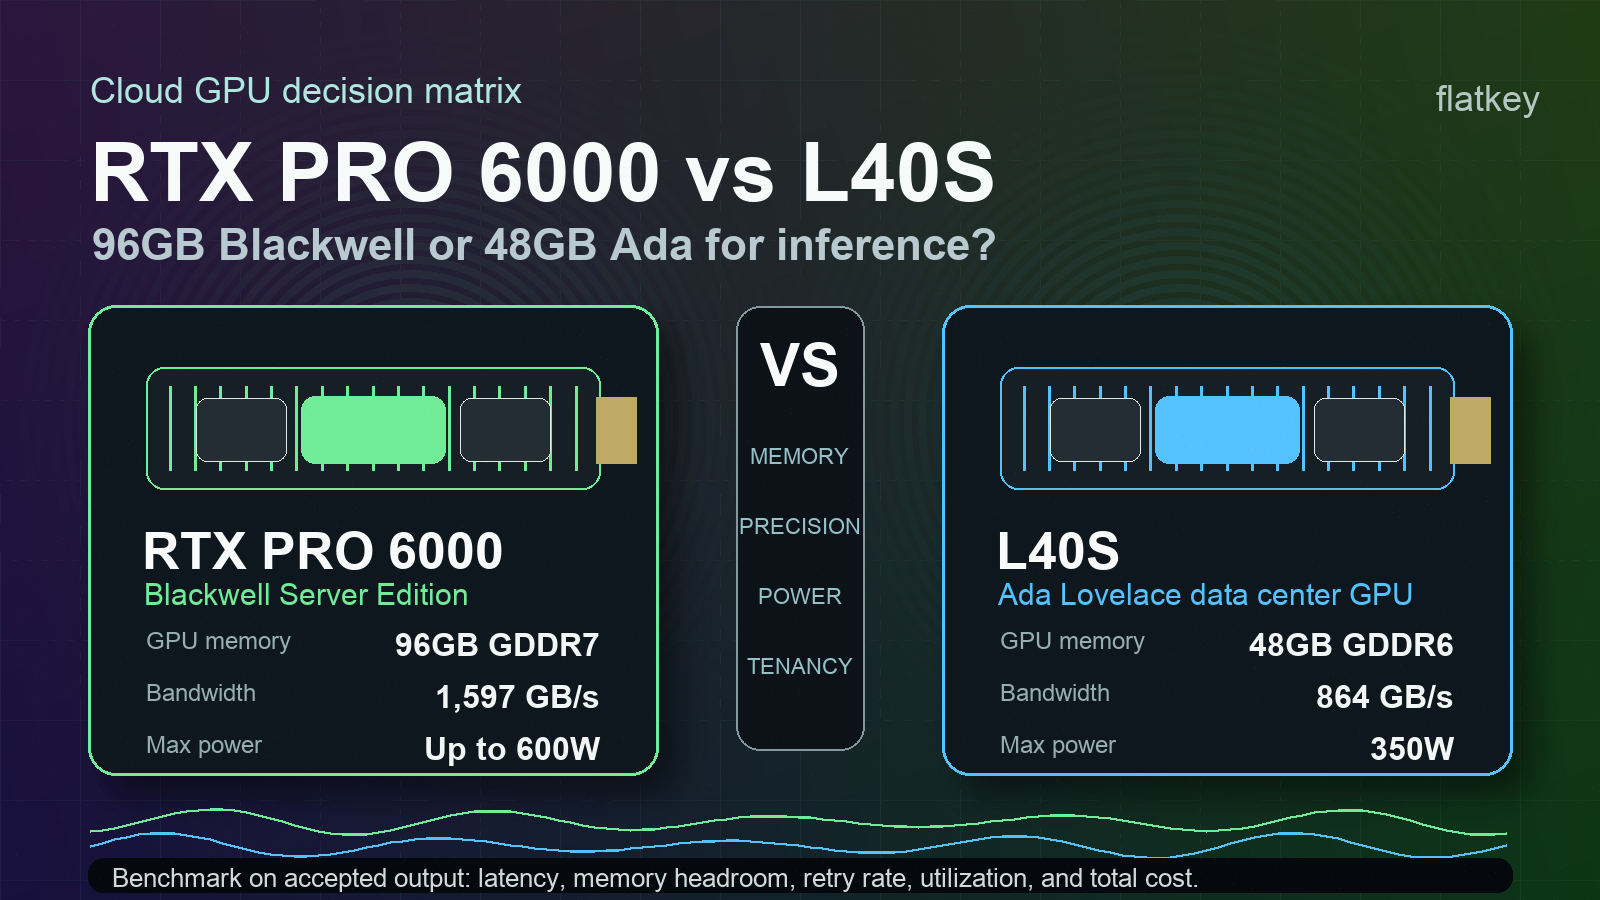
| Bộ nhớ GPU | 96GB GDDR7 với ECC | 48GB GDDR6 với ECC |
| Băng thông bộ nhớ | 1.597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Tiêu điểm độ chính xác Tensor | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1.466 TFLOPS với sparsity, FP16/BF16 362,05 / 733 TFLOPS với sparsity |
| Công suất tối đa | Lên đến 600W, có thể cấu hình | 350W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | Tối đa bốn instance cô lập trên RTX PRO 6000 | Không có hỗ trợ MIG được liệt kê cho L40S |
| Bài kiểm tra tốt nhất đầu tiên | Suy luận LLM ngữ cảnh dài, mô hình đa phương thức lớn hơn, chia sẻ GPU đa tenant, serving tối ưu FP4/Blackwell | LLM thân thiện với 48GB, tạo ảnh kiểu Stable Diffusion, rendering, video, các fleet Ada trưởng thành |
Nguồn: trang sản phẩm NVIDIA RTX PRO 6000 Blackwell Server Edition, trang sản phẩm NVIDIA L40S và trang kiến trúc Blackwell của NVIDIA.
Khuyến nghị nhanh
Bắt đầu benchmark l40s vs rtx pro 6000 bằng bộ nhớ, không phải TFLOPS đỉnh.
- Chọn RTX PRO 6000 Blackwell Server Edition khi model của bạn bị giới hạn bộ nhớ trên L40S, khi độ dài context hoặc áp lực KV cache làm ảnh hưởng đến số lượng GPU, khi bạn muốn thử các đường dẫn suy luận FP4/Blackwell, hoặc khi các lát cắt GPU cô lập quan trọng đối với cụm doanh nghiệp chia sẻ.
- Chọn L40S khi model, kích thước batch và cửa sổ context của bạn vừa thoải mái trong 48GB, khi stack production của bạn đã được tinh chỉnh cho Ada, hoặc khi chênh lệch giá từ nhà cung cấp đủ lớn để GPU cũ thắng về chi phí trên mỗi đầu ra được chấp nhận.
- Hãy dùng mốc cơ sở API model khi bạn không cần weights tùy chỉnh, điều khiển CUDA, lập lịch GPU riêng tư hoặc tăng tốc trực tiếp cho media/rendering. Phần cứng phải tốt hơn chi phí và sự đơn giản vận hành của các lệnh gọi model được quản lý sau khi tính đến hàng đợi, retry, thời gian nhàn rỗi và chi phí kỹ thuật.
Điểm cuối cùng đó là lý do quyết định nvidia rtx pro 6000 vs l40s không nên dừng ở bảng thông số. Một card nhanh hơn vẫn có thể là lựa chọn sai nếu mức sử dụng thấp hoặc đội ngũ không cần tự vận hành GPU.
Vì sao RTX PRO 6000 thay đổi câu chuyện về suy luận
RTX PRO 6000 Blackwell Server Edition gấp đôi dung lượng bộ nhớ được công bố so với L40S: 96GB GDDR7 thay vì 48GB GDDR6. Nó cũng tăng băng thông bộ nhớ được công bố từ 864 GB/s trên L40S lên 1.597 GB/s.
Đối với các đội suy luận, bộ nhớ không chỉ là “kích thước model.” Nó còn bao gồm KV cache, khoảng trống cho batching, buffer runtime, adapter, đầu vào đa phương thức, biên an toàn cho prompt dài và overhead đa tenancy. Trong một dịch vụ thực tế, card giúp tránh lỗi out-of-memory hoặc giảm việc sharding tensor-parallel có thể tốt hơn card rẻ hơn có chi phí theo giờ được niêm yết thấp hơn.
RTX PRO 6000 đặc biệt đáng thử khi:
- Bạn phục vụ lưu lượng LLM ngữ cảnh dài và KV cache chiếm phần lớn kế hoạch bộ nhớ.
- Bạn muốn thử các model lượng tử hóa cỡ 70B hoặc lớn hơn với ít shard hơn.
- Bạn vận hành workload đa phương thức hỗn hợp, nơi các thành phần image, video, embedding, reranking và LLM cạnh tranh bộ nhớ.
- Bạn cần phân vùng một GPU vật lý cho nhiều người dùng hoặc workload; NVIDIA công bố tối đa bốn instance MIG cô lập cho RTX PRO 6000.
- Bạn đang đánh giá các đường dẫn serving đặc thù của Blackwell như FP4/NVFP4, TensorRT-LLM, vLLM hoặc các cải tiến SGLang.
Đánh đổi về điện năng là có thật. NVIDIA liệt kê RTX PRO 6000 ở mức tối đa 600W có thể cấu hình, trong khi L40S là 350W. Nếu nhà cung cấp tính giá theo server cam kết, biên độ điện năng, mật độ rack hoặc năng lực đặt trước, mức trần cao hơn đó phải được đưa vào mô hình chi phí rtx 6000 pro vs l40s. Đừng so sánh giá GPU theo giờ mà không hỏi xem điện năng, làm mát, cấu hình host, hỗ trợ và tenancy có được bao gồm hay không.
Vì sao L40S vẫn hữu ích
L40S vẫn là một GPU thực tế rất mạnh vì đây là một card trung tâm dữ liệu Ada trưởng thành với bộ nhớ ECC 48GB, băng thông bộ nhớ 864 GB/s, công suất tối đa 350W và mức độ quen thuộc cao trong sản xuất. NVIDIA định vị L40S cho AI tạo sinh, huấn luyện và suy luận LLM, đồ họa, kết xuất, Omniverse và khối lượng công việc video.
Mức độ trưởng thành đó rất quan trọng trong mua sắm cloud. Một card cũ hơn một chút có thể thắng khi:
- Dung lượng hiện có ngay ở đúng khu vực bạn cần.
- Image của nhà cung cấp, driver, container và giám sát đã ổn định.
- Khối lượng công việc nằm gọn trong 48GB mà không cần sharding quá mức.
- Nút thắt của bạn là thời gian hàng đợi, tải dữ liệu, tiền xử lý CPU, hoặc lập lịch phần mềm chứ không phải đỉnh Tensor Core thô.
- Bạn đang chạy các tác vụ tạo ảnh, kết xuất, video, hoặc tính toán thị giác vốn đã có benchmark tốt trên Ada.
Câu hỏi nvidia l40s vs rtx pro 6000 thường quy về việc liệu thêm 48GB trên RTX PRO 6000 có làm thay đổi hình thức triển khai hay không. Nếu không, L40S có thể là lựa chọn thuê hoặc đặt trước ít rủi ro hơn, đặc biệt với các đội đã có sẵn script và mốc chuẩn.
Ma trận quyết định theo từng khối lượng công việc
Hãy dùng ma trận này trước khi yêu cầu nhà cung cấp báo giá.
| Khối lượng công việc | Ưu tiên RTX PRO 6000 khi... | Ưu tiên L40S khi... | Cần đo gì |
|---|---|---|---|
| Suy luận LLM ngữ cảnh dài | 48GB giới hạn độ dài ngữ cảnh, kích thước batch hoặc headroom KV cache | 48GB đáp ứng mục tiêu p95 về ngữ cảnh và độ đồng thời | Thời gian đến token đầu tiên, token/giây, độ trễ p95, tỷ lệ OOM, số phản hồi được chấp nhận/giờ |
| Phục vụ mô hình 70B đã lượng tử hóa | 96GB giảm sharding, retry hoặc độ phức tạp khi sắp xếp vị trí | Mô hình đã lượng tử hóa và KV cache của bạn vừa trên L40S ở mức đồng thời mục tiêu | Số GPU trên mỗi replica, độ trễ hàng đợi, điểm chất lượng, tỷ lệ retry |
| Suy luận đa thuê bao | Cô lập MIG và bộ nhớ 96GB cải thiện mức sử dụng | Đa thuê bao được xử lý ở cấp node hoặc scheduler | Mức sử dụng theo tenant, sự cố “noisy neighbor”, job thất bại |
| Stable Diffusion và tạo ảnh | Các mô hình lớn hơn, batch lớn hơn, hoặc giai đoạn đa phương tiện cần nhiều bộ nhớ hơn | Các pipeline hiện có đã đáp ứng mục tiêu thông lượng và chất lượng | Số ảnh được chấp nhận/giờ, headroom VRAM, chi phí trên mỗi ảnh được chấp nhận |
| Kết xuất và đồ họa 3D | Tính năng RT/media của Blackwell cải thiện đúng renderer hoặc pipeline đó | Hiệu năng Ada L40S đã được xác thực cho renderer | Thời gian khung/kết xuất, render thất bại, thông lượng mã hóa/giải mã media |
| Nâng cấp doanh nghiệp | Bạn muốn một nền tảng thời Blackwell cho 24 tháng tới | Bạn cần bổ sung dung lượng với vận hành đã biết | Ngưỡng sử dụng, công sức di chuyển, SLA hỗ trợ, khả dụng dung lượng |
Cách hữu ích để diễn giải l40s vs rtx 6000 pro là: không phải trang sản phẩm nào có con số lớn hơn, mà là GPU nào làm thay đổi số lượng đầu ra được chấp nhận mà bạn có thể xuất xưởng trên mỗi đô la.
Benchmark đầu ra được chấp nhận, không phải thông số đỉnh
Một benchmark l40s vs rtx pro 6000 nghiêm túc nên phát lại đúng khối lượng công việc của bạn thay vì chỉ dựa vào các đỉnh chung chung. Hãy đo đầu ra mà người dùng hoặc khách hàng của bạn chấp nhận.
Đối với suy luận LLM, hãy thu thập:
| Chỉ số | Vì sao quan trọng |
|---|---|
| Thời gian đến token đầu tiên | Phản ánh độ trễ của người dùng tương tác |
| Độ trễ giữa các token | Cho thấy hành vi giải mã dưới tải đồng thời thực |
| Độ đồng thời ổn định | Cho thấy 48GB hay 96GB có thay đổi batching hay không |
| Thang đo độ dài ngữ cảnh | Xác định khi nào áp lực KV cache xuất hiện |
| Tỷ lệ OOM và retry | Chuyển mức độ vừa bộ nhớ thành chi phí thực |
| Số phản hồi được chấp nhận mỗi giờ | Chuẩn hóa các bộ lọc chất lượng, lỗi và retry |
| Chi phí trên 1M token đầu ra được chấp nhận | Cho phép RTX PRO 6000, L40S và API mô hình dùng chung một chỉ số |
| Số giờ kỹ thuật mỗi tháng | Phản ánh công sức về driver, kernel, hàng đợi, sự cố và benchmark |
Với khối lượng công việc hình ảnh, video, kết xuất hoặc đa phương thức, hãy thay token được chấp nhận bằng ảnh được chấp nhận, clip được chấp nhận, khung hình được kết xuất hoặc job hoàn thành. Logic là như nhau. Một card trông nhanh hơn trên benchmark của nhà cung cấp có thể thua nếu nó làm tăng tranh chấp hàng đợi, tạo ra nhiều job thất bại hơn, hoặc đòi hỏi một lần di chuyển phần mềm mà đội của bạn không thể duy trì.
Câu hỏi dành cho nhà cung cấp trước khi thuê RTX PRO 6000 hoặc L40S
Hãy hỏi các câu sau trước khi cam kết với bất kỳ GPU nào:
- Dung lượng RTX PRO 6000 đó có phải cụ thể là Blackwell Server Edition không, và là bản dual-slot làm mát bằng không khí hay single-slot làm mát bằng chất lỏng?
- Dung lượng L40S là dedicated, fractional, containerized hay thuộc một dịch vụ job được quản lý?
- Những phiên bản driver, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch và container nào được hỗ trợ?
- Nhà cung cấp có cung cấp MIG trên RTX PRO 6000 không, và các instance được tính phí như thế nào?
- Các lượt chạy benchmark được tính theo giá on-demand, giá reserved hay đã bao gồm trong một cửa sổ đánh giá?
- Khu vực, fabric mạng, CPU host, loại lưu trữ và dung lượng NVMe cục bộ là gì?
- Các job thất bại, thời gian nhàn rỗi, thời gian hàng đợi, snapshot và egress có được tính phí riêng không?
- SLA hỗ trợ và đường thay thế nào được áp dụng khi host GPU không khỏe mạnh?
- Bạn có thể xuất mức sử dụng GPU theo từng job, mức dùng bộ nhớ, độ trễ hàng đợi, tỷ lệ retry và chi phí không?
- Phương án dự phòng là gì nếu tính sẵn có của Blackwell, driver hoặc kernel chậm hơn lịch ra mắt của bạn?
Kết hợp các câu trả lời đó với hướng dẫn giá thuê GPU của Flatkey, bảng tính TCO cụm GPU, và GPU cloud so với model API. Nếu bạn vẫn đang cân nhắc phân hạng GPU, hãy đọc hướng dẫn rộng hơn về GPU tốt nhất cho suy luận LLM trước khi thu hẹp lựa chọn xuống nvidia l40s vs rtx pro 6000.
Flatkey phù hợp ở đâu
Flatkey không thay thế RTX PRO 6000 hoặc L40S khi bạn cần kiểm soát GPU trực tiếp. Nếu bạn chạy weights riêng, kernel tùy chỉnh, yêu cầu vị trí dữ liệu nghiêm ngặt, pipeline dựng hình chuyên dụng, hoặc nghiên cứu ở mức phần cứng, bạn vẫn cần năng lực GPU cloud hoặc hạ tầng sở hữu riêng.
Flatkey là chuẩn cơ sở cần vượt qua khi nhóm của bạn chủ yếu cần đầu ra mô hình đáng tin cậy. Với một khóa và một số dư duy nhất trên các mô hình chính thức và công cụ AI, các nhóm có thể định tuyến khối lượng công việc API, theo dõi mức sử dụng, so sánh chi phí mô hình và tránh các tài khoản nhà cung cấp rời rạc. Điều đó cho tài chính và kỹ thuật một nhóm đối chứng rõ ràng trước khi cam kết vào năng lực GPU cố định.
Trên thực tế, hãy chạy ba hướng:
| Hướng | Khi nào nó thắng |
|---|---|
| RTX PRO 6000 | Nhiều bộ nhớ hơn hoặc các tính năng Blackwell làm giảm số GPU, lỗi, hoặc độ trễ đủ để bù chi phí cao hơn |
| L40S | 48GB là đủ và năng lực Ada trưởng thành có giá trên mỗi đầu ra được chấp nhận tốt nhất |
| API mô hình được quản lý qua Flatkey | Không cần kiểm soát GPU trực tiếp và sự đơn giản vận hành thắng thế so với sở hữu hạ tầng |
Người thắng đúng là hướng có chi phí thấp nhất trên mỗi đầu ra được chấp nhận tại mục tiêu chất lượng và độ trễ của bạn.
Khuyến nghị cuối cùng
Với l40s vs rtx pro 6000, hãy xem RTX PRO 6000 là chuẩn đầu tiên của bạn khi khoảng trống bộ nhớ, hỗ trợ FP4/Blackwell, PCIe Gen 5, hoặc phân vùng MIG có thể thay đổi kiến trúc phục vụ. Hãy xem L40S là chuẩn đầu tiên khi khối lượng công việc đã nằm gọn trong 48GB và năng lực Ada trưởng thành rẻ hơn hoặc dễ đặt trước hơn.
Sau đó so sánh cả hai với một chuẩn cơ sở model/API. Nếu Flatkey hoặc một lộ trình API được quản lý khác đáp ứng các yêu cầu về chất lượng, độ trễ, quyền riêng tư và chi phí, việc thuê GPU phải biện minh cho phần công việc vận hành bổ sung. Nếu không thể, lộ trình phần cứng là hợp lý, và lựa chọn cuối cùng trở thành một lần phát lại workload: rtx pro 6000 vs l40s dựa trên đầu ra được chấp nhận, chứ không phải các con số đỉnh marketing.
Câu hỏi thường gặp
RTX PRO 6000 Blackwell có nhanh hơn L40S không?
Theo thông số công khai của NVIDIA, RTX PRO 6000 Blackwell Server Edition có hiệu năng FP32 công bố cao hơn, nhiều bộ nhớ hơn, băng thông bộ nhớ lớn hơn, Tensor Cores mới hơn và hỗ trợ FP4. Điều đó không có nghĩa là nó rẻ hơn cho mọi workload. Hãy benchmark ngăn xếp phục vụ cụ thể của bạn và chi phí trên mỗi đầu ra được chấp nhận.
L40S có còn tốt cho suy luận LLM không?
Có, khi mô hình, cửa sổ ngữ cảnh và mục tiêu đồng thời đều vừa trong 48GB. L40S vẫn có thể thực tế cho suy luận LLM, tạo ảnh, dựng hình, video, và các workload kết hợp tính toán thị giác, đặc biệt ở nơi năng lực của nhà cung cấp đã trưởng thành.
Khác biệt lớn nhất giữa NVIDIA RTX PRO 6000 và L40S là gì?
Khác biệt thực tế lớn nhất là bộ nhớ. RTX PRO 6000 Blackwell Server Edition công bố 96GB GDDR7 và băng thông bộ nhớ 1.597 GB/s; L40S công bố 48GB GDDR6 và băng thông bộ nhớ 864 GB/s. RTX PRO 6000 cũng bổ sung đường FP4 của Blackwell và hỗ trợ MIG.
Tôi có nên nâng cấp từ L40S lên RTX PRO 6000 không?
Hãy nâng cấp khi giới hạn bộ nhớ của L40S đang tạo ra nhiều shard hơn, batch nhỏ hơn, cửa sổ ngữ cảnh ngắn hơn, job thất bại, hoặc sử dụng không hiệu quả. Hãy giữ L40S khi nó đã đáp ứng mục tiêu độ trễ và chất lượng của bạn với chi phí trên mỗi đầu ra được chấp nhận thấp hơn.
Tôi có nên dùng model API thay vì thuê một trong hai GPU không?
Hãy dùng model API khi bạn không cần weights tùy chỉnh, điều khiển CUDA trực tiếp, lập lịch GPU riêng tư, hoặc tăng tốc dựng hình/media. Một model API có thể là lộ trình kinh tế tốt hơn khi nhu cầu workload biến động hoặc mức sử dụng GPU sẽ thấp.
Nguồn đã kiểm tra
- Trang sản phẩm NVIDIA RTX PRO 6000 Blackwell Server Edition
- Trang sản phẩm NVIDIA L40S
- Trang kiến trúc Blackwell của NVIDIA
- Bản đồ chủ đề Flatkey Cloud GPU và nguồn từ khóa Cloud GPU ngày 2026-10-10
- Tổng quan sản phẩm Flatkey và định vị được phê duyệt: một khóa, một số dư, các mô hình chính thức, sổ cái sử dụng trả tiền theo lần gọi thành công


