
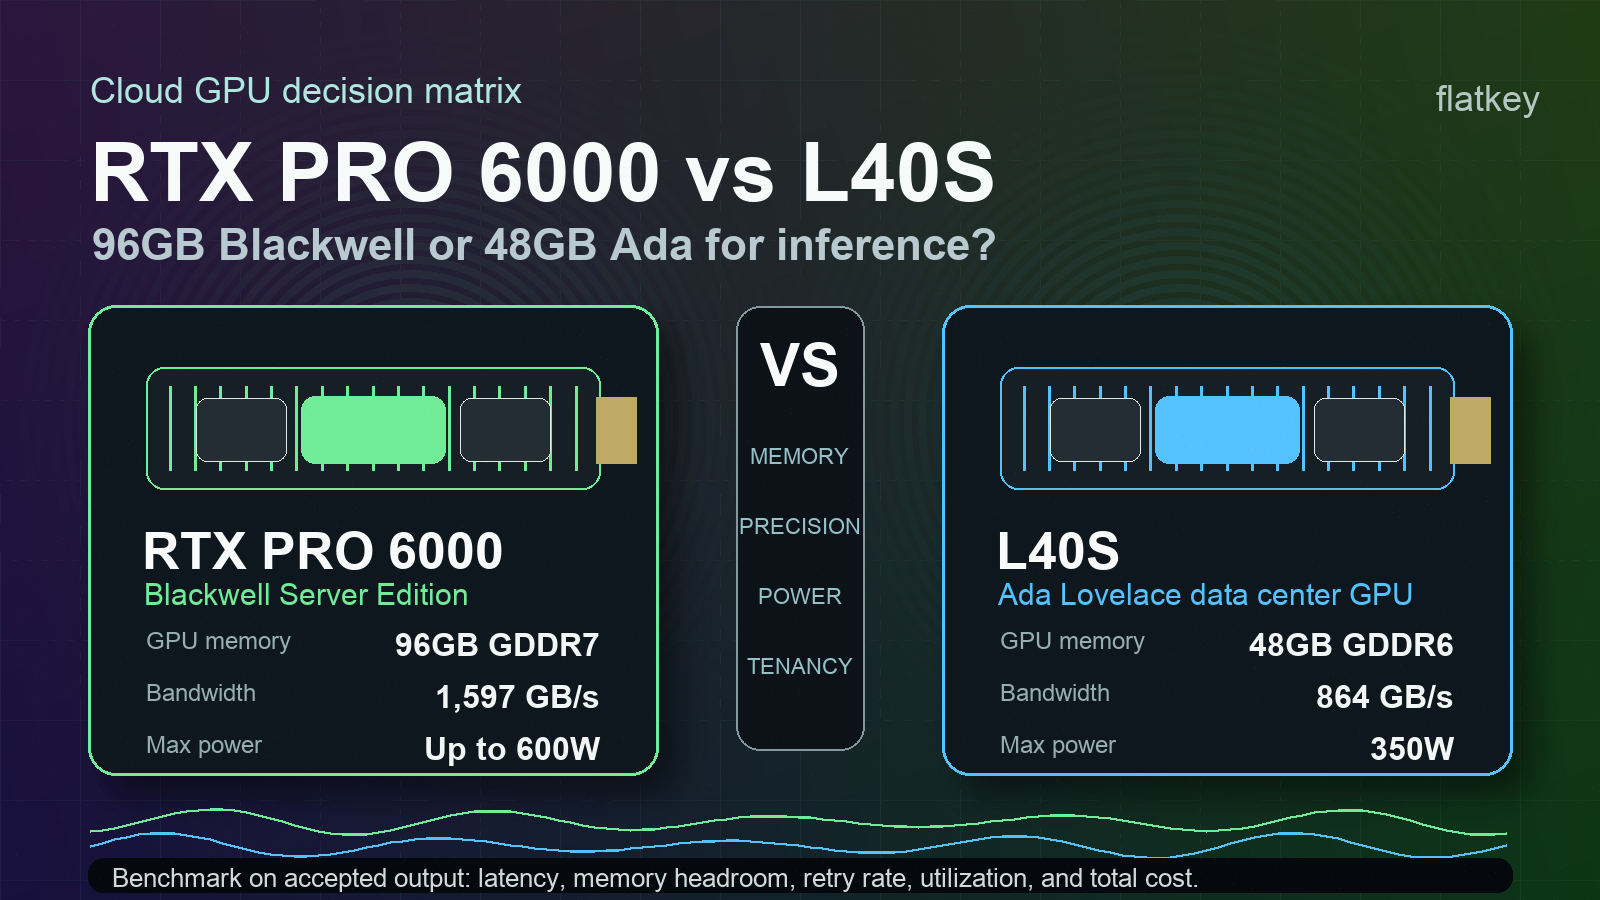
RTX PRO 6000 vs L40S : GPU d’inférence Blackwell 96 Go ou Ada ?
La réponse courte pour l40s vs rtx pro 6000 : choisissez NVIDIA RTX PRO 6000 Blackwell Server Edition lorsque 96 Go de mémoire GPU, la prise en charge de Blackwell FP4, PCIe Gen 5, le partitionnement MIG et des moteurs multimédias plus récents peuvent modifier votre architecture de service. Choisissez NVIDIA L40S lorsque votre charge de travail tient déjà dans 48 Go, que votre pile est mature sur les GPU Ada, et que l’écart de prix ou de disponibilité est suffisamment important pour surpasser la carte la plus récente.
Il ne s’agit pas d’une décision simple du type « le nouveau GPU gagne toujours ». La comparaison rtx pro 6000 vs l40s porte en réalité sur l’adéquation mémoire, la prise en charge de la précision, la maturité logicielle, l’enveloppe énergétique et le coût à sortie acceptée. Si le RTX PRO 6000 vous permet d’utiliser moins de shards, des fenêtres de contexte plus larges, des lots plus importants ou moins de nouvelles tentatives après manque de mémoire, il peut être le GPU d’inférence le plus performant. Si la capacité du L40S est moins chère, plus facile à réserver et répond déjà à votre objectif de latence, la carte Ada plus ancienne peut rester le choix pragmatique.
Vérifié le 13 octobre 2026.
L40S vs RTX PRO 6000 : la différence pratique
Utilisez ce tableau comme premier filtre d’achat avant de demander des benchmarks à un fournisseur.
| Point de décision | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| Génération de GPU | Blackwell | Ada Lovelace |
| Raison principale d’achat | Plus de mémoire, Tensor Cores plus récents, prise en charge FP4, PCIe Gen 5, partitionnement des charges de travail | GPU 48 Go mature pour les centres de données, pour l’inférence, le rendu, les graphismes et la vidéo |
| Mémoire GPU | 96 Go de GDDR7 avec ECC | 48 Go de GDDR6 avec ECC |
| Bande passante mémoire | 1 597 Go/s | 864 Go/s |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Point fort de précision Tensor | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1 466 TFLOPS avec sparsité, FP16/BF16 362,05 / 733 TFLOPS avec sparsité |
| Puissance max. | Jusqu’à 600 W configurable | 350 W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | Jusqu’à quatre instances isolées sur RTX PRO 6000 | Aucune prise en charge MIG indiquée pour L40S |
| Premier test recommandé | Inférence LLM à long contexte, modèles multimodaux plus volumineux, partage GPU multi-locataire, service optimisé FP4/Blackwell | LLM compatibles 48 Go, génération d’images de type Stable Diffusion, rendu, vidéo, parcs Ada matures |
Sources : page produit NVIDIA du RTX PRO 6000 Blackwell Server Edition, page produit NVIDIA du L40S et page d’architecture Blackwell de NVIDIA.
La recommandation rapide
Commencez le benchmark l40s vs rtx pro 6000 par la mémoire, et non par le pic de TFLOPS.
- Choisissez RTX PRO 6000 Blackwell Server Edition lorsque votre modèle est limité par la mémoire sur L40S, lorsque la longueur de contexte ou la pression du cache KV augmente le nombre de GPU nécessaire, lorsque vous souhaitez tester des chemins d’inférence FP4/Blackwell, ou lorsque des tranches GPU isolées comptent pour des clusters d’entreprise partagés.
- Choisissez L40S lorsque votre modèle, la taille de lot et la fenêtre de contexte tiennent confortablement dans 48 Go, lorsque votre pile de production est déjà optimisée pour Ada, ou lorsque la différence de prix chez le fournisseur est suffisamment grande pour que le GPU plus ancien l’emporte sur le coût à sortie acceptée.
- Utilisez une base de référence via une API de modèle lorsque vous n’avez pas besoin de poids personnalisés, de contrôle CUDA, de planification privée du GPU ou d’accélération directe des médias/rendus. Le matériel doit battre le coût et la simplicité d’exploitation des appels de modèle gérés après la mise en file d’attente, les nouvelles tentatives, les temps d’inactivité et la surcharge d’ingénierie.
C’est ce dernier point qui explique pourquoi la décision nvidia rtx pro 6000 vs l40s ne devrait pas s’arrêter à une fiche technique. Une carte plus rapide peut rester le mauvais achat si l’utilisation est faible ou si l’équipe n’a pas besoin de gérer elle-même les opérations GPU.
Pourquoi le RTX PRO 6000 change la discussion sur l’inférence
Le RTX PRO 6000 Blackwell Server Edition double la capacité mémoire indiquée par rapport au L40S : 96 Go de GDDR7 au lieu de 48 Go de GDDR6. Il augmente aussi la bande passante mémoire indiquée de 864 Go/s sur L40S à 1 597 Go/s.
Pour les équipes d’inférence, la mémoire ne se limite pas à la « taille du modèle ». Elle couvre aussi le cache KV, la marge pour le batching, les tampons d’exécution, les adaptateurs, les entrées multimodales, la marge de sécurité pour les prompts longs et la surcharge de multi-location. Dans un service réel, la carte qui évite les erreurs de manque de mémoire ou réduit le shardage tensor-parallel peut surpasser une carte moins chère au coût horaire affiché plus faible.
Le RTX PRO 6000 mérite particulièrement d’être testé lorsque :
- Vous servez du trafic LLM à long contexte et le cache KV domine la planification mémoire.
- Vous souhaitez tester des modèles quantifiés de classe 70B ou plus grands avec moins de shards.
- Vous exécutez des charges de travail multimodales mixtes où les composants image, vidéo, embedding, reranking et LLM se disputent la mémoire.
- Vous devez partitionner un GPU physique pour plusieurs utilisateurs ou charges de travail ; NVIDIA indique jusqu’à quatre instances MIG isolées pour le RTX PRO 6000.
- Vous évaluez des chemins de service spécifiques à Blackwell comme FP4/NVFP4, TensorRT-LLM, vLLM ou des améliorations SGLang.
Le compromis énergétique est réel. NVIDIA indique le RTX PRO 6000 jusqu’à 600 W configurable, tandis que le L40S est à 350 W. Si votre fournisseur facture par serveur engagé, enveloppe énergétique, densité de rack ou capacité réservée, ce plafond plus élevé doit entrer dans le modèle de coût rtx 6000 pro vs l40s. Ne comparez pas le prix horaire du GPU sans demander ce qui inclut l’alimentation, le refroidissement, la configuration de l’hôte, le support et la multi-location.
Pourquoi le L40S reste utile
La L40S reste un GPU pratique de premier plan, car il s’agit d’une carte data center Ada mature avec 48 Go de mémoire ECC, 864 Go/s de bande passante mémoire, une puissance maximale de 350 W et une grande familiarité en production. NVIDIA positionne la L40S pour l’IA générative, l’entraînement et l’inférence de LLM, les graphismes, le rendu, Omniverse et les charges de travail vidéo.
Cette maturité compte dans l’approvisionnement cloud. Une carte un peu plus ancienne peut l’emporter lorsque :
- La capacité est disponible maintenant dans la région exacte dont vous avez besoin.
- Les images du fournisseur, les pilotes, les conteneurs et la supervision sont déjà stables.
- La charge de travail tient dans 48 Go sans sharding agressif.
- Votre goulot d’étranglement est le temps dans la file d’attente, le chargement des données, le prétraitement CPU ou l’ordonnancement logiciel plutôt que le pic brut des Tensor Cores.
- Vous exécutez des tâches de génération d’images, de rendu, de vidéo ou de calcul visuel qui benchmarkent déjà bien sur Ada.
La question nvidia l40s vs rtx pro 6000 se résume souvent à savoir si les 48 Go supplémentaires de la RTX PRO 6000 changent la forme du déploiement. Si ce n’est pas le cas, la L40S peut être l’option de location ou de capacité réservée la moins risquée, surtout pour les équipes disposant déjà de scripts et de références.
Matrice de décision charge de travail par charge de travail
Utilisez cette matrice avant de demander un devis à un fournisseur.
| Charge de travail | Préférer la RTX PRO 6000 quand... | Préférer la L40S quand... | Quoi mesurer |
|---|---|---|---|
| Inférence LLM à long contexte | 48 Go limitent la longueur de contexte, la taille de lot ou la marge du cache KV | 48 Go satisfont les objectifs p95 de contexte et de concurrence | Temps jusqu’au premier token, tokens/s, latence p95, taux d’OOM, réponses acceptées/heure |
| Service de modèles quantifiés de classe 70B | 96 Go réduisent le sharding, les retries ou la complexité de placement | Votre modèle quantifié et le cache KV tiennent sur la L40S à la concurrence cible | Nombre de GPU par réplique, délai de file d’attente, score de qualité, taux de retry |
| Inférence multi-tenant | L’isolation MIG et 96 Go de mémoire améliorent l’utilisation | La multi-location est gérée au niveau du nœud ou du planificateur | Utilisation par locataire, incidents de voisin bruyant, tâches échouées |
| Stable Diffusion et génération d’images | Les modèles plus grands, les lots ou les étapes multimédias mixtes nécessitent plus de mémoire | Les pipelines existants répondent déjà aux objectifs de débit et de qualité | Images acceptées/heure, marge VRAM, coût par image acceptée |
| Rendu et graphismes 3D | Les fonctionnalités RT/média Blackwell améliorent le moteur de rendu ou le pipeline exact | Les performances Ada de la L40S sont déjà validées pour le moteur de rendu | Temps d’image/rendu, rendus échoués, débit d’encodage/décodage média |
| Renouvellement d’entreprise | Vous voulez une plateforme de l’ère Blackwell pour les 24 prochains mois | Vous avez besoin d’une capacité incrémentale avec des opérations connues | Seuil minimal d’utilisation, effort de migration, SLA de support, disponibilité de capacité |
Voici la bonne façon de présenter l40s vs rtx 6000 pro : non pas quelle page produit affiche le plus grand chiffre, mais quel GPU change le nombre de sorties acceptées que vous pouvez livrer par dollar.
Benchmarkez la sortie acceptée, pas les spécifications de pointe
Un benchmark sérieux l40s vs rtx pro 6000 doit rejouer votre charge de travail plutôt que de s’appuyer sur des pics génériques. Mesurez la sortie que vos utilisateurs ou clients acceptent.
Pour l’inférence LLM, collectez :
| Métrique | Pourquoi c’est important |
|---|---|
| Temps jusqu’au premier token | Reflète la latence utilisateur interactive |
| Latence entre tokens | Montre le comportement de décodage sous concurrence réelle |
| Concurrence stable | Révèle si 48 Go ou 96 Go changent le batching |
| Échelle de longueur de contexte | Permet de détecter quand la pression du cache KV apparaît |
| Taux d’OOM et de retry | Convertit l’adéquation mémoire en coût réel |
| Réponses acceptées par heure | Normalise les filtres de qualité, les échecs et les retries |
| Coût par 1 M de tokens de sortie acceptés | Permet à la RTX PRO 6000, à la L40S et aux API de modèles de partager une même métrique |
| Heures d’ingénierie par mois | Prend en compte le travail lié aux pilotes, au noyau, à la file d’attente, aux incidents et aux benchmarks |
Pour les charges de travail d’image, de vidéo, de rendu ou multimodales, remplacez les tokens acceptés par les images acceptées, les clips acceptés, les frames rendues ou les tâches terminées. La logique est la même. Une carte qui semble plus rapide sur un benchmark fournisseur peut perdre si elle augmente la contention dans la file d’attente, crée plus de tâches échouées ou nécessite une migration logicielle que votre équipe ne peut pas maintenir.
Questions à poser au fournisseur avant de louer une RTX PRO 6000 ou une L40S
Posez ces questions avant de vous engager sur l’un ou l’autre GPU :
- La capacité RTX PRO 6000 est-elle spécifiquement la Blackwell Server Edition, et est-elle à refroidissement par air en double largeur ou à refroidissement liquide en simple largeur ?
- La capacité L40S est-elle dédiée, fractionnée, conteneurisée ou intégrée à un service de jobs managé ?
- Quelles versions de pilote, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch et conteneur sont prises en charge ?
- Le fournisseur expose-t-il MIG sur la RTX PRO 6000, et comment les instances sont-elles facturées ?
- Les exécutions de benchmark sont-elles facturées aux tarifs à la demande, aux tarifs réservés ou incluses dans une fenêtre d’évaluation ?
- Quelle est la région, la fabric réseau, le CPU hôte, la classe de stockage et la capacité NVMe locale ?
- Les jobs échoués, le temps d’inactivité, le temps dans la file, les snapshots et l’egress sont-ils facturés séparément ?
- Quel SLA de support et quel chemin de remplacement s’appliquent lorsqu’un hôte GPU est en mauvais état ?
- Pouvez-vous exporter l’utilisation GPU par job, l’utilisation mémoire, le délai de file, le taux de retry et le coût ?
- Quel est le plan de secours si la disponibilité Blackwell, les pilotes ou les kernels prennent du retard sur votre calendrier de lancement ?
Associez ces réponses au guide des prix de location de GPU, à la feuille de calcul du TCO d’un cluster GPU et à la comparaison GPU cloud vs API de modèle de Flatkey. Si vous hésitez encore sur la classe de GPU, consultez d’abord le guide plus large sur le meilleur GPU pour l’inférence LLM avant de vous concentrer sur nvidia l40s vs rtx pro 6000.
Où Flatkey s’inscrit
Flatkey ne remplace pas le RTX PRO 6000 ni le L40S lorsque vous avez besoin d’un contrôle direct du GPU. Si vous exécutez des poids privés, des kernels personnalisés, une stricte localisation des données, des pipelines de rendu dédiés ou de la recherche au niveau matériel, vous avez toujours besoin de capacité GPU cloud ou d’une infrastructure détenue.
Flatkey est la référence à battre lorsque votre équipe a בעיקר besoin de sorties de modèle fiables. Avec une seule clé et un seul solde pour les modèles officiels et les outils d’IA, les équipes peuvent router les charges de travail API, suivre l’utilisation, comparer le coût des modèles et éviter des comptes fournisseurs dispersés. Cela donne aux équipes finance et engineering un groupe témoin clair avant de s’engager sur une capacité GPU fixe.
En pratique, évaluez trois voies :
| Voie | Quand elle l’emporte |
|---|---|
| RTX PRO 6000 | Plus de mémoire ou les fonctionnalités Blackwell réduisent suffisamment le nombre de GPU, les pannes ou la latence pour compenser le coût plus élevé |
| L40S | 48 Go suffisent et la capacité Ada mature offre le meilleur prix par sortie acceptée |
| API de modèle gérée via Flatkey | Le contrôle direct du GPU n’est pas nécessaire et la simplicité opérationnelle l’emporte sur la possession de l’infrastructure |
Le bon gagnant est la voie avec le coût par sortie acceptée le plus bas au regard de votre cible de qualité et de latence.
Recommandation finale
Pour l40s vs rtx pro 6000, faites du RTX PRO 6000 votre premier benchmark lorsque la marge mémoire, la prise en charge FP4/Blackwell, PCIe Gen 5 ou le partitionnement MIG peuvent modifier l’architecture de service. Faites du L40S votre premier benchmark lorsque la charge de travail tient déjà dans 48 Go et que la capacité Ada mature est moins chère ou plus facile à réserver.
Comparez ensuite les deux à une base de référence modèle/API. Si Flatkey ou une autre solution d’API gérée répond aux exigences de qualité, de latence, de confidentialité et de coût, la location de GPU doit justifier son surcroît de travail opérationnel. Si ce n’est pas le cas, l’option matérielle est justifiée, et le choix final devient une relecture de la charge utile : rtx pro 6000 vs l40s sur la sortie acceptée, pas sur les pics marketing.
Questions fréquentes
Le RTX PRO 6000 Blackwell est-il plus rapide que le L40S ?
Selon les spécifications publiques de NVIDIA, le RTX PRO 6000 Blackwell Server Edition affiche des performances FP32 plus élevées, davantage de mémoire, une bande passante mémoire plus importante, des Tensor Cores plus récents et la prise en charge du FP4. Cela ne signifie pas qu’il est moins cher pour toutes les charges de travail. Mesurez votre pile de service exacte et le coût par sortie acceptée.
Le L40S est-il toujours bon pour l’inférence LLM ?
Oui, lorsque le modèle, la fenêtre de contexte et la cible de concurrence tiennent dans 48 Go. Le L40S peut encore être pratique pour l’inférence LLM, la génération d’images, le rendu, la vidéo et les charges de travail visuelles mixtes, surtout lorsque la capacité du fournisseur est mature.
Quelle est la plus grande différence entre NVIDIA RTX PRO 6000 et L40S ?
La plus grande différence pratique est la mémoire. Le RTX PRO 6000 Blackwell Server Edition indique 96 Go de GDDR7 et 1 597 Go/s de bande passante mémoire ; le L40S indique 48 Go de GDDR6 et 864 Go/s de bande passante mémoire. Le RTX PRO 6000 ajoute aussi une voie Blackwell FP4 et la prise en charge de MIG.
Dois-je passer du L40S au RTX PRO 6000 ?
Passez à la génération supérieure lorsque les limites mémoire du L40S créent des sharding supplémentaires, des lots plus petits, des fenêtres de contexte plus courtes, des tâches échouées ou une faible utilisation. Restez sur le L40S lorsqu’il répond déjà à vos cibles de latence et de qualité à un coût par sortie acceptée inférieur.
Dois-je utiliser une API de modèle plutôt que de louer l’un ou l’autre GPU ?
Utilisez une API de modèle lorsque vous n’avez pas besoin de poids personnalisés, d’un contrôle CUDA direct, d’une planification GPU privée ou d’accélération de rendu/média. Une API de modèle peut être la meilleure voie économique lorsque la demande de charge de travail est volatile ou que l’utilisation du GPU serait faible.
Sources vérifiées
- Page produit NVIDIA RTX PRO 6000 Blackwell Server Edition
- Page produit NVIDIA L40S
- Page sur l’architecture NVIDIA Blackwell
- Plan thématique des GPU cloud Flatkey et source de mots-clés Cloud GPU datée du 2026-10-10
- Présentation produit Flatkey et positionnement approuvé : une clé, un solde, modèles officiels, registre d’utilisation au paiement par appel réussi


