
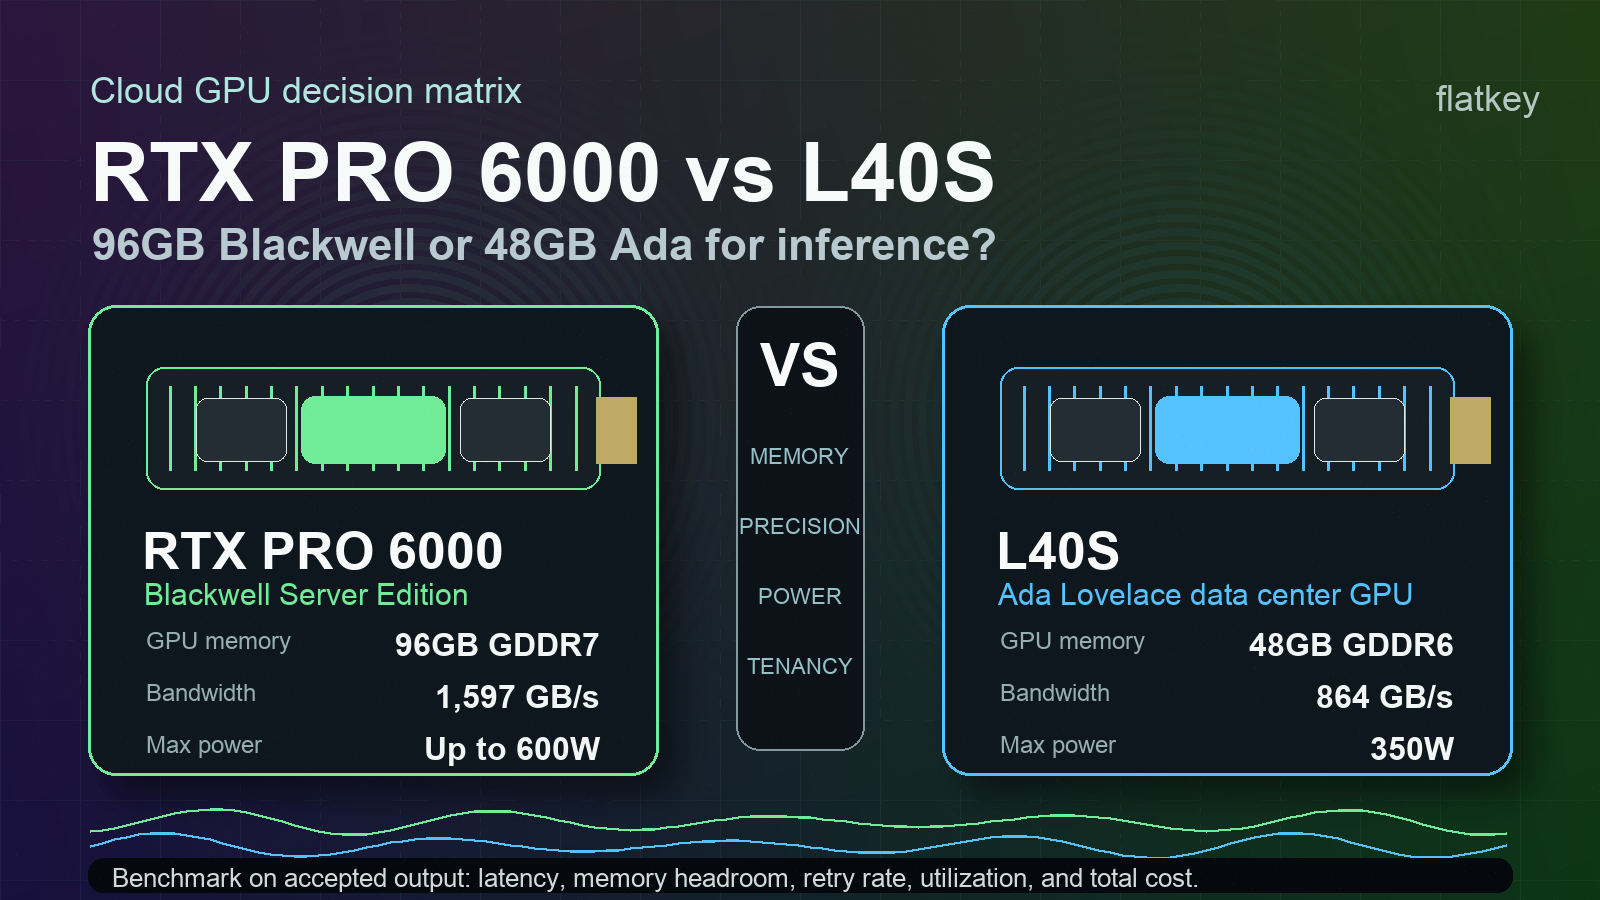
RTX PRO 6000 vs L40S: GPU de inferência Blackwell de 96 GB ou Ada?
A resposta curta para l40s vs rtx pro 6000: escolha a NVIDIA RTX PRO 6000 Blackwell Server Edition quando 96 GB de memória de GPU, suporte a Blackwell FP4, PCIe Gen 5, particionamento MIG e mecanismos de mídia mais novos puderem alterar seu design de serving. Escolha a NVIDIA L40S quando sua carga de trabalho já couber em 48 GB, sua stack já estiver madura em GPUs Ada e a diferença de preço ou disponibilidade for grande o suficiente para superar a placa mais nova.
Esta não é uma decisão limpa de "GPU nova sempre vence". A comparação rtx pro 6000 vs l40s gira, na verdade, em torno de adequação de memória, suporte a precisão, maturidade de software, orçamento de energia e custo de saída aceita. Se a RTX PRO 6000 permitir usar menos shards, janelas de contexto maiores, batches maiores ou menos tentativas por falta de memória, ela pode ser a GPU de inferência mais forte. Se a capacidade da L40S for mais barata, mais fácil de reservar e já atender ao seu alvo de latência, a placa Ada mais antiga ainda pode ser a escolha pragmática.
Verificado em 13 de outubro de 2026.
L40S vs RTX PRO 6000: a diferença prática
Use esta tabela como a primeira triagem de aquisição antes de pedir benchmarks do provedor.
| Ponto de decisão | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| Geração da GPU | Blackwell | Ada Lovelace |
| Principal motivo de compra | Mais memória, Tensor Cores mais novos, caminho FP4, PCIe Gen 5, particionamento de carga de trabalho | GPU de data center madura de 48 GB para inferência, renderização, gráficos e vídeo |
| Memória da GPU | 96 GB GDDR7 com ECC | 48 GB GDDR6 com ECC |
| Largura de banda da memória | 1.597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Destaque de precisão Tensor | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1.466 TFLOPS com sparsity, FP16/BF16 362,05 / 733 TFLOPS com sparsity |
| Potência máxima | Até 600 W configurável | 350 W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | Até quatro instâncias isoladas na RTX PRO 6000 | Sem suporte a MIG listado para a L40S |
| Melhor primeiro teste | Inferência de LLM de longo contexto, modelos multimodais maiores, compartilhamento de GPU multi-tenant, serving otimizado para FP4/Blackwell | LLMs amigáveis a 48 GB, geração de imagens no estilo Stable Diffusion, renderização, vídeo, frotas Ada maduras |
Fontes: página de produto da RTX PRO 6000 Blackwell Server Edition da NVIDIA, página de produto da L40S da NVIDIA e página da arquitetura Blackwell da NVIDIA.
A recomendação rápida
Comece o benchmark l40s vs rtx pro 6000 pela memória, não pelo TFLOPS de pico.
- Escolha RTX PRO 6000 Blackwell Server Edition quando seu modelo estiver limitado por memória na L40S, quando o comprimento de contexto ou a pressão do KV cache determinar o número de GPUs, quando você quiser testar caminhos de inferência FP4/Blackwell ou quando slices isolados de GPU forem importantes para clusters corporativos compartilhados.
- Escolha L40S quando seu modelo, tamanho de batch e janela de contexto couberem confortavelmente dentro de 48 GB, quando sua stack de produção já estiver ajustada para Ada ou quando a diferença de preço do provedor for grande o suficiente para que a GPU mais antiga vença no custo de saída aceita.
- Use uma linha de base de API de modelo quando você não precisar de pesos personalizados, controle de CUDA, agendamento privado de GPU ou aceleração direta de mídia/renderização. O hardware precisa superar o custo e a simplicidade operacional das chamadas de modelo gerenciadas depois de considerar fila, retries, tempo ocioso e overhead de engenharia.
Esse último ponto é por que a decisão nvidia rtx pro 6000 vs l40s não deve parar na folha de especificações. Uma placa mais rápida ainda pode ser a compra errada se a utilização for baixa ou se a equipe não precisar assumir as operações de GPU.
Por que a RTX PRO 6000 muda a conversa sobre inferência
A RTX PRO 6000 Blackwell Server Edition dobra a capacidade de memória listada em relação à L40S: 96 GB GDDR7 em vez de 48 GB GDDR6. Ela também aumenta a largura de banda de memória listada de 864 GB/s na L40S para 1.597 GB/s.
Para equipes de inferência, memória não é apenas "tamanho do modelo". Ela também cobre KV cache, folga para batching, buffers de runtime, adapters, entradas multimodais, margem de segurança para prompts longos e overhead de tenancy. Em um serviço real, a placa que evita erros de out-of-memory ou reduz o sharding de tensor paralelo pode superar uma placa mais barata com menor custo horário listado.
A RTX PRO 6000 vale especialmente a pena testar quando:
- Você atende tráfego de LLM de longo contexto e o KV cache domina o planejamento de memória.
- Você quer testar modelos quantizados de classe 70B ou maiores com menos shards.
- Você executa cargas de trabalho multimodais mistas em que componentes de imagem, vídeo, embeddings, reranking e LLM competem por memória.
- Você precisa particionar uma GPU física para vários usuários ou cargas de trabalho; a NVIDIA lista até quatro instâncias MIG isoladas para a RTX PRO 6000.
- Você está avaliando caminhos de serving específicos do Blackwell, como FP4/NVFP4, TensorRT-LLM, vLLM ou melhorias do SGLang.
O trade-off de energia é real. A NVIDIA lista a RTX PRO 6000 com até 600 W configuráveis, enquanto a L40S é 350 W. Se seu provedor precifica por servidor contratado, envelope de energia, densidade de rack ou capacidade reservada, esse teto mais alto entra no modelo de custo da rtx 6000 pro vs l40s. Não compare o preço horário da GPU sem perguntar o que está incluído em energia, refrigeração, configuração do host, suporte e tenancy.
Por que a L40S ainda é útil
A L40S continua sendo uma GPU prática e robusta porque é uma placa de data center Ada madura, com 48 GB de memória ECC, largura de banda de memória de 864 GB/s, potência máxima de 350 W e ampla familiaridade em produção. A NVIDIA posiciona a L40S para IA generativa, treinamento e inferência de LLM, gráficos, renderização, Omniverse e workloads de vídeo.
Essa maturidade importa na aquisição em nuvem. Uma placa um pouco mais antiga pode vencer quando:
- Há capacidade disponível agora na região exata de que você precisa.
- As imagens do provedor, drivers, contêineres e monitoramento já estão estáveis.
- O workload cabe em 48 GB sem shard agressivo.
- Seu gargalo é tempo de fila, carregamento de dados, pré-processamento de CPU ou escalonamento de software, em vez do pico bruto de Tensor Core.
- Você está executando geração de imagens, renderização, vídeo ou jobs de computação visual que já apresentam bons benchmarks em Ada.
A questão nvidia l40s vs rtx pro 6000 muitas vezes se resume a saber se os 48 GB extras da RTX PRO 6000 mudam a forma de implantação. Se não mudarem, a L40S pode ser a opção de menor risco para aluguel ou capacidade reservada, especialmente para equipes com scripts e linhas de base já existentes.
Matriz de decisão por workload
Use esta matriz antes de pedir uma cotação a um provedor.
| Workload | Prefira a RTX PRO 6000 quando... | Prefira a L40S quando... | O que medir |
|---|---|---|---|
| Inferência de LLM de contexto longo | 48 GB limitam o comprimento do contexto, o tamanho do batch ou a folga do cache KV | 48 GB atendem aos alvos de contexto e concorrência no p95 | Tempo até o primeiro token, tokens/s, latência p95, taxa de OOM, respostas aceitas por hora |
| Serviço de modelo quantizado de classe 70B | 96 GB reduzem sharding, retries ou complexidade de posicionamento | Seu modelo quantizado e o cache KV cabem na L40S com a concorrência-alvo | Número de GPUs por réplica, atraso na fila, pontuação de qualidade, taxa de retry |
| Inferência multi-tenant | O isolamento MIG e a memória de 96 GB melhoram a utilização | A multitenância é tratada no nível do nó ou do scheduler | Utilização por tenant, incidentes de noisy neighbor, jobs com falha |
| Stable Diffusion e geração de imagens | Modelos maiores, batches ou etapas de mídia mista exigem mais memória | Os pipelines existentes já atendem às metas de throughput e qualidade | Imagens aceitas por hora, folga de VRAM, custo por imagem aceita |
| Renderização e gráficos 3D | Recursos de RT/mídia do Blackwell melhoram exatamente o renderizador ou pipeline | O desempenho da Ada L40S já foi validado para o renderizador | Tempo de frame/renderização, renders com falha, throughput de codificação/decodificação de mídia |
| Atualização corporativa | Você quer uma plataforma da era Blackwell para os próximos 24 meses | Você precisa de capacidade incremental com operações conhecidas | Utilização mínima, esforço de migração, SLA de suporte, disponibilidade de capacidade |
Esta é a forma útil de enquadrar l40s vs rtx 6000 pro: não qual página de produto tem o número maior, mas qual GPU altera o número de saídas aceitas que você consegue entregar por dólar.
Benchmark de saída aceita, não de especificações de pico
Um benchmark sério de l40s vs rtx pro 6000 deve reproduzir seu workload em vez de depender de picos genéricos. Meça a saída que seus usuários ou clientes aceitam.
Para inferência de LLM, colete:
| Métrica | Por que isso importa |
|---|---|
| Tempo até o primeiro token | Captura a latência do usuário interativo |
| Latência entre tokens | Mostra o comportamento de decode sob concorrência real |
| Concorrência estável | Expõe se 48 GB ou 96 GB alteram o batching |
| Escada de comprimento de contexto | Identifica quando surge a pressão no cache KV |
| Taxa de OOM e retry | Converte adequação de memória em custo real |
| Respostas aceitas por hora | Normaliza filtros de qualidade, falhas e retries |
| Custo por 1M de tokens de saída aceitos | Permite que RTX PRO 6000, L40S e APIs de modelo compartilhem uma métrica |
| Horas de engenharia por mês | Captura o trabalho de driver, kernel, fila, incidentes e benchmarks |
Para workloads de imagem, vídeo, renderização ou multimodais, substitua tokens aceitos por imagens aceitas, clipes aceitos, frames renderizados ou jobs concluídos. A lógica é a mesma. Uma placa que parece mais rápida em um benchmark de fornecedor pode perder se aumentar a contenção na fila, gerar mais jobs com falha ou exigir uma migração de software que sua equipe não consegue manter.
Perguntas ao provedor antes de alugar a RTX PRO 6000 ou a L40S
Faça estas perguntas antes de se comprometer com qualquer uma das GPUs:
- A capacidade da RTX PRO 6000 é especificamente a Blackwell Server Edition, e é refrigerada a ar com dois slots ou líquida com um slot?
- A capacidade da L40S é dedicada, fracionada, conteinerizada ou faz parte de um serviço de jobs gerenciado?
- Quais versões de driver, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch e contêiner são suportadas?
- O provedor expõe MIG na RTX PRO 6000, e como as instâncias são cobradas?
- As execuções de benchmark são cobradas em tarifa sob demanda, tarifa reservada ou incluídas em uma janela de avaliação?
- Qual é a região, o fabric de rede, a CPU do host, a classe de armazenamento e a capacidade local de NVMe?
- Jobs com falha, tempo ocioso, tempo de fila, snapshots e egress são cobrados separadamente?
- Qual SLA de suporte e caminho de substituição se aplicam quando um host de GPU está com problema?
- É possível exportar utilização de GPU por job, uso de memória, atraso na fila, taxa de retry e custo?
- Qual é o caminho de fallback se a disponibilidade, os drivers ou os kernels do Blackwell ficarem atrás do seu cronograma de lançamento?
Combine essas respostas com o guia de preços de aluguel de GPU da Flatkey, a planilha de TCO de cluster de GPU e o artigo GPU cloud vs model API. Se você ainda estiver decidindo a classe de GPU, leia antes o guia mais amplo best GPU for LLM inference para então restringir a nvidia l40s vs rtx pro 6000.
Onde a Flatkey se encaixa
A Flatkey não substitui a RTX PRO 6000 nem a L40S quando você precisa de controle direto da GPU. Se você executa pesos privados, kernels personalizados, localidade de dados rigorosa, pipelines dedicados de renderização ou pesquisa em nível de hardware, ainda precisa de capacidade de GPU em nuvem ou de infraestrutura própria.
A Flatkey é a referência a ser superada quando sua equipe precisa principalmente de saída confiável de modelos. Com uma chave e um saldo únicos entre modelos oficiais e ferramentas de IA, as equipes podem encaminhar workloads de API, acompanhar o uso, comparar o custo do modelo e evitar contas fragmentadas em diferentes provedores. Isso dá ao financeiro e à engenharia um grupo de controle limpo antes de se comprometer com capacidade fixa de GPU.
Na prática, execute três caminhos:
| Path | Quando vence |
|---|---|
| RTX PRO 6000 | Mais memória ou recursos Blackwell reduzem o número de GPUs, falhas ou latência o suficiente para compensar o custo mais alto |
| L40S | 48GB é suficiente e a capacidade Ada madura tem o melhor preço por saída aceita |
| API de modelo gerenciada pela Flatkey | Não é necessário controle direto da GPU e a simplicidade operacional supera a posse da infraestrutura |
A vencedora certa é o caminho com o menor custo por saída aceita no seu alvo de qualidade e latência.
Recomendação final
Para l40s vs rtx pro 6000, faça da RTX PRO 6000 sua primeira referência quando folga de memória, suporte a FP4/Blackwell, PCIe Gen 5 ou particionamento MIG puderem mudar a arquitetura de serving. Faça da L40S sua primeira referência quando a carga de trabalho já couber dentro de 48GB e a capacidade Ada madura for mais barata ou mais fácil de reservar.
Depois compare ambas com uma linha de base de modelo/API. Se a Flatkey ou outro caminho de API gerenciada atender aos requisitos de qualidade, latência, privacidade e custo, o aluguel de GPU precisará justificar o trabalho operacional extra. Se não conseguir, o caminho de hardware está justificado, e a escolha final se torna uma reprodução da carga: rtx pro 6000 vs l40s em saída aceita, não em picos de marketing.
Perguntas frequentes
A RTX PRO 6000 Blackwell é mais rápida que a L40S?
Nas especificações públicas da NVIDIA, a RTX PRO 6000 Blackwell Server Edition tem desempenho FP32 listado mais alto, mais memória, maior largura de banda de memória, Tensor Cores mais novos e suporte a FP4. Isso não significa que ela seja mais barata para todas as cargas de trabalho. Faça benchmarking da sua stack de serving exata e do custo por saída aceita.
A L40S ainda é boa para inferência de LLM?
Sim, quando o modelo, a janela de contexto e a meta de concorrência cabem dentro de 48GB. A L40S ainda pode ser prática para inferência de LLM, geração de imagens, renderização, vídeo e cargas mistas de computação visual, especialmente quando a capacidade do provedor é madura.
Qual é a maior diferença entre a NVIDIA RTX PRO 6000 e a L40S?
A maior diferença prática é a memória. A RTX PRO 6000 Blackwell Server Edition lista 96GB de GDDR7 e 1.597 GB/s de largura de banda de memória; a L40S lista 48GB de GDDR6 e 864 GB/s de largura de banda de memória. A RTX PRO 6000 também adiciona um caminho Blackwell FP4 e suporte a MIG.
Devo fazer upgrade da L40S para a RTX PRO 6000?
Faça upgrade quando os limites de memória da L40S estiverem gerando mais shards, lotes menores, janelas de contexto mais curtas, jobs com falha ou baixa utilização. Permaneça na L40S quando ela já atender às suas metas de latência e qualidade com um custo por saída aceita menor.
Devo usar uma API de modelo em vez de alugar qualquer uma das GPUs?
Use uma API de modelo quando você não precisar de pesos personalizados, controle direto de CUDA, agendamento privado de GPU ou aceleração de renderização/mídia. Uma API de modelo pode ser o melhor caminho econômico quando a demanda de workload é volátil ou a utilização da GPU seria baixa.
Fontes verificadas
- Página do produto NVIDIA RTX PRO 6000 Blackwell Server Edition
- Página do produto NVIDIA L40S
- Página da arquitetura Blackwell da NVIDIA
- Mapa temático de Cloud GPU da Flatkey e fonte de palavra-chave Cloud GPU datada de 2026-10-10
- Visão geral do produto Flatkey e posicionamento aprovado: uma chave, um saldo, modelos oficiais, registro de uso por chamada bem-sucedida


