
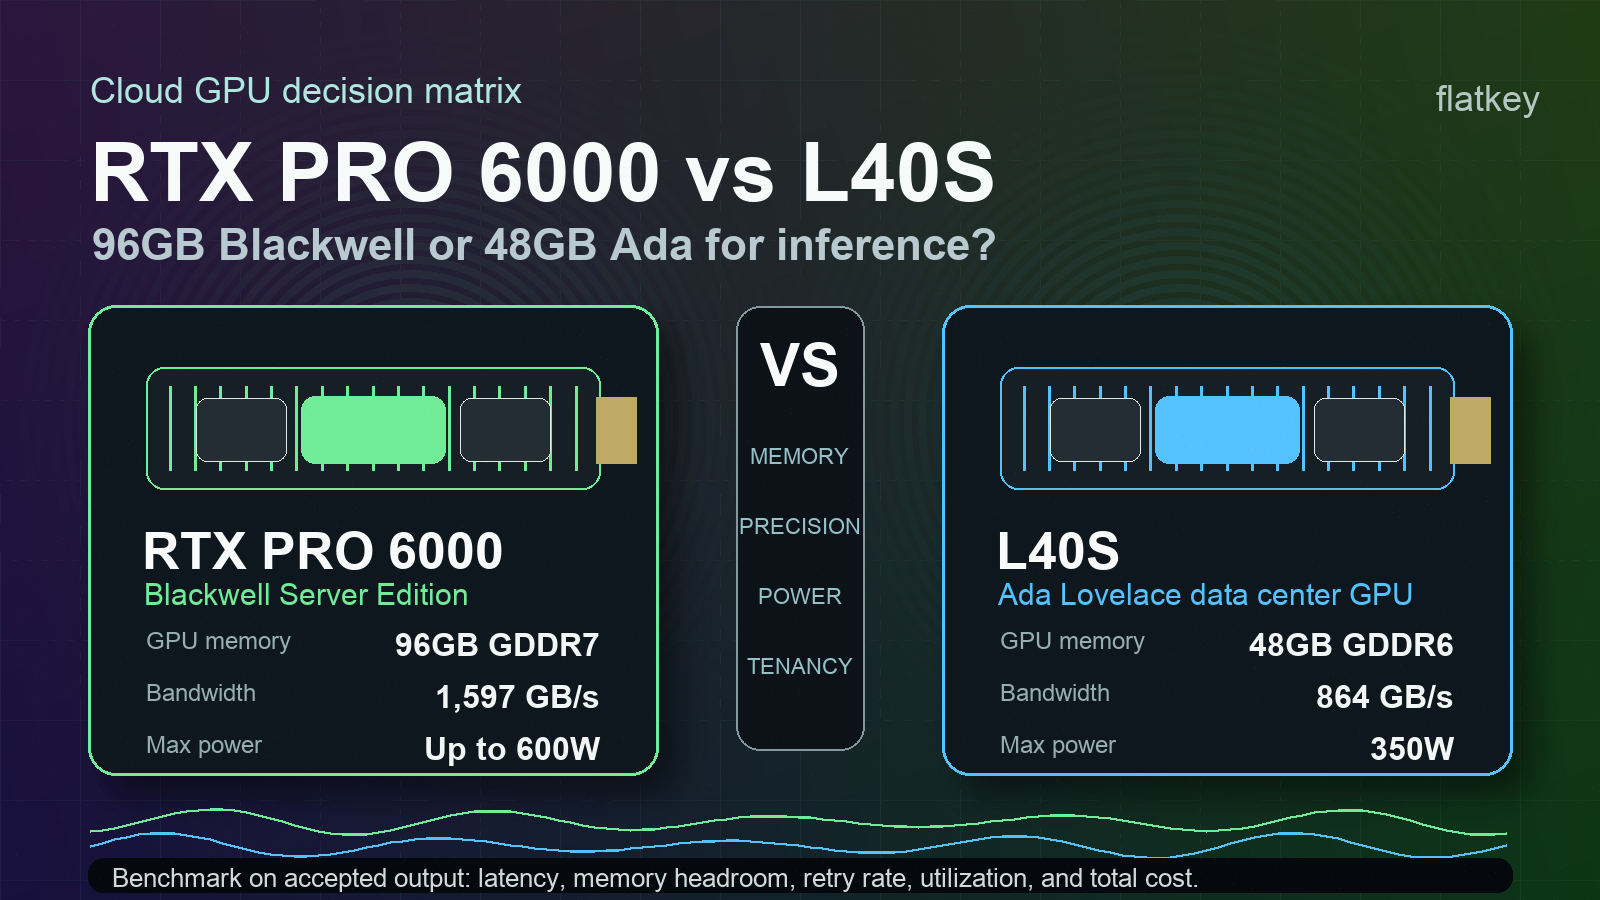
RTX PRO 6000 vs L40S: 96GB Blackwell or Ada 推論 GPU?
l40s vs rtx pro 6000 に対する簡潔な答えは、NVIDIA RTX PRO 6000 Blackwell Server Edition を選ぶべきなのは、96GB の GPU メモリ、Blackwell の FP4 サポート、PCIe Gen 5、MIG 分割、新しいメディアエンジンが、あなたのサービング設計を変えうる場合です。NVIDIA L40S を選ぶべきなのは、ワークロードがすでに 48GB に収まり、スタックが Ada GPU 上で成熟しており、価格差または入手性の差が新しいカードを上回るほど大きい場合です。
これは「新しい GPU が常に勝つ」という単純な判断ではありません。rtx pro 6000 vs l40s の比較は、実際にはメモリ適合性、精度サポート、ソフトウェアの成熟度、電力予算、そして許容される出力コストに関するものです。RTX PRO 6000 によって、より少ないシャード、大きなコンテキストウィンドウ、より大きなバッチ、または OOM(メモリ不足)再試行の削減が可能になるなら、それはより強力な推論 GPU になりえます。L40S の容量がより安価で、予約しやすく、すでにレイテンシ目標を満たしているなら、旧世代の Ada カードであっても実用的な選択肢です。
確認日: 2026 年 10 月 13 日。
L40S vs RTX PRO 6000: 実用上の違い
ベンダーのベンチマークを依頼する前の、最初の調達判断としてこの表を使ってください。
| 判断ポイント | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| GPU 世代 | Blackwell | Ada Lovelace |
| 主な購入理由 | 大容量メモリ、新しい Tensor Cores、FP4 パス、PCIe Gen 5、ワークロード分割 | 推論、レンダリング、グラフィックス、動画向けの成熟した 48GB データセンター GPU |
| GPU メモリ | ECC 付き 96GB GDDR7 | ECC 付き 48GB GDDR6 |
| メモリ帯域幅 | 1,597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91.6 TFLOPS |
| Tensor 精度の見出し | FP4 4 PFLOPS、FP8 2 PFLOPS、FP16/BF16 1 PFLOP | 疎行列ありで FP8 733 / 1,466 TFLOPS、疎行列ありで FP16/BF16 362.05 / 733 TFLOPS |
| 最大電力 | 最大 600W、設定可能 | 350W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | RTX PRO 6000 では最大 4 つの分離されたインスタンス | L40S については MIG サポートの記載なし |
| 最初のテストに最適 | 長文コンテキストの LLM 推論、大きなマルチモーダルモデル、マルチテナント GPU 共有、FP4/Blackwell 最適化サービング | 48GB に収まりやすい LLM、Stable Diffusion 風の画像生成、レンダリング、動画、成熟した Ada フリート |
出典: NVIDIA の RTX PRO 6000 Blackwell Server Edition 製品ページ、NVIDIA の L40S 製品ページ、NVIDIA の Blackwell アーキテクチャページ。
簡単な推奨
l40s vs rtx pro 6000 のベンチマークは、ピーク TFLOPS ではなくメモリから始めてください。
- モデルが L40S 上でメモリ制約を受ける場合、コンテキスト長や KV キャッシュの圧力が GPU 数を左右する場合、FP4/Blackwell 推論パスを試したい場合、または分離された GPU スライスが共有エンタープライズクラスターで重要な場合は、RTX PRO 6000 Blackwell Server Edition を選びます。
- モデル、バッチサイズ、コンテキストウィンドウが 48GB に無理なく収まる場合、本番スタックがすでに Ada 向けに調整されている場合、あるいはプロバイダーの価格差が大きく、旧世代 GPU のほうが許容出力コストで勝つ場合は、L40S を選びます。
- カスタム重み、CUDA 制御、プライベートな GPU スケジューリング、あるいは直接的なメディア/レンダリング加速が不要なら、モデル API のベースライン を使ってください。キューイング、再試行、アイドル時間、エンジニアリングのオーバーヘッドを考慮した後で、ハードウェアはマネージドなモデル呼び出しのコストと運用の簡便さに勝たなければなりません。
最後の点こそが、nvidia rtx pro 6000 vs l40s の判断をスペック表だけで終わらせるべきではない理由です。利用率が低い、またはチームが GPU 運用を自前で担う必要がない場合、より高速なカードであっても誤った購入になりえます。
RTX PRO 6000 が推論の前提を変える理由
RTX PRO 6000 Blackwell Server Edition は、L40S と比べて公称メモリ容量が 2 倍です。つまり、48GB GDDR6 ではなく 96GB GDDR7 です。また、公称メモリ帯域幅も L40S の 864 GB/s から 1,597 GB/s に増加しています。
推論チームにとって、メモリは単なる「モデルサイズ」ではありません。KV キャッシュ、バッチ余力、ランタイムバッファ、アダプター、マルチモーダル入力、長いプロンプトに対する安全マージン、テナンシーのオーバーヘッドも含まれます。実運用では、OOM エラーを回避したり、テンソル並列のシャーディングを減らせたりするカードが、見かけ上の時間単価が低いカードを上回ることがあります。
RTX PRO 6000 は、特に次のような場合に試す価値があります。
- 長文コンテキストの LLM トラフィックを提供しており、KV キャッシュがメモリ計画の大部分を占める。
- 70B 級以上の量子化モデルを、より少ないシャードで試したい。
- 画像、動画、埋め込み、再ランキング、LLM コンポーネントがメモリを奪い合う、混在したマルチモーダルワークロードを実行している。
- 複数ユーザーまたは複数ワークロード向けに物理 GPU を分割する必要がある。NVIDIA は RTX PRO 6000 に最大 4 つの分離された MIG インスタンスを掲載している。
- FP4/NVFP4、TensorRT-LLM、vLLM、SGLang の改善など、Blackwell 固有のサービングパスを評価している。
電力面のトレードオフは現実的です。NVIDIA は RTX PRO 6000 を最大 600W の設定可能値としており、L40S は 350W です。プロバイダーが契約サーバー、電力枠、ラック密度、予約容量で料金を決めるなら、その高い上限は rtx 6000 pro vs l40s のコストモデルに含める必要があります。GPU の時間単価だけを比較して、電力、冷却、ホスト構成、サポート、テナンシーが何を含むのかを確認しないのは避けてください。
L40S が依然として有用な理由
L40S は、48GB ECC メモリ、864 GB/s のメモリ帯域幅、350W の最大消費電力、そして幅広い本番環境での実績を備えた成熟した Ada データセンター向けカードであるため、依然として実用性の高い GPU です。NVIDIA は L40S を、生成 AI、LLM の学習と推論、グラフィックス、レンダリング、Omniverse、動画ワークロード向けに位置付けています。
この成熟度はクラウド調達において重要です。やや古いカードでも、次のような場合には勝つことがあります。
- 必要な正確なリージョンで、今すぐ容量を確保できる。
- プロバイダーのイメージ、ドライバー、コンテナ、監視がすでに安定している。
- ワークロードが大規模なシャーディングなしで 48GB に収まる。
- ボトルネックが生の Tensor Core のピーク性能ではなく、キュー時間、データ読み込み、CPU 前処理、またはソフトウェアのスケジューリングにある。
- すでに Ada 上で良好なベンチマークが出ている画像生成、レンダリング、動画、またはビジュアルコンピューティングのジョブを実行している。
nvidia l40s vs rtx pro 6000 の問いは、多くの場合、RTX PRO 6000 の追加 48GB がデプロイ形態を変えるかどうかに集約されます。そうでなければ、L40S は、特に既存のスクリプトやベースラインを持つチームにとって、リスクの低いレンタルまたは予約容量の選択肢になり得ます。
ワークロード別の意思決定マトリクス
プロバイダーに見積もりを依頼する前に、このマトリクスを使ってください。
| ワークロード | RTX PRO 6000 を優先するのは... | L40S を優先するのは... | 計測する項目 |
|---|---|---|---|
| 長文コンテキストの LLM 推論 | 48GB ではコンテキスト長、バッチサイズ、または KV キャッシュの余裕が不足する | 48GB で p95 のコンテキストおよび同時実行ターゲットを満たせる | 初回トークンまでの時間、tokens/sec、p95 レイテンシ、OOM 発生率、受理応答数/時 |
| 量子化された 70B クラスモデルの提供 | 96GB によりシャーディング、再試行、または配置の複雑さが減る | 量子化モデルと KV キャッシュが、目標同時実行数で L40S に収まる | レプリカあたりの GPU 数、キュー遅延、品質スコア、再試行率 |
| マルチテナント推論 | MIG 分離と 96GB メモリにより利用率が向上する | テナンシーはノードまたはスケジューラ層で処理される | テナント別利用率、ノイジーネイバーの発生件数、失敗ジョブ数 |
| Stable Diffusion と画像生成 | より大きなモデル、バッチ、またはマルチメディア段階に、より多くのメモリが必要 | 既存のパイプラインがすでにスループットと品質の目標を満たしている | 受理画像数/時、VRAM の余裕、受理画像あたりのコスト |
| レンダリングと 3D グラフィックス | Blackwell の RT/メディア機能が、対象のレンダラーまたはパイプラインを改善する | Ada L40S の性能が、すでにそのレンダラーで検証済みである | フレーム/レンダリング時間、失敗レンダー数、メディアのエンコード/デコードスループット |
| エンタープライズ刷新 | 今後 24 か月のために Blackwell 世代のプラットフォームを望む | 既知の運用のまま段階的に容量を増やしたい | 最低稼働率、移行工数、サポート SLA、容量の可用性 |
これは l40s vs rtx 6000 pro を考える際の有用な捉え方です。どの製品ページの数字が大きいかではなく、どの GPU が 1 ドルあたりに出荷できる受理済み出力数を変えるか、が重要です。
ピーク仕様ではなく、受理済み出力をベンチマークする
本格的な l40s vs rtx pro 6000 ベンチマークでは、一般的なピーク値に頼るのではなく、自分のワークロードを再生すべきです。ユーザーや顧客が受け入れる出力を計測してください。
LLM 推論では、次を収集します。
| 指標 | 重要な理由 |
|---|---|
| 初回トークンまでの時間 | 対話型ユーザーのレイテンシを捉える |
| トークン間レイテンシ | 実際の同時実行時のデコード挙動を示す |
| 安定同時実行数 | 48GB または 96GB がバッチングを変えるかどうかを明らかにする |
| コンテキスト長の段階評価 | KV キャッシュの圧迫がいつ発生するかを見つける |
| OOM と再試行率 | メモリ適合性を実コストに変換する |
| 1 時間あたりの受理応答数 | 品質フィルタ、失敗、再試行を正規化する |
| 受理済み出力トークン 100 万個あたりのコスト | RTX PRO 6000、L40S、モデル API を同一指標で比較できる |
| 月あたりのエンジニア工数 | ドライバー、カーネル、キュー、インシデント、ベンチマークにかかる作業を捉える |
画像、動画、レンダリング、またはマルチモーダルのワークロードでは、受理済みトークンを受理済み画像、受理済みクリップ、レンダリング済みフレーム、または完了ジョブに置き換えます。考え方は同じです。ベンダーのベンチマークでは速く見えるカードでも、キューの競合を増やしたり、失敗ジョブを増やしたり、チームが維持できないソフトウェア移行を必要としたりすれば、負けることがあります。
RTX PRO 6000 または L40S をレンタルする前のプロバイダーへの質問
どちらの GPU にするか決める前に、次の質問をしてください。
- RTX PRO 6000 の容量は、具体的に Blackwell Server Edition ですか。また、空冷のデュアルスロットですか、それとも液冷のシングルスロットですか。
- L40S の容量は、専有型、分割型、コンテナ型、それともマネージドジョブサービスの一部ですか。
- どのドライバー、CUDA、TensorRT-LLM、vLLM、SGLang、PyTorch、コンテナの各バージョンがサポートされていますか。
- プロバイダーは RTX PRO 6000 で MIG を公開していますか。また、インスタンスの課金方法はどうなっていますか。
- ベンチマーク実行はオンデマンド料金、予約料金、それとも評価期間に含まれますか。
- リージョン、ネットワークファブリック、ホスト CPU、ストレージクラス、ローカル NVMe 容量は何ですか。
- 失敗ジョブ、アイドル時間、キュー時間、スナップショット、egress は別料金ですか。
- GPU ホストの状態が不健全な場合、どのサポート SLA と交換パスが適用されますか。
- ジョブごとの GPU 利用率、メモリ使用量、キュー遅延、再試行率、コストをエクスポートできますか。
- Blackwell の可用性、ドライバー、カーネルがリリーススケジュールに遅れた場合のフォールバック経路は何ですか。
これらの回答を、FlatkeyのGPUレンタル価格ガイド、GPUクラスターTCOワークシート、およびGPUクラウド vs モデルAPIと組み合わせてください。まだGPUクラスを決めかねているなら、nvidia l40s vs rtx pro 6000に絞り込む前に、より広いLLM推論向け最適GPUガイドを読んでください。
Flatkeyが適する場面
RTX PRO 6000やL40Sが必要なのに、直接GPU制御を行う場合は、Flatkeyはそれらの代替にはなりません。プライベート重み、カスタムカーネル、厳格なデータローカリティ、専用レンダリングパイプライン、またはハードウェアレベルの研究を行うなら、依然としてクラウドGPU容量か自前のインフラが必要です。
チームが主に信頼できるモデル出力を必要としているなら、Flatkeyは比較対象となるベースラインです。公式モデルとAIツール全体で1つのキーと1つの残高を使えるため、チームはAPIワークロードをルーティングし、使用量を追跡し、モデルコストを比較し、プロバイダーアカウントの分散を避けられます。これにより、財務とエンジニアリングは固定GPU容量にコミットする前に、明確な比較基準を持てます。
実務では、次の3つの経路を比較してください。
| 経路 | 勝つ条件 |
|---|---|
| RTX PRO 6000 | より大きなメモリやBlackwell機能により、GPU台数、障害、または遅延が十分減って高コストを相殺できる場合 |
| L40S | 48GBで十分で、成熟したAda容量が最も低い承認済み出力コストを実現する場合 |
| Flatkey経由のマネージドモデルAPI | 直接GPU制御が不要で、インフラ所有より運用のシンプルさが勝る場合 |
真の勝者は、品質とレイテンシーの目標において、承認済み出力1件あたりの総コストが最も低い経路です。
最終推奨
l40s vs rtx pro 6000では、メモリの余裕、FP4/Blackwell対応、PCIe Gen 5、またはMIG分割によって提供アーキテクチャが変わるなら、RTX PRO 6000を最初のベンチマークにしてください。ワークロードがすでに48GB以内に収まり、成熟したAda容量のほうが安価または予約しやすいなら、L40Sを最初のベンチマークにしてください。
そのうえで、両者をモデル/APIのベースラインと比較してください。Flatkeyまたは別のマネージドAPI経路で品質、レイテンシー、プライバシー、コスト要件を満たせるなら、GPUレンタルは追加の運用負荷を正当化する必要があります。満たせないなら、ハードウェア経路は正当化され、最終的な選択はマーケティング上のピーク値ではなく、承認済み出力に基づくワークロード再現比較、すなわちrtx pro 6000 vs l40sになります。
よくある質問
RTX PRO 6000 BlackwellはL40Sより高速ですか?
NVIDIAの公開仕様では、RTX PRO 6000 Blackwell Server Editionは、掲載されているFP32性能、メモリ容量、メモリ帯域幅、新しいTensor Core、FP4サポートが上回っています。だからといって、すべてのワークロードで安価とは限りません。実際の提供スタックと承認済み出力コストでベンチマークしてください。
L40SはまだLLM推論に適していますか?
はい、モデル、コンテキストウィンドウ、同時実行目標が48GB以内に収まるなら適しています。L40Sは、特にプロバイダーの容量が成熟している環境では、LLM推論、画像生成、レンダリング、動画、そして混在したビジュアルコンピューティングのワークロードに依然として実用的です。
NVIDIA RTX PRO 6000とL40Sの最大の違いは何ですか?
最大の実務上の違いはメモリです。RTX PRO 6000 Blackwell Server Editionは96GB GDDR7と1,597 GB/sのメモリ帯域幅を、L40Sは48GB GDDR6と864 GB/sのメモリ帯域幅を示しています。RTX PRO 6000にはBlackwellのFP4パスとMIGサポートも追加されています。
L40SからRTX PRO 6000にアップグレードすべきですか?
L40Sのメモリ制限が、追加のシャード、小さいバッチ、短いコンテキストウィンドウ、失敗ジョブ、または低い利用率を生んでいる場合はアップグレードしてください。L40Sがすでに低い承認済み出力コストでレイテンシーと品質の目標を満たしているなら、そのまま使い続けてください。
どちらかのGPUを借りる代わりにモデルAPIを使うべきですか?
カスタム重み、直接CUDA制御、プライベートなGPUスケジューリング、またはレンダリング/メディア加速が不要なら、モデルAPIを使ってください。ワークロード需要が変動的である場合や、GPU利用率が低くなりそうな場合、モデルAPIのほうが経済的に優れた経路になることがあります。
確認したソース
- NVIDIA RTX PRO 6000 Blackwell Server Edition 製品ページ
- NVIDIA L40S 製品ページ
- NVIDIA Blackwellアーキテクチャページ
- Flatkey Cloud GPUトピックマップおよび2026-10-10付のCloud GPUキーワードソース
- Flatkeyの製品概要と承認済みポジショニング: 1つのキー、1つの残高、公式モデル、成功した呼び出しごとの利用台帳


