
Coûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
Prix du GPU H100 : tarifs, facteurs de coût et guide d’achat
Guide des prix du GPU H100 pour comparer une offre PCIe à 32 200 $, des instantanés de location cloud, les formats et le TCO d’un devis sur site.

Serveur GPU : guide de l’architecture, des performances et du déploiement cloud
Choisissez et déployez un serveur GPU cloud grâce à un cadre axé sur les charges de travail, les tests de performances et la préparation à la production.
API LLM gratuite : limites, coûts et compromis de production
Guide pratique des offres gratuites d’API LLM : crédits, limites de débit, coûts d’exploitation cachés et contrôles à ajouter avant que les utilisateurs ne dépendent d’une route.
ComfyUI sur un GPU cloud : guide d’installation, stockage et coûts
Guide pratique pour déployer ComfyUI sur un GPU cloud avec stockage persistant, accès privé, sélection du GPU selon la charge de travail et maîtrise des coûts.

API LLM les moins chères en 2026 : comparez les prix selon la charge de travail, pas le battage médiatique
Un guide vérifié à la source pour comparer les API LLM à bas coût selon la charge de travail, y compris les coûts d’entrée, de sortie, de cache, de traitement par lots, d’outils, de relances et de correction.

Infrastructure d’IA souveraine : modèles, résidence des données et maîtrise du calcul (guide 2026)
Guide pratique de l’infrastructure d’IA souveraine en 2026 : ses quatre couches (calcul, données, modèles, exploitation), les réglementations qui la motivent, cinq niveaux de souveraineté, une configuration de déploiement de modèles à poids ouverts et un exemple de coût GPU dans le pays pour un modèle 70B.

Clé API Anthropic (2026) : comment l’obtenir, types de clés, Claude Code et erreurs
Guide pas à pas de la clé API Anthropic en 2026 : configuration dans Console, clés personnelles et de compte de service, expiration, première requête, Claude Code, coûts et erreurs.

Tarifs de l'API Grok (2026) : tous les modèles, frais d'outils et multiplicateurs
Tarifs actuels de l'API xAI Grok : texte, image, vidéo et voix, les cinq multiplicateurs (contexte long, priorité, région US, Batch et outils), un calculateur de coûts et une comparaison avec GPT, Claude, Gemini et Qwen.
Tarifs de l'API Mistral (2026) : tous les modèles, remise batch et exemples de coût
Grille complète des tarifs de l'API Mistral (données officielles d'octobre 2026), offre gratuite, remises batch et cache, calculateur de coûts, comparatif avec GPT, Claude, Gemini et Qwen, et code.
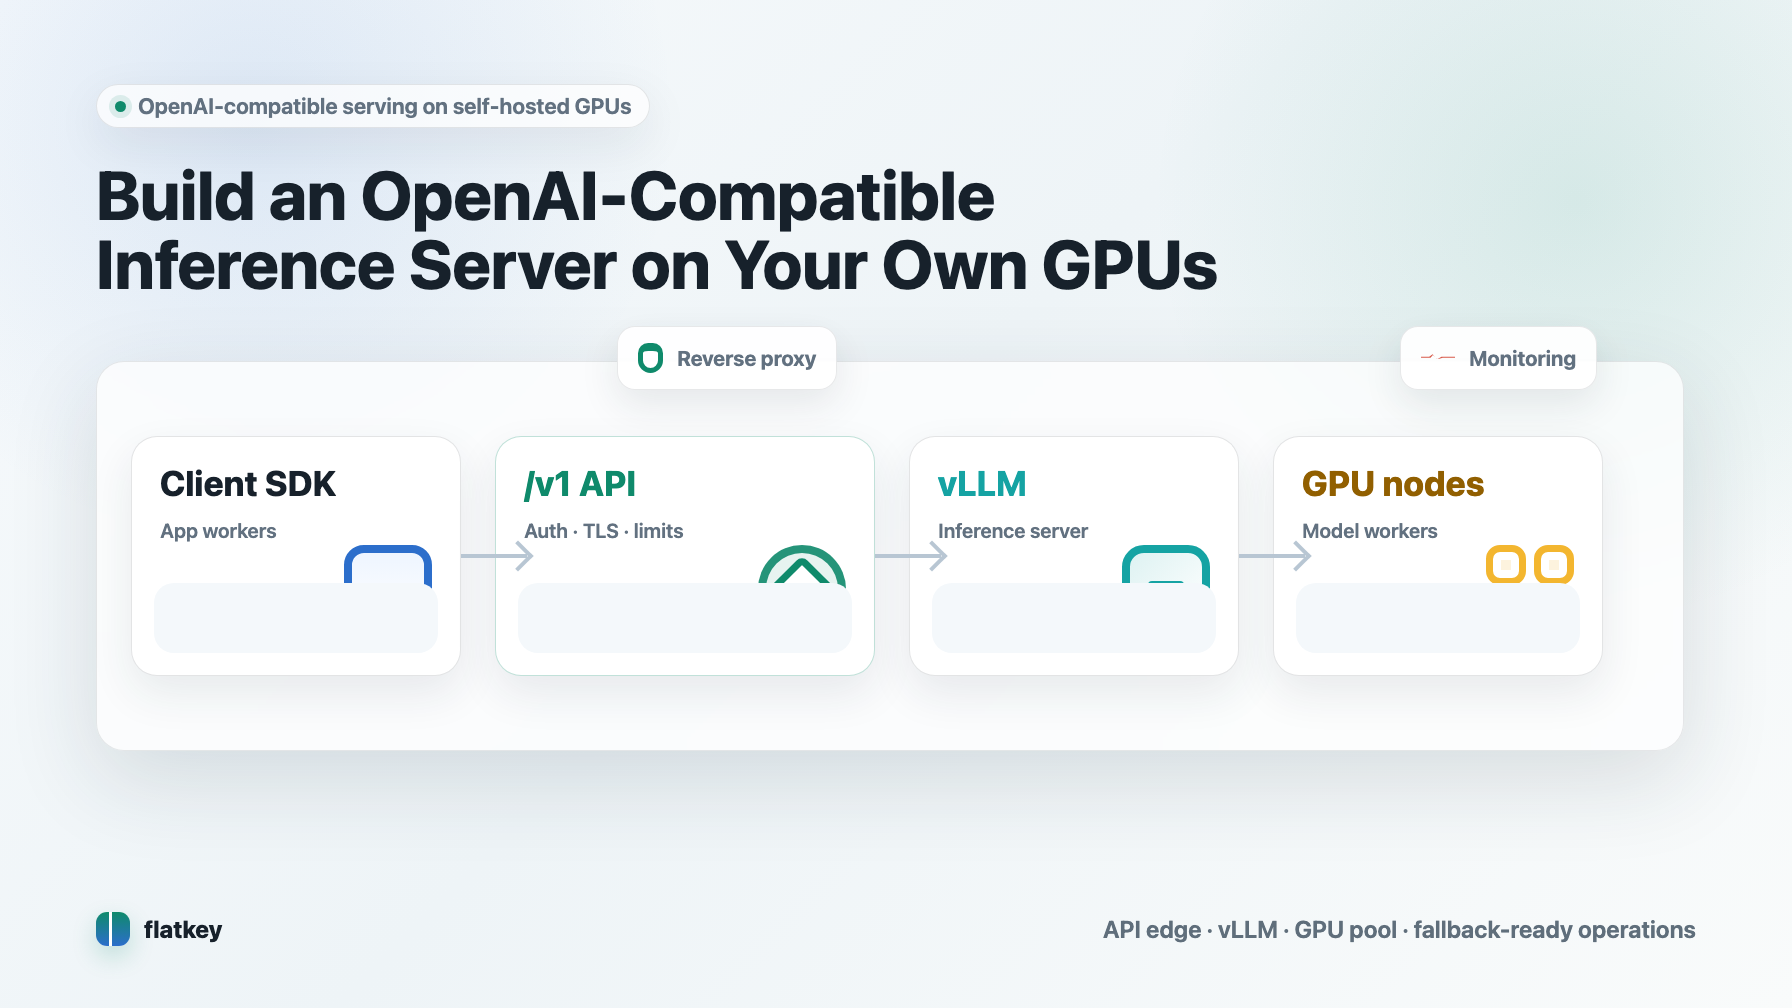
Guide du LLM auto-hébergé (2026) : rentabilité, matériel nécessaire et déploiement
Un LLM auto-hébergé exécute des modèles à poids ouverts sur des GPU que vous contrôlez. Découvrez quand il devient plus rentable qu’une API facturée au token, avec les tarifs GPU d’octobre 2026, comment dimensionner la mémoire GPU, quel outil de service choisir et comment déployer un serveur vLLM compatible OpenAI avec une solution de secours.
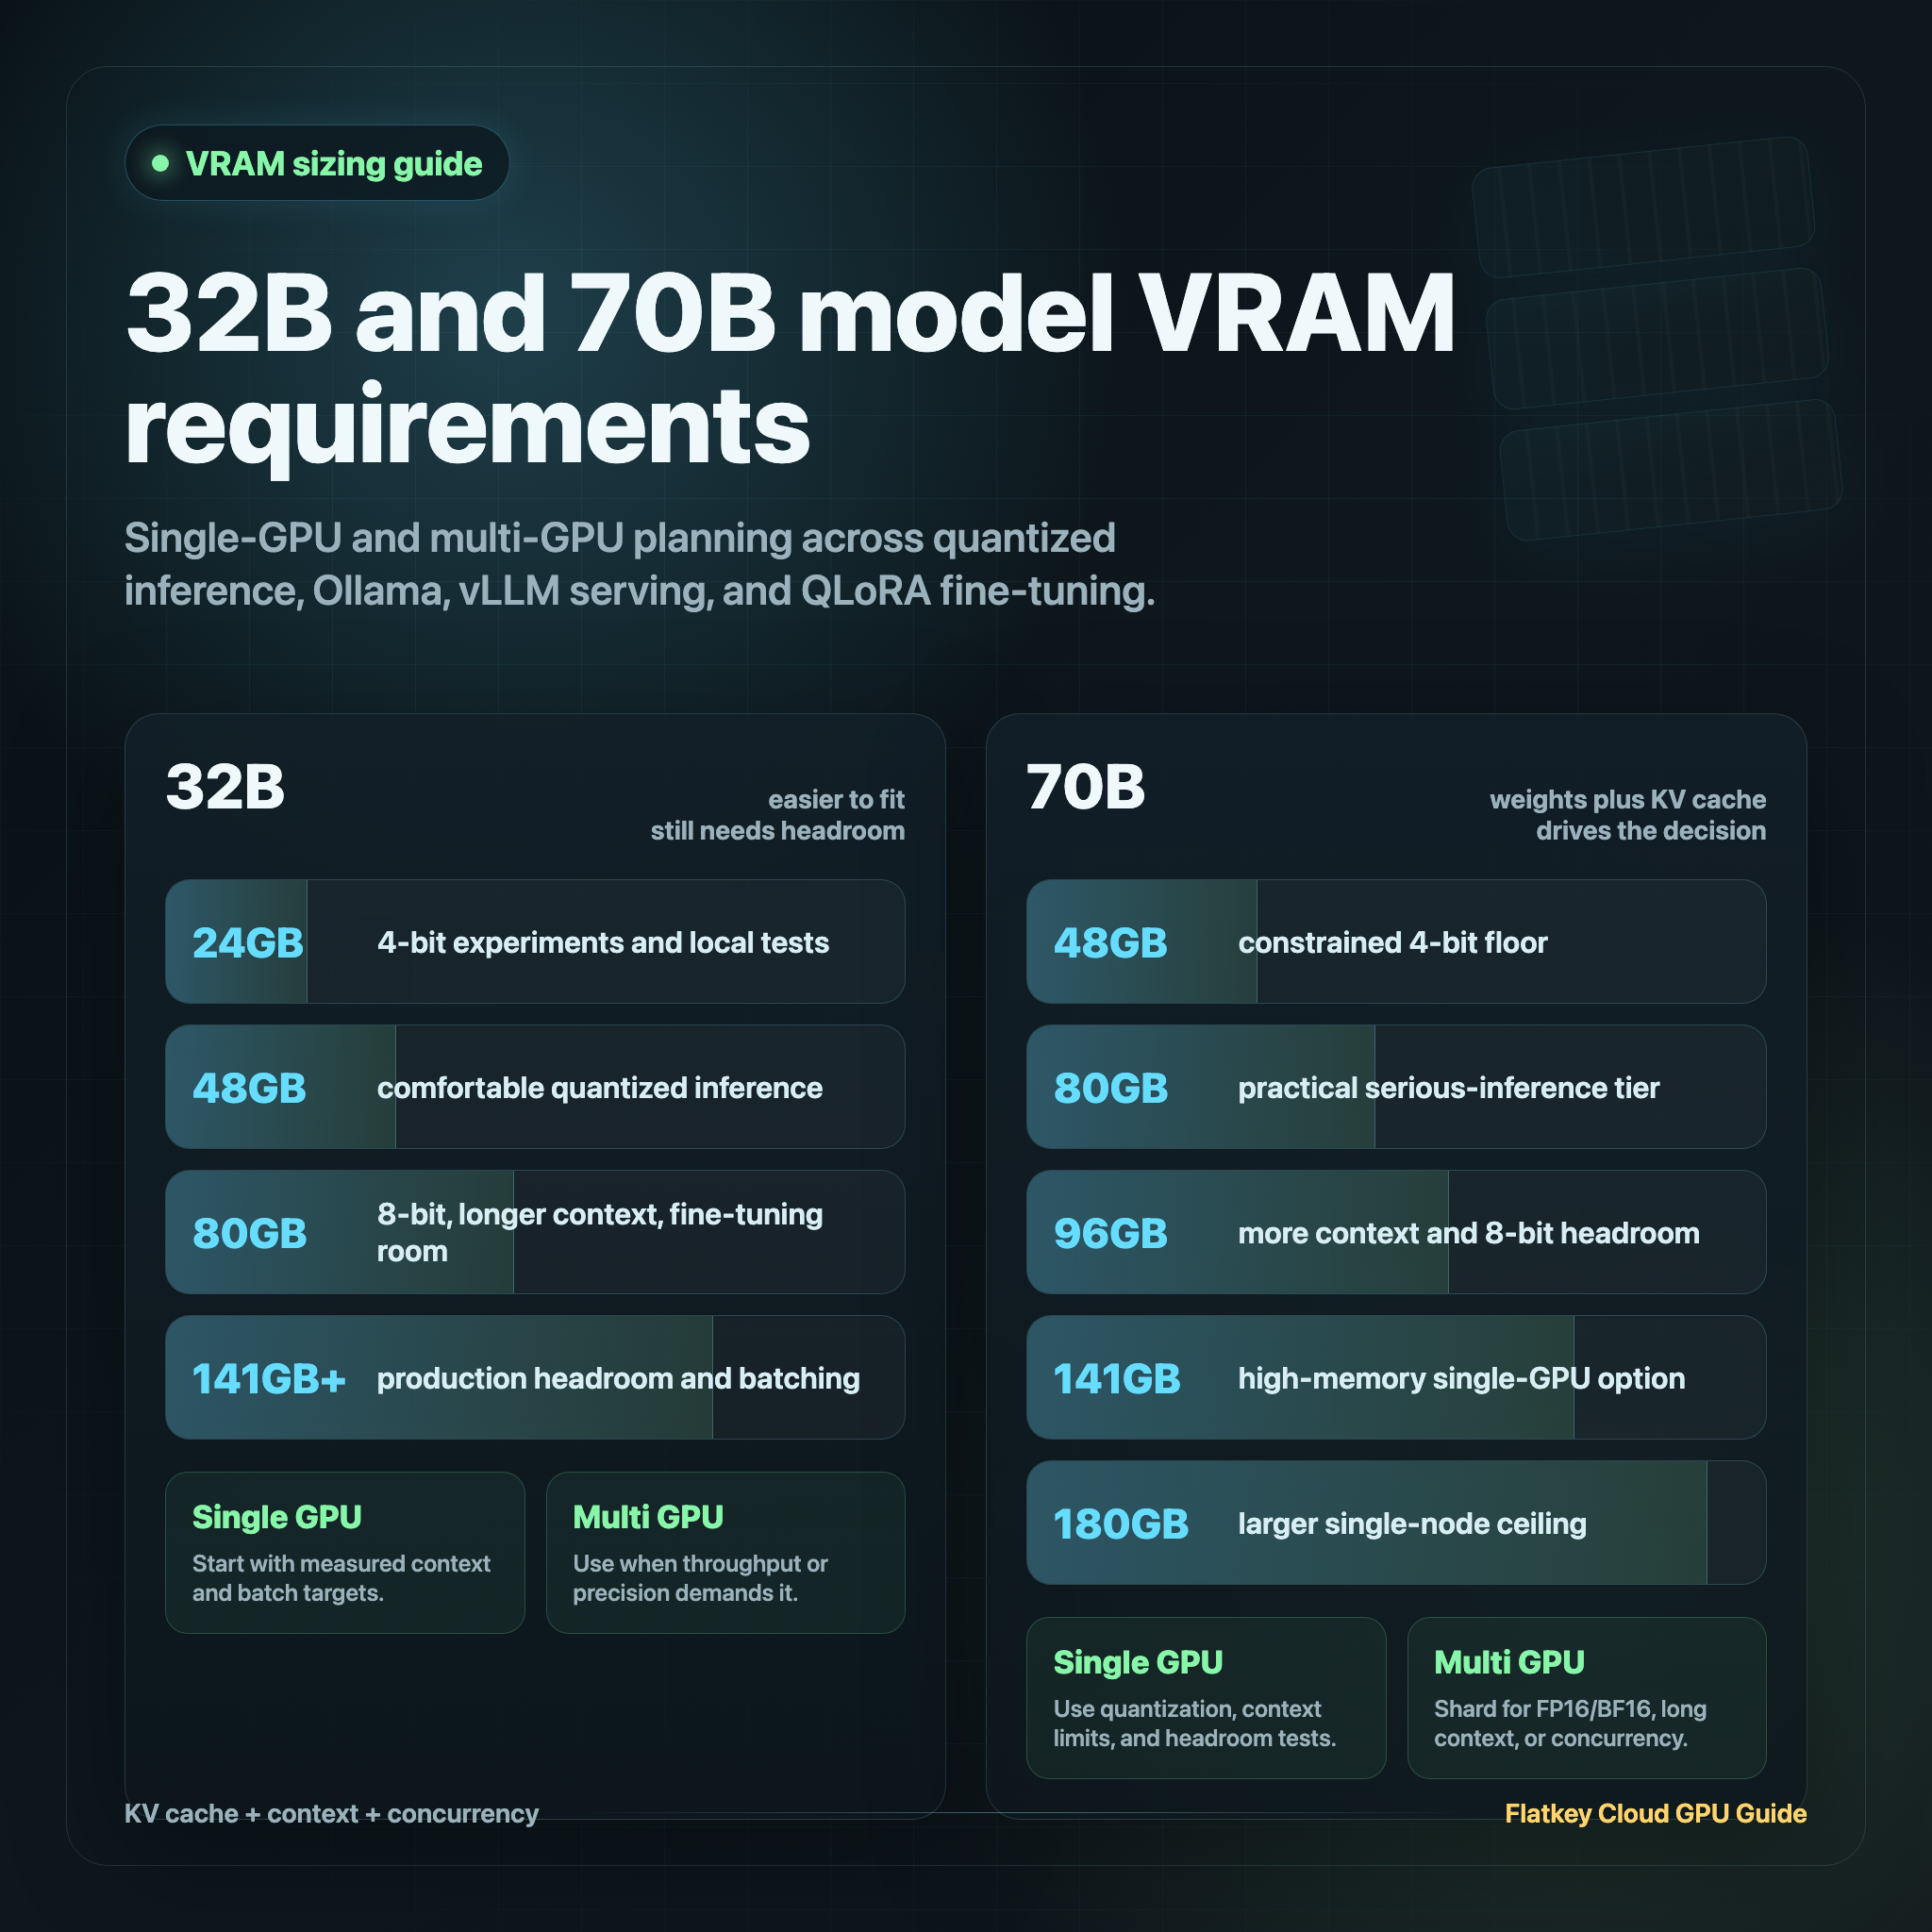
Guide VRAM pour les modèles 32B et 70B : options mono-GPU et multi-GPU
Découvrez les besoins pratiques en VRAM des modèles 32B et 70B pour l’inférence en 4 bits, 8 bits, FP16/BF16, Ollama, le fine-tuning QLoRA et les options multi-GPU.
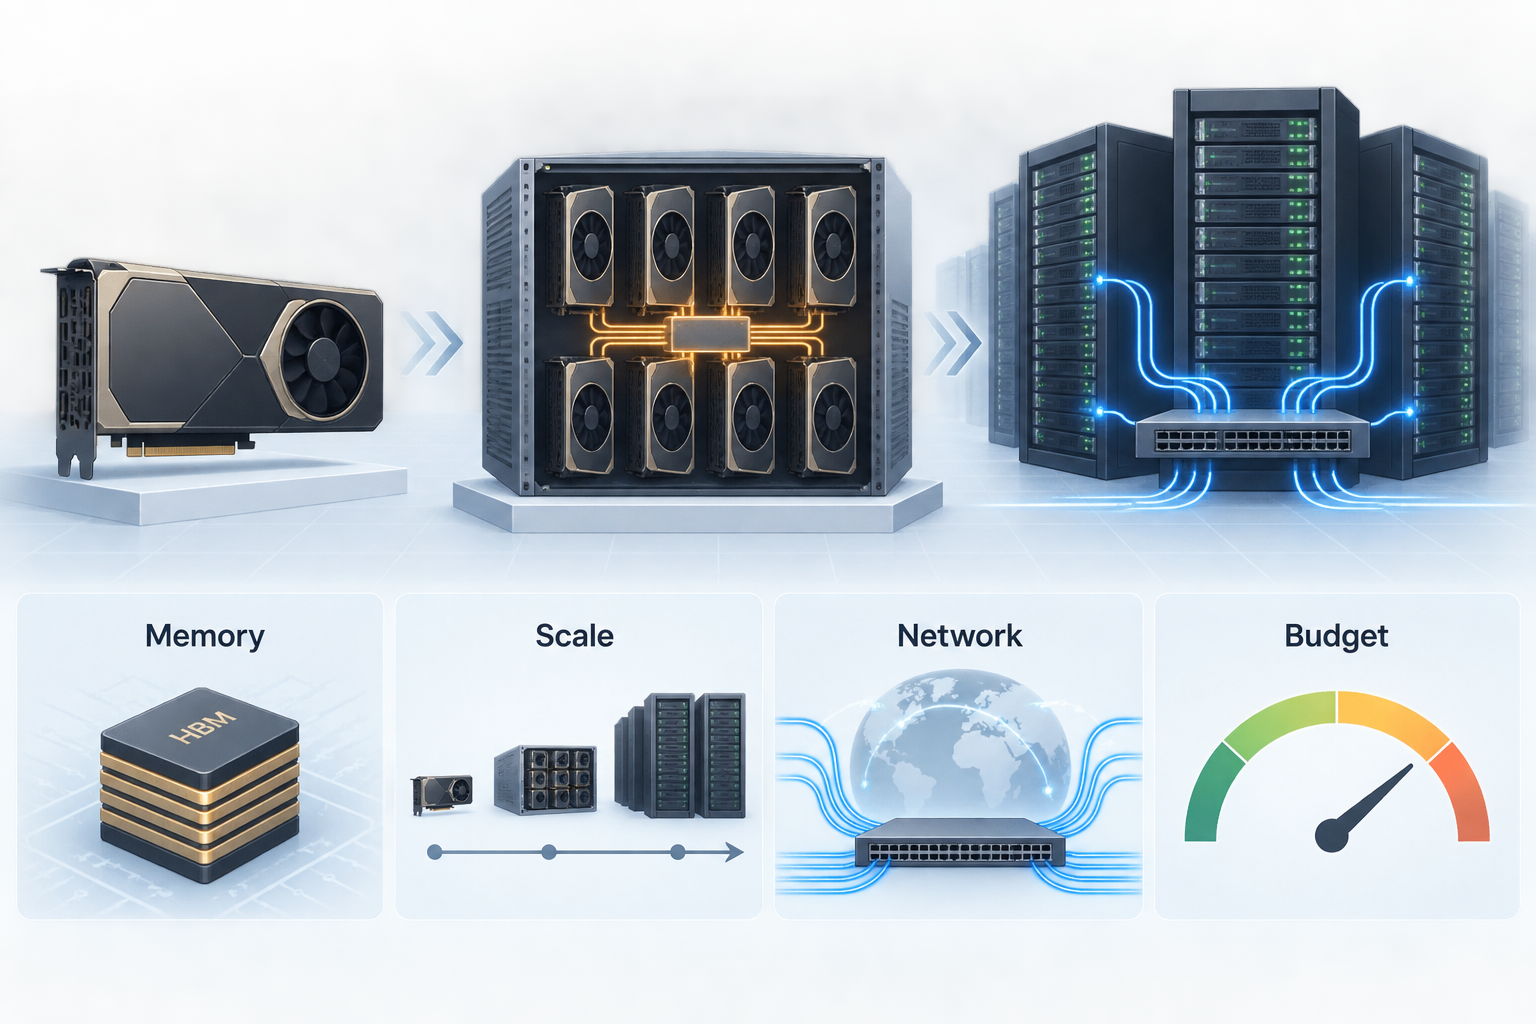
Meilleur GPU pour l'entraînement des LLM : échelle, mémoire, réseau et budget
Un guide pratique 2026 pour choisir le meilleur GPU pour l'entraînement des LLM selon l'échelle, la mémoire, le réseau, l'adéquation au fournisseur et le coût par checkpoint finalisé.
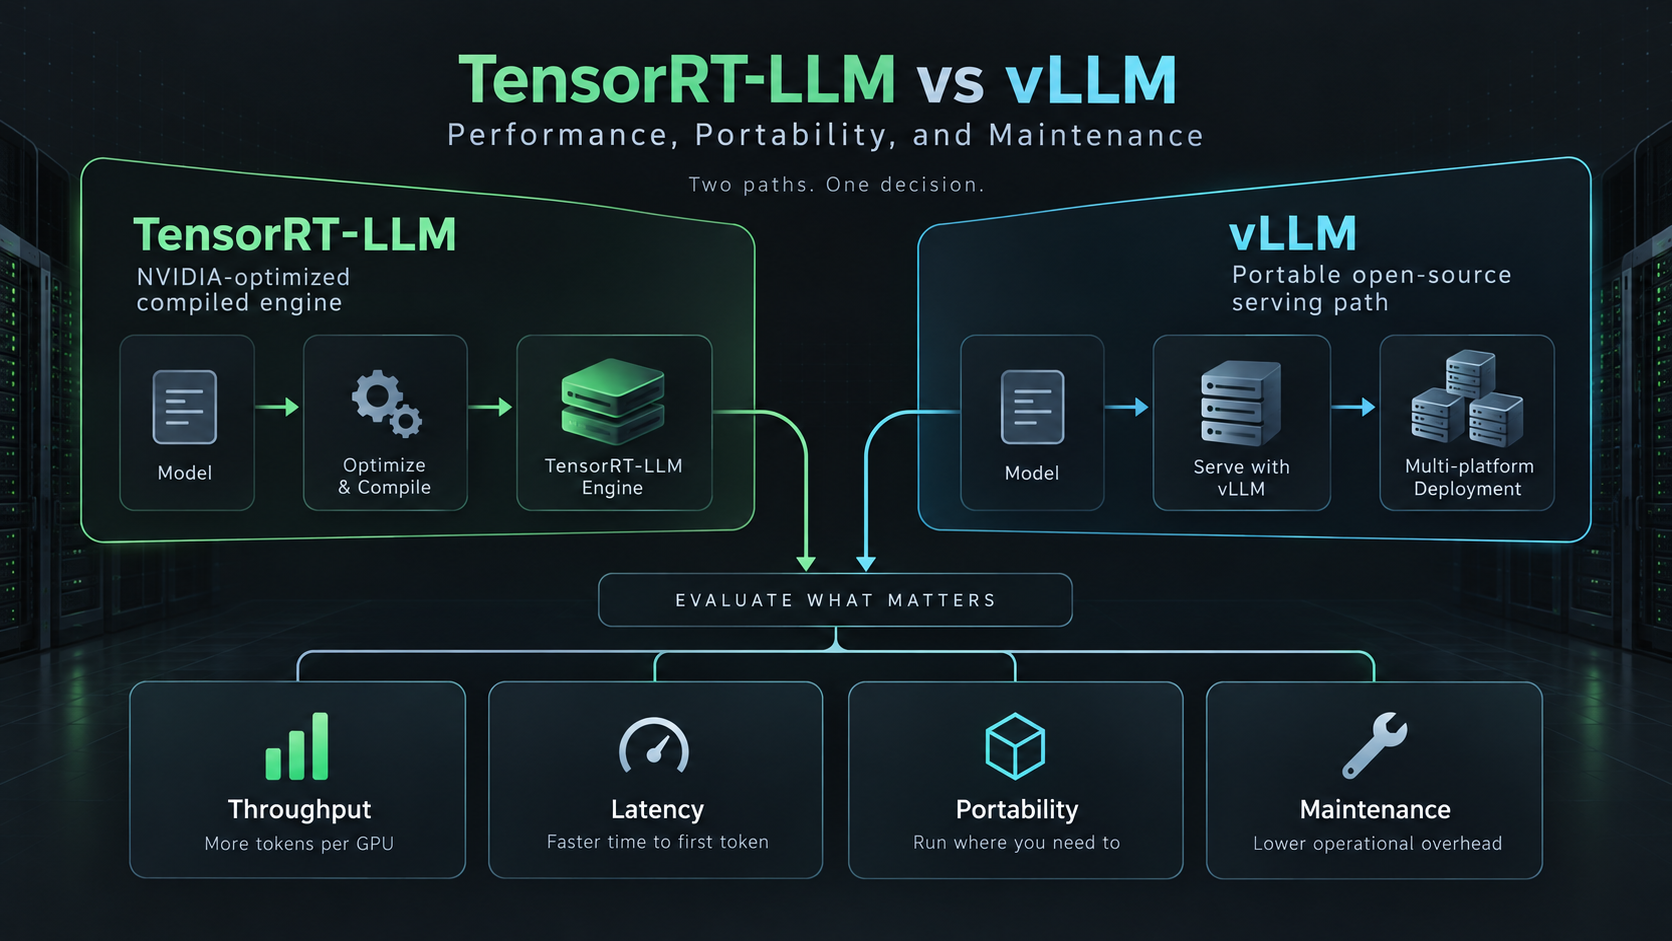
TensorRT-LLM vs vLLM : performances, portabilité et maintenance
Une comparaison pratique entre TensorRT-LLM et vLLM pour les équipes d’infrastructure IA qui choisissent un moteur de service LLM selon les performances, la portabilité, la maintenance et la conception des benchmarks.
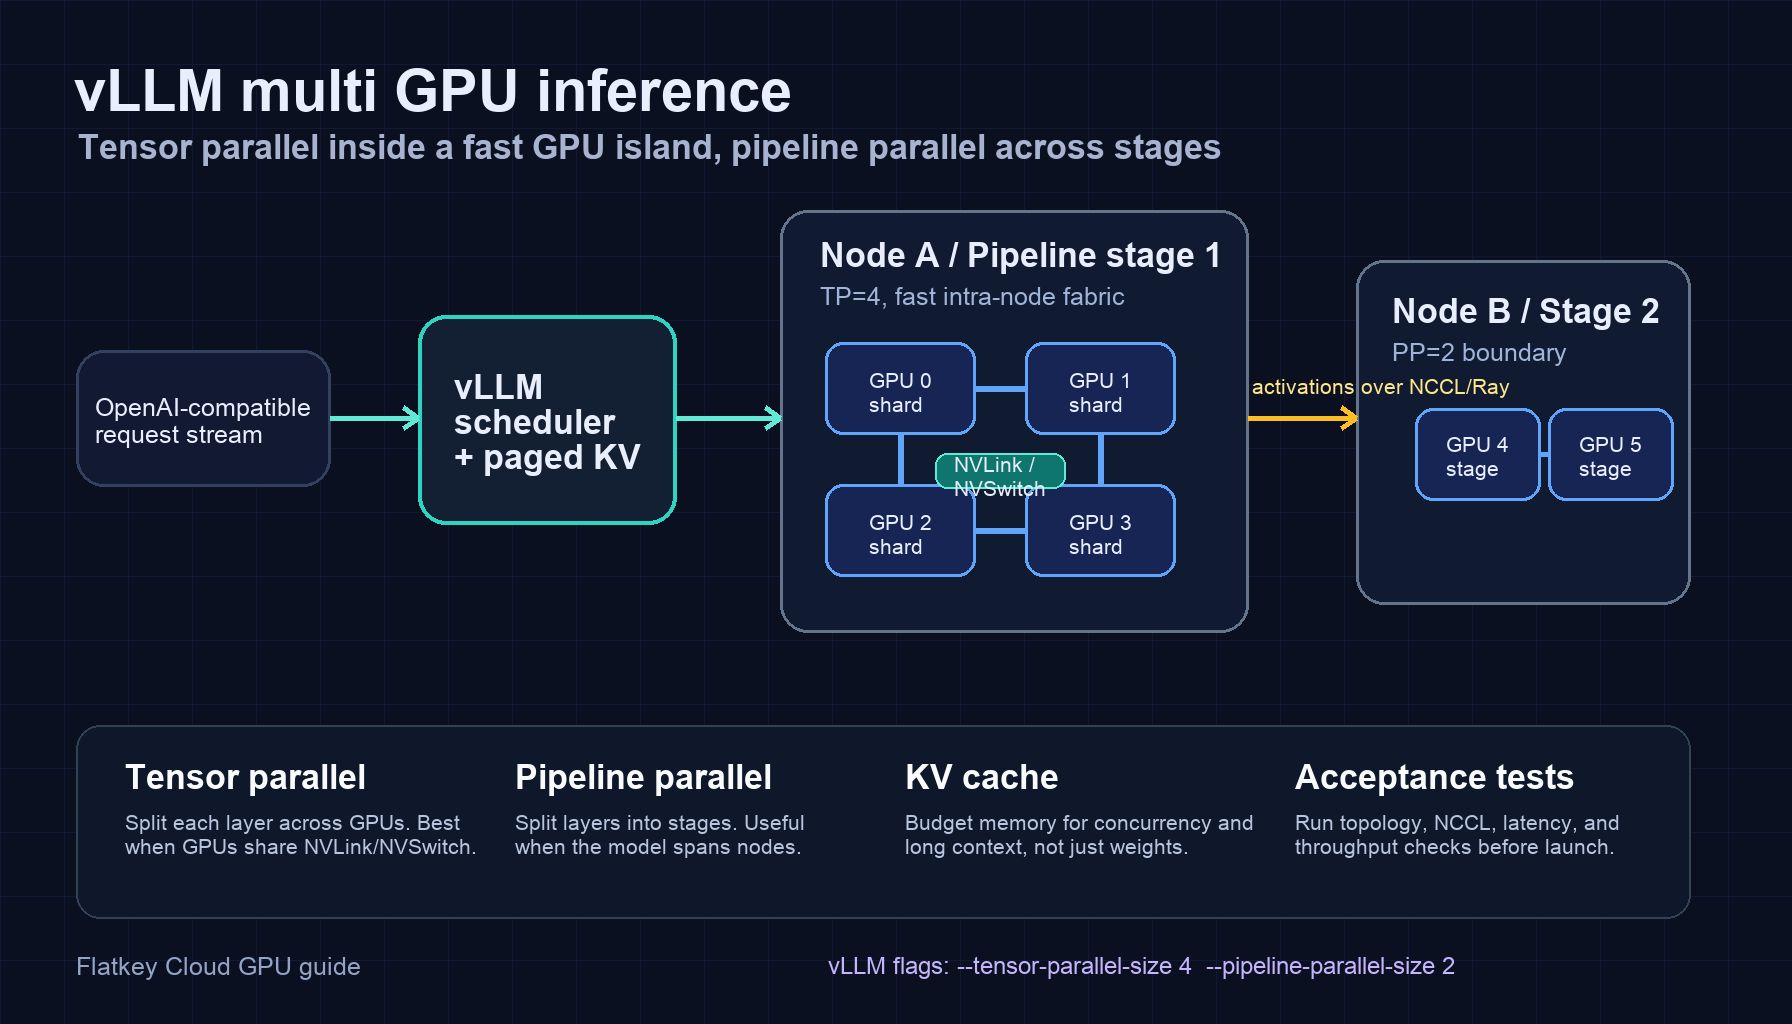
Inférence multi-GPU vLLM : configuration du parallélisme tensoriel et pipeline
Configurez l’inférence multi-GPU avec vLLM grâce au parallélisme tensoriel, au parallélisme de pipeline, à Ray, aux vérifications de topologie, à des exemples et à des tests de production.
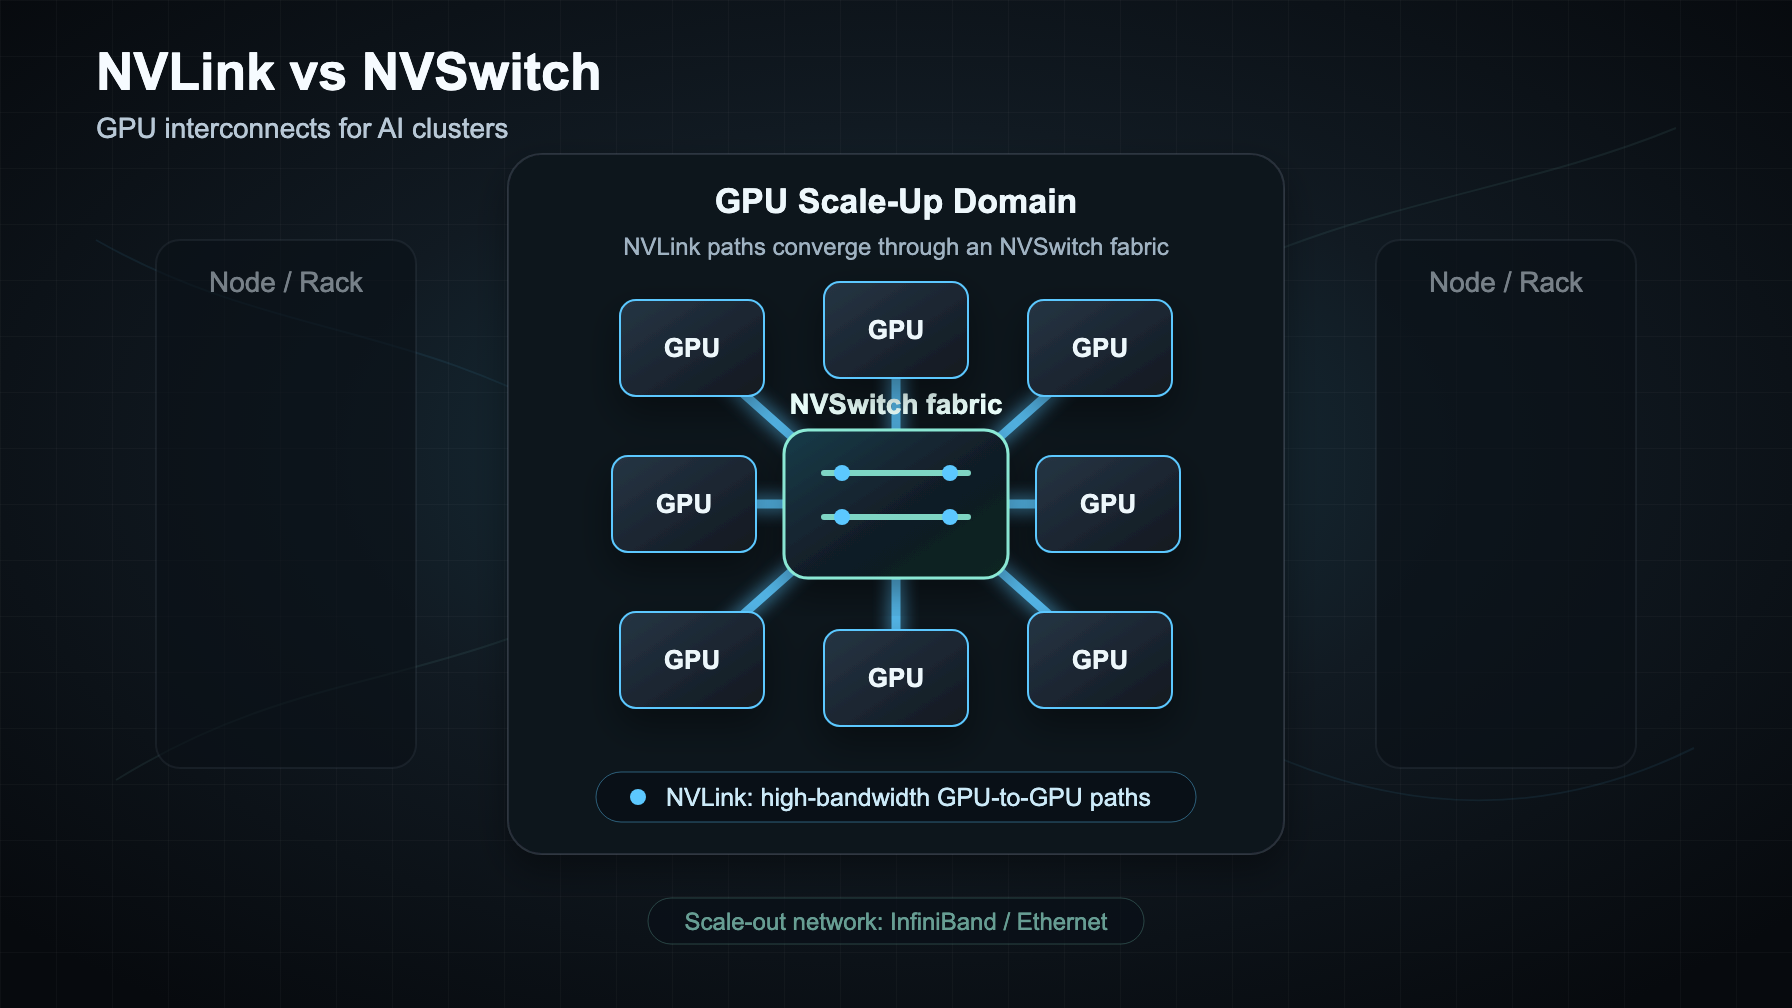
NVLink vs NVSwitch : explication des interconnexions GPU pour les clusters d’IA
NVLink est la liaison GPU à GPU, NVSwitch est la fabric, et InfiniBand ou Ethernet est le réseau de mise à l’échelle. Voici comment choisir pour les clusters d’IA.
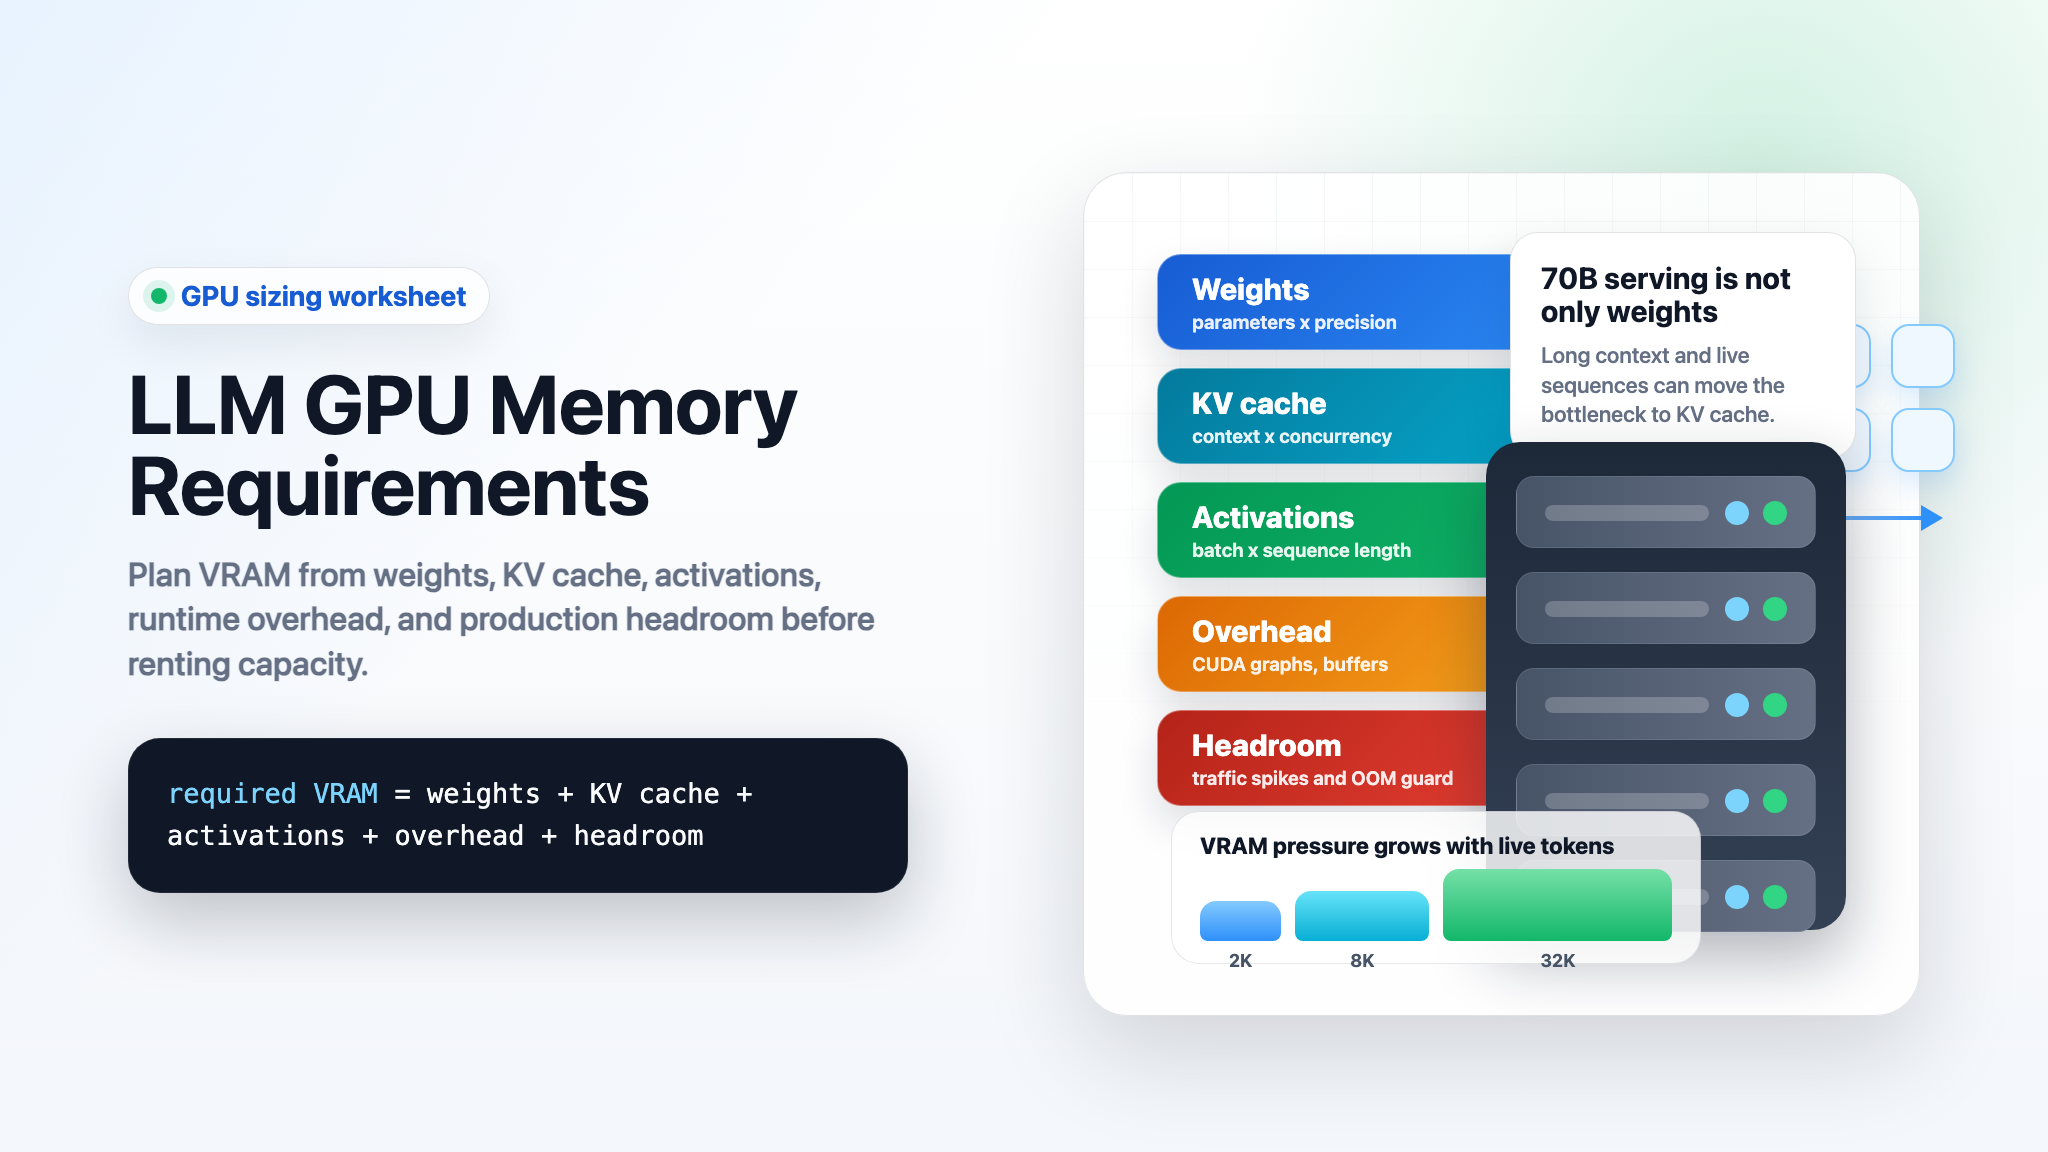
Exigences de mémoire GPU pour les LLM : poids, cache KV, activations et surcharge
Un tableau pratique pour estimer les besoins en mémoire GPU des LLM pour les poids, le cache KV, les activations, la surcharge de service, la planification vLLM 70B, le fine-tuning et l'entraînement.
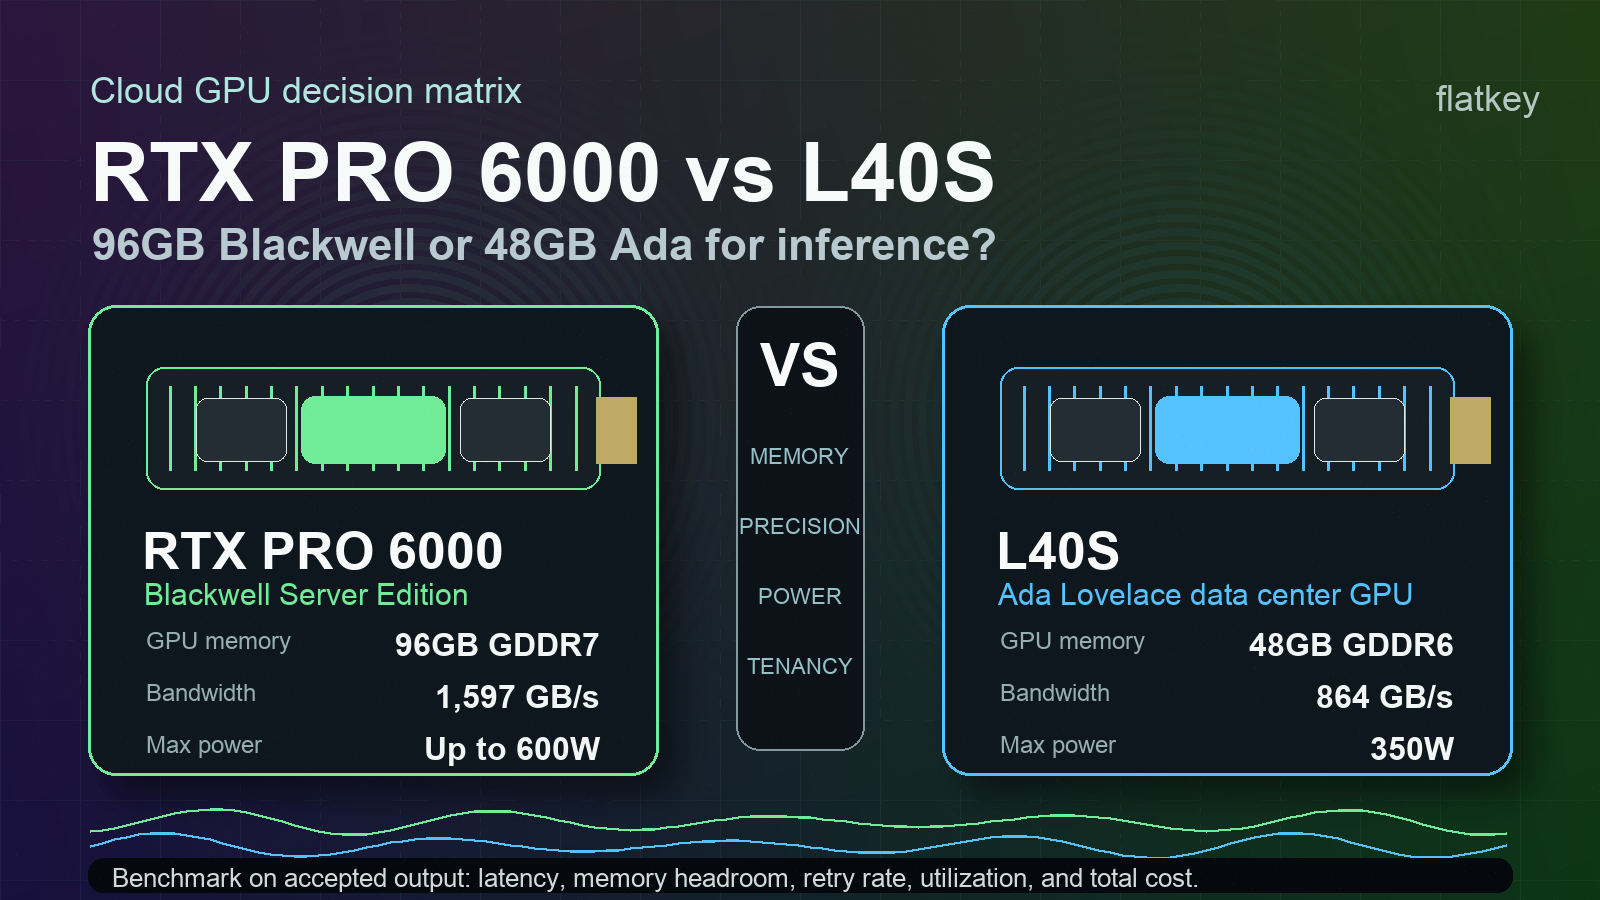
RTX PRO 6000 vs L40S : GPU d’inférence Blackwell 96 Go ou Ada ?
Comparez la NVIDIA L40S et la RTX PRO 6000 Blackwell Server Edition pour l’inférence LLM, les charges de travail multimodales, l’adéquation mémoire, la consommation électrique et le coût par résultat accepté.
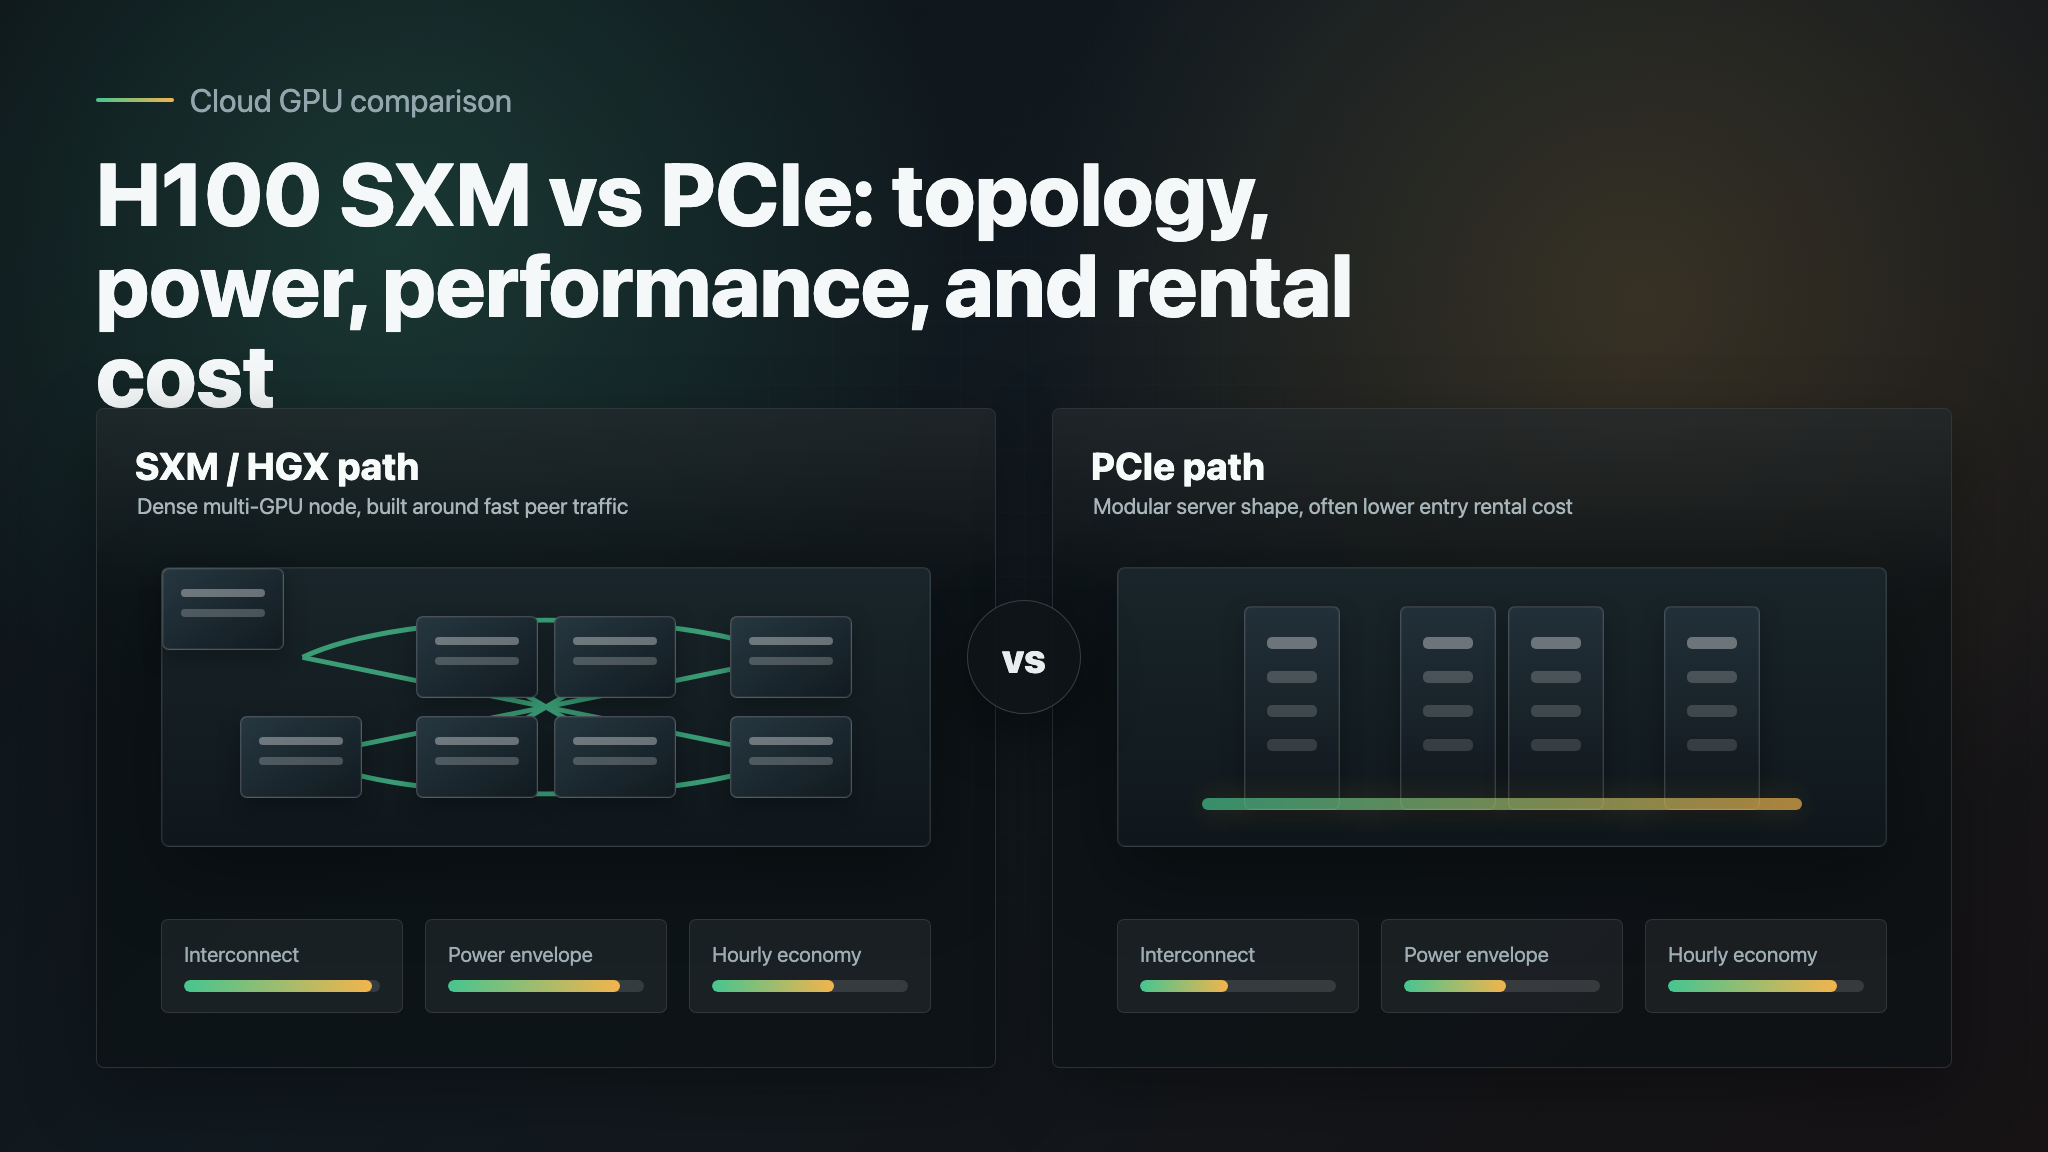
H100 SXM vs PCIe : NVLink, puissance, performances et coût de location
Comparez H100 PCIe et SXM en matière de NVLink, de consommation électrique, de performances des workloads et de coût de location avant de louer des GPU cloud.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer