
Coûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
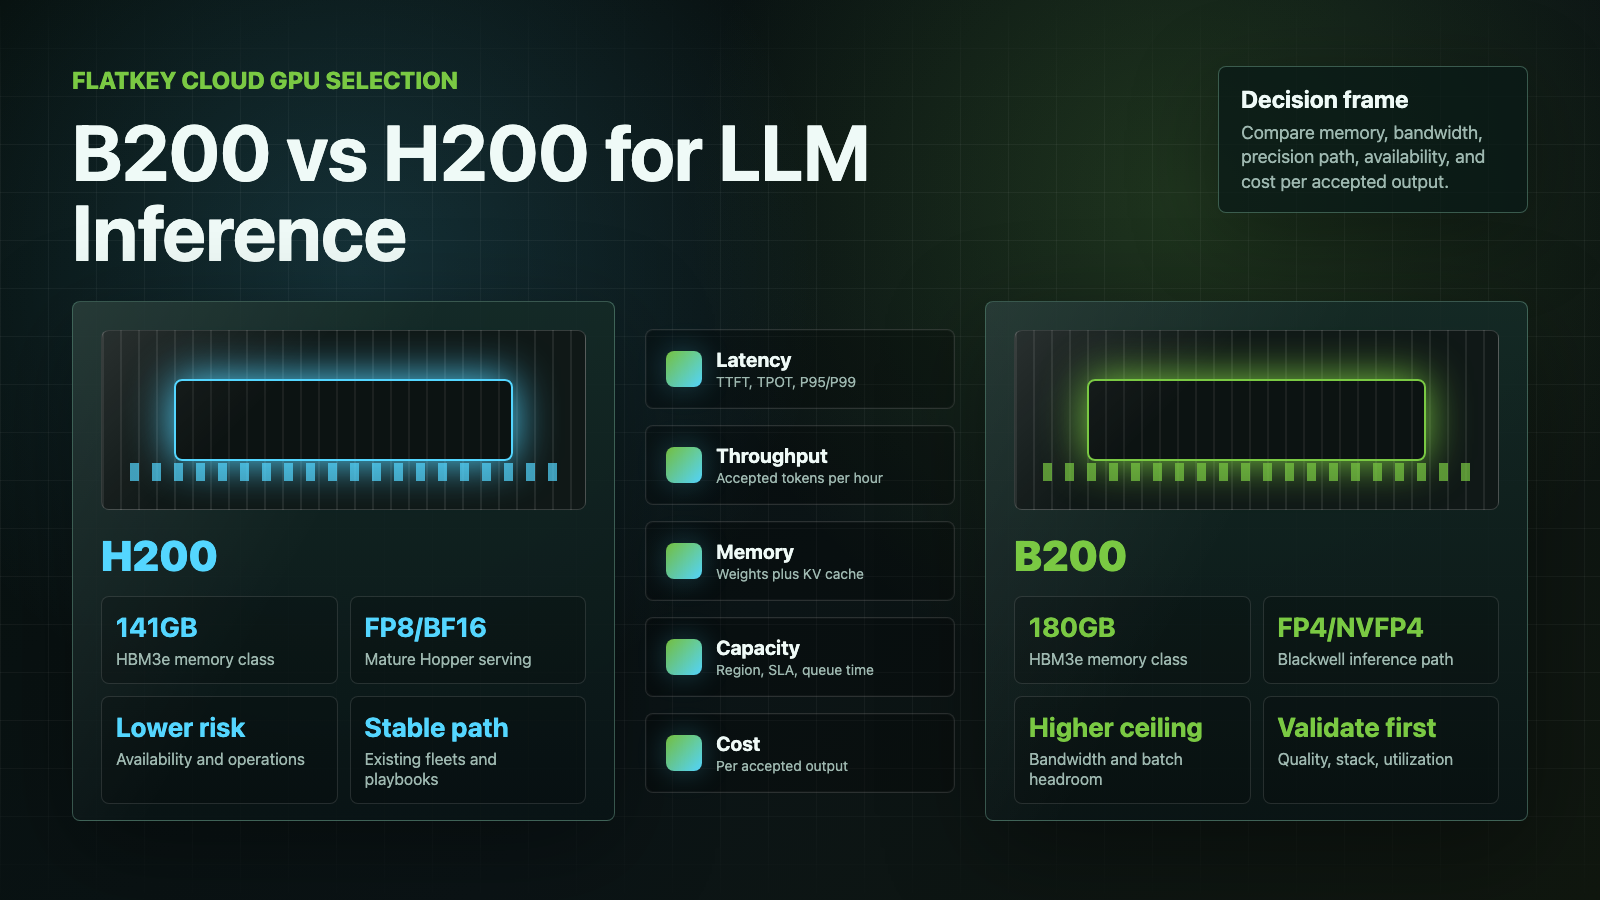
NVIDIA B200 vs H200 : quel GPU est le meilleur pour l'inférence de LLM ?
Comparez les NVIDIA B200 et H200 pour l'inférence de LLM selon la mémoire, la bande passante, la prise en charge de la précision, les systèmes DGX, la disponibilité dans le cloud et le coût par sortie acceptée.
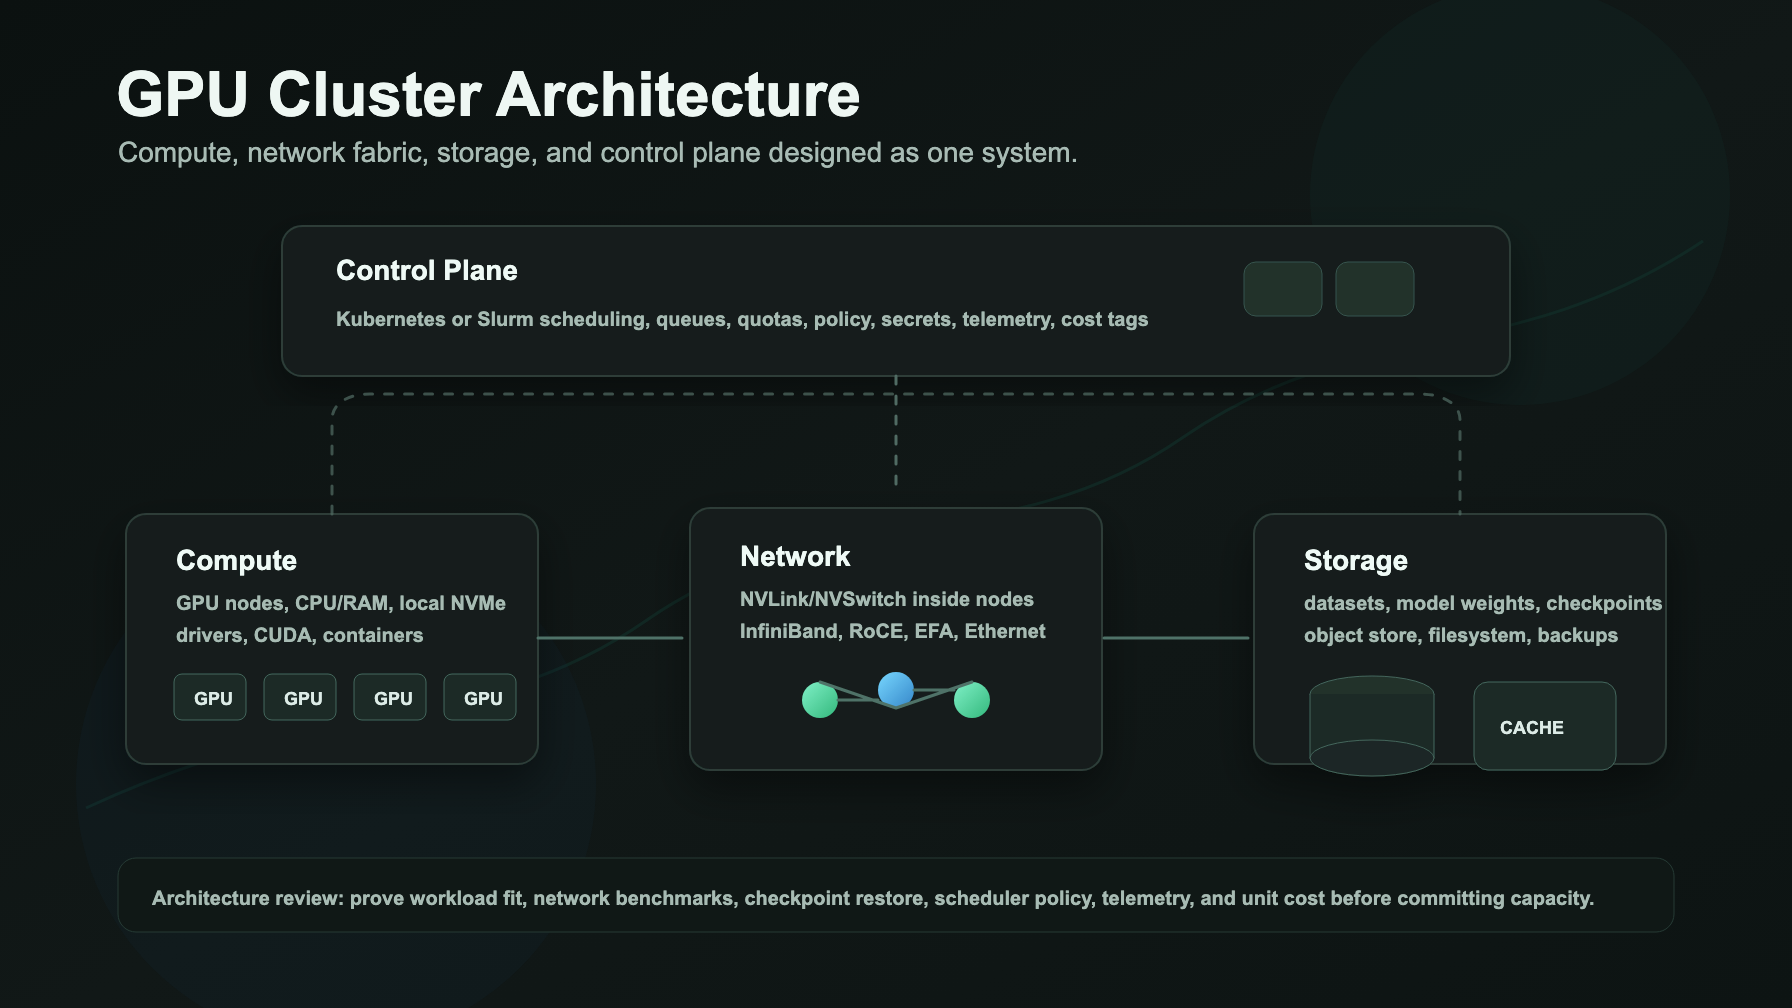
Architecture de cluster GPU : calcul, réseau, stockage et plan de contrôle
Un guide pratique d’architecture de cluster GPU pour les nœuds de calcul, le réseau, le stockage, le plan de contrôle Kubernetes ou Slurm, l’observabilité et les tests d’acceptation.
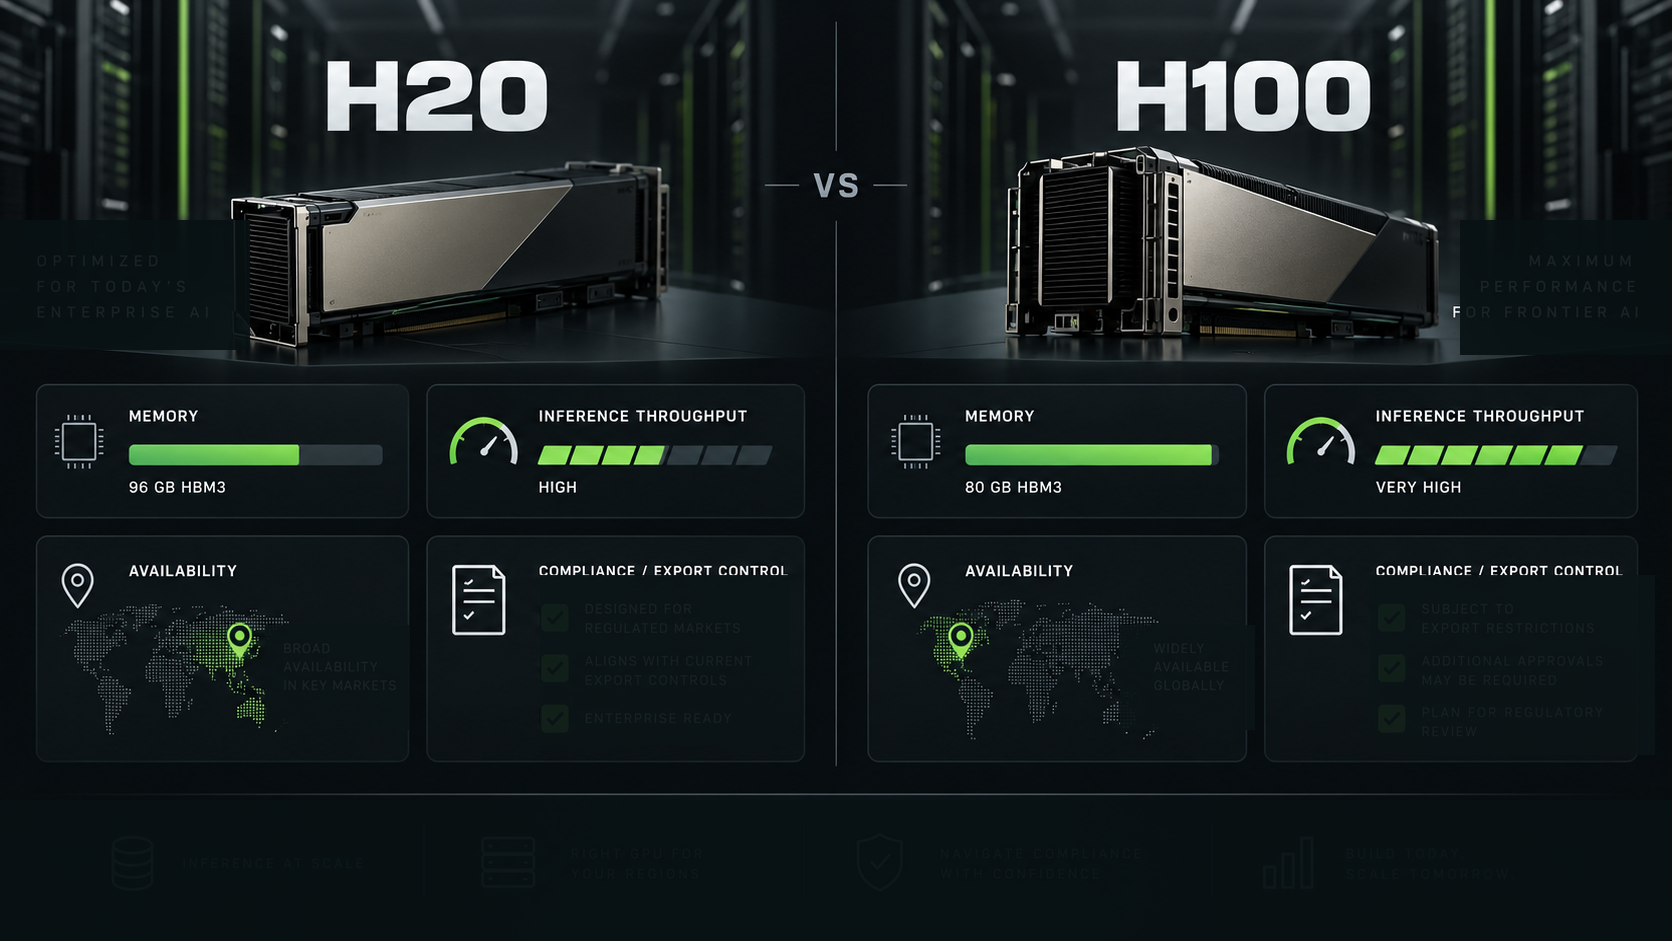
NVIDIA H20 vs H100 : inférence, mémoire, disponibilité et conformité
Une comparaison pratique H20 vs H100 pour les équipes IA en entreprise, couvrant l’inférence, la mémoire, la disponibilité, le risque lié au contrôle des exportations et les cas où H200 ou les API de modèles constituent de meilleures bases de référence.
Meilleures plateformes de location de GPU cloud en 2026 : prix, capacité, réseau et support
Une sélection pratique 2026 de plateformes cloud GPU pour les équipes IA, comparant le niveau de prix, la capacité, le réseau, le support et les cas où une API de modèle constitue une meilleure base.
NVIDIA Blackwell Ultra B300 : qu’est-ce qui a changé par rapport au B200 ?
Un suivi pratique du NVIDIA B300 Blackwell Ultra pour les équipes d’infrastructure IA, comparant les spécifications du B300, l’état de disponibilité, les réserves sur le prix et l’adéquation aux workloads face au B200.
AMD MI455X et Helios : suivi de l’architecture, de la mémoire et de la disponibilité
Un suivi orienté acheteurs pour AMD MI455X et Helios, couvrant l’architecture, la mémoire HBM4, la bande passante, la disponibilité, la compatibilité vLLM, les questions aux fournisseurs et la stratégie de repli pour les modèles/API.
GPU NVIDIA Vera Rubin : GPU, NVL72, mémoire, réseau et suivi de disponibilité
Un suivi actualisé des spécifications du GPU NVIDIA Vera Rubin, du DGX Vera Rubin NVL72, de la mémoire HBM4, du réseau et des étapes de disponibilité pour les acheteurs de GPU cloud.
Tarification de l’API Image OpenAI : tarifs de GPT Image 2.5, formule de coût et contrôles budgétaires
Découvrez comment fonctionne la tarification de l’API image OpenAI pour GPT Image 2.5, notamment les tarifs en tokens, les règles d’entrée mise en cache, les images partielles, Batch et le coût par image acceptée.
GB200 vs B200 : superchip Grace Blackwell ou HGX x86 ?
Comparez GB200 et B200 pour l’achat d’infrastructures IA : systèmes Grace Blackwell à l’échelle du rack NVL72, nœuds B200 HGX/x86, benchmarks et vérifications du TCO.
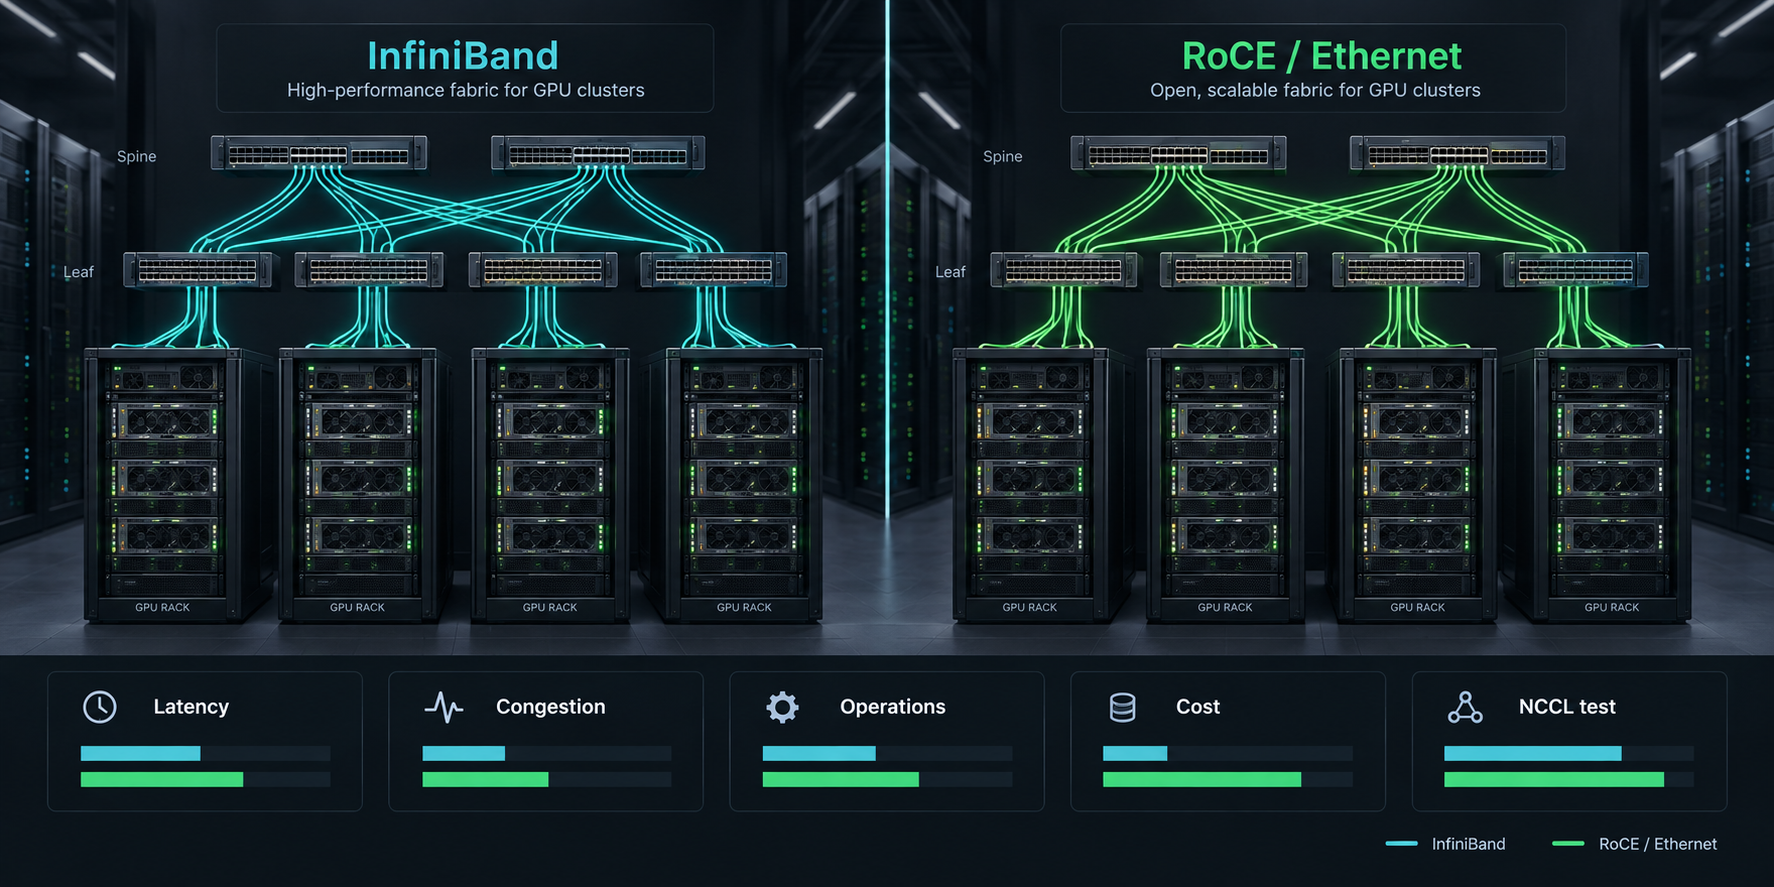
RoCE vs InfiniBand pour les clusters GPU : latence, exploitation et coût
Comparez RoCE et InfiniBand pour les clusters GPU multinœuds avec une matrice de décision pratique, un test d’acceptation NCCL, un modèle de coûts et une checklist d’achat.
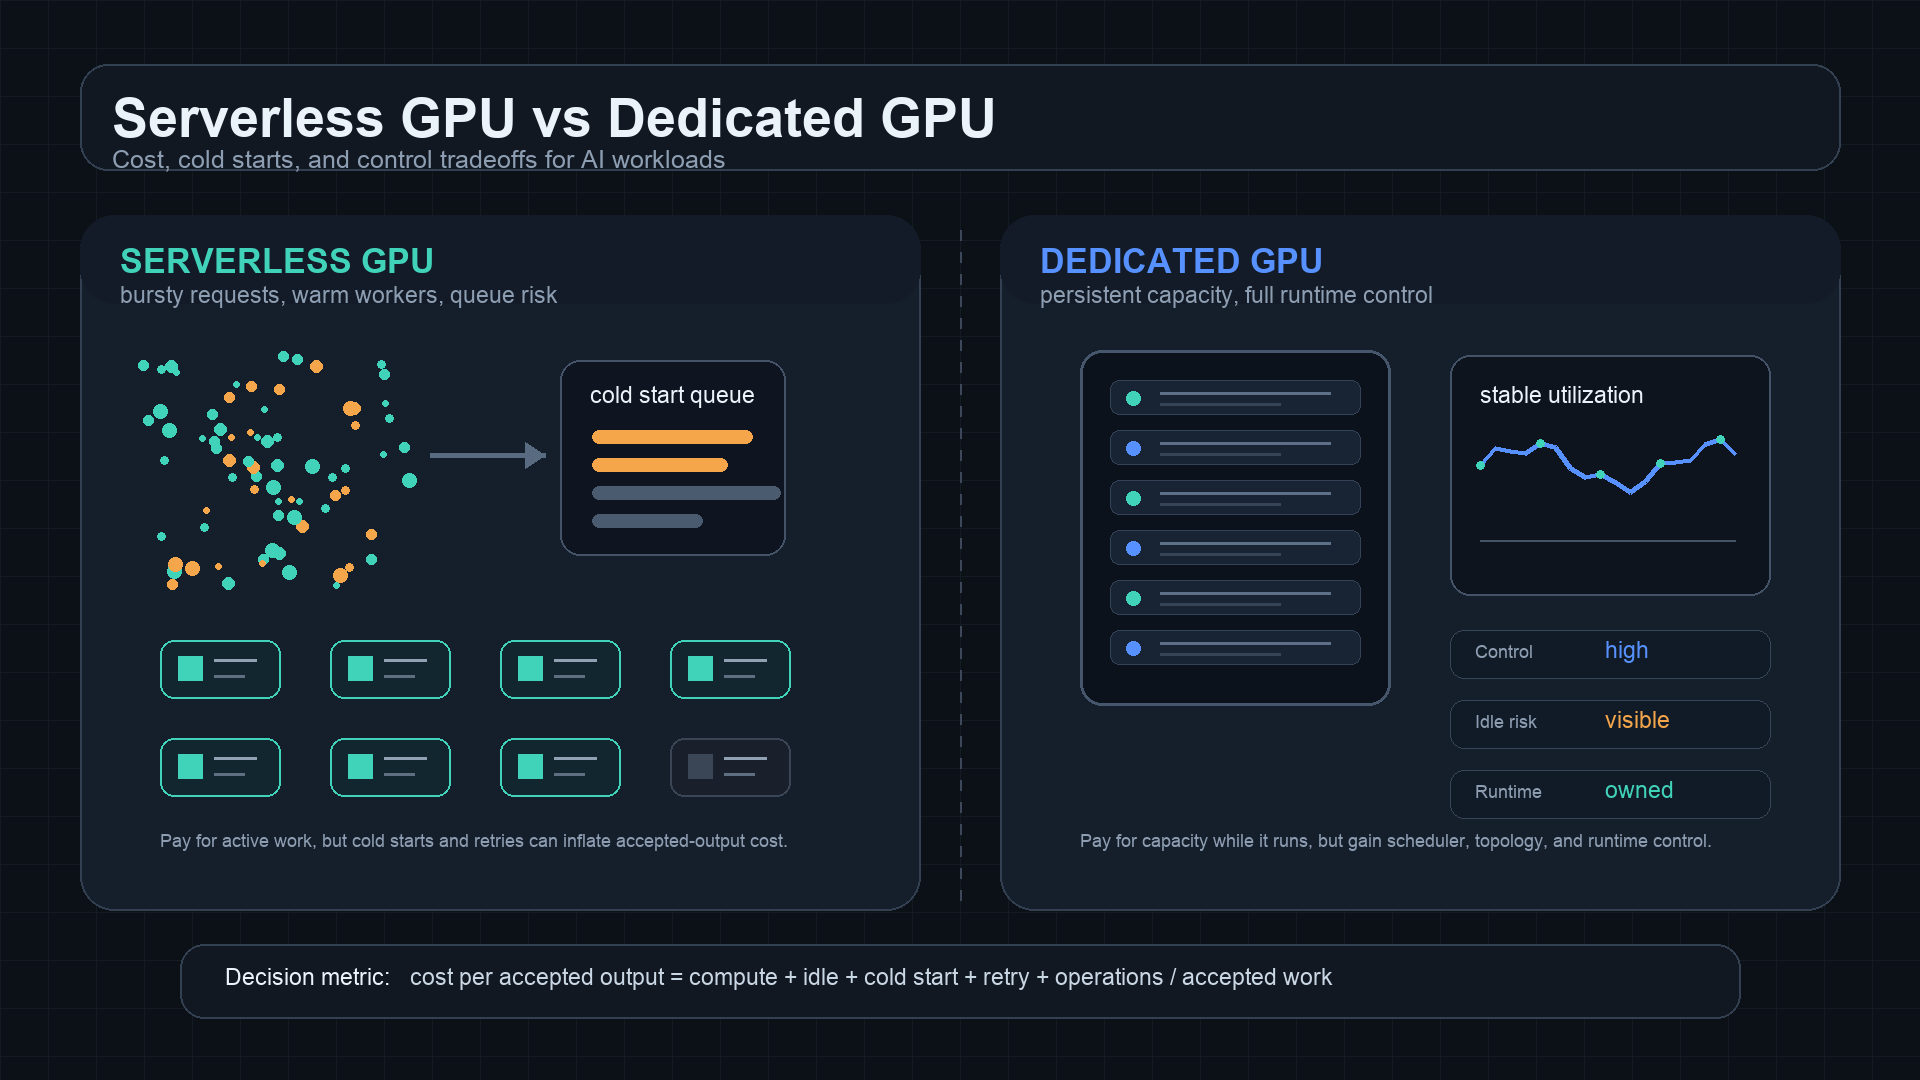
GPU serverless vs GPU dédié : coût, démarrages à froid et contrôle
Comparez le GPU serverless et le GPU dédié selon le coût par résultat accepté, les démarrages à froid, la capacité inactive, l’autoscaling et le contrôle opérationnel.

Comparaison des tarifs des API de génération d’images IA : GPT Image, Gemini, Imagen et fal
Comparez les tarifs des API de génération d’images entre GPT Image, Gemini Image, Imagen et fal en normalisant les unités de facturation en coût par image acceptée.
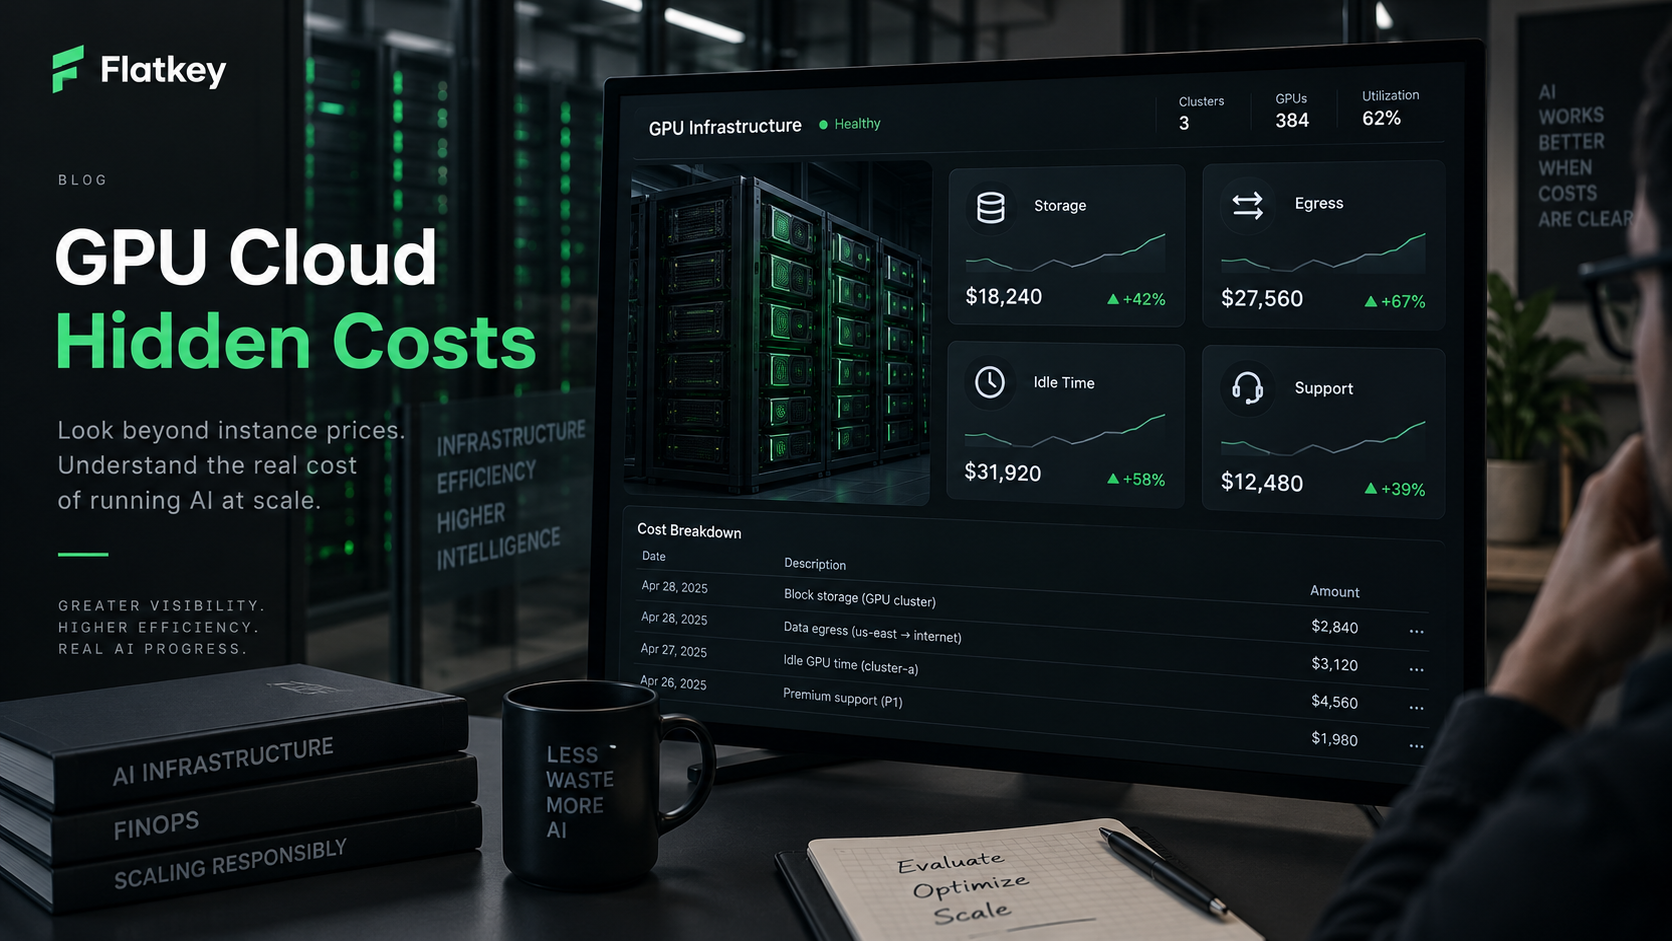
Quels sont les coûts cachés des services GPU cloud ? Stockage, egress, temps d’inactivité et support
Un guide pratique du coût total de possession des GPU cloud pour repérer les coûts de stockage, d’egress, de temps d’inactivité, d’échecs de jobs, de support, de réseau et d’exploitation avant l’arrivée de la facture.
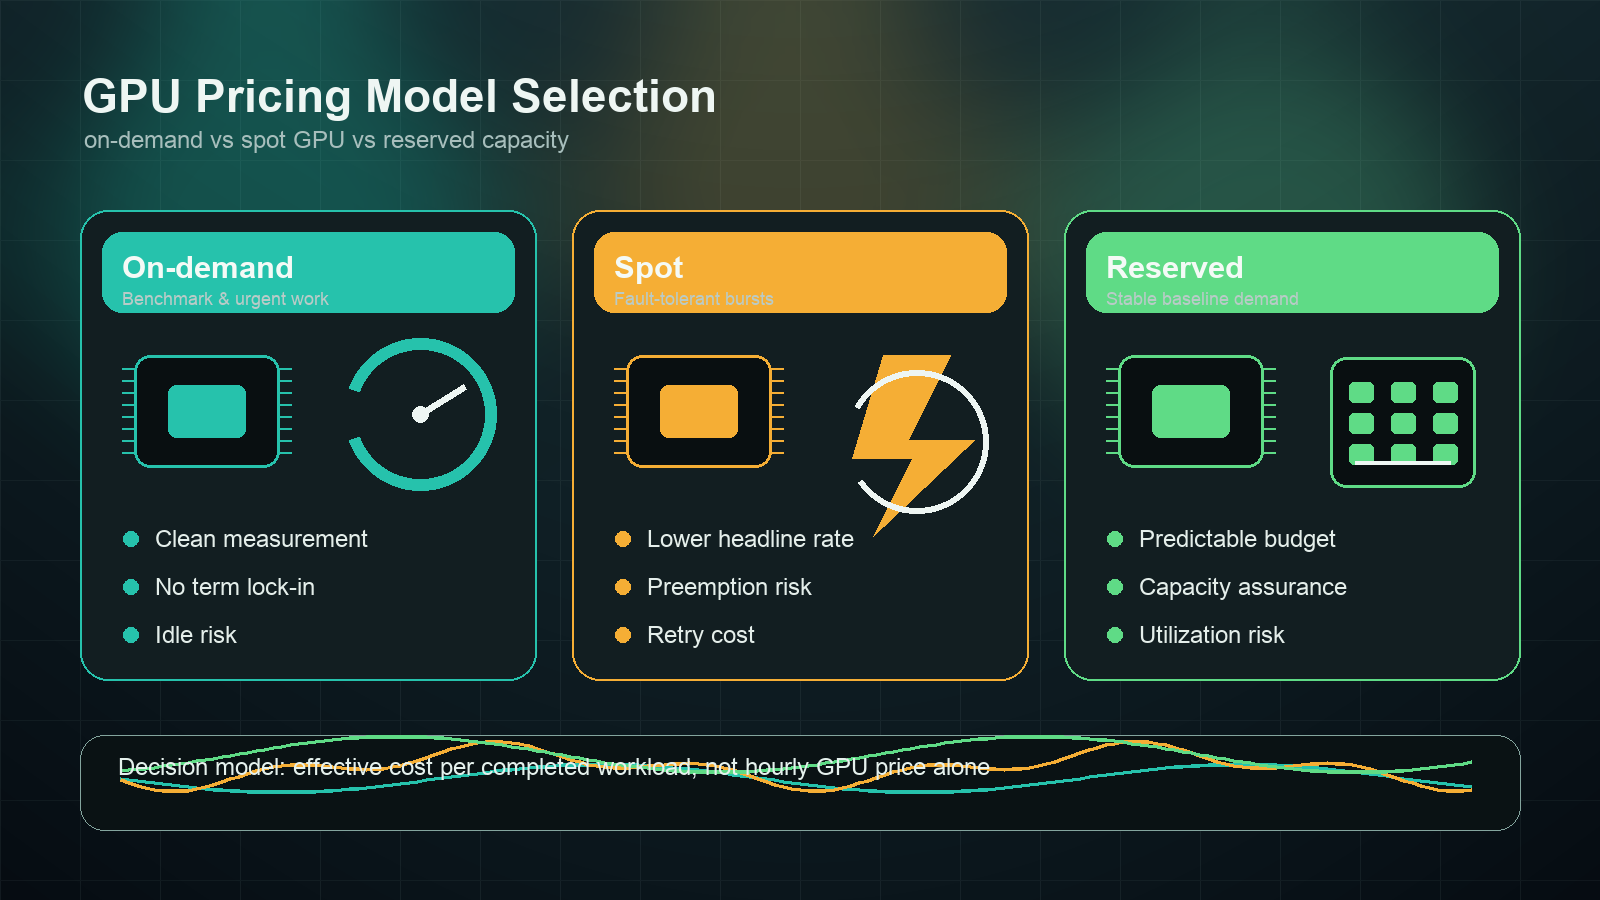
Tarification GPU à la demande vs Spot vs Réservée : quel modèle convient à votre charge de travail ?
Un cadre guidé par la charge de travail pour choisir une capacité GPU à la demande, Spot ou réservée, sans confondre le tarif horaire affiché avec le coût réel de la charge de travail terminée.
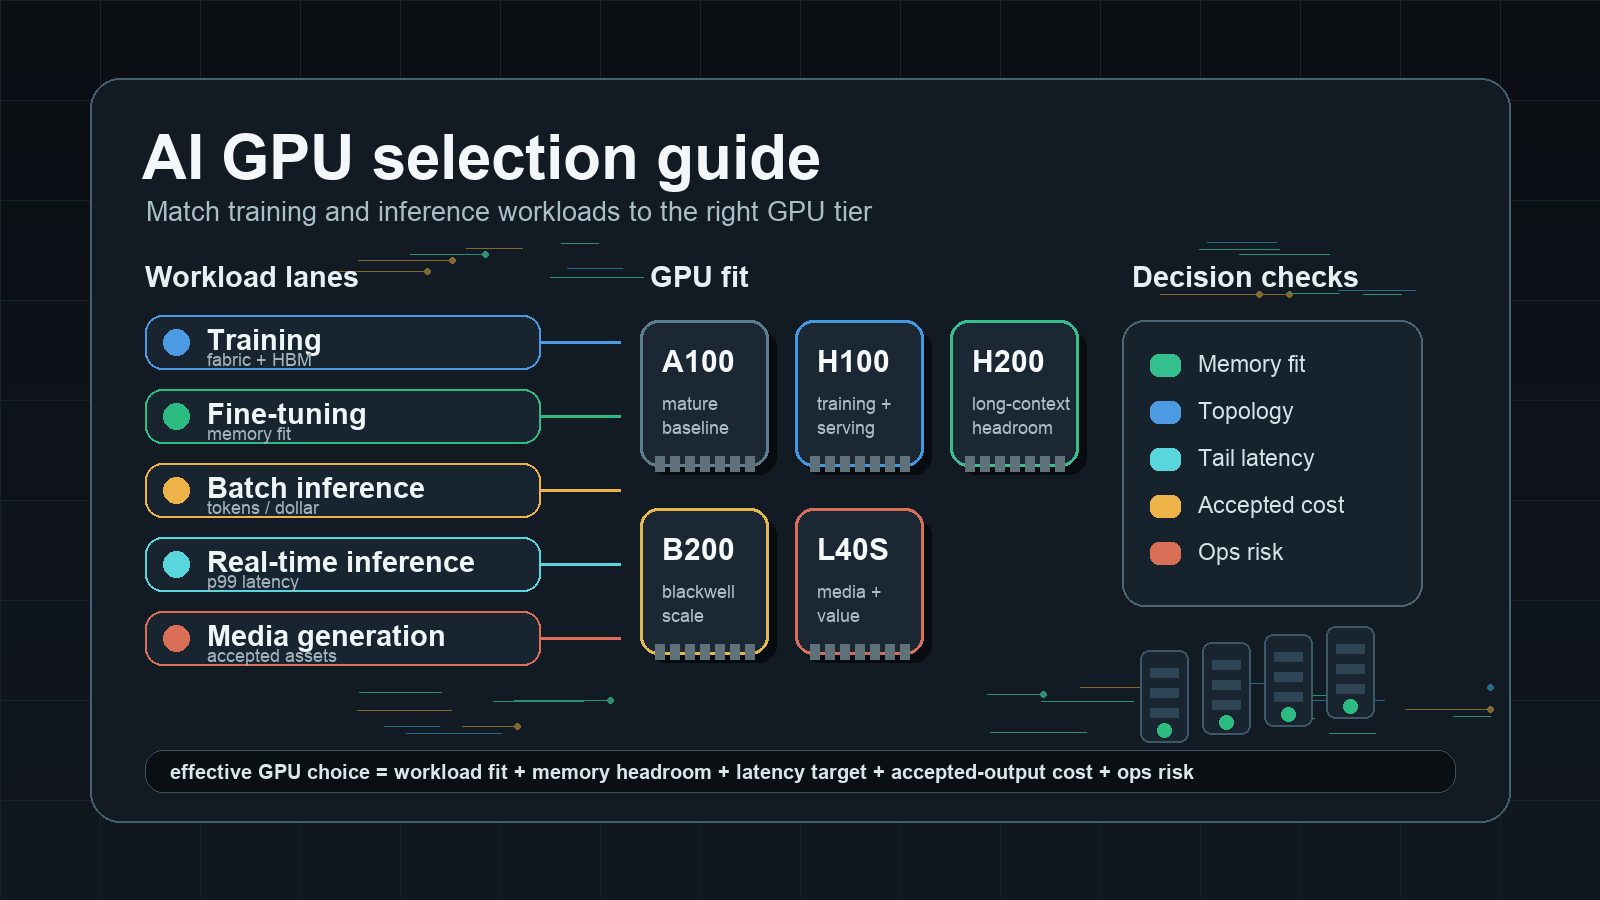
Guide de sélection de GPU IA : associez les charges de travail d’entraînement et d’inférence au bon GPU
Un guide pratique de sélection de GPU IA pour aider les équipes à associer les charges de travail d’entraînement, de fine-tuning, d’inférence LLM, de génération de médias et d’évaluation au bon GPU et au bon modèle de capacité.
Cloud GPU privé : architecture, isolation et modèle opérationnel
Découvrez comment évaluer l’architecture d’un cloud GPU privé, l’isolation, la propriété du planificateur, les preuves de sécurité, le modèle opérationnel, le TCO et les tests d’acceptation.

Guide de déploiement de vLLM : servir une API LLM compatible OpenAI sur des GPU
Déployez vLLM comme API compatible OpenAI sur des GPU avec Docker, RunPod Serverless, Ray Serve, des métriques, des contrôles de déploiement progressif et des vérifications du coût par sortie acceptée.
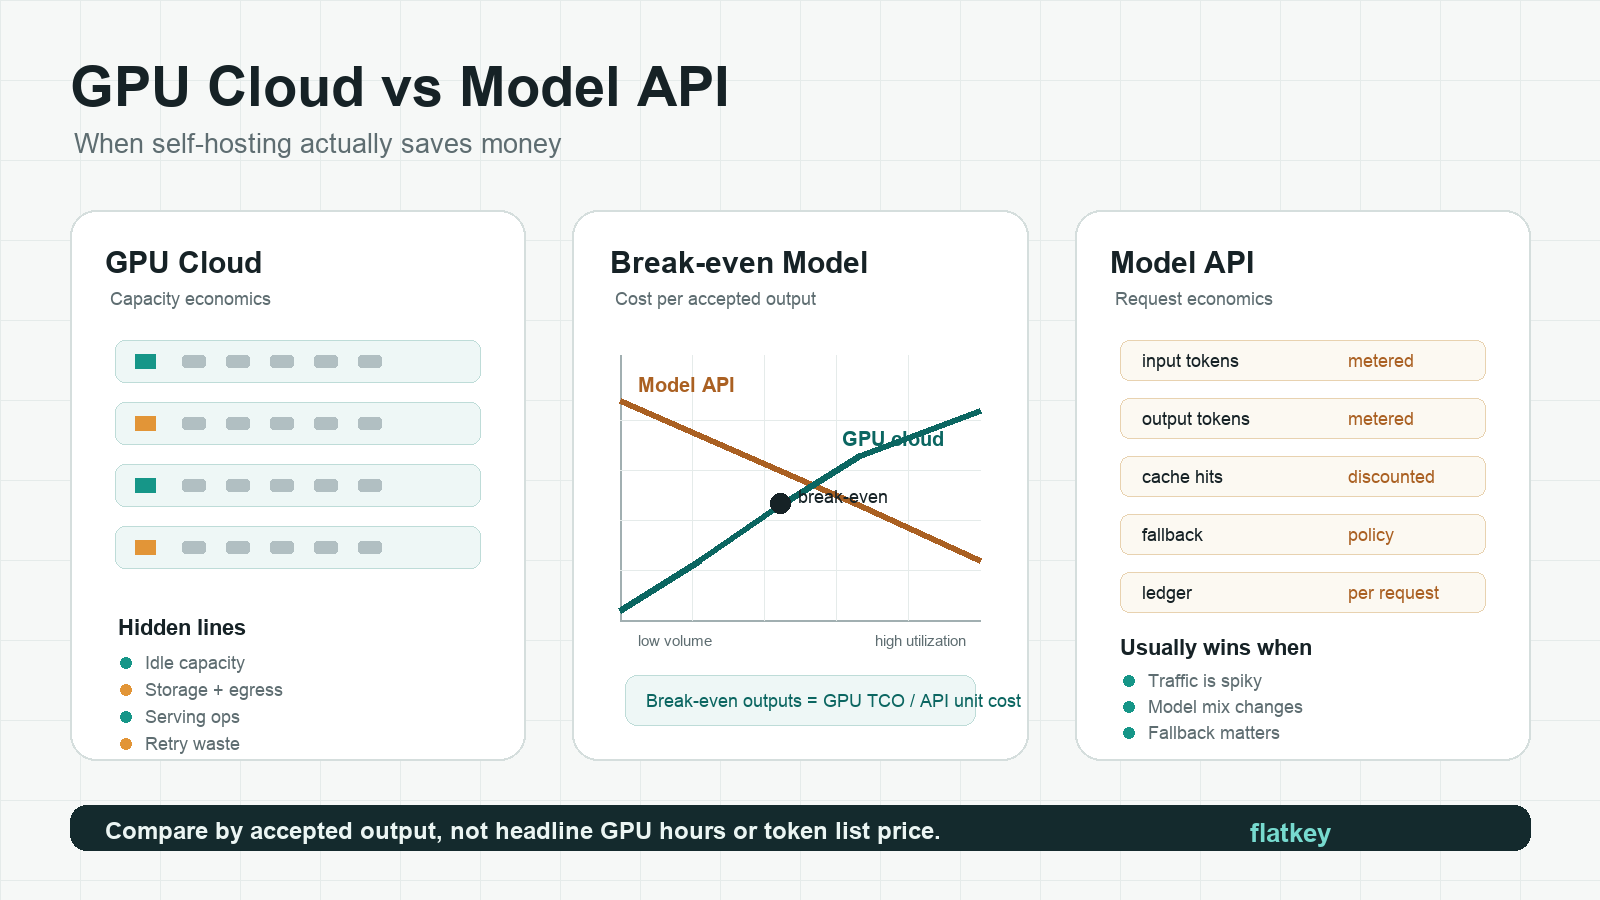
GPU Cloud vs API de modèle : quand l’auto-hébergement permet vraiment d’économiser
Comparez l’économie du GPU cloud par rapport à une API de modèle avec une feuille de calcul du seuil de rentabilité pour le coût de sortie acceptée, l’utilisation, les retries, la capacité inactive et les opérations de service.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer