
Blog flatkey.ai
Analyses, notes produit et guides d'implémentation pour les équipes qui construisent avec des API d'IA.
Architecture des passerelles IA
Derniers articles dans Architecture des passerelles IA.
Lire la suiteMigration des URL de base et des SDK
Derniers articles dans Migration des URL de base et des SDK.
Lire la suiteCoûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
Lire la suiteContrôles d’entreprise et confiance
Derniers articles dans Contrôles d’entreprise et confiance.
Lire la suiteComparatifs de passerelles
Derniers articles dans Comparatifs de passerelles.
Lire la suiteGuides des modèles et des modalités
Derniers articles dans Guides des modèles et des modalités.
Lire la suiteFiabilité et routage
Derniers articles dans Fiabilité et routage.
Lire la suiteIntégrations d’outils
Derniers articles dans Intégrations d’outils.
Lire la suite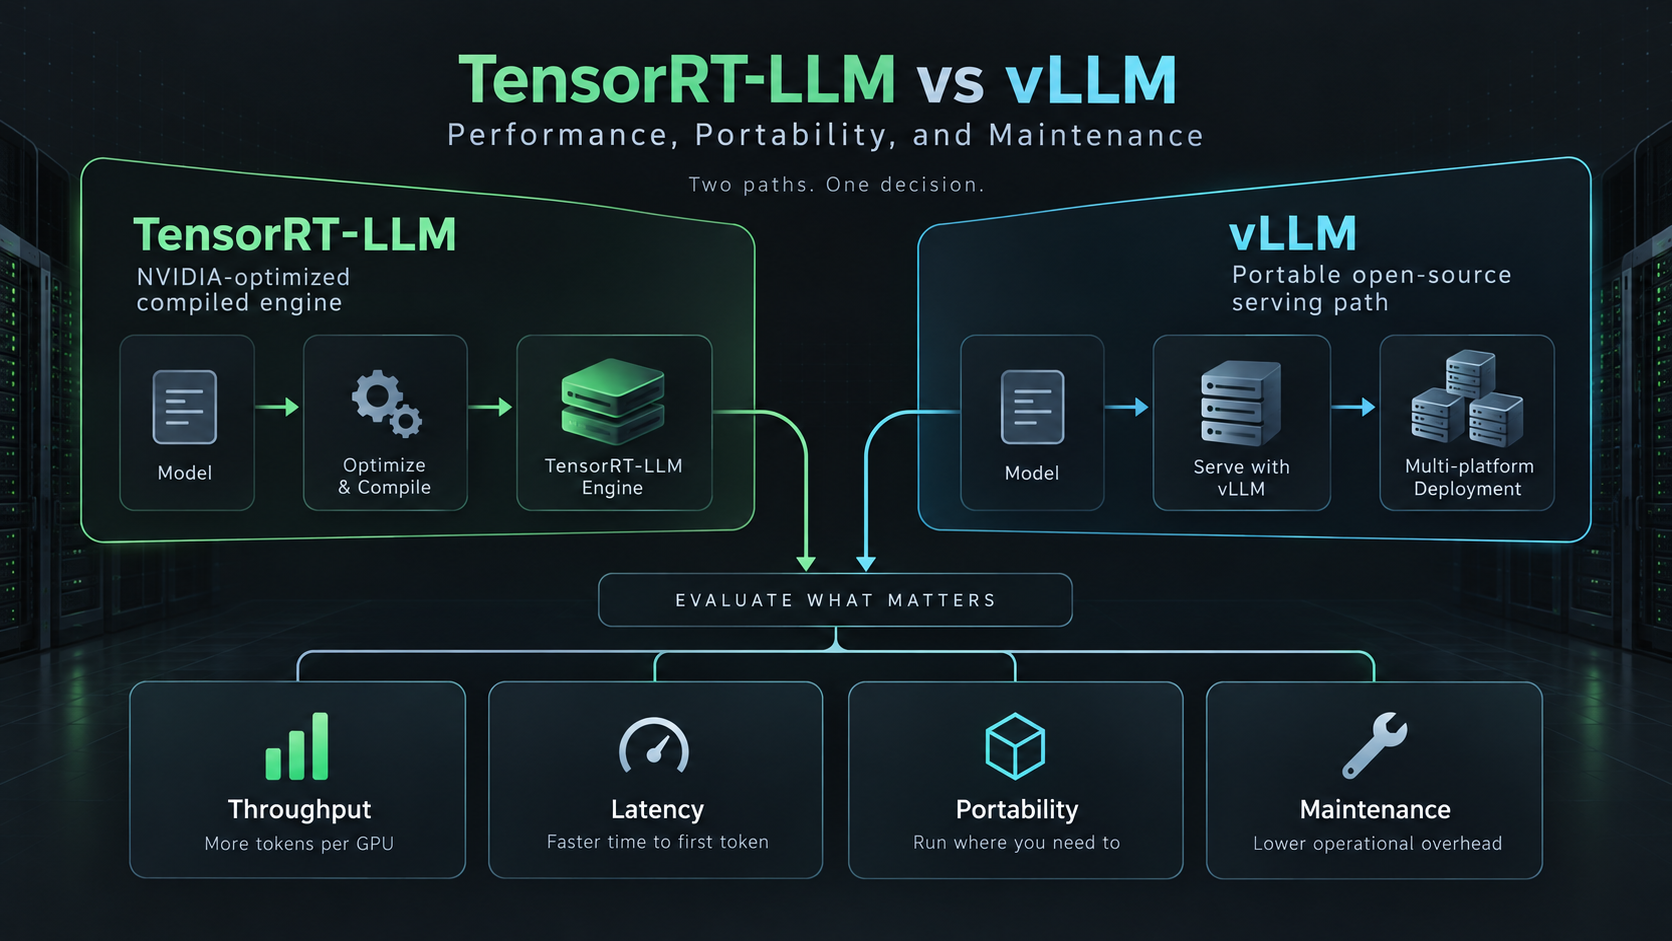
TensorRT-LLM vs vLLM : performances, portabilité et maintenance
Une comparaison pratique entre TensorRT-LLM et vLLM pour les équipes d’infrastructure IA qui choisissent un moteur de service LLM selon les performances, la portabilité, la maintenance et la conception des benchmarks.
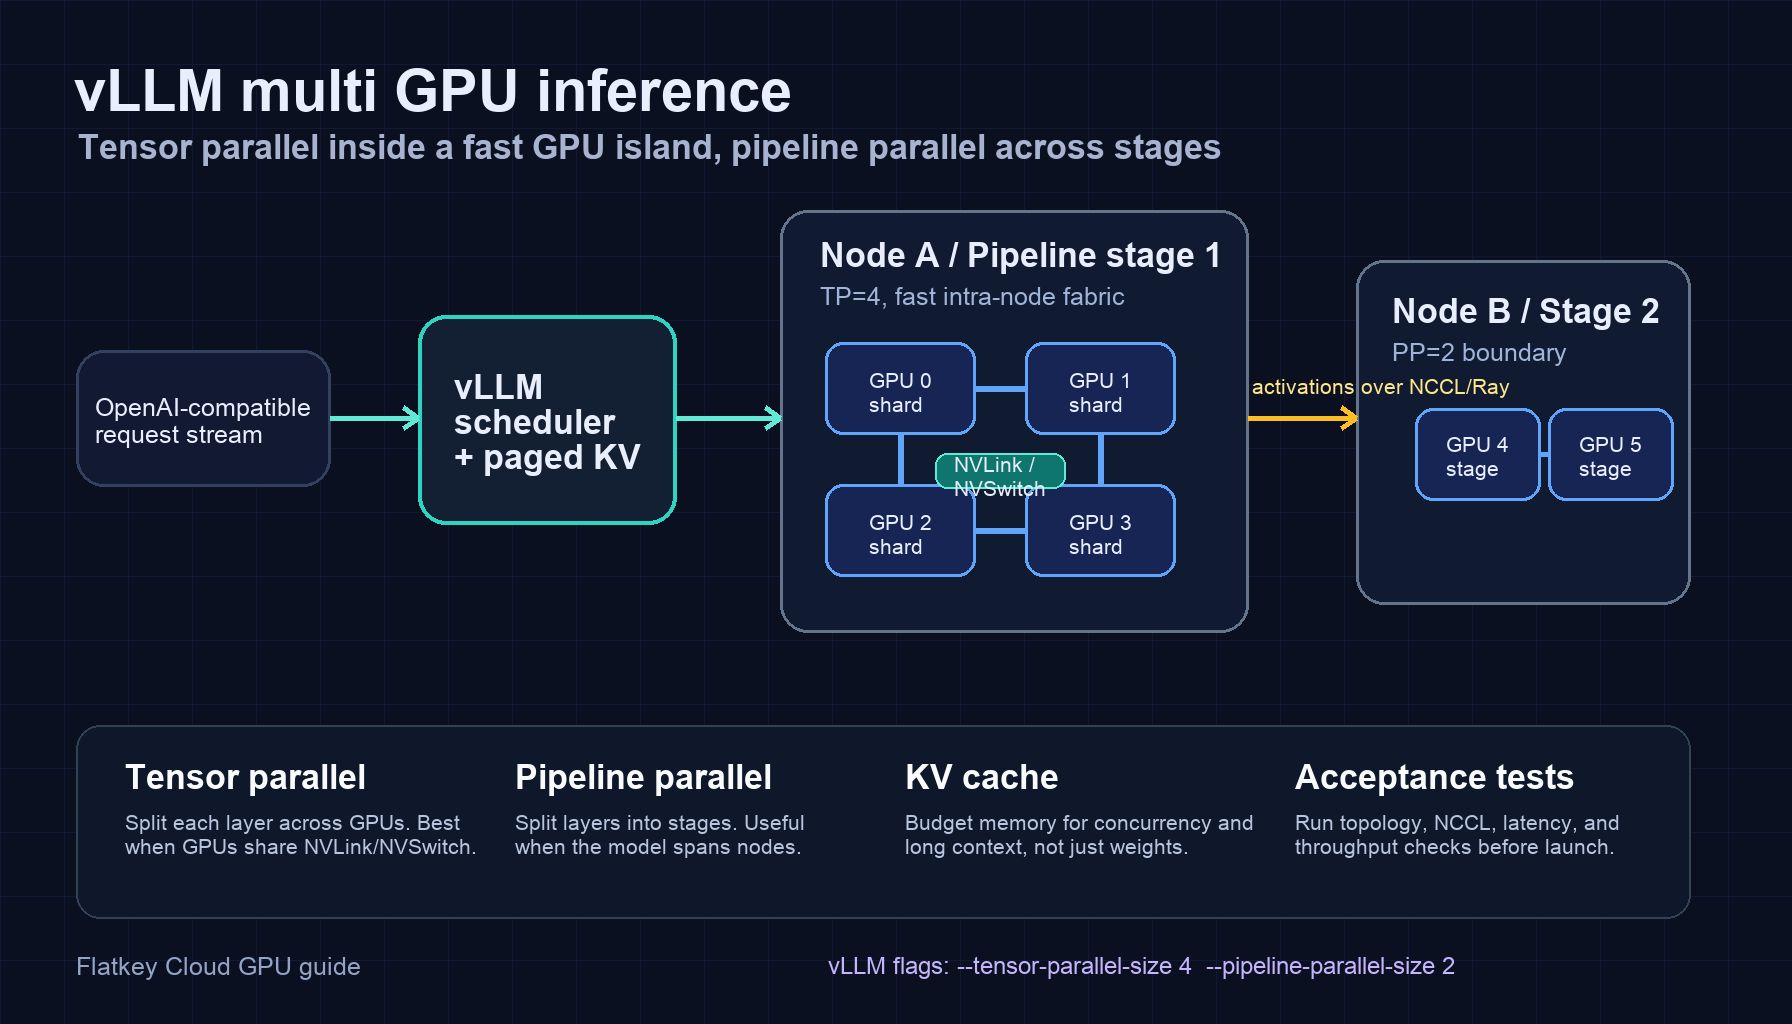
Inférence multi-GPU vLLM : configuration du parallélisme tensoriel et pipeline
Configurez l’inférence multi-GPU avec vLLM grâce au parallélisme tensoriel, au parallélisme de pipeline, à Ray, aux vérifications de topologie, à des exemples et à des tests de production.
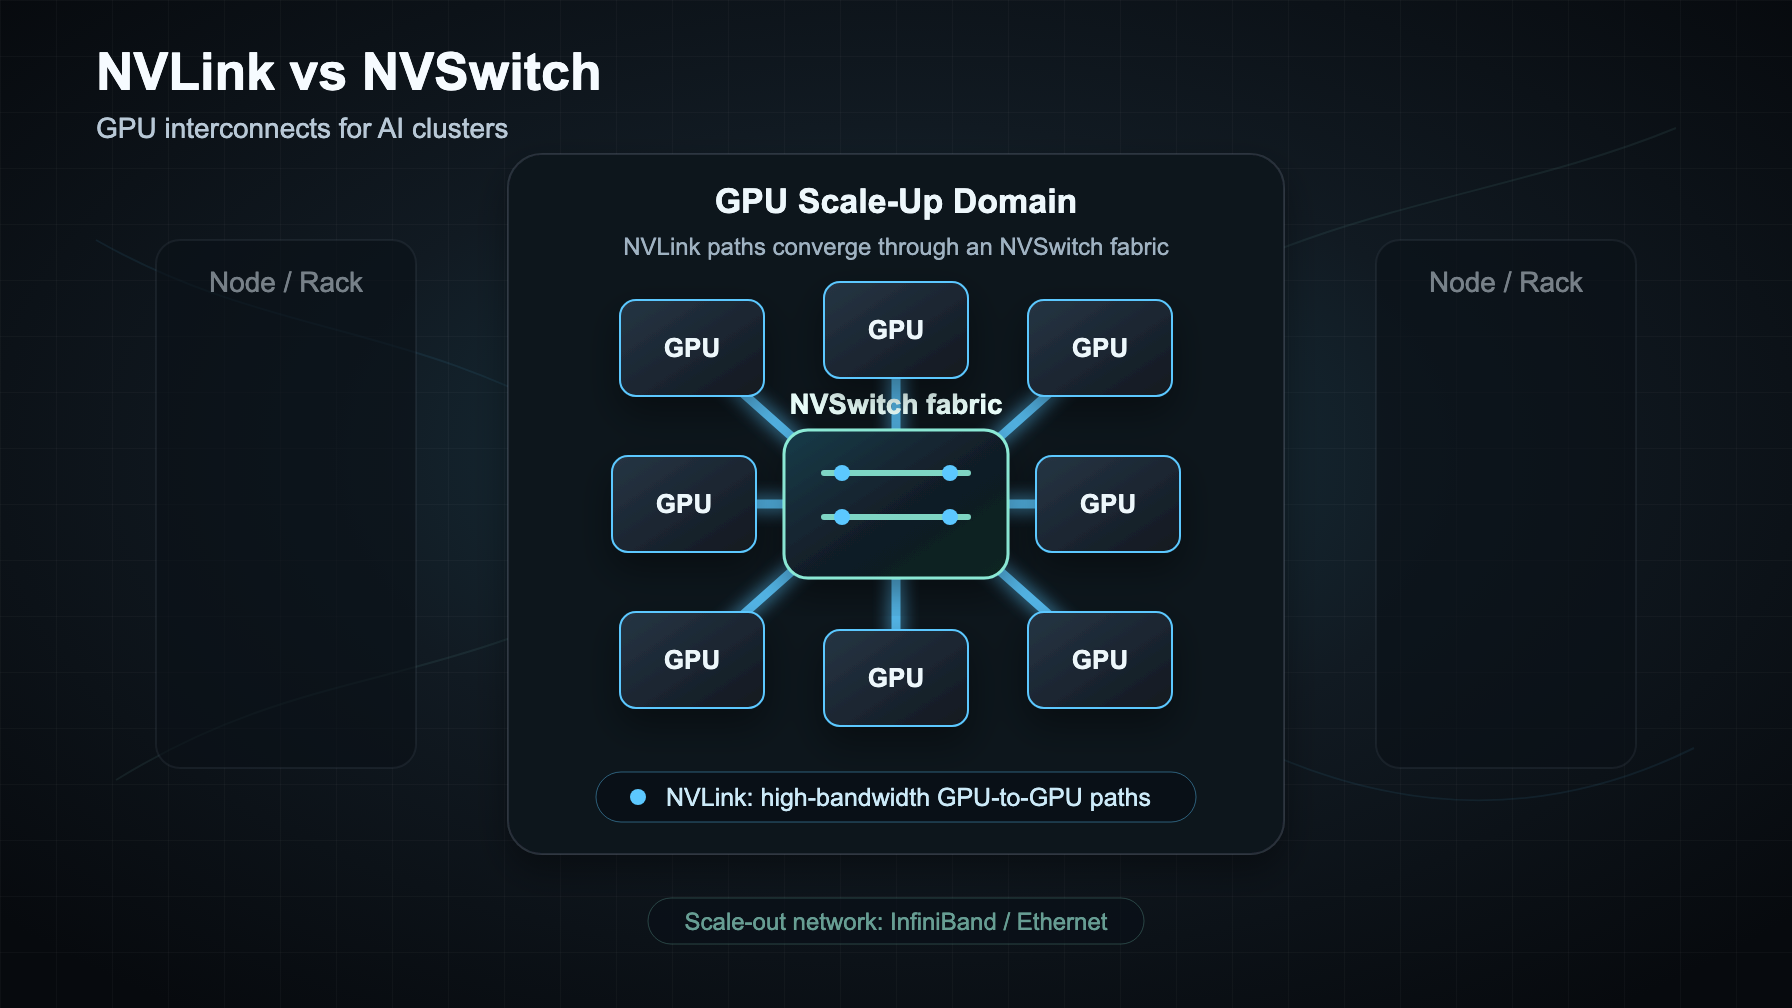
NVLink vs NVSwitch : explication des interconnexions GPU pour les clusters d’IA
NVLink est la liaison GPU à GPU, NVSwitch est la fabric, et InfiniBand ou Ethernet est le réseau de mise à l’échelle. Voici comment choisir pour les clusters d’IA.
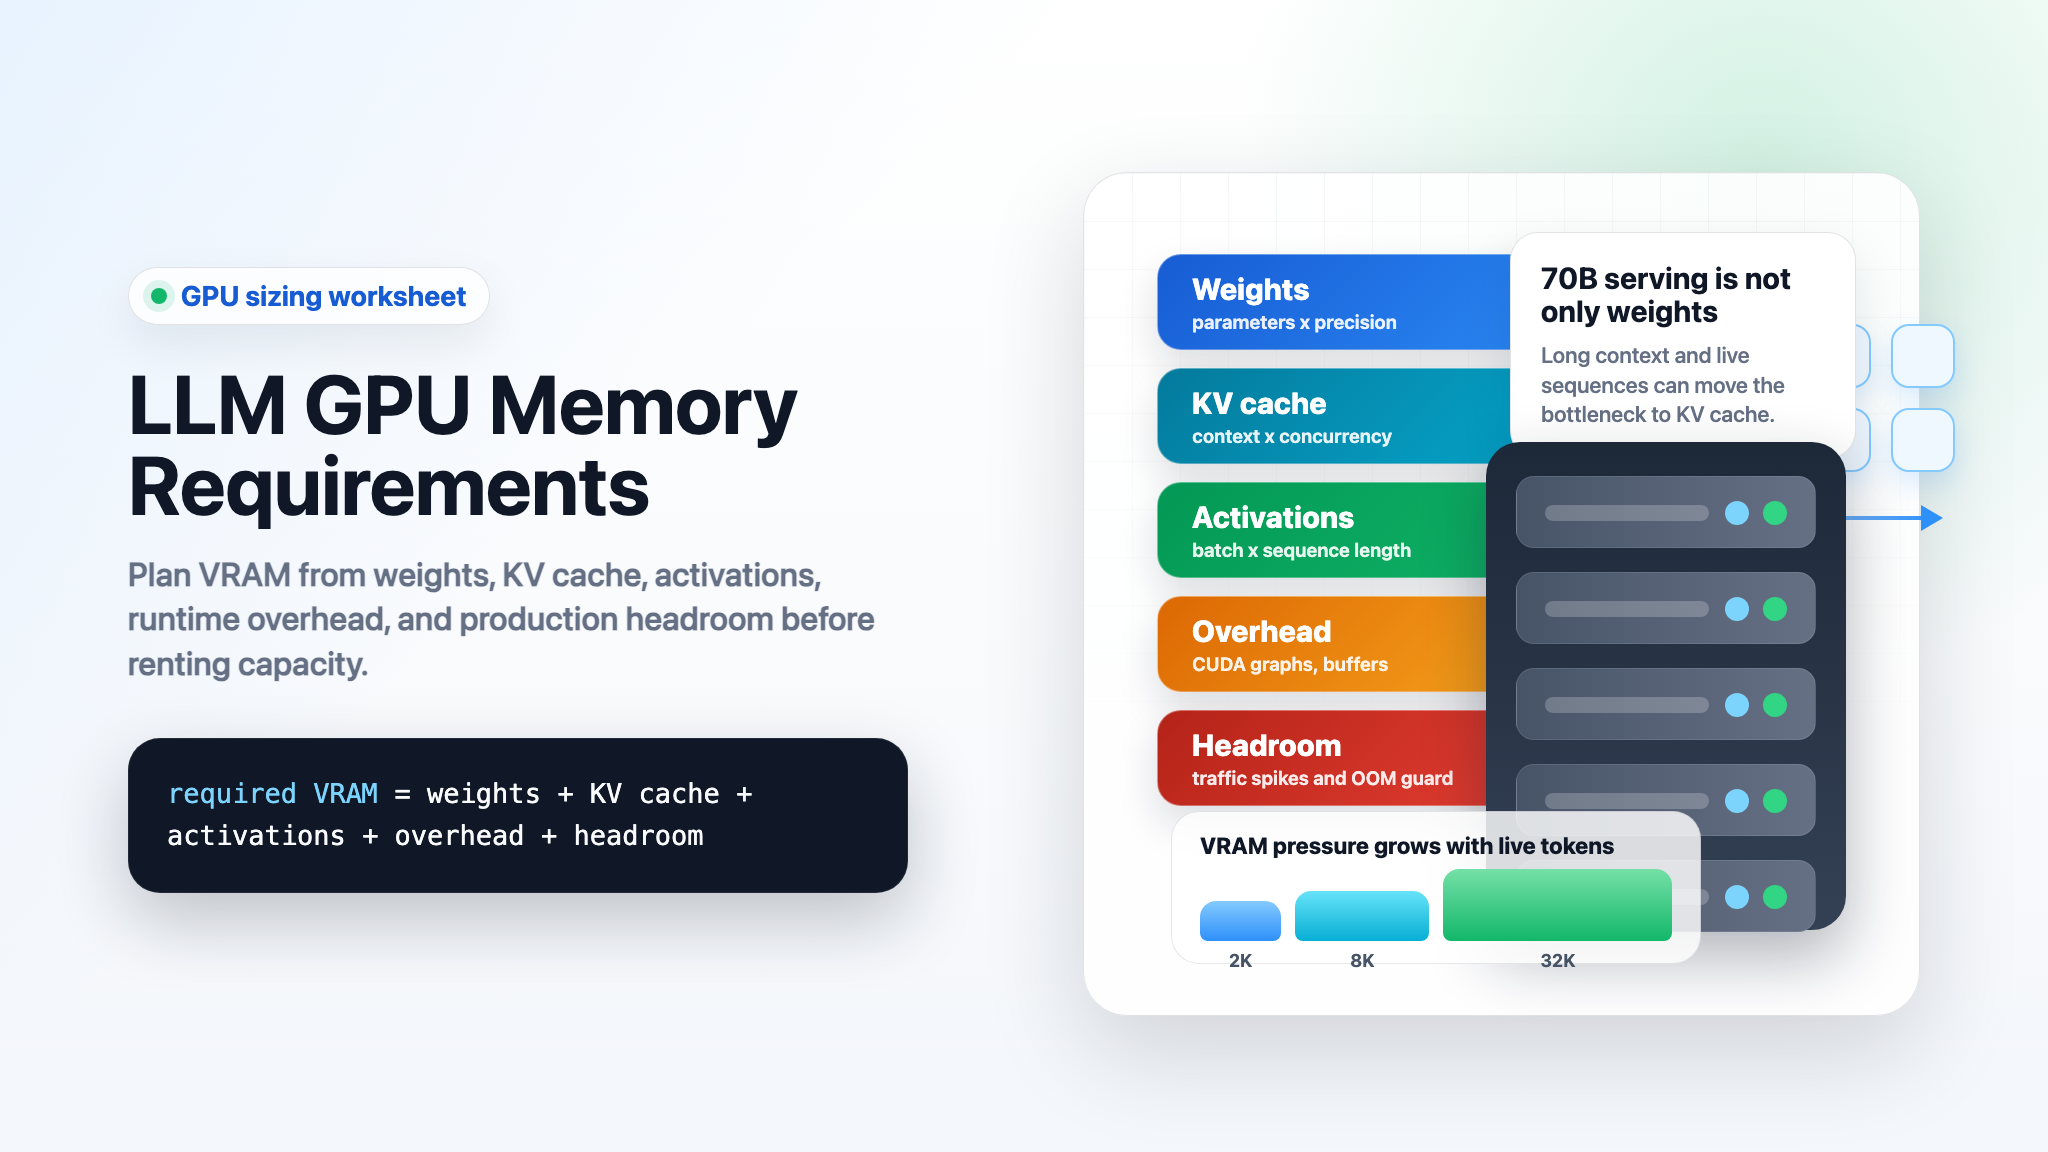
Exigences de mémoire GPU pour les LLM : poids, cache KV, activations et surcharge
Un tableau pratique pour estimer les besoins en mémoire GPU des LLM pour les poids, le cache KV, les activations, la surcharge de service, la planification vLLM 70B, le fine-tuning et l'entraînement.
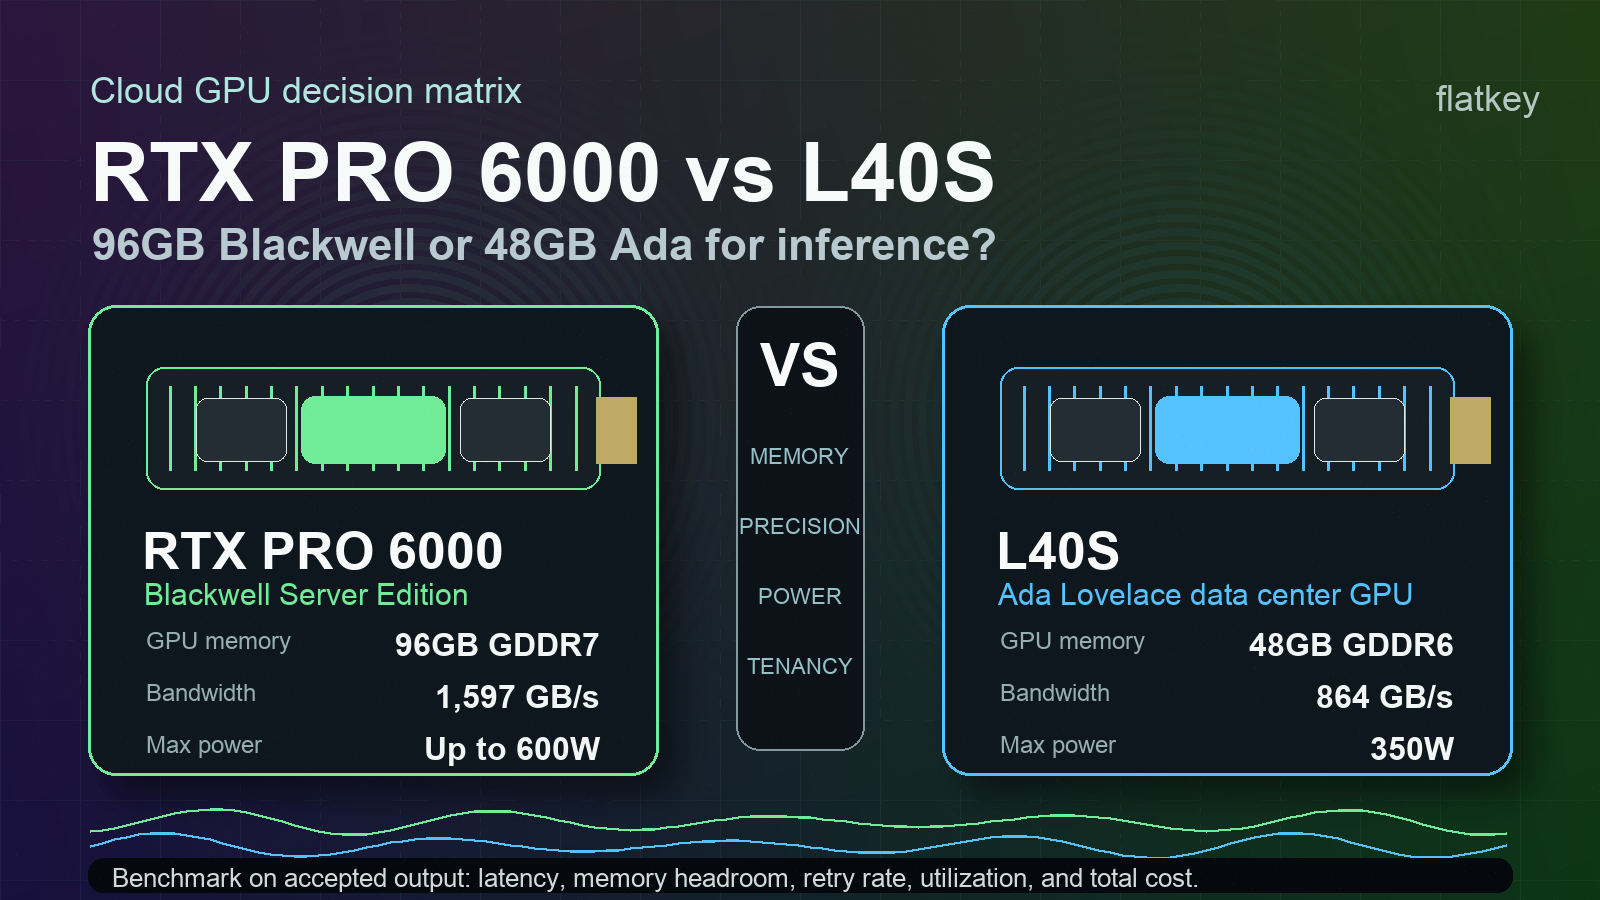
RTX PRO 6000 vs L40S : GPU d’inférence Blackwell 96 Go ou Ada ?
Comparez la NVIDIA L40S et la RTX PRO 6000 Blackwell Server Edition pour l’inférence LLM, les charges de travail multimodales, l’adéquation mémoire, la consommation électrique et le coût par résultat accepté.
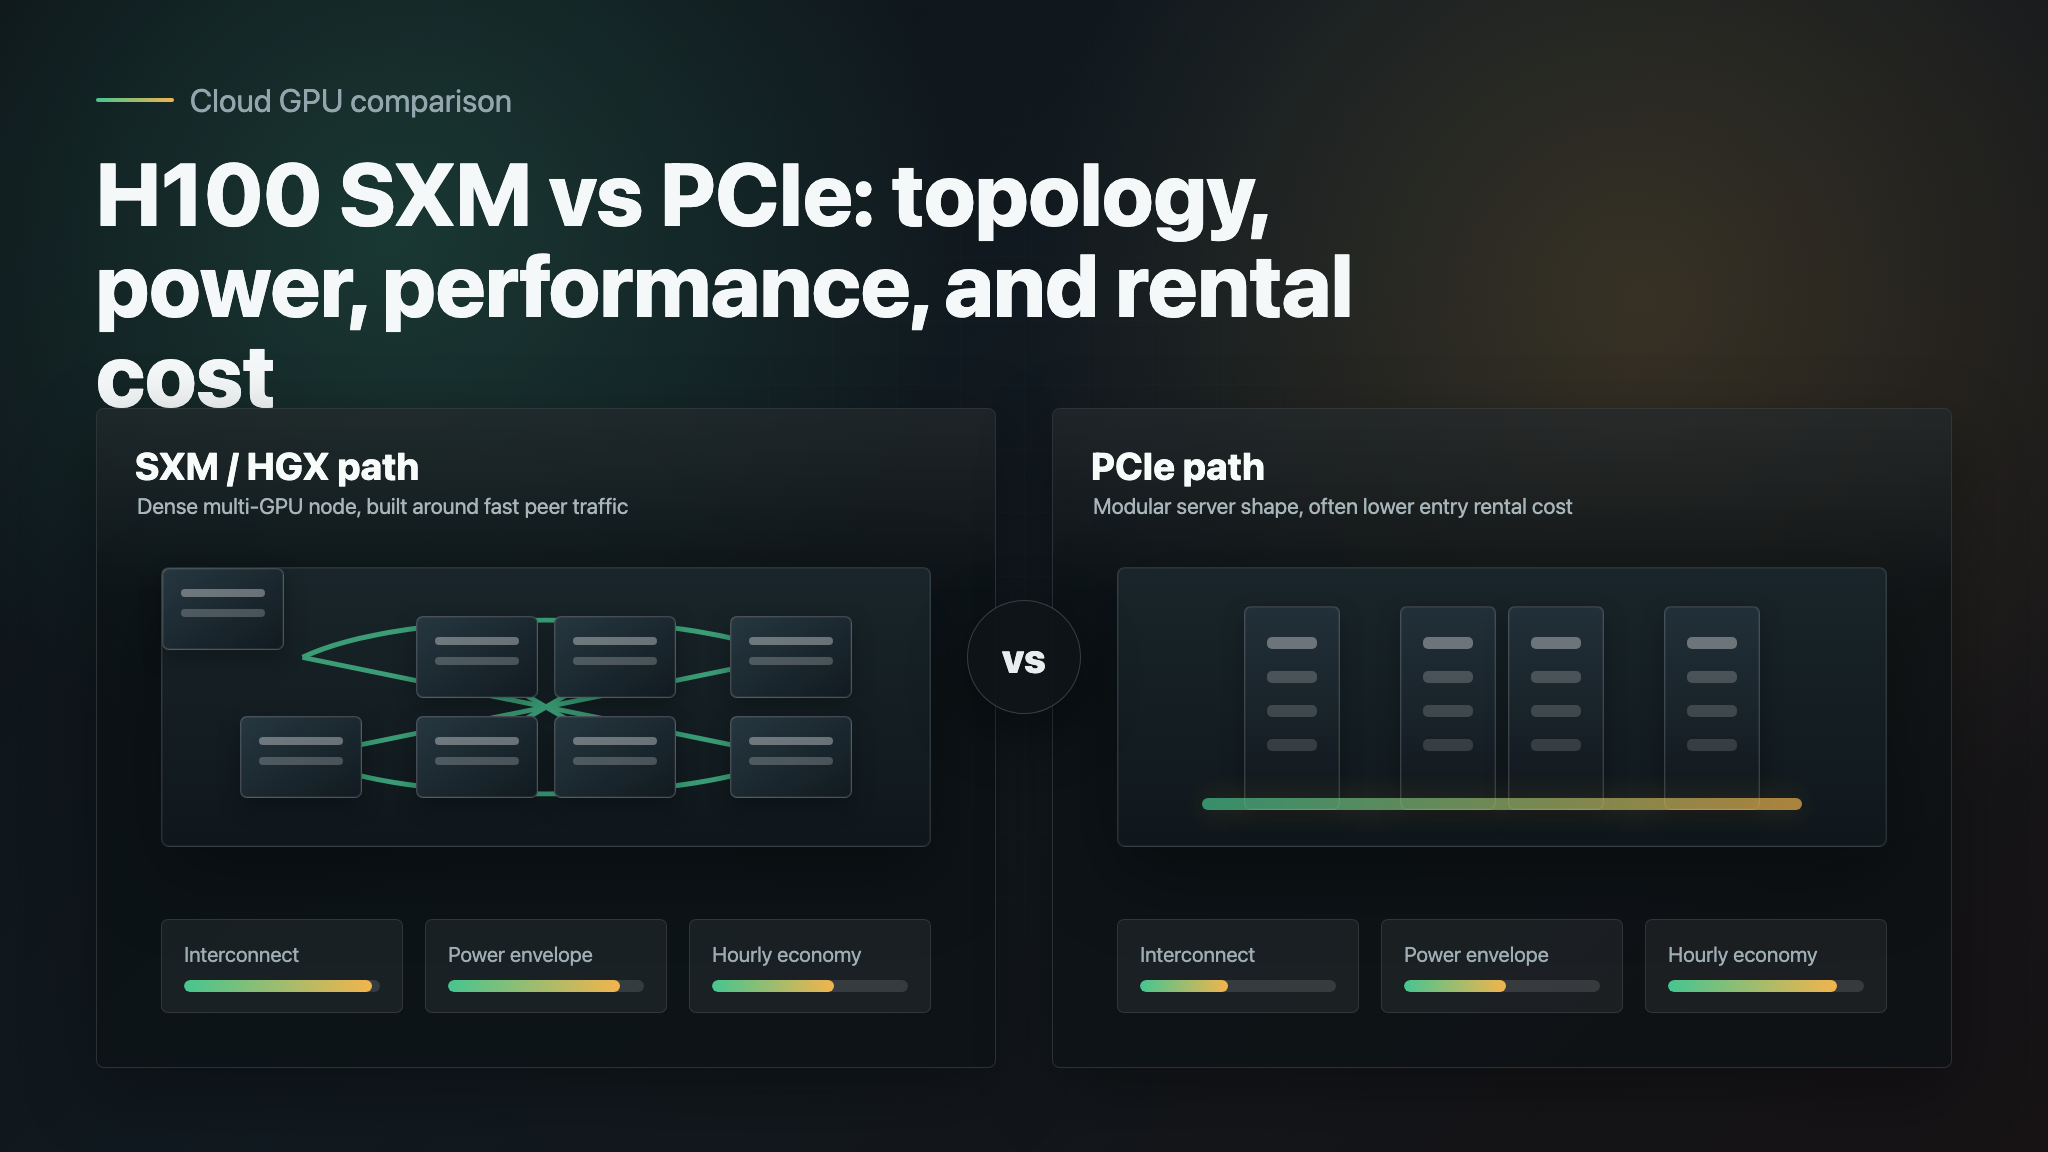
H100 SXM vs PCIe : NVLink, puissance, performances et coût de location
Comparez H100 PCIe et SXM en matière de NVLink, de consommation électrique, de performances des workloads et de coût de location avant de louer des GPU cloud.
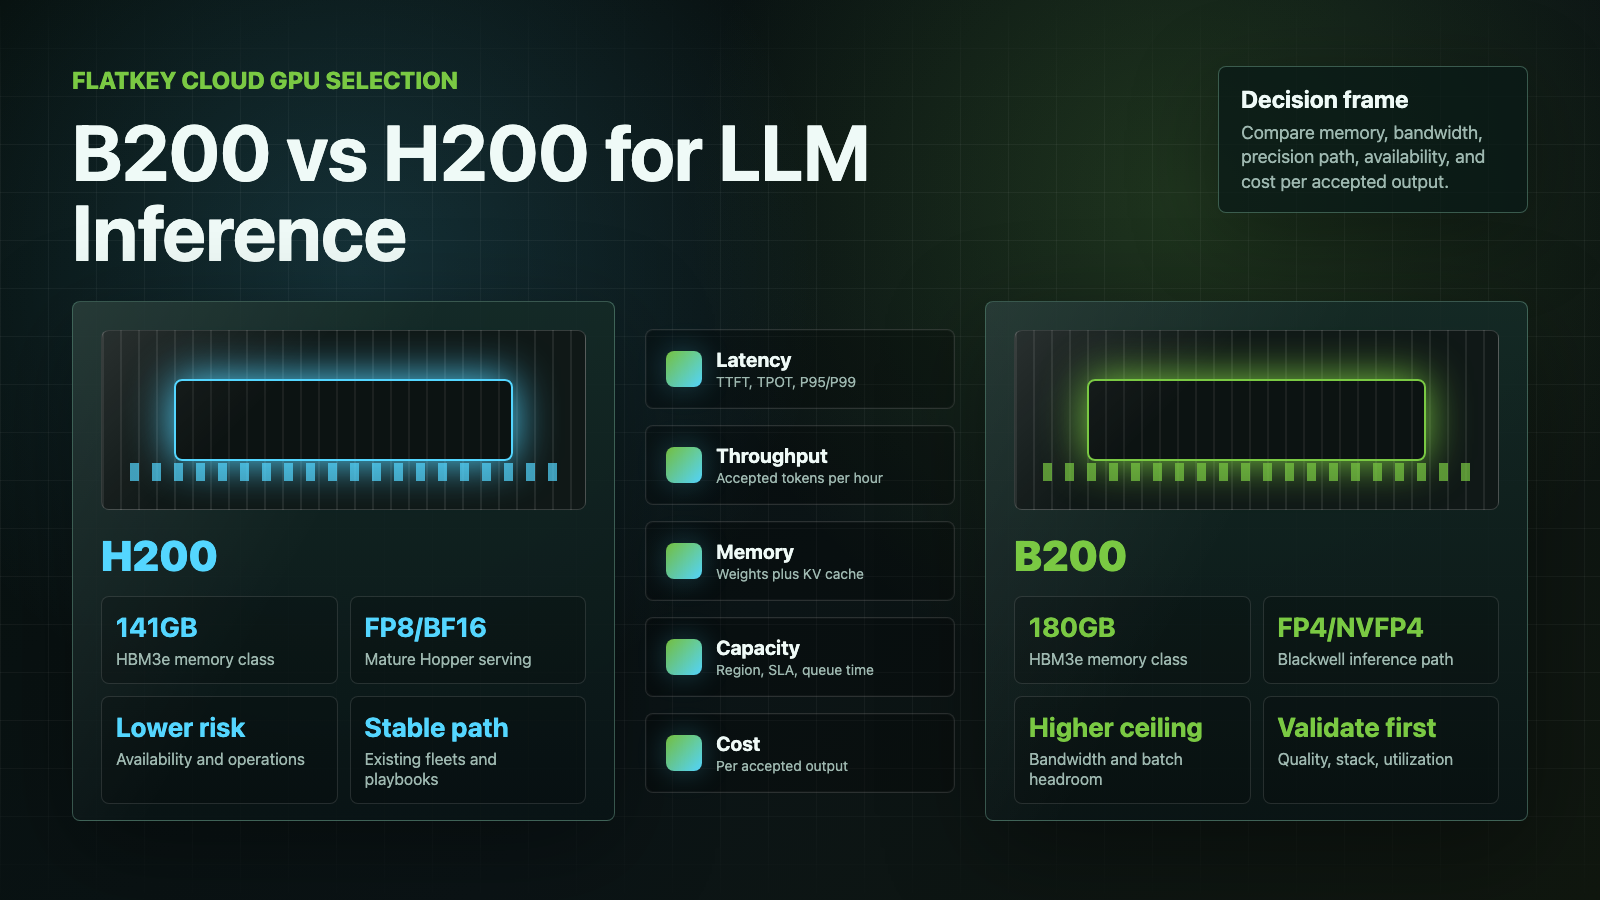
NVIDIA B200 vs H200 : quel GPU est le meilleur pour l'inférence de LLM ?
Comparez les NVIDIA B200 et H200 pour l'inférence de LLM selon la mémoire, la bande passante, la prise en charge de la précision, les systèmes DGX, la disponibilité dans le cloud et le coût par sortie acceptée.
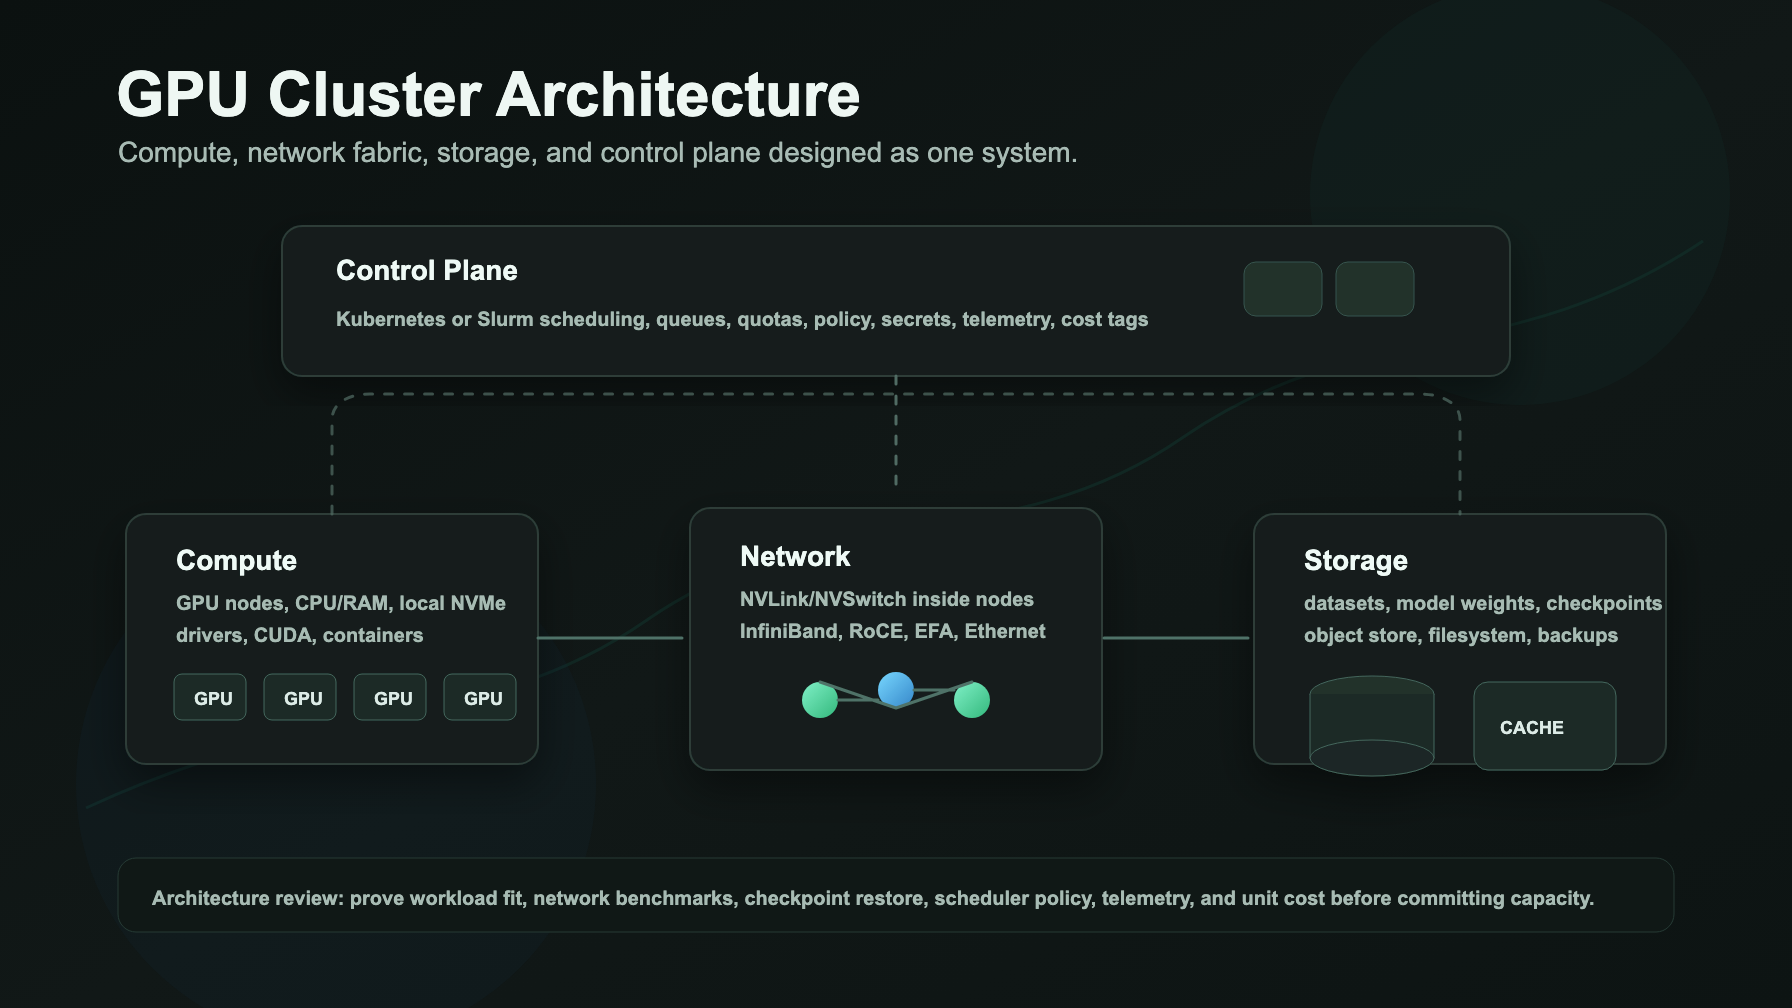
Architecture de cluster GPU : calcul, réseau, stockage et plan de contrôle
Un guide pratique d’architecture de cluster GPU pour les nœuds de calcul, le réseau, le stockage, le plan de contrôle Kubernetes ou Slurm, l’observabilité et les tests d’acceptation.
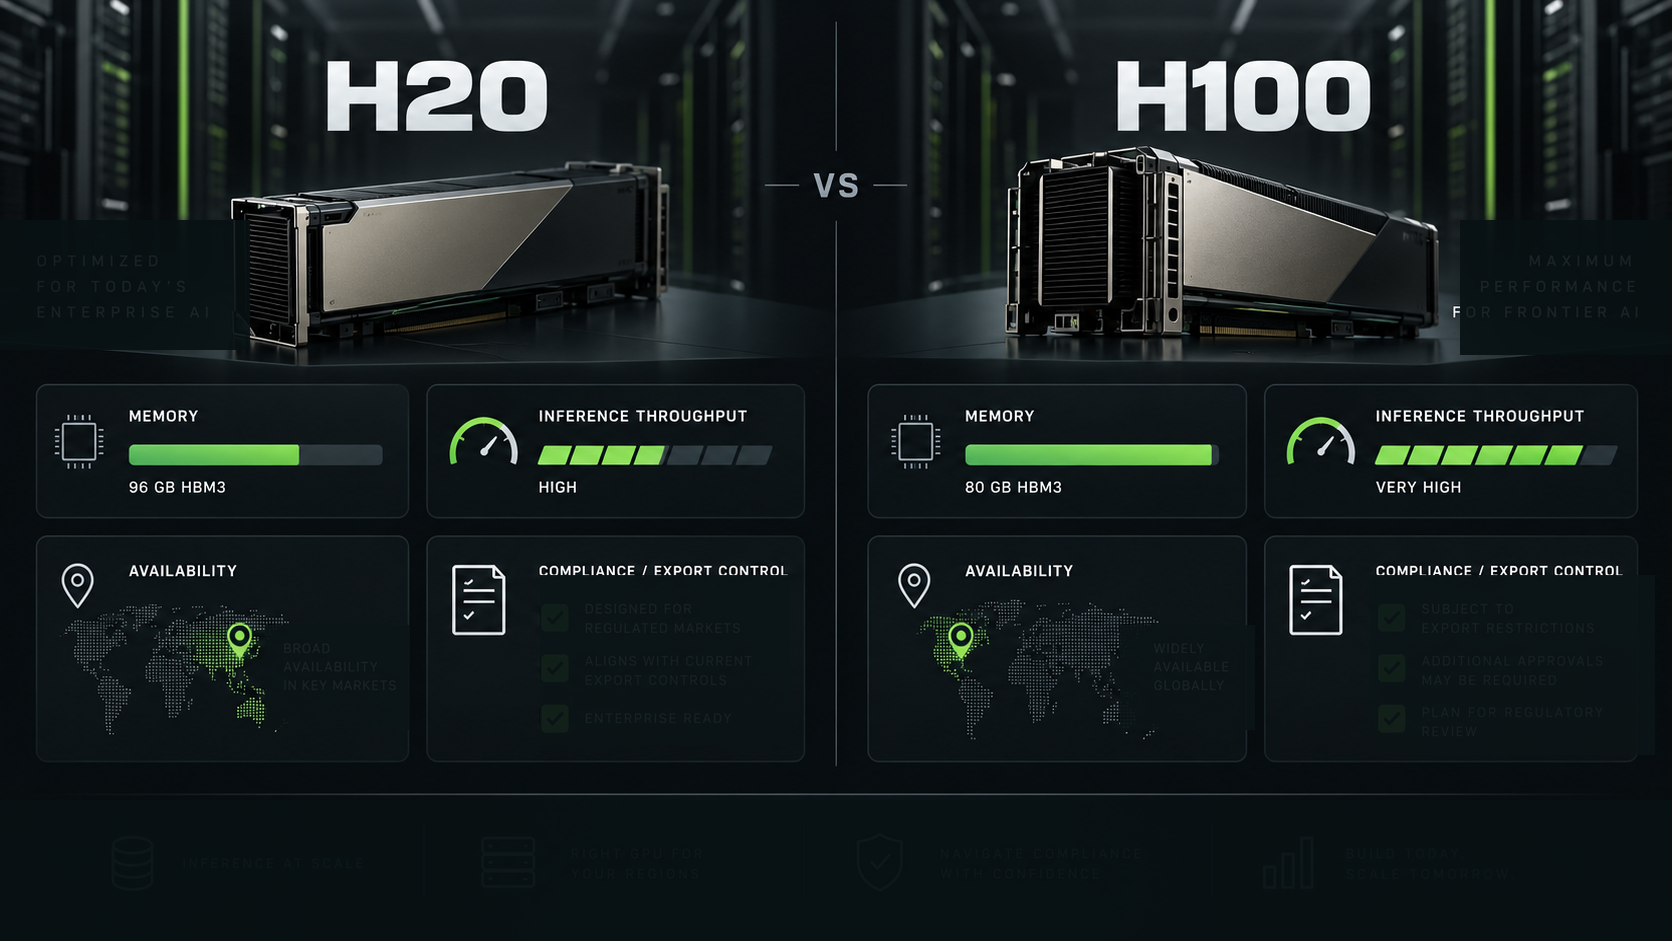
NVIDIA H20 vs H100 : inférence, mémoire, disponibilité et conformité
Une comparaison pratique H20 vs H100 pour les équipes IA en entreprise, couvrant l’inférence, la mémoire, la disponibilité, le risque lié au contrôle des exportations et les cas où H200 ou les API de modèles constituent de meilleures bases de référence.
Meilleures plateformes de location de GPU cloud en 2026 : prix, capacité, réseau et support
Une sélection pratique 2026 de plateformes cloud GPU pour les équipes IA, comparant le niveau de prix, la capacité, le réseau, le support et les cas où une API de modèle constitue une meilleure base.
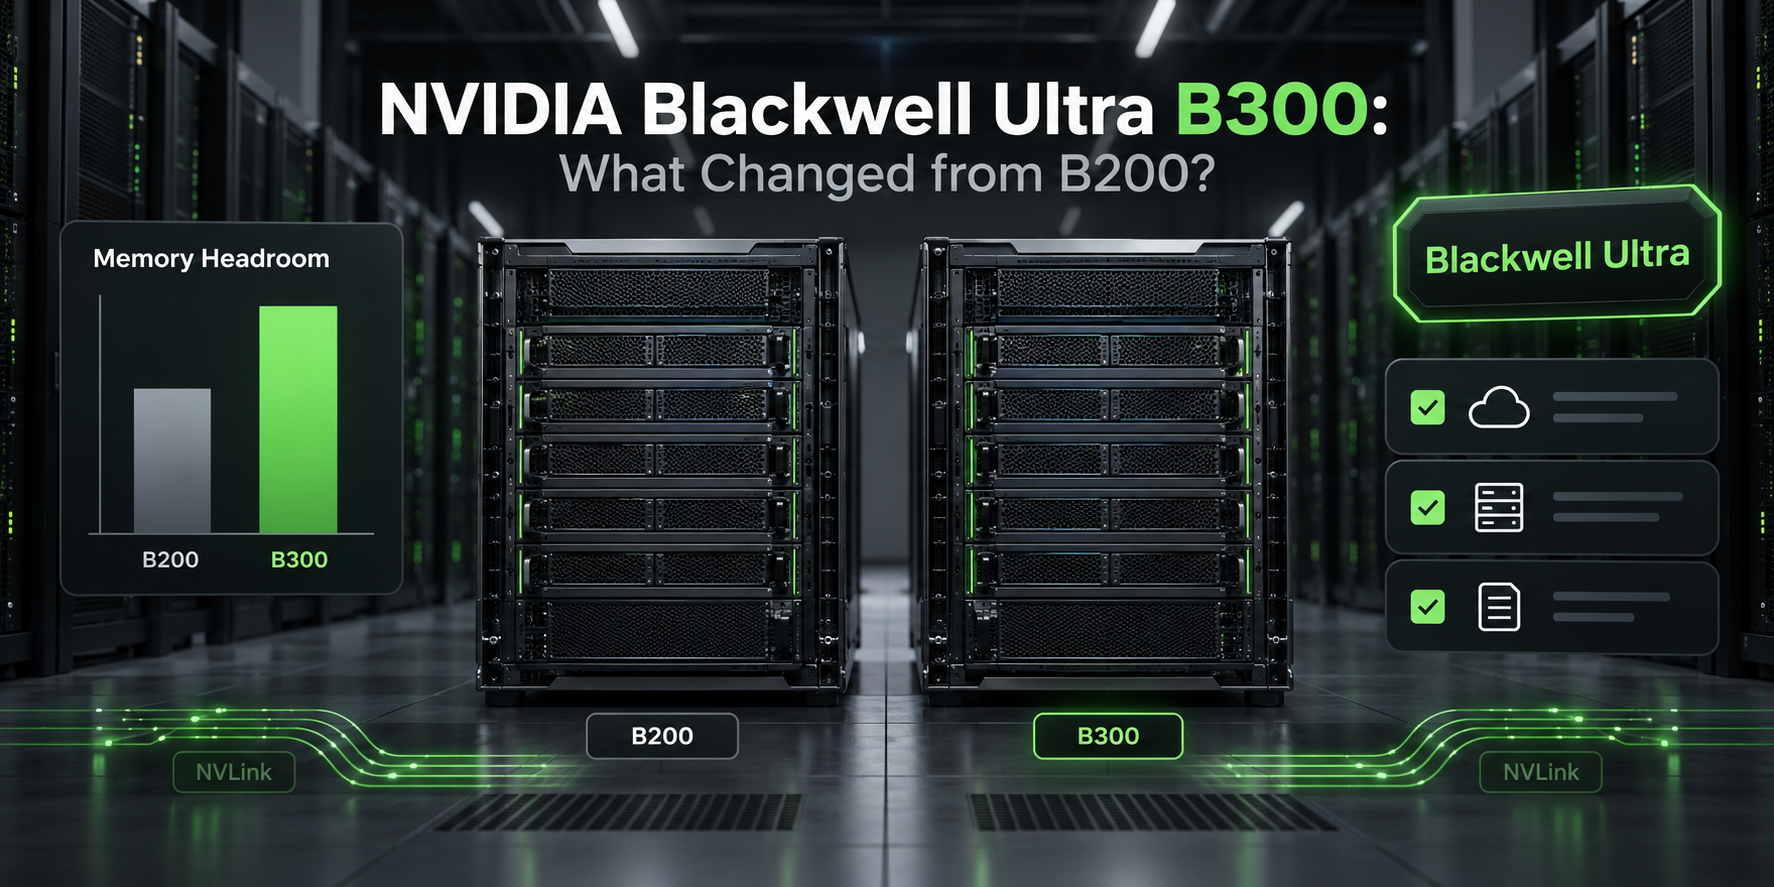
NVIDIA Blackwell Ultra B300 : qu’est-ce qui a changé par rapport au B200 ?
Un suivi pratique du NVIDIA B300 Blackwell Ultra pour les équipes d’infrastructure IA, comparant les spécifications du B300, l’état de disponibilité, les réserves sur le prix et l’adéquation aux workloads face au B200.
AMD MI455X et Helios : suivi de l’architecture, de la mémoire et de la disponibilité
Un suivi orienté acheteurs pour AMD MI455X et Helios, couvrant l’architecture, la mémoire HBM4, la bande passante, la disponibilité, la compatibilité vLLM, les questions aux fournisseurs et la stratégie de repli pour les modèles/API.
GPU NVIDIA Vera Rubin : GPU, NVL72, mémoire, réseau et suivi de disponibilité
Un suivi actualisé des spécifications du GPU NVIDIA Vera Rubin, du DGX Vera Rubin NVL72, de la mémoire HBM4, du réseau et des étapes de disponibilité pour les acheteurs de GPU cloud.
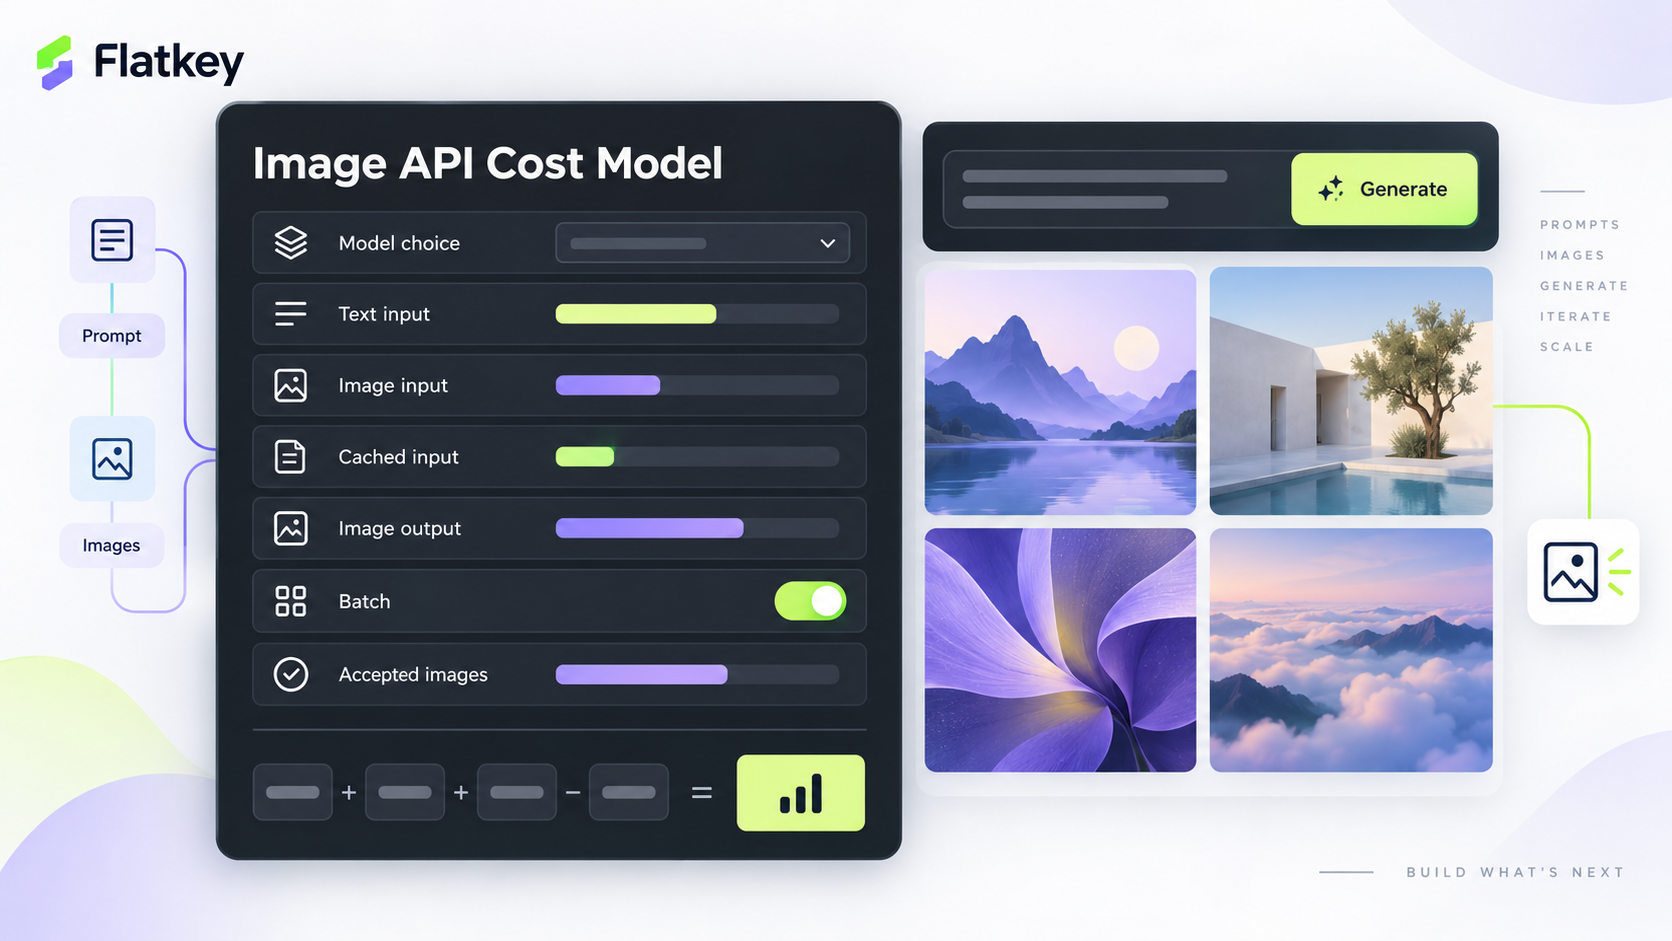
Tarification de l’API Image OpenAI : tarifs de GPT Image 2.5, formule de coût et contrôles budgétaires
Découvrez comment fonctionne la tarification de l’API image OpenAI pour GPT Image 2.5, notamment les tarifs en tokens, les règles d’entrée mise en cache, les images partielles, Batch et le coût par image acceptée.
GB200 vs B200 : superchip Grace Blackwell ou HGX x86 ?
Comparez GB200 et B200 pour l’achat d’infrastructures IA : systèmes Grace Blackwell à l’échelle du rack NVL72, nœuds B200 HGX/x86, benchmarks et vérifications du TCO.
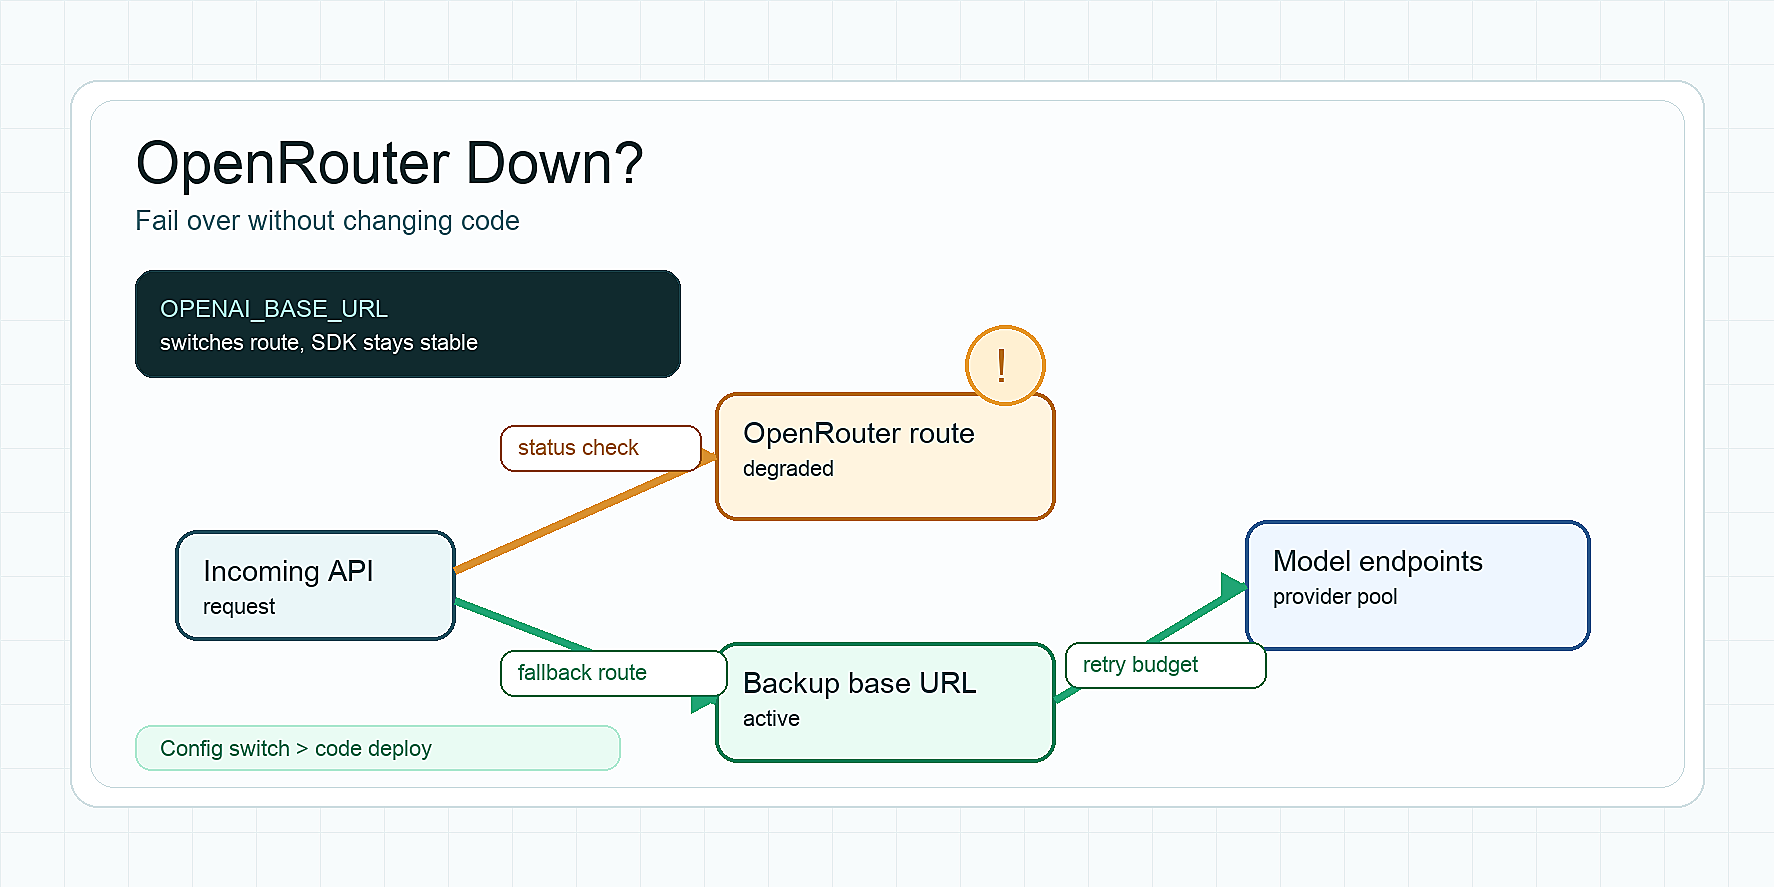
OpenRouter en panne ? Comment basculer sans changer de code
Vérifiez si OpenRouter est en panne, distinguez les erreurs de fournisseur des incidents de plateforme, et mettez en place un basculement avec base_url, retries, provider fallback et model fallback.
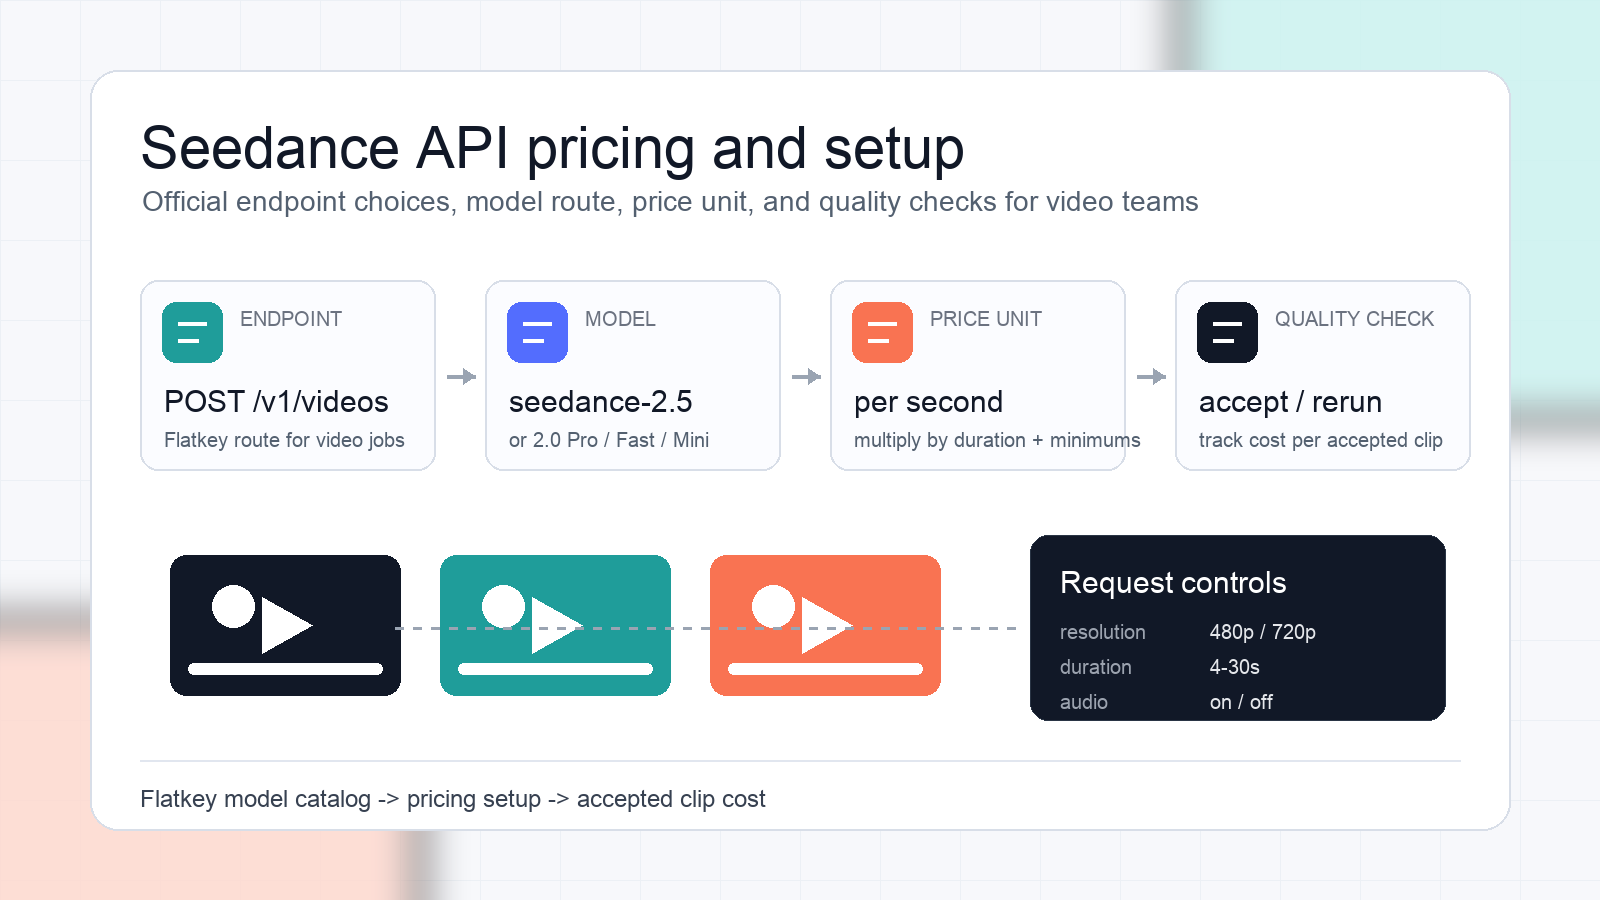
Seedance API : tarification, qualité et configuration pour les points de terminaison officiels
Comparez les options officielles de points de terminaison de l’API Seedance, la tarification à la seconde de Flatkey, les étapes de configuration et les contrôles qualité pour les équipes de génération vidéo.
Qu’est-ce qu’une usine d’IA ? Clusters GPU, données, modèles et opérations
Découvrez ce qu’est une usine d’IA, comment les clusters GPU, les pipelines de données, les modèles, l’inférence, la gouvernance et les opérations fonctionnent ensemble, et quand les API de modèles peuvent remplacer la possession directe de GPU.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer