
コスト・課金・運用
コスト・課金・運用 の最新記事。
H100 GPUの価格:価格設定、コスト要因、購入ガイド
32,200ドルのPCIe掲載価格、クラウドレンタルのスナップショット、フォームファクター、オンプレミス見積もりの背後にあるTCOを比較するためのH100 GPU価格ガイド。

GPUサーバー:アーキテクチャ、パフォーマンス、クラウド導入ガイド
ワークロード優先のアーキテクチャ、性能テスト、本番運用の準備フレームワークで、クラウドGPUサーバーを選定・導入します。
無料LLM API:制限、コスト、本番運用のトレードオフ
無料LLM APIのティア、クレジット、レート制限、見えにくい運用コスト、そしてユーザーがルートに依存する前に追加すべき本番運用向け制御を実践的に解説します。
クラウドGPUでComfyUIを使う:セットアップ、ストレージ、コストガイド
永続ストレージ、プライベートアクセス、ワークロードに応じたGPU選定、コスト管理を備えたクラウドGPUへのComfyUI導入ガイド。

2026年最安LLM API:話題性ではなくワークロード別に価格を比較
入力、出力、キャッシュ、バッチ、ツール、リトライ、修復のコストを含め、低コストなLLM APIをワークロード別に比較するための、出典確認済みガイド。

ソブリンAIインフラ:モデル、データレジデンシー、計算資源の管理(2026年ガイド)
2026年のソブリンAIインフラ実践ガイド。計算資源・データ・モデル・運用の4層、導入を促す規制、主権確保の5段階、オープンモデルの配信構成、国内GPUで70Bモデルを運用する場合のコスト例を解説します。

Anthropic APIキー(2026年):取得方法、キーの種類、Claude Code設定、エラー対処
2026年のAnthropic APIキー完全ガイド。Console設定、個人キーとサービスアカウントキー、有効期限、最初のリクエスト、Claude Code設定、料金、エラー対処まで。

Grok APIの料金(2026年):全モデル・ツール料金・料金倍率
xAI Grok APIの最新料金。テキスト・画像・動画・音声の単価、長文コンテキスト・優先処理・米国リージョン・Batch・ツールの5つの倍率、コスト計算例、GPT・Claude・Gemini・Qwenとの価格比較。
Mistral APIの料金(2026年):全モデル、バッチ割引、コスト試算例
Mistral APIの全モデル料金表(2026年10月の公式データ)、無料枠、バッチ・キャッシュ割引、コスト計算ツール、GPT・Claude・Gemini・Qwenとの価格比較、接続コードをまとめました。
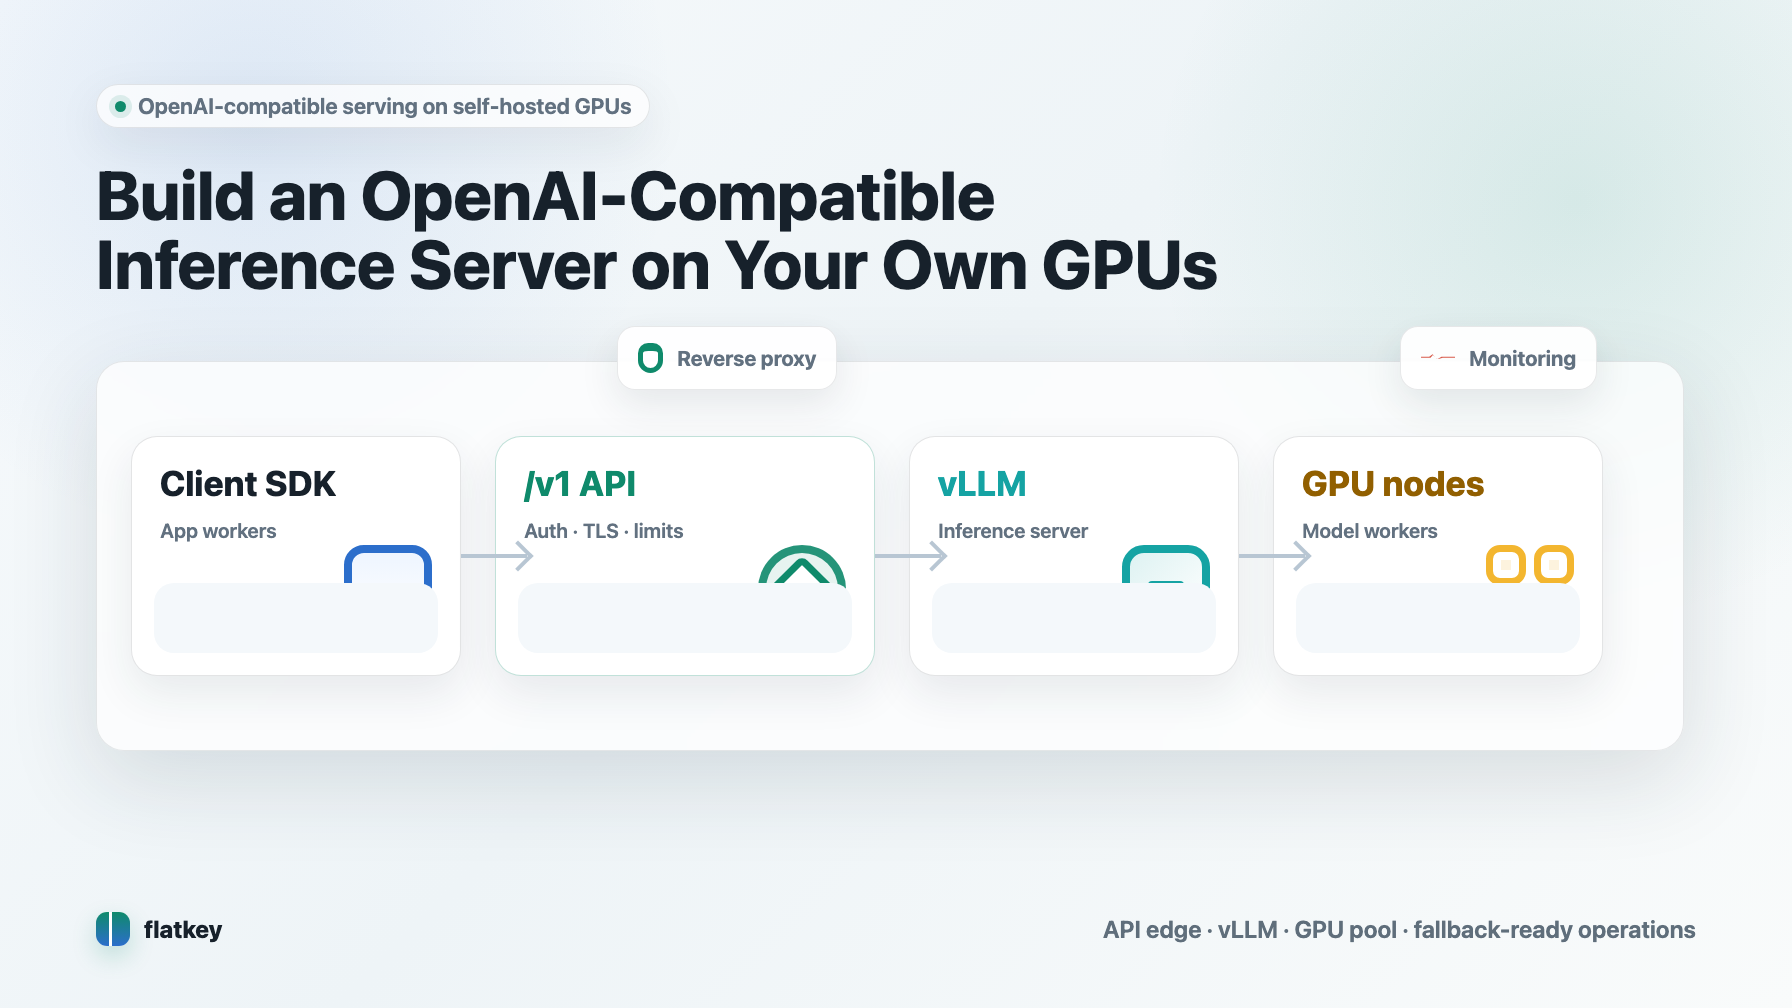
LLMセルフホスティングガイド(2026年):採算の見極め、必要なハードウェア、推論サーバーの構築
セルフホスト型LLMは、自分で管理するGPU上でオープンウェイトモデルを動かす仕組みです。2026年10月のGPU料金を基に、トークン従量課金のAPIより安くなる条件、GPUメモリの見積もり方、推論ツールの選び方、フォールバックを備えたOpenAI互換vLLMサーバーのデプロイ方法を解説します。
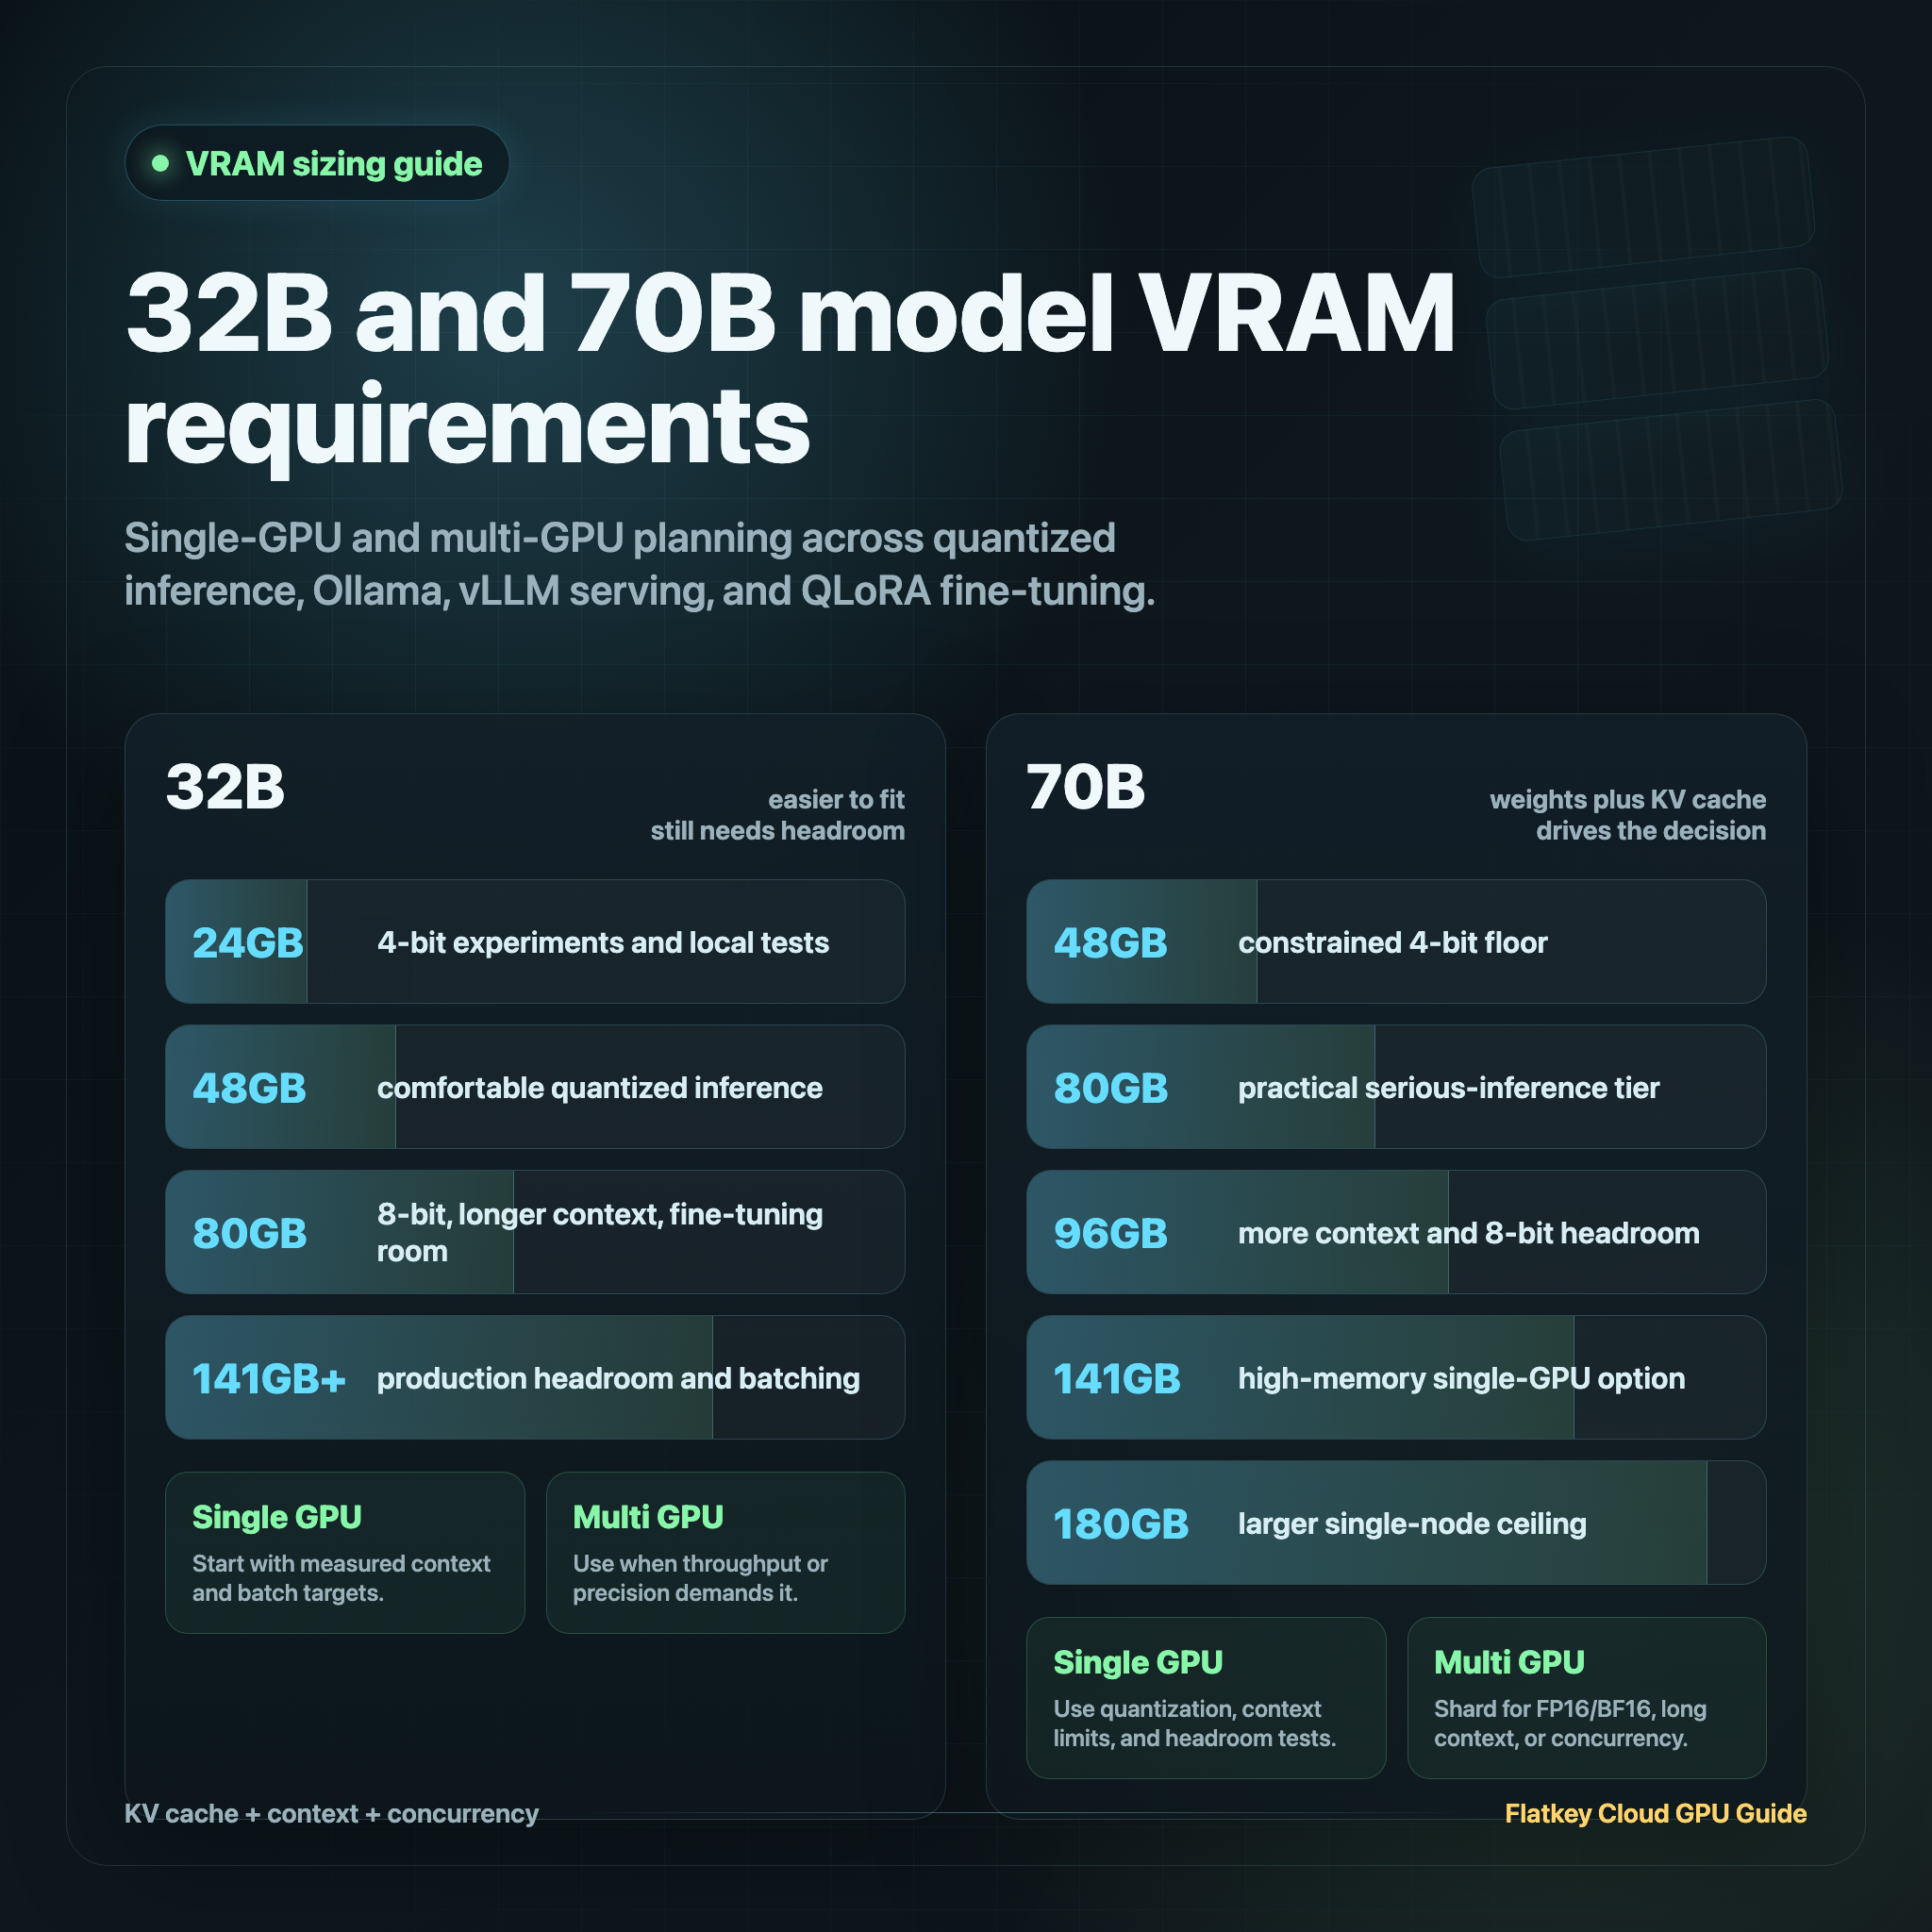
32Bおよび70BモデルのVRAMガイド:単一GPUとマルチGPUの選択肢
4bit、8bit、FP16/BF16推論、Ollama、QLoRAファインチューニング、マルチGPU構成における32Bおよび70Bモデルの実用的なVRAM要件を解説します。
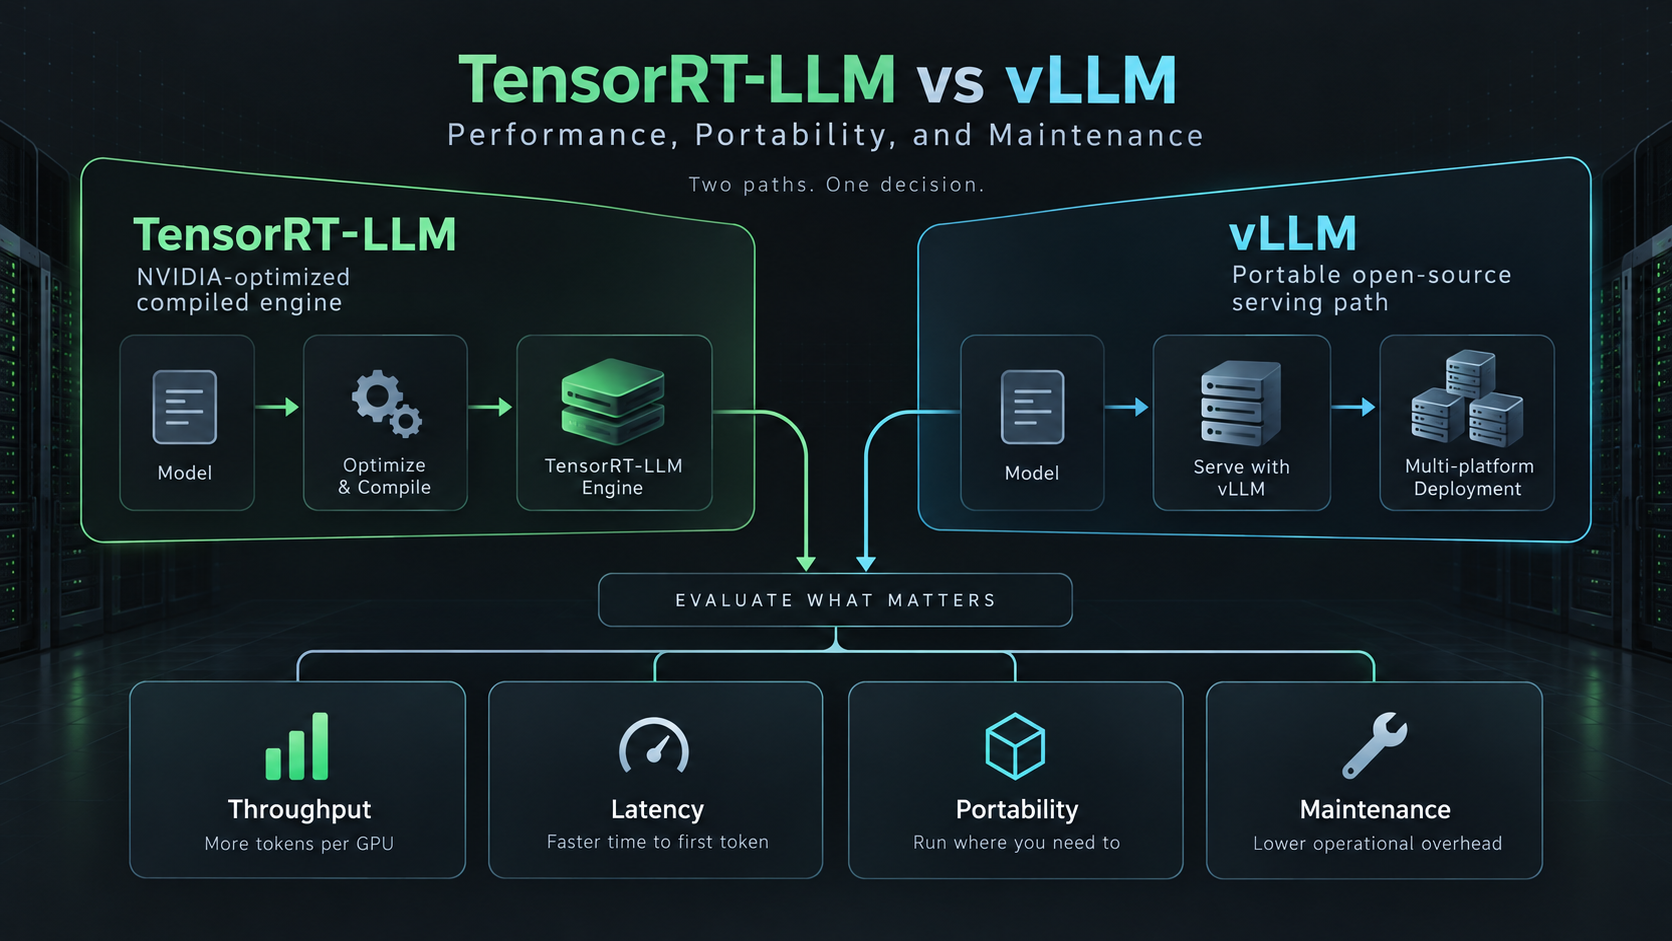
TensorRT-LLM vs vLLM: 性能、移植性、運用保守の比較
TensorRT-LLM vs vLLM を性能、移植性、保守コスト、ベンチマーク設計の観点から比較する実務ガイド。
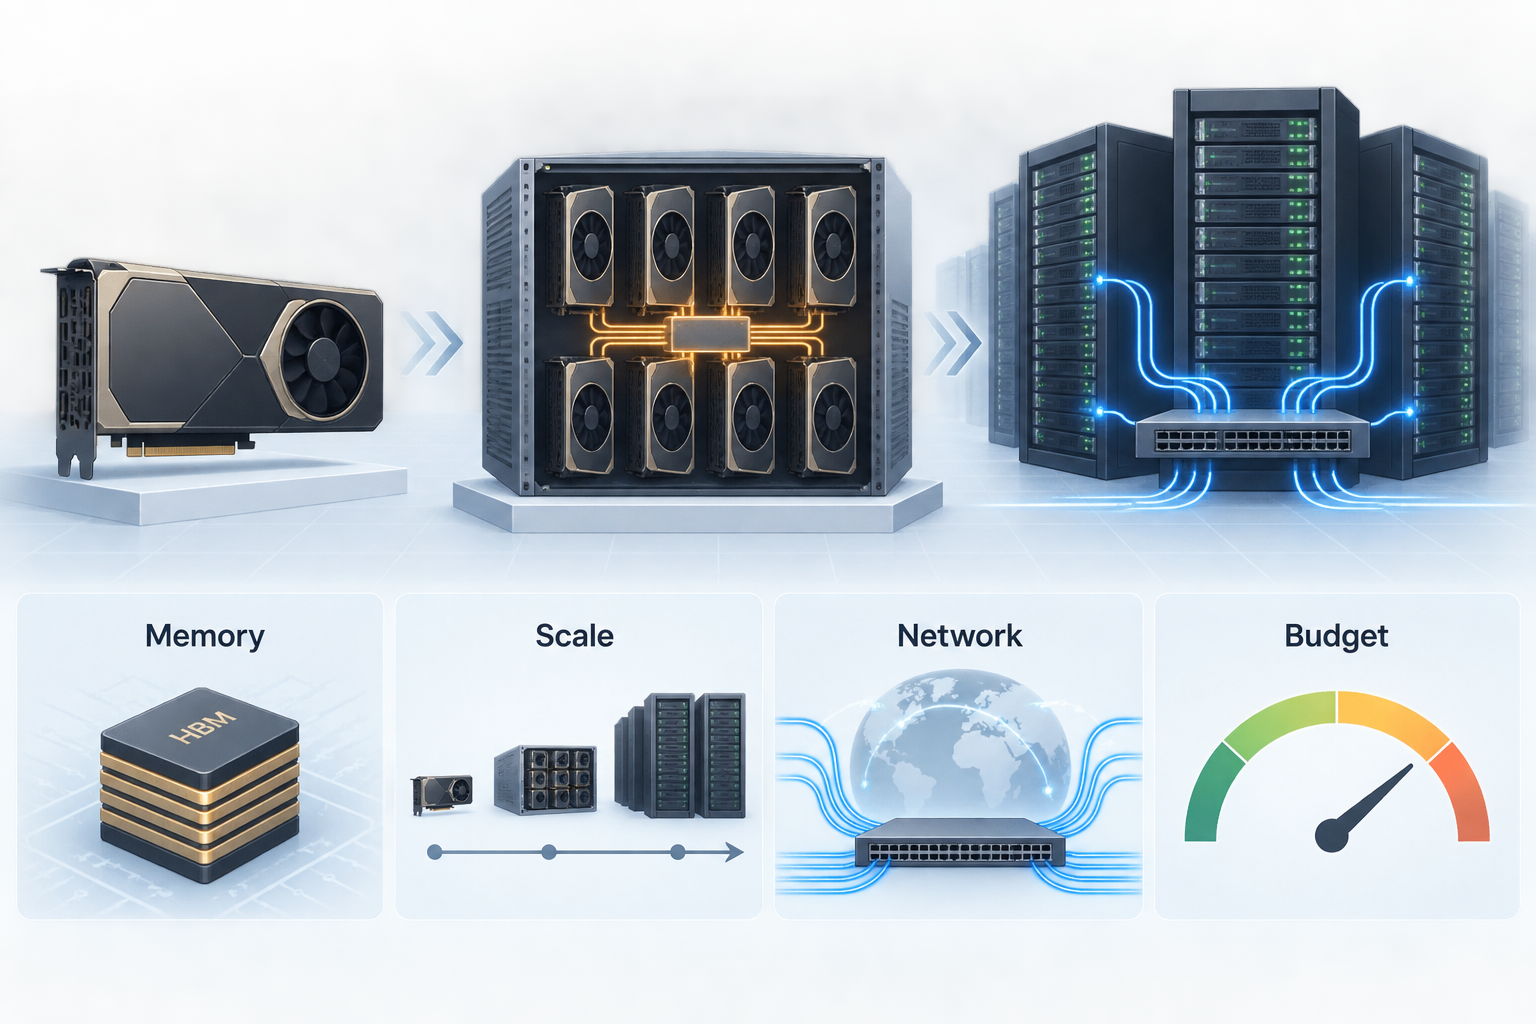
LLMトレーニングに最適なGPU:スケール、メモリ、ネットワーク、予算
スケール、メモリ、ネットワーク、プロバイダー適合性、完了チェックポイントあたりのコストに基づいてLLMトレーニングに最適なGPUを選ぶための、実践的な2026年ガイド。
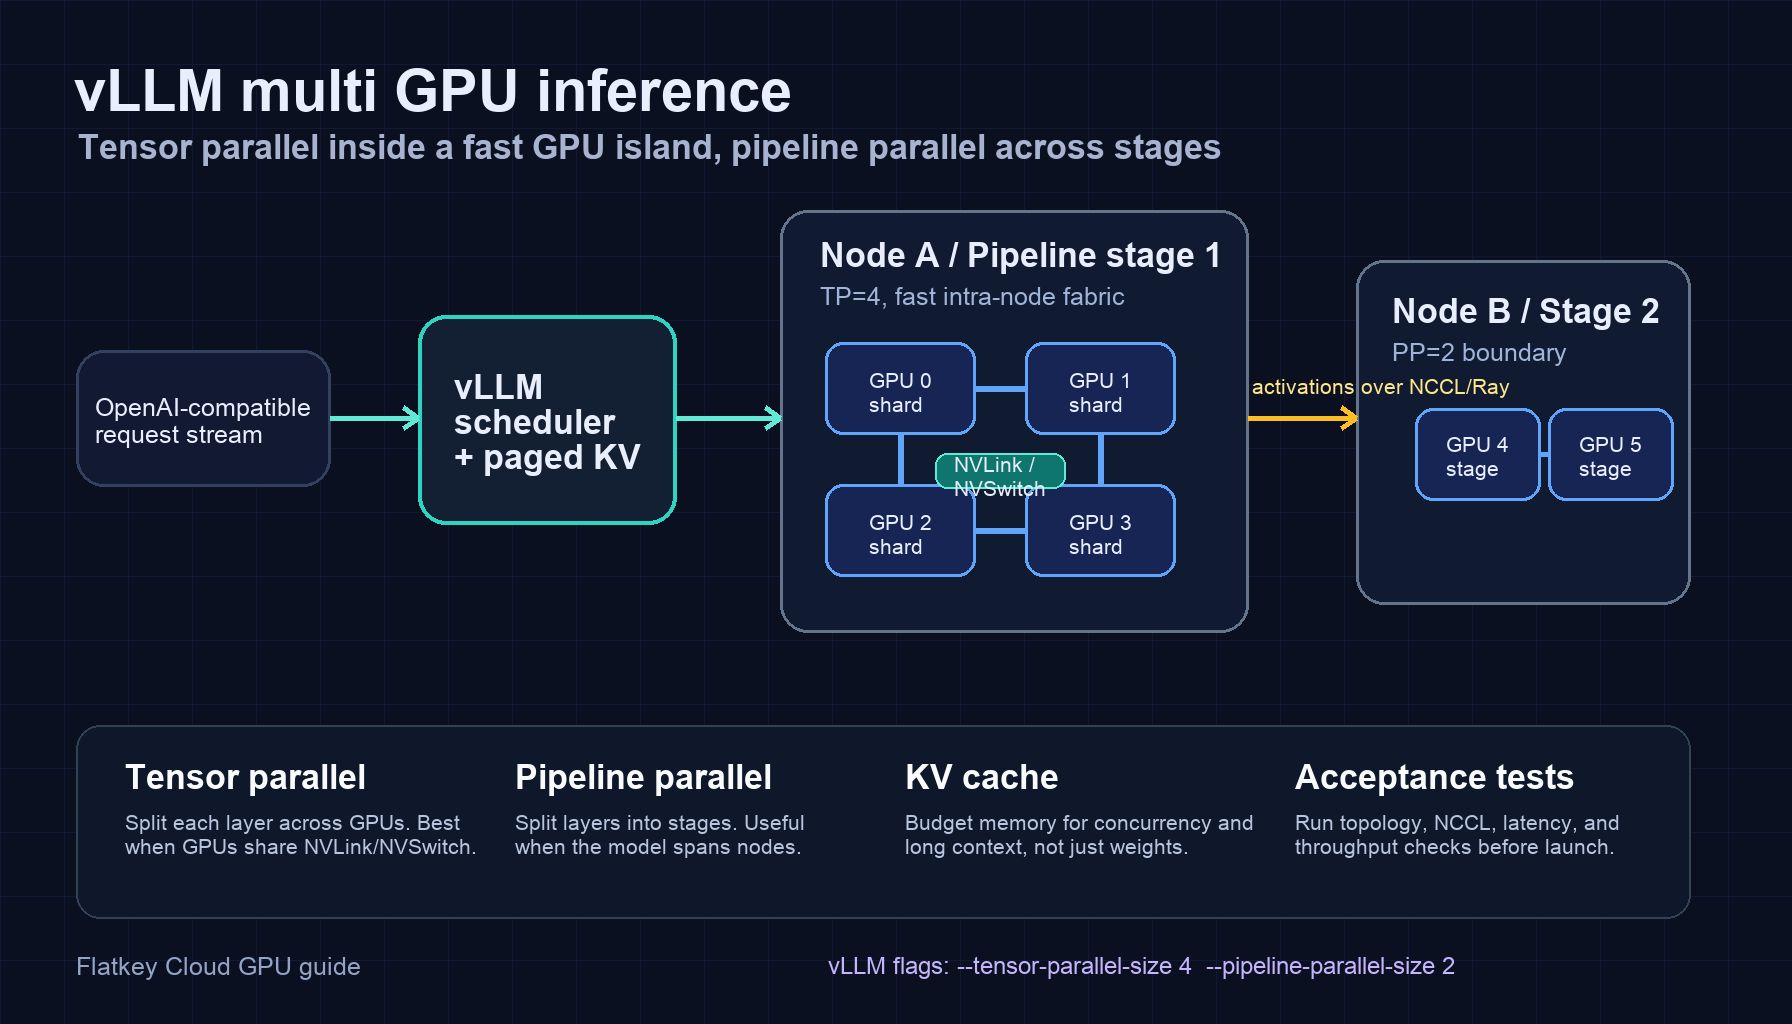
vLLM マルチGPU推論: Tensor と Pipeline の並列セットアップ
vLLM のマルチGPU推論を、tensor parallelism、pipeline parallelism、Ray、トポロジー確認、サンプル、運用テストでセットアップします。
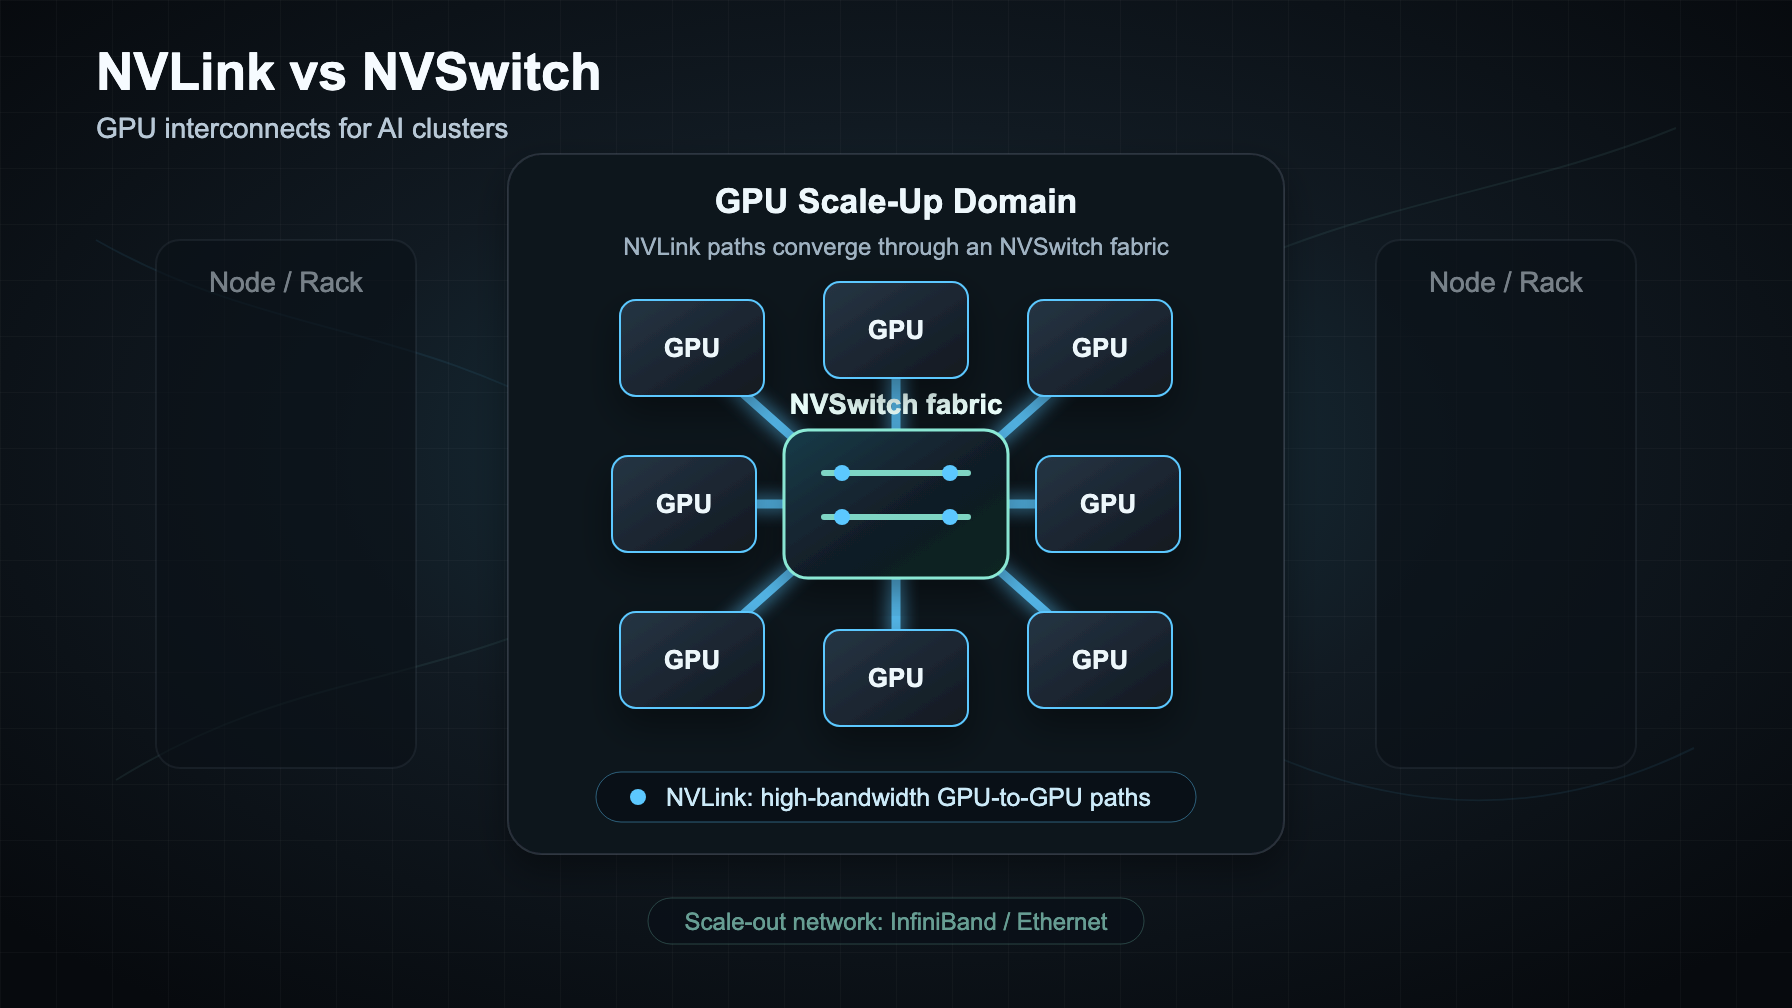
NVLink vs NVSwitch: AIクラスター向けGPUインターコネクトを解説
NVLinkはGPU同士をつなぐリンク、NVSwitchはそのファブリック、そしてInfiniBandやEthernetはスケールアウト用ネットワークです。AIクラスターでの選び方を解説します。
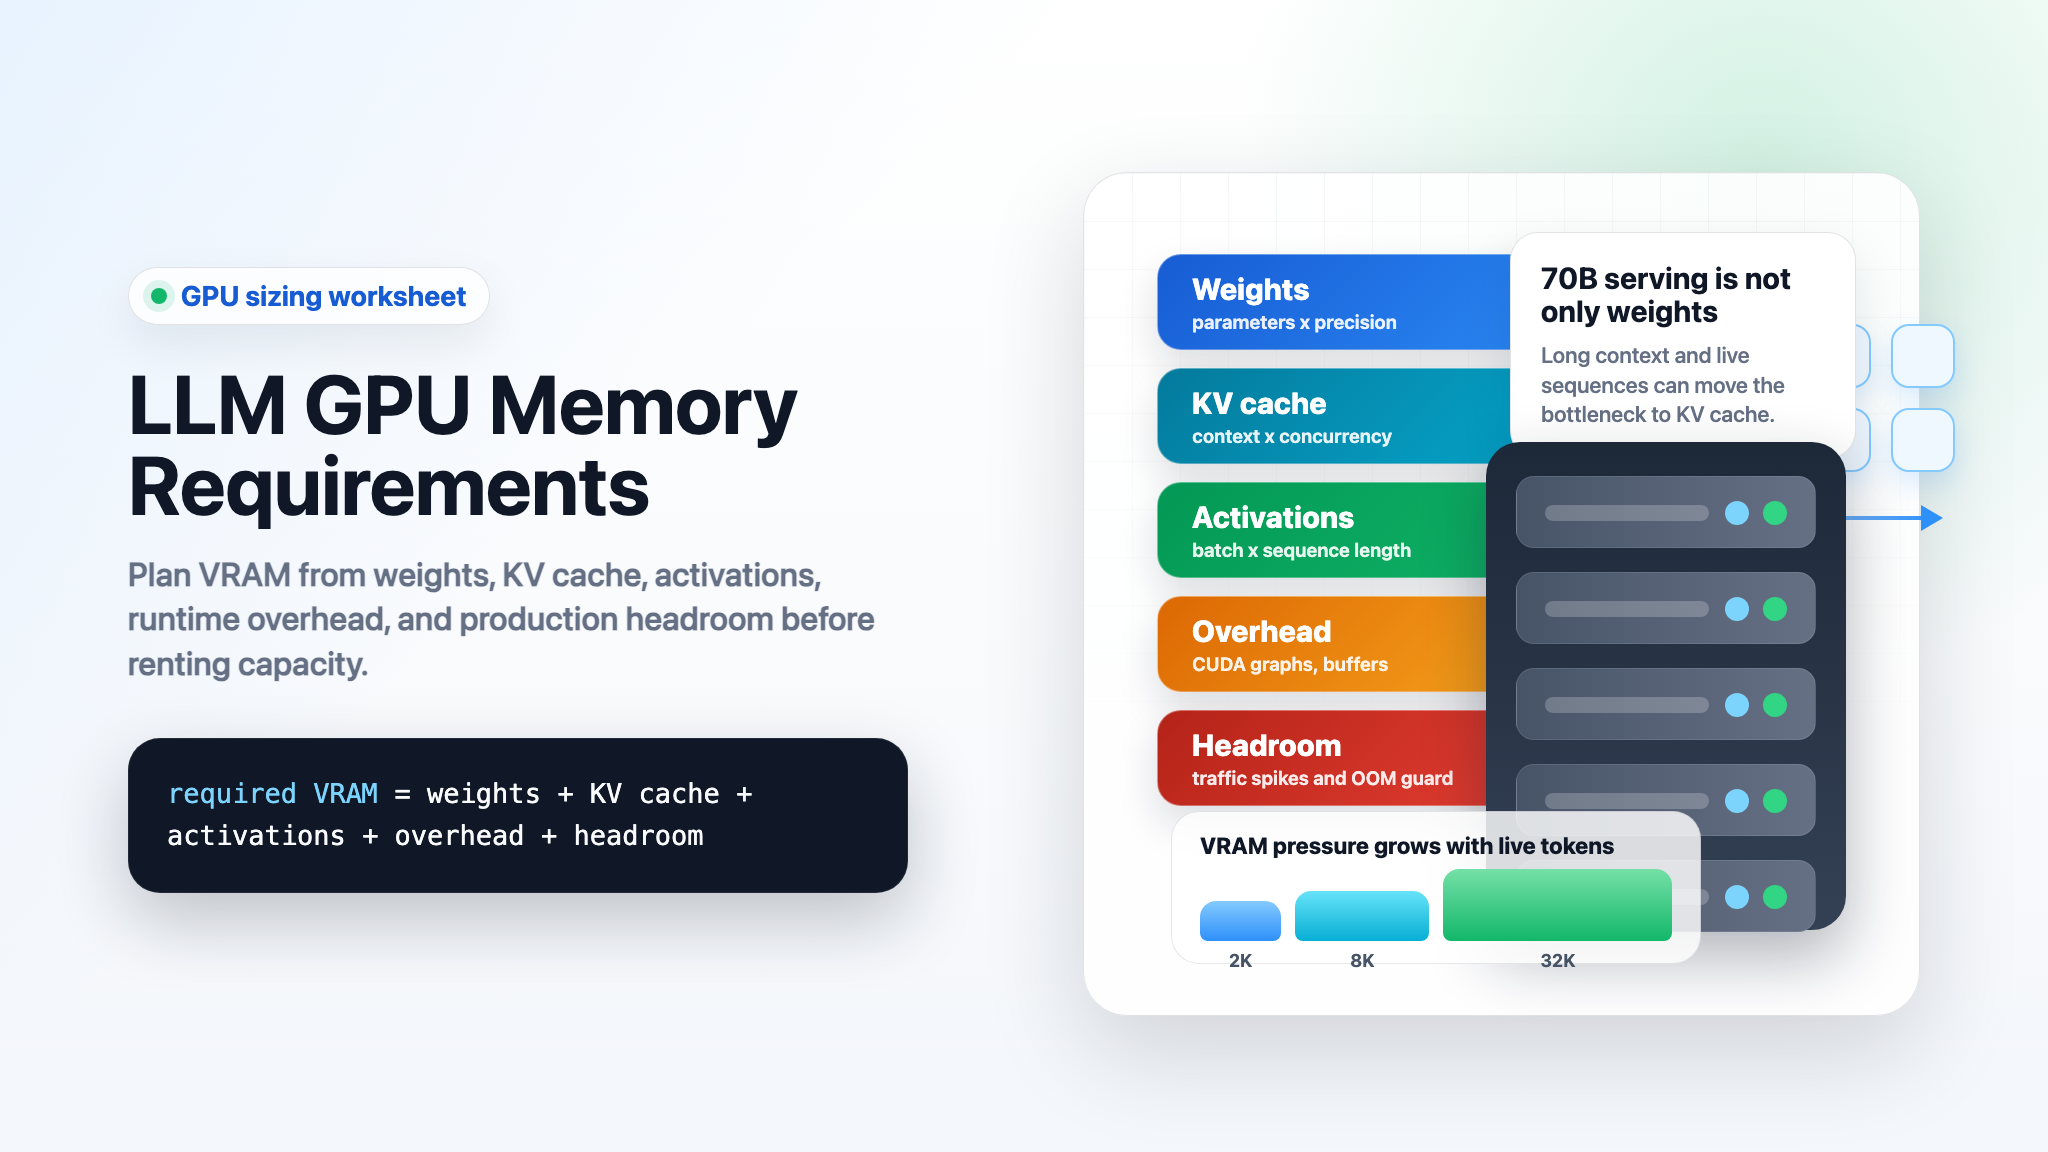
LLMのGPUメモリ要件:Weights、KV Cache、Activations、Overhead
weights、KV cache、activations、serving overhead、vLLM 70Bの計画、fine-tuning、trainingにわたってLLMのGPUメモリ要件を見積もるための実用的なワークシート。
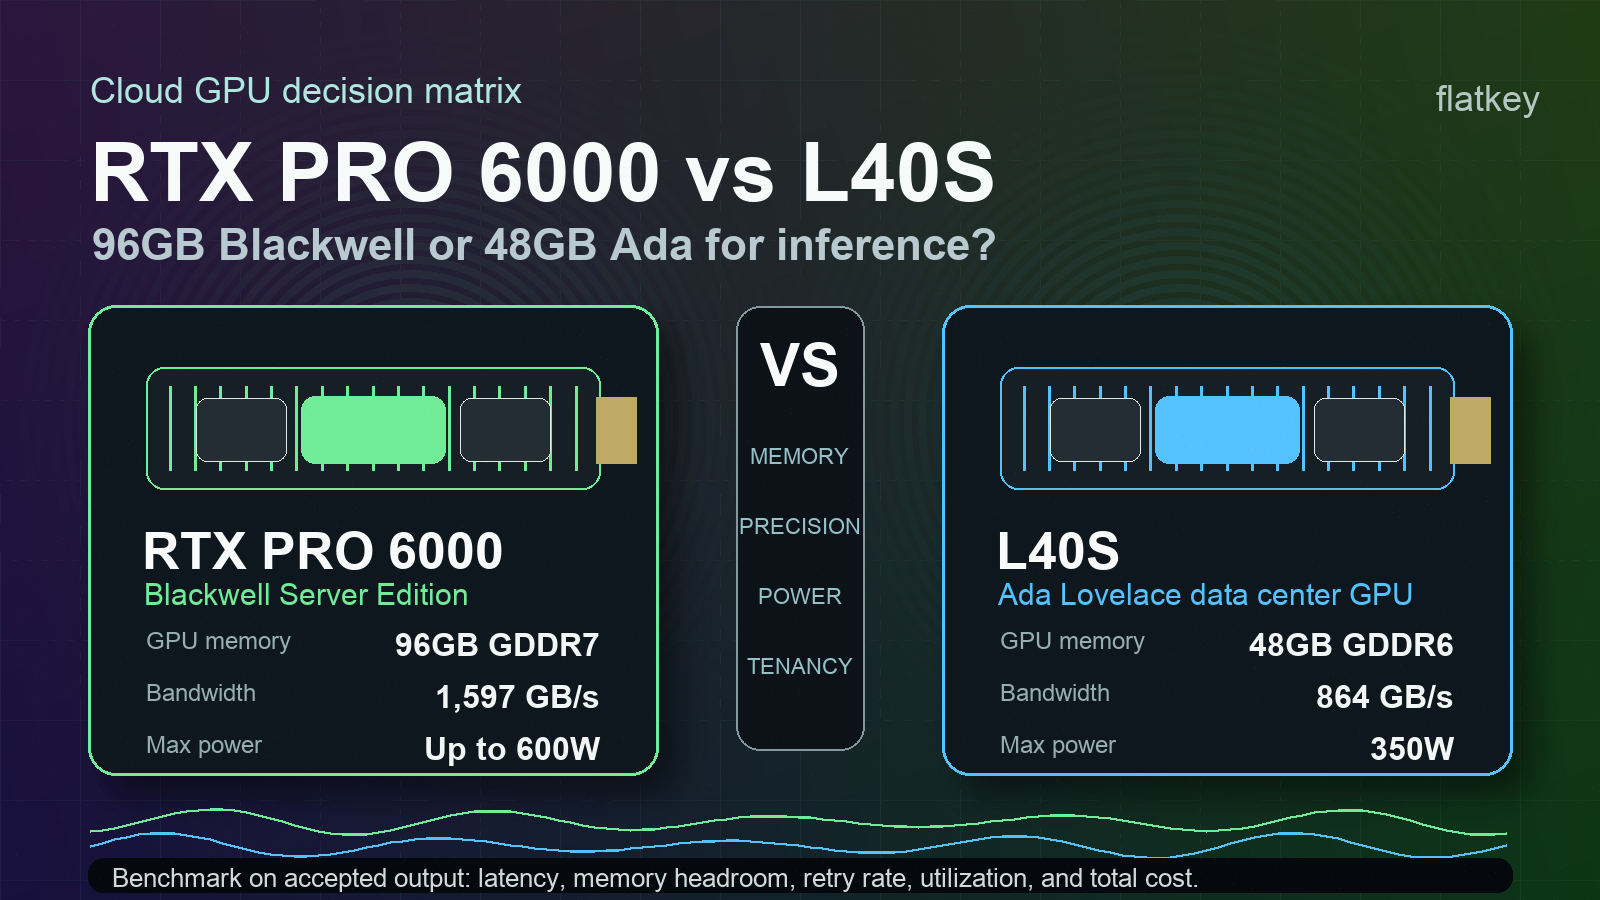
RTX PRO 6000 と L40S の比較: 96GB Blackwell か Ada の推論 GPU か?
LLM 推論、マルチモーダル ワークロード、メモリ適合性、消費電力、受け入れ出力コストの観点から、NVIDIA L40S と RTX PRO 6000 Blackwell Server Edition を比較します。
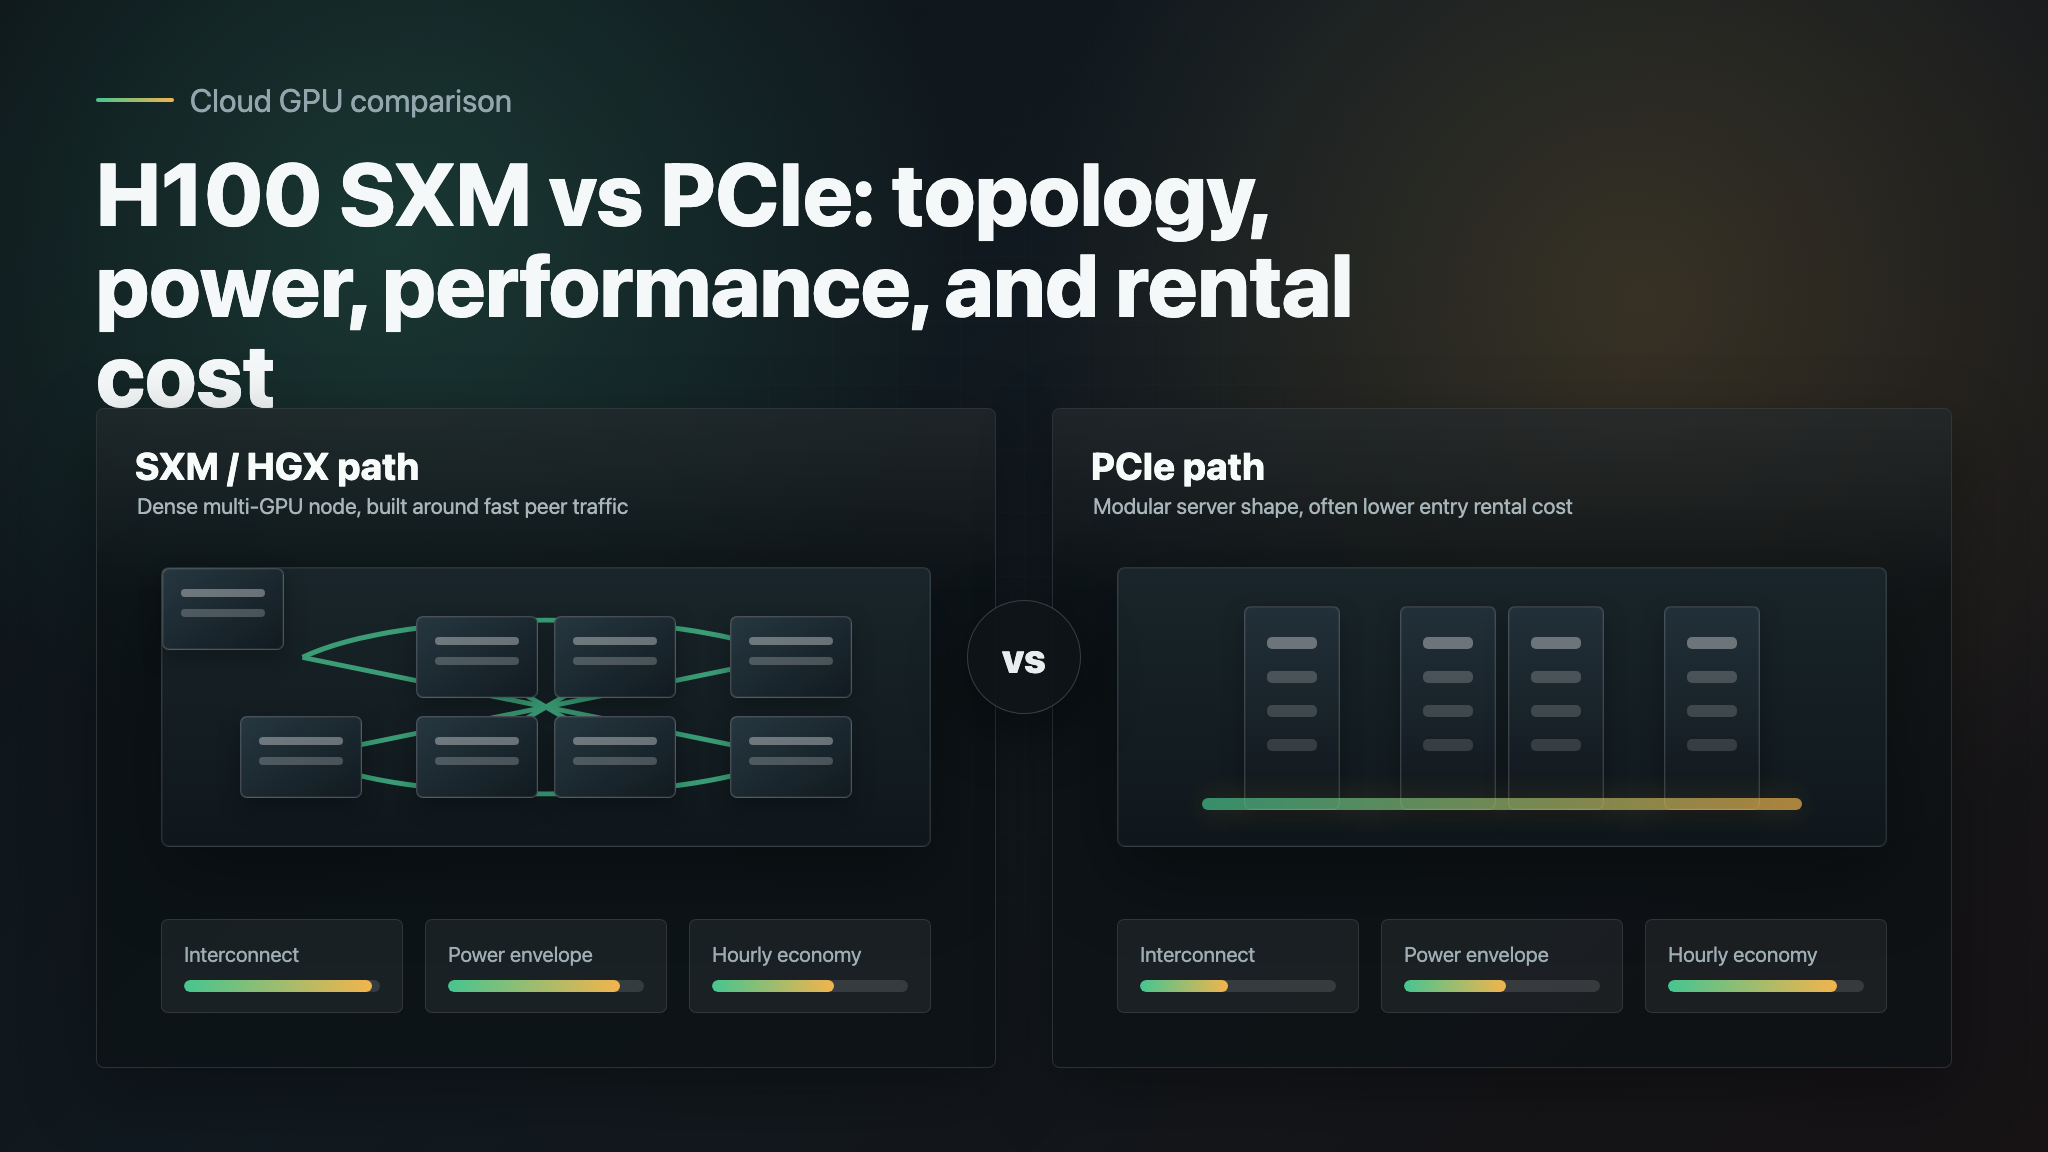
H100 SXM vs PCIe:NVLink、電力、性能、レンタルコスト
クラウドGPUをレンタルする前に、H100 PCIeとSXMをNVLink、消費電力、ワークロード性能、レンタルコストで比較しましょう。
1つの AI ゲートウェイで開発を加速。
flatkey.ai なら、モデル、キー、課金、可観測性を1つの API プラットフォームで管理できます。
始める