
コスト・課金・運用
コスト・課金・運用 の最新記事。
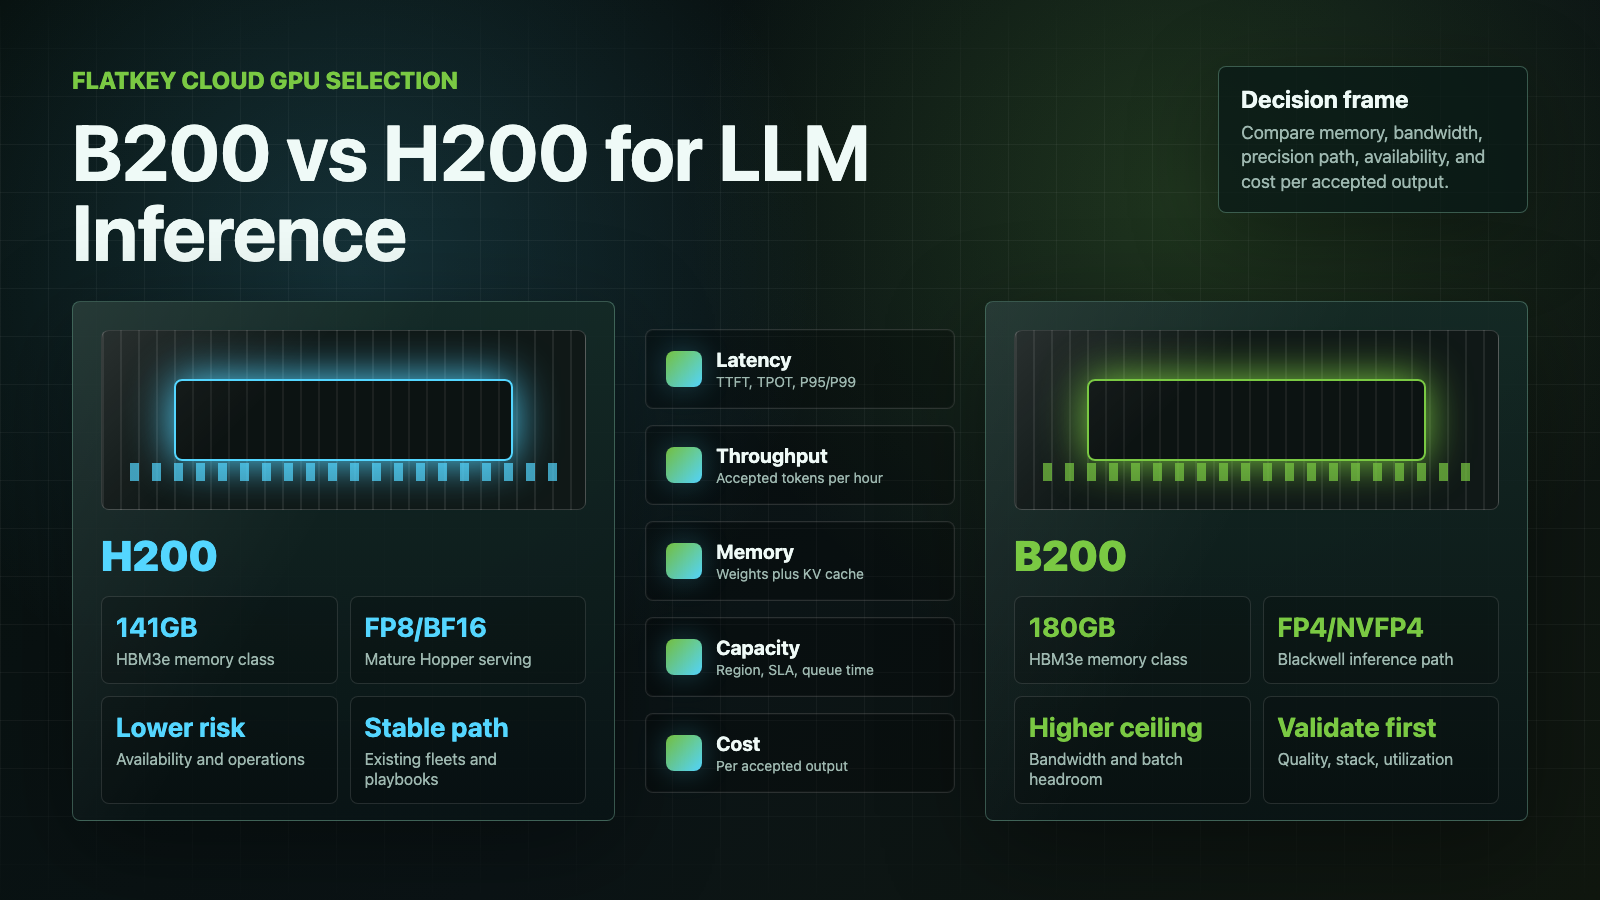
NVIDIA B200 vs H200:LLM推論に最適なのはどちらのGPUか?
NVIDIA B200とH200を、LLM推論向けにメモリ、帯域幅、精度サポート、DGXシステム、クラウドGPUの提供状況、受理済み出力あたりのコストで比較します。
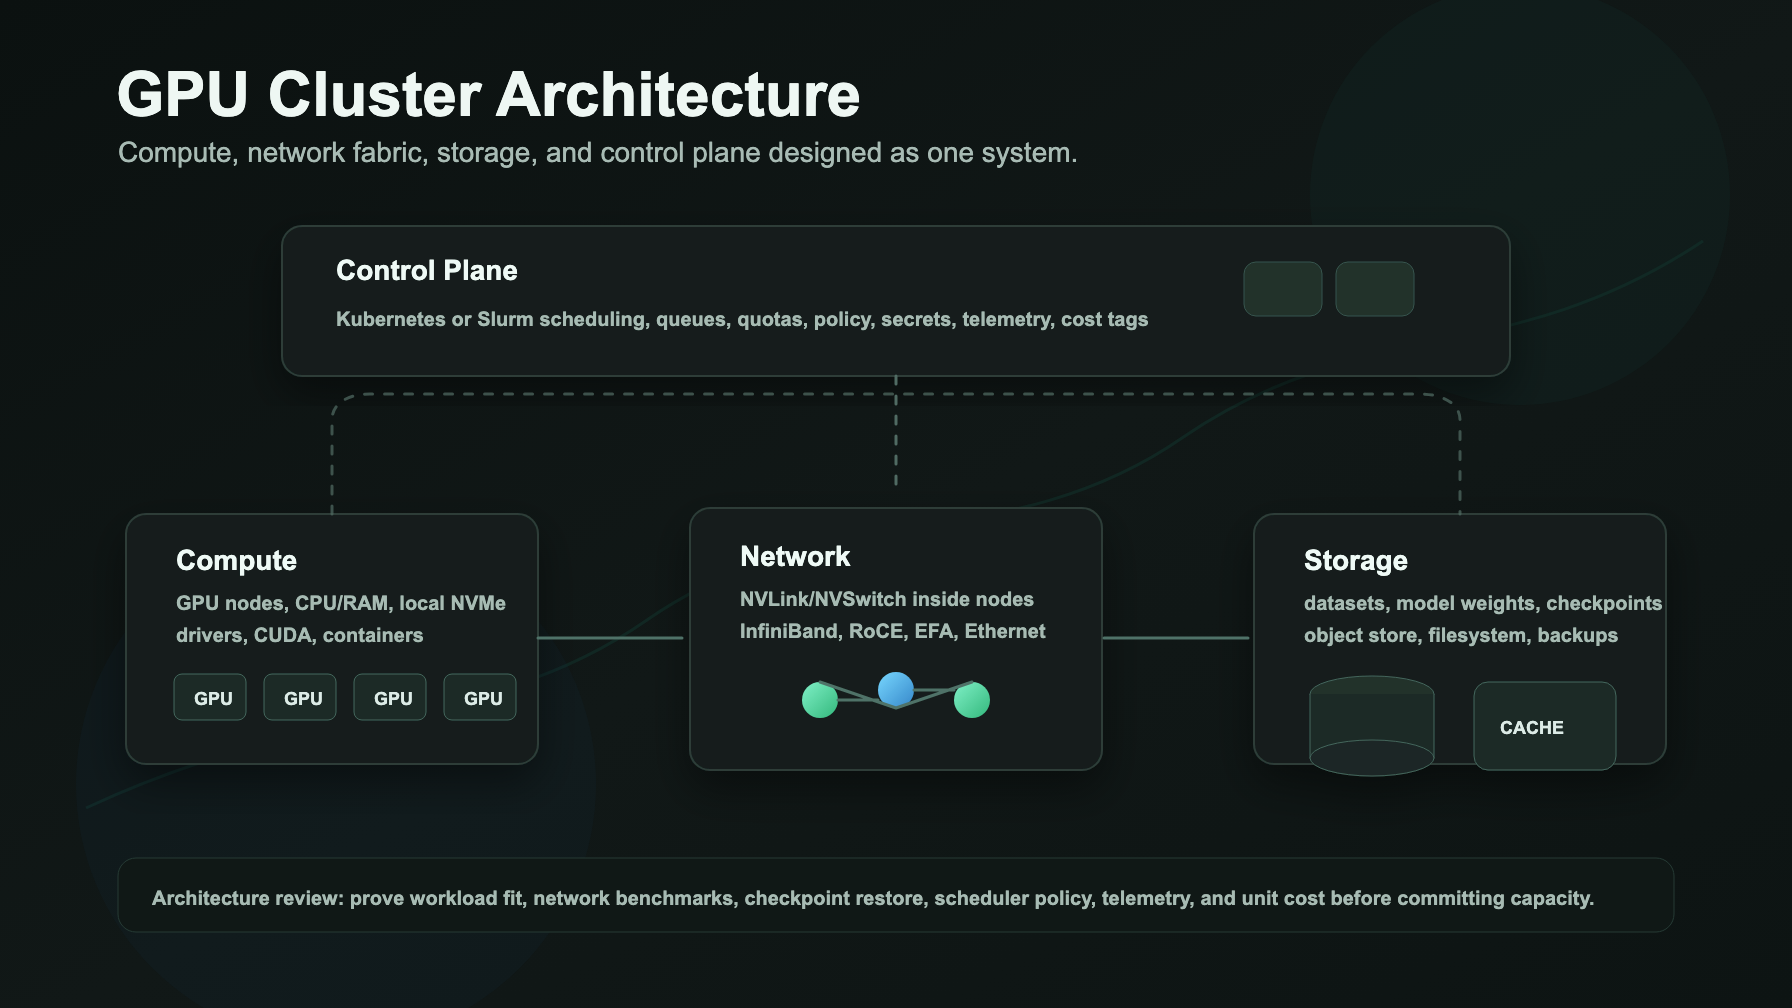
GPUクラスターアーキテクチャ: Compute、Network、Storage、Control Plane
computeノード、ネットワークファブリック、ストレージ、KubernetesまたはSlurmのControl Plane、可観測性、受け入れテストを含む、実践的なGPUクラスターアーキテクチャガイドです。
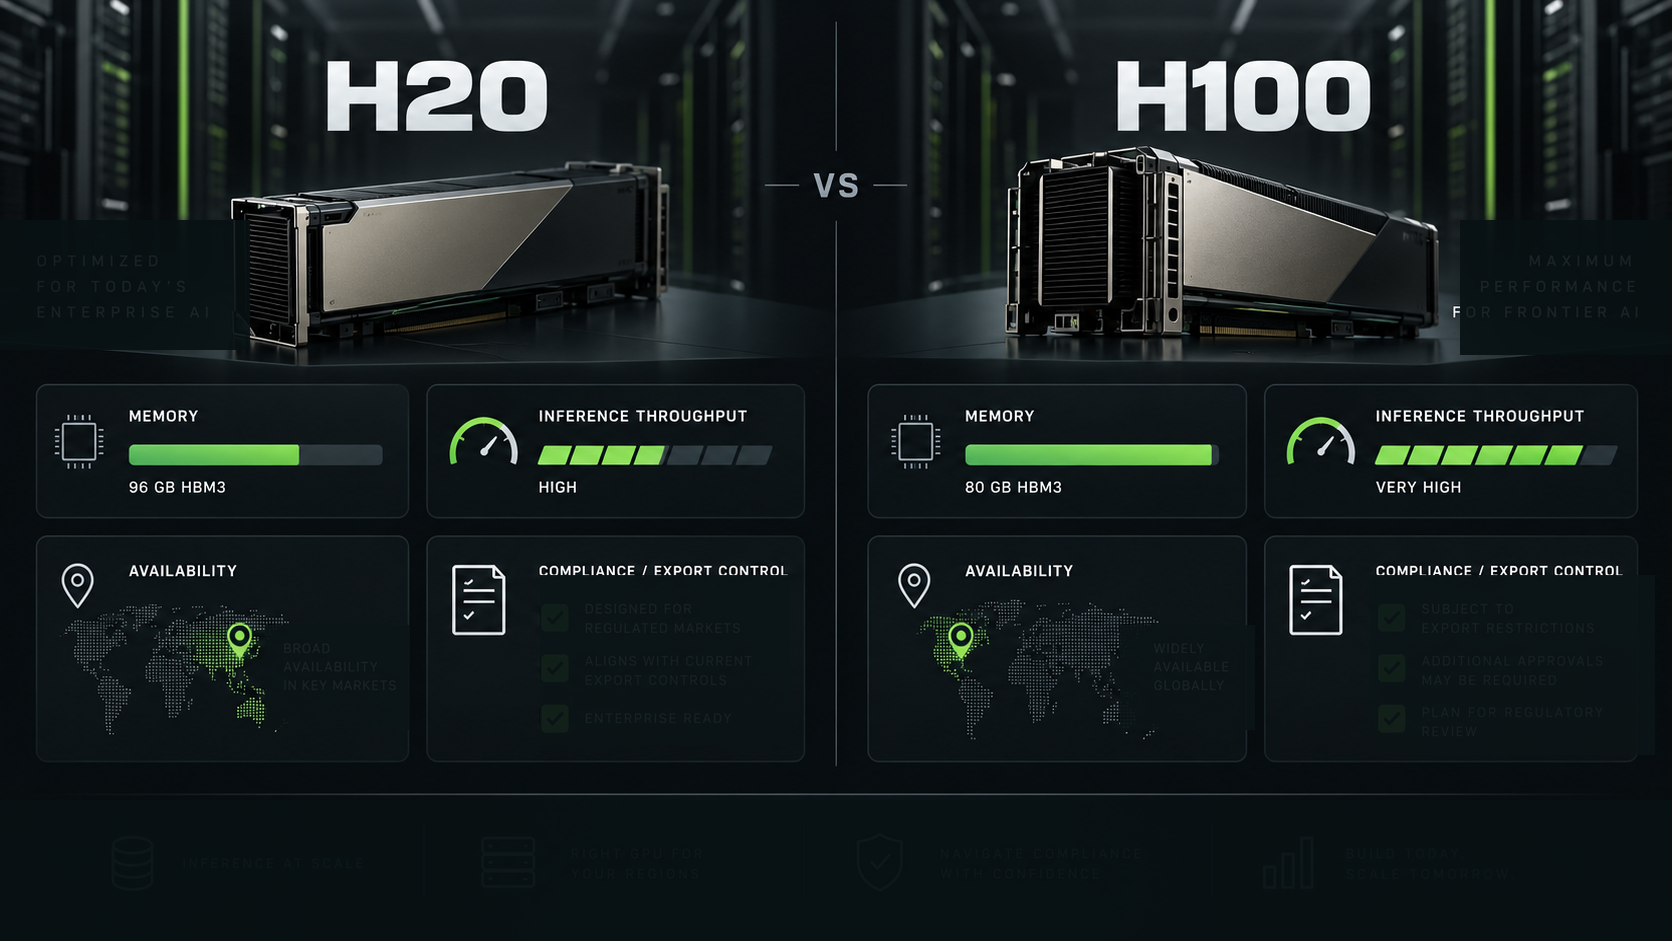
NVIDIA H20 vs H100: 推論、メモリ、入手性、コンプライアンス
エンタープライズAIチーム向けの実用的なH20とH100の比較。推論、メモリ、入手性、輸出規制リスク、そしてH200やモデルAPIをより良い基準にすべき場面を解説します。
2026年版 最高のクラウドGPUレンタルプラットフォーム:価格、容量、ネットワーク、サポート
AIチーム向けに、価格設定、提供容量、ネットワーク、サポート、そしてモデルAPIのほうが適している場面を比較した、2026年版の実用的なGPUクラウド・プラットフォームの厳選リスト。
NVIDIA Blackwell Ultra B300: B200から何が変わったのか?
B300のスペック、リリース状況、価格面の注意点、そしてB200とのワークロード適性を比較する、AIインフラチーム向けの実用的なNVIDIA B300 Blackwell Ultra追跡ガイドです。
AMD MI455XとHelios:アーキテクチャ、メモリ、提供状況トラッカー
AMD MI455XとHeliosの購入者向けトラッカー。アーキテクチャ、HBM4メモリ、帯域幅、提供状況、vLLM対応状況、プロバイダーへの確認事項、モデル/APIのフォールバック戦略をまとめています。
NVIDIA Vera Rubin GPU: GPU、NVL72、メモリ、ネットワーク、提供状況トラッカー
NVIDIA Vera Rubin GPUの仕様、DGX Vera Rubin NVL72、HBM4メモリ、ネットワーク、クラウドGPU購入者向けの提供マイルストーンを追跡する最新トラッカーです。
OpenAI Image APIの料金: GPT Image 2.5のレート、費用計算式、予算管理
OpenAI image APIの料金の仕組みを、GPT Image 2.5のトークン単価、キャッシュ済み入力のルール、部分画像、Batch、承認済み画像1枚あたりのコストまで含めて解説します。
GB200 vs B200: Grace Blackwell Superchip か x86 HGX か?
AIインフラ調達向けに GB200 と B200 を比較。Grace Blackwell のラックスケール NVL72 システム、B200 HGX/x86 ノード、ベンチマーク、TCO を確認します。
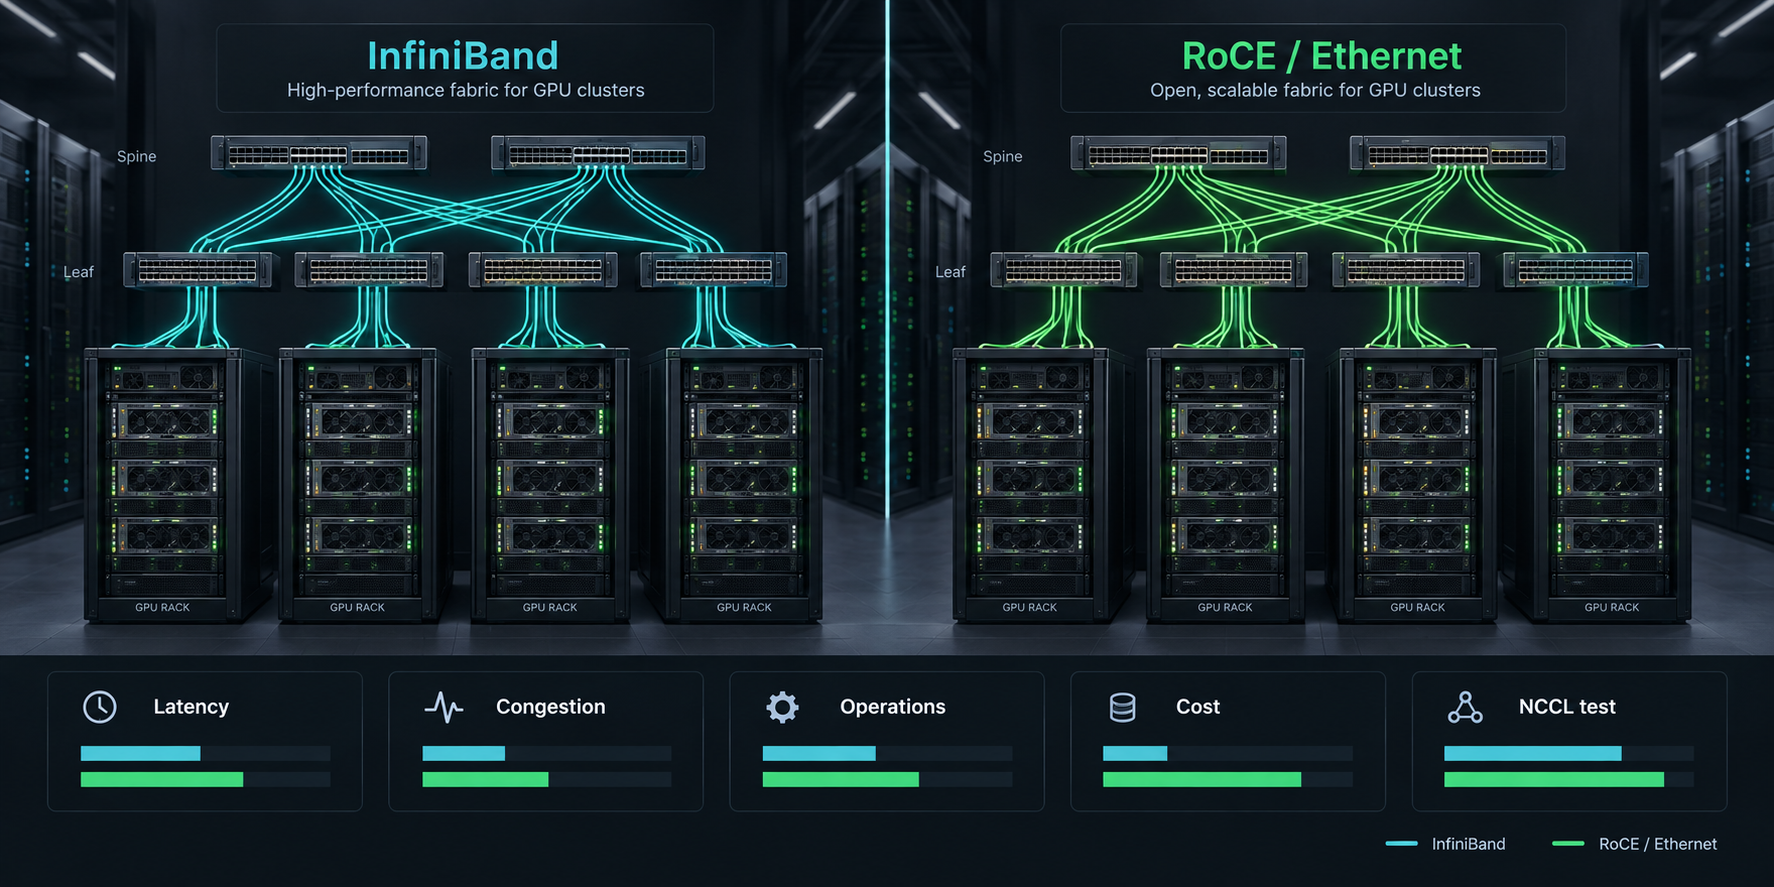
GPUクラスター向けのRoCEとInfiniBand:レイテンシ、運用、コスト
実用的な判断マトリクス、NCCL受け入れテスト、コストモデル、調達チェックリストを用いて、マルチノードGPUクラスター向けにRoCEとInfiniBandを比較します。
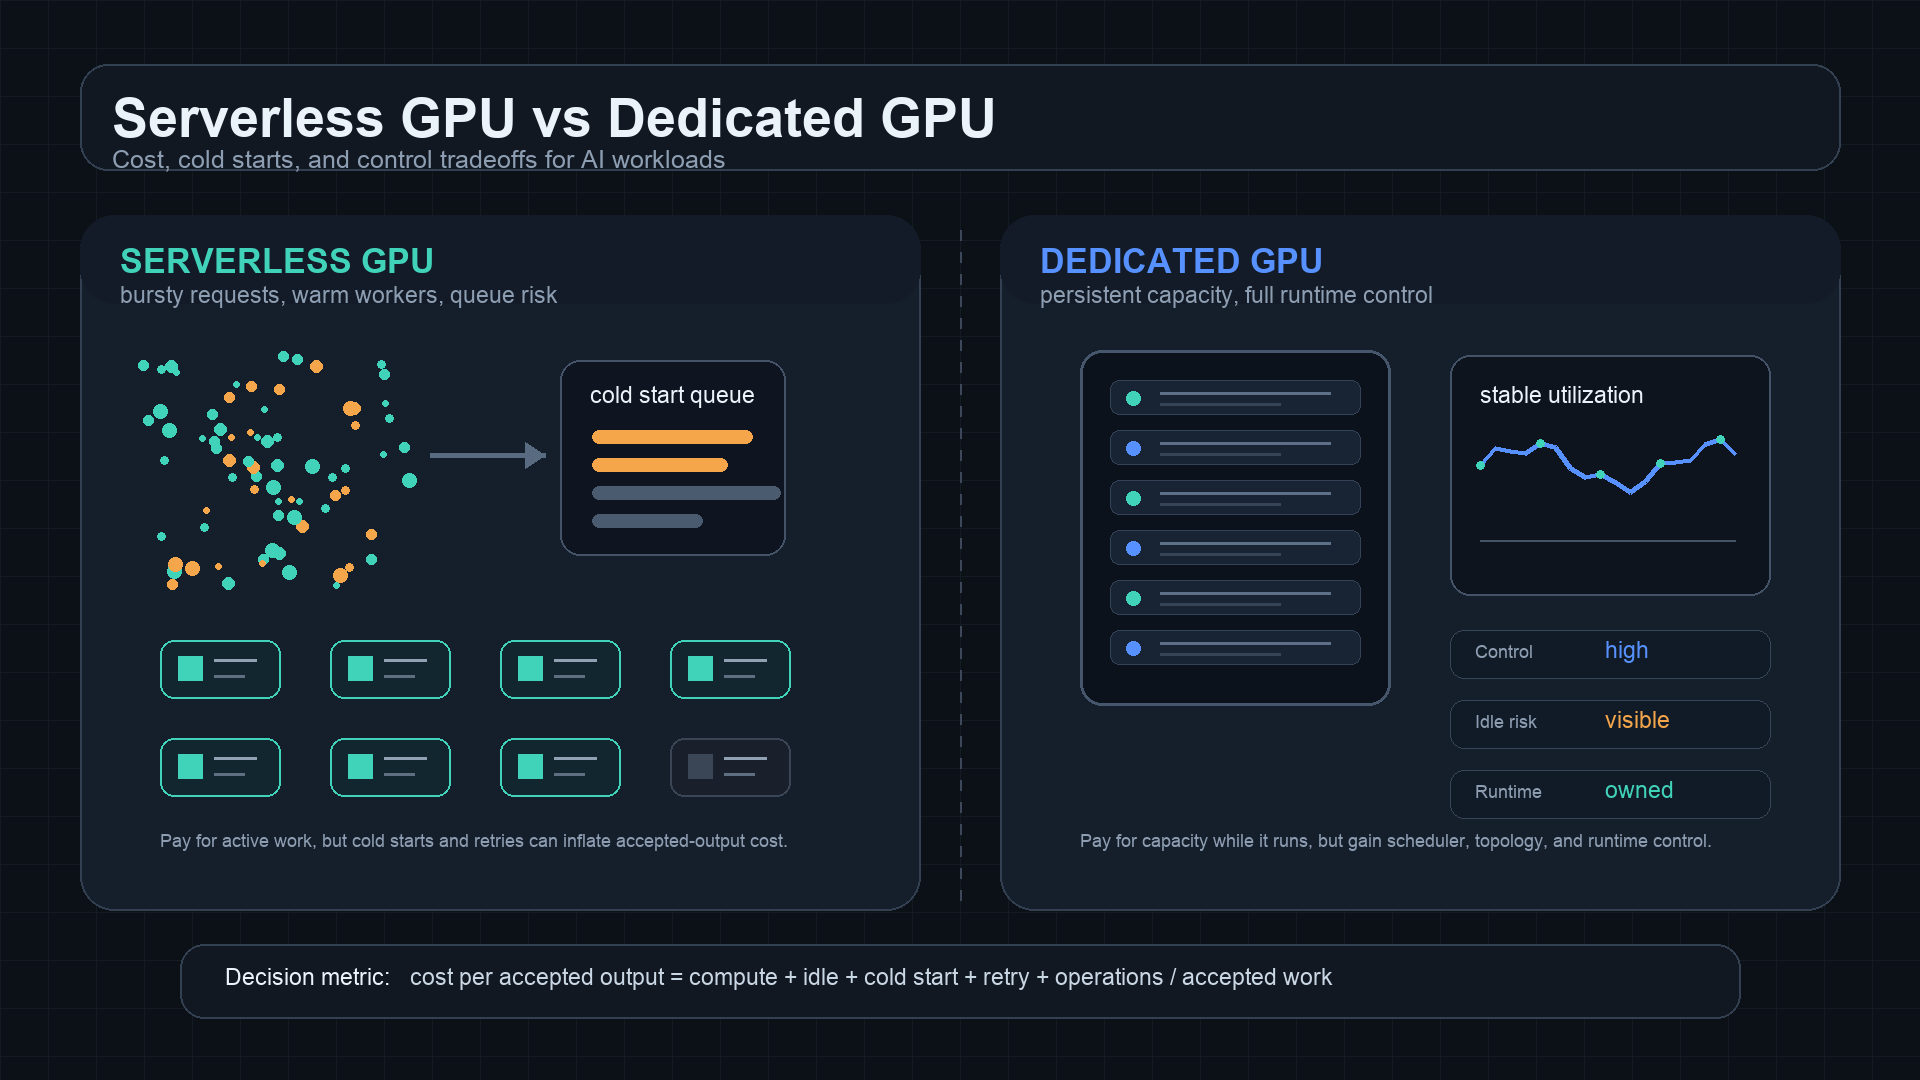
サーバーレスGPU vs 専用GPU: コスト、コールドスタート、制御
サーバーレスGPUと専用GPUを、受理された出力あたりのコスト、コールドスタート、アイドル容量、オートスケーリング、運用制御の観点で比較します。

AI画像生成APIの料金比較: GPT Image、Gemini、Imagen、fal
GPT Image、Gemini Image、Imagen、fal の各ルートの画像生成API料金を、承認済み画像1枚あたりのコストに正規化して比較します。
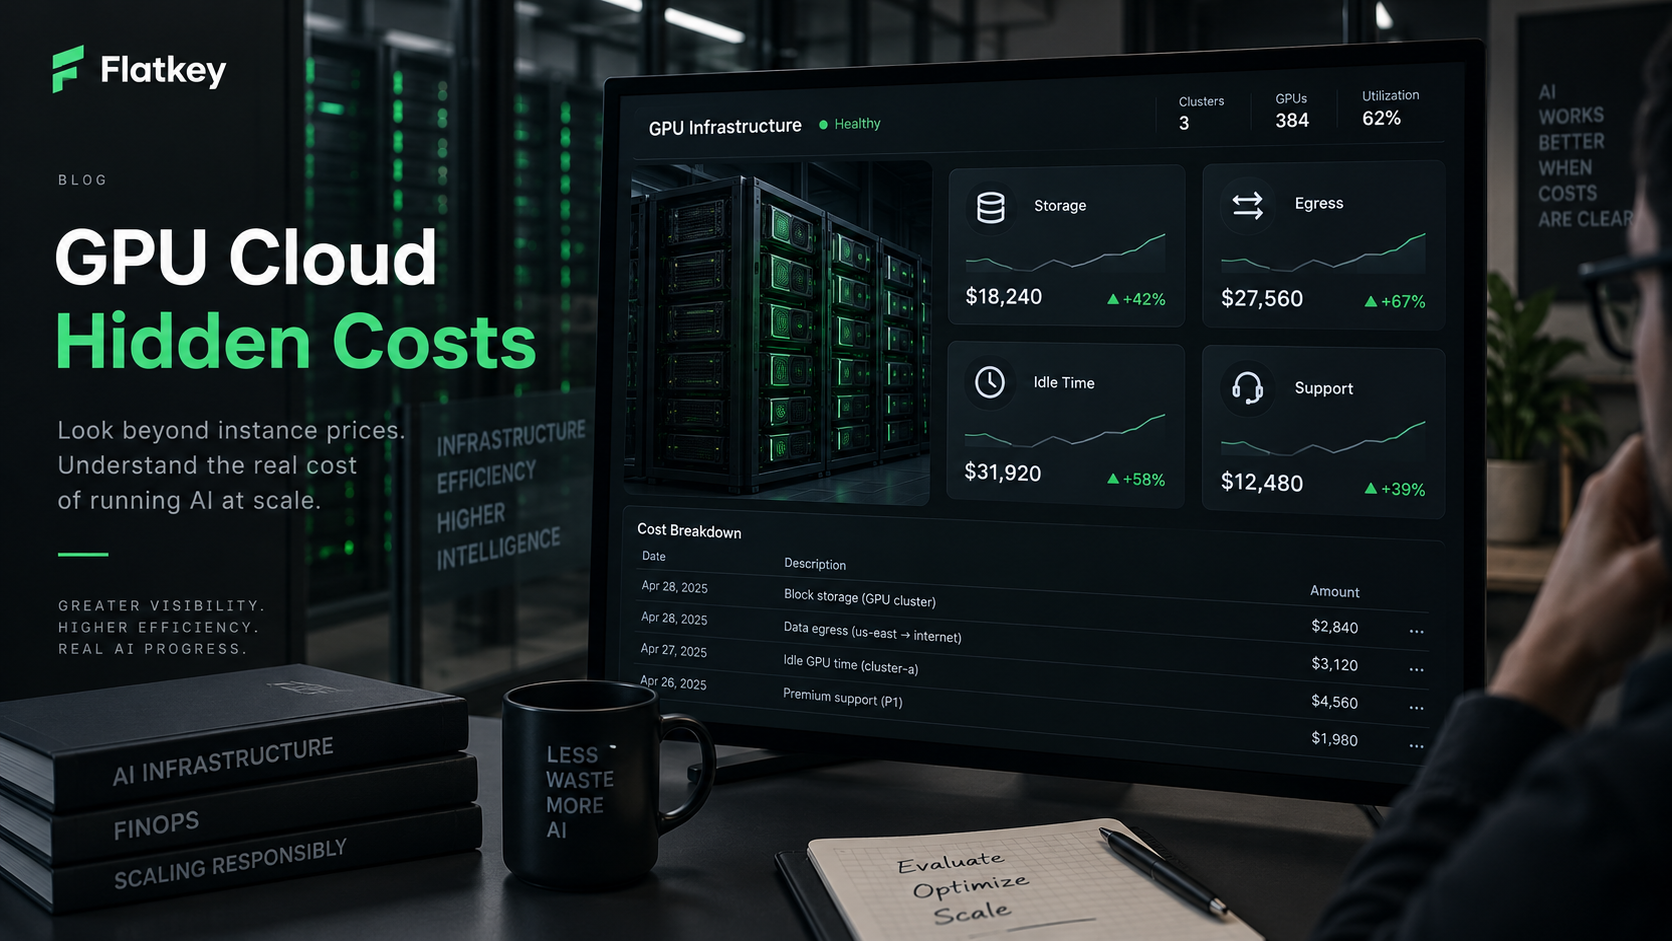
クラウドGPUサービスの隠れたコストとは? ストレージ、エグレス、アイドル時間、サポート
請求書が届く前に、ストレージ、エグレス、アイドル時間、ジョブ失敗、サポート、ネットワーク、運用のコストを見極めるための実践的なクラウドGPU TCOガイドです。
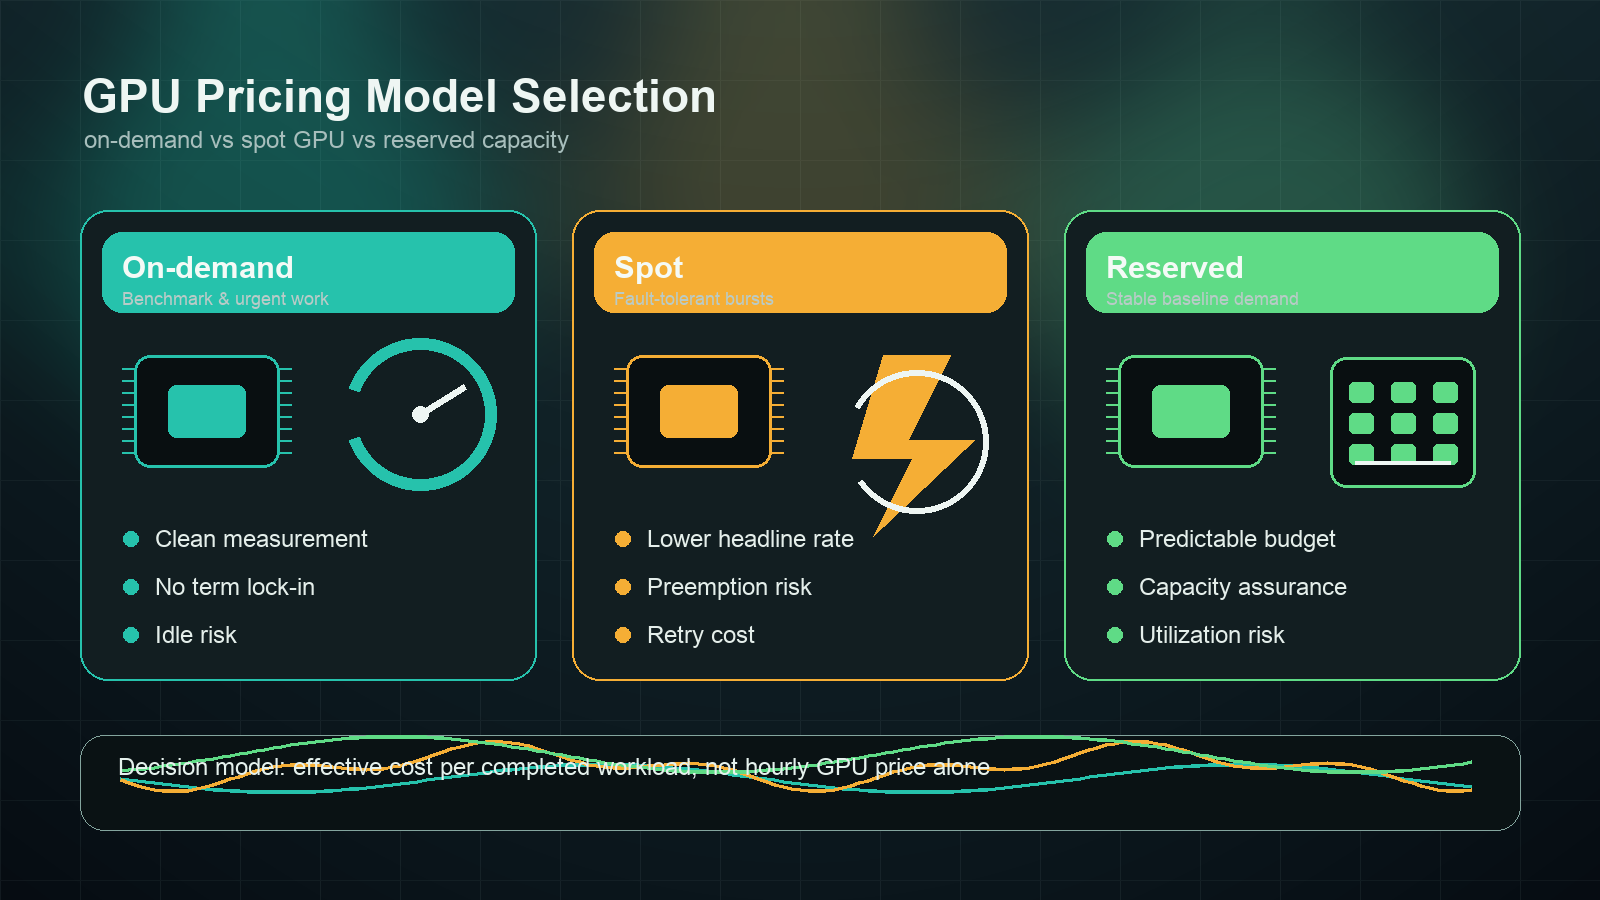
オンデマンド vs スポット vs 予約 GPU 料金: どのモデルがワークロードに適しているか?
ワークロード起点のフレームワークで、表示の時間単価と完了したワークロードのコストを混同せずに、オンデマンド、スポット、予約 GPU 容量を選ぶ方法を解説します。
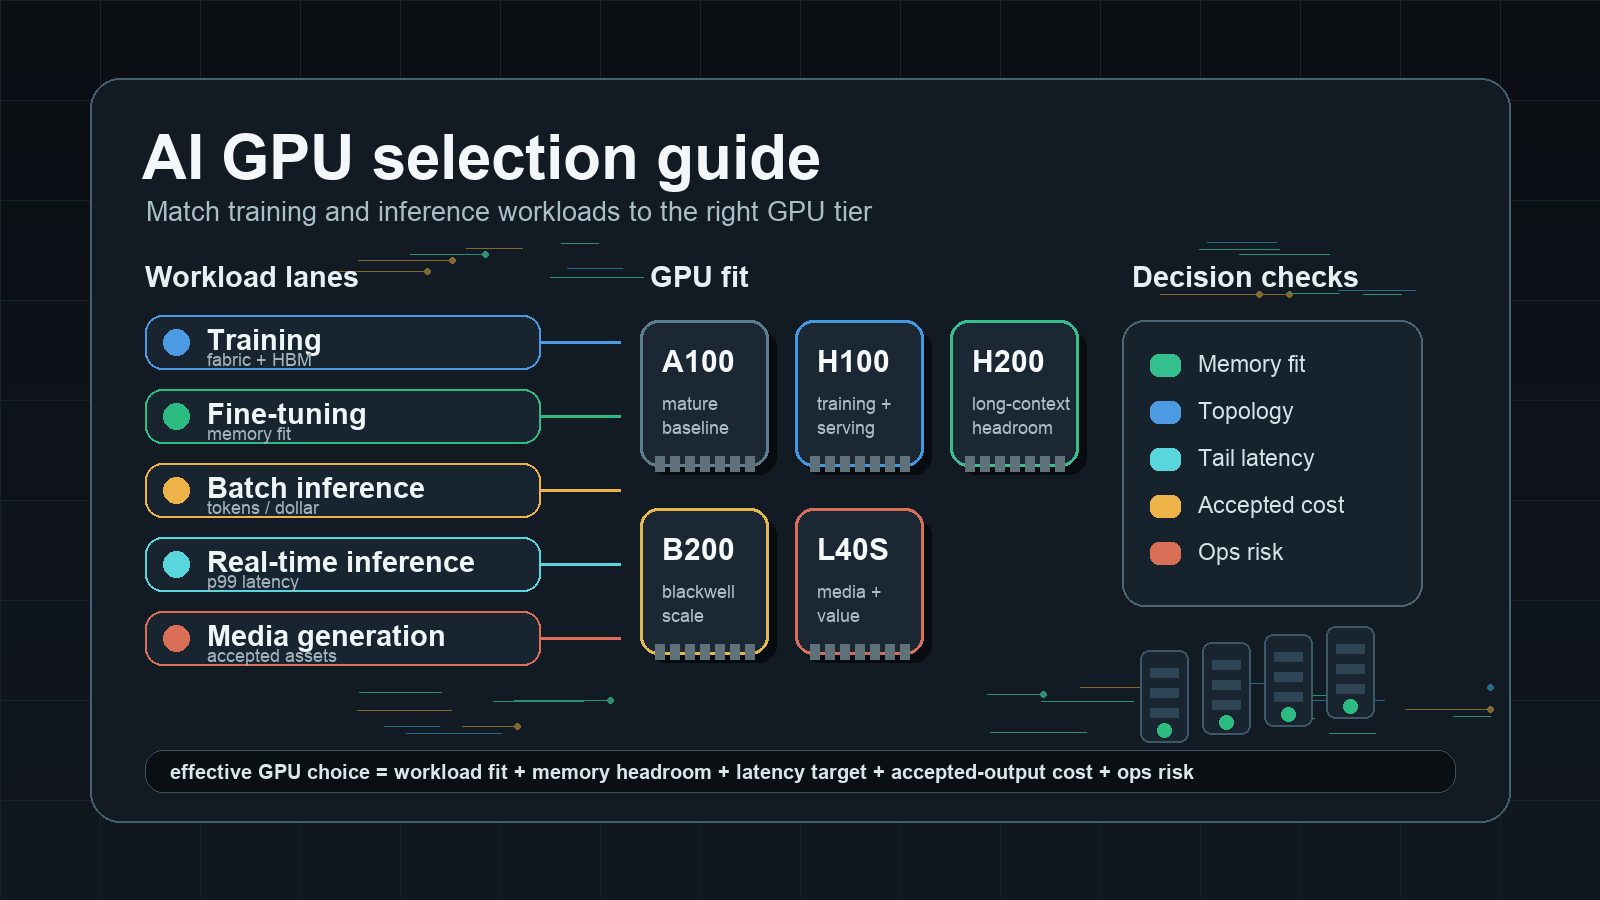
AI GPU選定ガイド: 学習と推論のワークロードに最適なGPUを選ぶ
学習、ファインチューニング、LLM推論、メディア生成、評価などのワークロードを、適切なGPUとキャパシティモデルに割り当てるための実践的なAI GPU選定ガイドです。
プライベート GPU クラウド: アーキテクチャ、分離、運用モデル
プライベート GPU クラウドのアーキテクチャ、分離、スケジューラの所有権、セキュリティ証跡、運用モデル、TCO、受け入れテストの評価方法を学びましょう。

vLLM デプロイメントガイド: GPU上でOpenAI互換LLM APIを提供する
Docker、RunPod Serverless、Ray Serve、メトリクス、ロールアウト制御、承認済み出力あたりのコスト確認を使って、vLLMをGPU上でOpenAI互換APIとしてデプロイします。
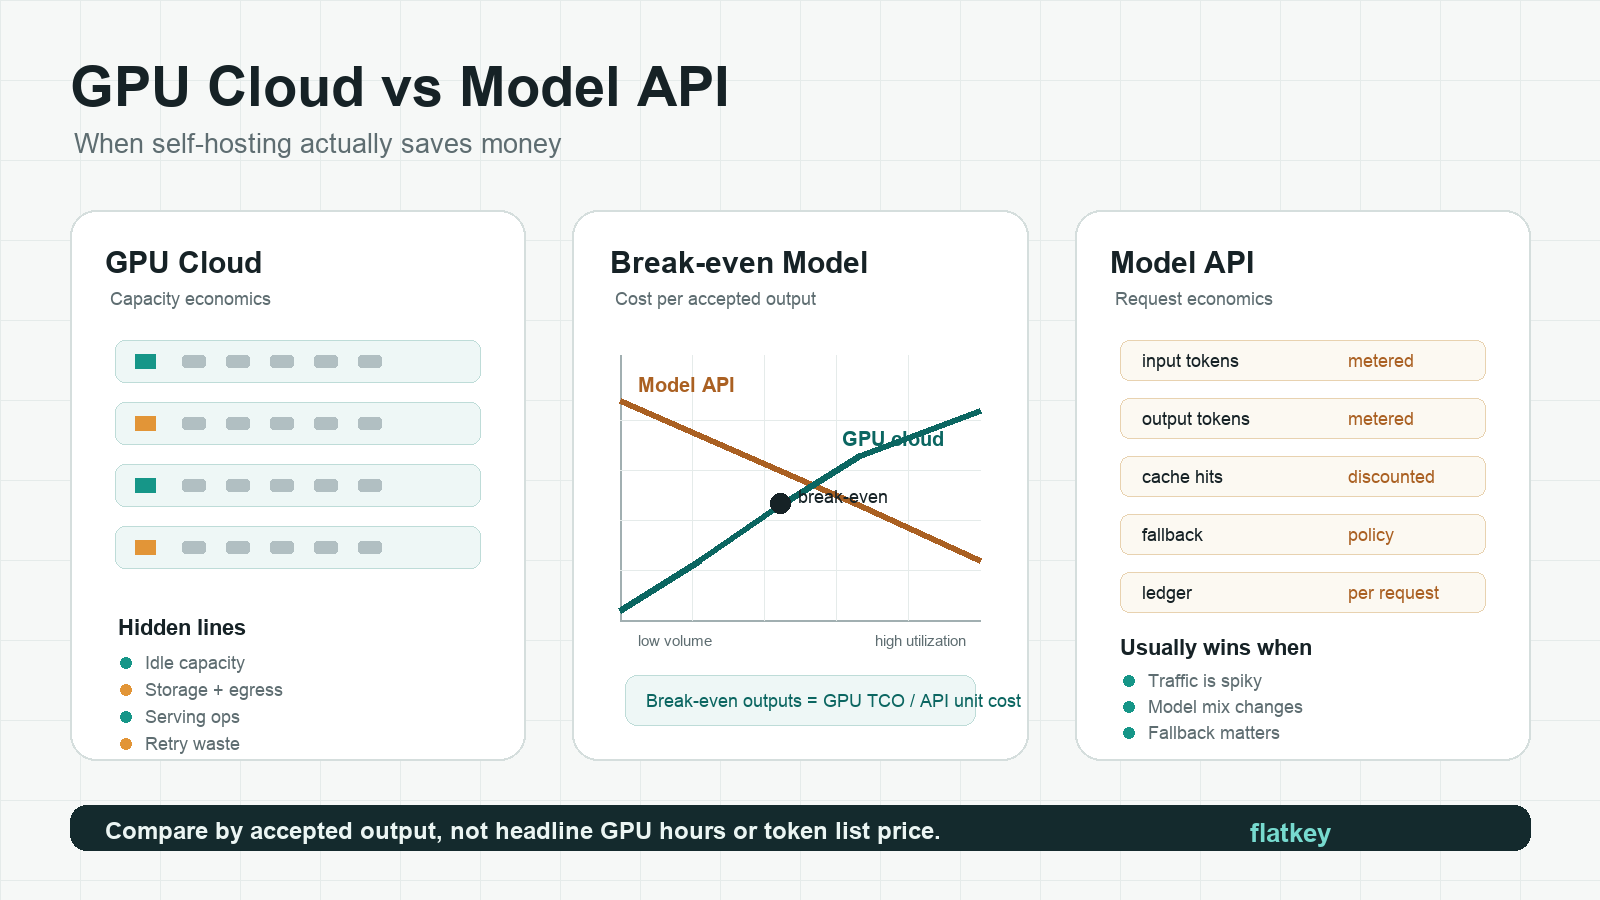
GPUクラウド vs モデルAPI: 自前ホスティングが本当にコストを下げるのはいつか
GPUクラウドとモデルAPIの経済性を比較し、承認済み出力コスト、稼働率、再試行、アイドル容量、サービング運用を含む損益分岐点ワークシートを紹介します。
1つの AI ゲートウェイで開発を加速。
flatkey.ai なら、モデル、キー、課金、可観測性を1つの API プラットフォームで管理できます。
始める