
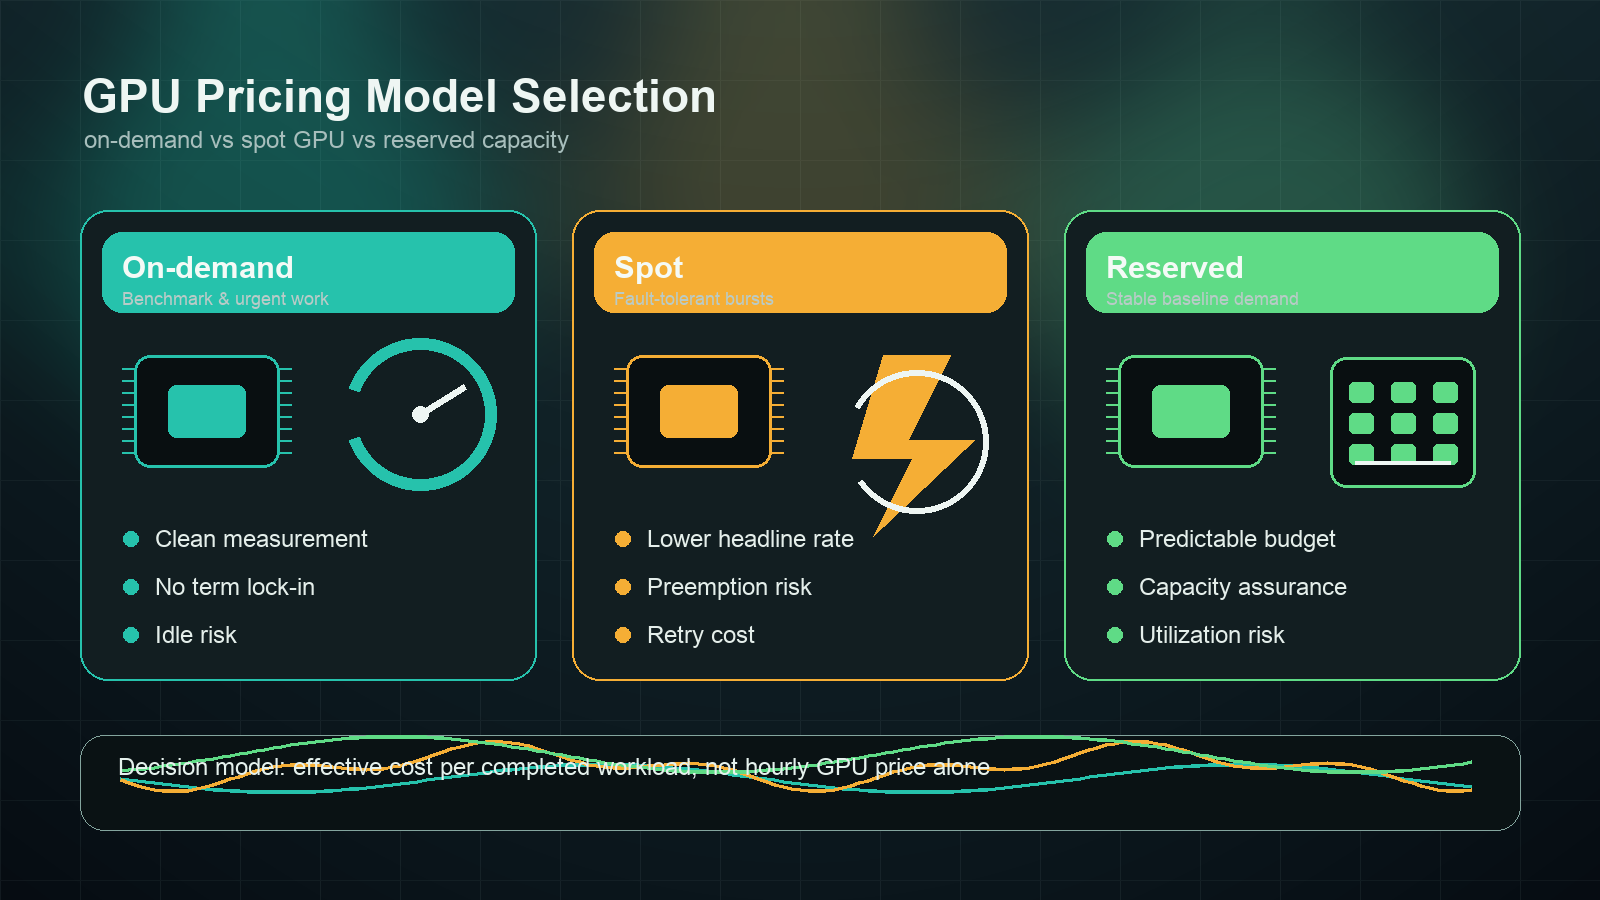
オンデマンドとスポットの GPU 容量のどちらを選ぶかは、単なる料金表の比較ではありません。安い時間単価でも、ジョブが再起動する、チェックポイントが不十分、データの再読み込みが必要、あるいはインタラクティブに停止されるマシンを維持するためにエンジニアが何日も費やすなら、結果的に損をすることがあります。予約済み GPU 容量も、モデル需要が変化してチームが未使用ハードウェアに縛られるまで、安く見えることがあります。
このガイドでは、AI インフラの購入担当者、FinOps チーム、実務的なワークロード判断モデルを必要とするプラットフォームエンジニア向けに、オンデマンド、スポット、予約済みの GPU 料金を比較します。短い答えは次のとおりです。初期測定や緊急対応には オンデマンド GPU、障害耐性のあるバッチワークロードには スポット GPU、そしてベースライン利用率を証明できるようになってからのみ 予約済み GPU 容量 を使ってください。
そもそも GPU をレンタルすべきかまだ判断しているなら、まずはより広い視点の GPU レンタル料金 と GPU クラウド vs モデル API のガイドをご覧ください。この記事は、GPU 容量を計画に含めることはすでに分かっている前提で、その後の料金モデル選択に焦点を当てています。
簡単な答え: オンデマンド vs スポット GPU vs 予約済み
多くのチームでは、最初の検討は次のようになります:
| 料金モデル | 最適な用途 | 主なリスク | 確認すべき指標 |
|---|---|---|---|
| オンデマンド GPU | ベンチマーク、緊急の実験、デモ、初期本番、利用率が不明な場合 | 待機時間と高めの時間単価 | 有効な GPU 稼働分 / 課金対象分 |
| スポット GPU | バッチ推論、オフライン評価、チェックポイント付き学習、メディアキュー、再試行可能なワーカー | 回収、キュー遅延、再起動の無駄、重複作業 | 中断コスト後に完了したジョブ数 |
| 予約済み GPU | 安定した本番推論、スケジュールされた学習、ローンチ期間、専用クラスタ | 過少利用、ハードウェアの固定化、契約ミスマッチ | ベースライン利用率とコミットメントの損益分岐点 |
オンデマンド vs スポット GPU の判断における持続的なルールはシンプルです。表示上の GPU 1 時間単価ではなく、完了したワークロード 1 件あたりの実効コスト を比較してください。
1 完了ワークロードあたりの実効コスト =
  (計算 + ストレージ + 帯域 + 待機時間 + 再起動の無駄 + サポート + エンジニアリングオーバーヘッド)
  / 受理されたジョブ数、学習トークン、推論トークン、画像、クリップ、またはベンチマーク実行数
この式が重要なのは、各モデルがリスクを別の場所へ移すからです。オンデマンドはリスクを待機時間に置きます。スポットは中断とオーケストレーションに置きます。予約済み容量は予測精度に置きます。
オンデマンド GPU 料金の意味
オンデマンド GPU 料金は、最も分かりやすい基準です。インスタンス、ポッド、またはサーバーが稼働している間だけ支払い、長期契約はありません。AWS は On-Demand Instances を、長期的なコミットメントのない従量課金の容量として説明しています。専業 GPU クラウドも、課金単位や含まれるストレージが異なる場合でも、ポッド、インスタンス、または時間課金の GPU サーバーについて同様の表現を使います。
ワークロードがまだ不明なときは、まずオンデマンドを使ってください:
| ユースケース | オンデマンドが適している理由 |
|---|---|
| モデルまたはサービングスタックの最初のベンチマーク | 中断要因なしの純粋な計測が必要だからです。 |
| ドライバー、CUDA、コンテナ、またはフレームワークの検証 | デバッグをスポット回収リスクと混同すべきではないからです。 |
| 顧客デモまたは QA 環境 | 最安値よりも予測可能性のほうが重要だからです。 |
| 初期本番エンドポイント | 安定した利用データが得られる前に可用性が必要だからです。 |
| 短時間の緊急学習またはファインチューニング実行 | キュー遅延が時間単価の節約より高くつくことがあるからです。 |
落とし穴は待機時間です。ノートブック、ポッド、または推論サーバーが 100 課金時間稼働していても、GPU が有効に使われたのが 28 時間だけなら、実際のコストはプロバイダーの表示時間単価ではありません。実効レートはアイドルの無駄で押し上げられます。
オンデマンドの実効時間単価 =
  表示上のオンデマンド時間単価 / 有効利用率
利用率が 35% なら、$4/hour の GPU は、ストレージ、帯域、またはエンジニアリングオーバーヘッドを除く前でも、$11.43/useful-hour のリソースのように振る舞います。オンデマンド vs スポット GPU の判断では、より良い時間単価を交渉する前に、アイドル時の停止とキューの詰め込みを修正してください。
スポット GPU 料金の意味
スポット GPU 料金は、余剰または中断可能な容量を使います。AWS は EC2 Spot Instances について、余剰の EC2 容量を使用し、On-Demand 価格と比べて最大 90% の割引を提供できると説明しています。Google Cloud Spot VMs や Azure Spot Virtual Machines も同様の大枠に従っています。つまり、クラウドが必要とする際に回収・停止される可能性がある代わりに、より低価格な容量です。
スポット GPU は AI ワークロードに魅力的です。学習、評価、画像生成、バッチ推論には、再試行可能な大きな塊があることが多いからです。しかし、「再試行可能」であることは自動ではありません。チェックポイント、冪等なジョブ、データ局所性、監視、そして結果を壊さずに再起動できるスケジューラが必要です。
スポットは通常、次のような場合に有力です:
- 学習ジョブが頻繁にチェックポイントを保存し、きれいに再開できる。
- バッチ推論がユーザーに見える失敗なしに再試行できる。
- オフライン評価を多数のワーカーに分散して実行できる。
- メディア生成ジョブがキューの背後にある。
- 1 つのワーカー障害でマルチノード全体のジョブが無効にならない。
- チームにすでに回収対応と重複防止のオーケストレーションがある。
スポットは通常、次のような場合には弱い候補です:
- 1回の複数日トレーニング実行が、古いチェックポイントから再開される。
- 起動時間の大半が、モデル、イメージ、またはデータセットの取得に費やされる。
- 顧客向けのレイテンシーが、マシンが稼働し続けることに依存している。
- 1人のワーカーが消えると、マルチノードトレーニングが失敗する。
- エンジニアが再起動を手動で付きっきりで監視しなければならない。
スポット GPU インスタンスとオンデマンド GPU インスタンスの長所と短所を比較する際は、計算に中断による無駄も含めるべきです:
スポットの実効時間単価 =
  スポットの時間単価 / (1 - 中断による無駄の割合)
スポットが 60% 安くても、中断、データの再読み込み、失敗したステップ、キュー待ちによる無駄が経過作業の 35% を占めるなら、実際の割引率は表示価格よりかなり小さくなります。再起動の無駄が割引率と同じ程度に達するなら、オンデマンド容量のほうが多くの場合シンプルです。
予約 GPU 料金の意味
予約 GPU 料金はコミットメント型のモデルです。予約インスタンス、Savings Plans、コミット利用割引、予約クラスタ、専有容量、キャパシティブロック、または専用 GPU 契約として現れることがあります。名称はプロバイダーによって異なりますが、トレードオフは同じです。柔軟性を、予測可能な容量またはより低い実効レートと交換します。
予約 GPU 容量が適しているのは、次のような場合です:
| シグナル | 意味 |
|---|---|
| 安定したベースラインの推論トラフィック | 月の大半の時間、GPU を稼働させておけます。 |
| 繰り返し発生するトレーニング計画 | いつ、どれくらいの期間、容量が必要か把握しています。 |
| ローンチ時の容量要件 | ベストエフォートのスポット可用性に頼れません。 |
| マルチノードのトポロジー要件 | ネットワーク配置、ファブリック、ストレージのローカル性が重要です。 |
| 調達で固定支出が必要 | 変動する利用量より、既知の月次コミットメントのほうが承認されやすいです。 |
予約容量の中心的な問いは、利用率の損益分岐点です:
予約の損益分岐利用率 =
  予約の月次コミットメント
  / (オンデマンドの時間単価 * 月間時間数)
予約コミットが利用率 62% で損益分岐し、実際のベースラインが 25% なら、予約容量は割引ではありません。それはアイドル容量のサブスクリプションです。GPU クラスタでは、これを GPU クラスタ TCO モデルと組み合わせて、ネットワーキング、ストレージ、サポート、リモートハンズ、運用を含めて考慮してください。
ワークロード別の判断マトリクス
最適な料金モデルは、モデルサイズそのものよりも、失敗許容度と利用率に左右されます。
| ワークロード | より良い出発点 | 理由 |
|---|---|---|
| 初回モデルのベンチマーク | オンデマンド GPU | スループット、レイテンシー、メモリ、失敗モードのクリーンな基準が必要です。 |
| 新しいサービングスタックの評価 | オンデマンド GPU | 価格最適化の前に、vLLM、SGLang、TensorRT-LLM、ドライバ、イメージ、モデル読み込みを検証します。 |
| オフライン評価スイート | スポット GPU | 結果は再試行、分割、重複作業の確認が可能です。 |
| バッチ埋め込みまたはバッチ推論 | スポット GPU、オンデマンドのフォールバック付き | 冪等性と再試行制御があれば、ジョブをキューに入れられます。 |
| 顧客向け推論のベースライン | 予約 + オンデマンドのバースト | 安定需要はコミットメントを正当化でき、バーストは柔軟性を保てます。 |
| 単発のローンチまたは短期キャンペーン | オンデマンドまたはキャパシティブロック | 長期割引よりも容量保証のほうが重要な場合があります。 |
| マルチノード分散トレーニング | 予約または専用クラスタ | 配置、ネットワークファブリック、障害ドメインが時間単価よりも支配的です。 |
| 低ボリュームの AI プロダクト機能 | モデル API またはゲートウェイ | アイドル GPU 容量は、管理された従量課金推論より高くつくことがあります。 |
各行における GPU モデル選定については、この記事と AI GPU 選定ガイド、LLM 推論に最適な GPU、vLLM デプロイガイドを組み合わせてください。
オンデマンド vs スポット GPU の経済性: 簡単な例
推論バッチが、オンデマンドまたはスポットのどちらでも同じ GPU クラスで実行できると仮定します。
| 項目 | オンデマンド | スポット |
|---|---|---|
| 表示時間単価 | $4.00 |
$1.80 |
| 有効稼働率 | 70% |
70% |
| 再起動と退避による無駄 | 0% |
22% |
| 実効有効時間あたりコスト | $5.71 |
$3.30 |
この例では、無駄よりも割引のほうが大きいため、スポットが依然として有利です。次に、ジョブが繰り返し重みを再読み込みし、部分バッチを失うため、再起動の無駄を 55% に変更します。
| 項目 | オンデマンド | スポット |
|---|---|---|
| 表示時間単価 | $4.00 |
$1.80 |
| 有効稼働率 | 70% |
70% |
| 再起動と退避による無駄 | 0% |
55% |
| 実効有効時間あたりコスト | $5.71 |
$5.71 |
その時点で、見かけ上のスポット割引は消えてしまいます。だからこそ、オンデマンド vs スポットの GPU 比較では、プロバイダーのスポット割引率だけでなく、運用上の無駄も含める必要があります。
予約 GPU の経済性: 稼働率テスト
予約容量には別のテストが必要です。たとえば、オンデマンド GPU が $4/hour で、同等容量の予約月間コミットメントが $1,900/month だとします。
monthly on-demand cost at 100% utilization =
  $4 * 730 hours = $2,920

reserved break-even utilization =
  $1,900 / $2,920 = 65%
この予約が魅力的なのは、ワークロードが GPU を月の 3 分の 2 超の時間、稼働させ続けられる場合だけです。本番エンドポイントが営業時間中は GPU を集中的に使っていても、夜間や週末にはアイドルになっているなら、実際のベースラインは損益分岐点を下回っている可能性があります。
この問いを調達の観点で言い換えると、次のようになります:
- 予測上のピークではなく、実測のベースラインはどれか?
- どのワークロードが、遊休の予約容量を埋めることを許されるのか?
- モデルが H100 から H200、B200、L40S、またはマネージド API に移行したらどうなるのか?
- ストレージ、サポート、ネットワーク、イグレスはコミットメントの内側か外側か?
- 契約はダウングレード、GPU タイプ変更、リージョン移動に対応できるか?
期待だけで予約してはいけません。実測の稼働率に基づいて予約してください。
プロバイダーのソースチェックリスト
GPU 料金ページは頻繁に変わり、市場価格は調達サイクルより速く変動することがあります。これは固定レート表ではなく、ソースチェックリストとして使ってください。支出を承認する当日に再確認しましょう。
| Provider category | Official source to check | What to capture |
|---|---|---|
| AWS | Amazon EC2 pricing, EC2 Spot Instances, EC2 Capacity Blocks for ML | リージョン、GPU インスタンスファミリー、オンデマンド、スポット、Savings Plans または Reserved Instances、Capacity Block の時間帯、EBS、データ転送、サポート。 |
| Google Cloud | Compute Engine GPU pricing, Spot VMs, Committed use discounts | GPU タイプ、マシンファミリー、リージョン、Spot VM のステータス、コミット期間、予約の必要性、永続ディスク、ネットワークイグレス。 |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | GPU VM SKU、リージョン、回収ポリシー、最大価格設定、予約期間、マネージドディスク、帯域幅、サポート。 |
| RunPod | RunPod pricing and product docs | Secure Cloud vs Community Cloud、pod 料金、serverless 料金、永続ストレージ、ネットワークボリューム、コールドスタートの挙動。 |
| Vast.ai | Vast.ai pricing and Vast.ai docs | ホストの信頼性、データセンター/コミュニティのステータス、interruptible フラグ、ディスク、帯域幅、verified host、公的 IP の必要性。 |
| Lambda | Lambda Cloud GPU pricing | インスタンスタイプ、GPU 数、リージョン、オンデマンドの利用可能性、予約クラスター見積もり条件、ストレージとネットワーキングの前提。 |
スプレッドシートには確認日を 1 行追加してください。この記事では、ソースチェックリストを 2026年10月13日 に確認しました。
選定前の調達に関する質問
オンデマンド vs スポット GPU 容量を選ぶ前、または予約 GPU 契約に署名する前に、次の質問をしてください:
| Question | Why it matters |
|---|---|
| ジョブは手動修復なしでチェックポイントから再開できるか? | スポット中断リスクを受け入れられるかどうかを決定します。 |
| 有用な GPU 作業が始まるまでの起動時間はどのくらいか? | モデルとデータの読み込みが長いほど、スポットの節約効果は減り、オンデマンド効率は悪化します。 |
| 実測のアイドル率はどれくらいか? | アイドル時間はオンデマンドコストの主な漏れです。 |
| ピークではなく、ベースラインはどれか? | 予約価格が機能するのは、ベースライン需要が वास्तविकな場合だけです。 |
| ワークロードは特定のリージョンやネットワークファブリックを必要とするか? | 希少なトポロジーでは、一般的なスポット/オンデマンド料金が無意味になることがあります。 |
| ストレージ、スナップショット、帯域幅、サポートは含まれているか? | GPU 時間は実際の請求書の一項目にすぎません。 |
| モデル選択が変わった場合の出口戦略は何か? | モデルアーキテクチャが変わると、ハードウェアのロックインは高くつきます。 |
| 代わりにマネージドモデル API で要件を満たせるか? | 低稼働率または複数モデルのワークロードでは、GPU 運用を正当化できない場合があります。 |
マルチノードおよび専有容量の判断については、GPU クラスター レンタル と プライベート GPU クラウド と比較してください。
モデル API が 3 つすべての GPU 料金モデルを上回る場合
オンデマンド、スポット、予約 GPU はすべて、ハードウェアを借りて運用することが適切な抽象化レイヤーであることを前提にしています。しかし、それが常に正しいとは限りません。
管理されたモデル API は、次のような場合により経済的な出発点になることがあります。
- 利用率が低い、断続的、または不明である。
- 製品が 1 つのセルフホスト型モデルではなく、多数のモデルを必要とする。
- 信頼性、アップグレード、スケーリングが製品ロードマップの妨げになってしまう。
- チームがハードウェア制御よりも、利用台帳、予算、請求書を必要としている。
- ワークロードが、モデルの学習やカスタム提供の研究ではなく、本番推論である。
Flatkey は、この判断の API 側に位置します。AI チームに 1 つの API キー、1 つの残高、1 つの請求書、利用状況の可視化、そして各プロバイダーの公式モデルルートへのアクセスを提供します。オンデマンド vs スポット GPU のワークシートで、ハードウェア利用率がまだ十分に高くないと示された場合は、GPU 容量を購入または予約する前に、受け入れ済み結果 1 件あたりの管理 API コストを比較してください。次のステップは、AI モデル価格比較 と AI ゲートウェイ料金 のガイドです。
最終的な推奨
次の順序で進めてください。
- ベンチマークと利用率の数値が信頼できるようになるまでは、オンデマンド GPU 容量から始める。
- チェックポイント、冪等性、再起動の自動化が実証されてから、再試行可能なジョブをスポット GPU に移す。
- 測定されたベースライン需要、確約されたローンチ期間、またはトポロジーに敏感なクラスターに対してのみ、GPU 容量を予約する。
- 利用率が低い、モデルの選択が頻繁に変わる、または財務部門がより明確な利用配分を必要とする場合は、モデル API の経路を開いたままにしておく。
最適なオンデマンド vs スポット GPU の判断とは、掲載上の時間単価が最も低いものではありません。チームが実際に管理できる範囲に信頼性リスクを収めながら、完了したワークロードあたりのコストを最小化するオンデマンド vs スポット GPU の判断です。


