
Custos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
Preço da GPU H100: preços, fatores de custo e guia de compra
Guia de preços da GPU H100 para comparar uma oferta PCIe de US$ 32.200, referências de aluguel na nuvem, formatos e o TCO por trás de uma cotação on-premises.

Servidor GPU: arquitetura, desempenho e guia de implantação na nuvem
Escolha e implante um servidor GPU na nuvem com uma estrutura orientada à carga de trabalho para arquitetura, testes de desempenho e preparação para produção.
API de LLM gratuita: limites, custos e compromissos em produção
Um guia prático sobre níveis gratuitos de APIs de LLM, créditos, limites de taxa, custos operacionais ocultos e os controles de produção a adicionar antes que os usuários dependam de uma rota.
ComfyUI numa GPU na nuvem: guia de configuração, armazenamento e custos
Um guia prático para implementar o ComfyUI numa GPU na nuvem com armazenamento persistente, acesso privado, seleção de GPU conforme a carga de trabalho e controlo de custos.

APIs de LLM mais baratas em 2026: compare preços por carga de trabalho, não por hype
Um guia com fontes verificadas para comparar APIs de LLM de baixo custo por carga de trabalho, incluindo custos de entrada, saída, cache, lote, ferramentas, tentativas e correções.

Infraestrutura de IA soberana: modelos, residência de dados e controle computacional (guia de 2026)
Um guia prático sobre infraestrutura de IA soberana em 2026: as quatro camadas (capacidade computacional, dados, modelos e operações), as regulamentações que impulsionam sua adoção, cinco níveis de soberania, uma configuração para servir modelos abertos e um exemplo de custos de GPUs no país para um modelo de 70B.

Chave de API da Anthropic (2026): como obter, tipos de chave, Claude Code e erros
Guia passo a passo da chave de API da Anthropic em 2026: configuração no Console, chaves pessoais e de conta de serviço, expiração, primeira requisição, Claude Code, custos e erros.

Preços da API do Grok (2026): todos os modelos, taxas de ferramentas e multiplicadores
Preços atuais da API xAI Grok: tarifas de texto, imagem, vídeo e voz, os cinco multiplicadores (contexto longo, prioridade, região dos EUA, Batch e ferramentas), uma calculadora de custos e a comparação com GPT, Claude, Gemini e Qwen.
Preços da API da Mistral (2026): todos os modelos, desconto em batch e exemplos de custo
Tabela completa de preços da API da Mistral (dados oficiais de outubro de 2026), plano gratuito, descontos de batch e cache, calculadora de custos, comparação com GPT, Claude, Gemini e Qwen, e código.
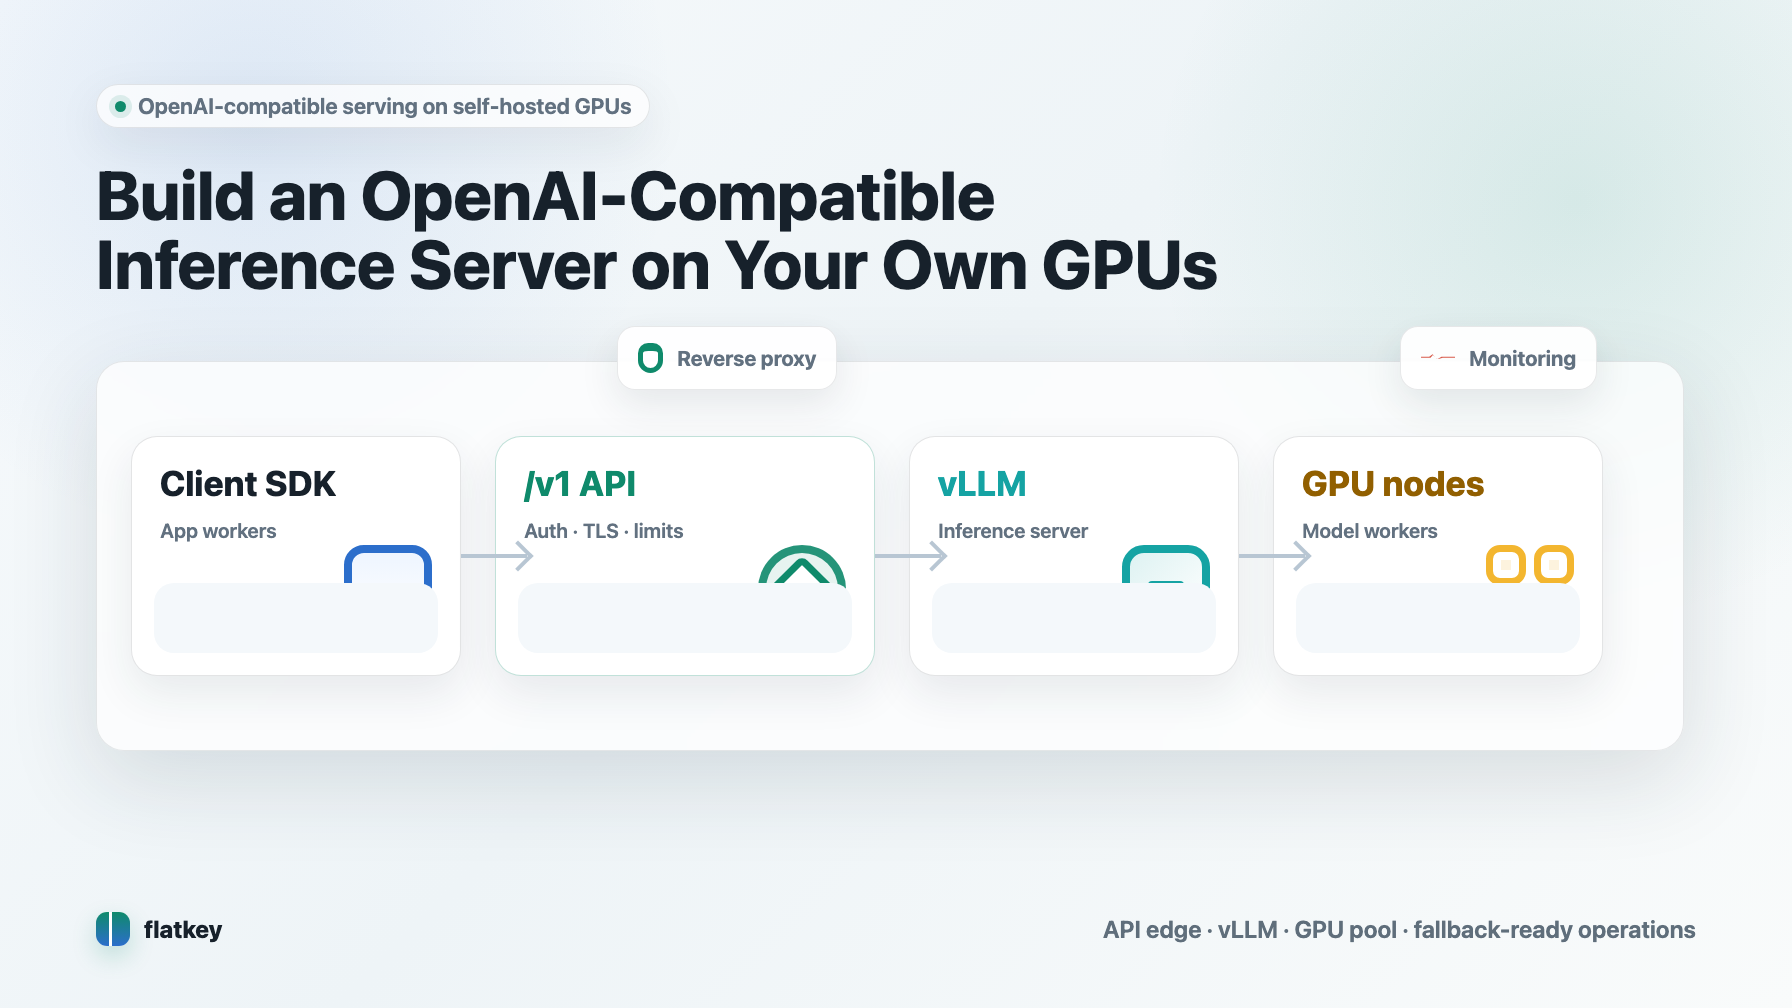
Guia de LLM auto-hospedado (2026): quando vale a pena, qual hardware usar e como servir o modelo
Um LLM auto-hospedado executa modelos de pesos abertos em GPUs sob seu controle. Saiba quando ele custa menos que uma API cobrada por token (com preços de GPU de outubro de 2026), como dimensionar a memória da GPU, qual ferramenta de inferência escolher e como implantar um servidor vLLM compatível com OpenAI com uma alternativa para falhas.
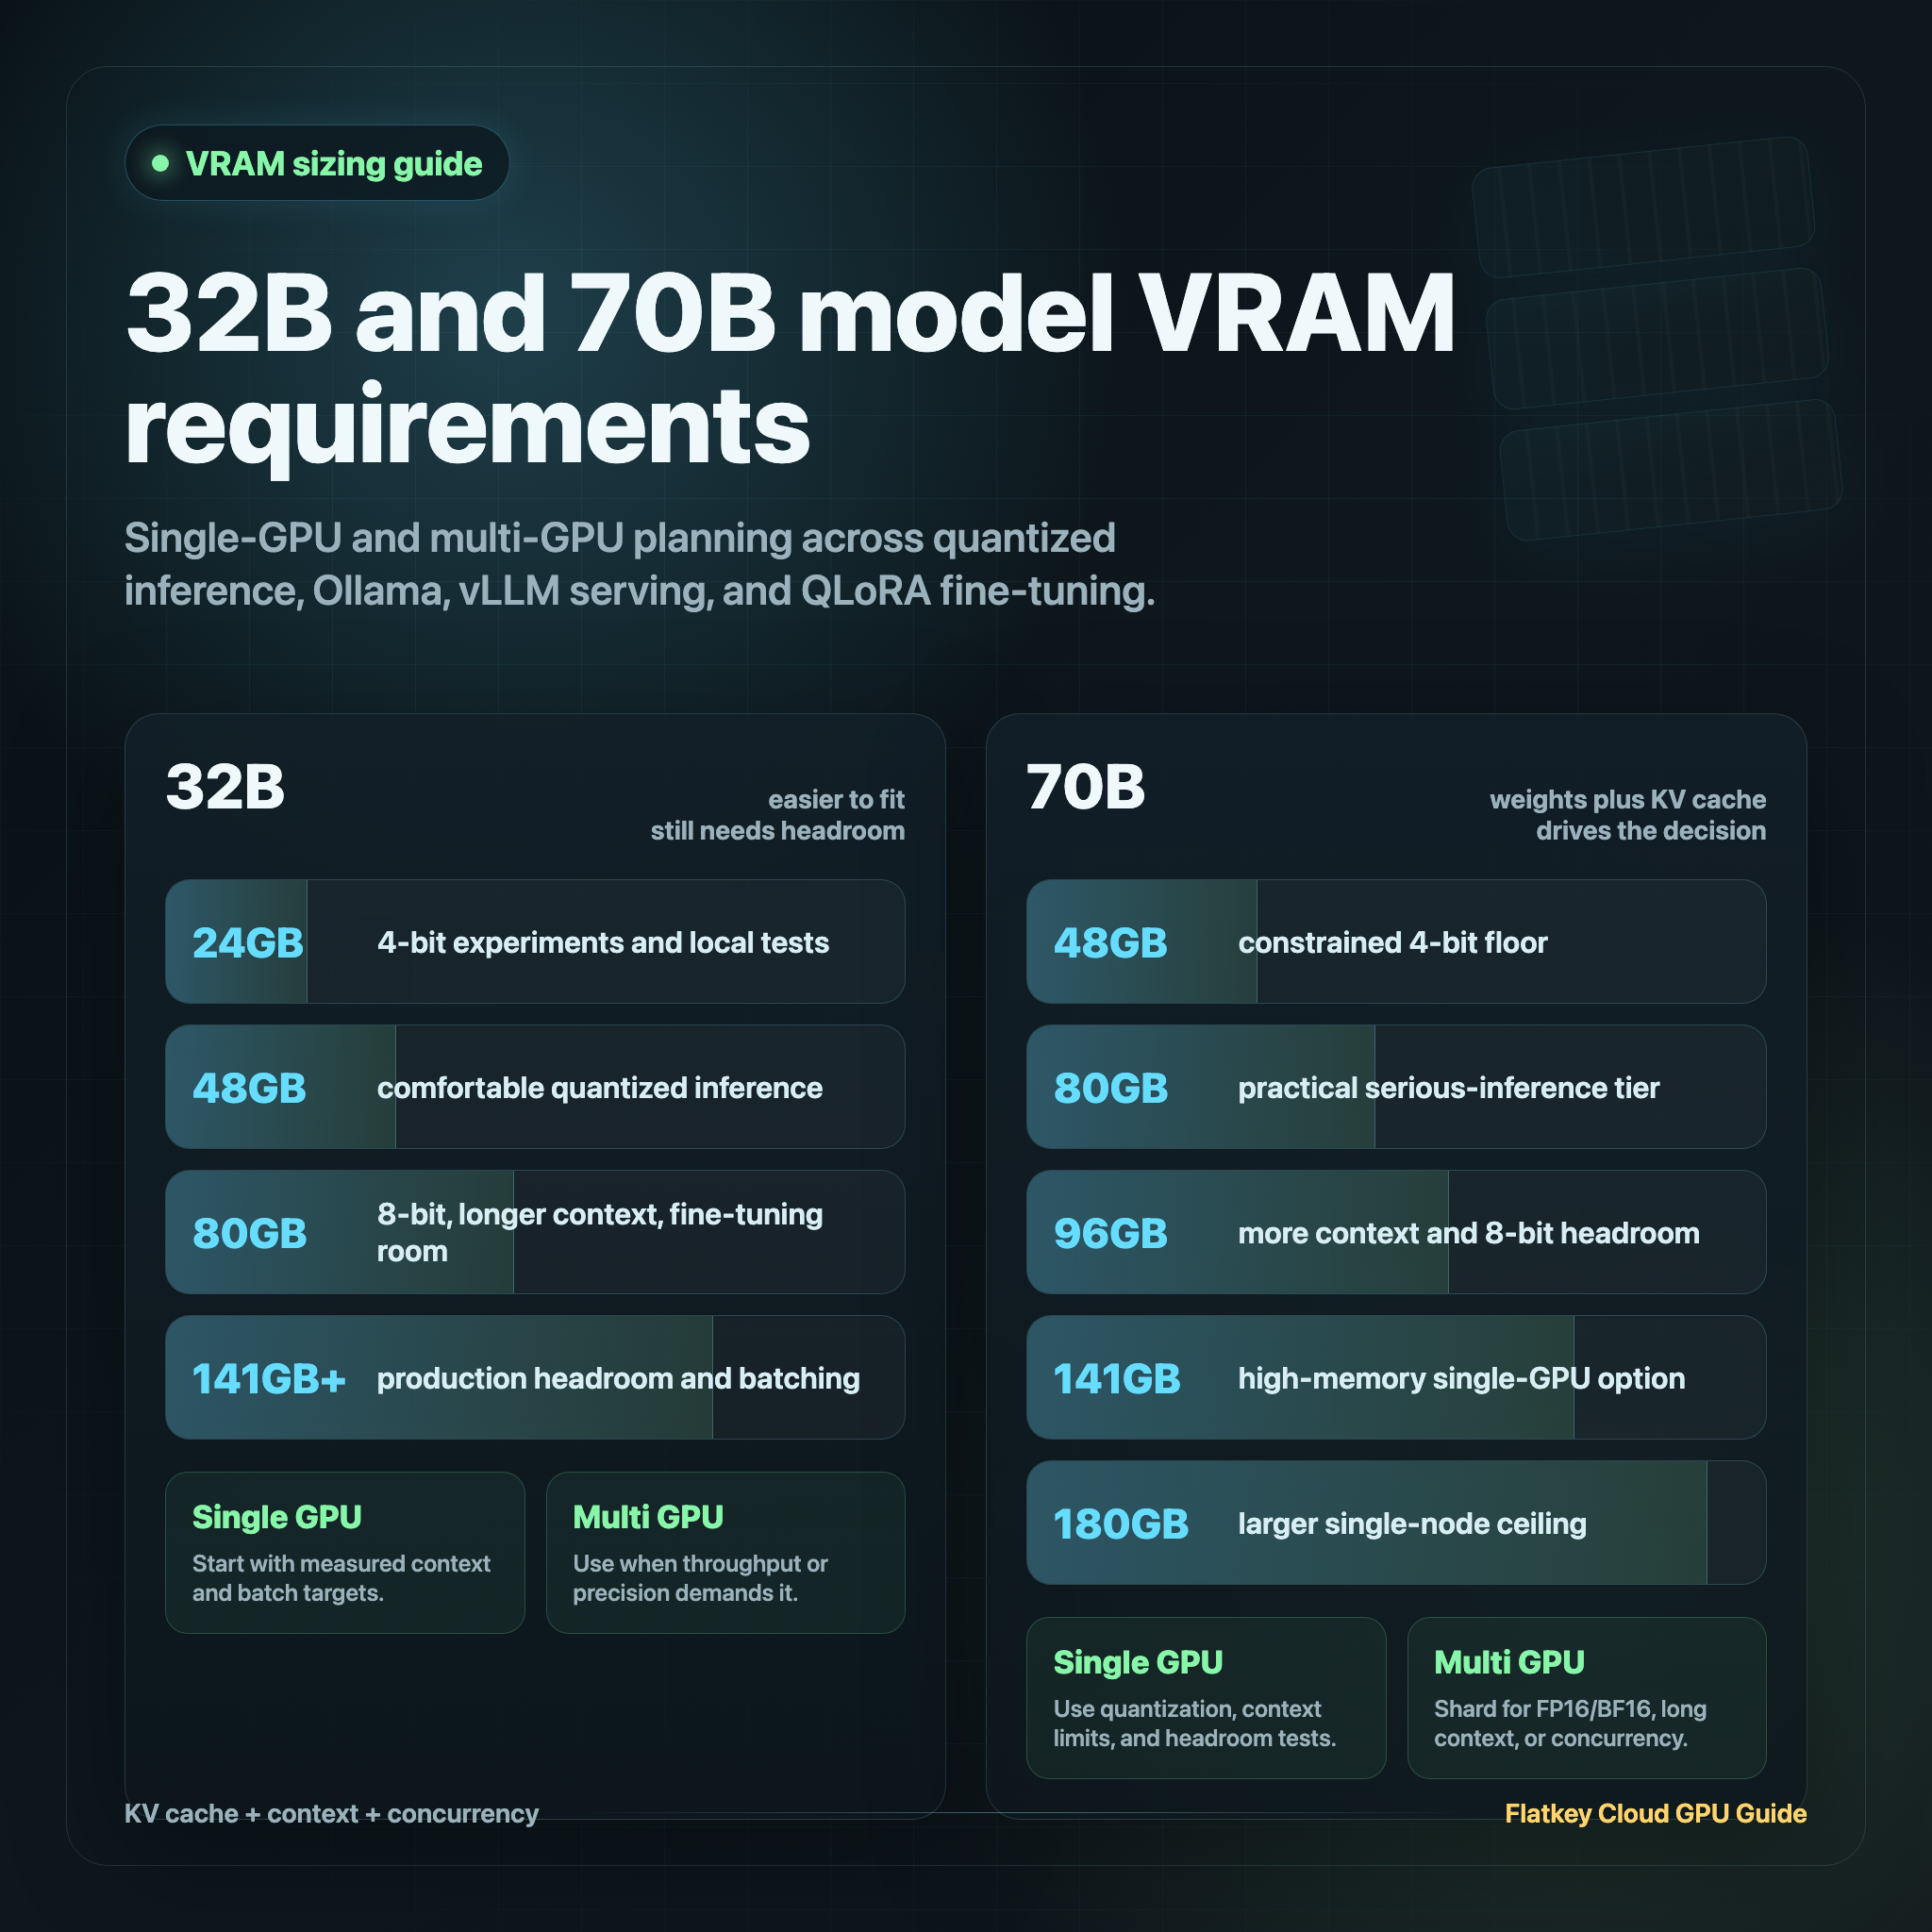
Guia de VRAM para modelos 32B e 70B: opções com GPU única e múltiplas GPUs
Aprenda os requisitos práticos de VRAM para modelos 32B e 70B em inferência 4-bit, 8-bit, FP16/BF16, Ollama, fine-tuning com QLoRA e opções com múltiplas GPUs.
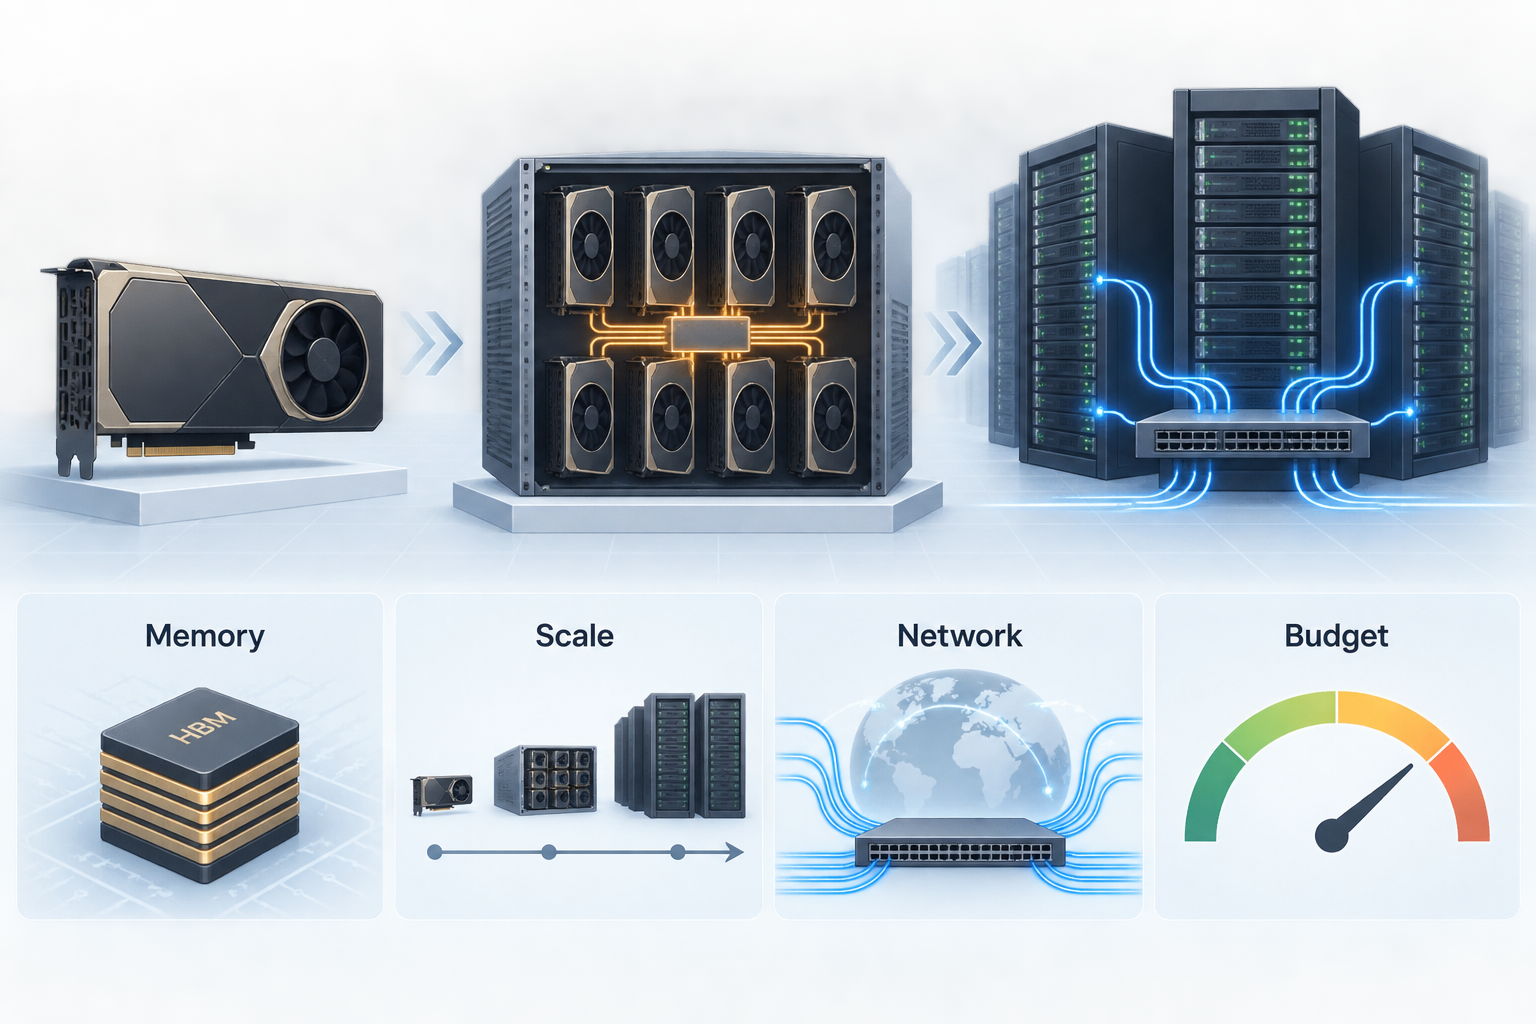
Melhor GPU para Treinamento de LLM: escala, memória, rede e orçamento
Um guia prático de 2026 para escolher a melhor GPU para treinamento de LLM por escala, memória, rede, compatibilidade com provedor e custo por checkpoint concluído.
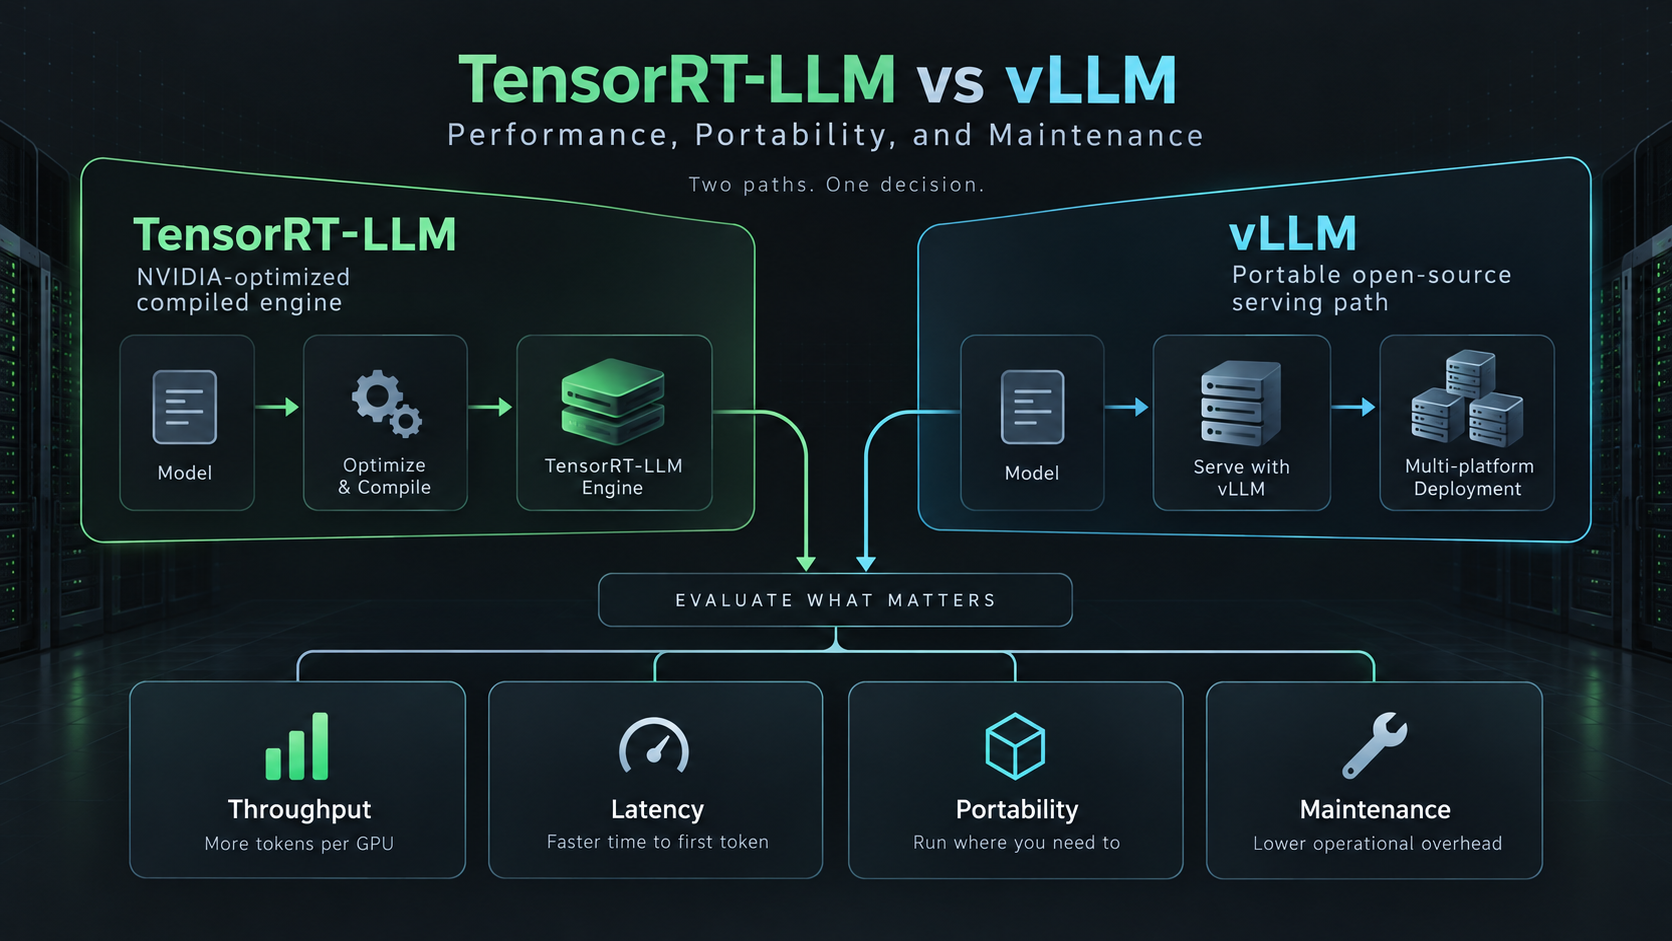
TensorRT-LLM vs vLLM: Desempenho, Portabilidade e Manutenção
Uma comparação prática entre TensorRT-LLM e vLLM para equipes de infraestrutura de IA que escolhem um mecanismo de serving de LLM entre desempenho, portabilidade, manutenção e design de benchmarks.
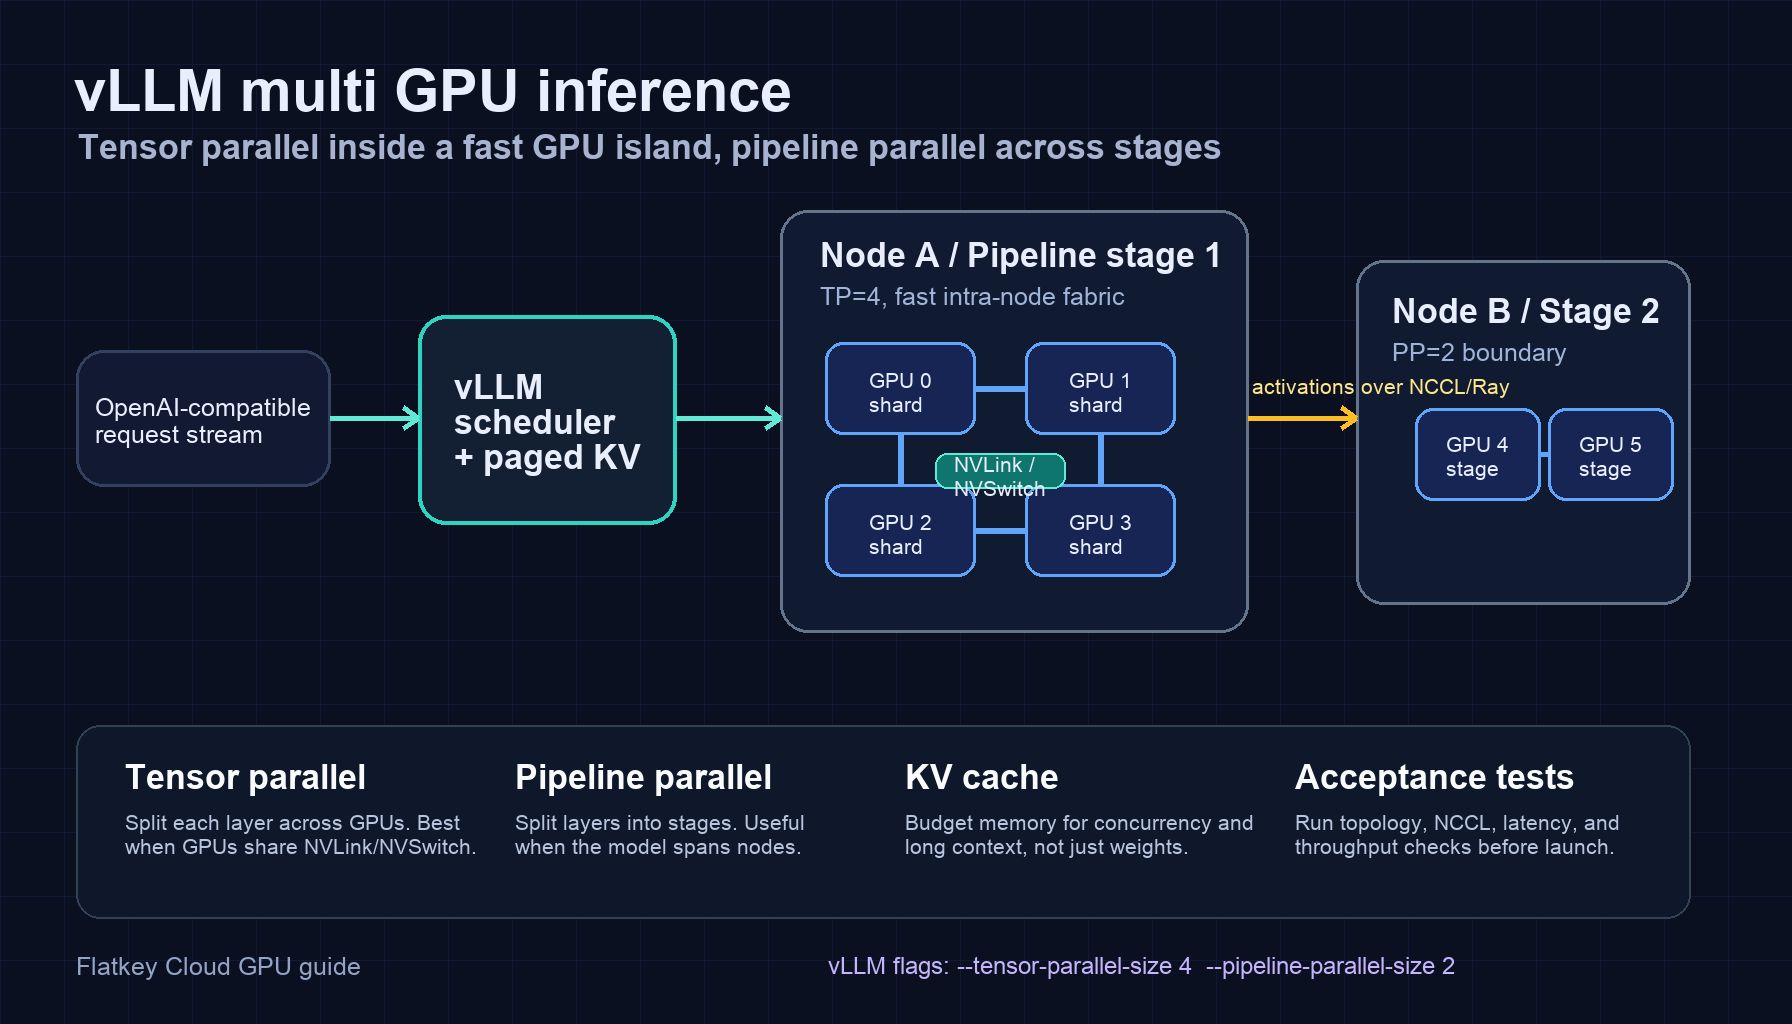
Inferência Multi-GPU com vLLM: Configuração de Paralelismo Tensorial e de Pipeline
Configure a inferência multi-GPU com vLLM usando paralelismo tensorial, paralelismo de pipeline, Ray, verificações de topologia, exemplos e testes em produção.
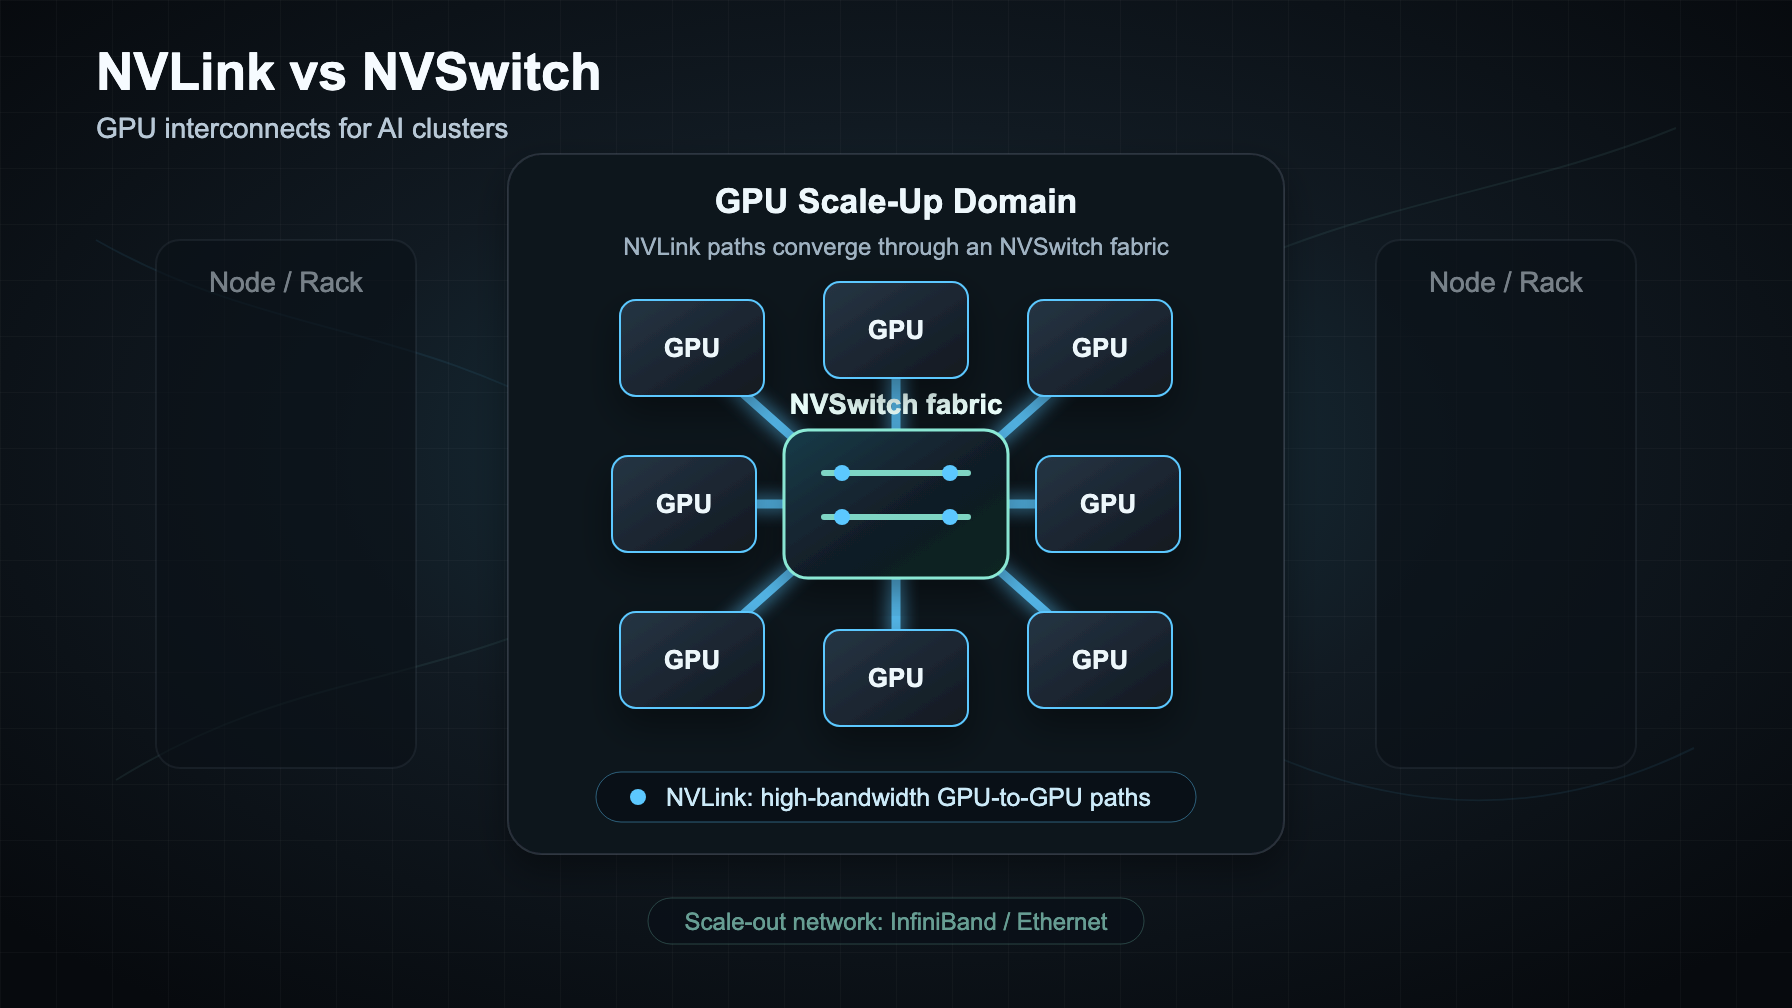
NVLink vs NVSwitch: Explicação das interconexões de GPU para clusters de IA
NVLink é a ligação GPU a GPU, NVSwitch é a malha, e InfiniBand ou Ethernet é a rede de escala horizontal. Veja como escolher para clusters de IA.
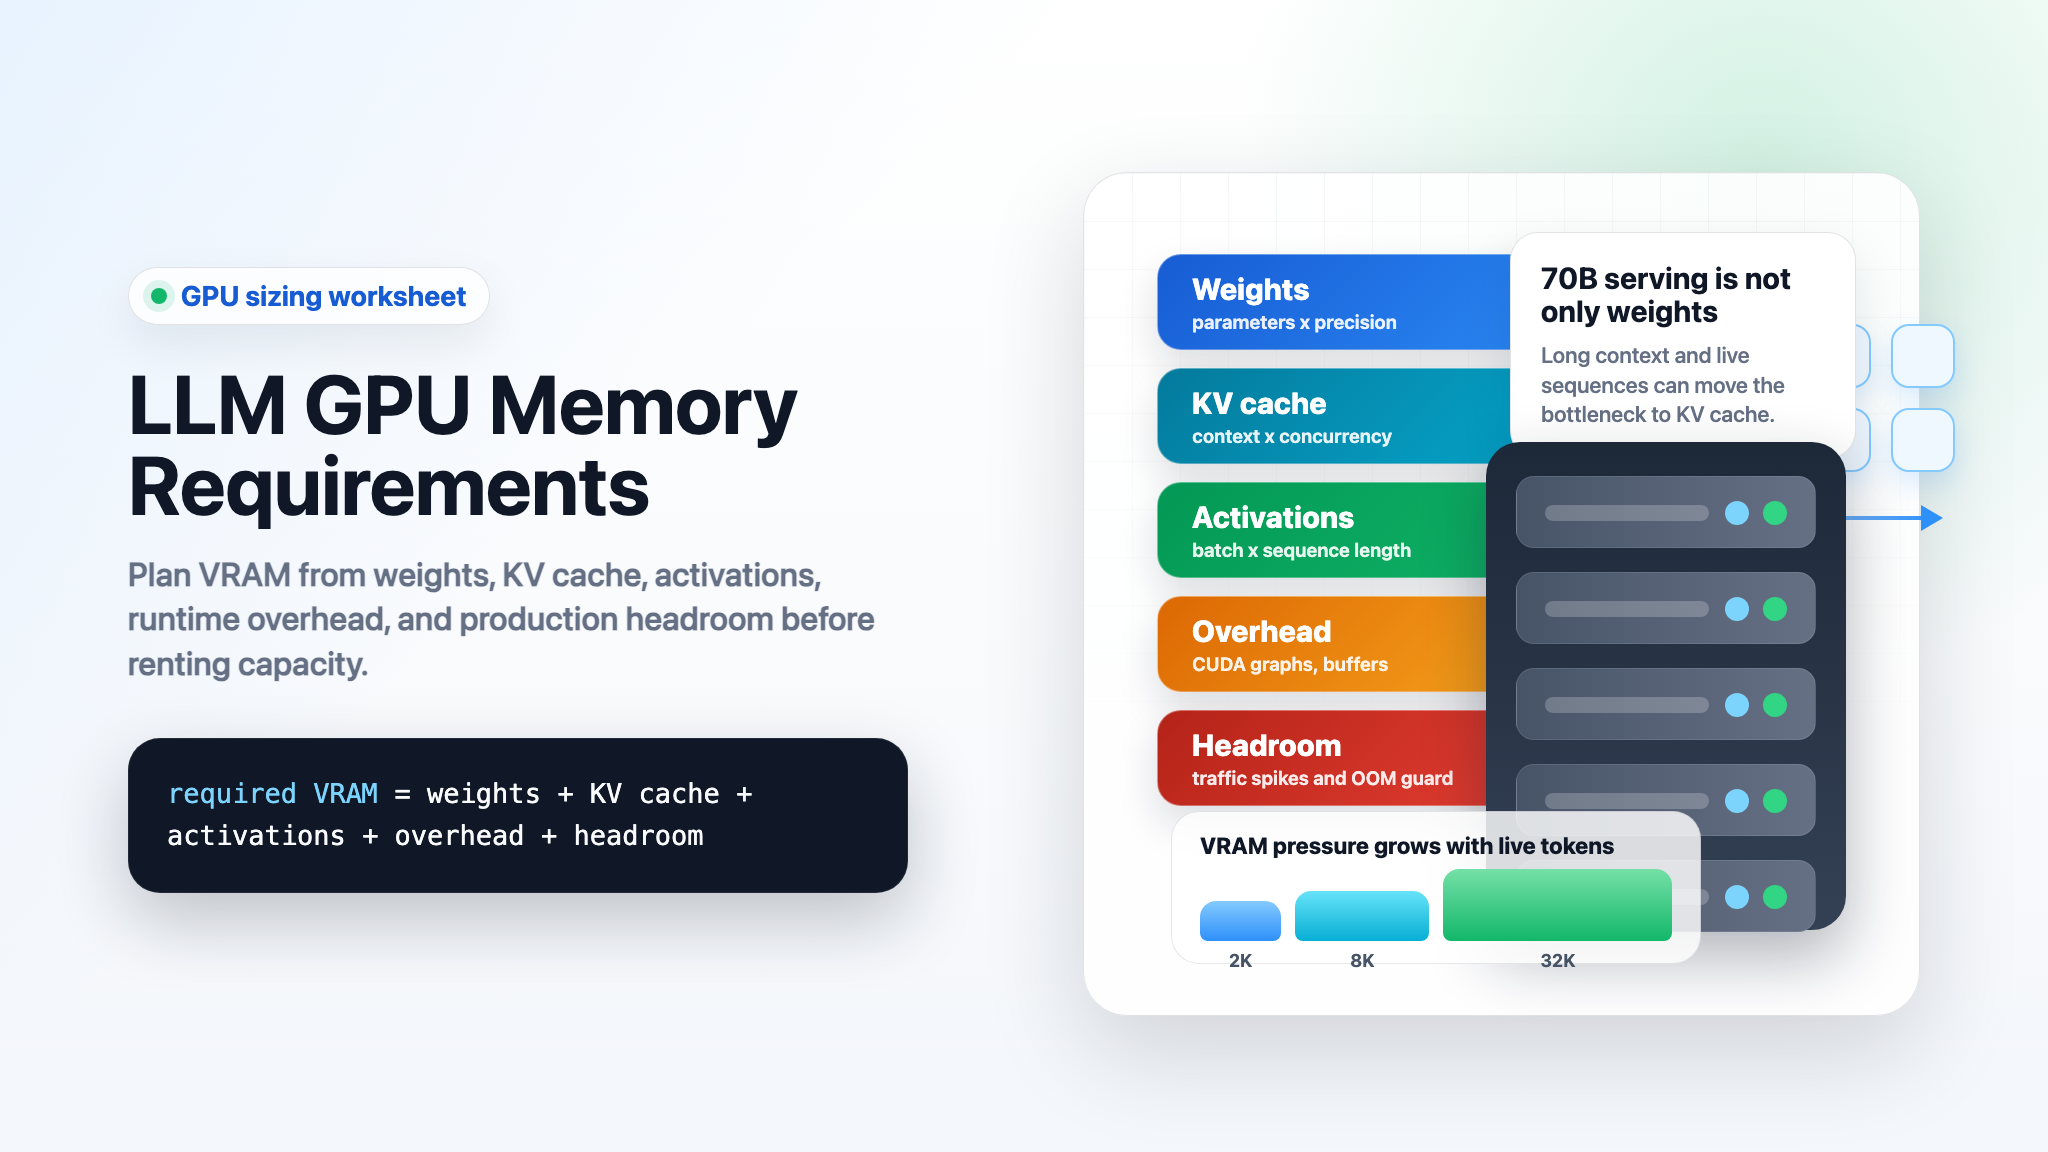
Requisitos de Memória GPU para LLM: Pesos, KV Cache, Ativações e Overhead
Uma planilha prática para estimar os requisitos de memória GPU de LLMs em pesos, KV cache, ativações, overhead de serving, planejamento de vLLM 70B, fine-tuning e treinamento.
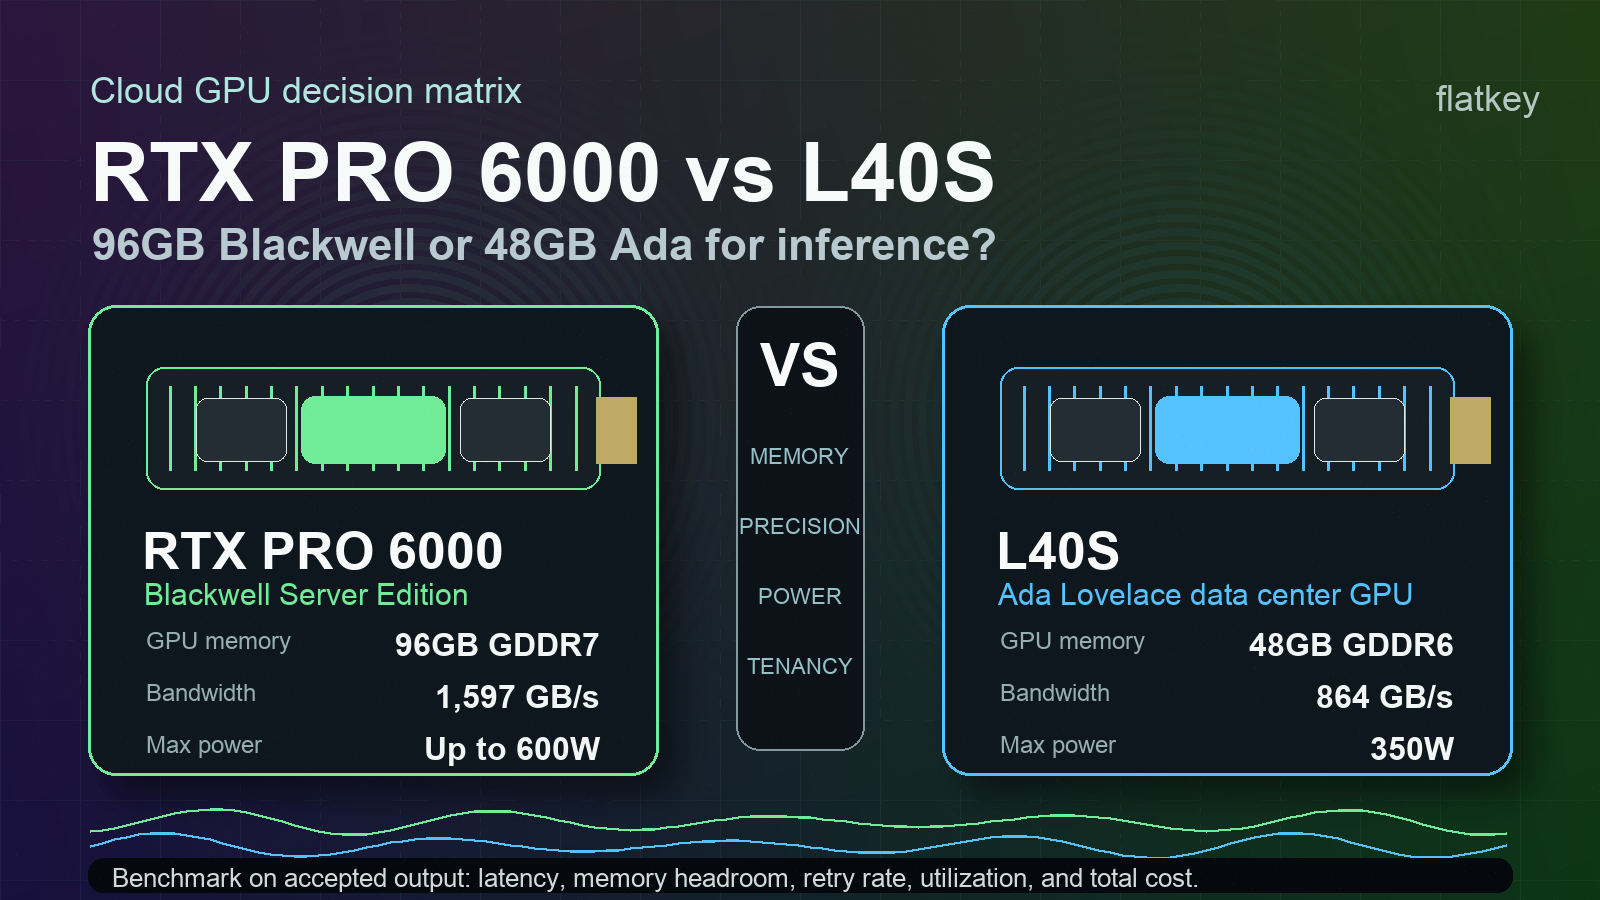
RTX PRO 6000 vs L40S: GPU de inferência Blackwell de 96 GB ou Ada?
Compare o NVIDIA L40S com o RTX PRO 6000 Blackwell Server Edition para inferência de LLM, workloads multimodais, adequação de memória, consumo de energia e custo por saída aceita.
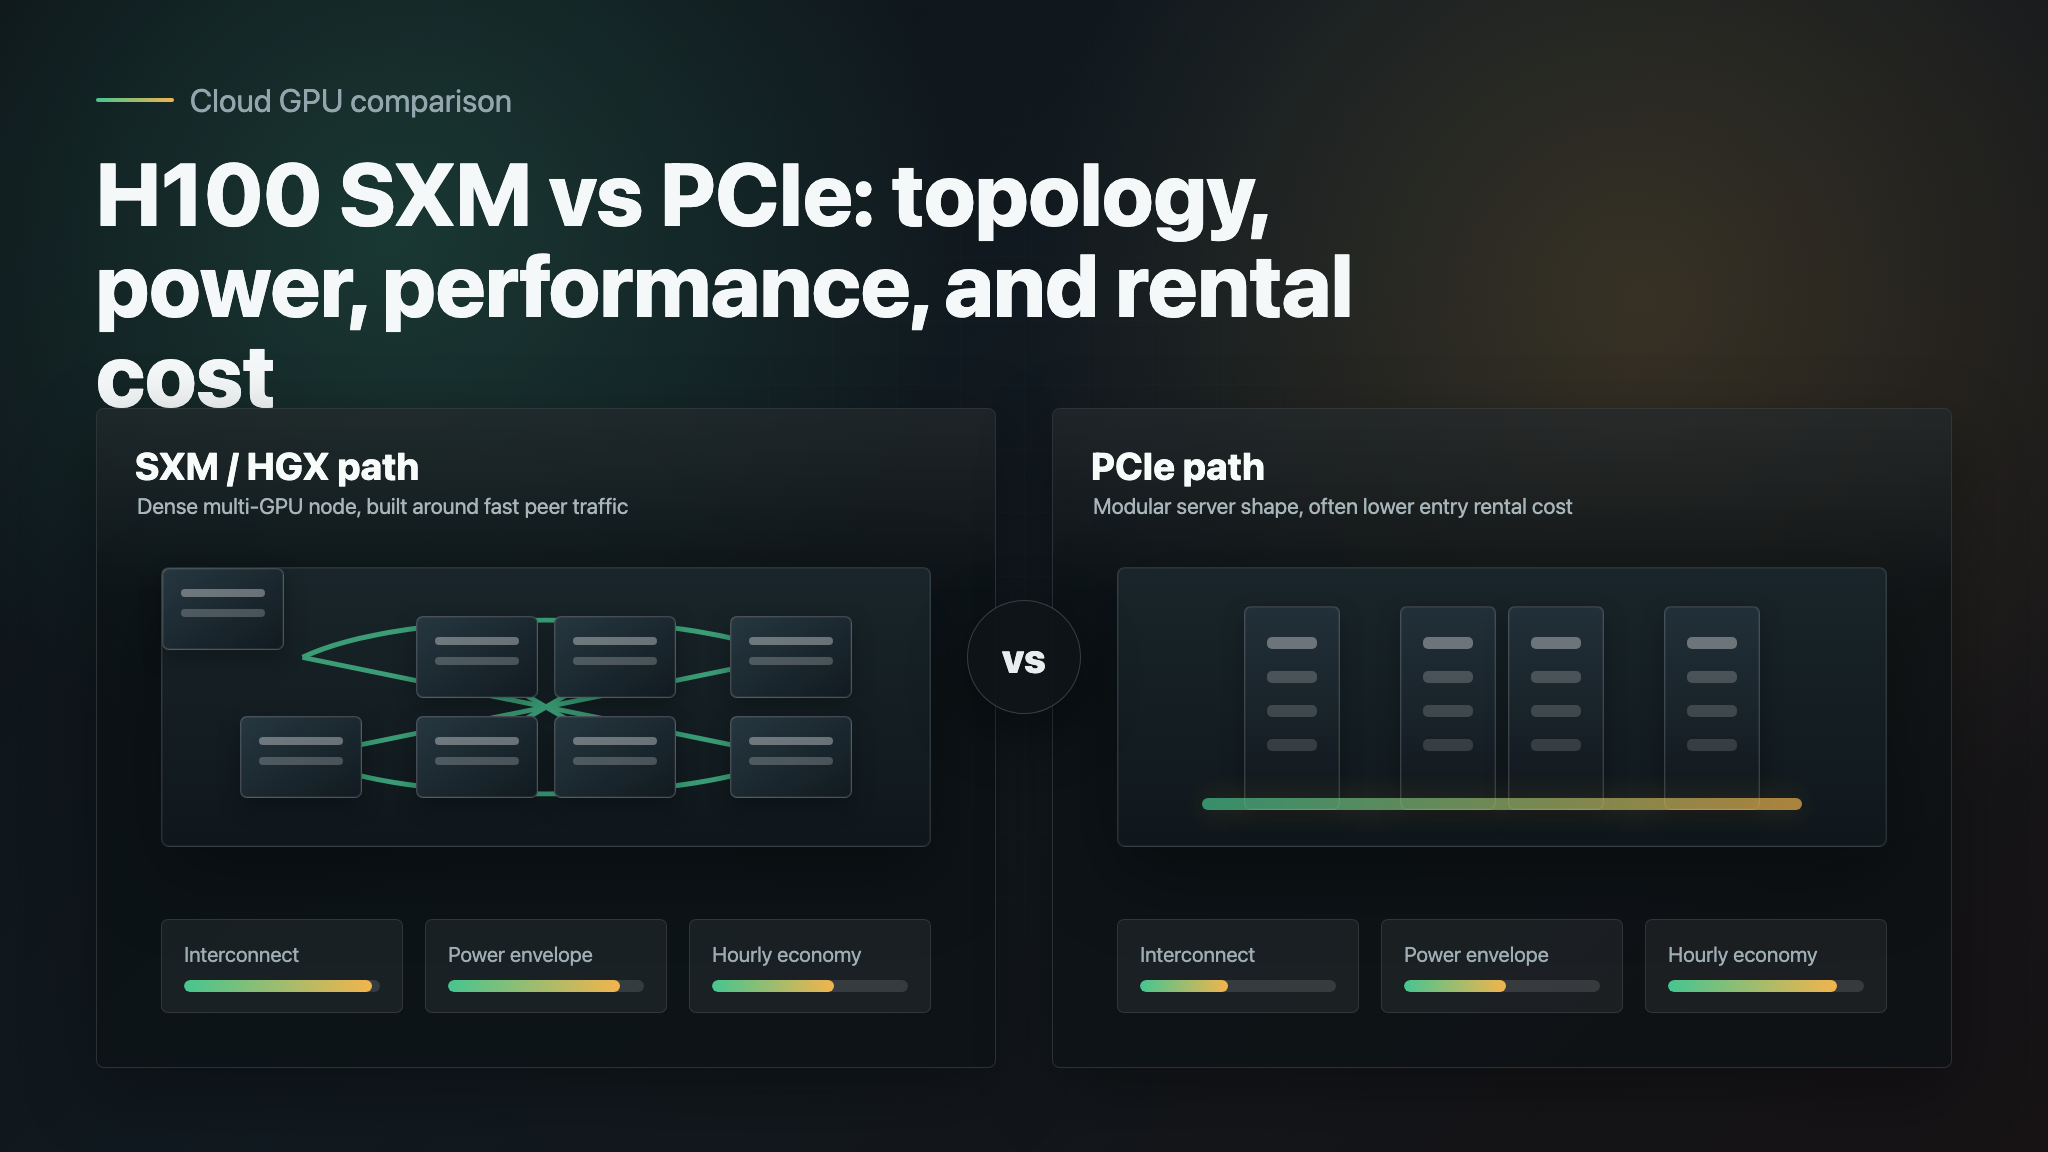
H100 SXM vs PCIe: NVLink, Energia, Desempenho e Custo de Aluguel
Compare o H100 PCIe vs SXM em NVLink, consumo de energia, desempenho em workloads e custo de aluguel antes de alugar GPUs na nuvem.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar