
Custos, cobrança e operações
Artigos mais recentes em Custos, cobrança e operações.
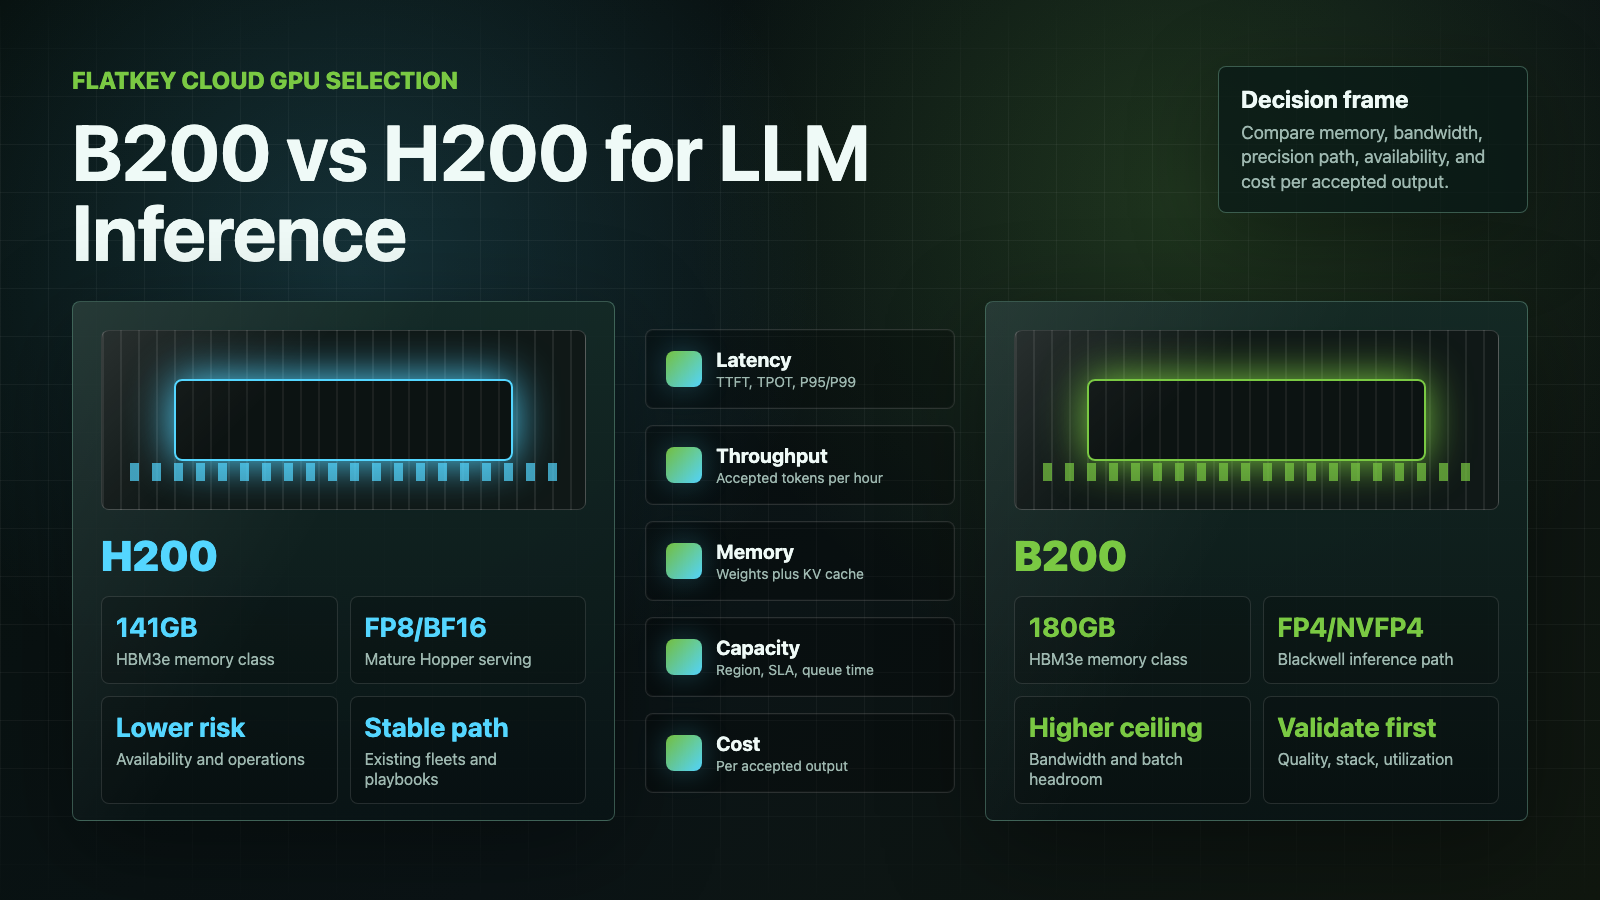
NVIDIA B200 vs H200: Qual GPU é melhor para inferência de LLM?
Compare o NVIDIA B200 vs H200 para inferência de LLM por memória, largura de banda, suporte a precisão, sistemas DGX, disponibilidade de GPUs na nuvem e custo por saída aceita.
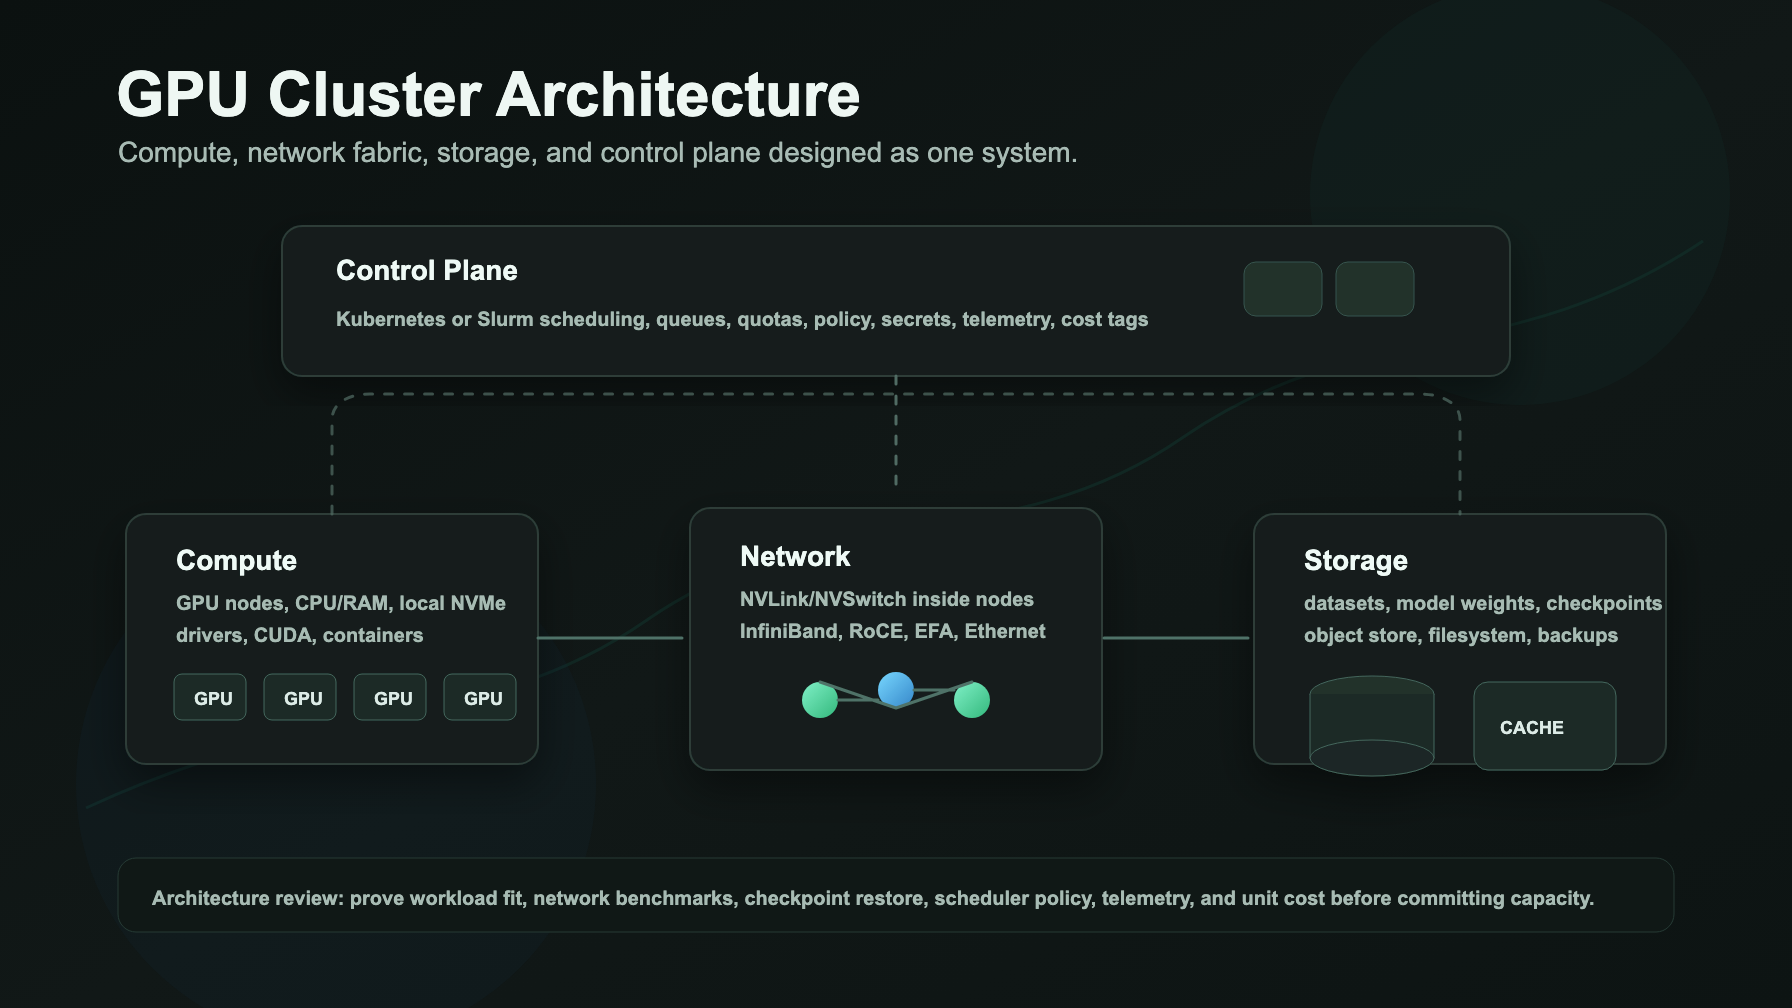
Arquitetura de Cluster GPU: Computação, Rede, Armazenamento e Plano de Controle
Um guia prático de arquitetura de cluster GPU para nós de computação, malha de rede, armazenamento, plano de controle Kubernetes ou Slurm, observabilidade e testes de aceitação.
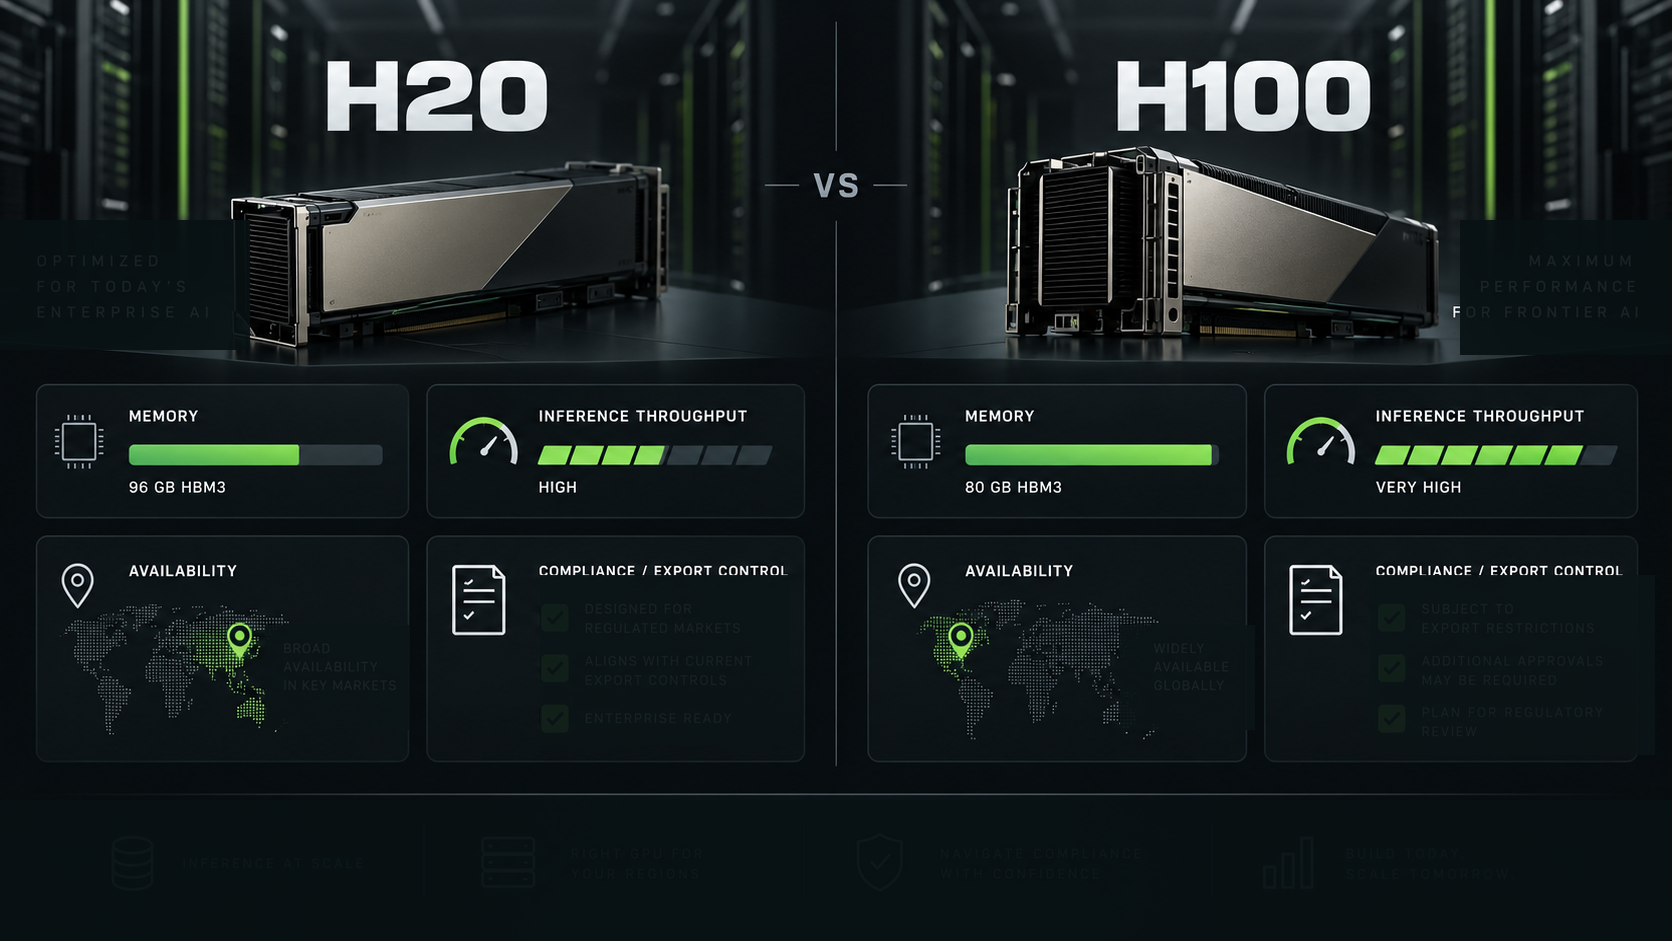
NVIDIA H20 vs H100: Inferência, Memória, Disponibilidade e Conformidade
Uma comparação prática entre H20 e H100 para equipas de IA empresarial, abrangendo inferência, memória, disponibilidade, risco de controlo de exportação e quando H200 ou APIs de modelos são melhores referências.
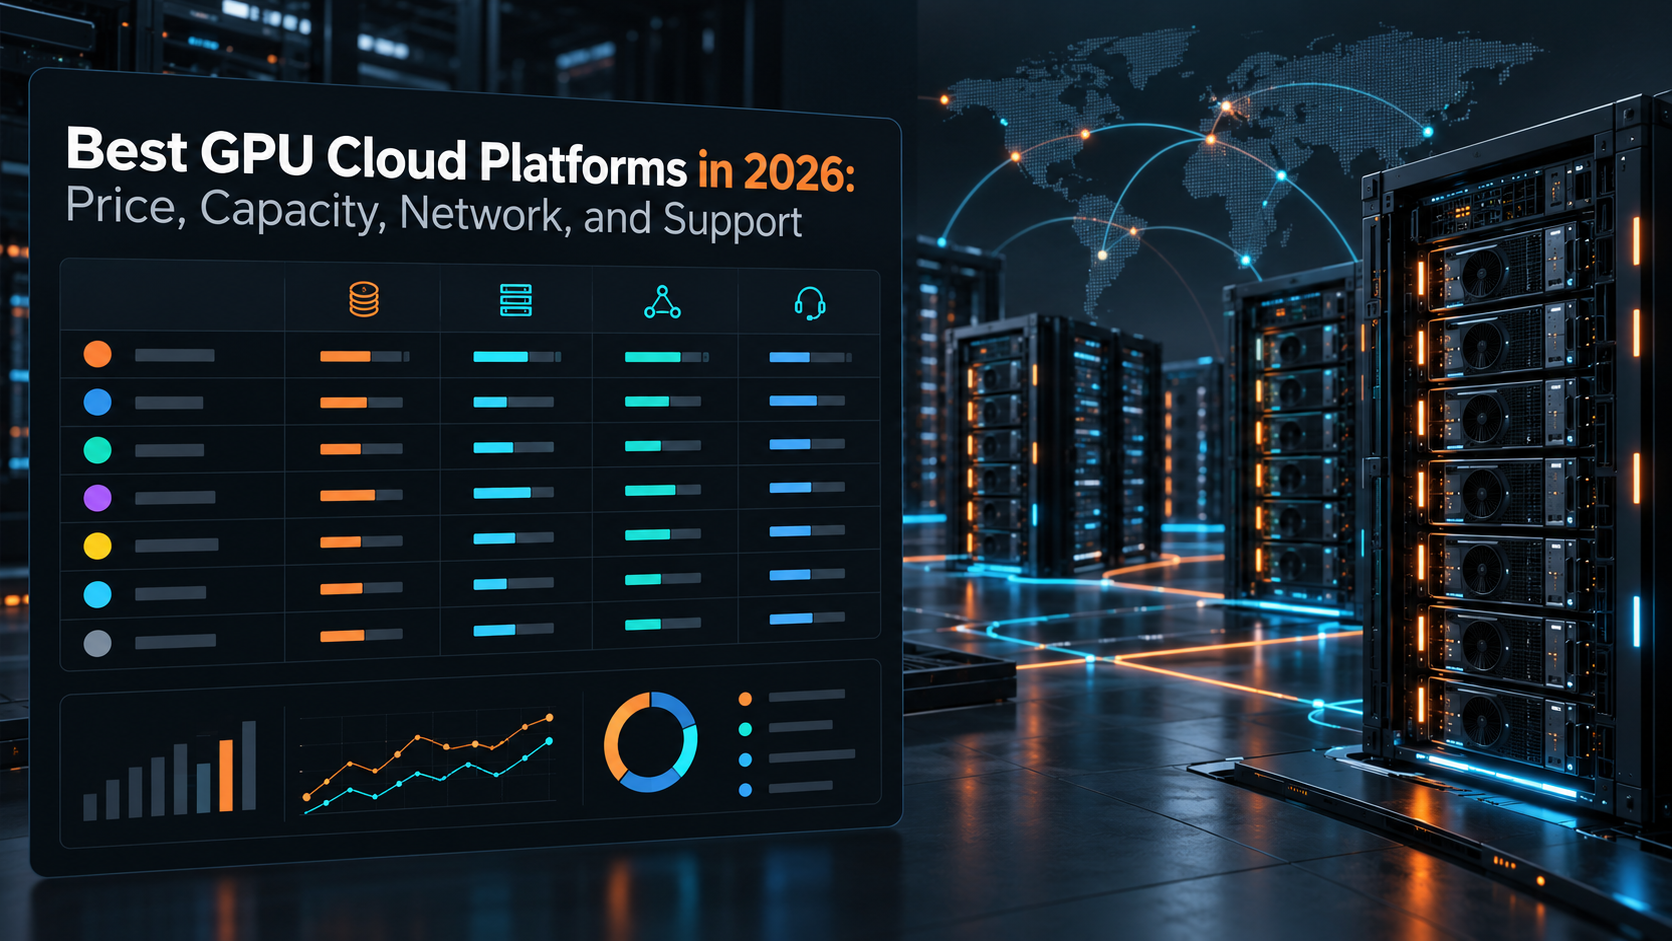
Melhores Plataformas de Aluguel de GPU na Nuvem em 2026: Preço, Capacidade, Rede e Suporte
Uma seleção prática de 2026 de plataformas de GPU na nuvem para equipes de IA, comparando preço, capacidade, rede, suporte e quando uma API de modelo é a melhor base.
NVIDIA Blackwell Ultra B300: O que mudou em relação ao B200?
Um guia prático do NVIDIA B300 Blackwell Ultra para equipas de infraestrutura de IA, comparando especificações do B300, estado de lançamento, alertas sobre preço e adequação de carga de trabalho face ao B200.
AMD MI455X e Helios: Rastreador de Arquitetura, Memória e Disponibilidade
Um rastreador voltado para compradores sobre o AMD MI455X e Helios, cobrindo arquitetura, memória HBM4, largura de banda, disponibilidade, prontidão para vLLM, dúvidas com provedores e estratégia de fallback de modelos/API.
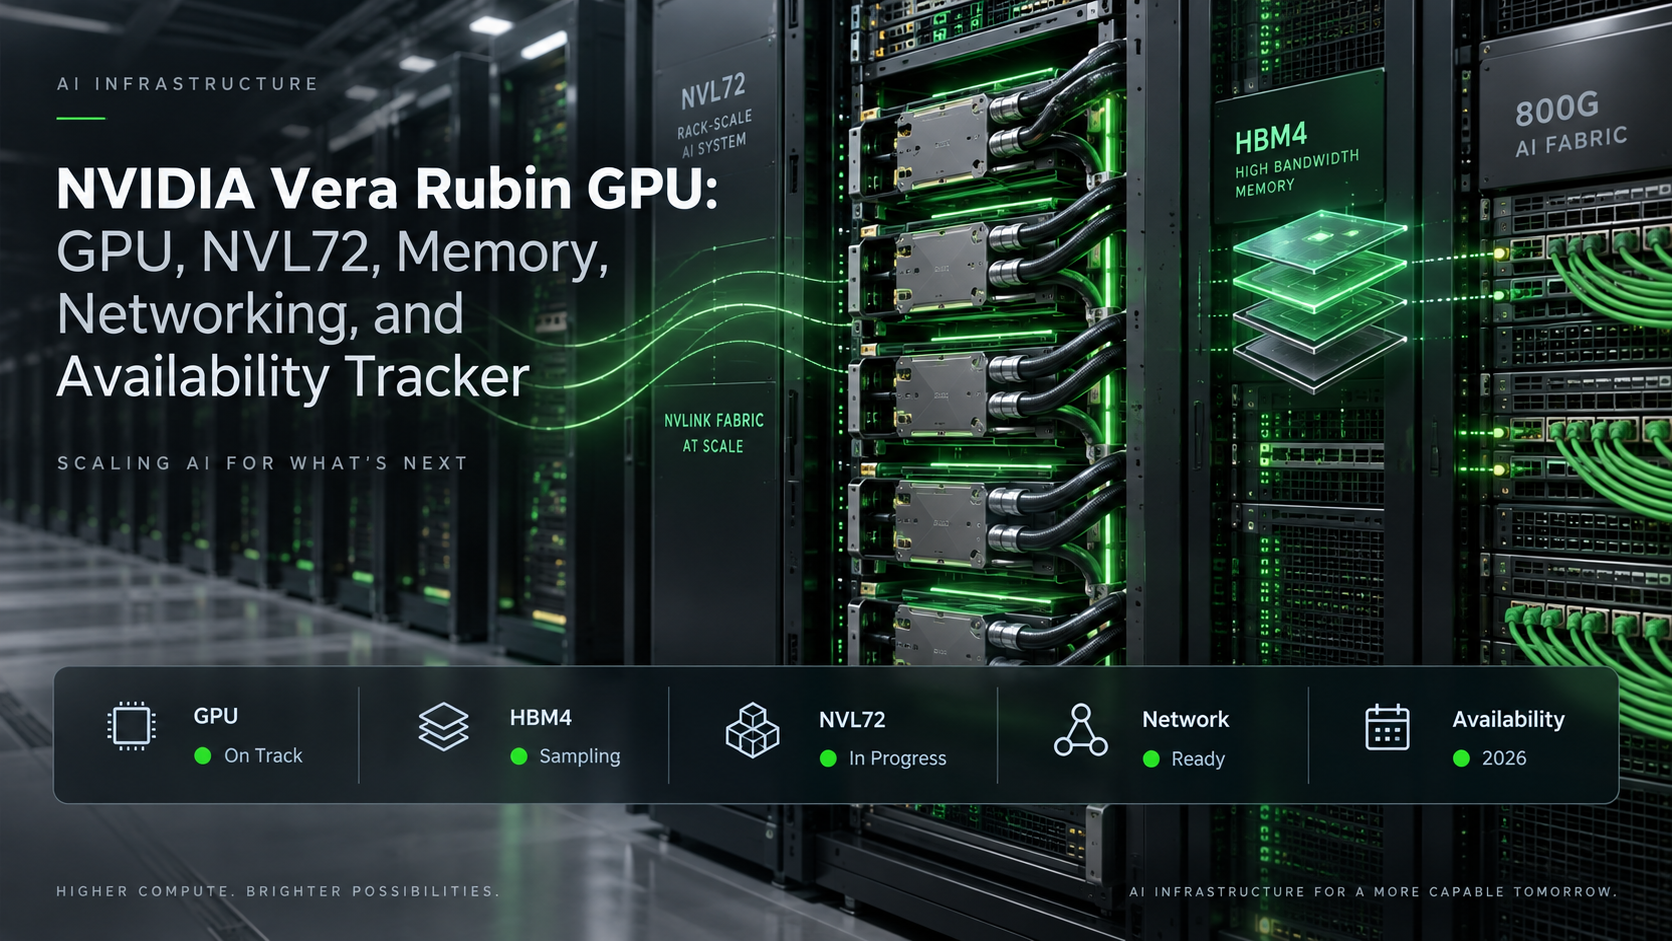
GPU NVIDIA Vera Rubin: GPU, NVL72, Memória, Rede e Rastreador de Disponibilidade
Um rastreador atualizado das especificações da GPU NVIDIA Vera Rubin, DGX Vera Rubin NVL72, memória HBM4, rede e marcos de disponibilidade para compradores de GPUs em nuvem.
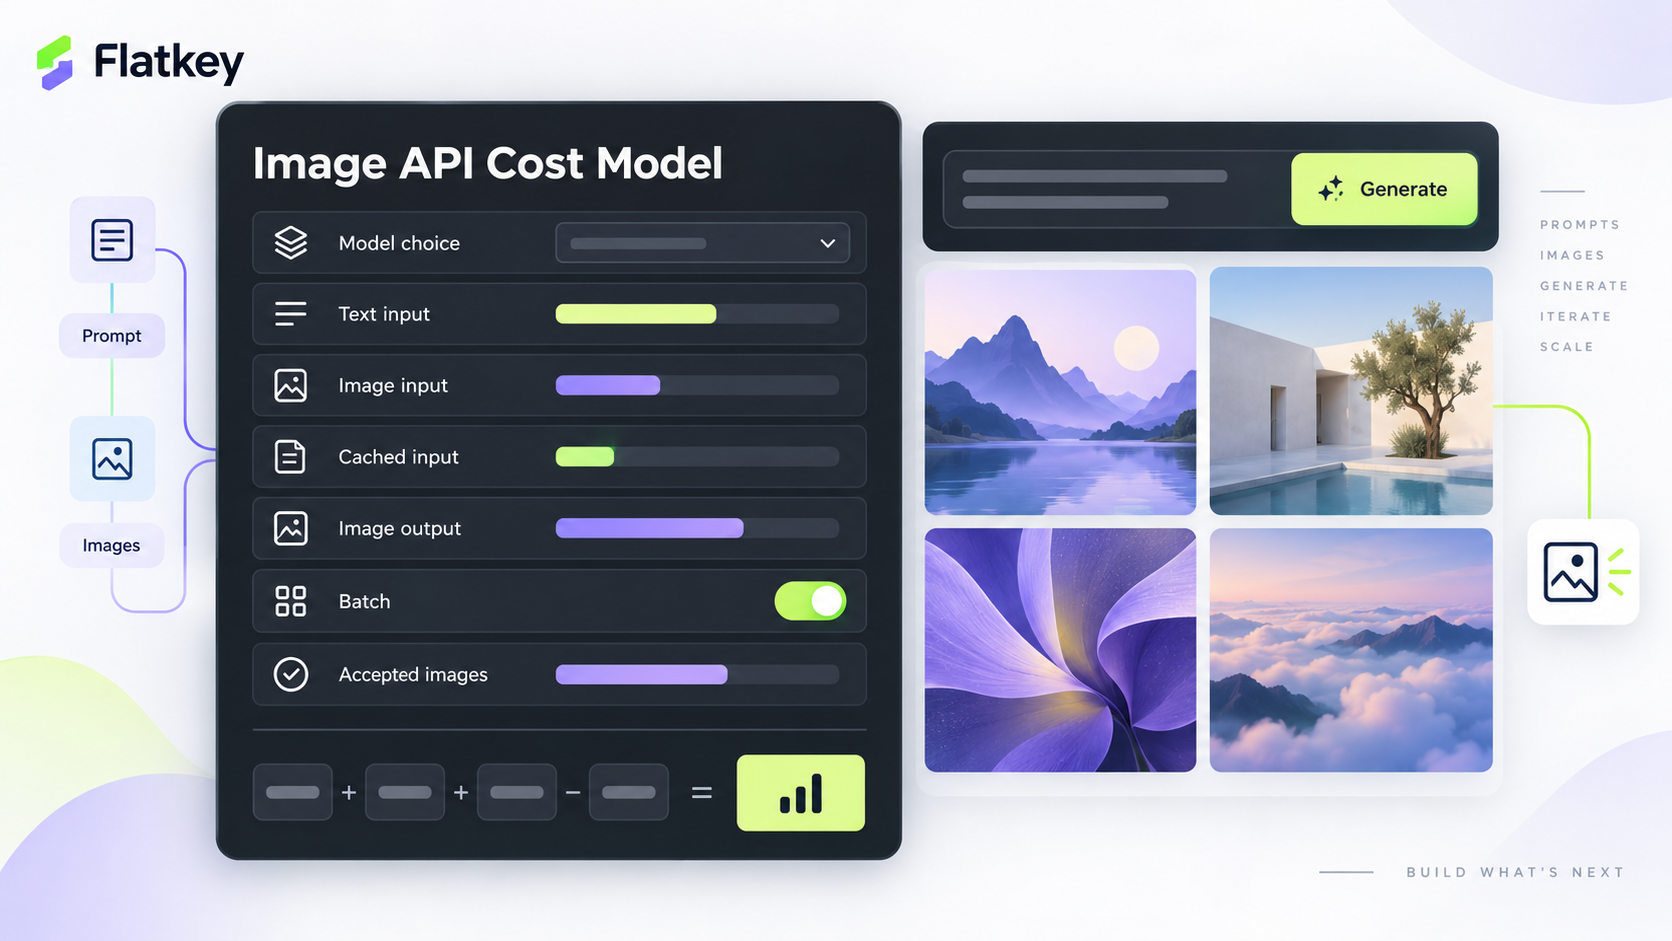
Preços da API de Imagem da OpenAI: taxas do GPT Image 2.5, fórmula de custo e controles de orçamento
Saiba como funciona o preço da API de imagem da OpenAI para o GPT Image 2.5, incluindo taxas por token, regras de entrada em cache, imagens parciais, Batch e custo por imagem aceita.
GB200 vs B200: Superchip Grace Blackwell ou HGX x86?
Compare GB200 vs B200 para aquisição de infraestrutura de IA: sistemas Grace Blackwell em escala de rack NVL72, nós B200 HGX/x86, benchmarks e análises de TCO.
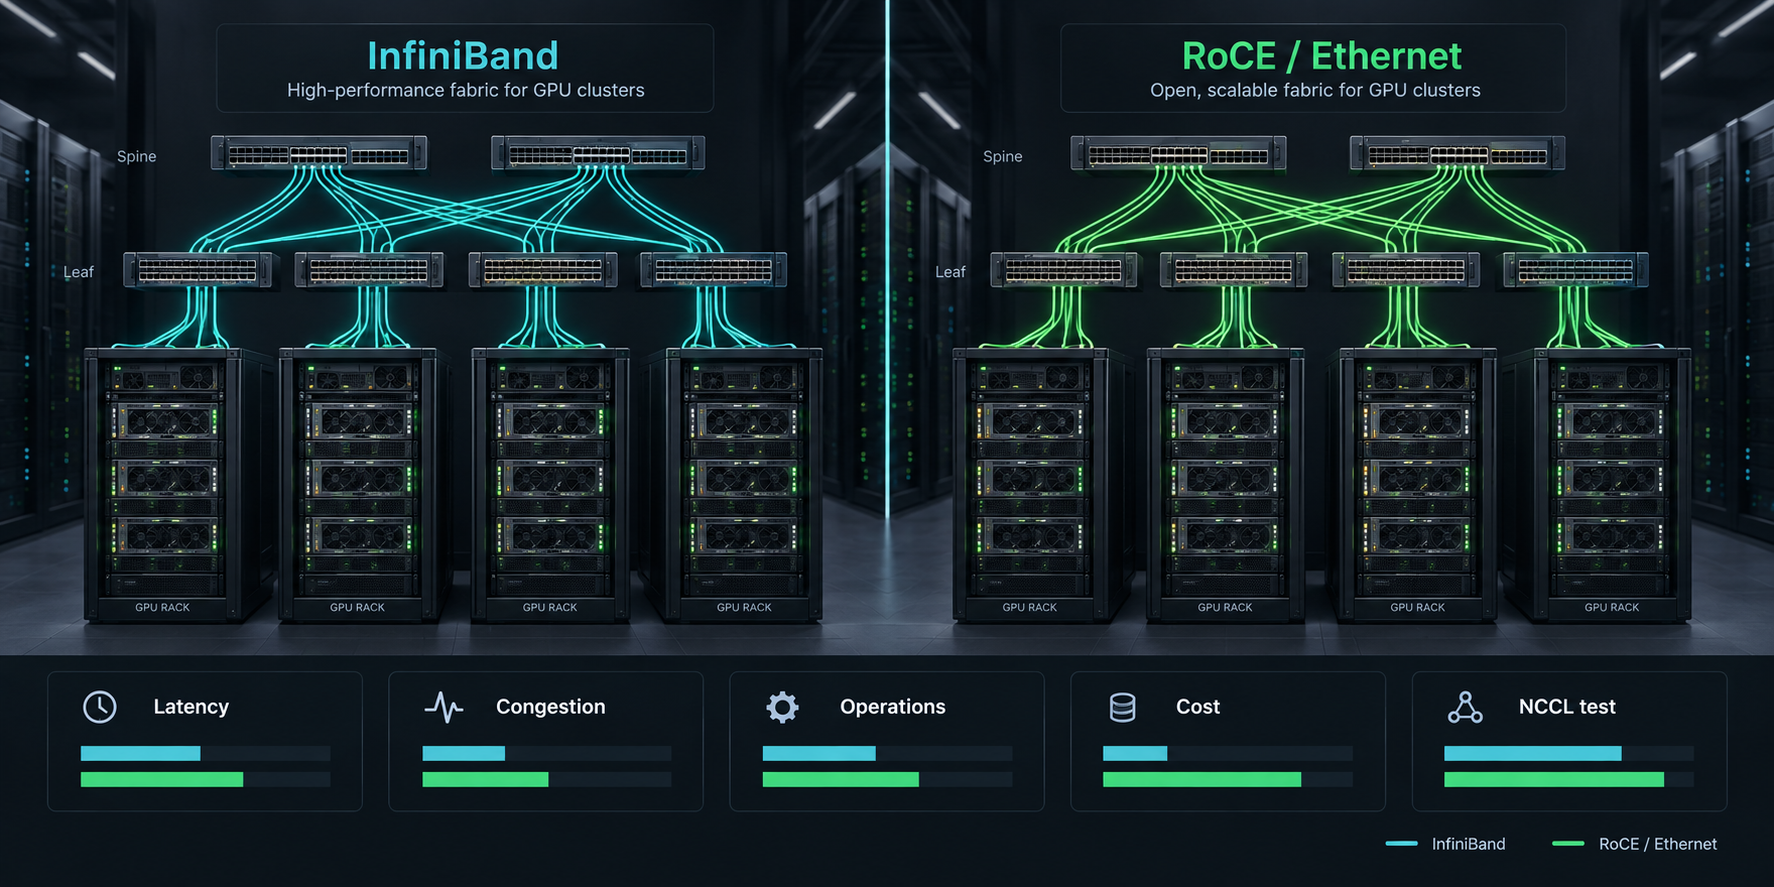
RoCE vs InfiniBand para Clusters de GPU: Latência, Operações e Custo
Compare RoCE e InfiniBand para clusters de GPU multi-nó com uma matriz prática de decisão, teste de aceitação NCCL, modelo de custos e checklist de aquisição.
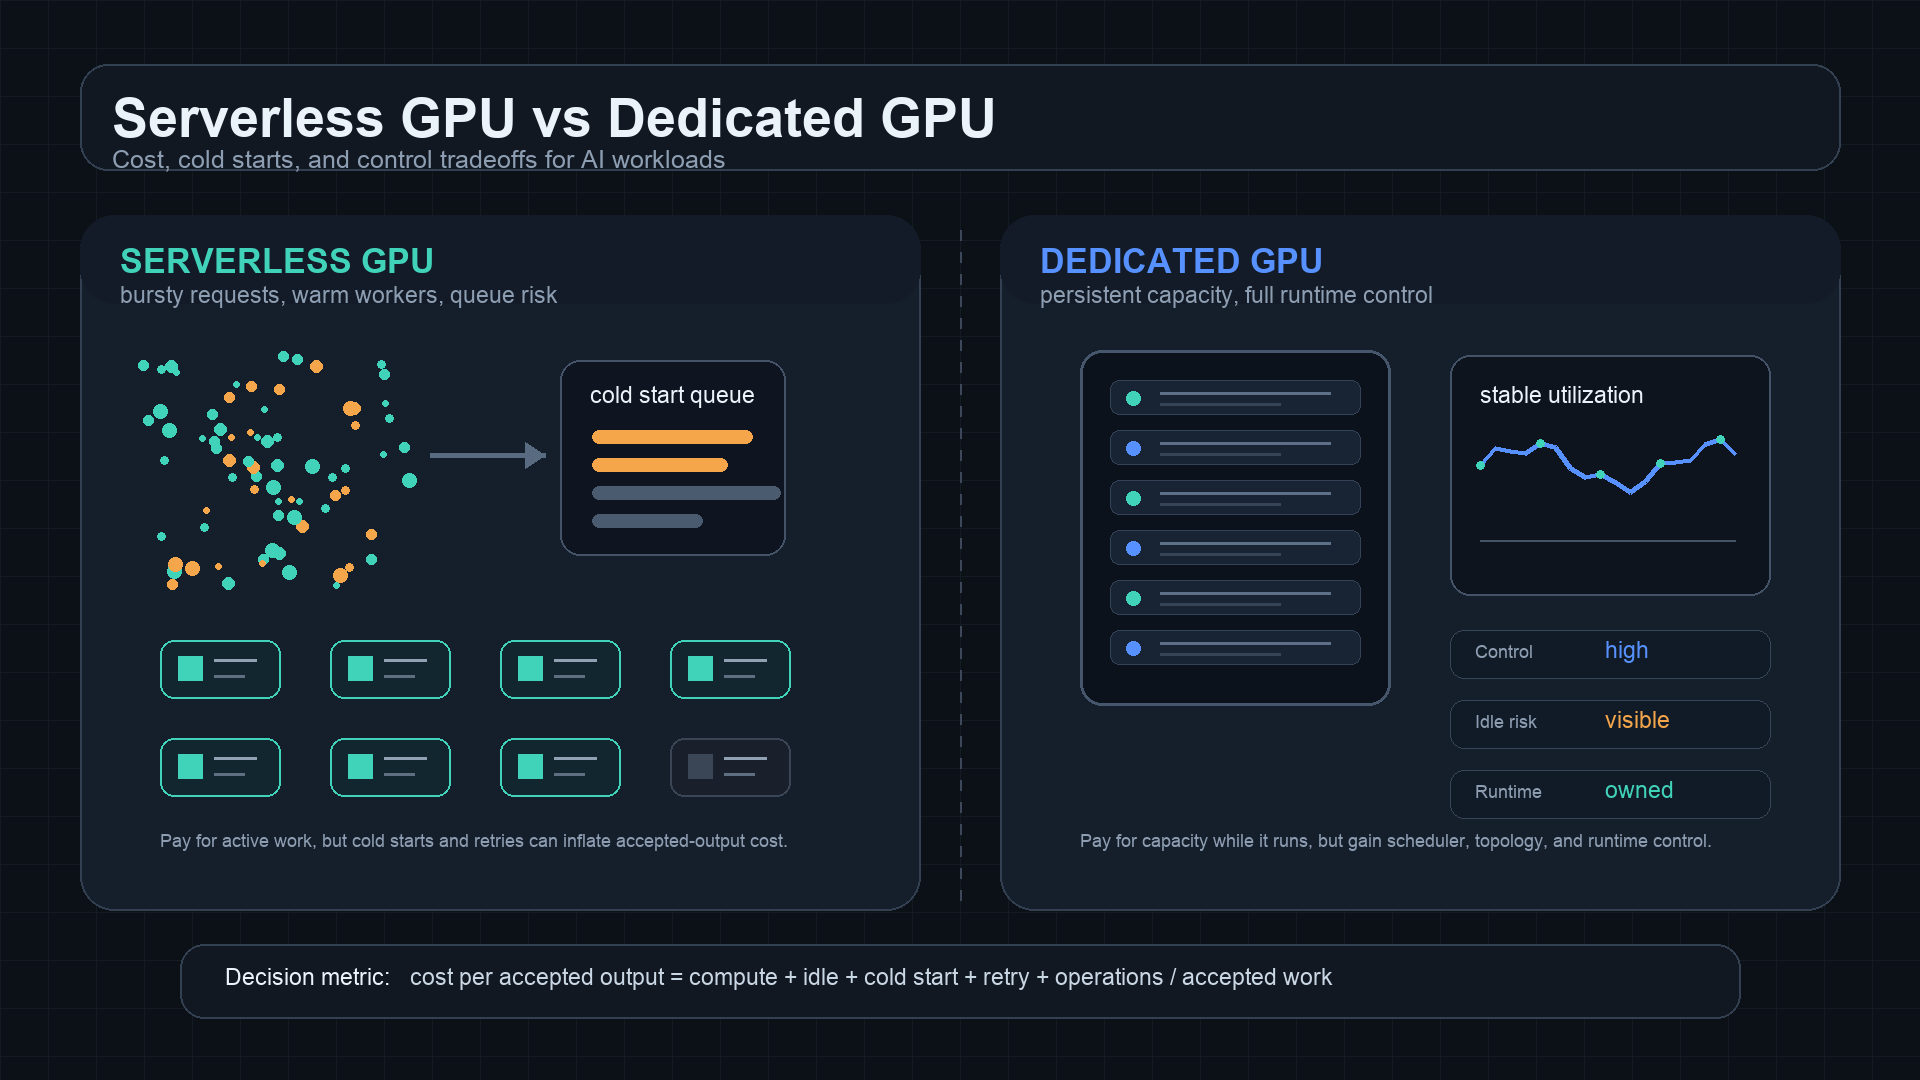
GPU serverless vs GPU dedicado: custo, cold starts e controle
Compare GPU serverless vs GPU dedicado por custo por saída aceita, cold starts, capacidade ociosa, autoscaling e controle operacional.

Comparação de Preços de APIs de Geração de Imagens por IA: GPT Image, Gemini, Imagen e fal
Compare os preços das APIs de geração de imagens entre GPT Image, Gemini Image, Imagen e rotas fal, normalizando as unidades de cobrança em custo por imagem aceita.
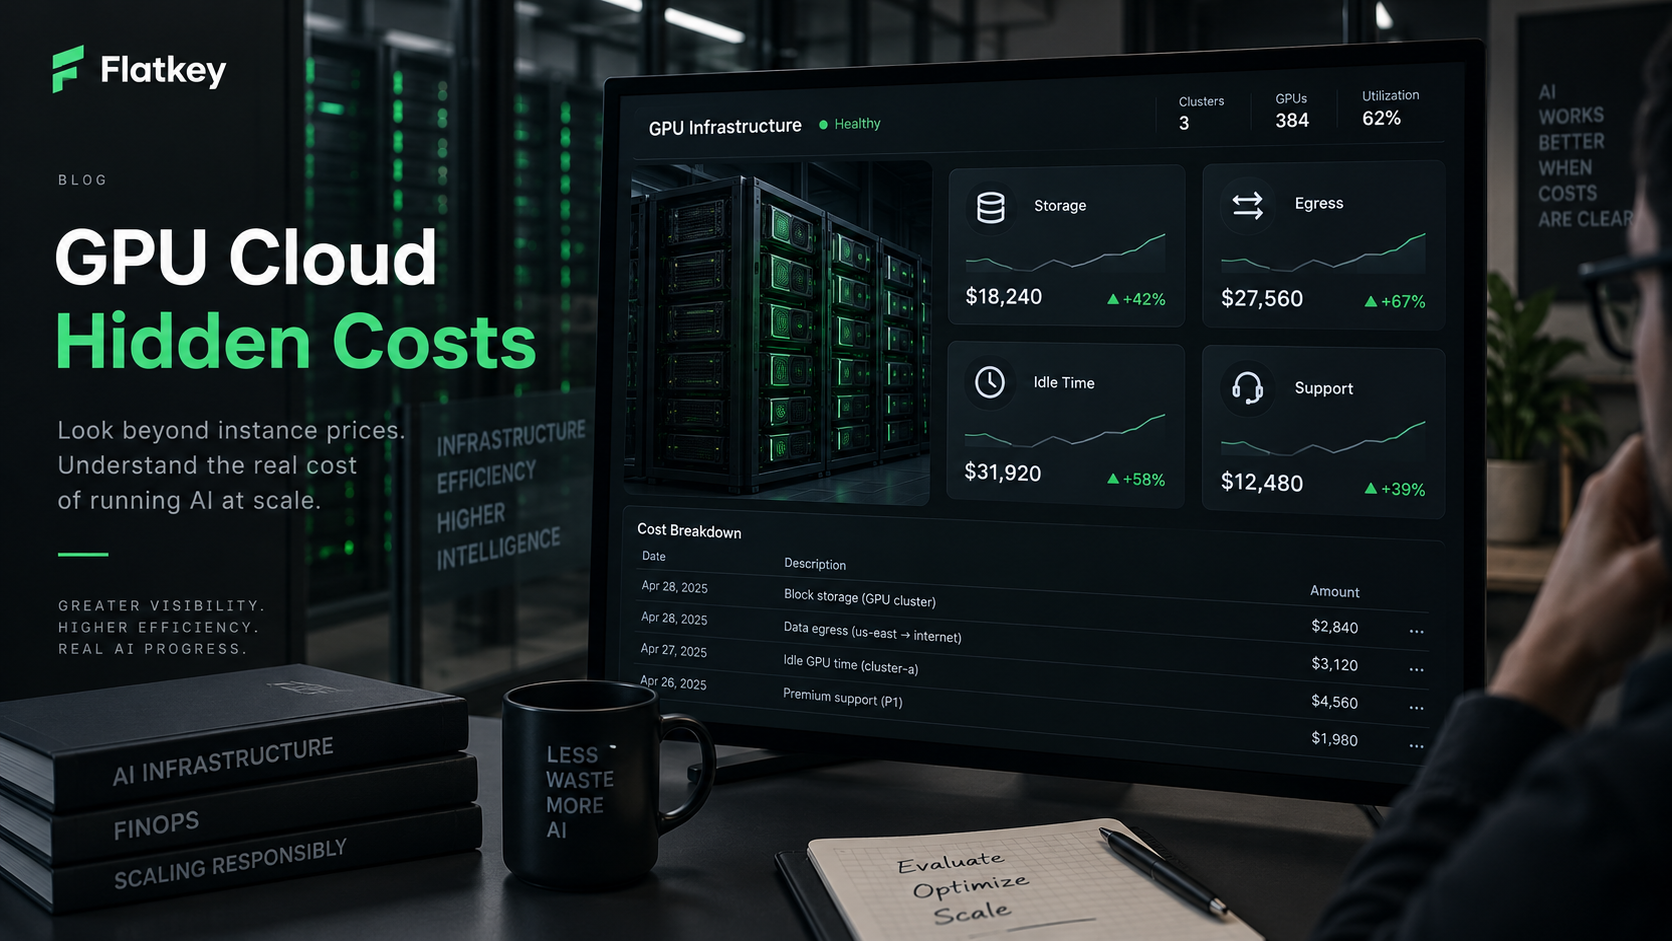
Quais são os custos ocultos dos serviços de GPU na nuvem? Armazenamento, egress, tempo ocioso e suporte
Um guia prático de TCO para GPU na nuvem, para identificar custos de armazenamento, egress, tempo ocioso, falhas de jobs, suporte, rede e operações antes que a fatura chegue.
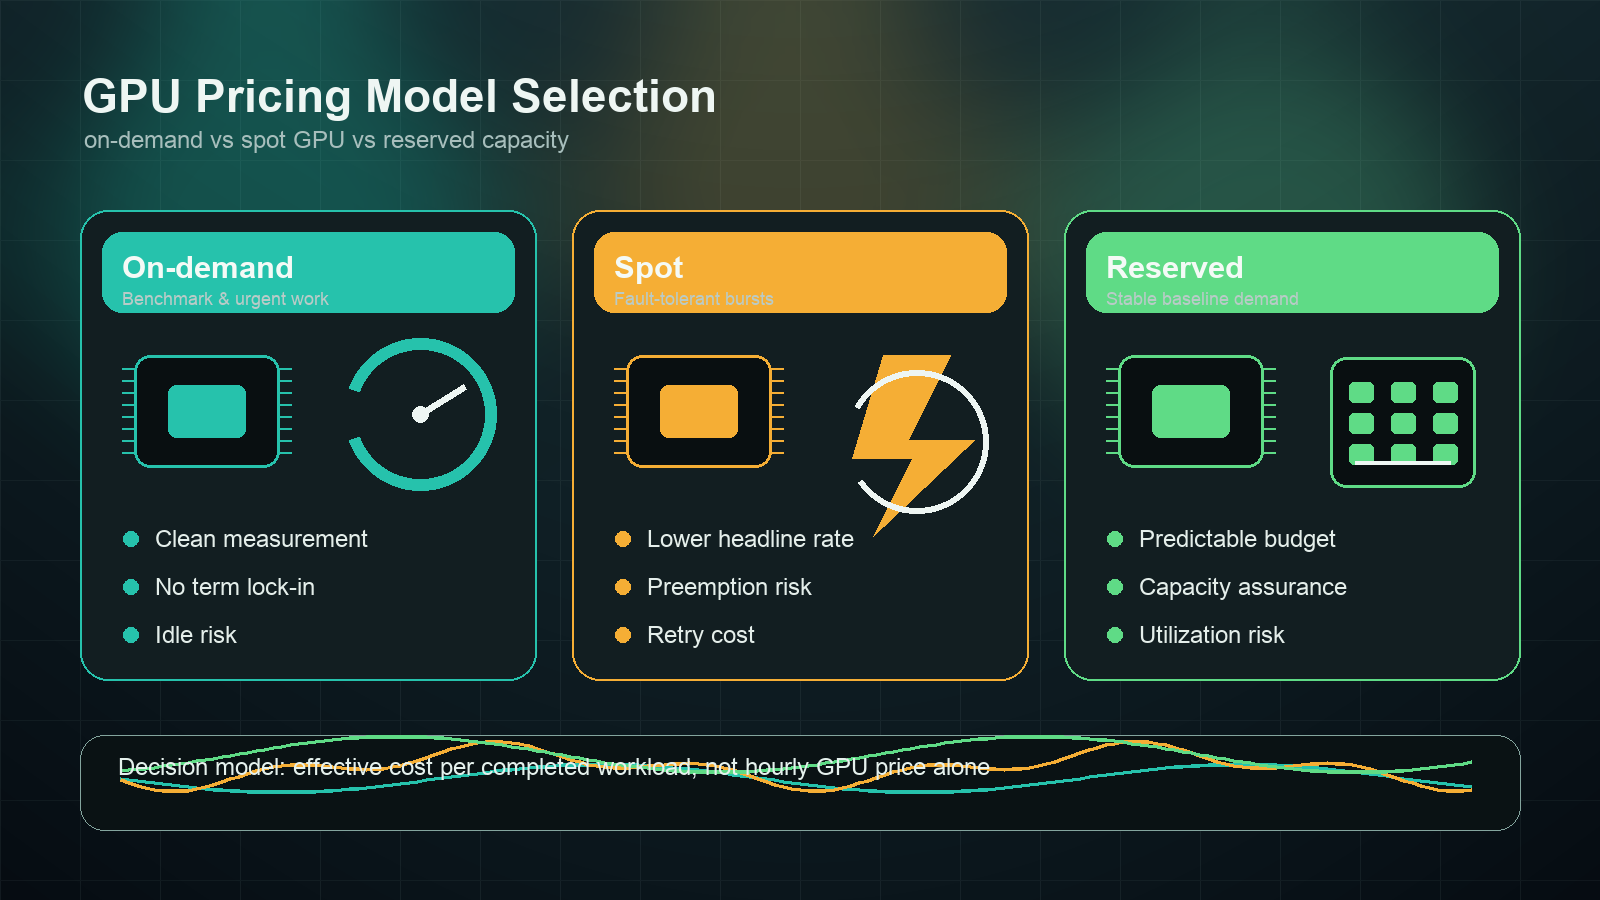
Preços de GPU sob demanda vs spot vs reservada: qual modelo se adapta à sua carga de trabalho?
Uma estrutura orientada pela carga de trabalho para escolher capacidade de GPU sob demanda, spot ou reservada sem confundir a tarifa horária listada com o custo da carga de trabalho concluída.
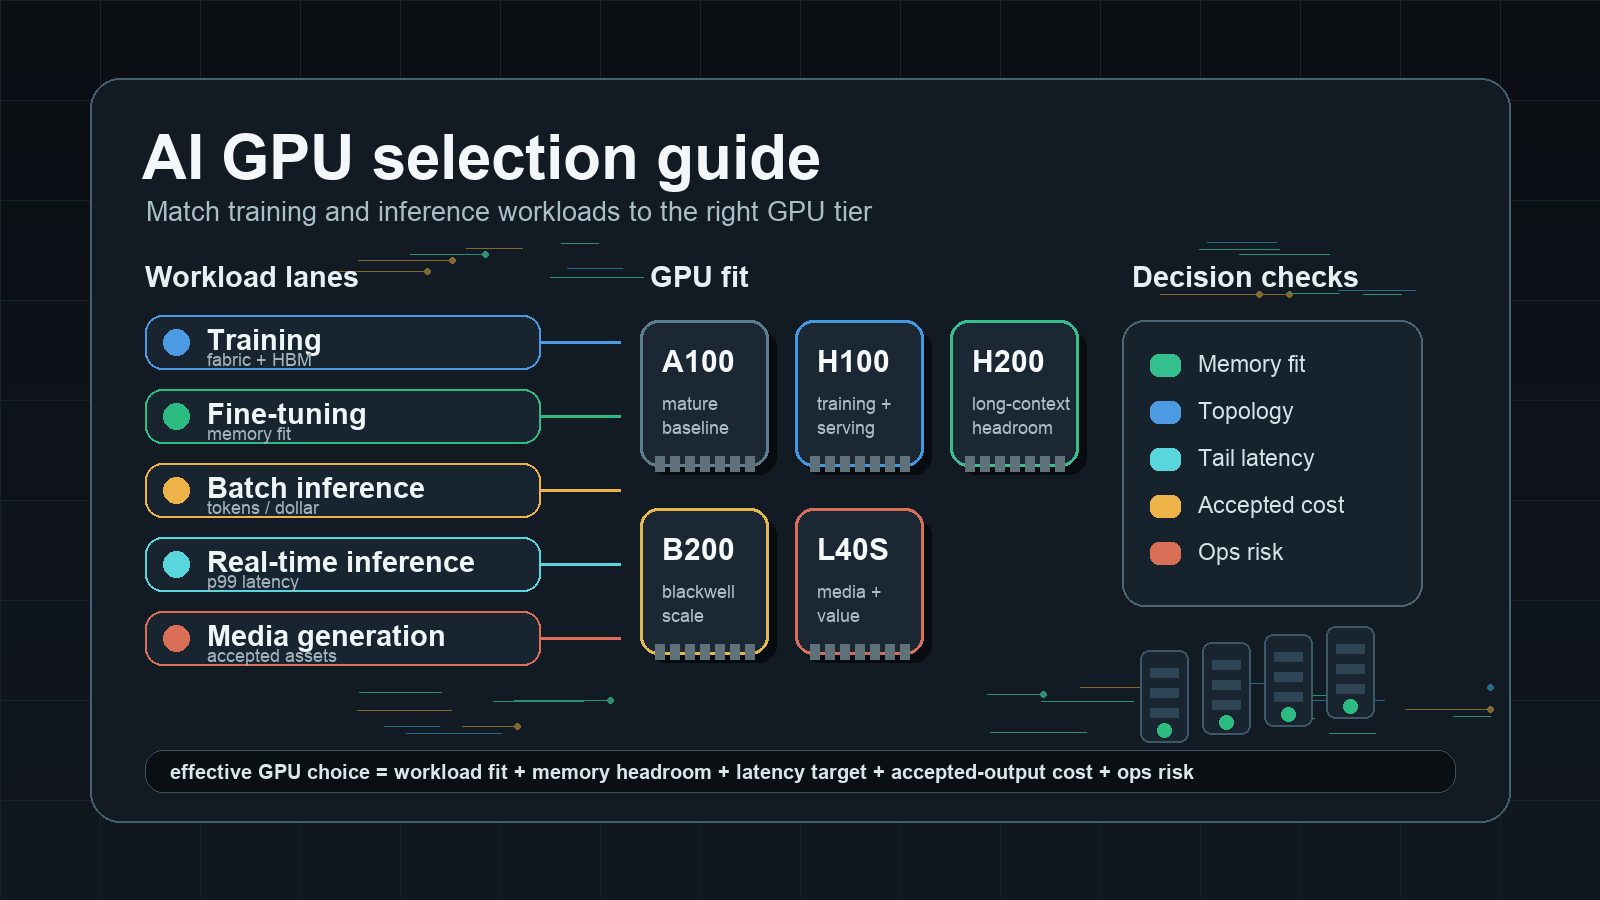
Guia de Seleção de GPU para IA: Combine Cargas de Trabalho de Treinamento e Inferência com a GPU Certa
Um guia prático de seleção de GPU para IA, voltado a equipes que precisam alinhar cargas de trabalho de treinamento, fine-tuning, inferência de LLMs, geração de mídia e avaliação à GPU e ao modelo de capacidade certos.
Nuvem Privada de GPU: Arquitetura, Isolamento e Modelo Operacional
Saiba como avaliar a arquitetura de nuvem privada de GPU, o isolamento, a propriedade do scheduler, as evidências de segurança, o modelo operacional, o TCO e os testes de aceitação.

Guia de Implantação do vLLM: Sirva uma API de LLM Compatível com a OpenAI em GPUs
Implante o vLLM como uma API compatível com a OpenAI em GPUs com Docker, RunPod Serverless, Ray Serve, métricas, controles de rollout e verificações de custo por saída aceita.
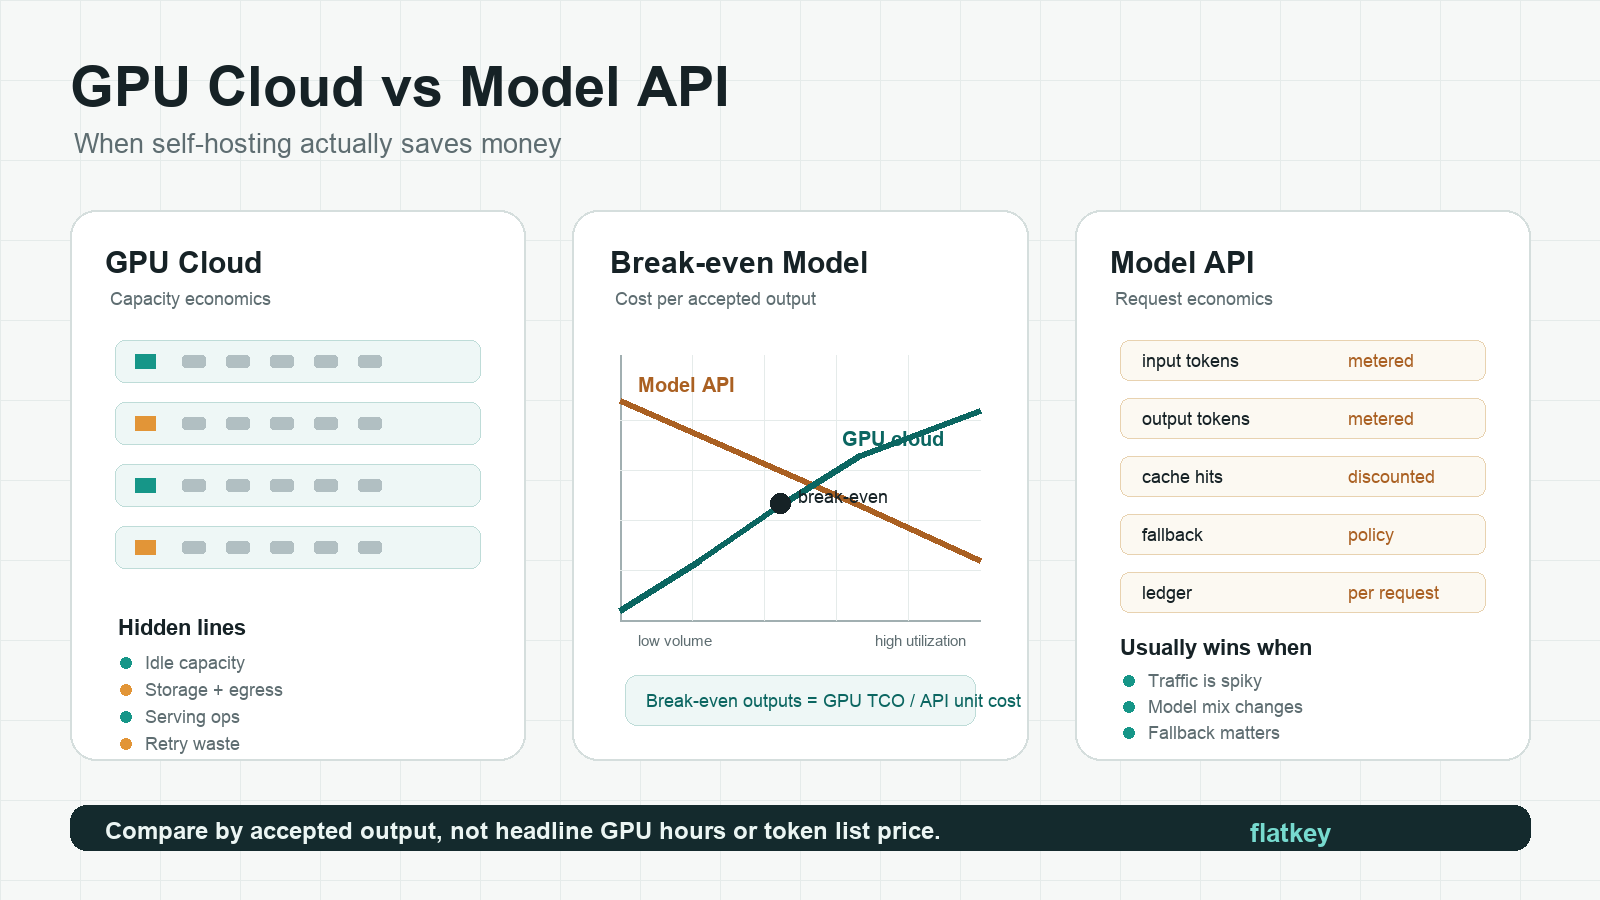
GPU Cloud vs API de Modelo: Quando a Auto-hospedagem Realmente Economiza Dinheiro
Compare a economia entre GPU cloud e API de modelo com uma planilha de ponto de equilíbrio para custo por saída aceita, utilização, retries, capacidade ociosa e operações de serving.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar