
Затраты, оплата и эксплуатация
Последние статьи в категории Затраты, оплата и эксплуатация.
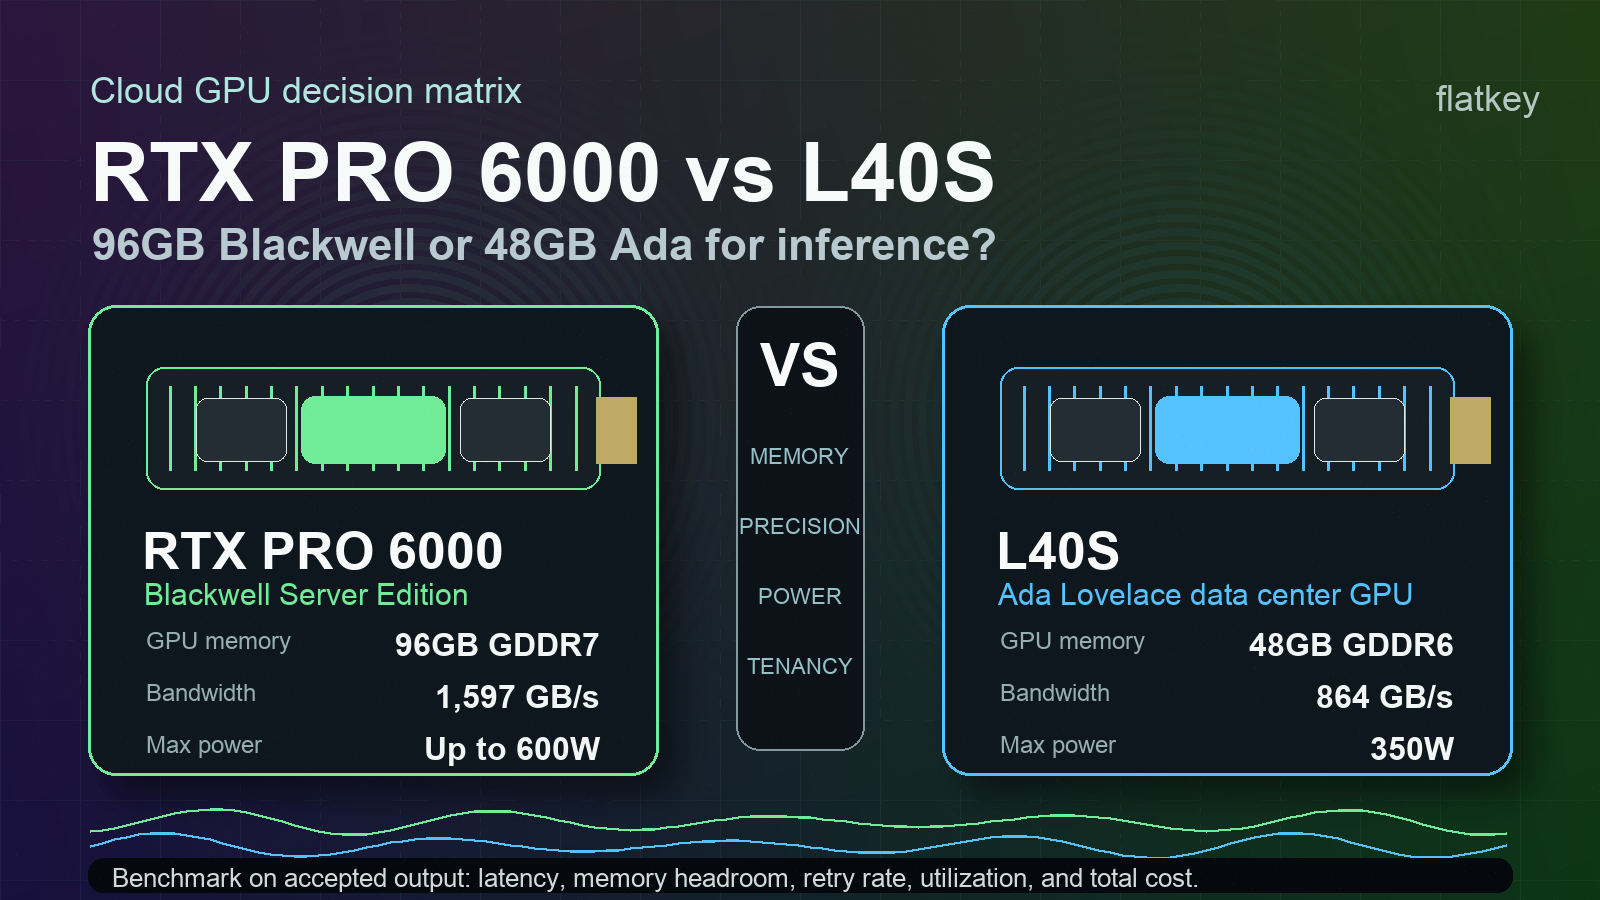
RTX PRO 6000 против L40S: 96 ГБ Blackwell или Ada GPU для инференса?
Сравните NVIDIA L40S и RTX PRO 6000 Blackwell Server Edition для инференса LLM, мультимодальных нагрузок, соответствия объёму памяти, энергопотребления и стоимости принятого выхода.
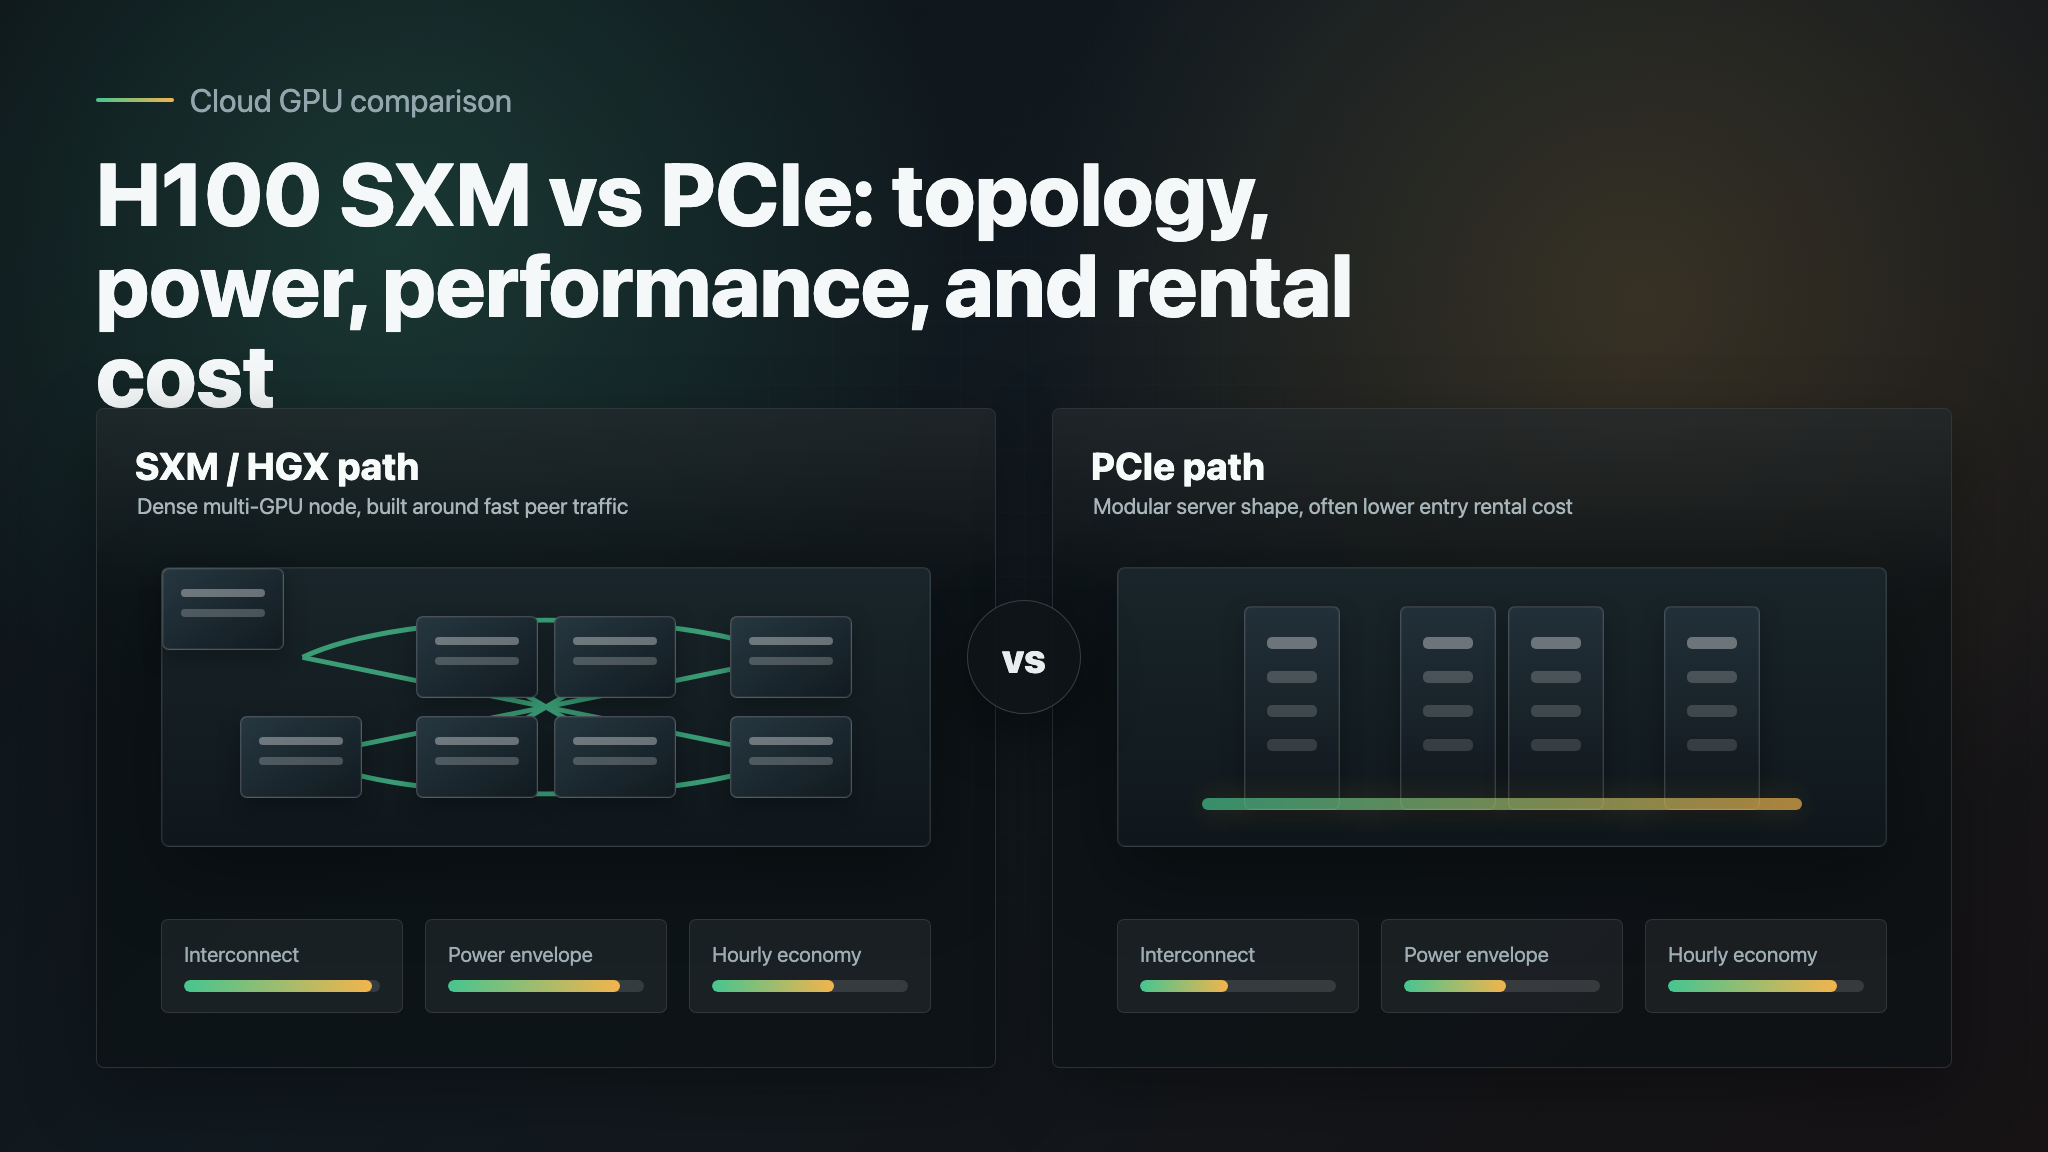
H100 SXM vs PCIe: NVLink, Power, Performance и стоимость аренды
Сравните H100 PCIe и SXM по NVLink, энергопотреблению, производительности рабочих нагрузок и стоимости аренды перед арендой облачных GPU.
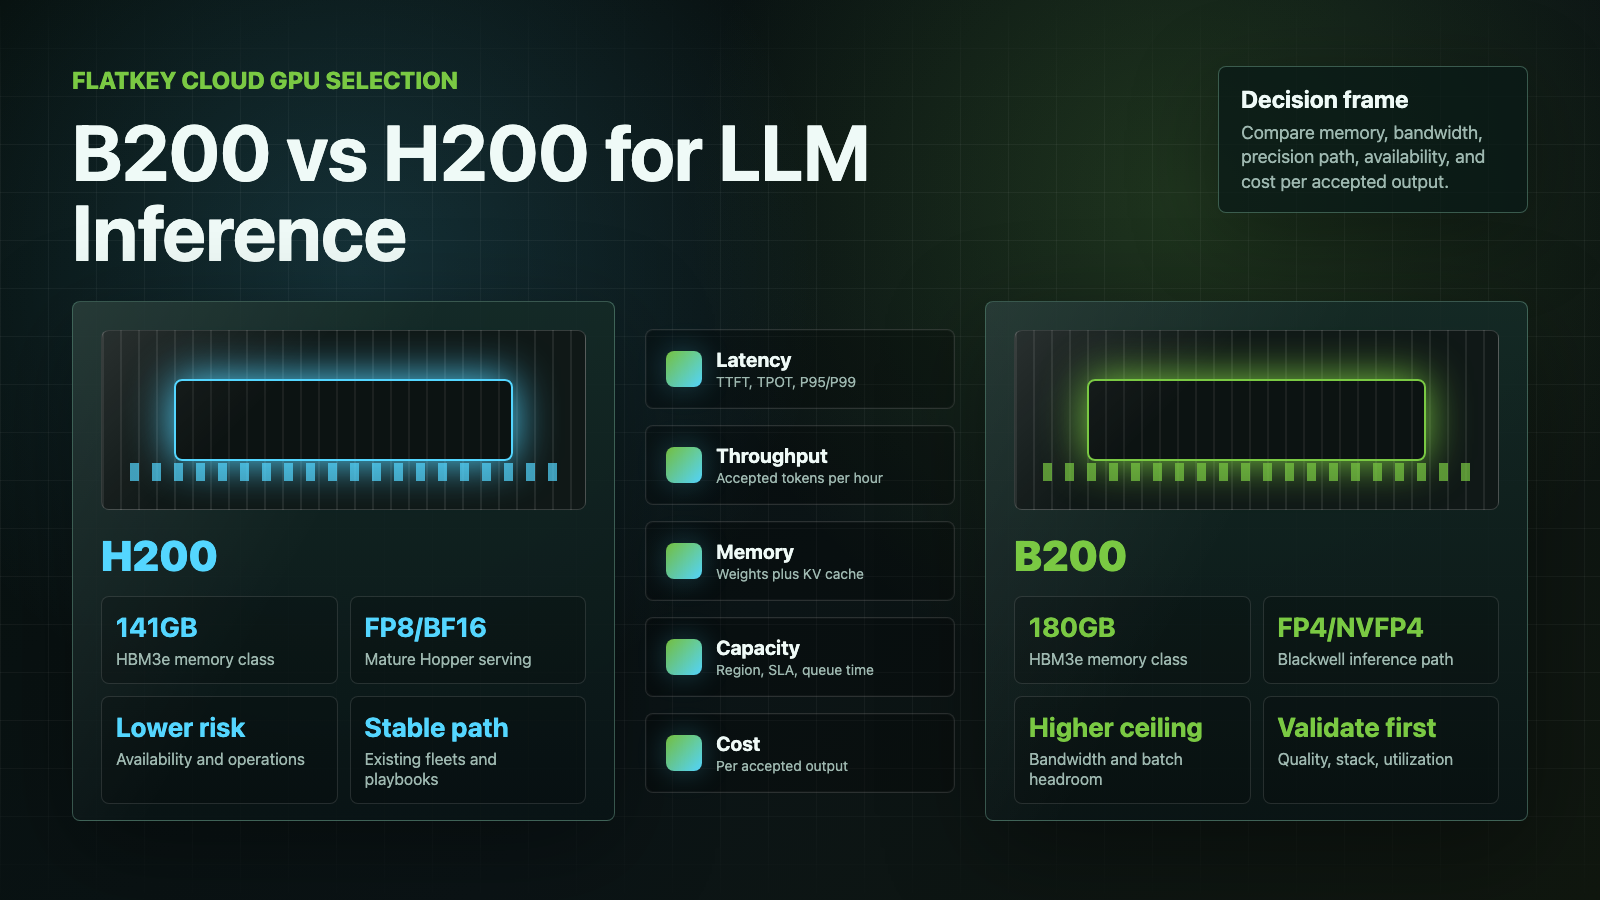
NVIDIA B200 против H200: какой GPU лучше для инференса LLM?
Сравните NVIDIA B200 и H200 для инференса LLM по объёму памяти, пропускной способности, поддержке точности, системам DGX, доступности облачных GPU и стоимости за принятый результат.
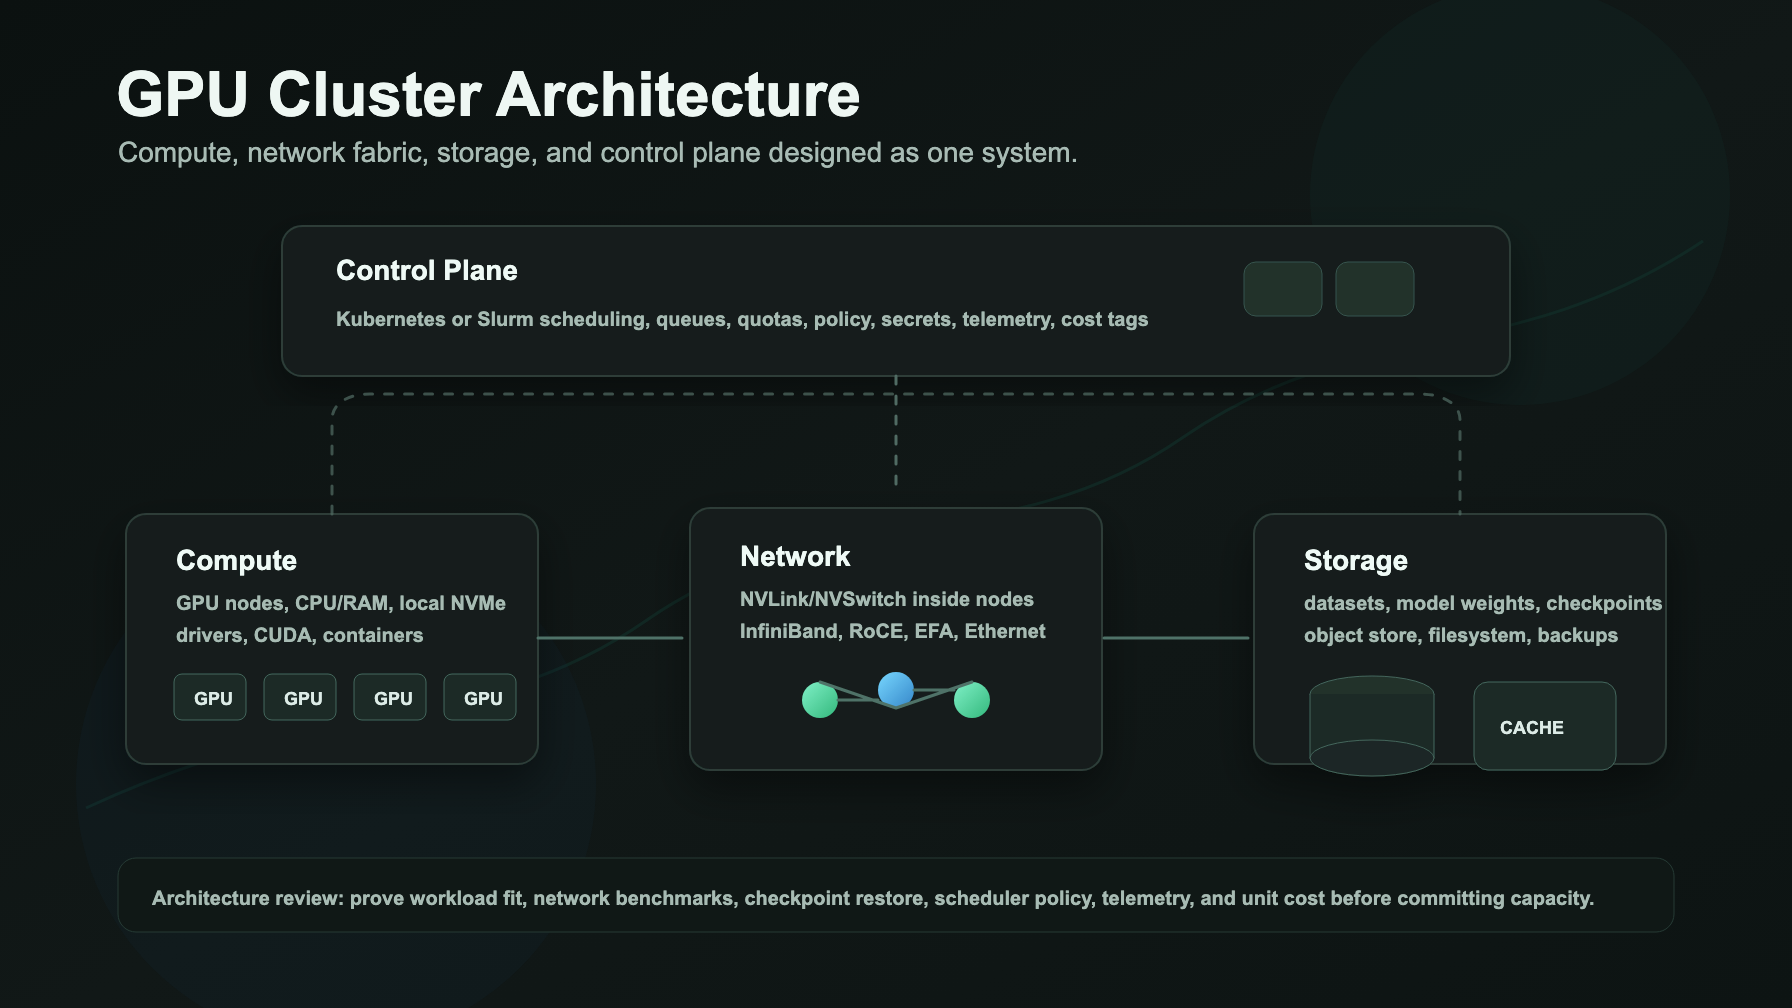
Архитектура GPU-кластера: вычисления, сеть, хранилище и control plane
Практическое руководство по архитектуре GPU-кластера: вычислительные узлы, сетевой fabric, хранилище, control plane Kubernetes или Slurm, наблюдаемость и приемочные тесты.
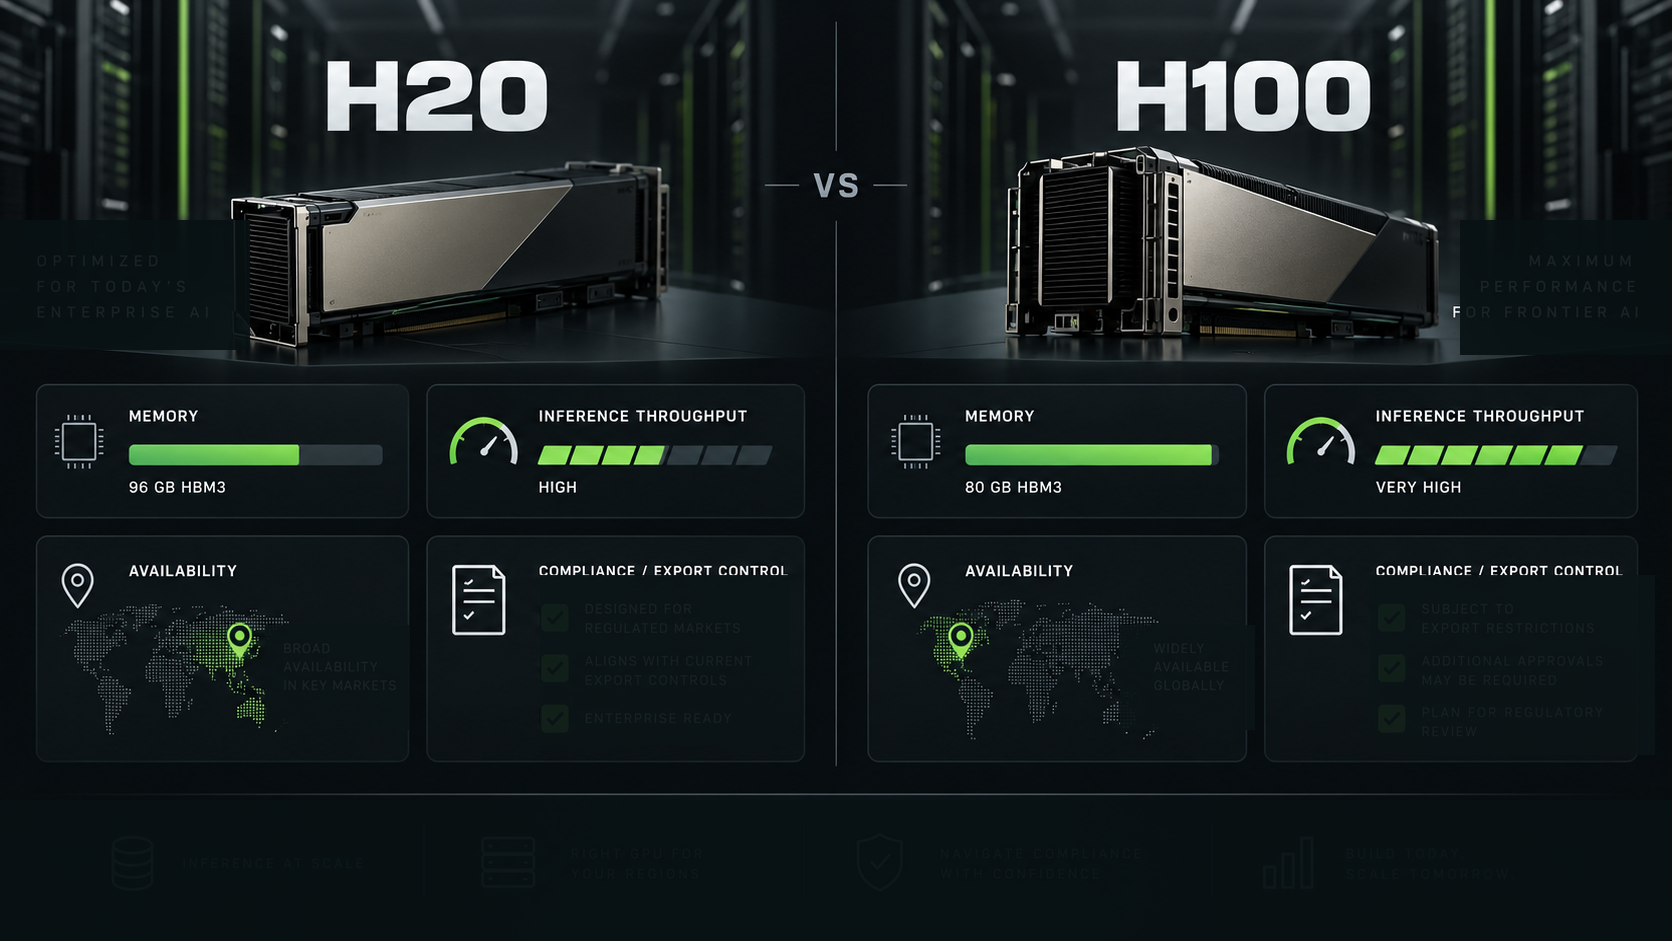
NVIDIA H20 vs H100: инференс, память, доступность и соответствие требованиям
Практическое сравнение H20 и H100 для корпоративных AI-команд: инференс, память, доступность, риски экспортного контроля и случаи, когда H200 или API моделей являются более удачной базой.
Лучшие платформы аренды облачных GPU 2026: цена, мощность, сеть и поддержка
Практическая подборка облачных GPU-платформ на 2026 год для AI-команд: сравнение ценовой политики, доступных мощностей, сети, поддержки и случаев, когда API модели — более удачная отправная точка.
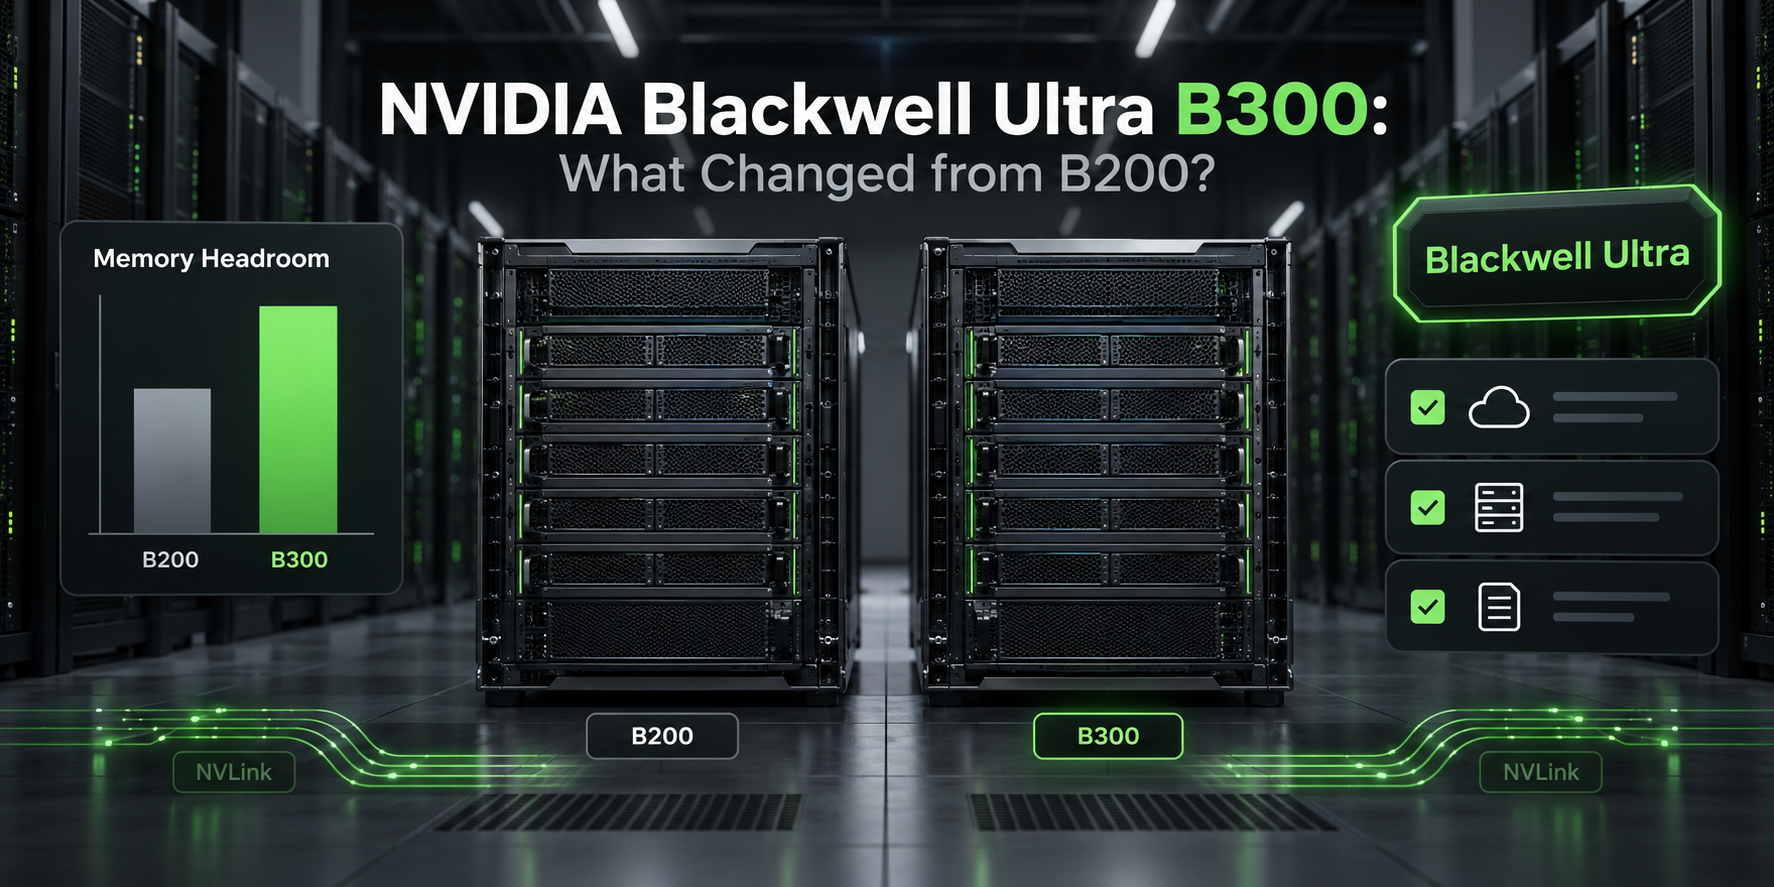
NVIDIA Blackwell Ultra B300: Что изменилось по сравнению с B200?
Практический трекер NVIDIA B300 Blackwell Ultra для команд AI-инфраструктуры: сравнение характеристик B300, статуса выпуска, оговорок по цене и пригодности для рабочих нагрузок с B200.
AMD MI455X и Helios: трекер архитектуры, памяти и доступности
Трекер AMD MI455X и Helios для покупателей: архитектура, память HBM4, пропускная способность, доступность, готовность к vLLM, вопросы к провайдерам и стратегия резервного перехода на модели/API.
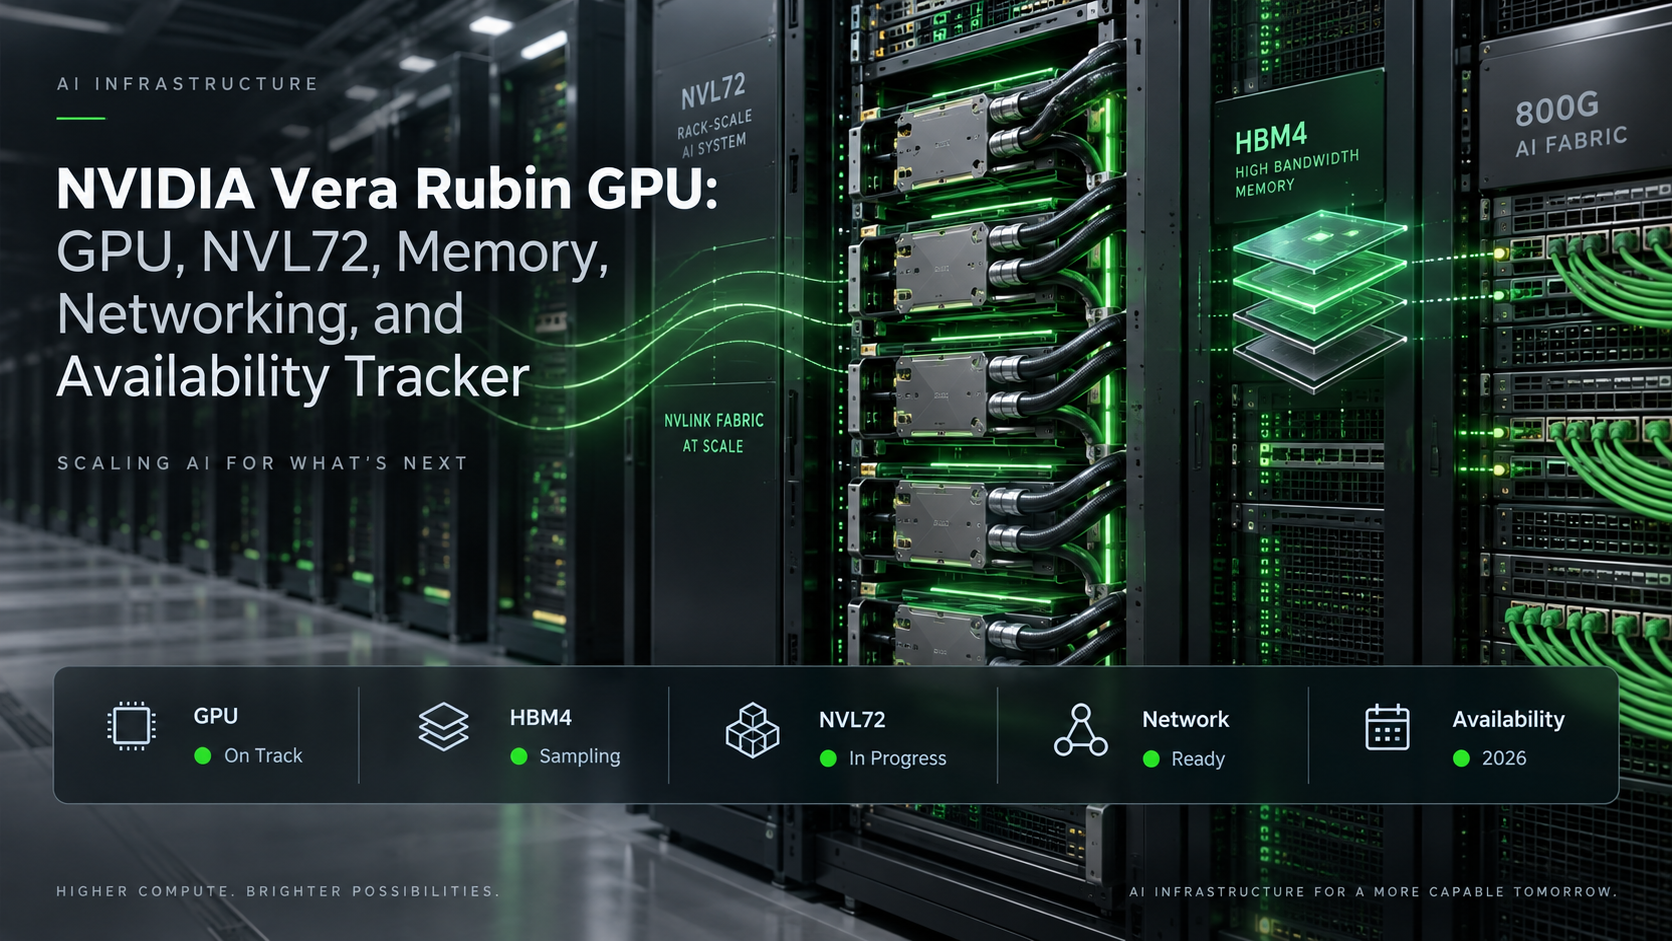
GPU NVIDIA Vera Rubin: трекер GPU, NVL72, памяти, сети и доступности
Актуальный трекер характеристик NVIDIA Vera Rubin GPU, DGX Vera Rubin NVL72, памяти HBM4, сетевых возможностей и этапов доступности для покупателей облачных GPU.
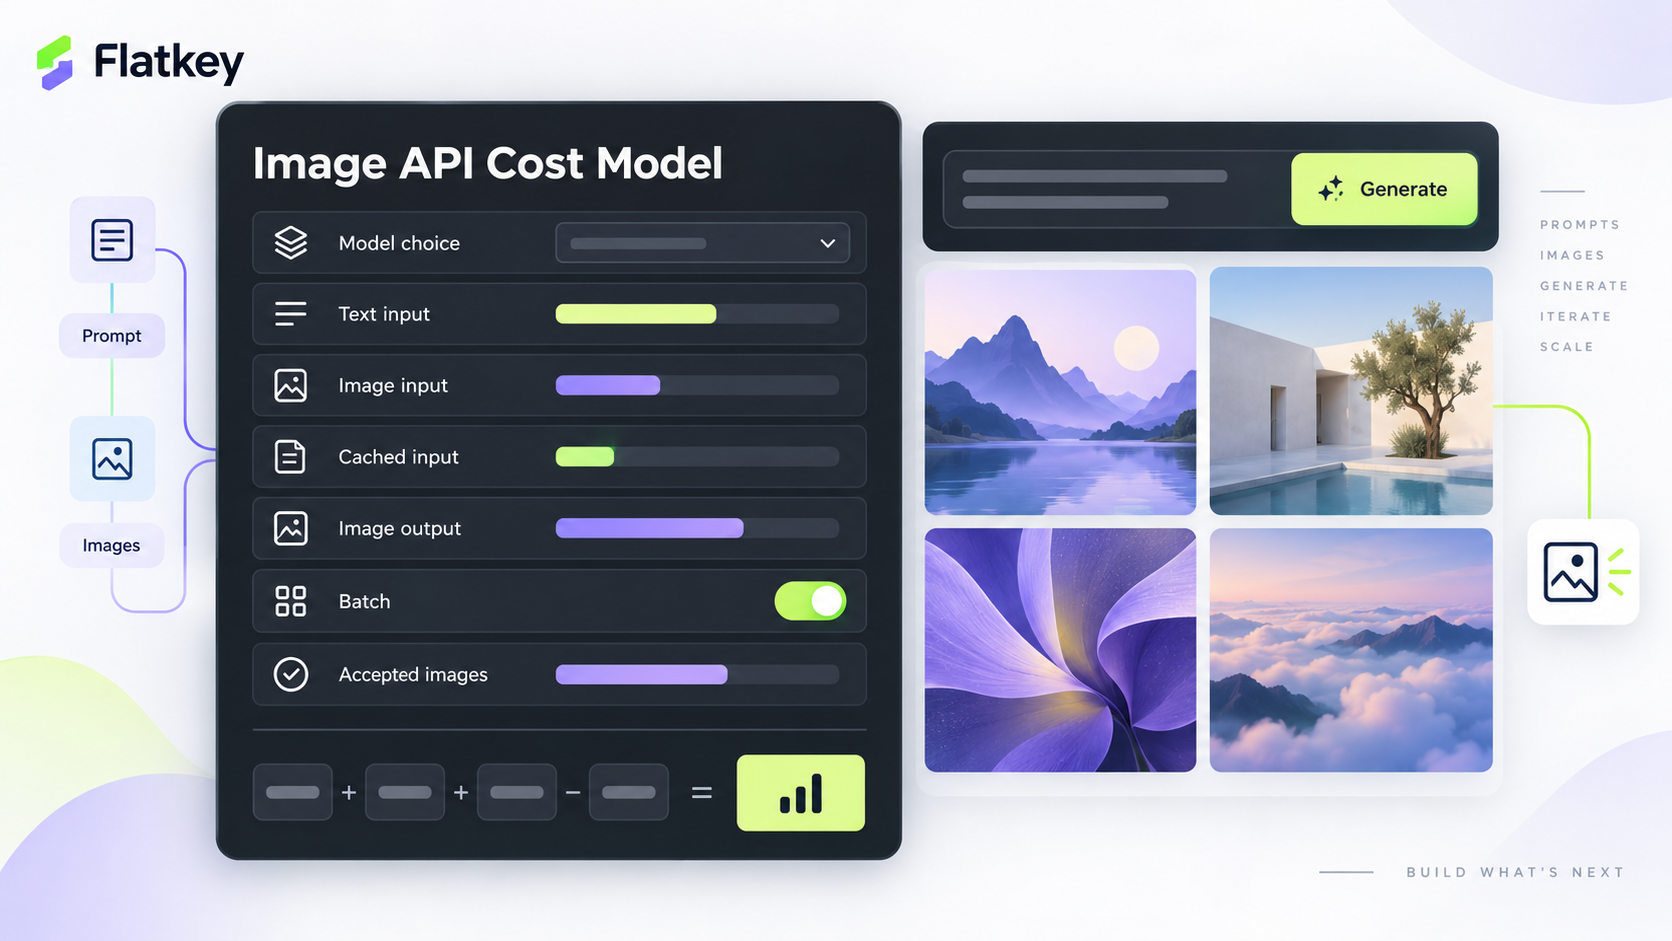
Цены OpenAI Image API: тарифы GPT Image 2.5, формула расчёта стоимости и контроль бюджета
Узнайте, как работает ценообразование OpenAI Image API для GPT Image 2.5, включая тарифы по токенам, правила кэшированного ввода, частичные изображения, Batch и стоимость за принятое изображение.
GB200 vs B200: суперчип Grace Blackwell или x86 HGX?
Сравните GB200 и B200 для закупки AI-инфраструктуры: системы Grace Blackwell масштаба стойки NVL72, узлы B200 HGX/x86, бенчмарки и проверка TCO.
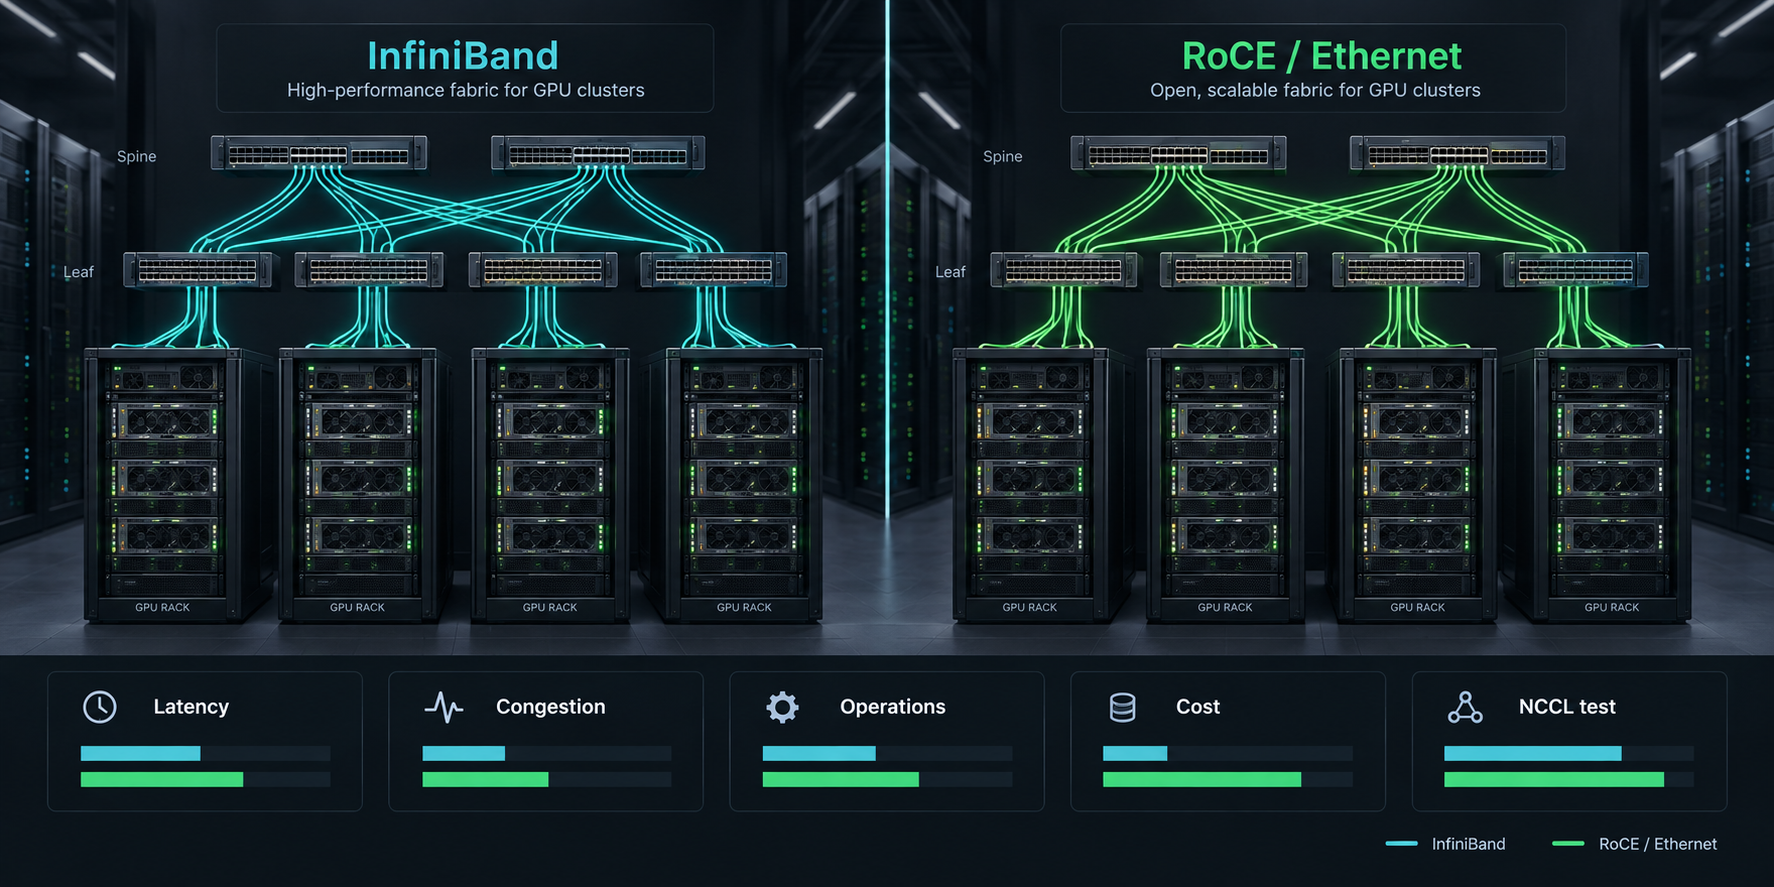
RoCE vs InfiniBand для GPU-кластеров: задержка, эксплуатация и стоимость
Сравните RoCE и InfiniBand для многоузловых GPU-кластеров с помощью практической матрицы принятия решений, теста приемки NCCL, модели затрат и чек-листа для закупок.
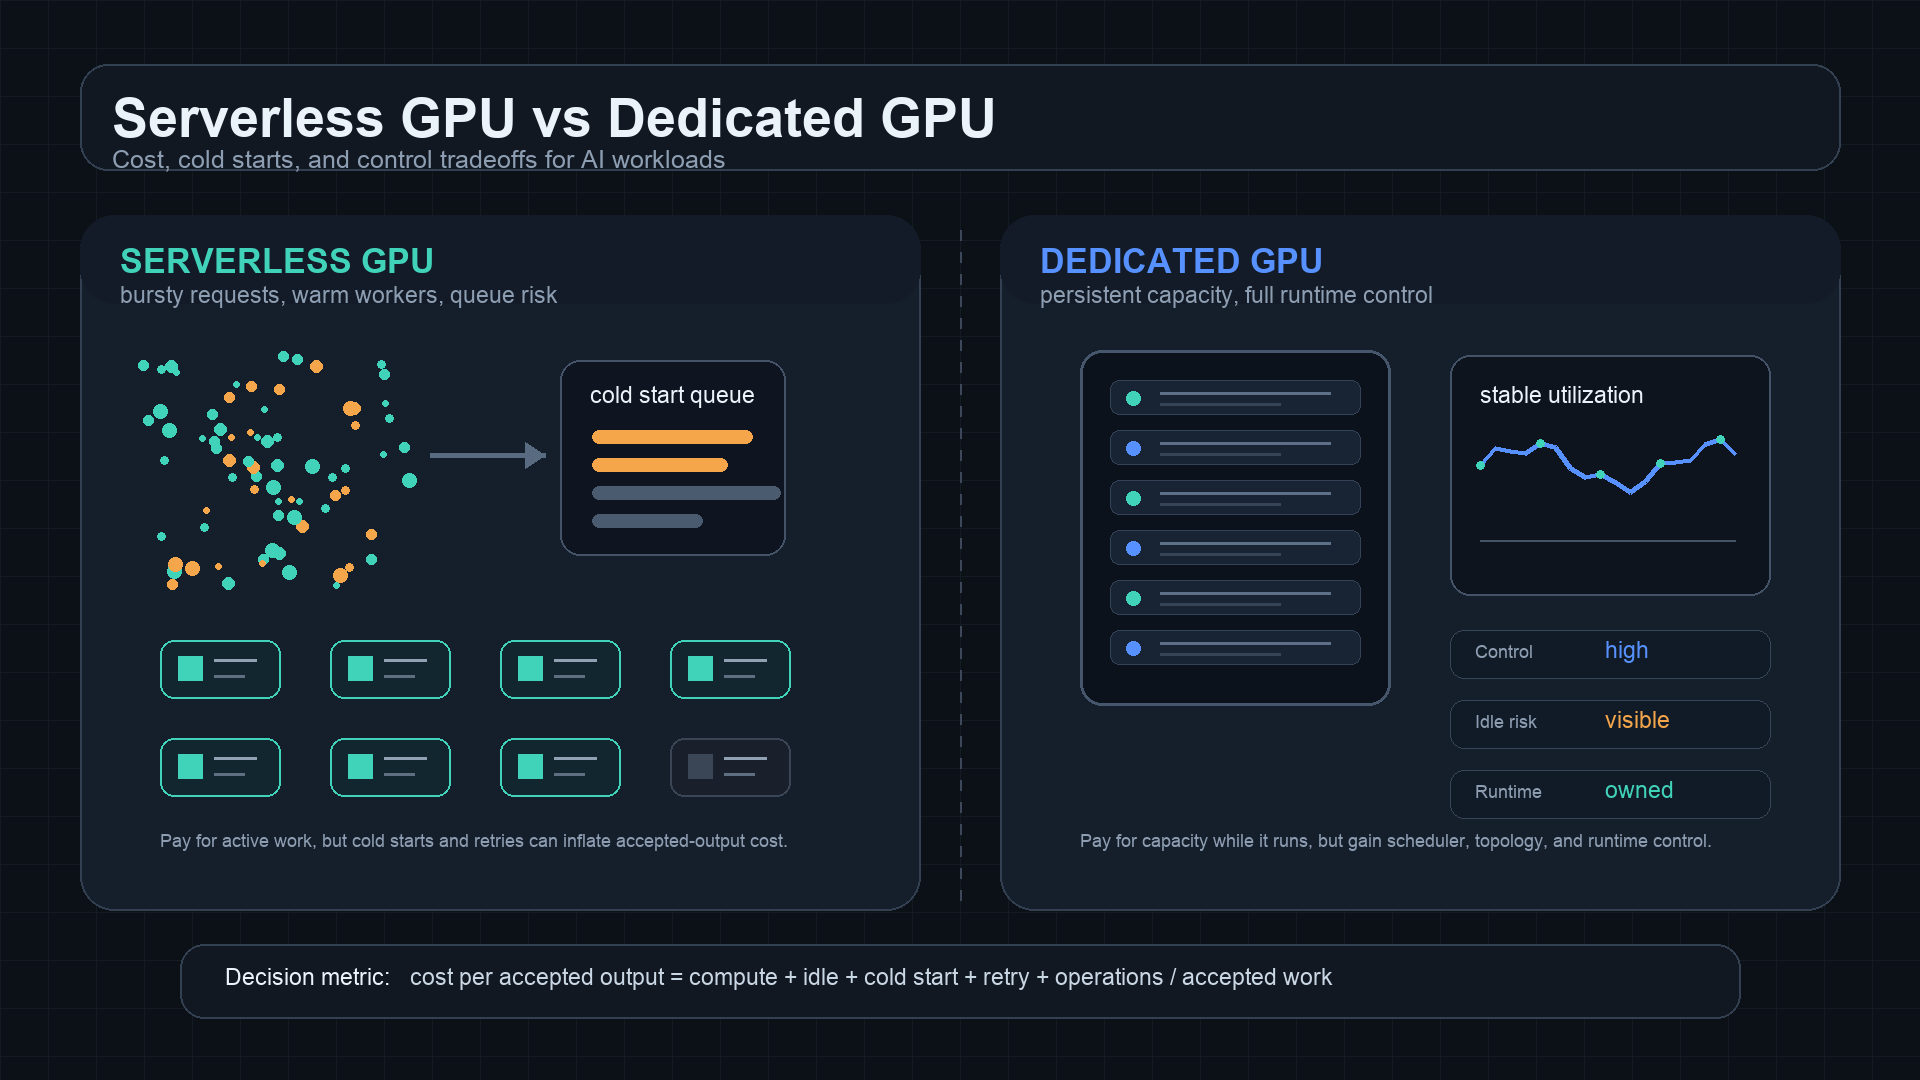
Serverless GPU vs Dedicated GPU: Стоимость, cold start и контроль
Сравните serverless GPU и dedicated GPU по стоимости за принятый результат, cold start, простаивающей мощности, autoscaling и операционному контролю.

Сравнение цен на API генерации изображений с помощью ИИ: GPT Image, Gemini, Imagen и fal
Сравните цены API генерации изображений для GPT Image, Gemini Image, Imagen и маршрутов fal, нормализуя единицы биллинга до стоимости за принятое изображение.
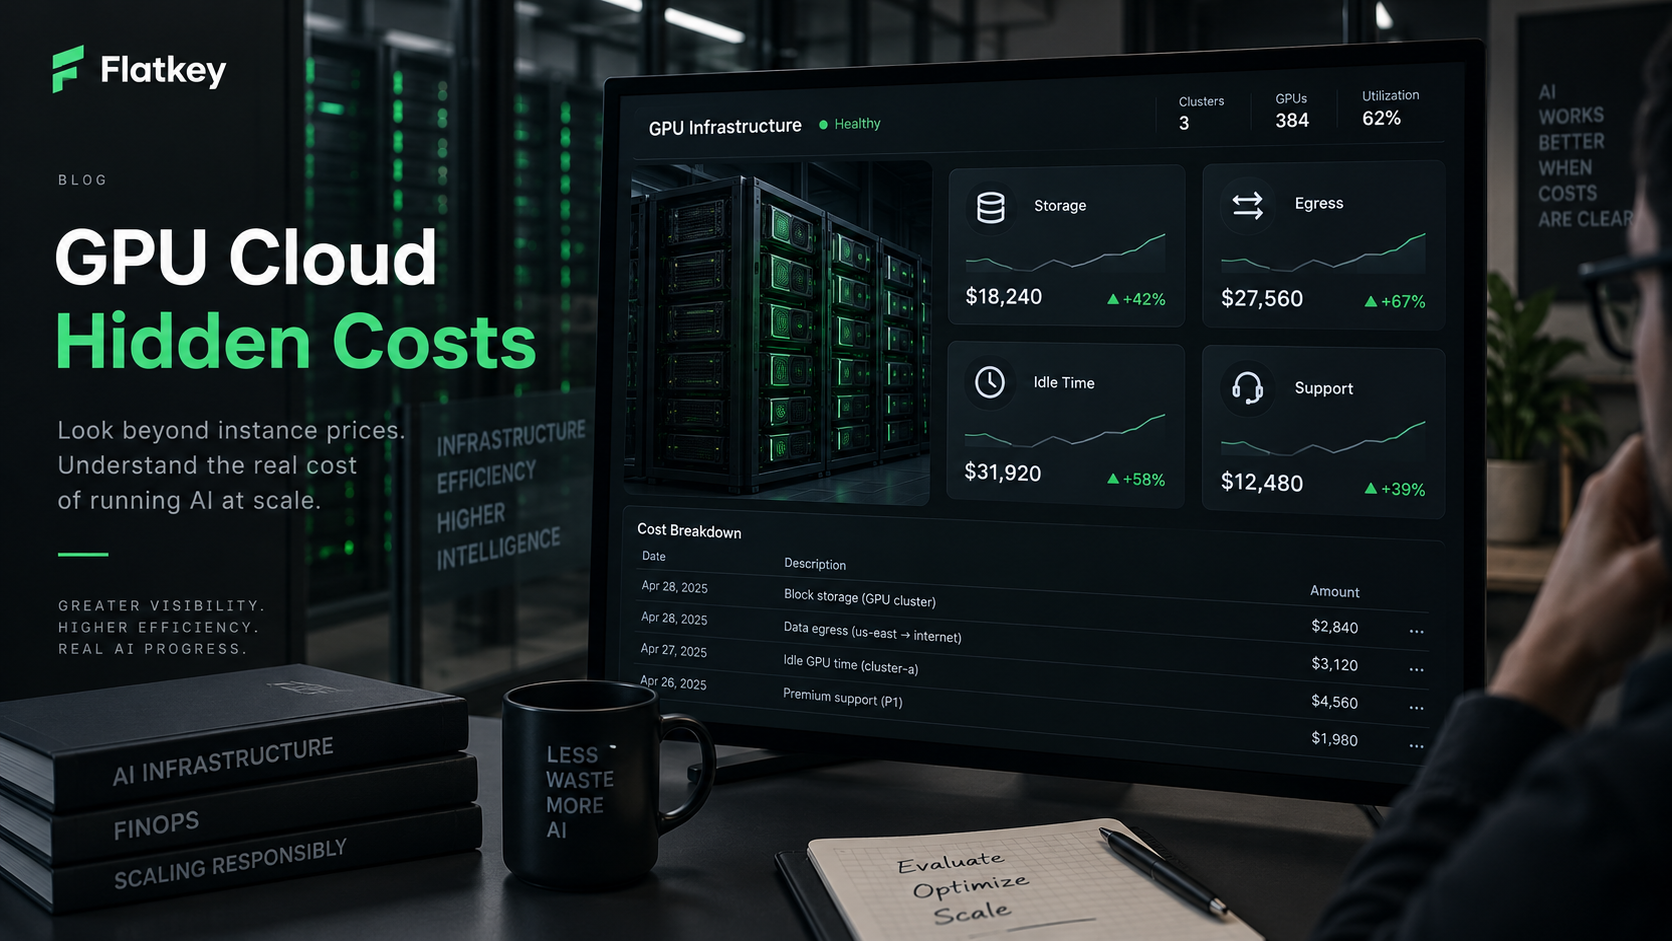
Каковы скрытые расходы облачных GPU-сервисов? Хранение, egress, простой и поддержка
Практическое руководство по TCO для облачных GPU: как заранее выявить расходы на хранение, egress, простой, неудачные задания, поддержку, сеть и операции до получения счёта.
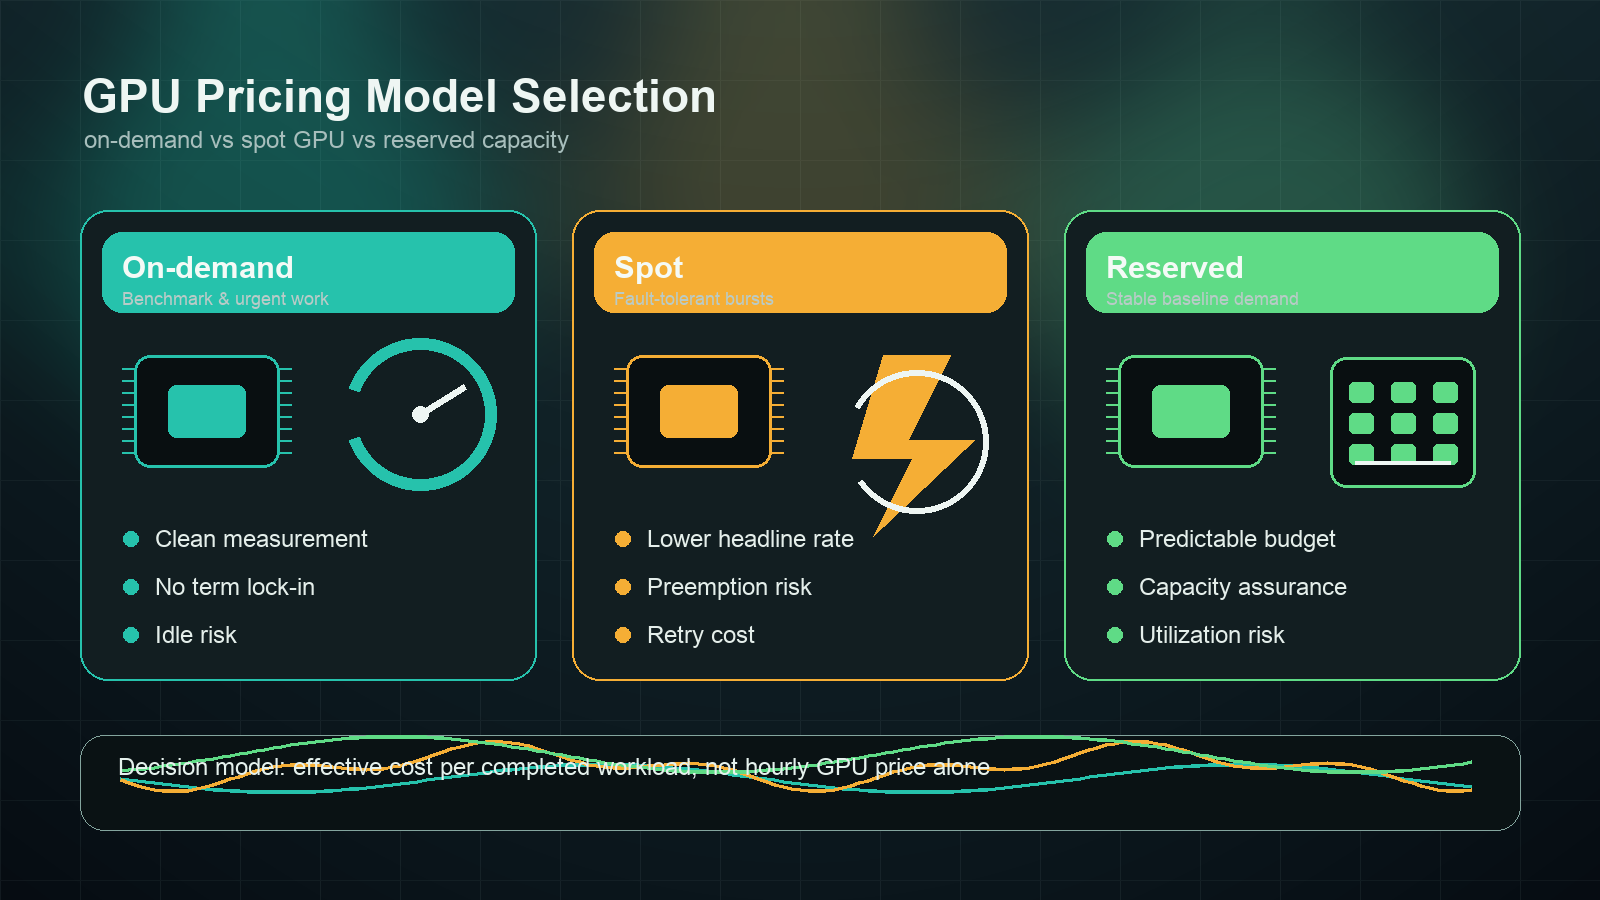
Цены на GPU по запросу, спот и по резервированию: какая модель подходит вашей нагрузке?
Подход к выбору между GPU по запросу, спот и резервированными мощностями на основе особенностей нагрузки, без путаницы между указанной почасовой ставкой и фактической стоимостью выполненной работы.
Частное GPU-облако: архитектура, изоляция и операционная модель
Узнайте, как оценить архитектуру частного GPU-облака, изоляцию, владение планировщиком, доказательства безопасности, операционную модель, TCO и приемочные тесты.

Руководство по развертыванию vLLM: предоставление LLM API, совместимого с OpenAI, на GPU
Разверните vLLM как API, совместимый с OpenAI, на GPU с помощью Docker, RunPod Serverless, Ray Serve, метрик, управления релизами и проверок стоимости на принятый результат.
Запускайте быстрее с единым AI-шлюзом.
Используйте flatkey.ai, чтобы управлять моделями, ключами, биллингом и наблюдаемостью на одной API-платформе.
Начать