
Chi phí, thanh toán và vận hành
Bài viết mới nhất trong Chi phí, thanh toán và vận hành.
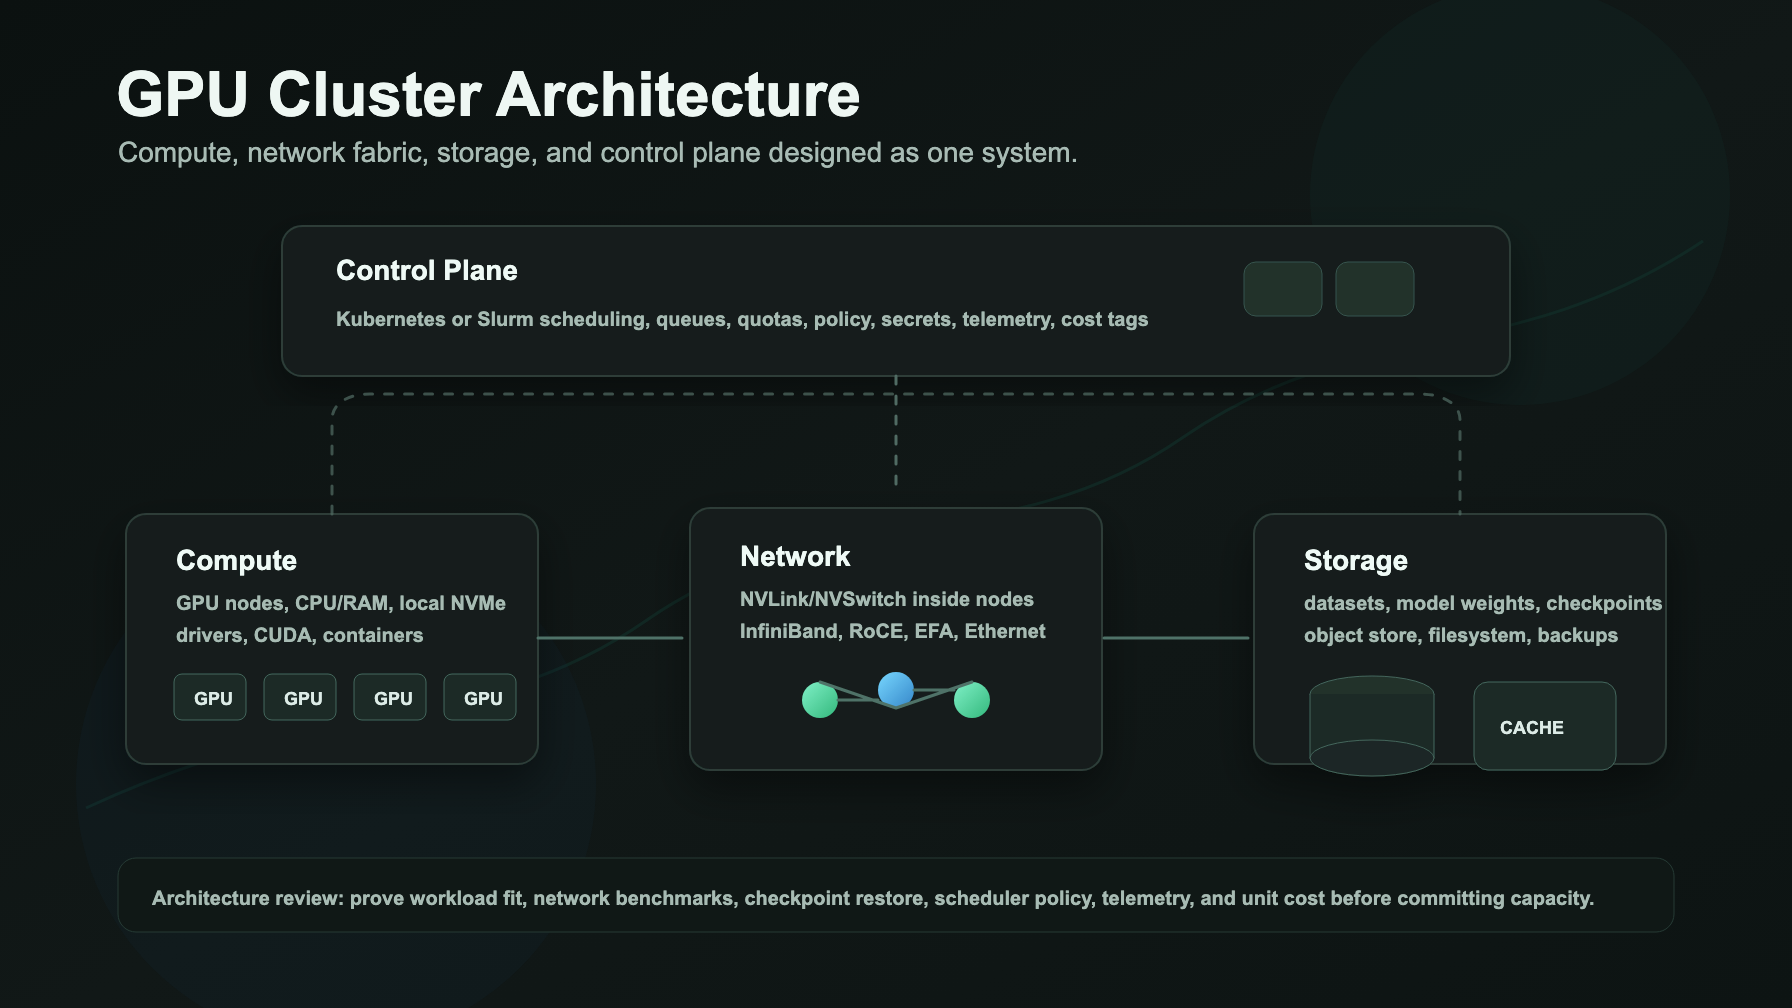
Kiến trúc Cụm GPU: Compute, Network, Storage và Control Plane
Hướng dẫn thực tiễn về kiến trúc cụm GPU cho các nút compute, mạng fabric, lưu trữ, control plane Kubernetes hoặc Slurm, khả năng quan sát và kiểm thử nghiệm thu.
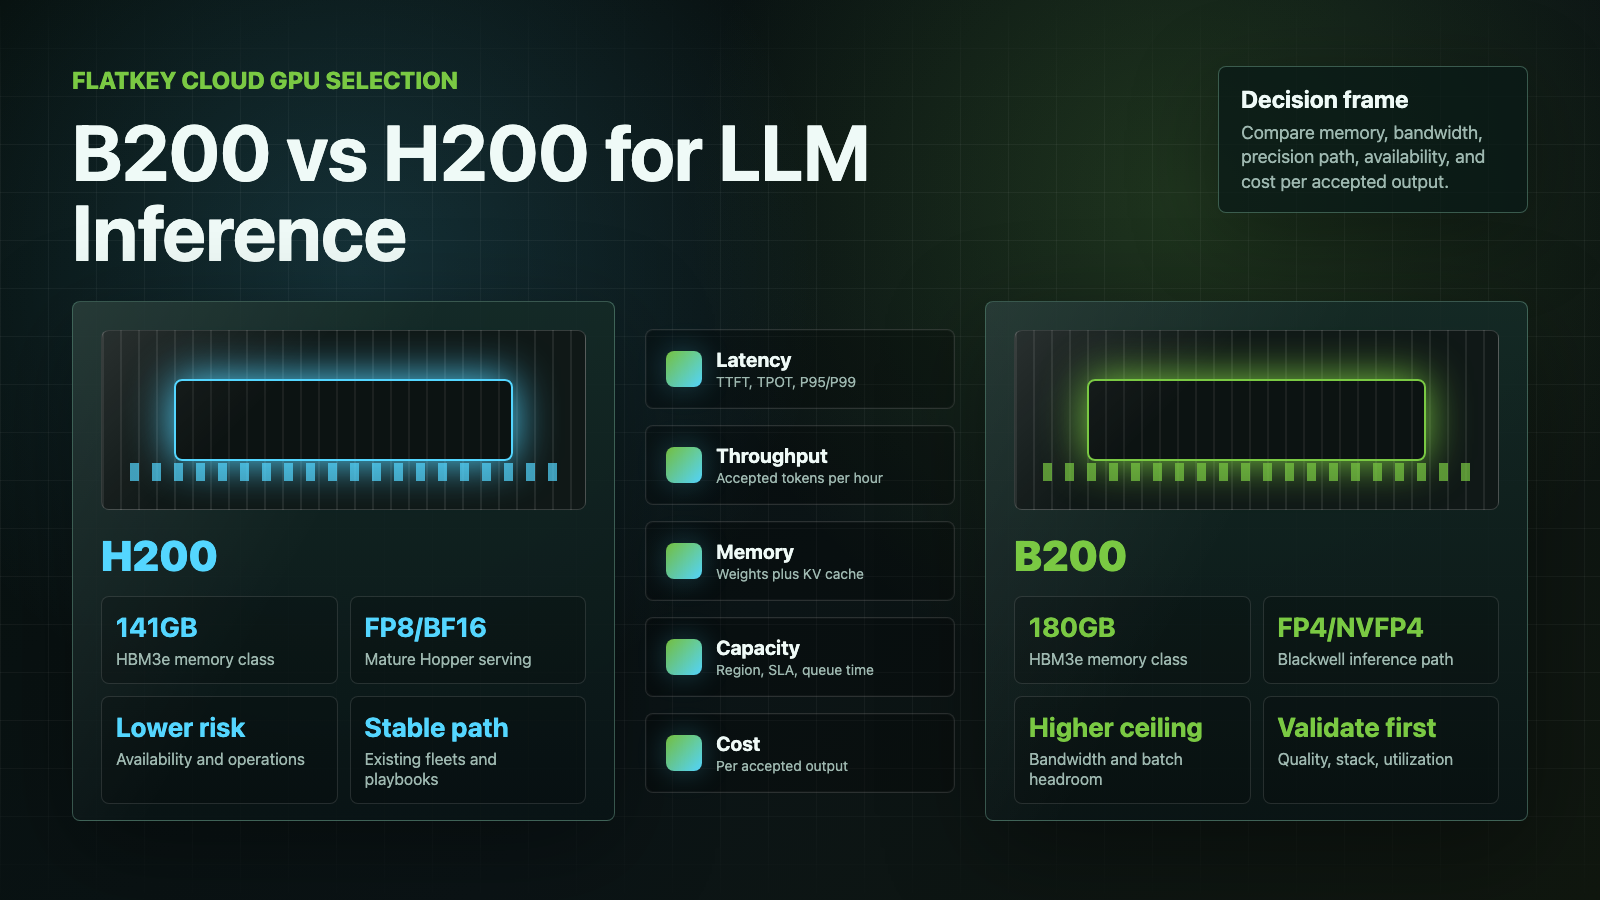
NVIDIA B200 so với H200: GPU nào tốt hơn cho suy luận LLM?
So sánh NVIDIA B200 và H200 cho suy luận LLM theo bộ nhớ, băng thông, hỗ trợ độ chính xác, hệ thống DGX, khả năng sẵn có trên cloud GPU và chi phí trên mỗi đầu ra được chấp nhận.
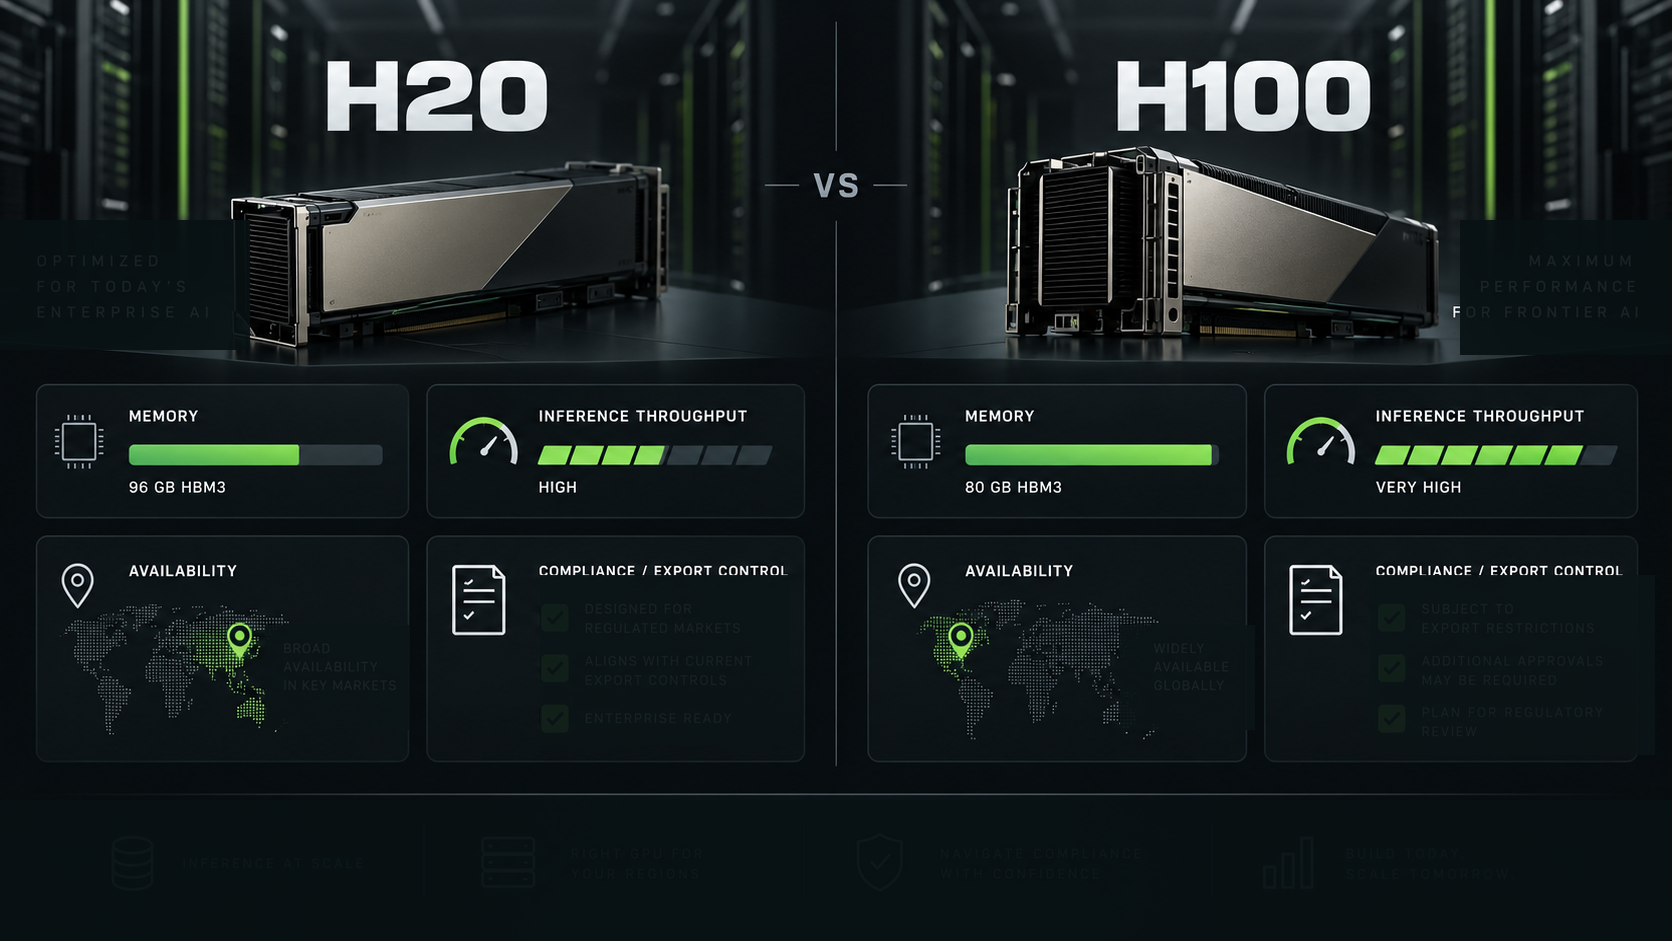
NVIDIA H20 so với H100: Suy luận, bộ nhớ, khả dụng và tuân thủ
So sánh thực tế H20 và H100 dành cho các nhóm AI doanh nghiệp, bao gồm suy luận, bộ nhớ, khả dụng, rủi ro kiểm soát xuất khẩu và khi nào H200 hoặc API mô hình là lựa chọn nền tảng tốt hơn.
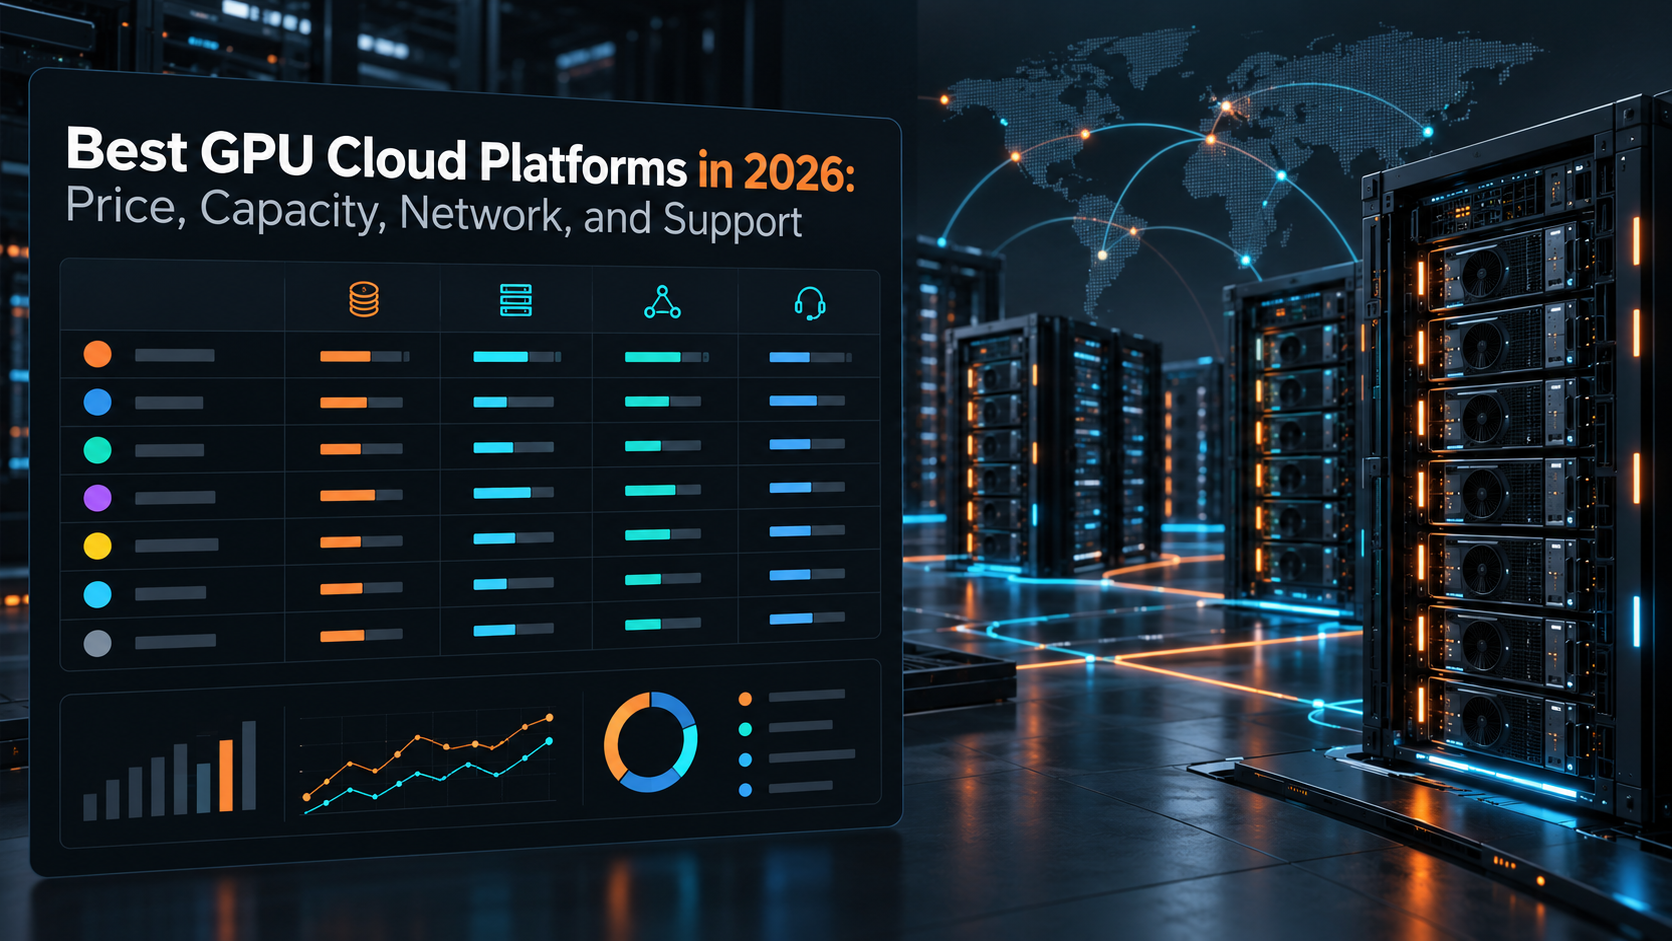
Các nền tảng thuê Cloud GPU tốt nhất 2026: Giá, dung lượng, mạng và hỗ trợ
Danh sách ngắn thực tế năm 2026 các nền tảng cloud GPU dành cho đội ngũ AI, so sánh mức giá, dung lượng, mạng, hỗ trợ và khi nào API mô hình là lựa chọn nền tảng tốt hơn.
NVIDIA Blackwell Ultra B300: Có gì thay đổi so với B200?
Một bản theo dõi thực tế về NVIDIA B300 Blackwell Ultra dành cho các nhóm hạ tầng AI, so sánh thông số B300, tình trạng ra mắt, lưu ý về giá và mức độ phù hợp với khối lượng công việc so với B200.
AMD MI455X và Helios: Theo dõi kiến trúc, bộ nhớ và tình trạng sẵn có
Bản theo dõi dành cho người mua về AMD MI455X và Helios, bao gồm kiến trúc, bộ nhớ HBM4, băng thông, tình trạng sẵn có, mức độ sẵn sàng cho vLLM, câu hỏi với nhà cung cấp và chiến lược dự phòng model/API.
NVIDIA Vera Rubin GPU: GPU, NVL72, Bộ nhớ, Mạng và Trình theo dõi Tình trạng Sẵn sàng
Trình theo dõi cập nhật các thông số NVIDIA Vera Rubin GPU, DGX Vera Rubin NVL72, bộ nhớ HBM4, mạng và các mốc sẵn sàng dành cho người mua GPU đám mây.
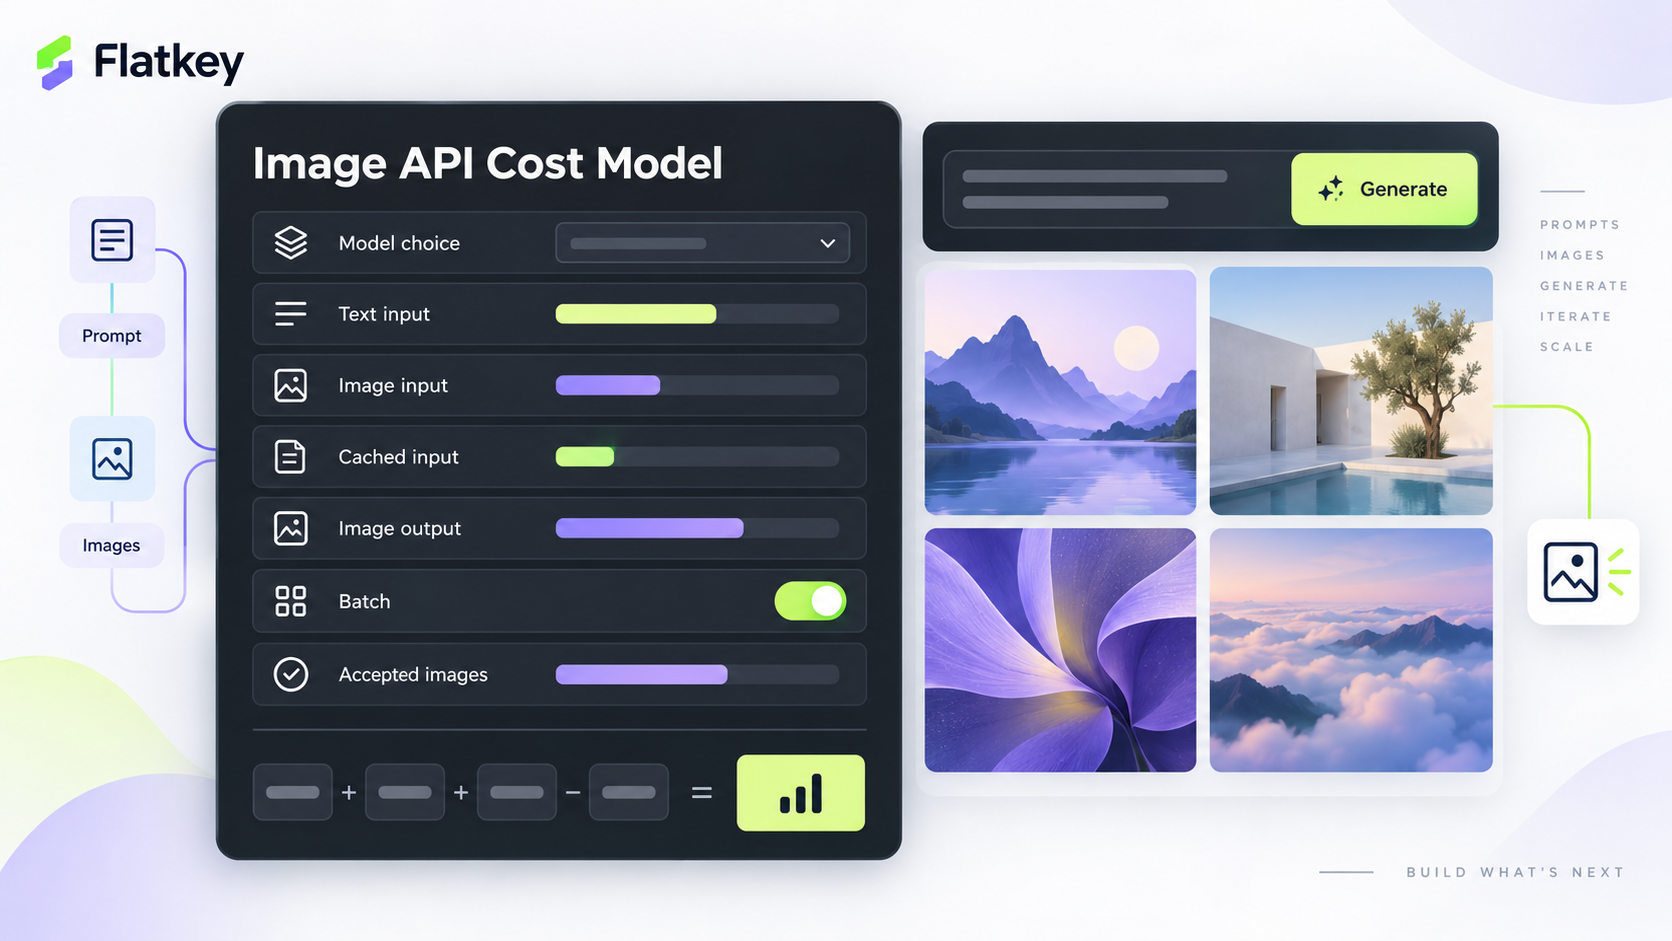
Định giá OpenAI Image API: Bảng giá GPT Image 2.5, công thức chi phí và kiểm soát ngân sách
Tìm hiểu cách hoạt động của định giá OpenAI image API cho GPT Image 2.5, bao gồm mức giá theo token, quy tắc input đã lưu cache, ảnh một phần, Batch và chi phí cho mỗi ảnh được chấp nhận.
GB200 vs B200: Superchip Grace Blackwell hay x86 HGX?
So sánh GB200 và B200 cho mua sắm hạ tầng AI: hệ thống Grace Blackwell quy mô rack NVL72, các node B200 HGX/x86, benchmark và kiểm tra TCO.
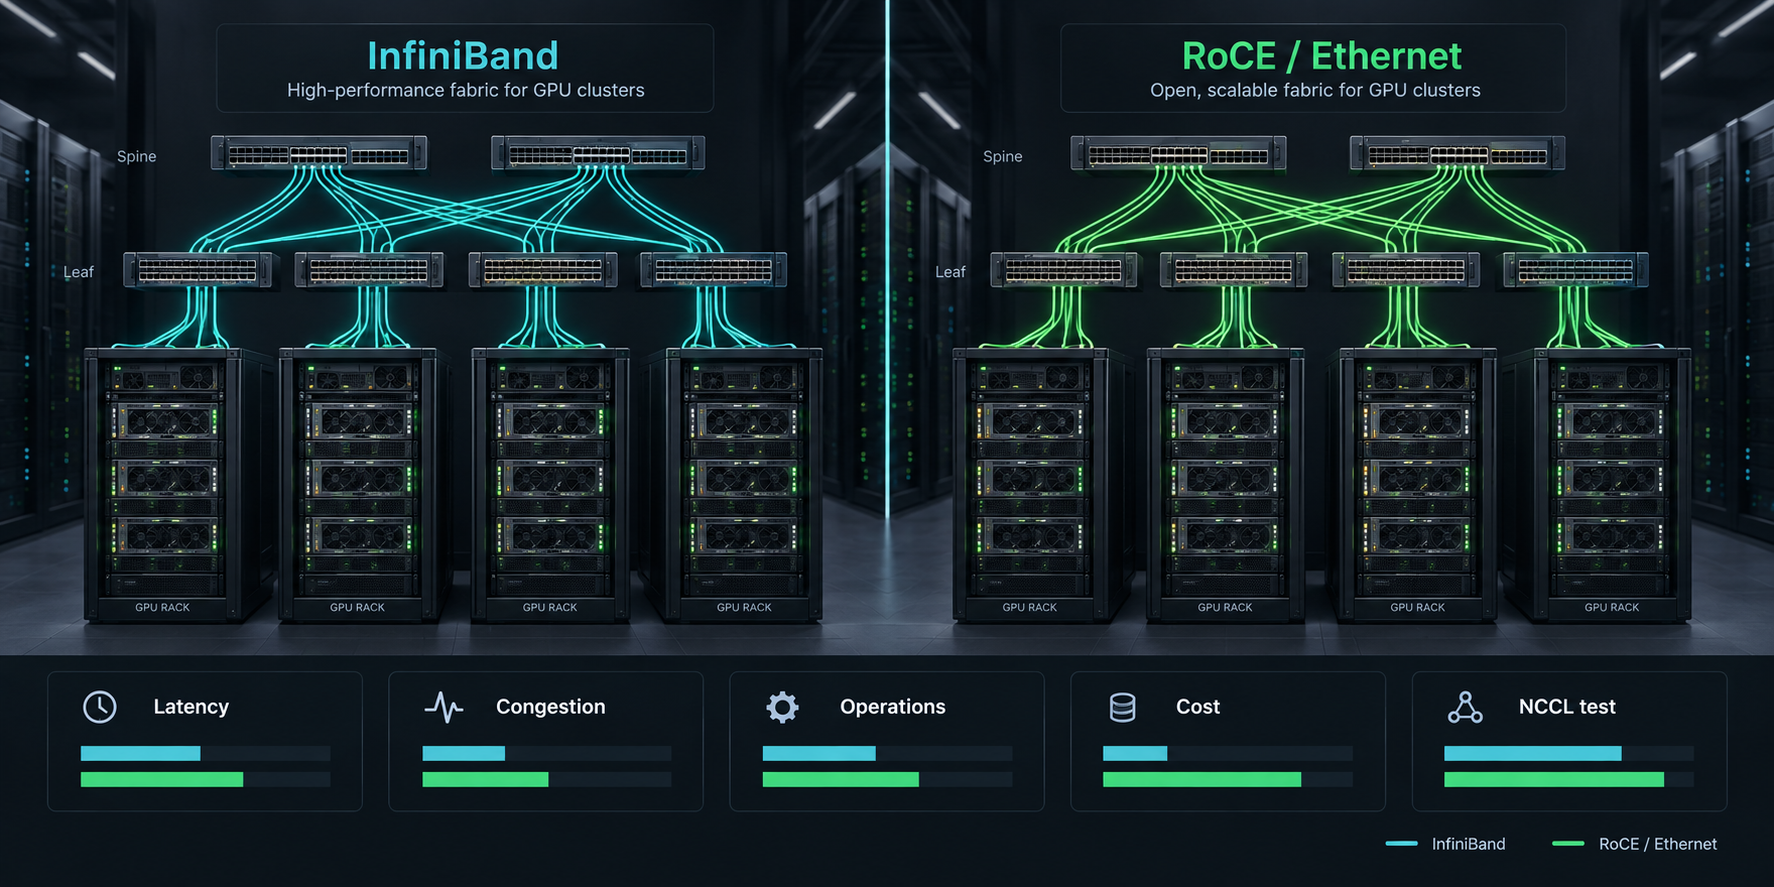
RoCE vs InfiniBand cho các cụm GPU: Độ trễ, vận hành và chi phí
So sánh RoCE và InfiniBand cho các cụm GPU đa nút với ma trận quyết định thực tế, bài kiểm tra chấp nhận NCCL, mô hình chi phí và danh sách kiểm tra mua sắm.
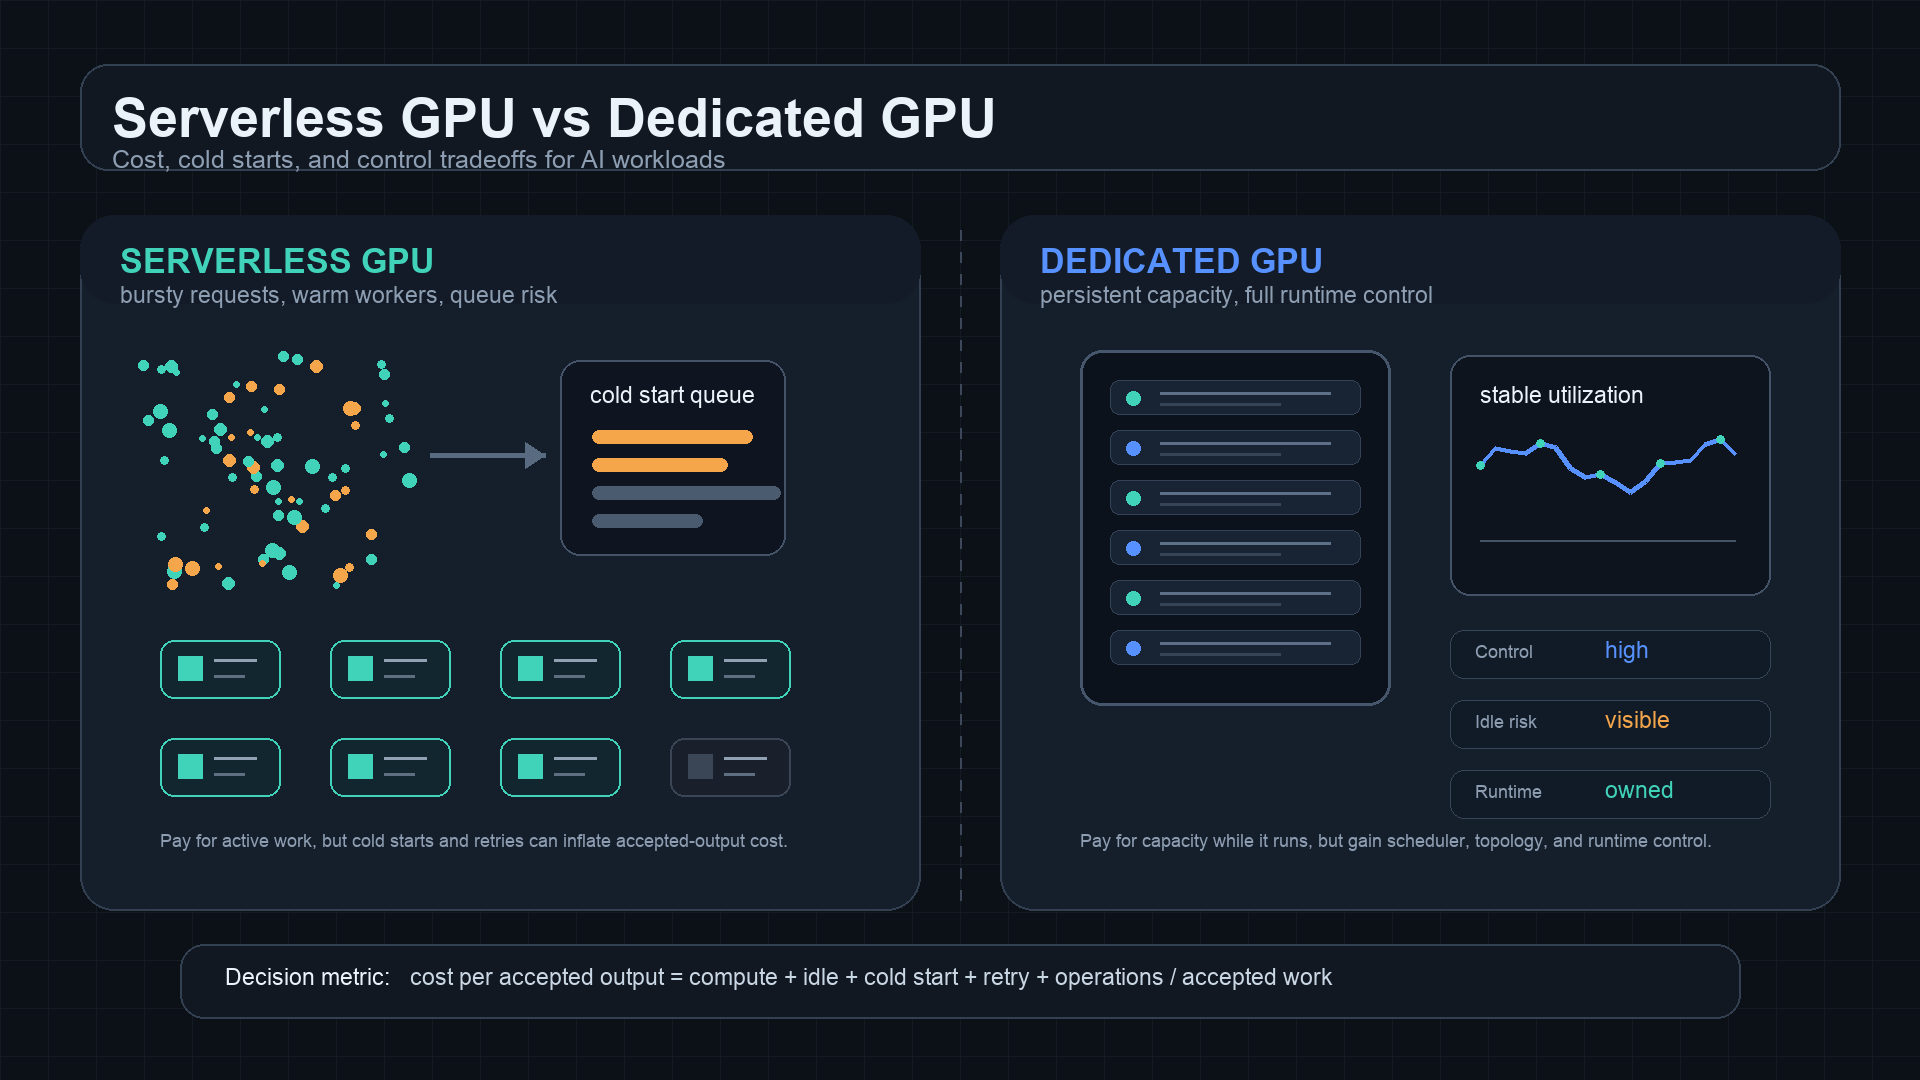
Serverless GPU so với Dedicated GPU: Chi phí, cold start và khả năng kiểm soát
So sánh serverless GPU với dedicated GPU theo chi phí trên mỗi đầu ra được chấp nhận, cold start, dung lượng nhàn rỗi, tự động mở rộng và mức độ kiểm soát vận hành.

So sánh giá API tạo ảnh AI: GPT Image, Gemini, Imagen và fal
So sánh giá API tạo ảnh giữa GPT Image, Gemini Image, Imagen và các tuyến fal bằng cách chuẩn hóa đơn vị tính phí thành chi phí trên mỗi ảnh được chấp nhận.
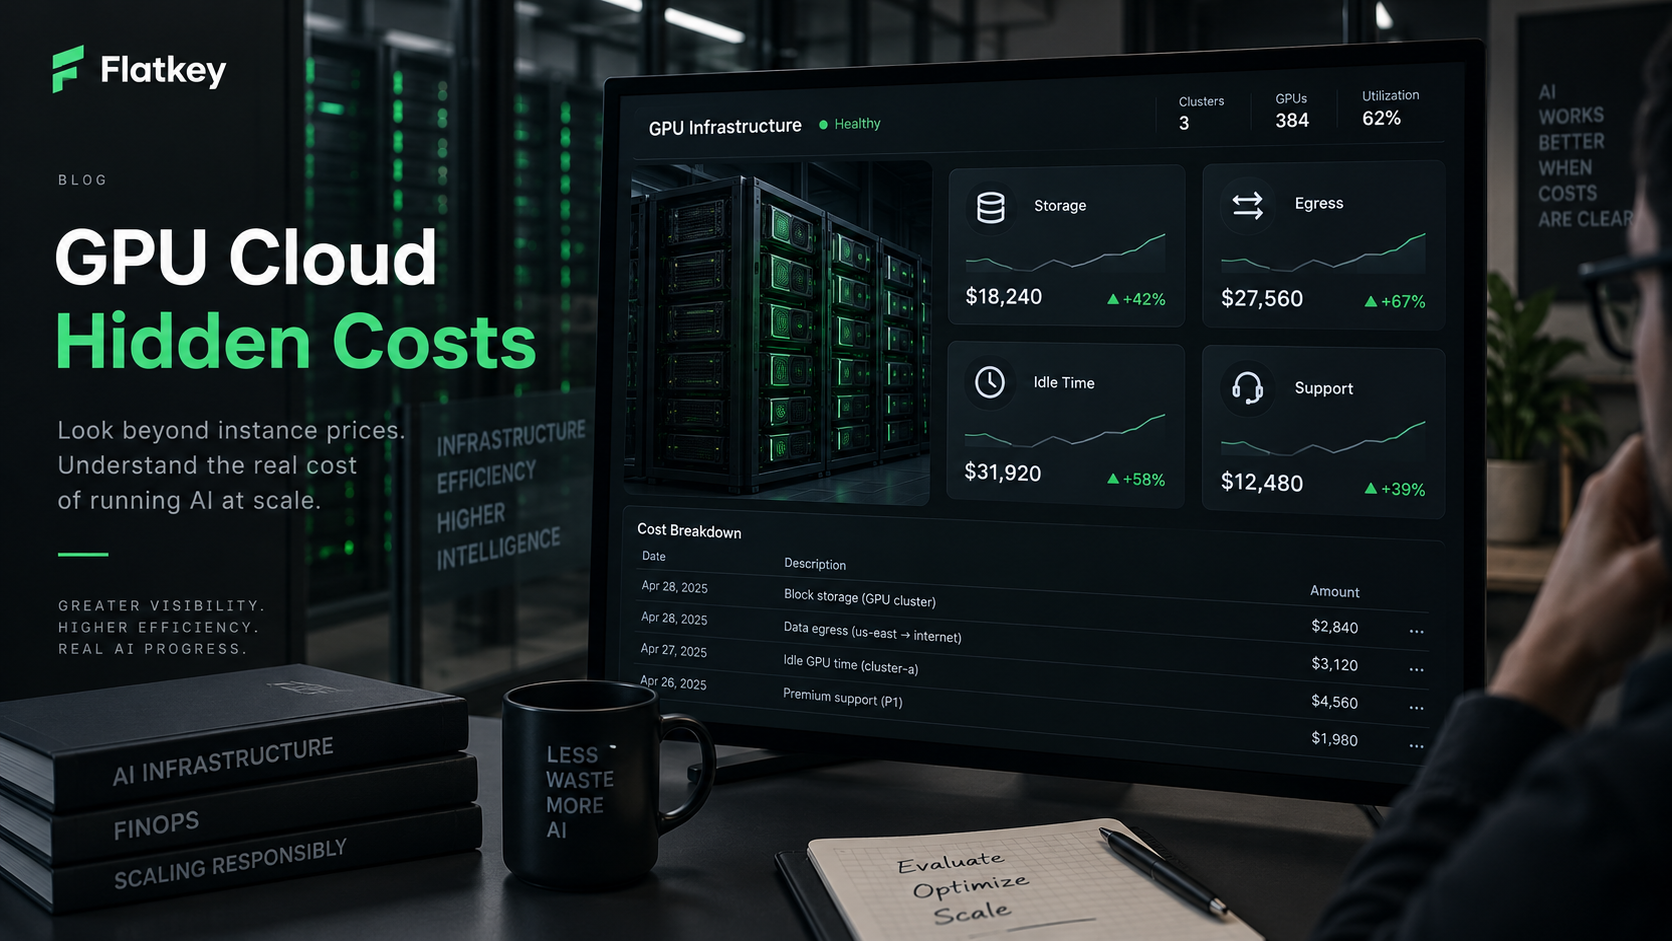
Chi phí ẩn của dịch vụ GPU Cloud là gì? Lưu trữ, egress, thời gian nhàn rỗi và hỗ trợ
Hướng dẫn TCO thực tế cho GPU cloud để xác định trước các chi phí lưu trữ, egress, thời gian nhàn rỗi, job lỗi, hỗ trợ, mạng và vận hành trước khi hóa đơn xuất hiện.
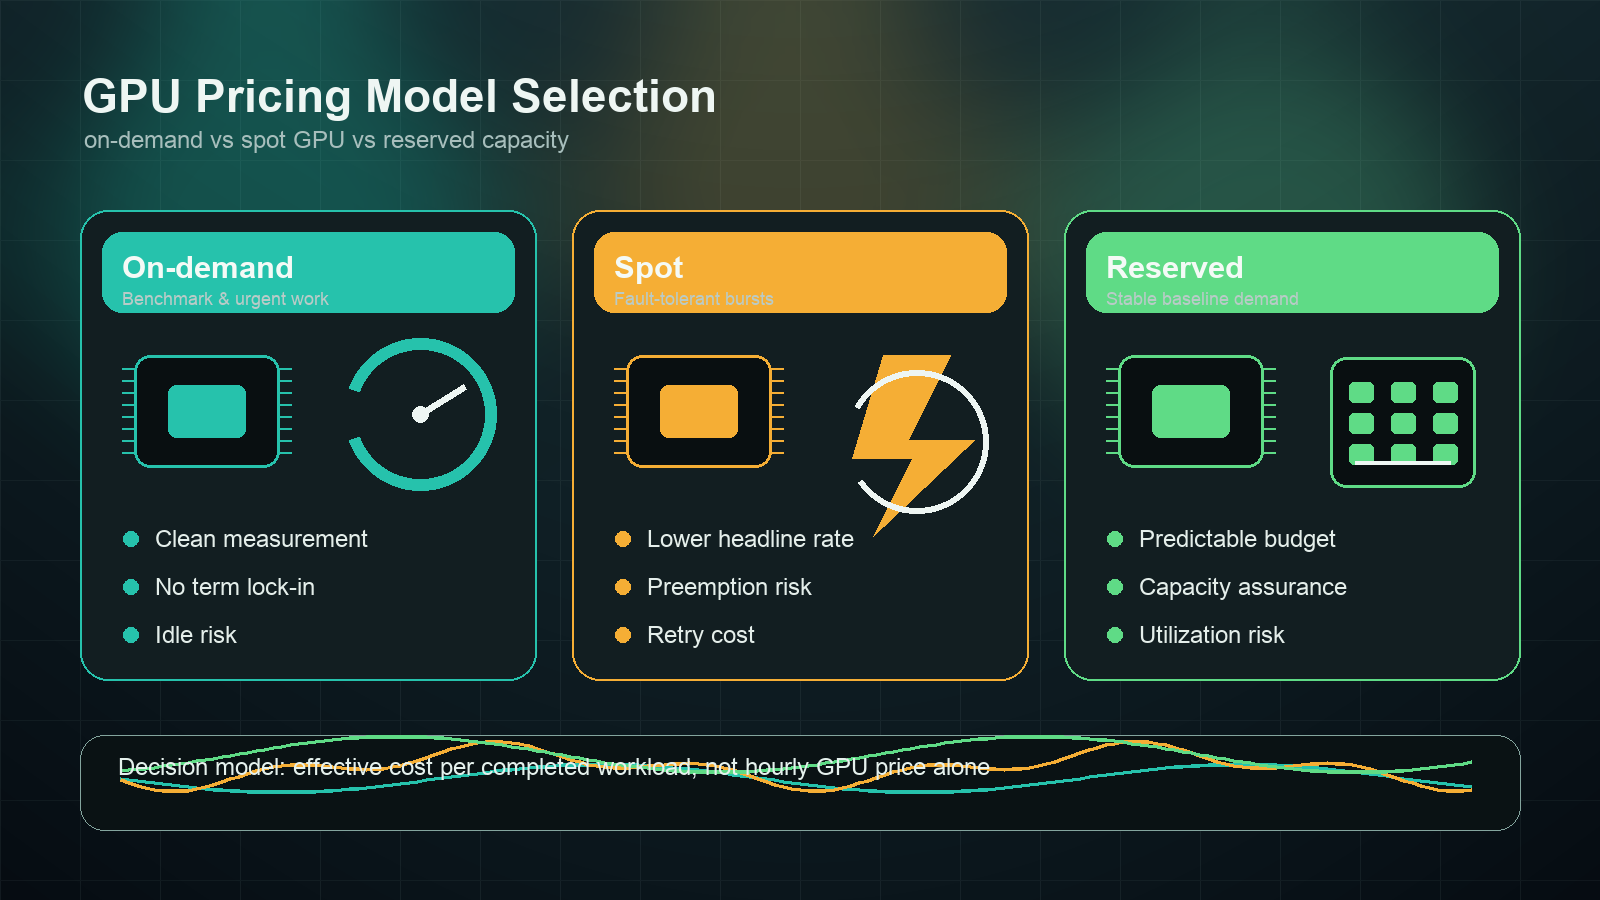
So sánh giá GPU theo On-Demand, Spot và Reserved: Mô hình nào phù hợp với khối lượng công việc của bạn?
Một khung đánh giá theo khối lượng công việc để chọn dung lượng GPU on-demand, spot hoặc reserved mà không nhầm lẫn giữa đơn giá theo giờ niêm yết và chi phí thực tế của tác vụ hoàn thành.
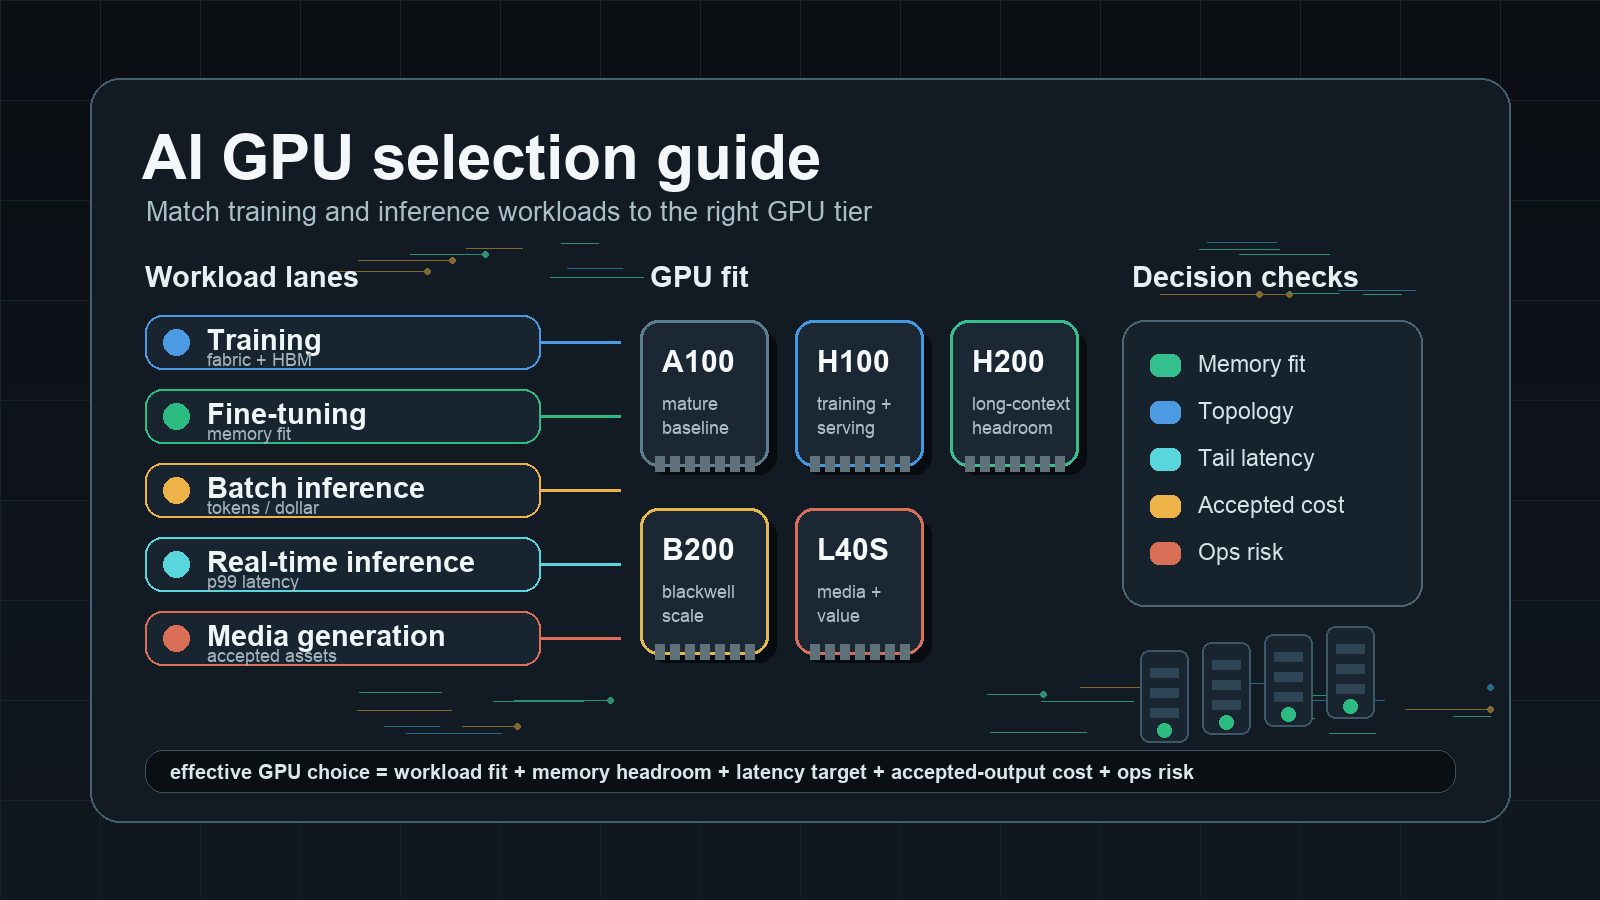
Hướng dẫn chọn GPU cho AI: Ghép đúng khối lượng công việc huấn luyện và suy luận với GPU phù hợp
Hướng dẫn thực tế chọn GPU AI cho các nhóm đang ghép khối lượng công việc huấn luyện, fine-tuning, suy luận LLM, tạo media và đánh giá với GPU phù hợp và mô hình năng lực phù hợp.
Cloud GPU riêng tư: Kiến trúc, cô lập và mô hình vận hành
Tìm hiểu cách đánh giá kiến trúc cloud GPU riêng tư, cơ chế cô lập, quyền sở hữu bộ lập lịch, bằng chứng bảo mật, mô hình vận hành, TCO và các bài kiểm thử nghiệm thu.

Hướng dẫn triển khai vLLM: phục vụ API LLM tương thích OpenAI trên GPU
Triển khai vLLM thành API tương thích OpenAI trên GPU với Docker, RunPod Serverless, Ray Serve, metrics, kiểm soát rollout và kiểm tra chi phí trên mỗi đầu ra được chấp nhận.
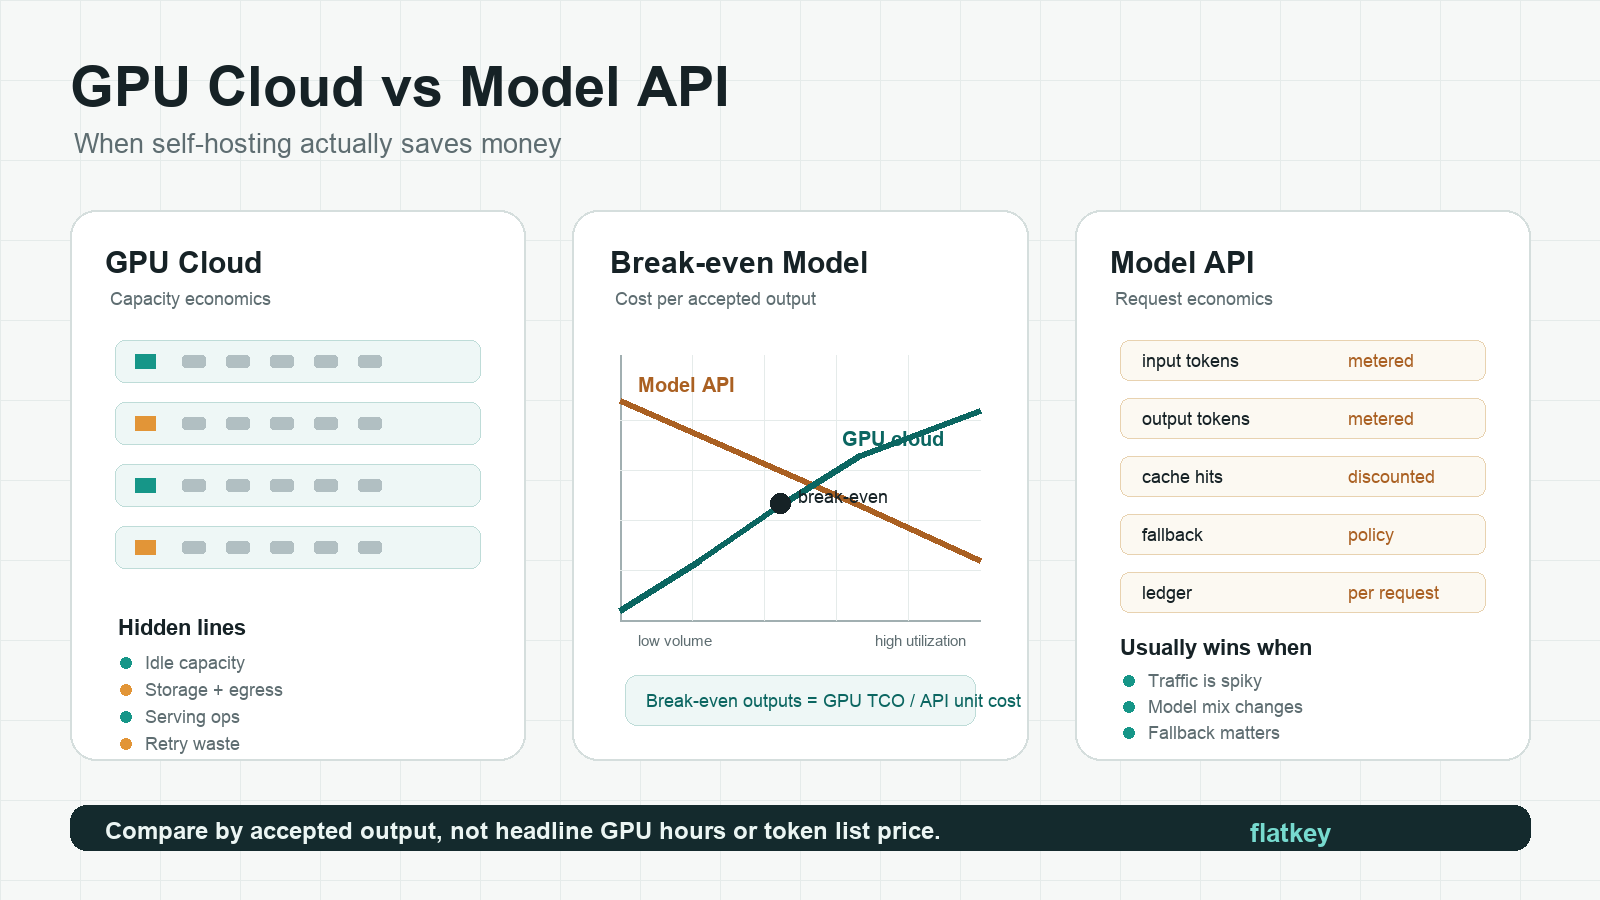
GPU Cloud vs Model API: Khi Tự Triển Khai Thực Sự Tiết Kiệm Chi Phí
So sánh kinh tế giữa GPU cloud và model API với bảng tính điểm hòa vốn cho chi phí đầu ra được chấp nhận, mức sử dụng, số lần thử lại, năng lực nhàn rỗi và vận hành phục vụ.
Xây dựng nhanh hơn với một cổng AI.
Dùng flatkey.ai để quản lý mô hình, khóa, tính phí và quan sát vận hành trong một nền tảng API.
Bắt đầu